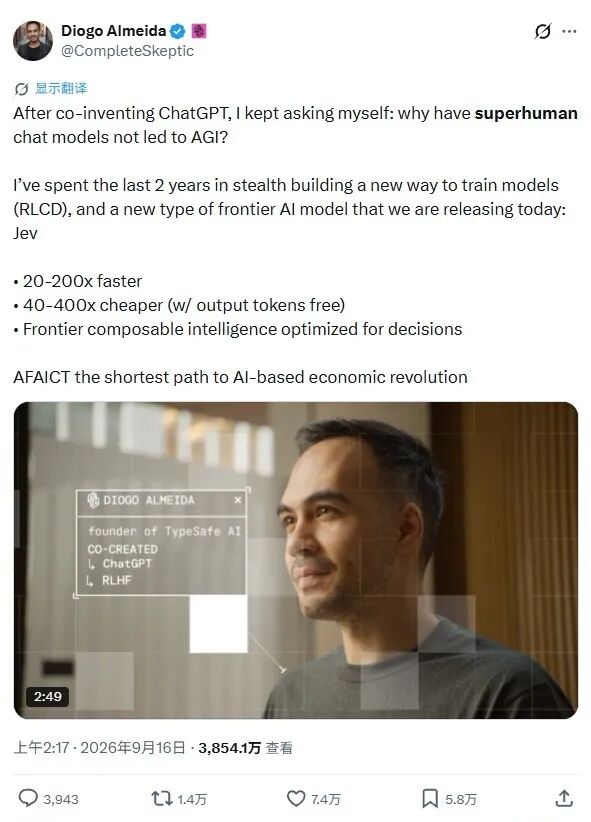
Jev 上线 Vercel AI Gateway 的 24 小时内,近 13% 的付费团队用过它,是该网关历史上新模型采用最快的一次,同期覆盖达到 GPT-5.6 系列的两倍以上、Fable 5.1 的六倍以上。创始人在 X 上的发布帖有超过 3600 万浏览。开源社区的反应也很快,三天内做出的竞品 Laya 已经拿到 8820 颗 Star。
开发者把它接进流水线做的事情很具体:给 Agent 挑下一个该调用的工具,决定一条工作流该继续、重试、询问用户还是停下,在动作执行前评估紧急度和风险,以及校验模型输出、执行护栏、把没把握的案例转人工复核。
它的作者是 Diogo Almeida,参与过 InstructGPT 与 ChatGPT 的早期开发,是 RLHF 的共同发明人,此前在 OpenAI 任研究员。他在旧金山创办 TypeSafe AI,公司刚完成由 DCVC 领投的 4000 万美元种子轮,并于 2026 年 9 月 15 日发布 Jev。
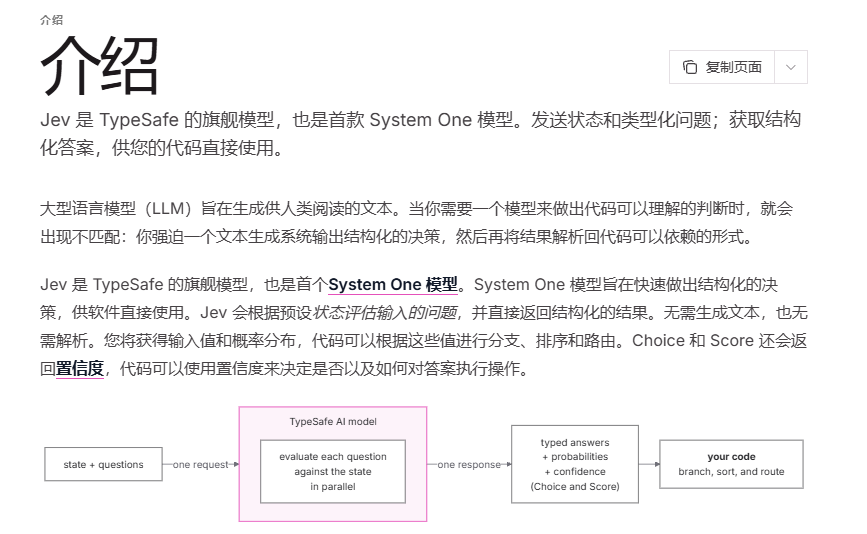
在大多数模型都在比拼生成长度、对话能力和长文本推理的时候,Jev 走了一条完全相反的路。它不写文章,也不做开放式问答,只接收一段上下文与预设的几个选项,然后直接输出各个选项的概率。
官方在设计原则里甚至明确提出了一句口号:"Building prod, not God"(造生产工具,而不是造神)。它在系统里根本不是用来写内容的,而是一个专门在代码分支里做选择题的判卷器。
01 Jev 是什么:只回答选择题的判别式模型
要理解 Jev 的定位,可以先看日常开发中大家是怎样让大模型做判断的。
比如,需要判断一条用户评论是不是垃圾广告。如果调用常见的大语言模型,哪怕你在提示词里千叮咛万嘱咐「请只回答是或否,不要输出任何多余内容」,模型的底层逻辑依然是在写作文。它必须启动整套自回归生成网络,一个词一个词地往外吐字。有时候它老老实实输出「是」,有时候却会多吐出标点符号、解释前缀或者换行符。开发者为了在代码里用这个结果,还得专门写正则表达式去清洗返回的文本。一旦大模型没按预期格式出牌,后续业务逻辑直接报错。
让一个擅长写长文的生成模型来做这种是非判断,不仅慢、计费贵,而且输出格式随时可能失控。
Jev 从根本上不做问答题,只做选择题。
在模型形态上,它不属于逐词预测的自回归生成模型,而是退回到了专门做分类与判断的判别式模型。开发者把待分析的文本作为输入,同时递给它几个固定选项。Jev 在运行后不吐出任何自然语言,而是像扫描一样,直接给每一个选项打出确切的概率。
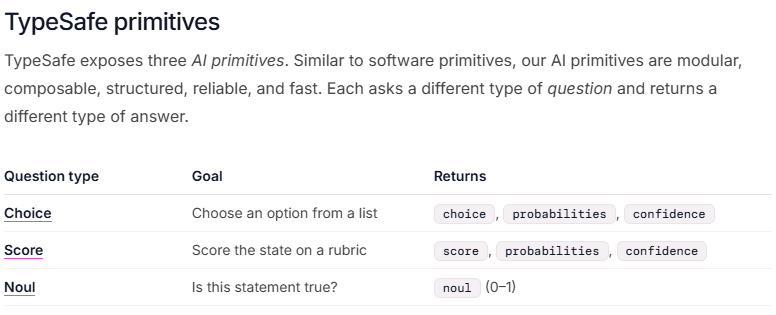
对于开发者来说,这种选择题被抽象成了三种最基础的题型(官方称为原语):
-
Choice(单选题),用于多分类标签。比如判断客服工单属于「退款咨询」、「技术报错」还是「功能建议」,模型直接返回各个分类的概率。
-
Score(评分题),用于有序刻度打分。比如在 1 到 5 分之间评估内容的匹配度或风险等级,返回各档位的分布与加权分。
-
Noul(判断题),用于纯粹的二元是非判断。直接评估某个命题是真是假,比如「这段内容包含敏感词」的成立概率。
官方文档给出了完整的请求与返回。下面这组是 Score 题型的原始示例,一个 bug 报告加上一个「有多严重」的问题:
bash
from typesafe_sdk import Score, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state="The export button crashes the settings page in Safari. It works in Chrome, but a few of our customers only use Safari.",
        questions={
            "bug_severity": Score(
                instructions="How severe is the reported issue?",
                criteria=[
                    "Cosmetic; no impact to functionality",
                    "Broken or degraded feature, but workaround exists",
                    "Blocking issue; no workaround exists",
                ],
            ),
        },
    )

print(response.answers["bug_severity"].score)返回是纯净的 JSON,没有任何聊天前缀:
bash
{
  "model": "jev-1.13.0",
  "answers": {
    "bug_severity": {
      "type": "score",
      "score": 1.43,
      "confidence": 0.35,
      "legend": {
        "0": "Cosmetic; no impact to functionality",
        "1": "Broken or degraded feature, but workaround exists",
        "2": "Blocking issue; no workaround exists"
      },
      "probabilities": {
        "0": 0.0,
        "1": 0.57,
        "2": 0.43
      }
    }
  },
  "usage": {
    "input_tokens": 332,
    "output_tokens": 18
  }
}
三种题型的返回字段并不相同,这点容易看混。
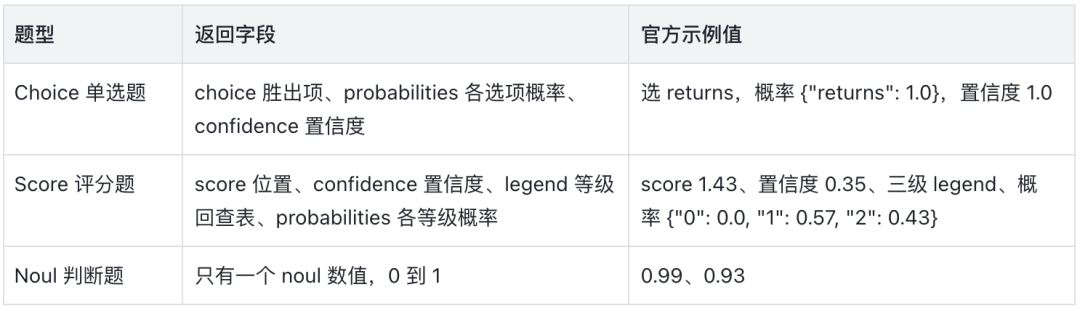
Noul 是唯一不带 confidence 的题型。官方的解释是它的分布只有两个结果,一个数就能完整描述。Choice 和 Score 都把概率摊在多个选项或等级上,需要 confidence 概括摊开的程度。
score 不是等级编号,是等级编号按概率加权后的位置。官方示例里 0.57 落在第 1 级、0.43 落在第 2 级,加权出来就是 0.57 加 0.86 等于 1.43,所以它可以落在两个等级之间。legend 的作用是把数字编号映射回你写的等级描述,避免回头查代码。
usage 里有两个 token 计数。output_tokens 并不是 0,官方示例里它是 18 到 212 之间的正数,统计的是结构化答案占用的 token,不是模型生成的自然语言。「不生成文本」在官方 Introduction 里写得很直接,No text generation, no parsing,开发者拿到的是带类型的值和概率分布,代码可以直接分支、排序和路由。
三种题型可以混在同一次请求里。官方文档的说法是每个问题对同一份 state 并行、隔离地求值,加问题几乎不改变响应时间,只多花少量 question token。
官方相关资源与示例地址:
-
官方 Python SDK,
pip install typesafe-sdk(开源项目主页:https://github.com/typesafe-ai ) -
官方示例与 Agent Skills 仓库,https://github.com/typesafe-ai/skills
-
官方文档与 Playground 控制台,https://docs.typesafe.ai
这三种题型底层是一样的逻辑,把待处理的文本(官方叫 State)塞给它,附上你的具体问题和判断标准,它就在你给定的这几个选项里算一遍概率。
很多原本让大模型做的事,说到底就是代码里的几个 if-else 分支。能用大模型写出来的逻辑,不等于非要让大模型打字去算。Jev 就是把这些大模型做起来又慢又贵的分类任务接过来,当成一个轻快、省钱的判断工具供程序直接调用。
02 工作原理:单次前向与概率校准
普通的聊天模型生成回答,本质上是在反复循环。模型读完上下文后,在整个词表里算一遍所有词的得分,挑一个最合适的词拼上去,然后再拿拼好的新文本从头计算下一个词。生成一段完整的回答,模型整套网络就要硬跑几十遍甚至几百遍。
Jev 把逐词解码的循环全砍掉了。
在执行过程中,模型拿到文本和候选选项之后,只看候选位置对应的分值,在预设的这几个选项之间算好归一化概率就直接返回。整个过程只跑一次模型前向计算,没有循环,没有采样,也没有文字拼接。
而且,Jev 支持在一个上下文下同时提多个问题。输入的文本只用编码一次,底下挂的几个独立问题是在同一次计算里并发评估的。所以在同一个请求里同时问三个问题和只问一个问题,耗时几乎没有区别。
在概率输出上,平时最容易把三个概念搞混:
-
概率(Probabilities),各个选项分数的占比,加起来正好是 100%。分布的扁平或陡峭本身就代表了不确定性。
-
置信度(Confidence),官方为了避免开发者在代码里手算香农信息熵,自动帮你把分布的离散程度压缩成一个 0 到 1 的数字。如果三个选项是 34%、33%、33%,置信度接近 0;如果是 98%、1%、1%,置信度极高。它衡量的是模型自己有多笃定,而不是答案在客观上对不对。至于 Noul(是非题)为什么没有置信度,是因为二元题的概率数值本身就已经完整代表了把握程度。
-
校准(Calibration),这是大量统计下的准确率匹配。一个校准良好的模型,当它给出一万次「90% 概率」的判断时,回头去复盘,真实对的大概就是九千次。它不盲目自信,也不瞎谦虚。
学术背景上,给概率打分的数学早在 1950 年预测天气时就形成了 Brier 评分,后来统计学确立了严格适当评分规则。近两年学术界才把这套评分体系搬进大模型的强化学习里(如 MIT 提出的 RLCR 机制),专门治模型满嘴跑火车、盲目自信的毛病。Jev 也是顺着这个思路,把概率测得准当作最核心的能力来训。
03 开源社区的跟进,三大复刻流派
虽然 Jev 在今年 9 月拿了 4000 万美元种子轮融资爆火出圈,但「不用自回归生成、纯靠强化学习给预设选项打概率」的技术思路,并不是今年才凭空冒出来的。
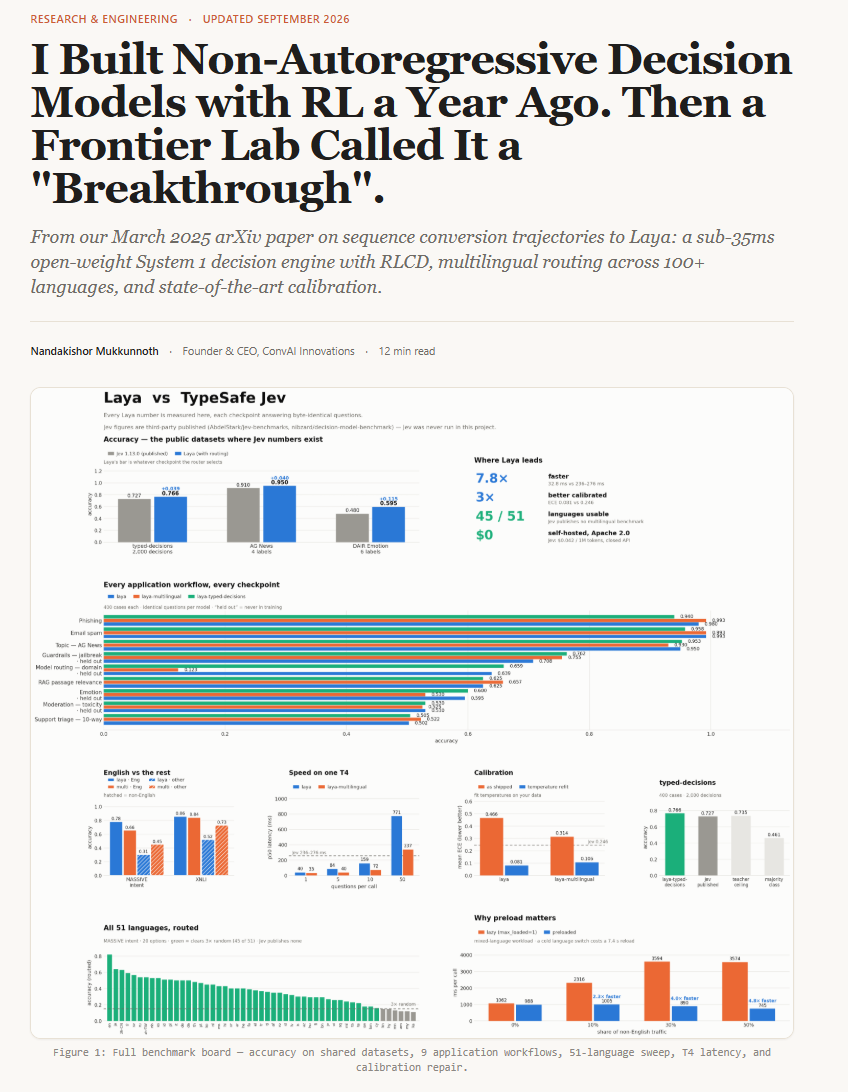
早在 2025 年 3 月,开源社区开发者 Nandakishor M 就发表了学术论文《SalesRLAgent》(arXiv:2503.23303),提出用强化学习直接在序列隐表示上预测概率轨迹,摆脱自回归生成。同年 10 月,他又发表了第二篇论文《Confidence-Aware Routing》(arXiv:2510.01237),把基于多信号置信度评估的预生成决策系统正式形式化,并公开了数据集与权重。
当 TypeSafe 以闭源商业 API 的形态推出 Jev 后,开源社区迅速演化出了三个极具代表性的复刻流派:
第一个流派走双向编码器路线,主打轻量、极速与多语言,代表作是开源项目 Laya。Laya 采用 ModernBERT 与多语言 mmBERT 构建,单张消费级显卡延迟仅 32.8 毫秒,甚至比 Jev 的远程接口快数倍。更关键的是它内置了多字符集检测分流器,支持 100 多个语种,成为目前中文与多语言自建环境的首选。该项目在 GitHub 上线仅 3 天,截至 2026 年 9 月 21 日已积累 8820 颗 Star。
开源项目地址:https://github.com/NandhaKishorM/laya 在线交互与实测对比:https://laya.convaiinnovations.com/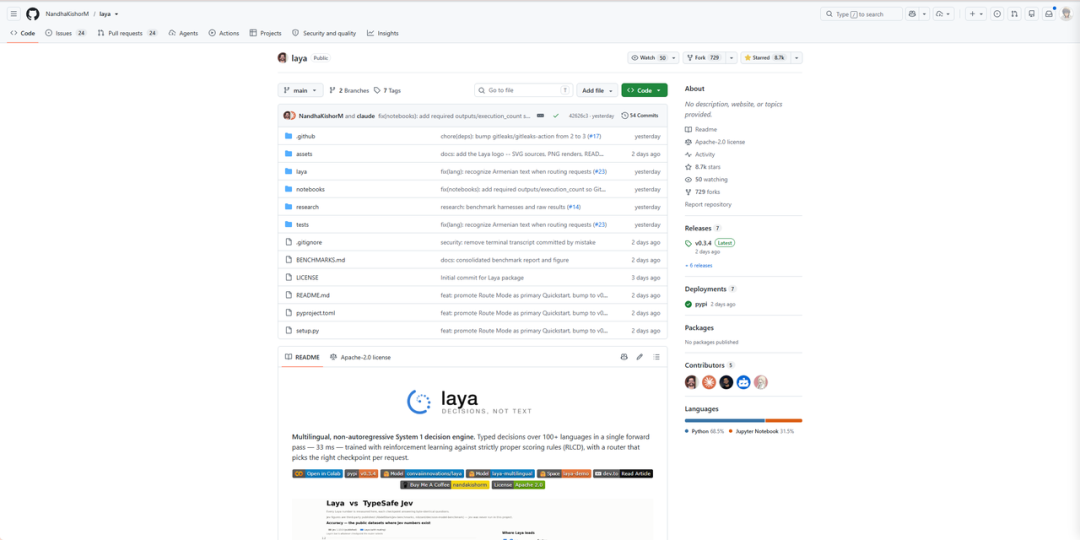
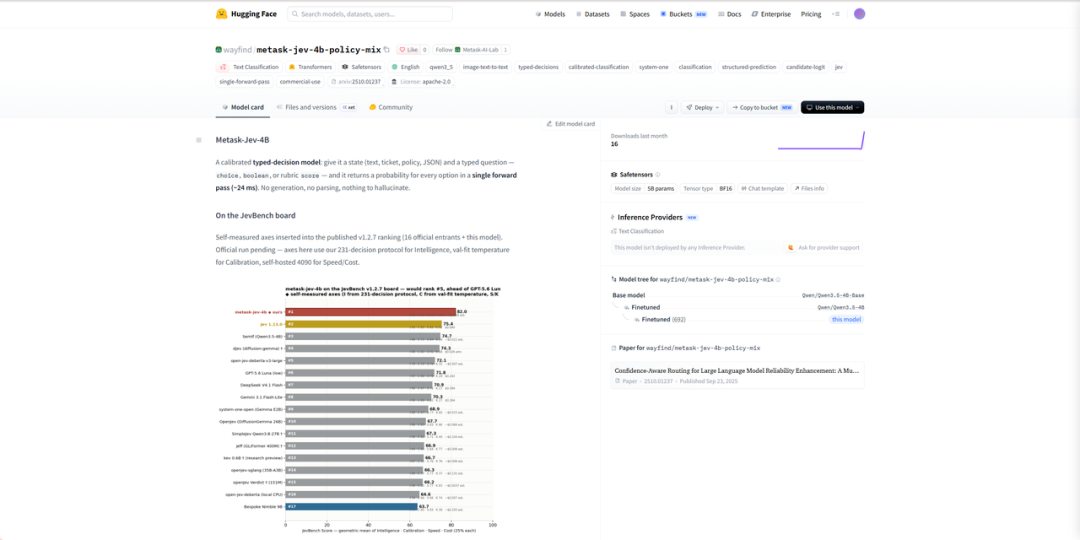
第二个流派走因果解码器路线,主打大模型底座与超长上下文,代表作是近期在 Hugging Face 发布的 Metask-Jev-4B 与 Bespoke Nimble。这类项目基于 Qwen3.5 等成熟大模型基座进行微调,同样遵循「单次前向读取选项 Token 的 logit、绝不逐词生成」的协议。以 Metask-Jev-4B 为例,单次前向仅需约 24 毫秒,架构上限为 26 万 Token,但模型卡明确说明 4096 Token 才是已验证的评测点位,长文档场景仍需自行验证。
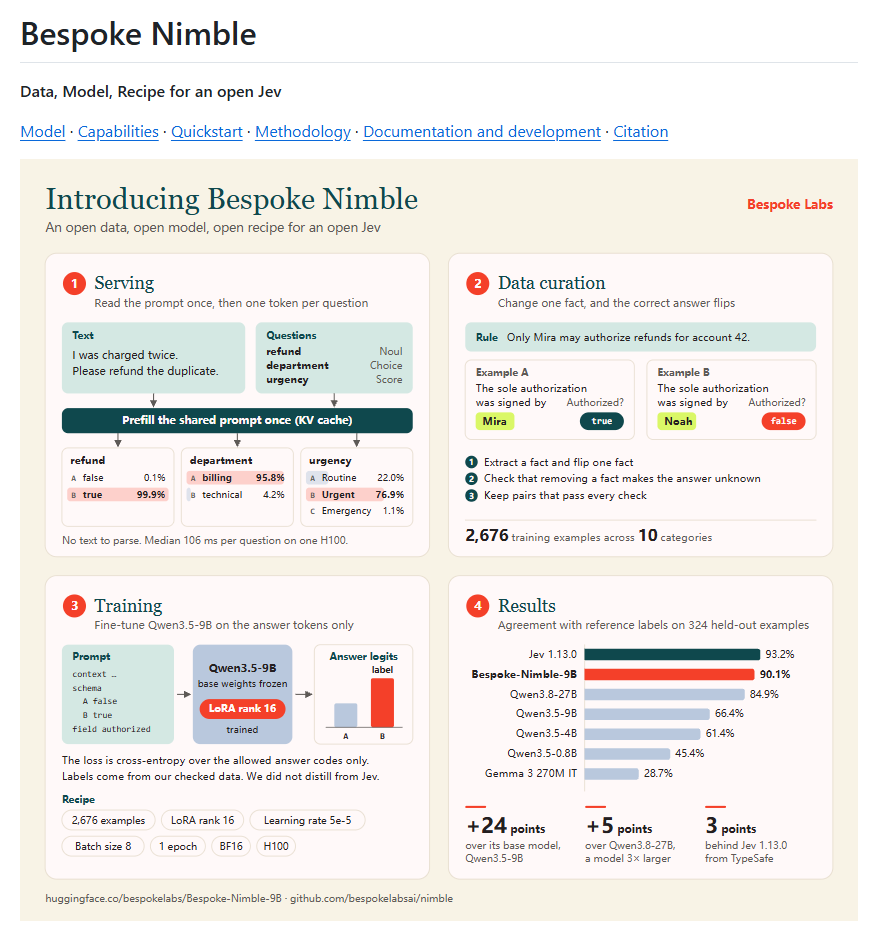
第三个流派主打轻量包装与边缘交互。比如开源项目 SemIf(原 OpenJev) 用最极简的代码把这种单次前向封装成了 Python 原生的语义 if 分支语句;而 jev-visual 则把 0.8B 的轻量决策模型塞进 3D 虚拟环境,让游戏里的 NPC 摆脱笨重的预设脚本,纯靠毫秒级概率快速反应。
商业闭源的 Jev 与开源社区的三大流派在同一赛道上的全面爆发,正好印证了一个趋势,在生成大模型卷到瓶颈的时候,业界都在不谋而合地把目光转向这种低延迟、高可靠的「系统一反射决策」。
04 Jev的十大决策形态与九类失灵场景
官方在用例指南中将这种能力提炼成了十大基础决策形态,包括分类、欺诈与异常探测、量规打分、工具路由、上下文检索初筛、搜索重排序、大模型输出防幻觉验证、以及为下游传统风控模型提取语义特征。
在具体的工程落地上,官方提供了一个标准的工单智能仲裁流水线范本:
bash
from typesafe_sdk import TypeSafeClient, Choice, Noul, Score
# 1. 确定性状态直接走代码处理,绝不浪费算力调用模型
if ticket["status"] == "closed":
    return "no_action"
# 2. 状态精炼:只提取问题判断必需的结构化字段
state = {
    "message": ticket["message"],
    "plan": customer["plan"],
    "open_orders": [o for o in customer["orders"] if o["status"] != "delivered"]
}
# 3. 结构化打包:同一次前向并发完成多项判定(推测性扇出)
questions = {
    "topic": Choice(
        instructions="该消息应由哪个团队处理?",
        criteria={
            "billing": "账单、扣费、退款或订阅争议",
            "orders": "订单状态、物流、取消或退货"
        }
    ),
    "refund_requested": Noul(instructions="用户是否明确要求退款或赔偿?"),
    "frustration": Score(
        instructions="用户情绪表现如何?",
        criteria=["平静客观", "烦躁但克制", "极度愤怒或威胁流失"]
    )
}
# 4. 单次并发调用并由代码主导后续分支与门控
response = client.system_one(state=state, questions=questions)
answers = response.answers
# 5. 置信度门控:不确定时不盲猜,直接转交人工复核
if answers["topic"].confidence < 0.75:
    return route_to_human_review(ticket)
# 6. 代码利用并发返回的答案直接走下游逻辑
if answers["topic"].choice == "billing":
    return route_to_billing(ticket, refund_requested=answers["refund_requested"].noul >= 0.7)
但别把它当成万能钥匙。官方在文档里专门列了 9 种会翻车的失灵场景,写得非常坦诚:
-
只认死理(字面化解读),你说什么它听什么,不会猜你心里真正想要啥。规则必须写得清清楚楚。
-
别让它做算术,比大小、算加减、数列表中有几个元素,老老实实用代码算,Jev 绝不是计算器。
-
日期比先后会迷糊,涉及先后顺序的时间比较容易翻车,必须遵循「提取拆件归模型,计算归代码」,把提取出的月份、年份交由程序算时间差。
-
多层逻辑绕不过来,A 决定 B、B 决定 C 这种多级跳转,判断很容易断层。
-
上下文塞太满会眼花,无关细节放太多充当干扰器,反而会干扰核心信息的判断。
-
默认不防对抗攻击,如果用户输入的文本里藏着恶意诱导,它容易被带偏。
-
规则和问题打架时会装聋,你的提问和设定的评估标准有冲突,它会悄悄偏向一边,不会主动报错。
-
概率加起来未必符合常识,对同一件事换个反向问法,两个概率加起来不一定严格等于 1。
-
它真的不会写字,需要生成完整句子、写代码或长篇大论,必须找正经的生成大模型。
高风险的操作(比如删库、打款),绝对不能全权交给它自动做主,代码里必须卡好置信度阈值,该让人工复核的就得转人工。
05 Jev 创始人眼中的下一代 Agent 架构
在推出 Jev 后,面对社区关于「为什么不顺手做一个 Coding Agent」的追问,TypeSafe 联合创始人 Diogo Almeida 专门公开了一篇内部设计备忘录,直白地给出了他对当前智能体架构的底层反思。
他认为,目前的编程智能体普遍陷入了「KV Cache 的暴政」。为了贪图复用服务端的上下文缓存,现有的 Agent 框架被迫把工具调用、终端输出、对话记录硬拼成一条不断延展的单向长链。会话一旦变长,就只能依赖粗暴的上下文压缩(Compaction)或者重启会话,而这往往会把最关键的系统规则和上下文冲淡。
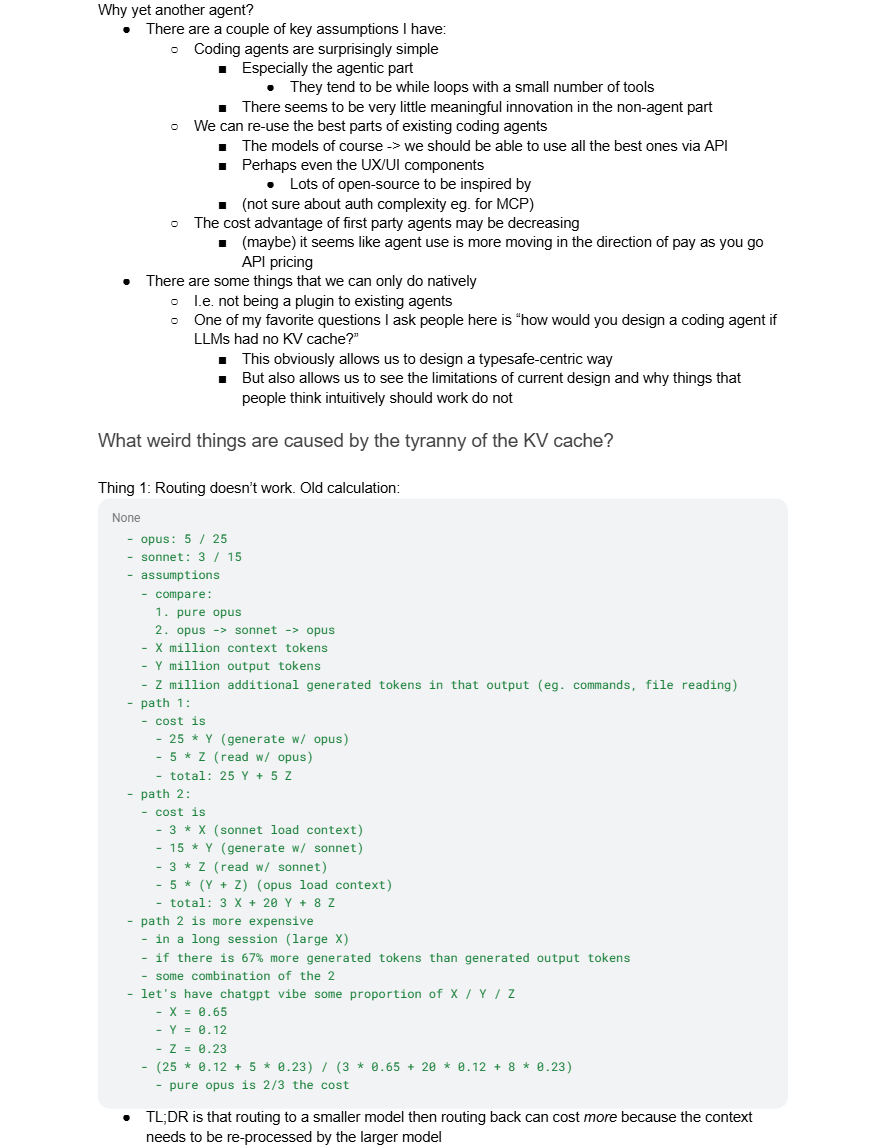
很多人试图在框架里引入「大模型与小模型混合路由」来省钱,但 Almeida 算了一笔反直觉的账。把子任务切给小模型处理、再切回顶级大模型,大模型必须把前面几十万字的历史全量重新计算一遍。在这种长会话场景下,反复破坏连续缓存带来的重复预填充成本,反而让总账单比自始至终纯用大模型贵出 30% 到 50%。
在 Almeida 看来,像 Jev 这样的系统一模型,未来在 Agent 内部可以充当全新的「动态元注意力(Meta-Attention)」组件:
-
上下文不再按时间机械堆积,每一轮由 Jev 在几十毫秒内对历史碎片进行相关性扫描,按需装配当前任务专属的上下文;
-
改变开局在系统提示词里塞满几千行规范的习惯,转为按条件动态挂载规则。改前端就即时挂载前端规范,进子目录就即时挂载该目录的避坑备忘,任务结束自动卸载,既防注意力稀释,又免疫压缩丢失;
-
在命令执行前直接由模型对脚本代码做安全打分,毫秒级实现可编程的权限分级门控。
06 怎么接入,官方托管与开源自建两条路线
现在想在工程中使用这类决策模型,主要有两条路线:
第一条路线,使用 TypeSafe Jev 官方托管服务
-
官方接入通道,在 TypeSafe 官网申请测试资格。
-
托管路由网关,走 Vercel AI Gateway 接入,模型填
typesafe-ai/jev。 -
第三方聚合平台,走 OpenRouter 接入,模型填
typesafe/jev-1.13。 -
计费与配额标准,输入每百万 Token 0.042 美元,输出 Token 永久免费;单请求上下文支持 64k Tokens,每分钟最高 1,200 次请求。
中文落地有个大坑。官方 Jev 的训练主力是英文,官方也承认中文等 CJK 语言的表现不如英文。开源社区在实测中发现,单语英文模型在处理非拉丁字符时,即使准确率跌到随机猜测的水平,自报的置信度依然可能在 0.95 以上。如果要做中文业务,要么在前置加上语言检测分流,换用支持多语言的模型(比如 Laya-multilingual),要么一定要在本地用真实的中文数据跑充分的核验,别直接拿英文单语模型裸跑。
第二条路线,使用开源自建模型(支持离线、多语言与长文档) 如果业务涉及敏感数据、有离线部署需求,或者需要处理多语言(特别是中文),开源社区现在提供了更自由的选型:
-
轻量极速与多语言,直接通过 pip 安装 Laya(
pip install laya),单 GPU 仅 32 毫秒,内置 100+ 语言路由; -
超长文档与高精度,可以选用基于 Qwen3.5-4B 改造的
wayfind/metask-jev-4b-policy-mix,单次前向约 24 毫秒,支持数千至上万 Token 的长政策文本审核。
真要把这类模型接进自己的业务代码,更稳妥的做法是分两步来试:
第一阶段,先在官方的调试界面(Playground)或本地 Demo 里粘几条真实的数据,比如真实的报错日志、客服聊天记录或者用户表单,先看看它在具体问题上的打分到底准不准。
第二阶段,挑一个业务代码里写得最长、维护起来最头疼的条件分支,接入模型先跑影子测试。让它跟着现有代码一起运行,默默记录它的打分和置信度,不直接干扰线上业务。连续观察一段时间,确认准确率没问题之后,再正式交给它执行。
还有个成本提醒。虽然单次判断便宜得像白送,但如果你在整个业务流程里串了几十上百个判断题,高并发跑起来累加的账单也不会太低。哪些该拆、哪些没必要问,在设计时要想清楚。
07 写在最后
Jev 和 Laya 的思路其实挺清晰。
这两年大家都在卷更大的参数、更长的生成、更深度的推理链。结果就是很多本来点一下头、摇一下头就能搞定的简单分类,也被迫塞给庞大笨重的生成大模型,又慢又贵。
它们把「写字」这件事砍掉,把所有力气花在单次前向的概率校准上,让判断重回毫秒级响应和确定性。
以后的系统架构里,生成大模型去负责写长文、搞复杂的开放式推理,轻量判别模型站在最前面管流量分流和逻辑分支,各干各最擅长的事,才是真正省钱省心的工程打法。
[1] https://x.com/CompleteSkeptic/status/2099925682726002904[2] https://typesafe.ai/blog/introducing-system-one-models-and-jev[3] https://docs.typesafe.ai[4] https://github.com/NandhaKishorM/laya[5] https://laya.convaiinnovations.com/[6] https://huggingface.co/wayfind/metask-jev-4b-policy-mix[7] https://github.com/bespokelabsai/nimble[8] https://github.com/TheoLeeCJ/openjev[9] https://github.com/hr98w/jev-visual[10] https://docs.google.com/document/d/1G61uUB0FifUnmmrPzFQojZ3KpczYKmXGpgEXDJ2l_Zg/edit?tab=t.0[11] https://openrouter.ai/models/typesafe/jev-1.13参考文献: