视觉 Mamba:RNN 与线性 Transformer 的统一视角 \textcolor{#A83471}{\textbf{视觉 Mamba:RNN 与线性 Transformer 的统一视角}} 视觉 Mamba:RNN 与线性 Transformer 的统一视角
论文:RNN as Linear Transformer: A Closer Investigation into Representational Potentials of Visual Mamba Models
作者:Timing Yang、Feng Wang、Guoyizhe Wei,Johns Hopkins University;CVPR 2026。
本文将正文与附录的理论、实验和实现细节合并介绍。标为"阅读理解"或"公式核查"的段落是基于原文的解读;其余结论均对应原论文。配图沿用原论文编号。
一、这篇工作整体做了什么? \textcolor{#A85E5C}{\textbf{一、这篇工作整体做了什么?}} 一、这篇工作整体做了什么?
这篇论文研究的是一个比分类准确率更基础的问题:视觉 Mamba 在 线性复杂度 \textcolor{#A83471}{\textbf{线性复杂度}} 线性复杂度的约束下处理图像时,究竟能够建立怎样的全局表征?它与 Softmax Attention、Linear Attention 的表达能力有何关系?
作者从三个层面展开:把三类 token mixer 写成统一的矩阵变换,通过分块矩阵的秩讨论表达约束;提出 Binary-AUC,用前景与背景的区分程度量化特征图;将视觉 Mamba 放入 DINO 自监督框架,结合可视化、线性探测、分割、检测和分布偏移实验检验表征质量。在作者的解释中,Mamba 扮演 Softmax Attention 的低秩近似,在效率与表征能力之间折中。论文报告它的表现通常介于 Softmax Attention 与所测试的 Linear Attention 之间,并展示了自监督训练、register token 和特征读出方式的影响。
理论、特征与任务相互印证 \textcolor{#5397A4}{\textbf{理论、特征与任务相互印证}} 理论、特征与任务相互印证是这项工作的重点:把"模型关注哪里""表征能够区分什么"和"下游任务表现如何"放到一起研究。其中,作者提出的严格秩层级需要结合后文的公式核查理解。
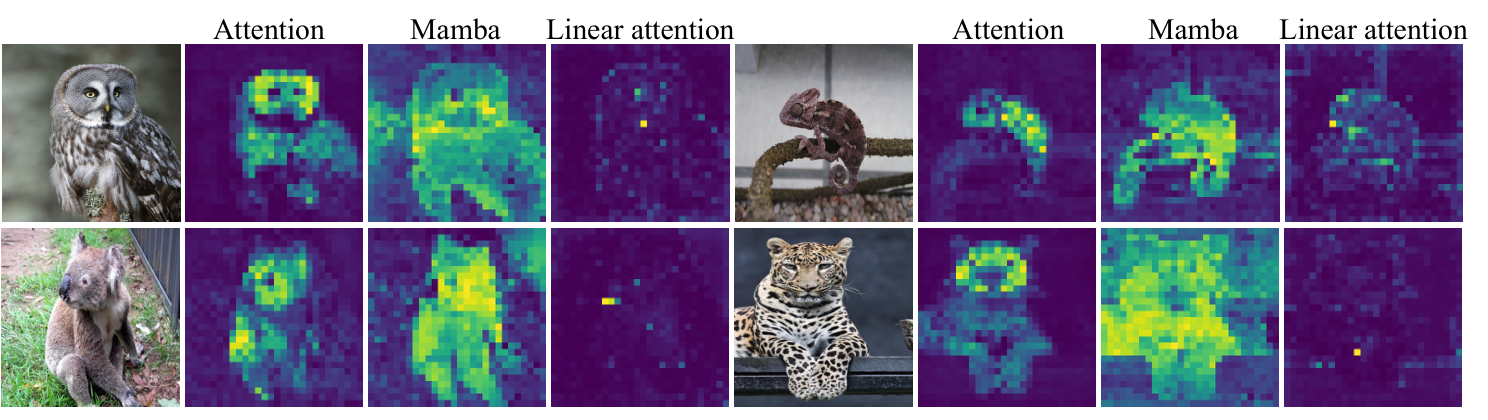
正文图 1:Self-Attention 的目标与背景通常分得最清楚;Mamba 能呈现类似的全局结构,但背景噪声更多;Linear Attention 在这些样例中较难突出目标区域。
二、动机:效率之外,表达什么? \textcolor{#A85E5C}{\textbf{二、动机:效率之外,表达什么?}} 二、动机:效率之外,表达什么?
2.1 效率与表达能力 \textcolor{#497797}{\textbf{2.1 效率与表达能力}} 2.1 效率与表达能力
论文首先提出视觉建模中的基本矛盾:Transformer 能建模全局依赖,但 attention 的时间与存储开销随序列长度二次增长,给高分辨率图像带来负担。Mamba 通过选择性状态空间模型与高效扫描,为长序列处理提供了另一条路径。
问题随之而来:图像被转换为 patch 序列之后,Mamba 依靠有限维状态递推传递信息。这种全局信息传递,与 attention 对不同图像区域的直接交互,在表达上有何差别?
已有视觉 Mamba 工作主要探索双向扫描、多方向扫描、register token 等架构设计;论文希望进一步解释这些模型学到了什么。
2.2 为什么统一 token mixer? \textcolor{#497797}{\textbf{2.2 为什么统一 token mixer?}} 2.2 为什么统一 token mixer?
论文回顾了从门控、遗忘机制、attention 重写以及秩增强等角度理解 Mamba 的研究。作者希望在统一的 token-mixing 表达下,把 Mamba、Softmax Attention 和 Linear Attention 直接放在一起比较。
其切入点是:将一次 token 混合写成矩阵作用后, 不同机制允许怎样的跨 token 交互结构? \textcolor{#5397A4}{\textbf{不同机制允许怎样的跨 token 交互结构?}} 不同机制允许怎样的跨 token 交互结构?作者选择矩阵秩,尤其是跨块子矩阵的秩,作为分析线索。
题目里的 RNN,具体对应本文讨论的 SSM 型递推;"看作线性 Transformer"发生在这个递推的矩阵展开与 token-mixing 表达层面。
2.3 从可视化到定量评价 \textcolor{#497797}{\textbf{2.3 从可视化到定量评价}} 2.3 从可视化到定量评价
图 1 给出了直观现象:三类模型都处理整幅图像,但突出目标、抑制背景和刻画区域差异的能力并不相同。
不过,论文中的逻辑并不止于"看起来更清楚"。作者进一步引入带分割标注的图像,将特征图与真实前景、背景对应起来,使用 ROC-AUC 进行量化。这样,同一个工具就能比较训练方式、模型规模、attention head、register 位置和网络深度。
2.4 为什么选择 DINO? \textcolor{#497797}{\textbf{2.4 为什么选择 DINO?}} 2.4 为什么选择 DINO?
作者选择 DINO,是因为这一自监督框架能够产生较清晰、便于解释的视觉特征图。随后,论文又比较监督训练与自监督训练,并将预训练表征迁移到下游任务。
完整的研究链条因此是:
- 高分辨率视觉任务需要高效的全局建模。
- Mamba 提供线性序列处理,但其视觉表达机制仍需解释。
- 统一 token-mixing 矩阵,用跨块秩分析表达约束。
- 用 DINO 特征图观察实际学到的表示。
- 用 Binary-AUC 将视觉观察转为定量比较。
- 用读出消融和下游任务检验这些表征差异的实际意义。
三、方法:统一表达、评价与训练 \textcolor{#A85E5C}{\textbf{三、方法:统一表达、评价与训练}} 三、方法:统一表达、评价与训练
3.1 三类 token mixer 的统一表达 \textcolor{#497797}{\textbf{3.1 三类 token mixer 的统一表达}} 3.1 三类 token mixer 的统一表达
Softmax Attention:基本形式 \textcolor{#A7825B}{\textbf{Softmax Attention:基本形式}} Softmax Attention:基本形式
给定长度为 L L L 的输入序列:
X ∈ R L × d m o d e l , X\in\mathbb{R}^{L\times d_{\mathrm{model}}}, X∈RL×dmodel,
查询、键和值为:
Q = X W Q , K = X W K , V = X W V . Q=XW_Q,\qquad K=XW_K,\qquad V=XW_V. Q=XWQ,K=XWK,V=XWV.
其中 Q , K ∈ R L × D Q K Q,K\in\mathbb{R}^{L\times D_{QK}} Q,K∈RL×DQK, V ∈ R L × J V\in\mathbb{R}^{L\times J} V∈RL×J。输出为:
Y = softmax ( Q K ⊤ D Q K ) V . Y= \operatorname{softmax}\left( \frac{QK^\top}{\sqrt{D_{QK}}} \right)V. Y=softmax(DQK QK⊤)V.
这里的 softmax 沿相似度矩阵的行进行归一化。虽然 Q K ⊤ QK^\top QK⊤ 的秩受 D Q K D_{QK} DQK 限制,经过非线性的 softmax 后,输出权重矩阵可以获得更高的秩。
Linear Attention:因式分解 \textcolor{#A7825B}{\textbf{Linear Attention:因式分解}} Linear Attention:因式分解
按论文的简化表达,Linear Attention 为:
Y = ( ϕ ( Q ) ϕ ( K ) ⊤ ) V . Y=\bigl(\phi(Q)\phi(K)^\top\bigr)V. Y=(ϕ(Q)ϕ(K)⊤)V.
其计算可以利用矩阵乘法的结合律:
Y = ϕ ( Q ) ( ϕ ( K ) ⊤ V ) . Y=\phi(Q)\bigl(\phi(K)^\top V\bigr). Y=ϕ(Q)(ϕ(K)⊤V).
在特征维度固定时,这使计算量对序列长度保持线性。论文的 LinearViT 基线具体采用:
ϕ ( Q ) = softmax ( Q ) , ϕ ( K ) = softmax ( K ) . \phi(Q)=\operatorname{softmax}(Q),\qquad \phi(K)=\operatorname{softmax}(K). ϕ(Q)=softmax(Q),ϕ(K)=softmax(K).
也就是说,Q 和 K 分别经过 softmax,再相乘。附录说明,这个基线保留 ViT-B 的其他组件:模型维度、层数、head 数和参数量相同,并使用相同的 DINO 预训练流程。
为进行因果形式的理论比较,论文引入下三角掩码:
( L A t t n ) i j = { 1 , i ≥ j , 0 , i < j . (L_{\mathrm{Attn}})_{ij}= \begin{cases} 1,&i\ge j,\\ 0,&i<j. \end{cases} (LAttn)ij={1,0,i≥j,i<j.
于是:
Y = L A t t n ⊙ ( ϕ ( Q ) ϕ ( K ) ⊤ ) V , Y=\left L_{\\mathrm{Attn}}\\odot \\bigl(\\phi(Q)\\phi(K)\^\\top\\bigr) \\rightV, Y=LAttn⊙(ϕ(Q)ϕ(K)⊤)V,
其中 ⊙ \odot ⊙ 表示逐元素乘积。
Mamba:递推的矩阵展开 \textcolor{#A7825B}{\textbf{Mamba:递推的矩阵展开}} Mamba:递推的矩阵展开
对单个输入通道,SSM 的递推形式为:
h t = A t h t − 1 + B t x t , y t = C t ⊤ h t . h_t=A_th_{t-1}+B_tx_t,\qquad y_t=C_t^\top h_t. ht=Atht−1+Btxt,yt=Ct⊤ht.
这里 h t , B t , C t ∈ R N h_t,B_t,C_t\in\mathbb{R}^{N} ht,Bt,Ct∈RN, N N N 是状态维度。以 t = 1 t=1 t=1 为起点、初始状态为零,将递推展开:
h t = ∑ j = 1 t A t A t − 1 ⋯ A j + 1 B j x j , h_t= \sum_{j=1}^{t} A_tA_{t-1}\cdots A_{j+1}B_jx_j, ht=j=1∑tAtAt−1⋯Aj+1Bjxj,
y t = ∑ j = 1 t C t ⊤ A t A t − 1 ⋯ A j + 1 B j x j . y_t= \sum_{j=1}^{t} C_t^\top A_tA_{t-1}\cdots A_{j+1}B_jx_j. yt=j=1∑tCt⊤AtAt−1⋯Aj+1Bjxj.
空乘积取为恒等变换。论文随后采用 Mamba-2 的标量状态转移形式,将输出写为:
Y = M X , Y=MX, Y=MX,
M i j = { C i ⊤ B j ∏ k = j + 1 i A k , i ≥ j , 0 , i < j . M_{ij}= \begin{cases} C_i^\top B_j\displaystyle\prod_{k=j+1}^{i}A_k, &i\ge j,\\ 0,&i<j. \end{cases} Mij=⎩ ⎨ ⎧Ci⊤Bjk=j+1∏iAk,0,i≥j,i<j.
定义:
( L M ) i j = { ∏ k = j + 1 i A k , i ≥ j , 0 , i < j , G i j = C i ⊤ B j , (L_M){ij}= \begin{cases} \displaystyle\prod{k=j+1}^{i}A_k,&i\ge j,\\ 0,&i<j, \end{cases} \qquad G_{ij}=C_i^\top B_j, (LM)ij=⎩ ⎨ ⎧k=j+1∏iAk,0,i≥j,i<j,Gij=Ci⊤Bj,
就得到:
M = L M ⊙ G . M=L_M\odot G. M=LM⊙G.
将 B j B_j Bj、 C i C_i Ci 分别按列堆叠为 B , C ∈ R N × L \mathcal B,\mathcal C\in\mathbb{R}^{N\times L} B,C∈RN×L,则 G = C ⊤ B G=\mathcal C^\top\mathcal B G=C⊤B,对应原文的 C ⊤ B C^\top B C⊤B 写法。
这个表达把两个因素分开了: G G G 描述状态写入与读取之间的联系, L M L_M LM 描述信息经过状态转移后如何影响后续位置。
为统一记号,将 attention 的值序列或 SSM 的输入序列记为 Z Z Z,三者都可写成 Y = M Z Y=MZ Y=MZ:
| Token mixer | 原文比较的有效混合矩阵 |
|---|---|
| Softmax Attention | L A t t n ⊙ softmax ( Q K ⊤ ) L_{\mathrm{Attn}}\odot\operatorname{softmax}(QK^\top) LAttn⊙softmax(QK⊤) |
| Linear Attention | L A t t n ⊙ ( ϕ ( Q ) ϕ ( K ) ⊤ ) L_{\mathrm{Attn}}\odot\bigl(\phi(Q)\phi(K)^\top\bigr) LAttn⊙(ϕ(Q)ϕ(K)⊤) |
| Mamba | L M ⊙ ( C ⊤ B ) L_M\odot(\mathcal C^\top\mathcal B) LM⊙(C⊤B) |
表中 softmax 表达沿用论文统一式,省略了缩放项。这些矩阵是给定输入下的有效 token 混合权重;相关参数或权重可以依赖输入。以下秩分析针对单个 head 的因果混合形式;后文的视觉 Mamba 实验使用双向扫描,理论子矩阵与完整视觉骨干属于不同层级的分析对象。
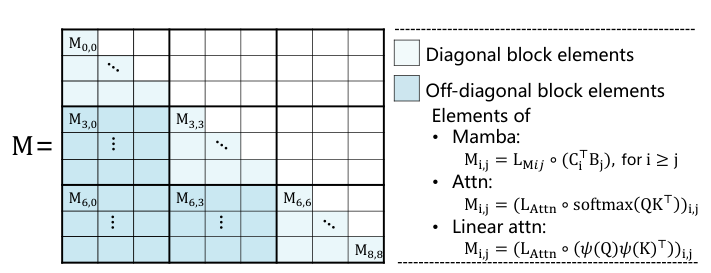
正文图 2:对角块对应块内交互;严格位于对角线下方的非对角块对应跨块交互。
3.2 跨块矩阵的秩分析 \textcolor{#497797}{\textbf{3.2 跨块矩阵的秩分析}} 3.2 跨块矩阵的秩分析
论文将 M M M 划分为方形子矩阵,按单个 head 分析。下面用 b b b 表示原文的分块长度 C C C,以区别于状态读取向量 C t C_t Ct。
对角块本身是下三角矩阵。在对角元素非零的条件下,其秩为 b b b。因此,三类机制的整体矩阵都可能是满秩的,仅比较全矩阵秩并不能揭示作者关心的差异。
关键是非对角块:较早的一组 token,如何影响较晚的一组 token?
正文和附录使用两个矩阵秩性质:
rank ( A ⊙ B ) ≤ rank ( A ) rank ( B ) , \operatorname{rank}(A\odot B) \le \operatorname{rank}(A)\operatorname{rank}(B), rank(A⊙B)≤rank(A)rank(B),
rank ( A B ) ≤ min { rank ( A ) , rank ( B ) } . \operatorname{rank}(AB) \le \min\{\operatorname{rank}(A),\operatorname{rank}(B)\}. rank(AB)≤min{rank(A),rank(B)}.
第一条性质可以从低秩分解理解。若:
A = ∑ u = 1 r A p u q u ⊤ , B = ∑ v = 1 r B s v t v ⊤ , A=\sum_{u=1}^{r_A}p_uq_u^\top,\qquad B=\sum_{v=1}^{r_B}s_vt_v^\top, A=u=1∑rApuqu⊤,B=v=1∑rBsvtv⊤,
则:
A ⊙ B = ∑ u = 1 r A ∑ v = 1 r B ( p u ⊙ s v ) ( q u ⊙ t v ) ⊤ . A\odot B= \sum_{u=1}^{r_A}\sum_{v=1}^{r_B} (p_u\odot s_v)(q_u\odot t_v)^\top. A⊙B=u=1∑rAv=1∑rB(pu⊙sv)(qu⊙tv)⊤.
它由至多 r A r B r_Ar_B rArB 个秩一矩阵相加而成。第二条性质则说明,矩阵乘法不会突破中间表示的维度约束。附录 G 的证明分别考察两侧:B 的列空间经过 A 映射后,维度不会增加,因此秩不超过 B 的秩;再对乘积取转置,得到秩也不超过 A 的秩。两个上界共同给出上述结论。
对 Linear Attention,严格非对角块上的因果掩码全为一,秩为一,所以:
R L i n e a r o f f ≤ D Q K . R_{\mathrm{Linear}}^{\mathrm{off}}\le D_{QK}. RLinearoff≤DQK.
对 Mamba,作者给出的上界是:
R M a m b a o f f ≤ rank ( L M o f f ) N . R_{\mathrm{Mamba}}^{\mathrm{off}} \le \operatorname{rank}(L_M^{\mathrm{off}})\,N. RMambaoff≤rank(LMoff)N.
对 Softmax Attention,非线性变换使非对角块有可能达到其尺寸允许的满秩上界 b b b;具体输入并不保证每个块都满秩。
作者据此提出以下表达能力层级:
Softmax Attention > Mamba > Linear Attention . \text{Softmax Attention}> \text{Mamba}> \text{Linear Attention}. Softmax Attention>Mamba>Linear Attention.
原文以 b = 256 b=256 b=256、 N = D Q K = 64 N=D_{QK}=64 N=DQK=64 为例,认为可学习的 L M L_M LM 能提高跨块表达能力,并讨论扩大状态维度的计算代价:Mamba 的复杂度写为 O ( L N J ) O(LNJ) O(LNJ),Linear Attention 在其对应维度设定下写为 O ( L D Q K 2 ) O(LD_{QK}^{2}) O(LDQK2)。
这里,"低秩"讨论的是 token 维度上的跨块交互约束。附录 G 专门将它与 LoRA 等参数维度的低秩方法区分开来:参数低秩可以用于适配或正则化,而本文关注的是跨 token 信息交互的结构限制。附录还将高分辨率视觉任务中的依赖建模不足作为讨论背景;这是作者解释秩瓶颈的立场,具体表征质量仍需要实验判断。
公式核查:严格层级的条件 \textcolor{#A85E5C}{\textbf{公式核查:严格层级的条件}} 公式核查:严格层级的条件
以上是作者的分析,但按正文式(10)给出的标量 A k A_k Ak, L M L_M LM 的严格非对角块还具有更强的结构约束。
令 s s s 为两组 token 之间的分界,行位置满足 i > s i>s i>s,列位置满足 j ≤ s j\le s j≤s。直接拆分原文的乘积:
( L M ) i , j = ( ∏ k = s + 1 i A k ) ( ∏ k = j + 1 s A k ) = u i v j . (L_M){i,j}= \left(\prod{k=s+1}^{i}A_k\right) \left(\prod_{k=j+1}^{s}A_k\right) =u_iv_j. (LM)i,j=(k=s+1∏iAk) k=j+1∏sAk =uivj.
所以:
L M o f f = u v ⊤ , rank ( L M o f f ) ≤ 1. L_M^{\mathrm{off}}=uv^\top,\qquad \operatorname{rank}(L_M^{\mathrm{off}})\le 1. LMoff=uv⊤,rank(LMoff)≤1.
这意味着,在论文明确采用的标量状态转移形式下,跨块掩码的可学习性本身不能推出其秩大于一,相应地仍有:
R M a m b a o f f ≤ N . R_{\mathrm{Mamba}}^{\mathrm{off}}\le N. RMambaoff≤N.
当 N = D Q K N=D_{QK} N=DQK 时,仅凭这里的上界,不能证明 Mamba 严格高于 Linear Attention。上界之间的比较,也不自动构成实际秩或下游表现的严格排序。
因此,后文的 Mamba 优于所测 Linear Attention,应作为论文实验证据来理解;"可学习掩码提高跨块秩"这一严格解释,则在正文与附录给出的公式下存在论证缺口。这条备注只是核查原公式,不引入新的模型或实验结论。
3.3 Binary-AUC 如何评价特征? \textcolor{#497797}{\textbf{3.3 Binary-AUC 如何评价特征?}} 3.3 Binary-AUC 如何评价特征?
论文利用 CLS/register 与图像 token 的关系观察特征响应,并提出 Binary-AUC 评价其前景与背景区分能力。
对于大小为 H × W H\times W H×W、patch 边长为 N P N_P NP 的图像,特征图大小为:
( H N P , W N P ) . \left(\frac{H}{N_P},\frac{W}{N_P}\right). (NPH,NPW).
作者把真实分割标注中的多个类别合并为前景,将其他区域作为背景,再把标注调整到特征图的分辨率。设特征响应为 a ( i , j ) a(i,j) a(i,j),前景位置集合为 F F F,背景为 F ˉ \bar F Fˉ。
对阈值 t ∈ 0 , 1 t\in0,1 t∈0,1,预测激活区域为:
A t = { ( i , j ) : a ( i , j ) ≥ t } . A_t=\{(i,j):a(i,j)\ge t\}. At={(i,j):a(i,j)≥t}.
对应的真正率与假正率为:
TPR ( t ) = ∣ A t ∩ F ∣ ∣ F ∣ , FPR ( t ) = ∣ A t ∩ F ˉ ∣ ∣ F ˉ ∣ . \operatorname{TPR}(t)=\frac{|A_t\cap F|}{|F|}, \qquad \operatorname{FPR}(t)=\frac{|A_t\cap\bar F|}{|\bar F|}. TPR(t)=∣F∣∣At∩F∣,FPR(t)=∣Fˉ∣∣At∩Fˉ∣.
遍历阈值得到 ROC 曲线,按 FPR 递增的顺序,用梯形法计算:
AUC = ∑ k ( FPR k + 1 − FPR k ) TPR k + 1 + TPR k 2 . \operatorname{AUC}= \sum_k \bigl(\operatorname{FPR}{k+1}-\operatorname{FPR}{k}\bigr) \frac{\operatorname{TPR}{k+1}+\operatorname{TPR}{k}}{2}. AUC=k∑(FPRk+1−FPRk)2TPRk+1+TPRk.
原始 AUC 接近 1 1 1,表示高响应偏向前景;接近 0 0 0,表示高响应偏向背景; 0.5 0.5 0.5 对应缺乏前景、背景排序区分能力的基准。
论文进一步定义:
AUC n o r m a l i z e d = max { AUC , 1 − AUC } . \operatorname{AUC}_{\mathrm{normalized}} =\max\{\operatorname{AUC},1-\operatorname{AUC}\}. AUCnormalized=max{AUC,1−AUC}.
这个数值位于 0.5 , 1 0.5,1 0.5,1。其意义是:只要特征响应能够把前景与背景分开,即使响应方向相反,也可以获得高分。
因此,归一化 AUC 衡量的是区分能力;分析"模型究竟突出前景还是背景"时,还需要原始 AUC。论文的 register 位置和层深实验就保留了未归一化的分数。
附录 B 明确了评价数据:ImageNet-S 包含 919 个类别,作者仅使用其中的验证集,共 12,419 张带像素级语义标注的图像。多个语义类别在 Binary-AUC 中被合并为前景,所以该评价讨论的是目标与背景的分离。这里的分割标签用于评价已学到的特征,不参与 DINO 自监督预训练。
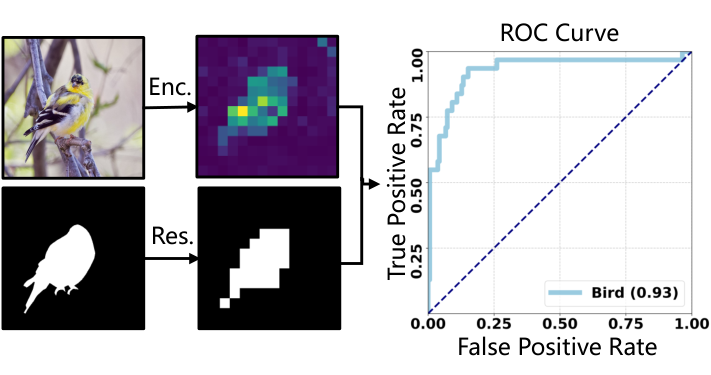
正文图 3:编码图像、对齐分割标注、扫描激活阈值,最后计算 ROC 曲线及 AUC。
阅读理解 \textcolor{#846784}{\textbf{阅读理解}} 阅读理解:这个指标把特征可视化变成了可比较的诊断工具。它反映前景与背景的响应差异;多类别语义、目标内部结构以及最终任务能力,则需要结合 PCA 与下游实验继续判断。
3.4 DINO 与视觉 Mamba \textcolor{#497797}{\textbf{3.4 DINO 与视觉 Mamba}} 3.4 DINO 与视觉 Mamba
论文沿用 DINO 的教师、学生框架:同一图像生成全局和局部裁剪,学生处理不同视图,教师提供全局视图的目标分布;教师参数由学生参数的指数移动平均更新。
教师输出经过 centering 与温度 softmax,并停止梯度传播。核心交叉熵为:
L = − P t ⊤ log P s , \mathcal L=-P_t^\top\log P_s, L=−Pt⊤logPs,
其中 P t P_t Pt、 P s P_s Ps 分别表示教师和学生的输出分布。
视觉骨干采用基于 Mamba-2 的双向扫描。图像被切成 patch、线性投影,并加入位置编码与 register token。以在第 m m m 个 patch 后插入一个 register R R R 为例,可将输入序列表示为:
T 0 = p 1 W ; ... ; p m W ; R ; p m + 1 W ; ... ; p L W + E p o s . T_0= p_1W;\\ldots;p_mW;R;p_{m+1}W;\\ldots;p_LW +E_{\mathrm{pos}}. T0=p1W;...;pmW;R;pm+1W;...;pLW+Epos.
这里 p j p_j pj 是展平后的 patch, W W W 为线性投影, E p o s E_{\mathrm{pos}} Epos 为位置编码;这个记号重排对应正文式(22)的 token 插入方式。附录 E 的架构图把这些组件放在同一个 DINO 流程中:
- Vim 对应在序列中间放置单个 CLS/register token。
- Mamba-Reg 插入多个 register token,便于比较不同位置的表征。
- 位置编码通过双三次插值适配不同输入大小,以支持 DINO 的多尺度裁剪。
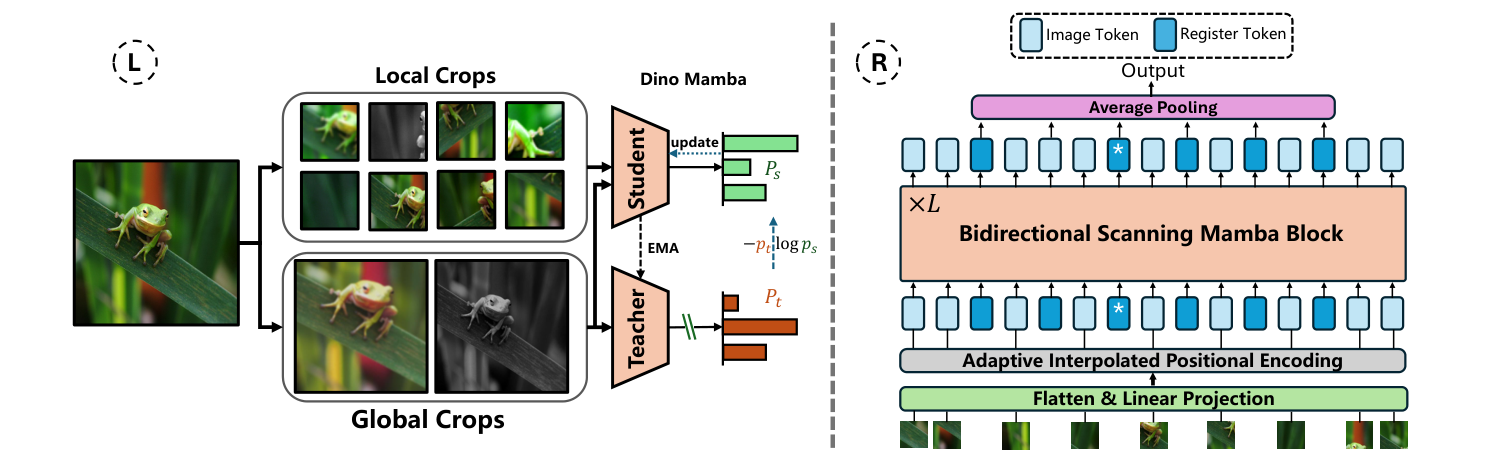
附录图 13:左侧为教师、学生自监督框架;右侧为 patch 投影、可插值位置编码、register token 和双向 Mamba block。*
正文与附录中的实现要点如下:
| 项目 | 论文设置 |
|---|---|
| 预训练数据 | ImageNet,约 1.28M 训练图像、50K 验证图像、1K 类别;使用 DINO 自监督预训练 |
| Mamba 规模 | Tiny、Small、Base 的模型维度分别为 256、512、768;均采用 24 层双向扫描 |
| LinearViT-B 对照 | 768 维、12 个 head、12 层、85M 参数;与 ViT-B 的差异集中于 token mixer |
| 多尺度输入 | 位置编码插值支持例如 224 × 224 224\times224 224×224 与 96 × 96 96\times96 96×96 的裁剪 |
| 预训练优化 | AdamW;总 batch size 为 1024,分布在 16 个 GPU 上;混合精度 BF16 |
| 学习率 | 前 10 个 epoch 预热,基础学习率按 0.0005 × b a t c h s i z e / 256 0.0005\times\mathrm{batchsize}/256 0.0005×batchsize/256 缩放,随后余弦衰减 |
| 权重衰减 | 按余弦计划从 0.04 增至 0.4 |
| 温度 | 教师从 0.04 在 30 个 epoch 内预热至 0.07;学生固定为 0.1 |
论文还说明了训练适配:梯度裁剪由 0.3 调至 3.0,启用 BF16,最低学习率由 2 × 10 − 6 2\times10^{-6} 2×10⁻⁶ 调至 10 − 6 10^{-6} 10−6,数据增强沿用 BYOL 的设置。附录 C 强调,预训练过程中采用已有标准架构,没有为这项研究额外加入新的计算模块。这里的主要变化是训练框架与训练配置。
四、核心实验与理解 \textcolor{#A85E5C}{\textbf{四、核心实验与理解}} 四、核心实验与理解
4.1 训练目标影响特征图 \textcolor{#497797}{\textbf{4.1 训练目标影响特征图}} 4.1 训练目标影响特征图
正文图 5 和附录图 11 对比了 ViT、Vim、Mamba-Reg 在监督训练与 DINO 自监督训练下的特征图。DINO 特征通常有更清楚的前景、背景区分,噪声更少;ViT 的图通常最干净,Mamba 在自监督设置下也能呈现较好的目标结构。
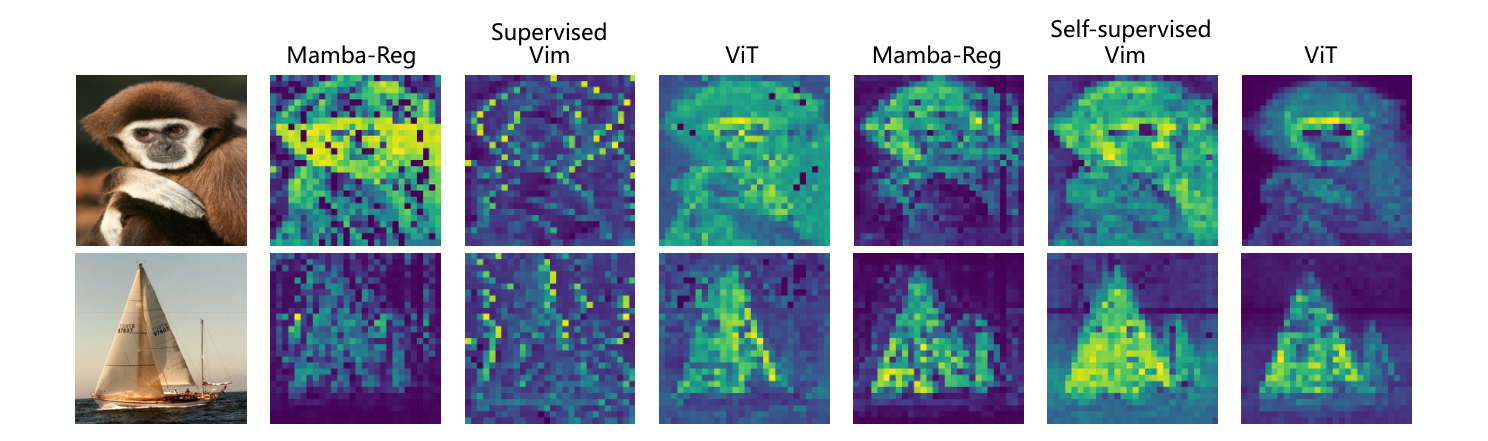
正文图 5:同一种骨干在不同训练范式下,可以表现出明显不同的激活结构。
附录图 11 补充了真实标注和 ROC 曲线,让"更清晰"的观察有对应的前景、背景排序依据。
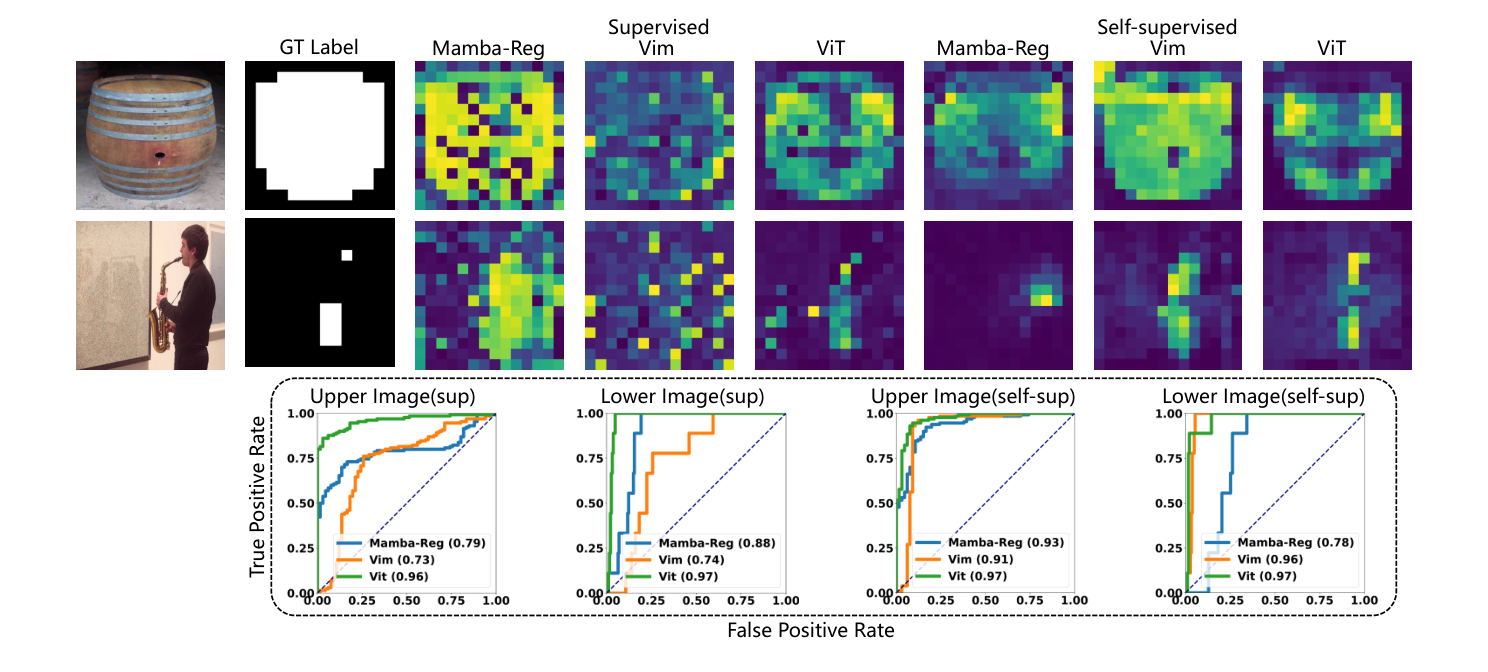
附录图 11:上方比较激活图,下方同时展示监督与自监督条件下的 ROC。*
这张附录图也说明,总体趋势需要与单例区分:下方样例的 Mamba-Reg,监督与自监督 AUC 分别为 0.88 和 0.78。论文关于 DINO 特征通常更清楚的结论,不要求每个模型在每张图像上的 AUC 都提高。
阅读理解 \textcolor{#846784}{\textbf{阅读理解}} 阅读理解:观察到某个模型的特征图不清晰时,需要同时考察其训练目标。这组实验说明,结构提供的表达空间与训练后实际形成的表征,需要一起讨论。
4.2 全局响应与区域分辨 \textcolor{#497797}{\textbf{4.2 全局响应与区域分辨}} 4.2 全局响应与区域分辨
正文图 6 与附录图 12 使用 PCA 展示特征空间。Self-Attention 较容易区分目标内部不同部分;Mamba 能呈现相关结构,但区域差异较模糊;Linear Attention 的区域分化较弱。
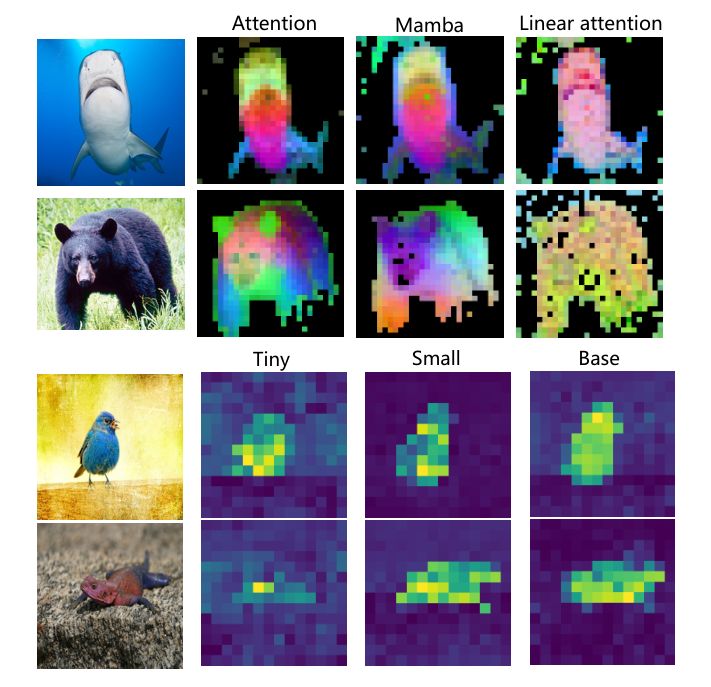
正文图 6:上半部分比较特征的区域分化;下半部分展示不同模型规模的响应。PCA 颜色表示特征差异,不是人工语义标签。
附录 D 与图 12 在一致阈值下补充了更多图像的 PCA 可视化。作者关注的是目标不同部分在特征空间中能否被区分:Self-Attention 的区域分化较明确,Mamba 稍模糊,Linear Attention 则更稀疏且较难分开目标内部部分。
附录图 12:附录中的补充例子覆盖了不同目标形态,用于观察各模型的区域信息分布。
附录图 10 又将特征图、真实前景标注和 ROC 放在一起,说明清晰度比较有相应的定量依据。
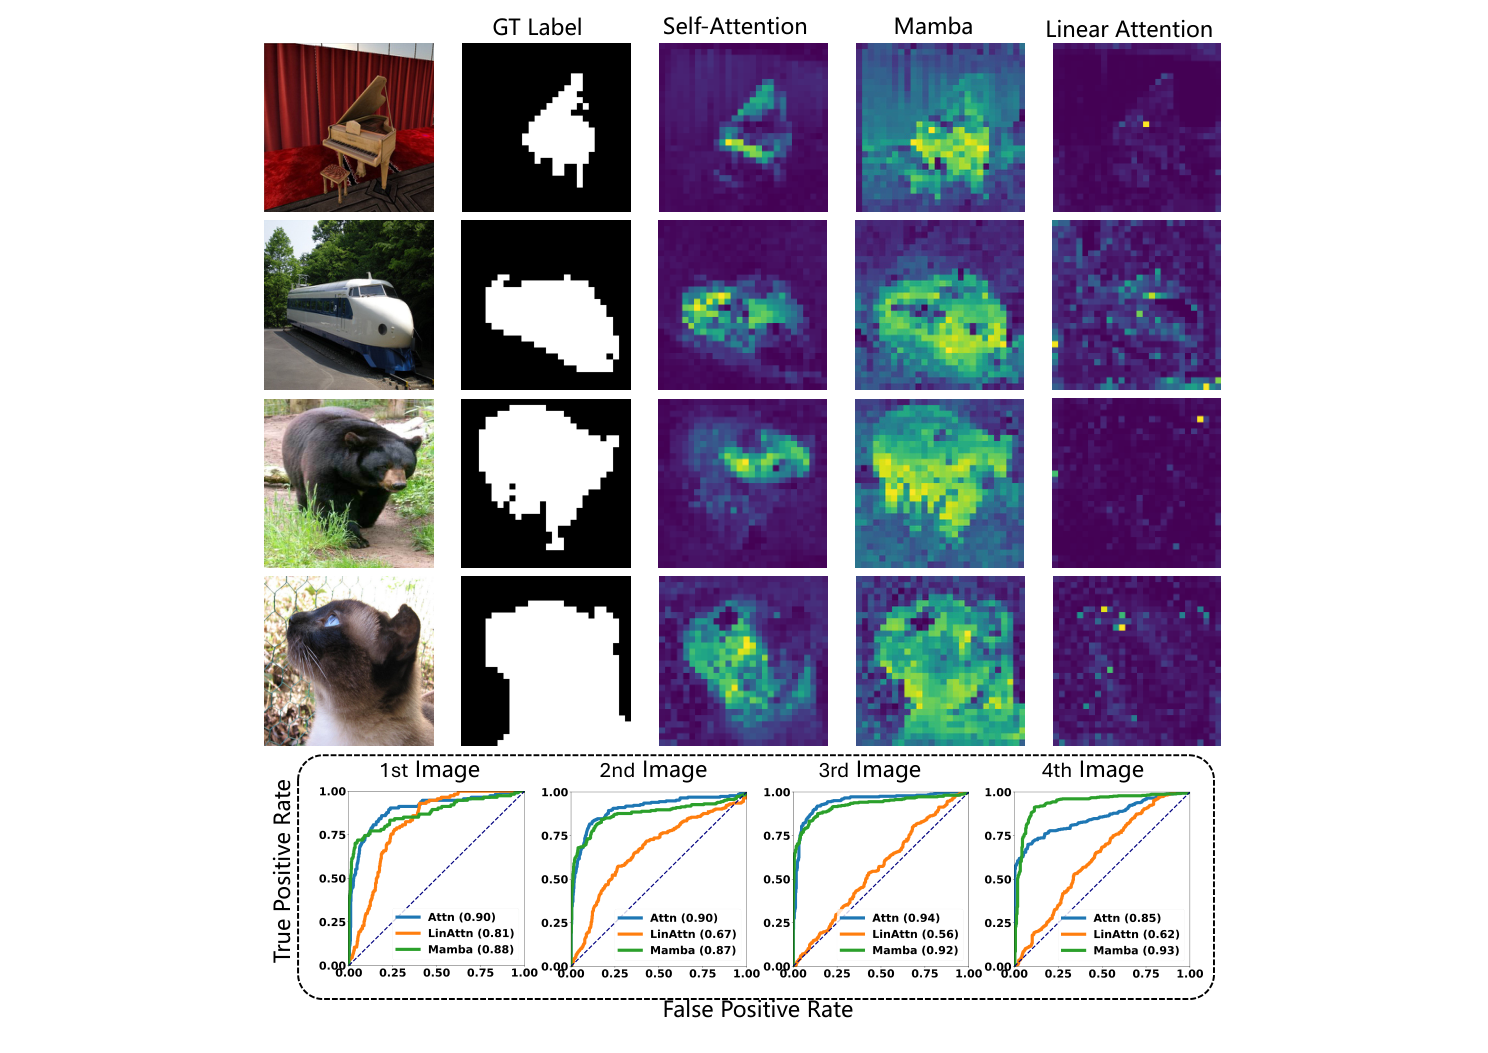
附录图 10:Mamba 能突出整体目标;Self-Attention 通常具有更清楚的区分;Linear Attention 在这些例子中的分离较弱。
阅读理解 \textcolor{#846784}{\textbf{阅读理解}} 阅读理解: 全局传递与精细区分 \textcolor{#A83471}{\textbf{全局传递与精细区分}} 全局传递与精细区分是两个层次。Mamba 在这些实验中展示了全局表征能力,但空间表征与 ViT 仍有差别。PCA 与 Binary-AUC 分别提供区域差异和前景、背景区分的观察,不能单独等同于混合矩阵秩的直接测量。
4.3 head、层深与 register \textcolor{#497797}{\textbf{4.3 head、层深与 register}} 4.3 head、层深与 register
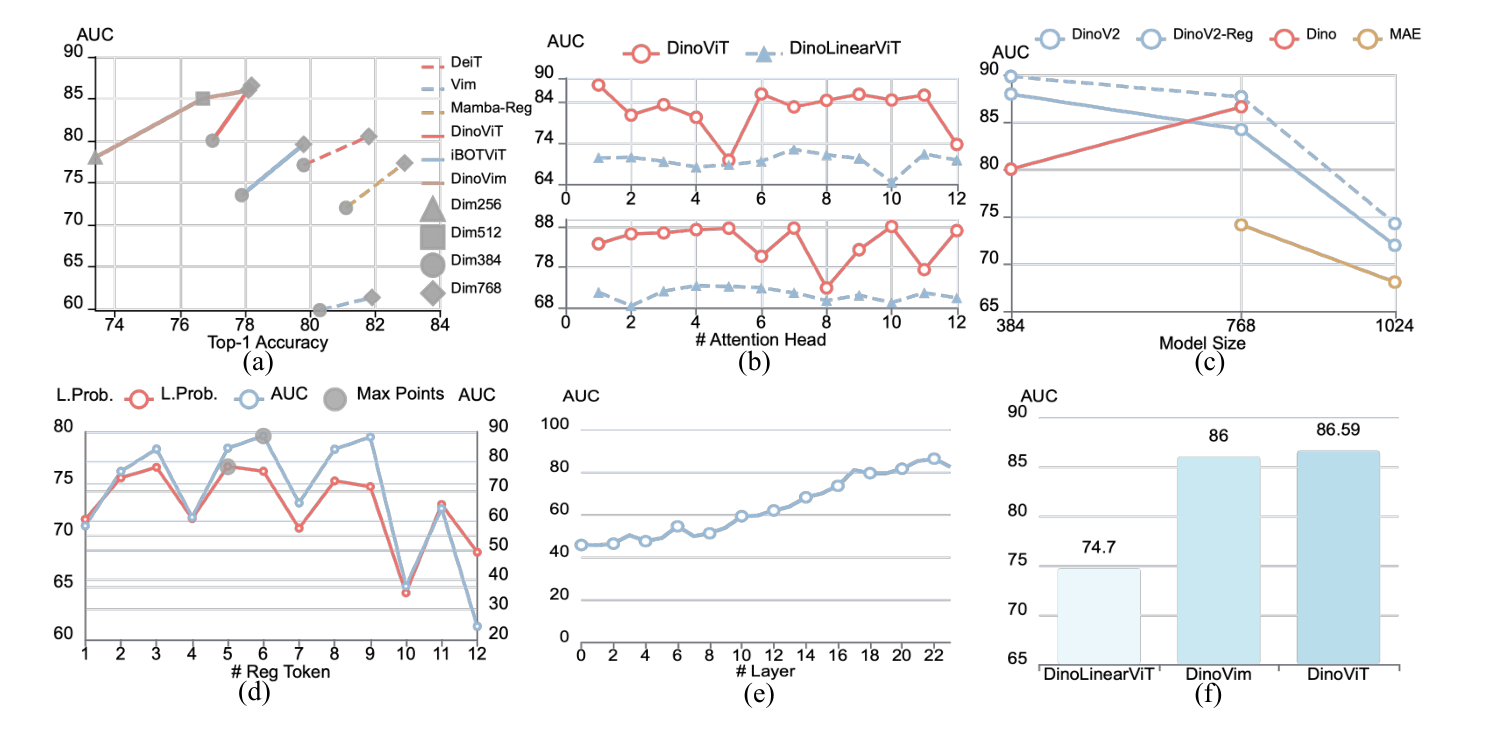
正文图 4:(a)训练方式与模型规模;(b)attention head;(c)DINOv2 与 register;(d)register 位置;(e)网络深度;(f)三类模型的总体比较。
不同 head 的贡献并不均衡。 \textcolor{#5397A4}{\textbf{不同 head 的贡献并不均衡。}} 不同 head 的贡献并不均衡。图 4(b)比较最后两层的 attention head:有些 head 的 AUC 较高,有些更低,作者称后者呈现"lazy behavior"。Linear Attention 的 head 分数整体较低。这说明,平均后的特征图可能掩盖内部组件的差异,AUC 可以用于定位这些差异。
层深改变了特征响应的方向。 \textcolor{#5397A4}{\textbf{层深改变了特征响应的方向。}} 层深改变了特征响应的方向。图 4(e)使用未归一化 AUC:较浅层的分数低于随机基准,更偏向背景;随着层数加深,响应逐渐转向目标。结合前文的归一化公式,这里应区分"突出背景"和"无法区分前景、背景"。
register 位置影响读出质量。 \textcolor{#5397A4}{\textbf{register 位置影响读出质量。}} register 位置影响读出质量。图 4(d)在序列中均匀放置 12 个 register token,比较各位置的 AUC 与线性探测准确率。中部位置通常更有利,两条曲线呈现相似的起伏,说明汇聚信息的位置会影响可读出的表征。
这些实验把 Binary-AUC 从骨干比较工具,进一步变成了观察内部组件的工具;论文结论也将它形容为分析模型的"听诊器"。
4.4 不同 register 的响应 \textcolor{#497797}{\textbf{4.4 不同 register 的响应}} 4.4 不同 register 的响应
附录图 7 展示了不同 register token 对应的特征图。不同位置的 register 会响应不同区域;即使位于较前位置的 register,也能感知图像中较远的目标。
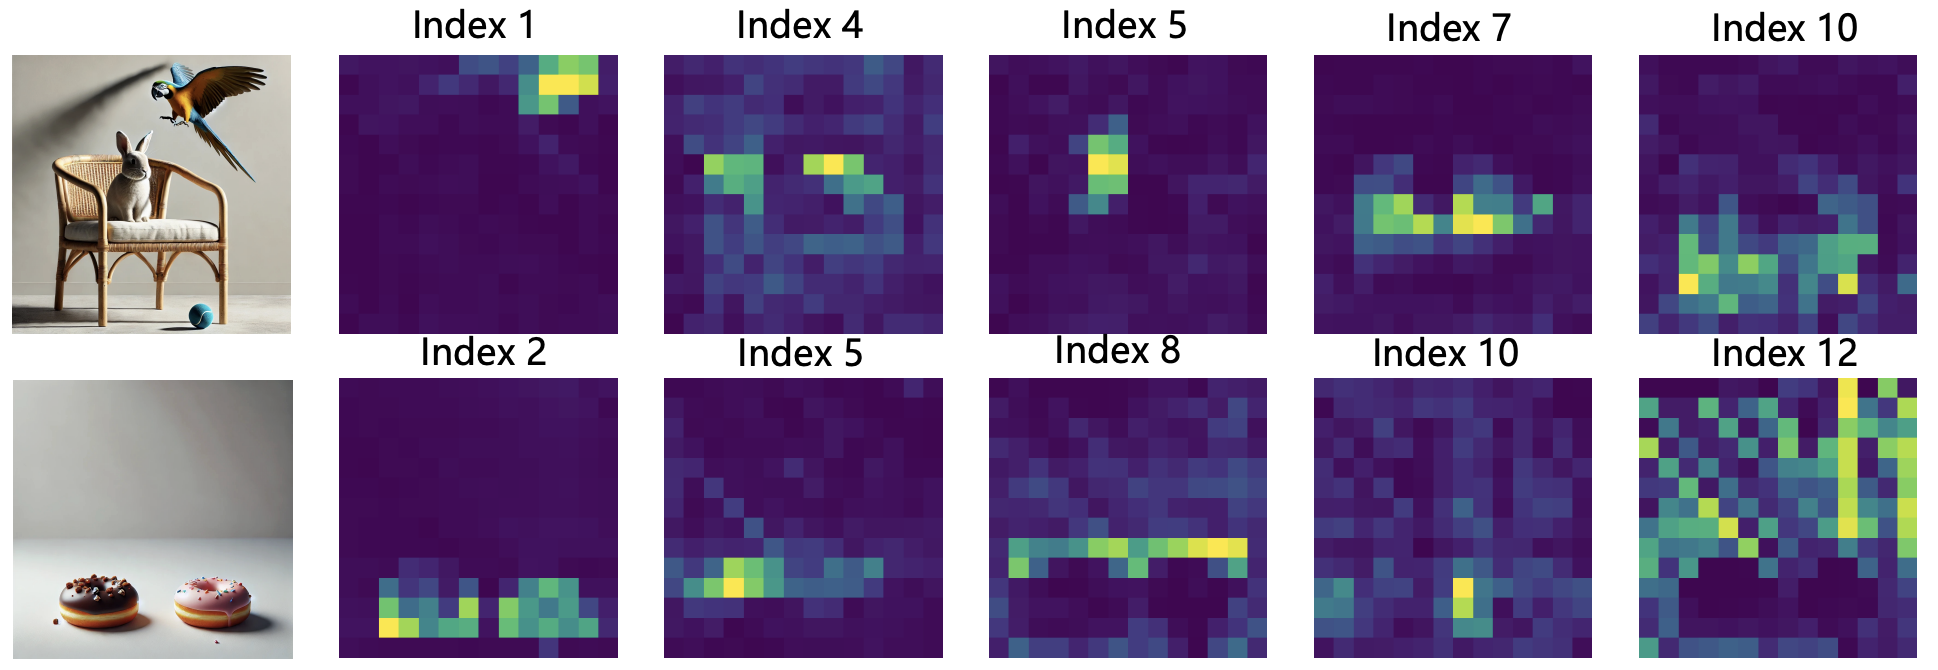
附录图 7:register token 的响应各有侧重;较前位置的 token 也能呈现全局目标模式。
作者将这种现象描述为类似多头 attention 的特征:不同 register 提供了不同的信息汇聚视角。结合模型的双向扫描,这些图像响应支持其跨位置的信息获取能力。
阅读理解 \textcolor{#846784}{\textbf{阅读理解}} 阅读理解:"类似多头"是对观察到的表征行为的描述。其价值在于,多 register 为分析 Mamba 的全局与局部信息提供了多个读出位置。
4.5 规模增长与异常响应 \textcolor{#497797}{\textbf{4.5 规模增长与异常响应}} 4.5 规模增长与异常响应
在论文的 DINO 设置下,图 4(a)显示更大模型总体上获得更高 AUC。然而,正文同时给出了 DINOv2 的例外:模型规模增加时,特征图质量可能下降;加入 register 后,高范数异常响应得到缓解。
作者将这一现象与高范数 outlier 联系起来,并讨论 masked patch 策略的影响。这是文中结合已有工作给出的机制解释,其适用范围应保留在相应训练设置中。
附录图 9 也提醒我们,单张图像的表现未必随模型规模单调改善:该图展示的 Small 模型可以有更清楚的响应。
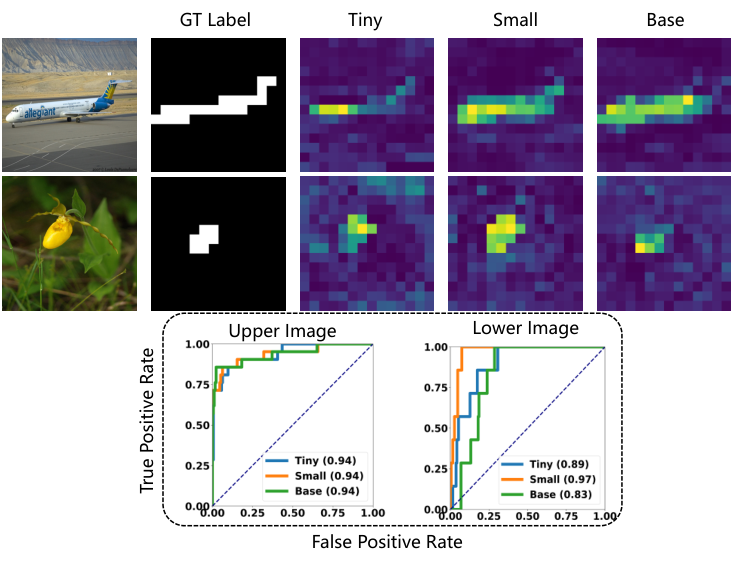
附录图 9:论文中的局部样例说明,整体规模趋势不要求每张图像都满足同一排序。
阅读理解 \textcolor{#846784}{\textbf{阅读理解}} 阅读理解:容量扩大、训练方式、异常响应与读出机制共同影响特征图。因此,评价一个视觉骨干时,需要保留"在什么训练设置、用什么方式观察"的上下文。
4.6 特征如何被读出 \textcolor{#497797}{\textbf{4.6 特征如何被读出}} 4.6 特征如何被读出
附录 F 在 Small DinoVim 上做了读出与超参数消融。附录表 6 首先比较分类读出策略:
| 读出策略 | Top-1 准确率(%) |
|---|---|
| Mean pooling | 75.9 |
| Max pooling | 74.6 |
| Middle CLS + mean | 76.5 |
| Middle CLS + max | 76.3 |
| Middle CLS | 77.2 \textcolor{#B9974F}{\textbf{77.2}} 77.2 |
Middle CLS 单独使用时最好。把平均或最大池化特征一起加入,也没有超过它。
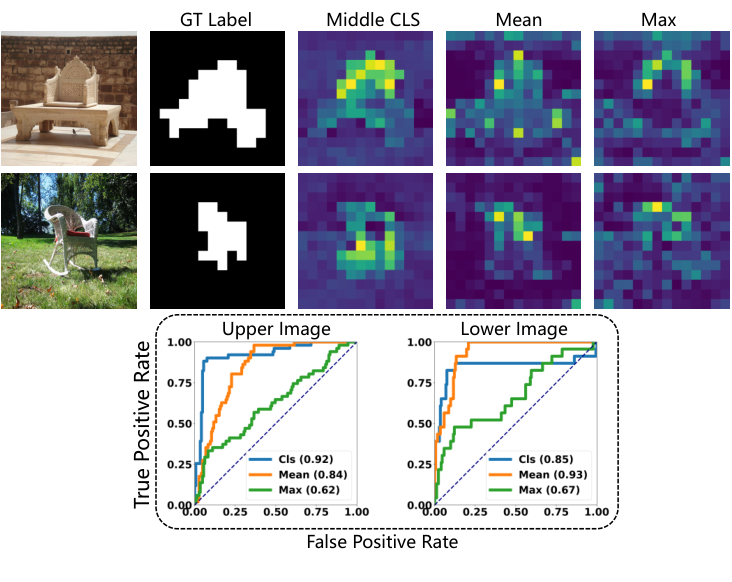
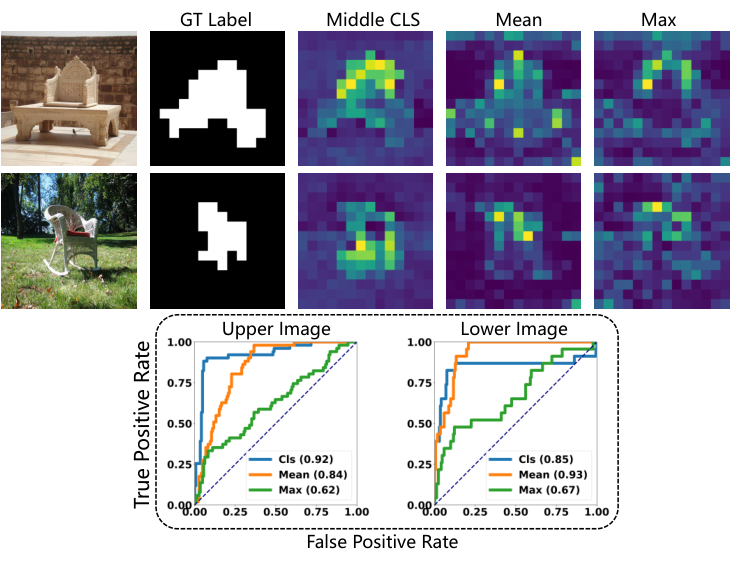
附录图 8:不同读出方式对应不同响应及 ROC。Middle CLS 的总体分类优势,不要求其每个可视化样例都获得最高 AUC。
例如,图 8 下方样例中,mean 的 AUC 为 0.93,Middle CLS 为 0.85。这与表 6 中 Middle CLS 的分类优势并不矛盾:单张图像的前景、背景分离与整个数据集的分类读出,评价对象不同。
附录表 5 的左侧关注多层读出。作者沿用 DINO 的思路,把最后若干个 block 的输出拼接,作为扩展后的线性探测输入;默认组合最后四个 block,并对这一选择进行消融:
| 拼接的末端 block 数量 | Top-1 准确率(%) |
|---|---|
| 1 | 71.8 |
| 2 | 75.6 |
| 3 | 76.7 |
| 4 | 77.2 \textcolor{#B9974F}{\textbf{77.2}} 77.2 |
在这组设置中,末端多层特征联合读出优于只读最后一层。附录表 5 的中间与右侧还分别考察了探测配置中的权重衰减和学习率。
固定学习率 10 − 3 10^{-3} 10−3,改变权重衰减:
| 权重衰减 | Top-1 准确率(%) |
|---|---|
| 0 | 77.2 |
| 10 − 2 10^{-2} 10−2 | 75.7 |
| 5 × 10 − 3 5\times10^{-3} 5×10⁻³ | 76.4 |
| 10 − 3 10^{-3} 10−3 | 77.3 |
固定权重衰减 10 − 3 10^{-3} 10−3,改变学习率:
| 学习率 | Top-1 准确率(%) |
|---|---|
| 2.5 × 10 − 4 2.5\times10^{-4} 2.5×10⁻⁴ | 77.1 |
| 5 × 10 − 4 5\times10^{-4} 5×10⁻⁴ | 77.2 |
| 10 − 3 10^{-3} 10−3 | 77.3 |
| 2 × 10 − 3 2\times10^{-3} 2×10⁻³ | 77.4 \textcolor{#B9974F}{\textbf{77.4}} 77.4 |
作者在测试配置中以学习率 2 × 10 − 3 2\times10^{-3} 2×10⁻³、权重衰减 10 − 3 10^{-3} 10−3 获得最好结果。这里的超参数扫描与预训练优化表是不同的配置层面;两个单变量扫描也不能扩展为任意学习率、权重衰减组合都已被测试。
阅读理解 \textcolor{#846784}{\textbf{阅读理解}} 阅读理解:线性探测的结果也依赖如何选取、汇聚预训练特征。这里增加拼接层数会扩大读出特征的维度;调整探测超参数也会改变结果。解释不同模型的探测准确率时,需要一并核对这些设置。
4.7 分类与空间表征 \textcolor{#497797}{\textbf{4.7 分类与空间表征}} 4.7 分类与空间表征
正文表 1 在相同规模的探测头下报告:
| 骨干 | 骨干参数量(M) | 探测头参数量(M) | ImageNet Top-1(%) |
|---|---|---|---|
| LinearViT-B | 85 | 1.5 | 74.7 |
| DinoVim-B | 88 | 1.5 | 78.1 |
| ViT-B | 85 | 1.5 | 78.2 |
DinoVim-B 与 ViT-B 的分类结果接近。但进入需要更强空间理解的任务后,差距仍然存在:
| 骨干 | ADE20K mIoU(%) | COCO 检测 A P b \mathrm{AP}^{b} APb | COCO 实例分割 A P m \mathrm{AP}^{m} APm |
|---|---|---|---|
| LinearViT-B | 29.2 | 37.1 | 32.6 |
| DinoVim-B | 38.0 | 42.8 | 37.4 |
| ViT-B | 43.2 | 44.8 | 39.1 |
这些实验使用 DINO 预训练权重初始化下游骨干。附录补充了设置:
| 下游任务 | 实验设置 |
|---|---|
| ADE20K 语义分割 | UperNet;输入 512 × 512 512\times512 512×512;AdamW,学习率 6 × 10 − 5 6\times10^{-5} 6×10⁻⁵、betas 为 ( 0.9 , 0.999 ) (0.9,0.999) (0.9,0.999)、权重衰减 0.05;前 1500 步用 LinearLR,起始因子为 10 − 6 10^{-6} 10−6,随后用 PolyLR,总训练步数为 160,000 |
| COCO 检测与实例分割 | Cascade Mask R-CNN;图像尺寸 1333 × 800 1333\times800 1333×800;AdamW,学习率 10 − 4 10^{-4} 10−4、权重衰减 0.1;前 500 步用 LinearLR,随后用 MultiStepLR,在第 8、11 个 epoch 衰减学习率;bias 和位置嵌入等参数不使用权重衰减 |
对这组结果,更有意义的理解有两个方面:
- 优势延续到密集任务 \textcolor{#5397A4}{\textbf{优势延续到密集任务}} 优势延续到密集任务:Mamba 在这些任务上继续优于所测 Linear Attention。可视化中的全局目标响应具有下游任务上的对应表现。
- 接近的分类准确率,仍可能伴随不同的空间表征质量。 \textcolor{#5397A4}{\textbf{接近的分类准确率,仍可能伴随不同的空间表征质量。}} 接近的分类准确率,仍可能伴随不同的空间表征质量。ViT 在分割和检测上保留优势,与论文中的区域分化、目标边界观察相呼应。
正文表 1 还单列了较重探测头的设置:
| 骨干 | 探测头参数量(M) | ImageNet Top-1(%) |
|---|---|---|
| DinoVim-B | 6.2 | 78.3 |
| DinoMamba-Reg-B | 6.2 | 78.5 |
因此,摘要中的 78.5% \textcolor{#B9974F}{\textbf{78.5\%}} 78.5% 来自 DinoMamba-Reg-B,使用 6.2M \textcolor{#B9974F}{\textbf{6.2M}} 6.2M 参数的较重探测头;前面 ViT-B 的 78.2% 使用 1.5M \textcolor{#B9974F}{\textbf{1.5M}} 1.5M 参数的探测头。论文展示了 Mamba 表征的实用潜力,但这两个数字不能直接解释为相同探测配置下的骨干优劣。
ViT-B 与 LinearViT-B 的架构对照较严格;Mamba 与 ViT 还存在层数及骨干参数量等差异。这些实验证据支持具体配置中的性能关系,对"差异完全由秩导致"的因果解释仍需谨慎。
4.8 分布偏移中的趋势与例外 \textcolor{#497797}{\textbf{4.8 分布偏移中的趋势与例外}} 4.8 分布偏移中的趋势与例外
论文在 ImageNet-V2、Sketch、A、R、Real 上评价鲁棒性。DinoVim-B 在这些测试中均优于 LinearViT-B,并在多数设置下接近但低于 ViT-B。
不过,原文表 4 的排序并非每列都相同:
- ImageNet-Sketch 上,DinoVim-B 为 27.6% \textcolor{#B9974F}{\textbf{27.6\%}} 27.6%,ViT-B 为 25.5% \textcolor{#B9974F}{\textbf{25.5\%}} 25.5%。
- ImageNet-V2 的 Matched-Frequency 设置中,二者均为 66.6% \textcolor{#B9974F}{\textbf{66.6\%}} 66.6%。
因此,这组实验更适合说明:Mamba 在作者测试的分布偏移下保持了有竞争力的表征,并总体优于该 Linear Attention 基线;它不构成所有分布上都严格一致的架构排序。
五、如何理解这篇工作? \textcolor{#A85E5C}{\textbf{五、如何理解这篇工作?}} 五、如何理解这篇工作?
这篇工作的贡献可以从三种证据的配合来理解。
统一矩阵表达提供了可检查的分析对象。 \textcolor{#5397A4}{\textbf{统一矩阵表达提供了可检查的分析对象。}} 统一矩阵表达提供了可检查的分析对象。SSM 递推展开后,同样能描述为 token 之间的有效权重。这让我们能够讨论跨块信息传递的结构约束,也让原文的理论条件可以被逐式检查。尤其应区分全矩阵秩、跨块秩上界和实际训练后的任务表现。
Binary-AUC 提供了具体的表征诊断。 \textcolor{#5397A4}{\textbf{Binary-AUC 提供了具体的表征诊断。}} Binary-AUC 提供了具体的表征诊断。它使前景、背景区分、head 差异、register 位置和层深变化能够放在同一评价工具下观察。同时,归一化前后的方向含义不同,使用这一指标时需要保留其测量对象。
DINO 与下游实验展示了视觉 Mamba 的实际潜力。 \textcolor{#5397A4}{\textbf{DINO 与下游实验展示了视觉 Mamba 的实际潜力。}} DINO 与下游实验展示了视觉 Mamba 的实际潜力。Mamba 能学到有全局目标结构的表示,合适的训练与读出方式也会改善其表现;分类接近 ViT,仍不代表密集空间理解上的差距消失。论文给出的经验结果值得保留,而其严格秩层级则应与前述公式核查一起阅读。
参考资料 \textcolor{#A85E5C}{\textbf{参考资料}} 参考资料
- 论文正文:CVF Open Access PDF:统一公式与秩分析见第 3 节,Binary-AUC 和 DINO 设置见第 4 节,特征诊断与下游实验见第 5 节。
- 论文附录:论文页面中的 supp 链接:register 全局响应见 B 节;数据与实现见 C 节;PCA 见 D 节;DINO 架构见 E 节;读出及超参数消融见 F 节;矩阵秩性质与理论说明见 G 节。
- 官方代码:Dino-Mamba。
所有图片均直接截取自论文正文与附录。图注同时标明原图编号和 PDF 页码;文件中的相对路径对应配图包中的 assets 目录。