**题目:**FlashSAM: Lightweight Vision Model for Multi-UAV Token Communication in Low-Latitude Wireless Networks
**作者:**江沸菠,涂思伟,董莉,王可之,杨鲲,Ruiqi Liu,潘存华,王江舟
**来源:**IEEE Journal of Selected Topics in Signal Processing
论文地址: FlashSAM: Lightweight Vision Model for Multi-UAV Token Communication in Low-Altitude Wireless Networks | IEEE Journals & Magazine | IEEE Xplore(查看全文请点击原文链接)
摘要:Token通信(TokenCom)是一种有前景的低空无线通信范式,旨在传输与任务相关的核心信息,尤其是在不确定性、噪声和带宽限制严格的环境中。然而,现有的TokenCom系统仍面临多个挑战,包括庞大的知识库、低效的Token编码以及对多用户Token共享的支持有限。为了解决这些问题,我们提出了一种基于轻量级视觉模型的多无人机Token通信(LVM-MTC)系统。首先,我们开发了一个轻量级的"Segment Anything Model"(SAM),称为FlashSAM,该模型采用了一系列创新的卷积架构,显著减少了模型参数。基于FlashSAM,我们构建了一个轻量级知识库(LKB),以实现高效的物体级感知。接下来,我们设计了一个基于Masked Autoencoder(MAE)架构的高效Token编解码器(ETC)。ETC在像素和Token级别上提高了语义压缩效率,并提供了针对资源受限的无人机量身定制的轻量级Token解码。此外,我们提出了一个多无人机Token共享(MTS)方案,用于多无人机Token通信。通过衡量无人机之间Token的相似性,MTS通过广播整合相似Token的传输,从而进一步提高了传输效率。最后,仿真结果验证了所提出的LVM-MTC系统的可行性和有效性。
1. 引言
低空无线网络是指部署在低空区域的通信网络,用于支持环境监测、海事通信、灾难响应和普适感知等应用的广域连接。随着对大规模、基础设施受限环境中可靠通信的需求日益增加,这些网络在实现广泛地理区域内的持续信息采集、态势感知和协调操作方面发挥着重要作。无人机(UAVs)因其具备快速部署、按需覆盖和空中中继等优势,已成为低空无线网络的关键支撑技术,特别是在地面基础设施稀缺或受干扰的地区。然而,机载能量、载荷、频谱和计算能力的严格限制,基本上限制了可用带宽和可实现的视觉数据传输保真度。在实际的下行任务中,基站可能需要传输与任务相关的视觉内容------如地理注册的语义地图、危险/禁飞区叠加层或多无人机协调共享的场景表示------以支持机载感知和决策。然而,直接通过这些资源受限的链路流式传输大量图像或视频通常效率低下,可能会影响时效性和可靠性。
语义通信(SemCom)是一种为6G设想的任务导向型通信范式。通过传输与任务相关的语义表示而非原始比特流,它实现了从"信号传输"到"意义传输"的转变,从而减少了带宽消耗,提升了能效和鲁棒性。Token通信(TokenCom)进一步将语义封装为紧凑的离散Token,并将Token作为基本的通信单元,提供了更标准化的语义接口,能够实现更可预测和可控速率的传输。在图像通信中,接收端可以利用Transformer模型的上下文推理能力来预测和补全缺失或不确定的Token,从而在极低比特率下实现高效的语义交换,同时保持与任务相关的语义保真度。然而,在有限通信资源的约束和日益增长的用户通信需求下,当前图像Token通信系统的研究仍面临以下挑战:
**1)庞大的知识库:**传统的语义通信系统通常依赖于大规模的规则集或知识图谱(KGs)作为外部知识库,这些知识库的收集、整理和更新过程既昂贵又复杂。从Token通信的角度来看,需要一个轻量级、任务对齐且可Token化的知识接口,以便在传输和解码过程中进行高效查询和调用。尽管大规模视觉模型(LVMs)包含丰富的知识,但其参数规模和推理延迟限制了实时部署。因此,低成本、快速构建"Token准备"知识库仍然是一个瓶颈。
**2)低效的Token编码:**图像具有显著的像素冗余和较低的信息密度。基于卷积神经网络(CNN)的编码器通常对整个图像进行编码,主要在语义层面去除冗余,而像素级冗余则未得到充分处理。在Token通信中,冗余像素会转化为更长的Token序列,削弱了速率控制能力;过度编码背景区域还会减少主物体的Token预算,损害任务相关的保真度。理想的设计应当联合修剪像素冗余,并保留面向物体的语义,从而生成紧凑的Token。
**3)缺乏多用户Token共享:**随着用户群体和应用规模的增长,点对点方案在大规模多用户环境中变得低效。现有的多用户语义通信研究很少在语义空间中利用Token级共享。在Token通信中,用户的Token流通常在环境先验、任务约束和场景元素上有所重叠。通过区分共享Token和用户特定Token,发送方可以合并共同部分,仅发送增量差异,从而减少带宽冗余并提高可扩展性。
轻量级视觉模型已成为实现LVM在边缘设备部署的关键方向。为了减少LVM的资源占用和推理延迟,研究人员广泛采用了知识蒸馏、量化和剪枝等技术,将LVM压缩为轻量级模型。基于这些进展,我们提出了一种基于轻量级视觉模型的多无人机Token通信系统(LVM-MTC)。LVM-MTC的关键创新如下:
**1)轻量级知识库:**为了应对LVM支持TokenCom知识接口时产生的高资源消耗和推理延迟,我们设计并训练了一个轻量化版本的SAM,称为FlashSAM。通过将SAM中的ViT骨干网替换为更紧凑的卷积结构,FlashSAM在参数上实现了约10倍的减少,并在推理速度上实现了约20倍的加速。基于FlashSAM,我们构建了一个轻量级知识库(LKB),它能够快速定位关键语义对象及其区域,为后续Token生成和选择提供可Token化的先验信息。因此,所提出的TokenCom系统能够更快、更准确地从图像中提取关键Token。
**2)高效的Token编解码器:**为了实现更高效的Token压缩和传输,我们开发了一个基于Masked AutoEncoder(MAE)架构的高效Token编解码器(ETC)。ETC编码器分为两个阶段进行Token编码。在低级(像素)阶段,它利用LKB提供的对象区域和位置信息进行自适应掩码,从而去除与对象无关的冗余像素。在高级(语义)阶段,基于ViT的图像编码器生成高质量的Token,并进一步消除冗余语义。在接收端,解码器只需要少量Token即可重建对象语义,然后通过利用像素级的统计相关性恢复图像的细节。此外,ETC采用了不对称设计:计算密集型的编码器部署在基站,而轻量级的解码器部署在无人机上。
**3)多无人机Token共享传输:**从Token通信的角度出发,我们利用LVM的表示能力构建了一个多用户语义空间,其中来自不同无人机的图像被映射为可比较的Token表示。语义相同或相似的Token被合并为共享Token。在传输过程中,Multi-UAV Token Sharing(MTS)方案分别传输共享Token和无人机特定的私有(即差异化)Token,以减少整体Token数量。在接收端,每个无人机将共享Token和私有Token重新组合,重建其对应的图像,从而实现更高效的多无人机Token通信系统。
本文的其余部分结构如下:第二部分回顾相关工作;第三部分介绍系统模型;第四部分详细描述了所提出的LVM-MTC;第五部分讨论了实验设置和结果;第六部分对本文进行总结。
2. 相关工作
2.1 无人机的语义通信系统
Xu 等人提出了一个基于联邦学习(FL)的无人机编队语义通信框架。为了应对动态拓扑和资源限制,他们引入了一种分层FL架构,采用集中式的簇内训练和去中心化的簇间聚合。Liu 等人提出了一种无人机辅助的移动边缘计算(MEC)系统,该系统集成了在干扰攻击下的语义通信。他们提出了一种基于深度强化学习(DRL)的资源管理算法,联合优化无人机轨迹、用户关联和信道选择,以学习并应对动态干扰。Hu 等人提出了一种多模态语义通信的智能资源分配方法,适用于无人机协同中继网络。该框架允许无人机在图像和文本传输模式之间动态切换,以最大化一种新颖的用户体验质量指标,同时最小化成本。
2.2 Token通信
Qiao 等人提出了TokCom,这是一个基于大模型驱动的跨模态语义通信范式。通过将多模态数据表示为统一的离散Token,并利用预训练的多模态大语言模型(MLLMs)进行掩码/下一个Token预测,TokCom能够在极低比特率下重建缺失的Token,从而建立了"Token即语义,语义即通信"的理念。Liu 等人设计了文本引导的TokCom,这是第一个将文本Token作为无线图像传输的边信息的系统。Zhang 等人提出了TokCom-UEP,揭示了等错误保护会浪费冗余,因为1维Token序列存在固有的语义层次结构。Jiang 等人提出了一种视觉语言模型驱动的TokCom范式,将多模态数据表示为统一的语义Token进行传输。
2.3 多用户语义通信系统
Xie 等人研究了任务导向的多用户语义通信系统,并提出了一个基于Transformer的框架,以统一不同任务的发送器架构,包括图像检索、机器翻译和视觉问答。Li 等人提出了一种基于非正交多址接入(NOMA)的多用户语义通信系统(NOMASC),该系统支持多个用户的语义传输,处理不同来源信息模态。该系统使用不对称量化器和神经网络模型进行符号映射和智能多用户检测。Mu 等人介绍了一个创新的异构语义和比特多用户通信框架,采用半NOMA方案有效促进异构语义和比特的多用户通信。他们还提出了一种机会性语义和比特通信方法,以缓解NOMA中的早期和晚期速率差异问题。
因此,现有的无人机辅助语义通信研究主要针对系统级优化,但通常依赖于重型视觉模型或连续特征传输,使得在带宽、计算和延迟受限的情况下,实现实时语义感知和传输变得困难。Token通信通过生成/预测Token补全来改善语义恢复,但其模型规模和推理复杂性可能会阻碍其在资源受限的无人机和低延迟闭环任务中的部署。多用户语义通信通常通过资源正交化或类似NOMA的方案来区分用户,而在语义空间共享方面的利用不足,导致源端的跨用户冗余问题未得到充分解决。相比之下,我们的复杂度感知、边缘友好设计使用了FlashSAM启用的LKB进行实时关键物体定位,采用不对称ETC将重编码任务卸载到基站,同时无人机执行轻量级解码,并通过MTS合并共享语义,减少冗余同时保持任务相关的语义保真度。
3.系统模型
如图1和图2所示,我们考虑了一个多无人机Token通信系统。该系统由一个发送端(基站)和多个接收端(无人机)组成。在基站,K个源图像被联合Token化和信道编码,并通过下行信道传输。在接收端,接收到的信号经过联合Token解码和信道解码,以重建源图像。
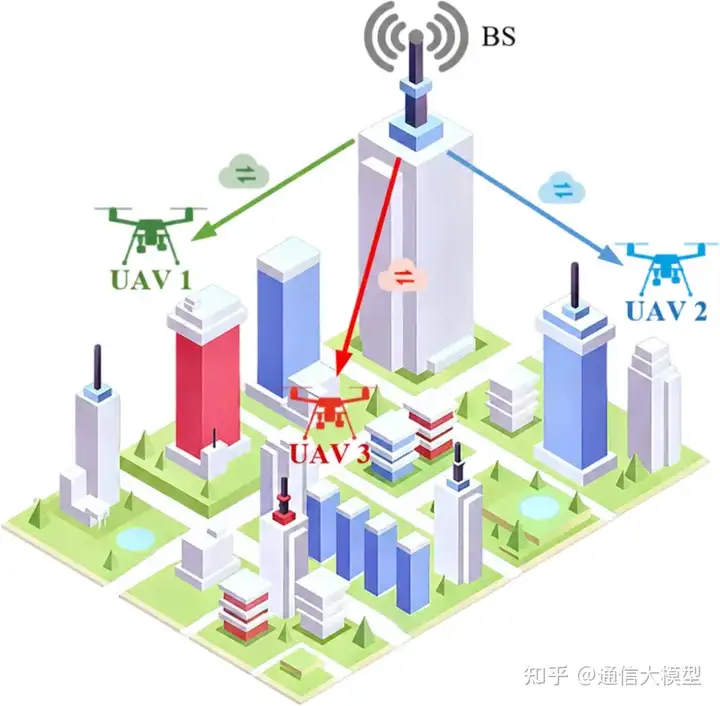
图1:基站--多无人机Token通信网络架构
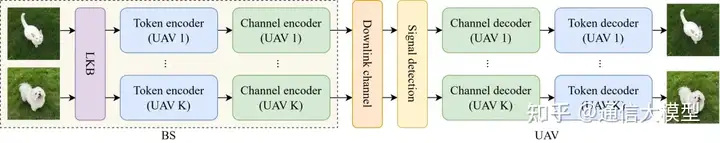
图2:下行多用户Token通信系统模型
3.1 基站端Token通信发送器
本文以第 k 架无人机对应的源图像作为输入,其数据维度由通道数、图像高度和图像宽度共同确定。每幅图像均包含与任务相关的信息,系统首先利用编码器将其转换为具有固定Token长度和嵌入维度的Token表示。在Token化过程中,第 k 架无人机对应的Token编码器采用可学习参数,而所有无人机共享参数固定的LKB知识库。具体而言,LKB从源图像中检索与任务相关的关键目标位置线索,并将这些线索融入Token化过程,以指导Token的生成与筛选。
考虑到通信资源有限以及无线环境复杂,系统进一步对第 k 架无人机的Token表示进行压缩,并将其映射为适合无线传输的复值信号。该过程由具有可学习参数的信道编码器完成,编码后信号的特征维度小于原始Token表示的嵌入维度,从而实现对Token信息的进一步压缩。完成信道编码后,系统对复值信号进行功率归一化,使其平均发送功率不超过单个发送端所允许的最大发送功率。该步骤能够确保发送信号的功率始终处于规定范围内,从而有效利用可用的发送功率。
3.2 下行信道
当发送信号通过多输入多输出物理信道时,接收信号由所有无人机发送信号经过相应信道后的叠加结果与噪声共同构成。其中,系统将所有无人机的发送信号组合为统一的发送信号矩阵,并使用基站与各无人机之间的信道矩阵描述信号传播过程。在瑞利衰落条件下,信道矩阵中的元素服从零均值、单位方差的复高斯分布。信道噪声被建模为各元素相互独立且同分布的圆对称复高斯噪声。信噪比由所有无人机经过各自信道后的接收信号功率之和与噪声方差之比确定。
随后,系统利用估计的信道状态信息,通过线性最小均方误差检测器恢复各无人机的发送信号。信道状态估计结果由真实信道状态与估计误差共同构成,其中,估计误差矩阵中的元素服从零均值复高斯分布,其方差用于表征信道状态信息的估计误差水平。线性最小均方误差检测器综合利用估计的信道矩阵、噪声方差和接收信号,获得各无人机发送信号的恢复结果。
3.3 无人机端Token通信接收器
对于第 k架无人机,信道解码器首先根据恢复后的复值信号重构具有相应Token长度和嵌入维度的Token表示。该信道解码器采用可学习参数,其目标是在减轻信道失真和无人机间干扰影响的同时,尽可能准确地恢复发送端传输的Token。随后,Token解码器对恢复后的Token表示进行解码,并将其重构为图像。每架无人机均配置具有可学习参数的Token解码器,最终获得与其对应的重构图像。
3.4 问题建模
基于上述系统模型,本文旨在联合学习部署于基站与各无人机侧的TokenCom模块,使重构图像能够保留与任务相关的信息。在固定LKB知识库参数的条件下,系统通过联合优化所有无人机对应的Token编码器、信道编码器、信道解码器和Token解码器,最小化各无人机任务损失之和的期望。该期望同时考虑训练数据分布、无线信道衰落和加性高斯噪声,从而使所学习的TokenCom系统能够在不同图像样本与随机信道条件下保持较好的任务相关信息重构能力。
4.提出的LVM-MTC系统
在本节中,我们将提供所提议的LVM-MTC系统的实现细节,如图3所示(以两个无人机为例)。
4.1 系统概述
**1)LKB:**我们首先在基站部署一个基于定制FlashSAM模型的轻量级知识库。LKB包含广泛的视觉知识,能够迅速且准确地定位图像中与任务相关的物体,以支持Token通信。它通过丢弃与任务无关的背景像素,促进ETC的自适应掩码过程,从而提高像素级别的Token化效率。如图3所示,LKB通过使用矩形边界框标记不同源图像数据中的关键物体,以进行Token化。
**2)ETC编码器:**我们利用ETC,由编码器和解码器组成,用于执行高效的Token编码和解码。首先,ETC编码器参考由LKB生成的位置位置信息,自适应地掩盖源图像中与任务相关物体关联较弱的像素部分。随后,Token编码器由多个Transformer编码层组成,对剩余的关键像素进行编码,以生成高语义密度的Token。如图3所示,对于一张动物图像,背景像素与动物本身的关联较弱。因此,ETC大部分背景像素会被自适应地掩盖,而ETC编码器则对剩余的关键像素执行高质量的Token生成。
**3)Token比较器:**在基站,Token比较器评估来自不同无人机的Token表示在语义空间中的相似性。每个Token被分为两部分:专属于每个无人机的私有Token和所有无人机共享的Token。共享Token捕捉不同无人机之间的相似特征,例如图3中不同动物身上的白色毛发和背景草地。
**4)MTS传输:**共享Token使用公共信道编码器进行编码,并通过公共下行信道传输到所有接收无人机,从而减少冗余的Token传输。另一方面,私有Token通过对应每个无人机的信道编码器和下行链路进行编码和传输。在接收端,每个无人机接收共享Token和私有Token。然后,这些Token被组合,并使用针对每个无人机的信道解码器进行解码。
**5)信道编码器和解码器:**编码后的Token通过信道编码器进行处理,以确保其能够有效地通过物理信道传输。信道编码器由自编码器组成,其中隐藏层的特征维度逐渐减少,从而实现数据压缩。感知机神经网络用于模拟信道,本质上表示输入和输出之间的映射。这个映射由所采用的信道模型(例如加性高斯噪声和衰落)决定,而不是可训练的权重和偏差,它的引入是为了在信道失真下进行端到端的鲁棒Token学习。在接收端,使用信道解码器来解码传输的Token。为了保持一致性,信道解码器采用与信道编码器相反的自编码器结构。
**6)ETC解码器:**在接收端,ETC解码器由多个Transformer解码层组成,作为Token解码器从有限的接收Token中重建原始图像。值得注意的是,Token编码器和解码器的结构是不对称的。Token编码器负责生成紧凑的Token,具有更多的参数,并部署在基站,而负责重建图像的Token解码器具有较少的参数,并部署在无人机上。
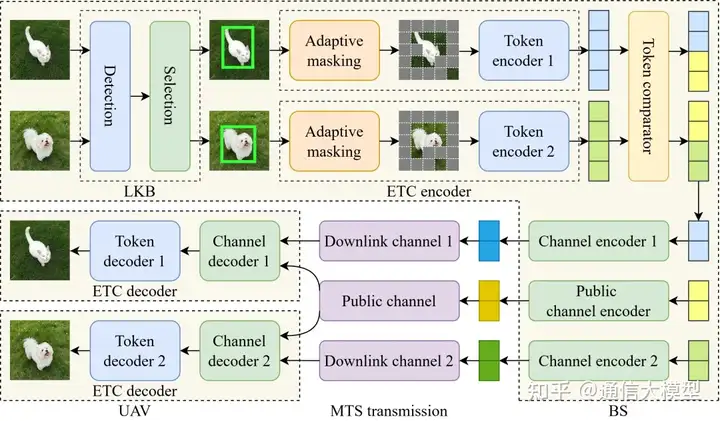
图3:所提出的下行多无人机Token通信系统框架
4.2 LKB
如图4所示,LKB作为ETC编码器的感知驱动空间先验生成器。它利用FlashSAM提取物体级的边界框,以便后续进行自适应掩码。与原始的依赖于重型视觉Transformer编码器的SAM相比,FlashSAM采用以卷积为主的架构,这显著减少了计算开销,同时保持了准确的物体定位。这个设计使得FlashSAM适用于实时的无人机辅助Token通信。FlashSAM的架构如下:
**1)骨干网络:**FlashSAM首先通过轻量化、以卷积运算为主的骨干网络,从输入图像中提取层次化视觉表示,并生成包含小尺度、中尺度和大尺度特征响应的多尺度特征图。
该骨干网络由CBS、C3K2、SPPF和C2PSA等高效卷积模块依次构成。其中,CBS是由卷积、批归一化和SiLU激活函数组成的基础模块,负责提取局部特征;C3K2是受跨阶段局部连接架构启发而设计的轻量化残差单元,能够在降低计算复杂度的同时改善梯度传播;SPPF通过多尺度池化扩大感受野并捕获多尺度上下文信息;C2PSA则利用并行分支注意力机制强化信息量较高的通道,同时抑制冗余特征。
**2) 颈部模块:**为增强模型对不同目标尺度的适应能力并提高上下文一致性,特征聚合颈部网络对骨干网络输出的多尺度特征执行自顶向下和自底向上的双向融合。融合后的特征包含更加丰富的多尺度上下文信息,并作为预测头的输入。
**3)预测头:**预测头将融合特征映射为目标级边界框及其对应的置信度分数。每个候选边界框由目标的中心位置、宽度和高度共同描述,并附有相应的目标存在置信度。最终的二维预测卷积层负责将经过优化的特征映射为目标检测结果,从而生成全部候选目标区域。
**4)目标导向过滤:**为使感知结果与下游语义任务保持一致,本文利用共享任务描述对候选区域进行文本引导筛选。首先,系统从输入图像中裁剪各候选边界框对应的图像区域,并通过CLIP图像编码器获得相应的视觉嵌入。与此同时,任务文本通过CLIP文本编码器转换为语义嵌入。随后,系统计算每个候选区域的视觉嵌入与任务文本语义嵌入之间的余弦相似度,以衡量候选目标与任务描述之间的语义匹配程度。为获得紧凑且准确的空间先验,系统选择语义相似度最高的候选区域,并将其边界框作为最终的位置先验。
本文最终采用FlashSAM构建LKB。对于给定的输入图像和任务文本,LKB生成与任务语义对齐的空间先验,并将其输入ETC编码器,以指导面向Token的自适应掩码过程。该机制能够抑制与任务无关的图像区域,同时保留TokenCom所需的任务关键内容。通过上述方式,LKB将通用目标检测结果转换为具有结构化特征且可进行Token化处理的先验信息。
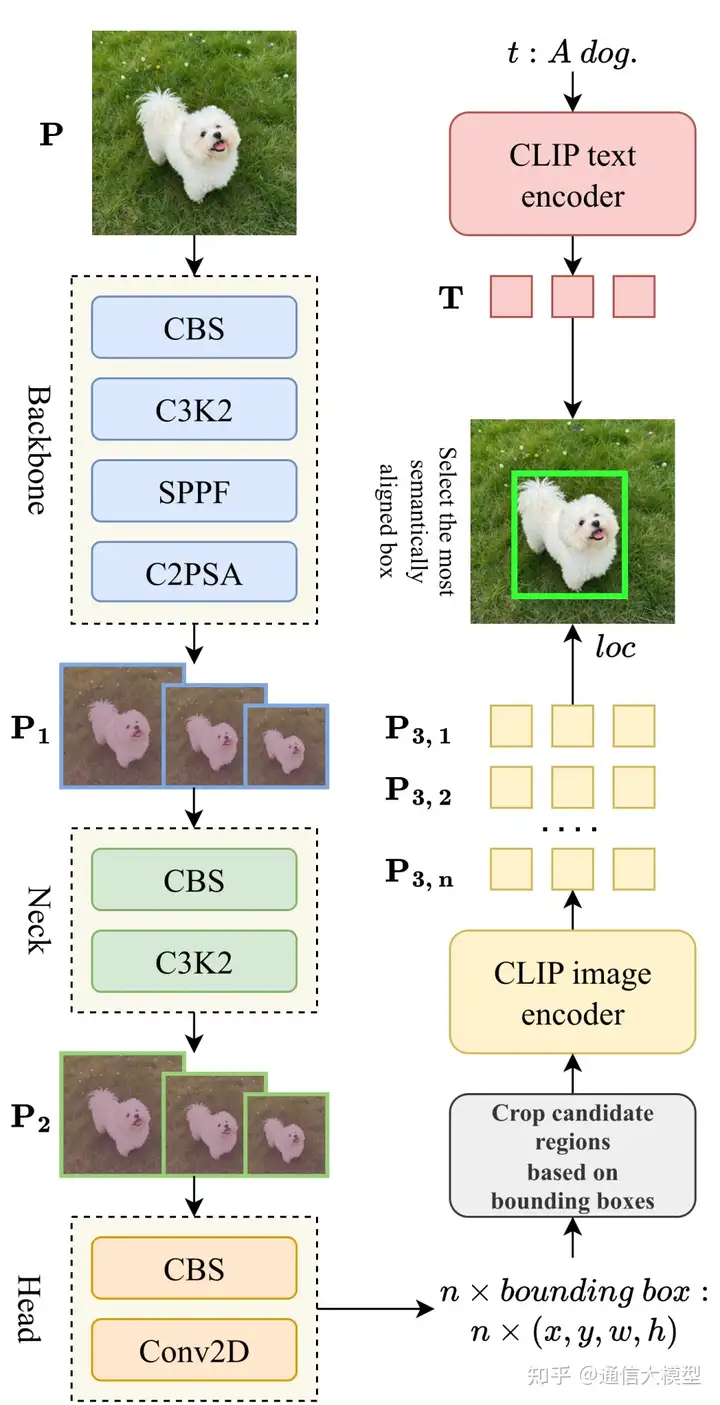
图4:FlashSAM(LKB)的工作流程
4.3 高效的Token编解码器
MAE是一种利用大规模图像数据进行自监督预训练的视觉模型。在编码阶段,输入图像被划分为多个图像块,其中大部分图像块会被随机掩码,编码器仅处理少量未被掩码的图像块;在解码阶段,模型根据这些有限的图像块重构原始图像。因此,MAE能够从图像中提取紧凑的Token表示,并实现较高的压缩率。
在所提出的LVM-MTC中,本文基于MAE设计了一种高效Token编解码器,称为ETC。ETC利用LKB提供的目标位置先验,将MAE中的随机掩码策略替换为目标导向的掩码策略,从而优先保留与目标相关的图像块,并在相同Token预算下生成信息量更丰富的Token。通过这种方式,参与Token编码的像素更多地集中于任务相关目标,从而实现高效Token化与可靠的TokenCom传输。其工作流程如图5所示。对于给定的输入图像及LKB生成的位置先验,ETC首先对图像进行Token编码,随后通过Token解码重构图像。具体过程如下。
**1)自适应掩码:**首先,ETC利用LKB提供的位置先验,优先对输入图像中的背景像素进行掩码,以去除与目标对象关联较弱的冗余像素,从而提高Token编码效率。需要指出的是,该策略并不意味着在编码过程中完全舍弃背景像素。具体而言,背景图像块被赋予较高的掩码概率,而前景图像块的掩码概率相对较低,使编码器能够在必要时保留用于描述场景上下文的Token。
在具体实现过程中,输入图像首先被划分为多个图像块。位于目标位置先验范围内的图像块被视为前景图像块,其余图像块则被视为背景图像块。由于LVM-MTC旨在更加准确地传输以目标为中心的Token,因此前景图像块的掩码概率被设置为低于0.5。由此,背景图像块具有更高的被掩码概率,从而有助于提高Token表示的质量。每个图像块的掩码状态服从伯努利分布,用于确定该图像块是否被掩码。系统对每个图像块执行一次前向采样,最终确定参与Token编码的保留图像块集合。
**2)Token编码:**LVM-MTC中的Token编解码框架由多层多头自注意力模块和前馈网络模块构成。具体而言,部署于基站侧的Token编码器堆叠了24层网络,用于学习层次化视觉特征并生成高质量Token。相比之下,部署于无人机侧的Token解码器仅包含8层网络,因而更加轻量,能够显著降低边缘设备的部署负担。在各网络层中,多头自注意力模块用于捕获图像块序列不同位置之间的全局依赖关系,前馈网络则分别处理各个位置的特征,以建模细粒度局部模式。对于保留下来的未掩码图像块,Token编码器首先进行层归一化,再通过多头自注意力模块提取全局关联特征,并利用残差连接保留输入信息。随后,前馈网络对注意力模块的输出进行层归一化和线性变换,并通过GeLU激活函数完成非线性特征映射,再利用残差连接获得该层的最终输出。上述过程在24层网络中依次执行。最后,编码器对第24层输出进行层归一化,得到最终的Token表示。
**3)Token解码:**在接收端,Token解码器根据经信道解码恢复的Token重构图像。按照MAE的解码机制,系统在被掩码图像块所对应的位置插入共享的可学习掩码Token,同时将接收到的Token重新放置到原始的保留位置,从而恢复用于解码的完整长度Token序列。
具体而言,重排操作依据完整图像块索引和保留图像块索引,将接收到的Token放回其原始位置,并在其余被掩码的位置填入共享的可学习掩码Token。由此恢复原始图像块排列顺序,获得完整的Token序列。随后,Token解码器继续对该序列进行处理,并生成最终的重构图像。
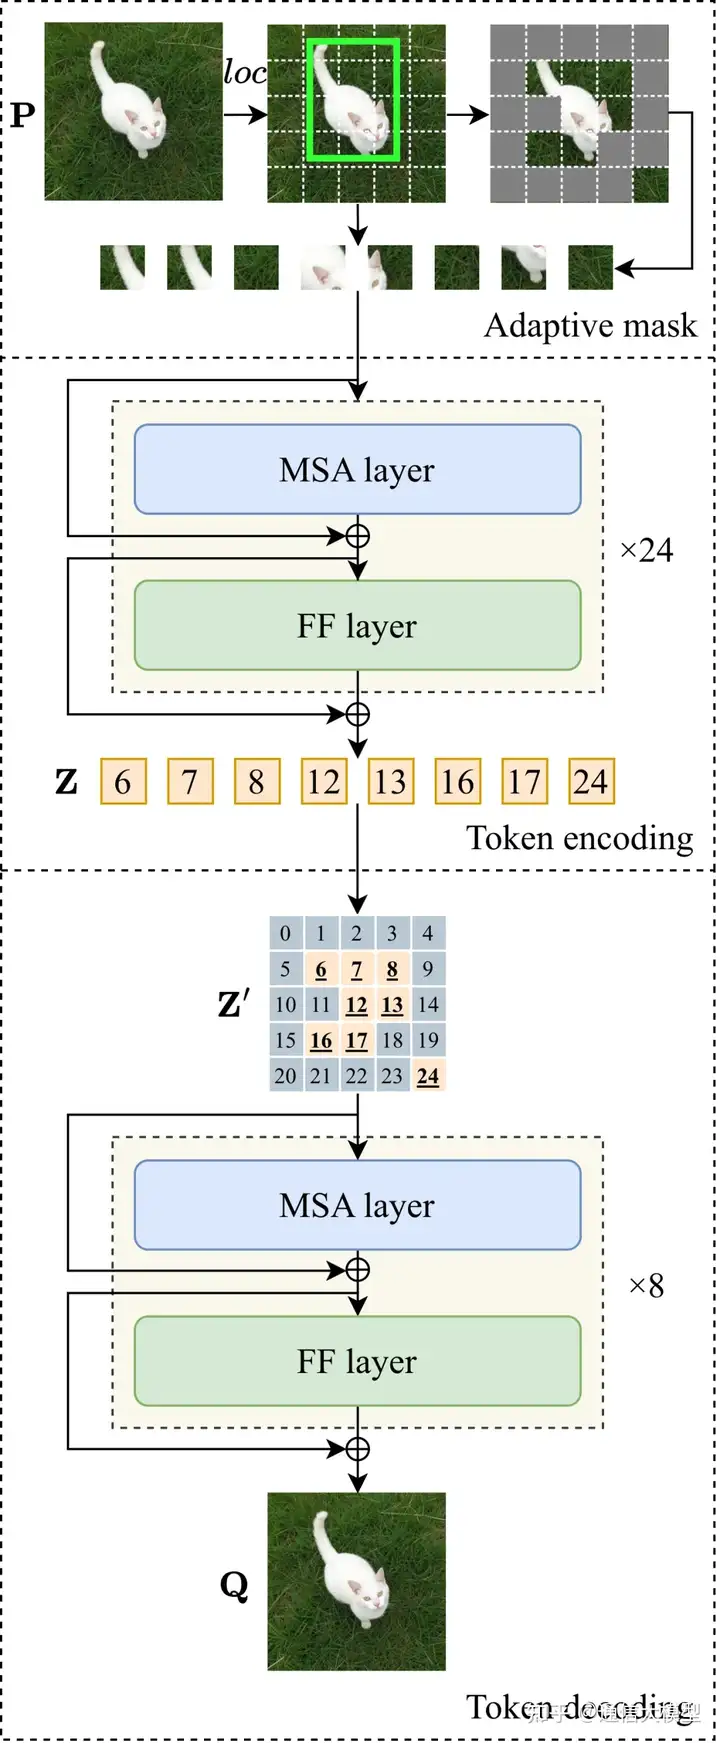
图5:ETC的工作流程:图像按照预定义的顺序被划分为小块。其中心点落在边界框内的小块被视为前景,并分配较低的掩码概率,而其他小块则分配较高的掩码概率。只有未掩盖的小块才会被编码。在解码过程中,被掩盖的位置共享一个掩码Token,该Token与编码后的特征结合,用于重建图像。
4.4 多无人机Token共享传输
已有大量研究表明,不同图像所包含的语义信息可能具有显著的相似性。例如,如图6所示,两幅图像中的草地背景和白色毛发像素区域在Token层面具有相似性。所提出的图像TokenCom系统利用轻量化视觉模型的精确感知与表示能力,将不同无人机的源图像映射至共享Token空间。随后,系统在该空间中引入Token比较器,从多架无人机的Token表示中识别、分析并提取公共Token与私有Token。通过对不同无人机的特有信息进行建模,系统能够区分各架无人机对应的私有Token成分。在无线传输过程中,包含公共Token的信号仅需广播一次,即可由多架无人机共同复用,从而减少系统总体信息传输量。
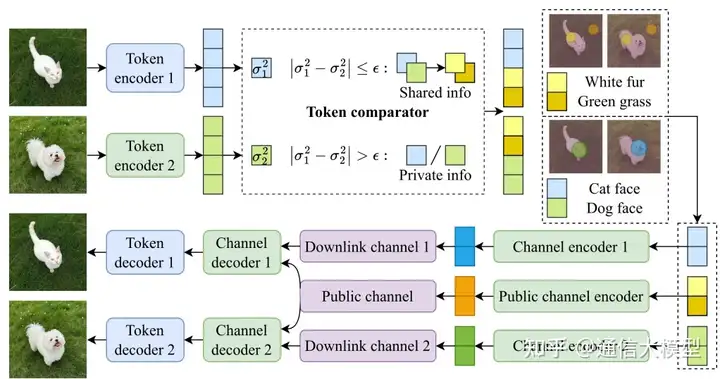
图 6:多无人机通信系统的Token共享传输
以两个无人机的Token通信系统为例,图6的左侧部分展示了Token比较器如何从多个无人机的Token表示中提取共享和私有Token,而图6的右侧部分提供了直观的例子,展示了共享和私有Token部分的含义。具体步骤如下:
**1)Token编码:**如图6所示,系统利用各架无人机对应的Token编码器,分别从其源图像中提取具有固定序列长度和嵌入维度的Token表示。其中,每个Token向量均可理解为与特定图像块相对应的Token嵌入。
**2)Token比较:**不同图像中的部分区域通常具有相似的视觉模式,这为多无人机TokenCom提取公共Token提供了基础。受MDMA方法启发,本文根据激活强度的一致性评估Token之间的共性,而非采用欧氏距离或余弦相似度。该方法更加契合TokenCom面向共享传输的冗余消除目标,因为它能够优先识别在不同用户数据中稳定重复出现的Token,从源头减少冗余传输。同时,这种基于统计量的比较方法计算开销较低,并且对尺度变化和噪声具有较强的鲁棒性,因而适用于资源受限的多无人机场景。
具体而言,每架无人机均从其对应图像中生成一组Token。系统为每个Token计算一个强度统计量,用于描述该Token在高维Token空间中的激活强度或信息集中程度。随后,系统针对候选Token组合比较不同无人机之间的强度统计量,并汇总所有无人机组合之间的差异,获得Token级差异评分。当差异评分低于预设阈值时,系统认为相应Token具有足够高的一致性,并将其划分为公共Token;否则,将其视为私有Token。对于公共Token,系统进一步对不同无人机中相互匹配的Token特征取平均,构建紧凑的公共表示,由此获得可以广播并复用的共享Token。相比之下,私有Token用于保留特定无人机对应图像中的个性化细节,需要分别传输至相应无人机。如图6所示,公共Token通常描述不同源图像中共同存在的视觉模式,例如相同的草地背景或相似的白色毛发区域;私有Token则表示源图像特有的语义信息,例如猫和狗各自不同的面部结构。
综上,Token比较器以所有无人机的Token表示作为输入,输出由各无人机共同使用的公共Token集合,以及分别对应各架无人机、用于表征个性化内容的私有Token集合。
**3)信道编码:**如图3所示,完成Token编码与Token比较后,系统利用各无人机专属的信道编码器分别编码私有Token,同时使用额外的公共广播信道编码器对公共Token进行编码。
**4)信道解码:**公共Token信号通过共享信道传输至所有接收无人机,而各架无人机对应的私有Token信号则通过专用信道传输至相应无人机。接收信号后,每架无人机利用其信道解码器分别恢复公共Token与自身对应的私有Token,并将二者拼接以获得完整的恢复Token表示。随后,Token解码器对恢复后的Token表示进行解码,生成相应的重构图像。
4.5 Token通信训练
本文将LVM-MTC的总体训练目标定义为:在保证信道损伤条件下Token能够可靠恢复的同时,最小化输入图像与重构图像之间的重构失真。整个训练流程包括以下四个阶段。
**1)FlashSAM训练:**首先,本文训练FlashSAM并将其作为LKB。FlashSAM采用类似YOLOv11x-seg的卷积骨干网络设计,在SA-1B数据集的2%数据上从随机初始化状态开始训练,共训练100个周期。训练完成后,该模型在下游任务中能够取得与SAM相当的性能。模型收敛后,FlashSAM的参数将被冻结。在后续TokenCom训练过程中,该模型仅用于推理并生成与任务对齐的空间先验,不再参与参数更新。
**2)Token编解码器训练:**在固定LKB参数的条件下,本文采用均方误差损失训练Token编码器与Token解码器,以最小化各架无人机的输入图像与重构图像之间的差异。该训练过程促使模型学习紧凑且能够保留任务相关内容的Token表示。
**3)信道编解码器训练:**随后,本文采用均方误差损失训练信道编码器与信道解码器,使其能够在下行信道条件下对Token进行鲁棒压缩与恢复。该阶段通过最小化原始Token表示与信道解码后恢复Token表示之间的差异,提高Token传输的抗信道损伤能力。
**4)端到端微调:**最后,除参数已经冻结的LKB外,本文对整个TokenCom系统进行联合微调。该阶段的损失函数同时考虑输入图像与重构图像之间的重构误差,以及原始Token与恢复Token之间的传输误差。通过联合优化上述两类误差,系统能够在图像重构质量与Token传输鲁棒性之间实现平衡。
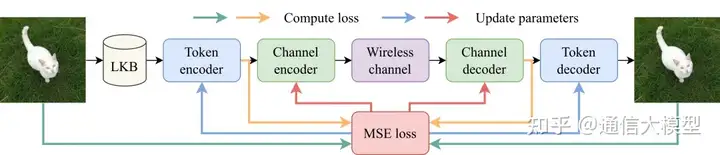
图7:所提议的Token通信系统训练过程
5. 仿真结果
5.1 仿真设置
本研究使用的图像数据集是PASCAL VOC2012,该数据集包含超过12,000张图像,涵盖了20个日常物体类别,如人类、车辆和动物。在实验过程中,该数据集被均匀划分,用于区分TokenCom设置中的多个无人机。
详细的实验配置如下:LKB包含56百万个参数。基于MAE的高效Token编码器包括24层视觉Transformer,特征维度为1024。信道编码器由一个线性层组成,输入特征维度为1024,输出特征维度为128。为保持一致性,信道解码器采用与信道编码器相反的结构。基于MAE解码器的Token解码器由8层视觉Transformer组成。在ETC的自适应掩码过程中,默认的物体补丁掩码概率Pr 设置为0.25。Token比较器的阈值ϵ 默认设置为0.1。实验中使用的信道编解码器训练了10个epoch,学习率为2×10⁻⁴。
训练和测试环境包括Windows 11、Python 3.8、PyTorch 2.0.1 和 CUDA 11.8。计算资源由12代Intel(R) Core(TM) i7-12700H 2.30 GHz CPU和80GB内存的A800 GPU提供。
5.2 LKB性能评估
是否可以在具有异构计算资源的设备上部署一个模型,对于降低构建相应知识库的部署成本至关重要,尤其对于TokenCom系统,在这种系统中,知识库必须提供可以Token化的空间先验,且开销最小。此外,TokenCom系统需要低延迟的感知到Token化过程,因此,知识库的推理时间越短,越能显著提高端到端TokenCom的效率和响应性。我们将LKB与SKB及一些代表性替代方案进行比较,包括SAM2、FastSAM和ViTDet。比较结果如图8所示。
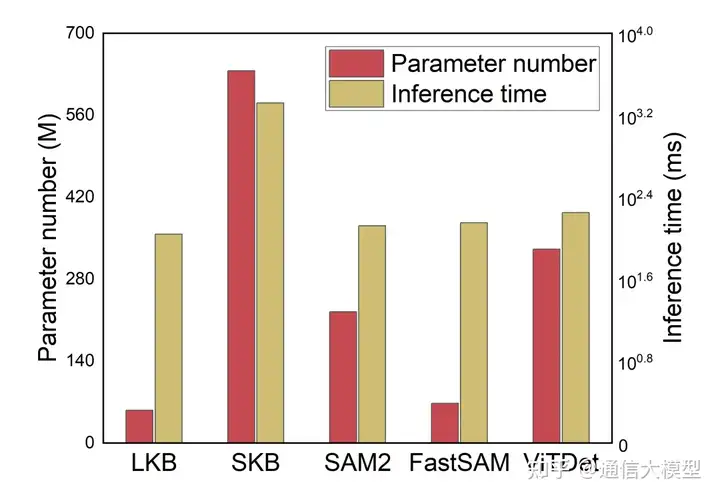
图8:LKB与其他知识库和模型的比较
如图8所示,LKB在参数大小和推理时间方面显著优于其他模型。这一优势归因于其采用了紧凑的架构,同时保持了竞争力的定位/分割能力。因此,LKB具有最低的构建和部署成本,并且与TokenCom的严格延迟要求最为契合,从而能够快速生成先验,支持后续的Token化和传输。
5.3 ETC性能评估
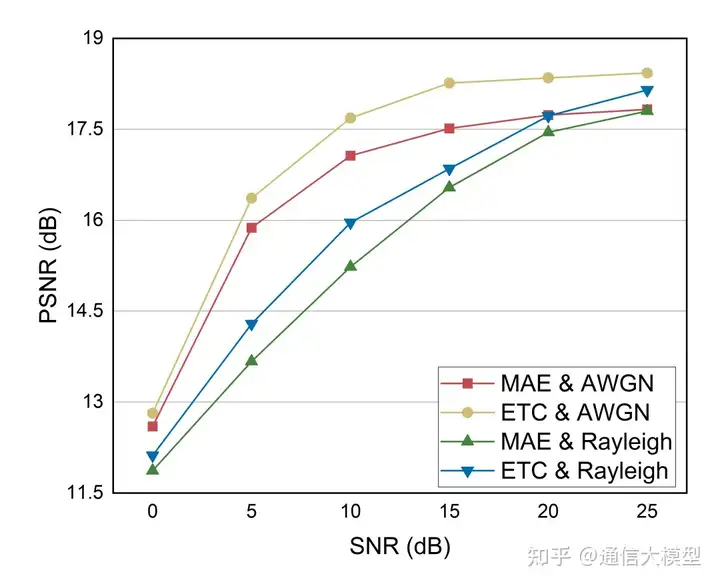
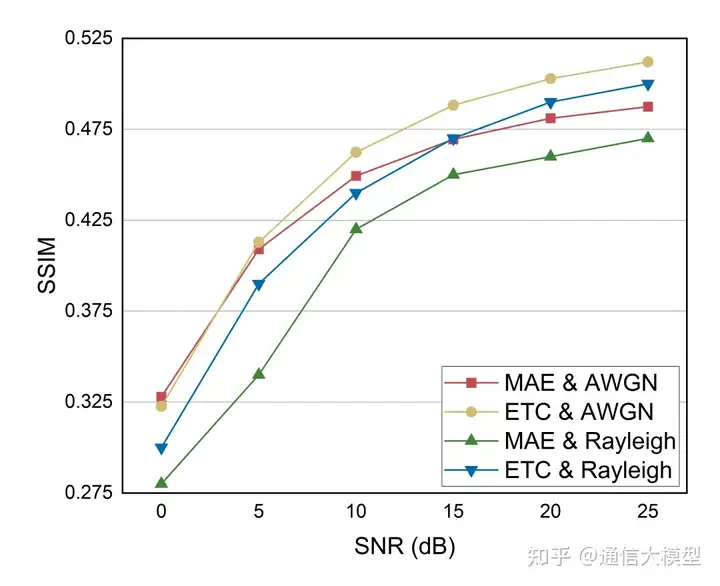
峰值信噪比(PSNR)和结构相似性指数(SSIM)是评估图像重建质量的广泛使用的指标。PSNR通过测量原始图像与重建图像之间的均方误差(MSE)来量化保真度,较高的值表示较小的失真。SSIM通过联合考虑亮度、对比度和结构一致性来评估感知相似性;接近1的值表示更高的相似性。我们首先比较在AWGN和瑞利衰落信道下,LKB指定区域内重建内容的PSNR和SSIM。在该实验中,分别使用ETC和标准MAE作为编码器--解码器骨干。由于LKB区域对应任务相关物体,这些指标直接反映了TokenCom旨在保留的关键内容的重建质量。实验结果如图9所示。
如图9(a)和图9(b)所示,ETC在LKB指定区域内的PSNR和SSIM显著高于MAE。这表明,ETC不仅继承了MAE风格的掩码编码效率,还提高了以物体为中心的重建保真度。性能提升来自两个方面:(i)ETC通过仅对少部分小块进行编码保持了压缩优势,和(ii)其LKB引导的自适应掩码将有限的编码预算优先分配给与物体相关的小块,从而减少了背景主导冗余的负面影响。
(a)
(b)
图9:ETC和MAE在AWGN和瑞利衰落信道下的重建质量
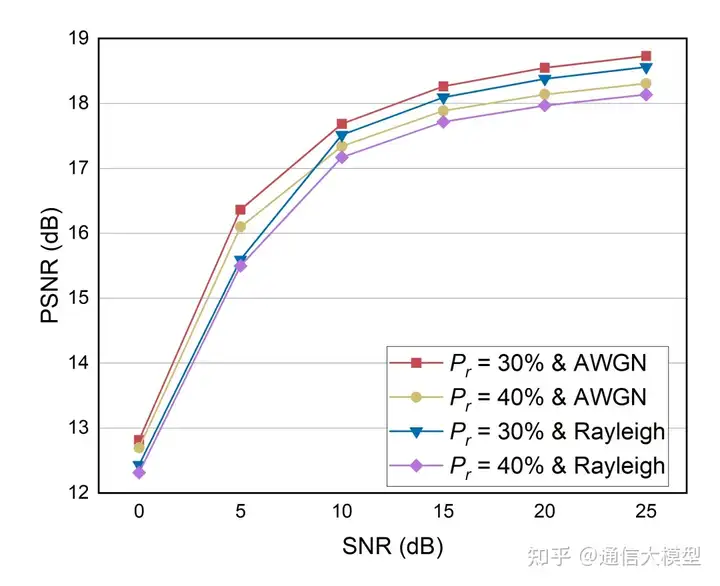
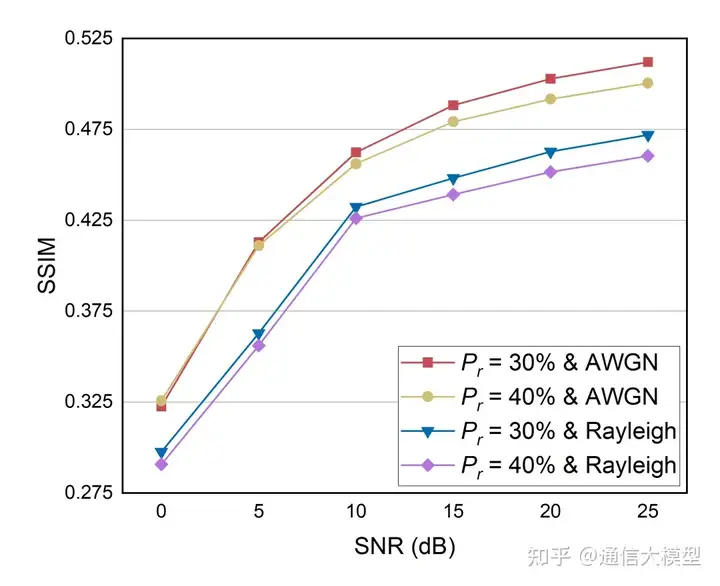
为了进一步研究物体补丁的掩码概率(记为 Pr)的影响,我们在AWGN和瑞利衰落信道下进行了不同Pr 值的消融实验,如图10所示。如图10(a)和图10(b)所示,当Pr 设置为30%时,重建质量达到最佳。若将Pr 增加到30%以上(例如40%),重建质量会下降,这表明过于保守的掩码策略可能会稀释编码预算,削弱物体为中心的表示。与MAE中的随机掩码相比,所提出的自适应掩码在物体区域的重建质量上持续改进。然而,背景小块不能完全被忽略,对背景掩码的残余依赖仍然会影响最终的重建。
掩码的敏感性还依赖于物体的尺度。使用固定的 Pr 值简单有效,但当目标占据图像的极大比例时,可能会偏离最优值。对于非常大的目标,过低的Pr(即激进掩码)可能会丢弃有信息的边界/上下文小块,降低重建保真度;对于非常小的目标,过高的 Pr 值则倾向于保留太多背景小块,导致冗余并降低传输效率。图10(a)和图10(b)中的经验最优值约为30%,这一轻微的尺度依赖性是吻合的。在实际应用中,一个基于目标区域比例的尺度感知调度(例如Pr∈0.2,0.4)可以提高鲁棒性。
(a)
(b)
图10:ETC在不同掩码概率下的重建质量
5.4 MTS传输性能评估
公共Token在不同图像中通常会重复出现,这使得在多无人机Token通信系统中通过Token重用来减少带宽成为一种自然结果。然而,随着无人机数量的增加,"公共"Token的定义变得更加严格,因为在少量无人机之间一致的Token,在加入具有不同观察结果的新无人机后可能不再保持一致。因此,公共Token集可能会缩小,带宽节省可能会饱和或略微下降。在我们的仿真中,我们评估了不同的阈值 ϵ 用于公共Token的识别,并逐步增加无人机的数量,从2增加到10。我们报告了数据压缩比,它定义为节省的传输数据与总传输数据的比例,结果如图11所示。
如图11所示,在不同ϵ 设置下,数据压缩比通常随着无人机数量的增加而增加,但增益逐渐饱和,并且当无人机群体变大时可能会略微下降。此外,较大的 ϵ 放宽了公共Token的标准,导致重用率持续较高,下降趋势较缓。在初期(较小的 K),增加无人机数量提高了不同图像共享公共模式的可能性,因此更多的公共Token可以被重用,曲线逐渐上升。随着 K 进一步增加,无人机之间的多样性变得更加显著,更多的Token被归类为私有,从而减少了共享的增益,并可能导致压缩比的轻微下降。
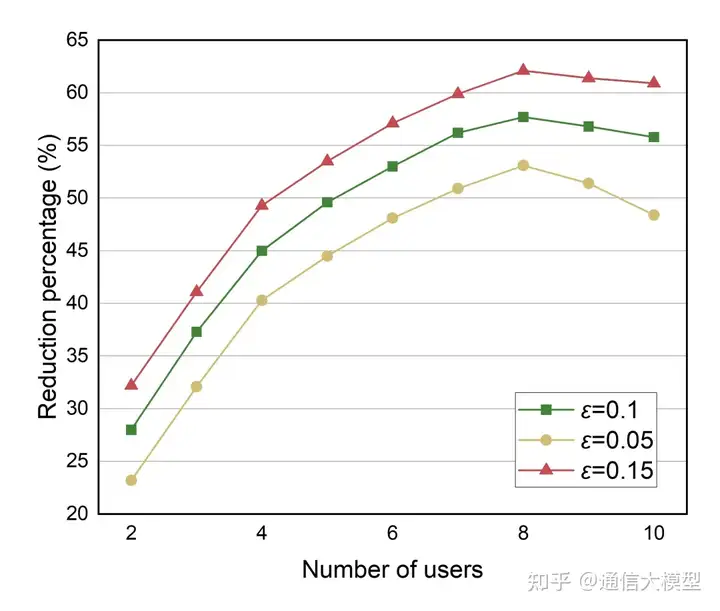
图11:用户规模对数据压缩比的影响
5.5 TokenCom 性能评估
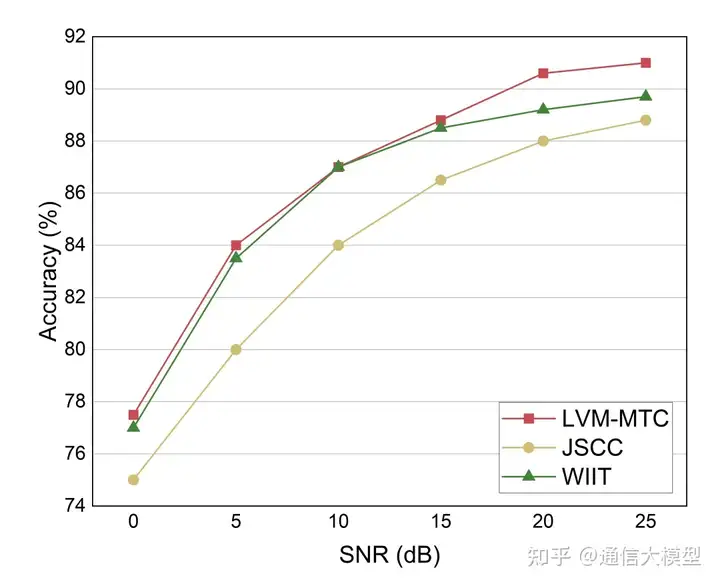
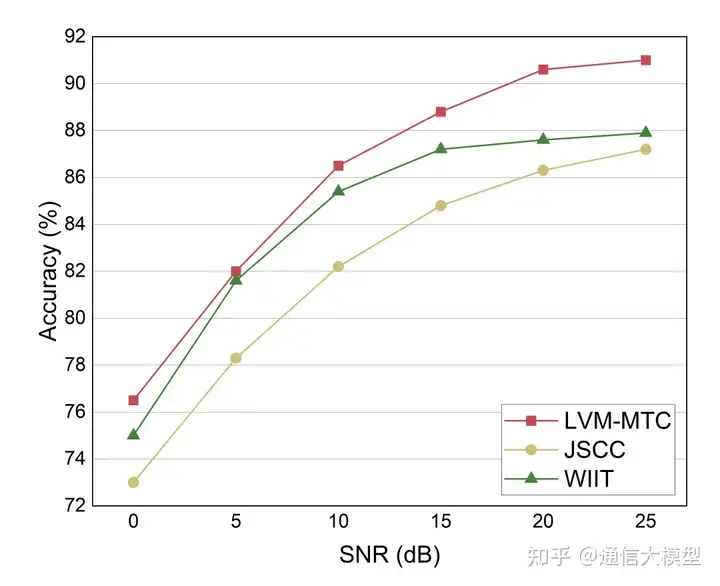
为了评估LVM-MTC系统在图像分类任务中的性能,我们将其与基于CNN(JSCC)和ViT(WITT)的两个语义通信系统(SC)进行比较,使用的测试数据集是CIFAR-10,评估的性能指标是分类准确率。实验结果如图12所示。
如图12所示,在两种信道环境下,LVM-MTC和WITT在分类准确率方面均优于JSCC。这是因为LVM-MTC和WITT都采用了基于Transformer架构的Token/语义编码器,使其能够比基于CNN的JSCC更有效地提取图像特征。此外,在较高SNR水平下,LVM-MTC的性能优于WITT。这可以归因于LVM-MTC中Token编码器和LKB的协同作用,使得系统能够更专注于图像中的主要物体,同时最小化背景噪声和其他无关信息的影响。
(a) AWGN
(b) Rayleigh Fading
图12:不同方法在分类任务中的性能比较
6. 结论
该系统专为无人机辅助低空无线网络设计。系统的核心在于构建一个LKB,基于定制的FlashSAM模型,能够快速且准确地感知无人机拍摄图像中的关键语义物体。此外,系统引入了基于MAE架构的ETC,通过选择性地对物体相关区域的像素进行编码,实现了高效的Token化和压缩。进一步地,我们开发了一个多无人机Token空间及其对应的MTS传输策略,支持多个无人机之间的公共/私有Token分离和Token重用。仿真结果验证了所提LVM-MTC系统的可行性和有效性。
从系统部署的角度来看,广播公共Token可能通过泄露敏感目标线索引发隐私暴露风险。因此,实际部署应当结合访问控制、Token级语义过滤和隐私保护Token化机制。同时,多个无人机之间轻量级LKB的一致性可以通过定期的模型/元数据同步来维持。展望未来,所提出的LKB--ETC流程和多无人机Token空间为视频和多模态Token通信、动态环境中的在线知识/编解码适配以及基于Agent的无人机协作提供了可借鉴的基础。未来的工作将通过研究海面传播效应并开发相应的数据集,进一步扩展系统到海洋及其他跨领域环境。
