别急着学 Python:Java 工程师做 AI 的全链路落地实战手册
上个月面试一个 Java 候选人时,我问了个问题:"Java 工程师做 AI,机会到底在训练还是落地?"不少人愣了一下,憋出一句"我得业余学学 Python"。其实真不用。这篇把我从真实项目里整理出来的 AI 落地工程方法论完整写出来,适合想转 AI 方向、又不想丢掉老本行的 Java 同学。干货有点密,建议先收藏。
一、先别急着学 Python,落地才是 Java 的主场
先给结论:训练是算法岗的战场,落地才是 Java 工程师的主场。
训练侧拼的是 GPU、数据、论文,全球能玩的公司不超过十几家,岗位占比不到 5%;而落地侧要把模型能力稳定、安全、便宜地塞进业务系统 ,95% 的需求都在这里。如果把一个 AI 项目的工作量拆开:数据准备约占 20%,模型训练约占 15%,工程落地约占 65%------最大的一块蛋糕在最后面。
训练是"造发动机",落地是"造整车 + 修高速 + 建加油站"。造发动机的就那么几家,但用发动机造汽车、造机床、造家电的市场,才是绝大多数人的机会。
| 维度 | 模型训练(算法团队) | 工程落地(Java 团队) |
|---|---|---|
| 核心动作 | 数据清洗、微调、评测、蒸馏 | 接入、编排、治理、集成 |
| 技能栈 | PyTorch、CUDA、分布式训练 | Spring、JVM、网关、中间件 |
| 交付物 | 模型权重、checkpoint | 能上线、能收费的功能 |
| 核心目标 | 提升精度、降低训练损失 | 保障 SLA、业务集成、成本可控 |
| 性能关注点 | 训练吞吐量、GPU 利用率 | 推理延迟、并发量、资源占用 |
| 上手成本 | 高(脱产 1~2 年) | 低(叠加一层 AI 应用能力) |
| 模型换代时 | 换模型 ≈ 重新训练 | 换模型 = 改一条配置 |
| 价值体现 | 模型指标提升 | 转化率、效率、成本、满意度提升 |
从商业回报看也更现实:训练是赢者通吃、失败率极高的游戏;落地是碎片化需求、百花齐放,确定性强得多。
为什么说是 Java 的主场?三个理由:
- 模型被"API 化"了。调模型变成一次 HTTP 调用,稀缺的不再是模型,而是"怎么把它用稳"。
- AI 项目 80% 是脏活。数据清洗、网关、限流、审计、灰度、回滚------全是 Java 的老本行。
- AI 的失败模式是工程问题。上线后挂掉,99% 不是模型不行,而是超时、上下文爆炸、成本失控。
再看 Java 工程师的三条护城河:
- 存量系统:公司的订单、支付、风控、ERP、供应链核心系统绝大多数是 Java 写的,AI 必须长在这些系统上,这是"最后一公里",绕不开;
- 工程治理:限流、熔断、灰度、可观测、多租户------这些模型不会,Python 工程师也不一定熟;
- 企业级集成 :权限、网关、配置中心、审计、灰度发布,Spring 生态全是现成积木,接 AI 和接支付宝没有本质区别。
💡 一句话记忆:大模型在 Java 世界里,本质上就是"另一个能聊天的第三方 RESTful 服务"------只是它特别慢、特别贵、还偶尔胡说八道。
想清楚这一点,你的定位就清楚了:不是转行做算法,而是做 LLM Application Engineer(AI 应用架构师) ,核心能力就四个字------让 AI 靠谱地跑在生产环境里 。如果画一张机会地图:模型层门槛高、机会少;框架层(Spring AI / LangChain4j)可以参与;应用层(RAG / Agent / 网关 / 评测 / 治理)才是需求最大的主战场。
模型是买来的水电煤,Java 负责盖楼和物业。楼怎么盖,往下看。
二、动手前先看清全景:一张图搞懂 AI 落地
AI 落地的技术栈是分层的,Java 工程师的主战场在中间两层:
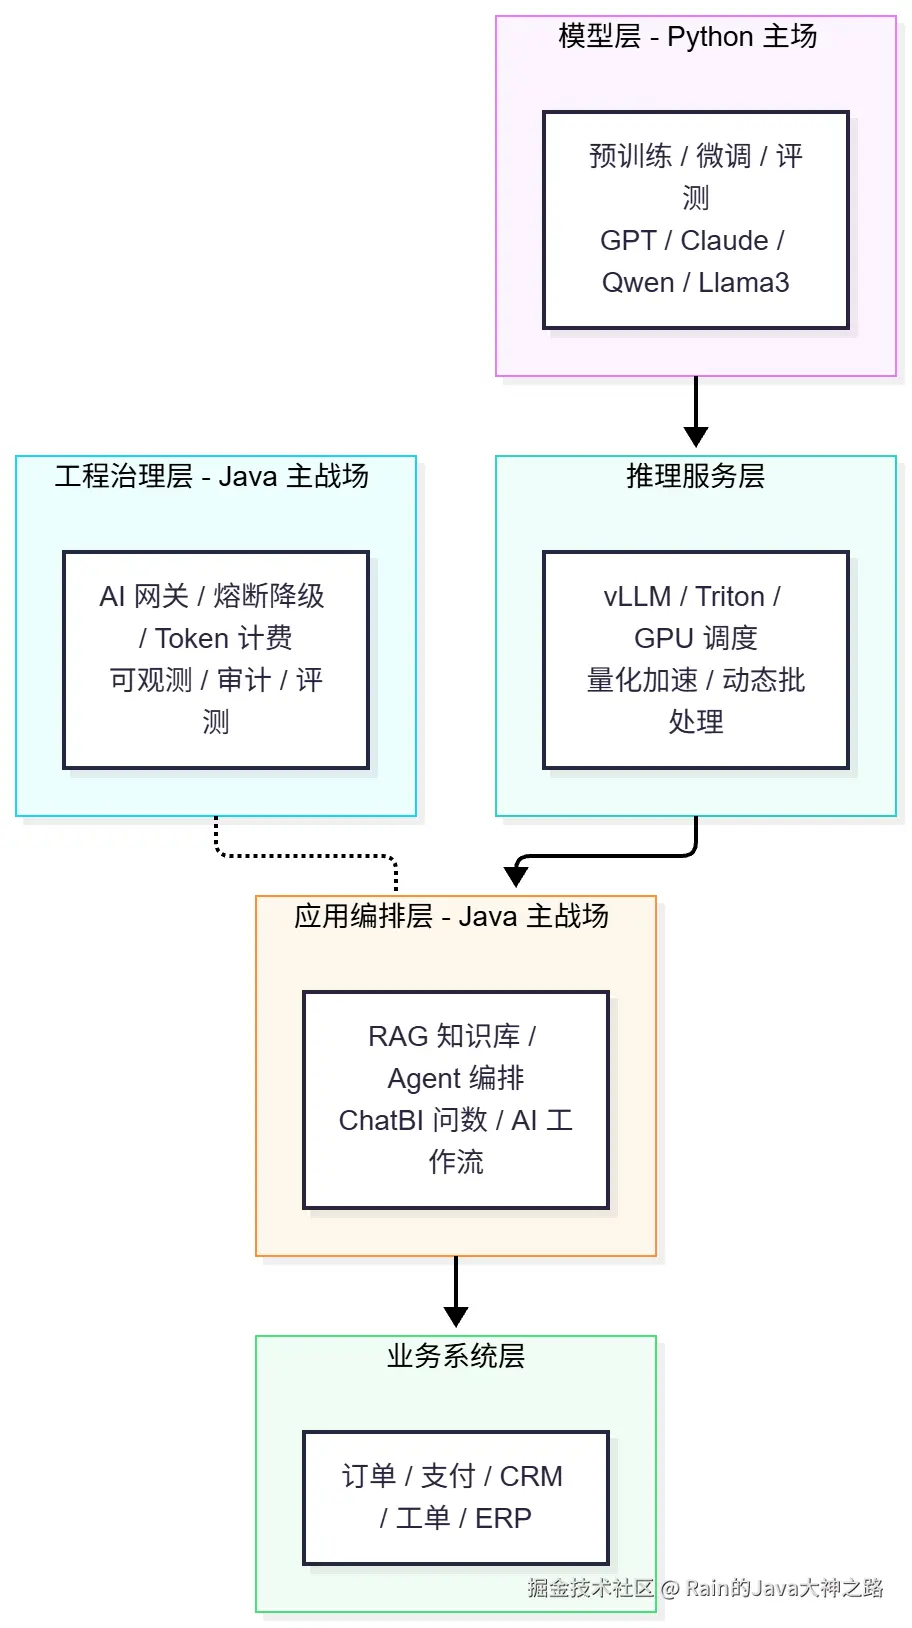
越往下,"Java 味"越浓,越不可替代。90% 的 AI 研发工作其实都集中在"应用层 + 编排层",根本不需要从零训练模型。
一条完整的线上请求链路长这样:

这条链路里真正体现竞争力的,不是"调通了大模型",而是缓存、熔断、降级、计费、溯源------全是 Java 后端的看家本事。
落地场景说穿了就四大战场,面试和实际项目基本都绕不开:
| 场景 | 一句话价值 | Java 侧关键动作 |
|---|---|---|
| 企业知识库 RAG | 让模型"懂"你们的私有文档 | 文档解析 → 分块 → 向量化 → 混合检索 → 精排 → 引用溯源 |
| Agent 工具编排 | 让模型"能干活":查订单、改工单 | 工具注册、Function Calling、多轮状态机、幂等与超时 |
| 智能问数 ChatBI | 让业务自己查数据,不用排队等 SQL | NL2SQL、Schema 召回、SQL 校验白名单、结果图表化 |
| AI 能力中台 / 网关 | 让全公司低成本、合规地用上模型 | 统一入口、多模型路由、Token 计费、审计脱敏、灰度切流 |
再往细分,主流的落地赛道有四个方向:企业级 RAG 知识库 (智能客服、合同审核、知识检索)、Agent 工作流编排 (审批、报表、数据查询)、存量业务系统智能化改造 (异常根因分析、内容审核、表单生成)、私有化推理服务封装(接口封装、推理加速、权限管控)。
不知道从哪下手的话,听我一句劝:先从知识库 RAG 做起。讲个我实际做过的项目。
实战案例:智能客服中台
背景很典型:客服系统是 Java 微服务集群,知识散落在 Confluence、工单系统、FAQ 表里,坐席每天重复回答 60% 的常见问题。
目标只有一句:提升自助首答率,且不能拖垮现有链路------模型挂了,客服系统必须还能用。
落地分三步:
- 先建 AI 网关做统一入口:鉴权、限流、多模型路由、Token 计费、日志脱敏,业务代码只认一个逻辑模型名;
- 再建 RAG 知识库:文档解析入库 + 混合检索 + 精排 + 引用溯源;
- 最后补 稳定性:独立线程池隔离、阶梯超时、三级降级、全链路埋点。
存储层就是 Java 熟悉的老配方:MySQL 存业务、Redis 做缓存、Milvus 存向量、ES 做关键词索引。结果:常见问题自助解决率显著提升,大模型故障时自动降级,可用性不受影响。
这个案例有个普适的模板意义:算法团队交付的是"能力",Java 工程师交付的是"产品"。能力不落进业务系统,就只是个 Demo。
把落地这件事浓缩成四个词:接入业务、控制成本、保障稳定、闭环评估。后面所有章节,都是围绕这四个词展开的。
生产卡点一览:先有地图,再上路
实际开发中经常遇到的问题,我整理成了一张清单。先看个全景,后面每章会逐个拆:
| # | 卡点 | 典型症状 | 解决方案(关键手段) |
|---|---|---|---|
| 1 | LLM 慢且抖、默认超时太长 | 秒级延迟;一个下游慢拖垮全站 | 异步 + SSE 流式 + 阶梯显式超时(按 P99 定)+ 熔断降级 |
| 2 | 限流雪崩 | 线程池打满、级联失败 | 独立线程池隔离 + 令牌桶 + 排队上限 + 快速失败 |
| 3 | ToolCall / JSON 格式乱 | 解析异常、接口 500 | 容错解析 + Schema 校验 + 重试一次 + 降级纯文本 |
| 4 | 上下文无限膨胀 | 越聊越贵、模型"失忆" | 滑动窗口 + 摘要压缩 + 稳定前缀(别硬截断);长文档 Map-Reduce 总结 |
| 5 | RAG 答非所问 | 召回不相关、漏关键词 | 混合检索 + RRF + Rerank + 父子分块 + 查询改写 / HyDE |
| 6 | 幻觉 | 一本正经胡说八道 | 强约束 Prompt + 引用溯源 + 无召回拒答 + 关键字段白名单 |
| 7 | 成本失控 | Token 烧钱 | 语义缓存 + Prompt Cache + 级联路由 + 上下文裁剪;盯重试率 |
| 8 | AI 调用与 DB 不一致 | 重复下单、重复发券 | 幂等键 + 本地消息表 + 事务后置 + 对账 |
| 9 | 模型绑定过死 | 换模型要改代码、重发版 | 逻辑模型名 + Provider 适配层 + 配置化灰度切流 |
| 10 | 数据安全与注入 | 敏感信息出域、用户诱导模型违规 | 私有化部署 + PII 脱敏 + 租户隔离 + 双向过滤护栏 + 审计 |
| 11 | 知识过期 | 文档改了,向量库还是旧的 | CDC 增量索引 + 文档版本号 + 失效自动重建 |
| 12 | 效果不可度量、不可观测 | 全靠用户反馈才知道挂了 | Golden Set 回归 + 日志回放 + 全埋点(QPS / 延迟 / Token / 失败率 / 降级次数 / 命中率) |
这张表建议存下来,上线前对着过一遍,能避开 80% 的坑。接下来我们从第一步------建"门"开始。
三、AI 网关:落地的第一步是先把"门"修好
为什么要先建网关?今天用 OpenAI,明天换通义,后天私有化部署 vLLM,这种事太常见了。各业务自己对接模型,换一次模型全公司一起发版,成本账更是一笔糊涂账。
网关的核心思想一句话:业务方只认"逻辑模型名",切换、降级、计费、审计都发生在网关内部 。这就是 Java 工程师最擅长的事------把不确定性封装起来。
3.1 统一调用入口:场景隔离 + 上下文裁剪 + 成本核算
java
@Service
public class LlmGatewayService {

    @Autowired private MultiLlmClient llmClient;
    @Autowired private PromptTemplateManager templateManager;
    @Autowired private ChatContextService contextService;
    @Autowired private LlmCostStatsService costStatsService;

    /**
     * 统一对话入口:安全校验 + 场景隔离 + 上下文裁剪 + 模型路由 + 成本核算
     */
    @CircuitBreaker(name = "llm-gateway", fallbackMethod = "chatFallback")
    @RateLimiter(name = "llm-global-limit")
    public ChatResult chat(String sessionId, String userInput, String sceneCode) {
        // 0. 内容安全前置校验:敏感内容在进入模型前就拦住,省一次冤枉调用
        if (!SafetyChecker.check(userInput).isPass()) {
            return ChatResult.fail("内容包含敏感信息");
        }

        // 1. 场景化 Prompt 模板:业务规则配置化,运营可改,无需发版
        String systemPrompt = templateManager.render(sceneCode,
                Map.of("userInput", userInput, "time", LocalDate.now()));

        // 2. 上下文自动裁剪:控制 Token 窗口,避免超量计费与接口报错
        List<ChatMessage> messages = contextService.buildContext(
                sessionId, systemPrompt, userInput, 4096);

        // 3. 大小模型路由:简单问题走便宜模型,复杂问题走大模型
        String model = ModelRouter.route(sceneCode, userInput);

        // 4. 统一参数约束:低温度 + 结构化输出,保证业务解析稳定
        ChatRequest request = ChatRequest.builder()
                .model(model)
                .messages(messages)
                .temperature(0.3)
                .responseFormat("json_object")
                .build();

        ChatResponse response = llmClient.chat(request);

        // 5. 上下文持久化 + 按场景统计成本
        contextService.appendMessage(sessionId, userInput, response.getOutput());
        costStatsService.record(sceneCode, model, response.getUsage());
        return ChatResult.success(response.getOutput());
    }

    /** 降级兜底:大模型不可用时返回规则化结果,保住业务可用性 */
    private ChatResult chatFallback(String sessionId, String userInput,
                                    String sceneCode, Exception e) {
        log.warn("大模型熔断降级, scene:{}", sceneCode, e);
        return ChatResult.success("助手繁忙,已切换精简模式,请简化问题后重试");
    }
}
这段代码有四个亮点:
- 场景化 Prompt 模板:业务规则与代码解耦,运营可配置,无需发版;
- 上下文自动裁剪:精准控制 Token 消耗,避免超量报错;
- 大小模型智能路由:平衡效果与成本,我在一个项目里实测能降 60% 左右的调用费用;
- 熔断降级 + 限流:避免 AI 故障拖垮业务,这是 Java 后端高可用的标准动作。
再补几个细节:限流要细到用户维度,比如 @RateLimiter(key = "#userId", permitsPerSecond = 5);内容安全校验一定要放在进模型之前 ,省一次冤枉钱。想接入得更优雅,还可以封装注解式 AOP 切面,业务方一个 @AiAbility 注解就能注入 AI 能力,跟调普通 RPC 一样。
3.2 多模型级联路由:贵模型挂了,自动落到便宜模型
✨ 技术亮点:把模型当成不稳定的外部依赖来治理------贵模型失败自动落到便宜模型,最后落到本地兜底,绝不把"转圈圈"丢给用户。
java
@Component
public class MultiModelRouter {

    /** 逻辑模型名 -> 真实接入点,按「能力/成本」排成级联链:一级贵 -> 二级便宜 */
    private final List<ModelEndpoint> cascade;
    private final CircuitBreakerRegistry cbRegistry;
    private final LlmMetrics metrics;

    public String chat(ChatRequest req) {
        for (ModelEndpoint ep : cascade) {
            CircuitBreaker cb = cbRegistry.circuitBreaker(ep.name());
            try {
                long t0 = System.nanoTime();
                String answer = CallableDecorators.decorate(
                        () -> ep.client().call(req), cb)   // 熔断保护
                        .call();
                metrics.record(ep.name(), System.nanoTime() - t0, "success");
                return answer;
            } catch (Exception ex) {
                // 关键:降级要打点,否则你永远不知道模型在偷偷降级
                metrics.counter("llm.fallback").increment();
                log.warn("model={} 不可用,降级到下一级. cause={}", ep.name(), ex.toString());
            }
        }
        return localFallback(req);   // 三级:本地兜底
    }

    /** 三级兜底:缓存 FAQ,兜不住就转人工 */
    private String localFallback(ChatRequest req) {
        return cache.findFaq(req.getQuestion())
                .map(Faq::getAnswer)
                .orElse("当前咨询人数较多,已为您转接人工客服,请稍候~");
    }
}
注意 metrics.counter("llm.fallback").increment() 这一行------降级必须打点,否则你永远不知道模型在偷偷降级,直到某天效果暴跌还查不到原因。这是我踩过的坑,排查了两天。
3.3 路由策略:敏感度、复杂度、成本三个维度
Provider 层建议用 sealed interface LlmProvider 抽象,每个实现提供 supports() 和 stream() 两个方法,屏蔽各家模型 API 的差异。路由逻辑三行就能说清:
java
private LlmProvider route(ChatRequest request) {
    if (request.isSensitive()) {                       // 敏感数据:走私有化模型,不出域
        return requireProvider(PrivateVllmProvider.class);
    }
    if (request.estimatedTokens() < 800) {             // 简单问题:走小模型,降成本
        return requireProvider(SmallModelProvider.class);
    }
    return requireProvider(CloudLargeModelProvider.class); // 复杂推理:走大模型
}
敏感走私有、简单走小模型、复杂走大模型------成本降得下来,合规也保得住。
3.4 阶梯超时与连接池:压测时最容易翻车的地方
⚠️ 踩坑提醒 :很多 SDK 的默认超时是 60s 甚至无限。一个下游变慢,线程池几分钟就被占满,故障会从"一个接口慢"扩散成"整个服务不可用"。我之前就踩过,现场相当惨烈。
java
@Bean
public WebClient llmClient() {
    return WebClient.builder()
            .baseUrl(llmBaseUrl)
            .clientConnector(new ReactorClientHttpConnector(
                    HttpClient.create()
                            .option(ChannelOption.CONNECT_TIMEOUT_MILLIS, 5000)  // 连接 5s
                            .responseTimeout(Duration.ofSeconds(30))             // 响应 30s
                            .wiretap(true)   // 调试用,上线关掉
            ))
            .build();
}

// 阶梯式超时:一级 3.5s,二级 1.5s,超时立即 Fast Fail,不拖线程池
public String call(String prompt, long timeoutMs) {
    return llmClient.post()
            .uri("/v1/chat/completions")
            .bodyValue(Payload.of(prompt))
            .retrieve()
            .bodyToMono(String.class)
            .timeout(Duration.ofMillis(timeoutMs))   // 必须显式设置
            .block();
}两个数字:连接超时 5s、响应超时 30s,一定要根据模型推理速度调优,否则高并发下连接池直接被打满。超时值按 P99 定,再逐步收紧。
3.5 流式 SSE 网关:幂等和预算熔断是两道容易漏的关
AI 应用的生产难题可以概括成一句话:流式响应 + 长耗时 + 高成本 + 不稳定。SSE 网关有三道容易漏的关:
java
@GetMapping(value = "/chat/stream", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
public SseEmitter streamChat(@RequestBody ChatRequest req) {
    SseEmitter emitter = new SseEmitter(90_000L);

    // ① 会话级幂等:防止客户端重试导致重复扣费
    String dedupeKey = req.getSessionId() + ":" + req.getTraceId();
    if (!idempotent.tryAcquire(dedupeKey)) {
        emitter.complete();
        return emitter;
    }

    // ② 成本预算熔断:单用户 / 单租户预算打穿,直接拒绝
    if (!budgetGuard.trySpend(req.getTenantId(), estimateTokens(req))) {
        sendSafe(emitter, Result.fail("今日额度已用完"));
        emitter.complete();
        return emitter;
    }

    // ③ 降级链:主模型 -> 小模型 -> 缓存答案
    FallbackChain chain = FallbackChain.of(primaryModel, liteModel, cacheAnswer);

    chain.stream(req)
         .timeout(Duration.ofSeconds(30))                   // 首 token 超时
         .retryWhen(Retry.max(1).filter(this::isRetryable)) // 只重试可重试异常
         .subscribe(
             token -> sendSafe(emitter, token),
             err   -> degrade(emitter, err),                // 降级不抛栈给用户
             emitter::complete
         );
    return emitter;
}- 会话级幂等:防止客户端重试导致重复扣费;
- 成本预算熔断 :单租户预算打穿直接拒绝------记住,AI 场景里限流不只是保稳定性,更是保预算,这是它和普通 RPC 调用的本质区别;
- 降级链:主模型 → 小模型 → 缓存答案,降级时别把异常栈丢给用户。
门修好了,接下来是面试被问得最多、业务里最常用的问题:怎么让模型"懂"你们的私有文档?这就是 RAG。
四、RAG 知识库:效果的 80% 取决于召回,而不是模型多聪明
先给个反直觉的结论:RAG 的效果,80% 取决于检索召回,而不是模型多聪明 。朴素 RAG(向量库 + Prompt 直接怼)在企业内网的准确率常常不到 60%,问题基本都出在检索上。答不好先查召回,别急着换模型。
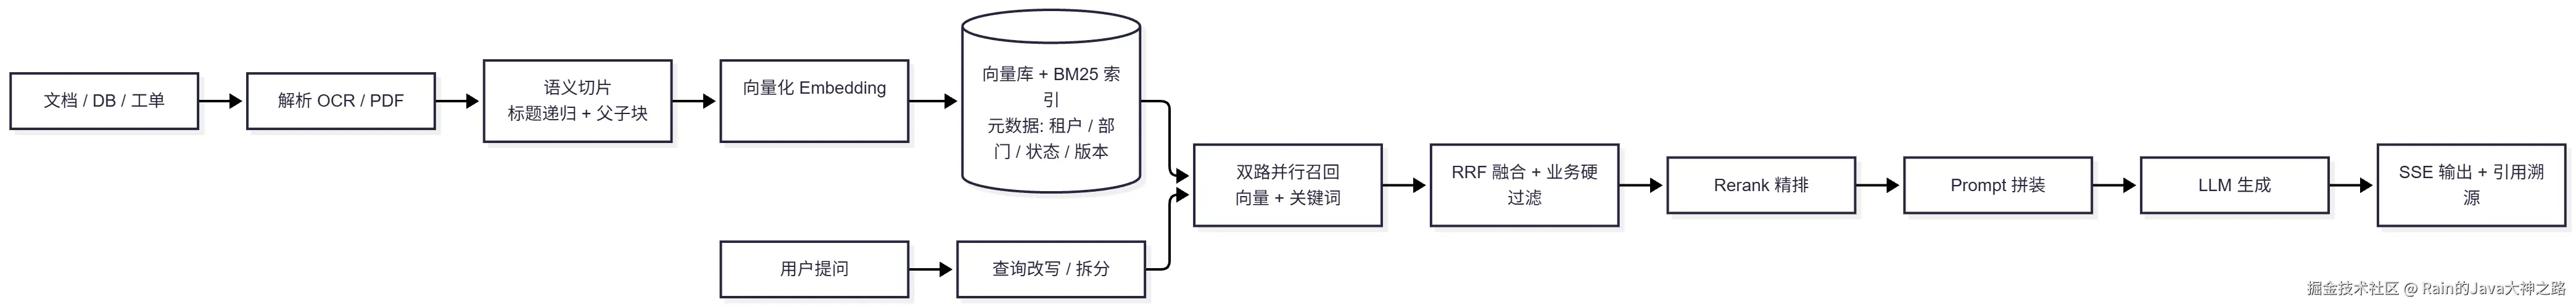
完整链路长这样:
4.1 分块:固定长度切是万恶之源
固定长度切会把语义切断------"问题在上半截、答案在下半截"是最常见的事故。实践中用两招:
- 按标题层级递归切,保留文档结构;
- 父子块(small-to-big):小块用于精准召回,召回后回带父块给模型补上下文,防止信息截断。
说句大实话:RAG 项目里花时间最多的,根本不是调 Prompt,而是切块策略、元数据过滤、重排这三件事。
4.2 混合检索 + RRF:向量管语义,BM25 管术语
为什么必须混合?举个真实例子:用户问"死信队列的告警阈值是多少",纯向量检索会自信地返回一堆"消息队列高可用架构",唯独漏掉那篇写着具体数字的运行手册。向量检索会把错误码、型号、订单号这类低频高信息词"平均掉",而关键词检索认不出同义词------谁都替代不了谁。
✨ 技术亮点:双路并行召回(串行会让 P99 直接翻倍)+ RRF 免归一化融合 + 超时降级。
java
public List<Chunk> hybridSearch(String query, int topK) {
    // ① 向量检索:擅长语义
    CompletableFuture<List<Chunk>> vecFuture = CompletableFuture.supplyAsync(
            () -> vectorStore.search(embedding.embed(query), 50), searchPool);

    // ② BM25 关键词检索:擅长精确术语匹配
    CompletableFuture<List<Chunk>> bm25Future = CompletableFuture.supplyAsync(
            () -> bm25Retriever.search(query, 50), searchPool);

    // ③ 并行等待 + 超时降级:检索卡住就退化为只用向量召回,P99 不炸
    List<Chunk> merged = vecFuture
            .thenCombine(bm25Future, (v, b) -> rrfFuse(v, b, 60))
            .orTimeout(300, TimeUnit.MILLISECONDS)
            .exceptionally(e -> vecFuture.join())
            .join();

    // ④ 业务硬过滤(权限 / 时效 / 部门)+ Cross-Encoder 精排
    return reranker.rerank(query, businessRuleFilter(merged), topK);
}

/** RRF: score(d) = Σ 1/(k + rank_i(d)),k 通常取 60;只看排名不看分数,天然免疫量纲不一致 */
private List<Chunk> rrfFuse(List<Chunk> a, List<Chunk> b, int k) {
    Map<String, Chunk> dic = new HashMap<>();
    Map<String, Double> score = new HashMap<>();
    for (List<Chunk> list : List.of(a, b)) {
        for (int i = 0; i < list.size(); i++) {
            Chunk c = list.get(i);
            dic.putIfAbsent(c.id(), c);
            score.merge(c.id(), 1.0 / (k + i + 1), Double::sum);
        }
    }
    return score.entrySet().stream()
            .sorted(Map.Entry.<String, Double>comparingByValue().reversed())
            .map(e -> dic.get(e.getKey()))
            .toList();
}
两个细节值得展开:
- RRF 只看排名不看分数,天然解决了两路分数量纲不一致的问题,免调参、极鲁棒;
- 业务硬过滤不能省 :权限、时效、部门。检索到越权知识不是效果问题,是数据安全事故。
元数据治理要从入库那天做起:tenantId、部门、状态、版本四个维度一个都不能少。用 Spring AI 的话,QuestionAnswerAdvisor 一行就能注入 RAG,检索条件用 filterExpression(比如 tenantId == 't001' && status == 'published'),topK(8)、similarityThreshold(0.62) 这些参数跟着评测结果调。
企业知识问答最怕两件事:检索到错误知识 ,模型一本正经胡说;检索到越权知识,直接是安全事故。所以 RAG 必须同时解决"权限"和"准确性"。
4.3 精排:解决 "Lost in the Middle"
融合之后的候选还是噪,用 Cross-Encoder 做精排,把真正相关的顶到最前面。别嫌麻烦------相关文档就算进了 Top-10,只要排在第 8 位,模型也可能"看不见"。
这套组合拳(混合召回 + 分块优化 + Rerank)下来,我们一个知识库的问答准确率从 60% 提到了 90% 以上。
4.4 纯 Java 的轻量方案:Lucene 9.x KNN
如果知识库规模不大,不想额外运维一套向量数据库,还有个轻量的选择:Lucene 9.x 原生 KNN 向量索引。纯 Java 依赖,毫秒级召回,还能叠加业务字段过滤:
java
public List<KnowledgeDoc> searchTopN(String queryText, int topN) throws IOException {
    // 1. 生成查询向量(本地 Embedding 模型或远程接口)
    float[] queryVector = embeddingService.encode(queryText);

    // 2. KNN 近邻查询,可叠加业务字段过滤
    KnnFloatVectorQuery query = new KnnFloatVectorQuery(
            "vector_field", queryVector, topN,
            new TermQuery(new Term("biz_type", "product_manual")));

    // 3. 执行检索并封装结果
    IndexSearcher searcher = new IndexSearcher(reader);
    TopDocs topDocs = searcher.search(query, topN);
    return Arrays.stream(topDocs.scoreDocs)
            .map(sd -> toKnowledgeDoc(searcher, sd))
            .collect(Collectors.toList());
}
等规模上来了,再平滑迁到 Milvus / PgVector / ES,检索逻辑不用大改。
4.5 召回不准怎么排查:分段四步法
用户问"年假"却召回了"病假"文档,别慌,按链路分段排查:
- 分块:是不是被切断了?改语义分块 + 重叠窗口;
- 检索:纯向量对专有名词弱?上 BM25 混合检索;
- 排序:候选进了 Top-10 但排名靠后?加 Rerank;
- 查询:用户措辞和文档措辞差太远?上查询改写 / HyDE。
觉得这一节有用的话,可以先点个关注,后面的 Agent、成本优化和稳定性治理更硬核,不迷路。
模型能"懂"文档了,下一步是让它"干活"------查订单、建工单、催发货。这就是 Agent,也是坑最多的地方。
五、Agent 与 Function Calling:让模型干活,但别让它碰数据库
先看一个真实场景。用户问:"我的订单 3 天了还没发货,能不能帮我催一下?"AI 不能只会聊天,它得:理解意图 → 查订单系统 → 检索售后政策知识库 → 判断是否满足催单条件 → 调工单系统创建催办 → 给用户有依据的回答 → 记录日志、审计、成本。
这一串编排,全是 Java 工程师的主场。
5.1 一个注解,把存量服务变成"工具"
Java 做 Agent 的杀手锏:存量系统就是资产 。给现有 Service 加一层 @Tool 注解,LLM 就能看懂并调用:
java
@Service
public class OrderTools {

    @Tool(description = "根据订单号查询订单状态和物流信息")
    public OrderStatus queryOrder(@Param("订单号") String orderId) {
        // 直接复用公司存量 Service,AI 就能"看懂"业务系统
        return orderRepository.findStatus(orderId);
    }
}

@RestController
public class ChatController {

    private final ChatClient chatClient;

    public ChatController(ChatClient.Builder builder, OrderTools tools) {
        this.chatClient = builder
                .defaultSystem("你是电商客服助手,只回答订单相关问题")
                .defaultTools(tools)   // 关键:LLM 自动决定何时调用
                .build();
    }

    // 流式输出:首 Token 延迟从 3s 降到 800ms,体验质变
    @GetMapping(value = "/chat", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
    public Flux<String> chat(@RequestParam String msg) {
        return chatClient.prompt().user(msg).stream().content();
    }
}
这里有两个亮点:
- LLM 只负责"理解意图 + 组织语言",业务操作全走 Java 方法------AI 不碰数据,只指挥数据,安全边界清晰;
- 流式输出是体验的分水岭:改 SSE 之后首 Token 延迟从 3s 降到 800ms。接入层的目标是首字 < 1.5s,达不到这个数,用户体感就是"卡"。
5.2 存量 Dubbo / RPC 接口也是资产
连 Service 都不用重写,直接把存量 RPC 接口包装成工具:
java
@Bean
ToolCallback refundTool(RefundService svc) {   // 存量系统就是资产
    return ToolCallback.builder("queryRefund")
        .description("按订单号查询退款进度;用户问'我的钱退了吗'时调用")
        .inputType(RefundReq.class)
        .call(req -> svc.query(req.orderId()))  // 直接复用 RPC,零重写
        .build();
}
**AI 不是另起炉灶,而是给存量服务加一层"自然语言入口"。**这句话在面试里讲出来,说服力很强。
5.3 执行层:反射调用 + 权限校验
如果是自己解析模型返回的函数调用指令,执行器要有三道关:
java
@Component
public class FunctionCallExecutor {

    private final Map<String, Method> functionRegistry = new ConcurrentHashMap<>();

    /** 执行大模型返回的函数调用指令 */
    public Object execute(FunctionCall call) {
        Method method = functionRegistry.get(call.getName());
        if (method == null) {
            throw new BizException("不支持的函数调用: " + call.getName());
        }

        // 1. 参数反序列化与校验
        Object[] args = ArgsParser.parse(method, call.getArguments());

        // 2. 权限校验:AI 只能操作用户有权限的资源
        PermissionChecker.check(method, UserContext.getCurrent());

        // 3. 反射执行业务方法(事务控制跟随业务方法)
        try {
            Object bean = SpringContextUtil.getBean(method.getDeclaringClass());
            return method.invoke(bean, args);
        } catch (Exception e) {
            throw new BizException("函数执行失败", e);
        }
    }
}注解式自动注册、参数自动映射校验、权限校验保证 AI 只能操作用户有权限的资源,最后反射执行 Spring Bean。工具描述写得越清晰,模型调用得越准。
5.4 工具调用安全:分级管控
AI 调业务接口,三个原则:最小权限、幂等执行、高危操作人工确认。
| 操作 | 风险等级 | 策略 |
|---|---|---|
| 查询订单 | 低 | 允许 |
| 查询用户手机号 | 中 | 脱敏后返回 |
| 创建工单 | 中 | 允许,但留审计 |
| 修改订单地址 | 高 | 二次确认 |
| 退款 | 高 | 只创建审批任务,人工审批 |
注意退款那行的处理方式:工具实现里不真的退款,只创建一条待审批任务。这样就算模型选错工具、传错参数(这就是"工具调用幻觉"),后果也是可控的。
配套的工程手段:工具描述标准化 + 参数强校验(JSR303)+ 执行结果二次核验 + 失败重试 + 单步拆解、禁止一次性多步调用。这套组合下来,Agent 任务完成率能提到 85%+。
5.5 Agent 还是 Workflow?
一条选型标准:流程可枚举,用 Workflow (可控);路径不确定,用 Agent(灵活,但要加护栏)。
千万别一上来就做 Agent------很多 AI 项目就死在"全能 Agent"的幻想上。这个下一节展开。
功能跑通了,能不能扛住生产?接下来是最硬核的一节:稳定性治理。
六、稳定性治理:把 LLM 当成"不靠谱的第三方依赖"
大模型推理的 P99 延迟能到几十秒,还会限流。这种"外部依赖又慢又抖"的场景,正是线程隔离、熔断、降级、重试退避的主场------Java 干了十几年的活。
6.1 阶梯式超时 + 三级降级
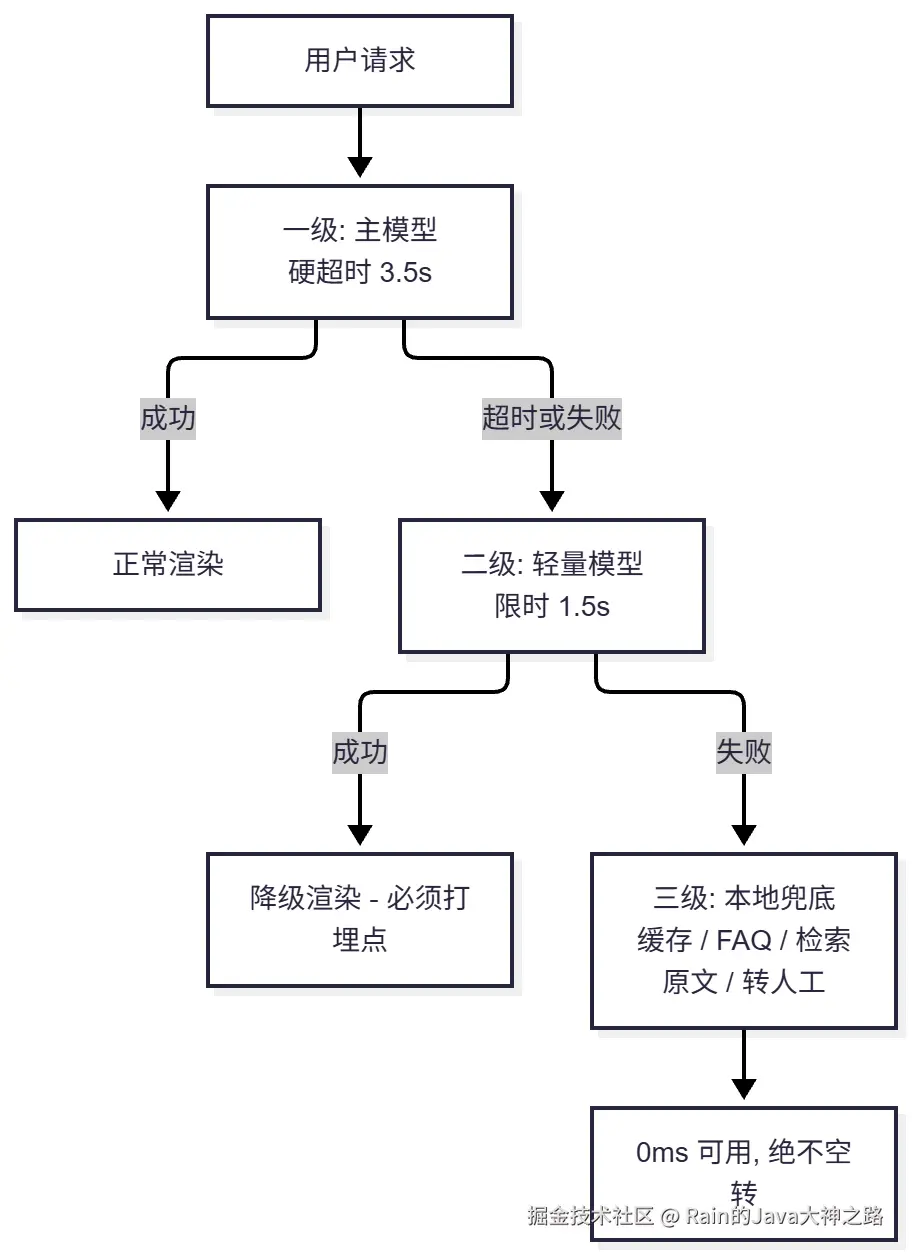
⚠️ 关键细节:降级要分级,不能瞎降。合同审阅、财务分析、正式客户回复这类高风险任务 ,主模型不可用时应该进人工审核队列或者排队,而不是盲目落到能力不足的小模型------降级降错了,比不回答更可怕。
6.2 保命三件套:重试、熔断、限流
注解式写法,Spring 同学闭眼都会:
java
@Retryable(retryFor = Exception.class, maxAttempts = 3)
@CircuitBreaker(name = "llmService", fallbackMethod = "fallback")
@RateLimiter(name = "llmLimiter")
public String callLLM(String prompt) {
    return chatModel.generate(prompt);
}

// LLM 是第三方黑盒服务,一定会挂------降级必须兜底
public String fallback(String prompt, Throwable t) {
    log.warn("LLM 降级触发, reason={}", t.getMessage());
    // 降级到知识库关键词检索,保证服务"半血可用"
    return ragService.keywordSearch(prompt)
            .orElse("客官稍安勿躁,正为您转接人工~");
}
响应式写法,适合流式场景:
java
public Flux<String> chat(String q) {
    return llmClient.stream(q)
        .timeout(Duration.ofSeconds(20))                 // 长尾延迟必须兜
        .retryWhen(Retry.backoff(2, Duration.ofMillis(500))
            .filter(ex -> !(ex instanceof TimeoutException)))  // 超时不重试,直接降级
        .onErrorResume(ex -> fallback(q))                // 降级:小模型 or 纯检索摘要
        .doOnNext(tok -> meter.increment(tok.length())); // Token 计量入账
}注意那个重试过滤器:超时不重试,直接降级------超时本身就说明链路在长尾上,重试只会雪上加霜。
6.3 结构化输出容错解析:不写这段,线上必炸
模型返回的 JSON 大概率带着 ```json 包裹、夹着解释文字、甚至少个括号,硬 parse 必抛异常:
java
private static final ObjectMapper MAPPER = new ObjectMapper()
        .configure(DeserializationFeature.FAIL_ON_UNKNOWN_PROPERTIES, false);

public <T> Optional<T> parseLoose(String raw, Class<T> type) {
    if (raw == null || raw.isBlank()) {
        return Optional.empty();
    }
    String cleaned = raw.replaceAll("```json|```", "").trim();

    // ① 截取第一个 '{' 到最后一个 '}',去掉模型聊的废话
    int left = cleaned.indexOf('{');
    int right = cleaned.lastIndexOf('}');
    if (left < 0 || right <= left) {
        return Optional.empty();
    }
    String json = cleaned.substring(left, right + 1);

    // ② 先原样解析,失败再尝试补全右括号后重试一次
    for (String candidate : List.of(json, repairBrackets(json))) {
        try {
            return Optional.of(MAPPER.readValue(candidate, type));
        } catch (JsonProcessingException ignore) {
            // 继续尝试下一个候选
        }
    }
    return Optional.empty();   // ③ 仍失败 -> 交给上层降级为纯文本展示
}

/** 常见修复:括号未闭合时补齐 */
private String repairBrackets(String json) {
    long missing = json.chars().filter(c -> c == '{').count()
                 - json.chars().filter(c -> c == '}').count();
    return json + "}".repeat((int) Math.max(0, missing));
}
四层容错:剥掉 markdown 包裹 → 截取 JSON 主体 → 补括号修复重试 → 还不行就降级纯文本。永远不要相信模型的输出格式,这是铁律。
6.4 限流雪崩与数据一致性:两个隐藏雷
- 限流雪崩 :模型侧一限流,请求全堆在线程池里,级联失败。解法:独立线程池隔离 + 令牌桶限流 + 熔断 + 排队上限,宁可快速失败也别拖死;
- AI 调用与 DB 不一致:模型重试导致重复下单、重复发券。解法:幂等键 + 本地消息表 + 事务后置 + 定期对账。
还有一个容易被忽略的:SSE 连接泄漏 。用户断连或网络抖动时,流可能残留在服务端。把 FluxSink 绑定到会话、监听 cancel 事件释放资源,再加个 timeout 操作符,长时间无数据自动关流。
稳定性兜住了,该聊钱了。AI 项目里,成本治理和稳定性同等重要------这也是面试官最爱追问的部分。
七、成本治理:省钱,但不降体验
先看一组数据,心里有个底:
| 手段 | 原理 | 大致收益 |
|---|---|---|
| 语义缓存 | Redis + 向量相似度,重复问题直出 | 省 30%--60% |
| Prompt Cache | 稳定前缀(System / 工具定义)命中后读取费极低 | 输入最高省 90% |
| 模型级联路由 | 便宜模型先答,质量不够再升级 | 省 40%--70% |
| 上下文裁剪 | Top-K 只喂最相关片段,历史做摘要 | 省 20%--40% |
7.1 语义缓存:不花一分钱省掉重复推理
✨ 技术亮点:精确缓存 + 向量近邻缓存双层,命中即 0 Token、0 延迟直出。
java
public Optional<String> lookup(String question) {
    String norm = normalize(question);   // 去空格、去标点、统一大小写

    // ① 精确缓存:最便宜,先打这一层
    String exact = redis.opsForValue().get("qa:exact:" + md5(norm));
    if (exact != null) {
        return Optional.of(exact);
    }

    // ② 语义缓存:同一问题换个说法也能命中
    List<SearchHit> near = cacheVectorStore.search(embedding.embed(norm), 3);
    return near.stream()
            .filter(h -> h.score() >= 0.95)   // 阈值按业务调,别贪高
            .findFirst()
            .map(SearchHit::answer);
}阈值提醒:0.95 这个数要按业务调,别贪高,否则命中率极低,缓存形同虚设。客服类场景缓存命中率做到 30%+ 很常见,本地 Caffeine + 远程 Redis 多级缓存一起上效果更好。
再送一招:请求合并。相同问题短时间内被大量用户提问时,用 Resilience4j 做请求合并,只推理一次,结果共享给所有等待的请求。
流式链路上还有几个省钱小细节:处理 SSE 响应时记得过滤 [DONE] 结束帧、从每帧里提取文本增量;完整回答生成后异步写缓存(比如 TTL 1 小时),别阻塞主链路。
7.2 意图路由:简单问题别用贵模型
java
record IntentResult(String intent, double confidence) {}

public String smartRoute(String message) {
    // ① 用小模型做意图识别,输出直接映射 Java 对象,告别手动解析 JSON
    IntentResult intent = chatClient.prompt()
            .user("分类意图(退换货/售后/闲聊/复杂投诉):" + message)
            .call()
            .entity(IntentResult.class);   // 类型安全的结构化输出

    // ② 简单问题走本地小模型,复杂问题才走大模型
    if (intent.confidence() >= 0.8 && !"复杂投诉".equals(intent.intent())) {
        return localSmallModel.generate(message);   // 便宜 100 倍
    }
    return bigModel.generate(message);
}
用小模型做意图分类,输出通过 entity() 直接映射成 Java 对象(结构化输出,告别手动 parse JSON),简单问题走本地小模型------便宜 100 倍。就这一招,整体成本能降 70%。
7.3 上下文裁剪:别硬截断
多轮对话 Token 涨得快,正确姿势是滑动窗口 + 摘要压缩。千万别硬截断------截断会让模型"忘记"之前约定好的输出格式。系统约束放到稳定前缀里,还能顺便吃 Prompt Cache 的红利,一举两得。
7.4 看重试率,别盯单次 Token
💸 血泪教训:为了省 Token 把上下文砍太狠 → 回答残缺 → 触发用户重试 → 重试时又把上下文补回来。**算总账反而比一开始不省更贵。**所以要看"重试率"这个指标,而不是盯单次 Token 数。
成本优化有个不可能三角:效果、成本、延迟不可兼得。平衡的关键就是模型路由------按问题难度分流,各取所需。
钱省了,稳定也有了,最后还有三道关:幻觉、安全、评测。这三关不过,别谈上线。
八、幻觉、安全、评测:上线前的三道关
8.1 幻觉:用工程手段兜住,别靠信仰模型
四板斧:
- 落地强约束 Prompt:只允许基于检索内容作答,无依据直接回"暂无相关信息 / 需要人工确认";
- 无召回则拒答 :检索分数低于阈值(比如
0.7)时不调生成模型,直接走兜底; - 引用溯源:答案附来源文档 + 片段,前端可点开原文,合规必备;
- 关键字段白名单校验:金额、日期、编号这类字段必须回原文比对。
更狠的一招:生成后校验答案中的每个事实段落能否回溯到检索块,校验不过就只返回原文摘要、不生成------宁可"笨",也不能"编"。引用率本身就能当幻觉的监控指标。
除了幻觉,还有"玄学输出":模型偶尔话多、格式飘。三招压住:固定系统指令 + 低 temperature(比如 0.3)+ Few-Shot 示例引导,再配合结构化校验和正则兜底。我们一个项目里把输出准确率稳稳提到了 95%+。
8.2 安全合规:数据不出域,模型不被骗
- 数据不出域:开源模型私有化部署(Llama3-8B、Qwen + vLLM 等),满足金融、政企的强合规要求;
- 出入参脱敏:PII 识别 + 正则脱敏,敏感字段不进模型;
- 租户隔离:租户级向量隔离 + 权限前置过滤,杜绝越权检索;
- Prompt 注入防护 :输入检测 + 输出审查 + 系统角色白名单 + 工具白名单,AI 不直连数据库;
- 全量调用审计:日志留痕,出了事说得清。
8.3 评测:没有评测的 AI 项目等于蒙眼狂奔
Prompt 改一个字,线上效果可能崩。Prompt 要像代码一样管理:版本号 + diff + 灰度发布,存在 Nacos / Apollo 这类配置中心里。每次改 Prompt、换模型,先跑 Golden Set 回归:
java
@Test
public void regressionEval() {
    List<GoldenCase> cases = loadGoldenSet("eval/qa_golden.csv"); // 200+ 真实问题
    EvalScore score = evaluator.run(cases, currentPromptVersion);

    assertTrue("准确率下降超过2%", score.accuracy() >= baseline.accuracy() - 0.02);
    assertTrue("幻觉率超标", score.hallucinationRate() < 0.05);
    assertTrue("成本超标", score.avgCost() < 0.01);
    // 结果写入评测大盘,形成版本基线
}指标盯四个维度:准确率、幻觉率、P95 延迟、单次成本 ,结果写进评测大盘形成版本基线。线上再补召回率@K、忠实度、有用率,以及点踩率闭环------BadCase 自动回流评测集。线上日志也可以通过 Kafka + ClickHouse 回放,变成评测的数据源。
知识时效性也算评测的一部分:文档改了、向量库还是旧数据,用户拿到的就是过期答案。用 CDC(比如 Canal)监听变更,触发重新切片和向量化;或者定时增量同步,把延迟控制在 1 分钟以内。
可观测性更不能省:QPS / 延迟 / Token / 失败率 / 降级次数 / 缓存命中率全埋点,Micrometer + OpenTelemetry 做全链路 Trace,每一步的耗时和召回内容都记下来。别等用户反馈才知道挂了。
方法论都齐了,到底从哪儿下手?给一条被验证过的路线。
九、落地路线图:先 RAG,再 Agent
更稳的路径长这样:

一句话:先能用,再好用,最后自动。
拆成六步,每一步都可度量:
- 找一个高频、可度量、风险可控的场景(客服问答、工单摘要都不错);
- 用 RAG 先解决知识问答;
- 接入业务查询工具,提升回答真实性;
- 接入写操作,必须人工确认;
- 建立评估、反馈、成本监控闭环;
- 数据足够后,再考虑微调或蒸馏。
三个原则请背下来:先落地,再优化;先 RAG,再 Agent;先可控,再智能。
跑通之后,还有这些进阶方向
基础 RAG 跑通后,每个方向都是简历上的亮点:
- Agent 编排:用 Spring State Machine 实现多轮工具调用(查订单 → 查物流 → 总结);
- 本地模型部署:JNI / ProcessBuilder 调用 llama.cpp,纯 CPU 推理,数据不出内网;
- 向量计算加速:JDK 22+ Vector API、JNI 绑定 OpenBLAS,或者直接用 Lucene KNN 的底层优化;
- 推理加速:Ollama 4-bit 量化、vLLM 的 continuous batching 动态批处理;
- 多模态扩展:接入图片、文档解析,支持"看图问答""合同图片提取";
- 业务系统智能化改造:异常根因分析、内容审核、表单生成,都能嵌进现有 Java 后端。
框架选型上,Java 生态主流是 Spring AI 或 LangChain4j,深度学习推理还有 DJL 可选;向量库按规模选 Milvus / PgVector;治理用 Resilience4j / Sentinel;可观测上 Micrometer / OpenTelemetry;JDK 21+ 的虚拟线程也值得一试。
十、面试速记卡,以及几句掏心窝的话
如果你在准备面试,这张速记卡建议存下来,面试前 3 分钟扫一遍:
| 关键词 | 一句话 |
|---|---|
| 定位 | 不做调 API 的,做把模型稳定接进业务的 |
| 两层主场 | 能力编排层 + 工程治理层 |
| 四大场景 | 知识库 RAG / Agent 编排 / 智能问数 / AI 网关 |
| 稳定性 | 阶梯超时 + 线程隔离 + 熔断 + 三级降级(分级降级!) |
| 成本 | 语义缓存 / Prompt Cache / 级联路由 / 上下文裁剪;盯重试率 |
| RAG 三板斧 | 混合检索(BM25 + 向量)+ RRF 融合 + Rerank 精排 |
| 幻觉 | 强约束 Prompt + 引用溯源 + 无召回即拒答 |
| 格式 | 容错解析 + Schema 校验 + 降级纯文本 |
| 三件套 | 可灰度、可监控、可回滚 |
站在面试官视角,哪些回答加分、哪些减分:
加分项:主动提"可灰度、可监控、可回滚";把模型当第三方依赖治理(超时、重试、熔断、降级一套齐全);有成本意识,且知道重试率比单次 Token 重要;提到引用溯源、脱敏、审计;明确区分训练和落地的边界,不越界也不自卑。
减分项:只会说"调 API、写 Prompt";张口就是"我得转 Python 去学训练"------把优势扔了;系统里没有任何降级兜底,模型挂了全站挂;不聊权限、脱敏、审计,让公司数据裸奔;把 Demo 跑通当成项目上线。
高频追问,一句话答法:
- RAG 还是微调? 优先 RAG:成本低、知识可实时更新、可溯源;微调适合固定风格 / 格式对齐。常见组合是 RAG 管"事实",微调管"风格"。
- Agent 还是 Workflow? 流程可枚举用 Workflow,路径不确定用 Agent,但必须加护栏。
- 为什么不用 Python 写应用层? 业务系统 90% 在 JVM 上,换 Python 等于重做权限、事务、RPC、监控。AI 应用真正的复杂度在编排和治理,这正是 Spring 生态的强项。
- 不懂算法能做好吗? 不需要推公式,但要懂原理边界:embedding、温度、上下文窗口、量化。
- 怎么防模型胡说? 工程上承认它会胡说,然后给它装刹车:强约束 + 引用溯源 + 拒答 + 字段校验。
- 多轮对话 Token 涨太快? 滑动窗口 + 摘要压缩 + 稳定前缀吃 Prompt Cache + 工具输出精简。
面试结束时,你还可以反问四个问题:团队的 AI 能力是自建中台还是各业务线各接各的?有没有做 Token 成本归因和预算告警?模型供应商是单一绑定还是多路容灾?有没有自动化的 RAG 评测集?------这四个问题一问出来,段位立刻不一样。
写到这里,想聊点感悟。
模型能力会越来越便宜、越来越同质化,真正稀缺的,是"把模型变成稳定产品"的工程能力 。训练拼算力,落地拼功力。Java 工程师的 AI 红利,就是让 AI 变得稳、快、省、可信。
模型决定上限,工程决定下限。很多 AI 项目不是死于模型不够强,而是死于没有一个懂生产的工程师把它扶上马。我们不用转行,我们是来升级的------不用硬卷"炼丹",把"模型能用"做成"业务好用",就是最大的机会。
一句话收尾:模型是别人的,系统是咱们的,业务价值是咱们创造的。 Python 把模型造出来,Java 把 AI 变成稳定、高并发、能赚钱的业务系统。AI 时代不需要每个 Java 工程师都变成算法工程师,但需要每个 Java 工程师都能把 AI 焊进业务系统里------焊工,一直都很值钱。