前言
之前我写过一篇关于 Codex Hook 的文章,还基于 Hook 做了一个任务统计工具,用来查看任务耗时、MCP、Skill、文件变化等信息。
最近我又开始关注一个问题:
Codex 一轮任务到底消耗了多少 Token?多少命中了缓存?又有多少用于推理?
于是,我给 Codex Task Stats 增加了 Token 用量统计。
先看看实际效果
先不讲原理,直接看一轮真实的任务统计。
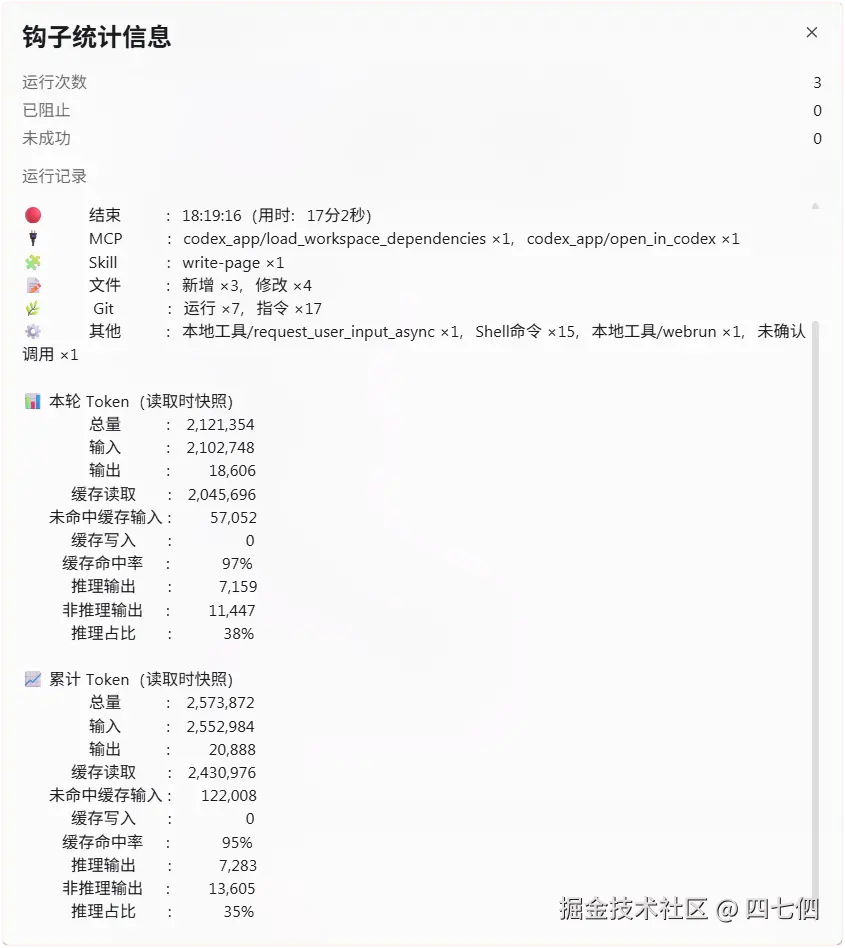
这一轮执行了 17 分 2 秒 ,累计消耗了 212 万 Token ,缓存命中率达到了 97%。
原来的任务统计只能告诉我 Codex 做了什么,现在还能看到它消耗了多少 Token。
不过,看到 212 万这个数字,可能会有疑问:
我只是让 Codex 完成一个任务,怎么会消耗这么多 Token?
1. 212 万 Token,代表什么?
其实,这里的 212 万并不是一次请求消耗的 Token,而是这一轮任务中多次模型请求的累计消耗。
比如让 Codex 修复一个 Java 接口的 Bug,它可能会:
- 查找代码,分析问题。
- 修改文件,运行测试。
- 根据测试结果继续调整。
这些步骤可能涉及多次模型请求,而且后续请求通常还会携带之前的上下文。
因此,任务累计消耗 212 万 Token,不代表上下文窗口同时容纳了 212 万 Token。
这也是为什么复杂任务执行时间越长,累计 Token 往往越多。
2. 我最关心的指标:缓存命中率
除了总量,我最想知道的其实是:这些 Token 有多少被缓存复用了?
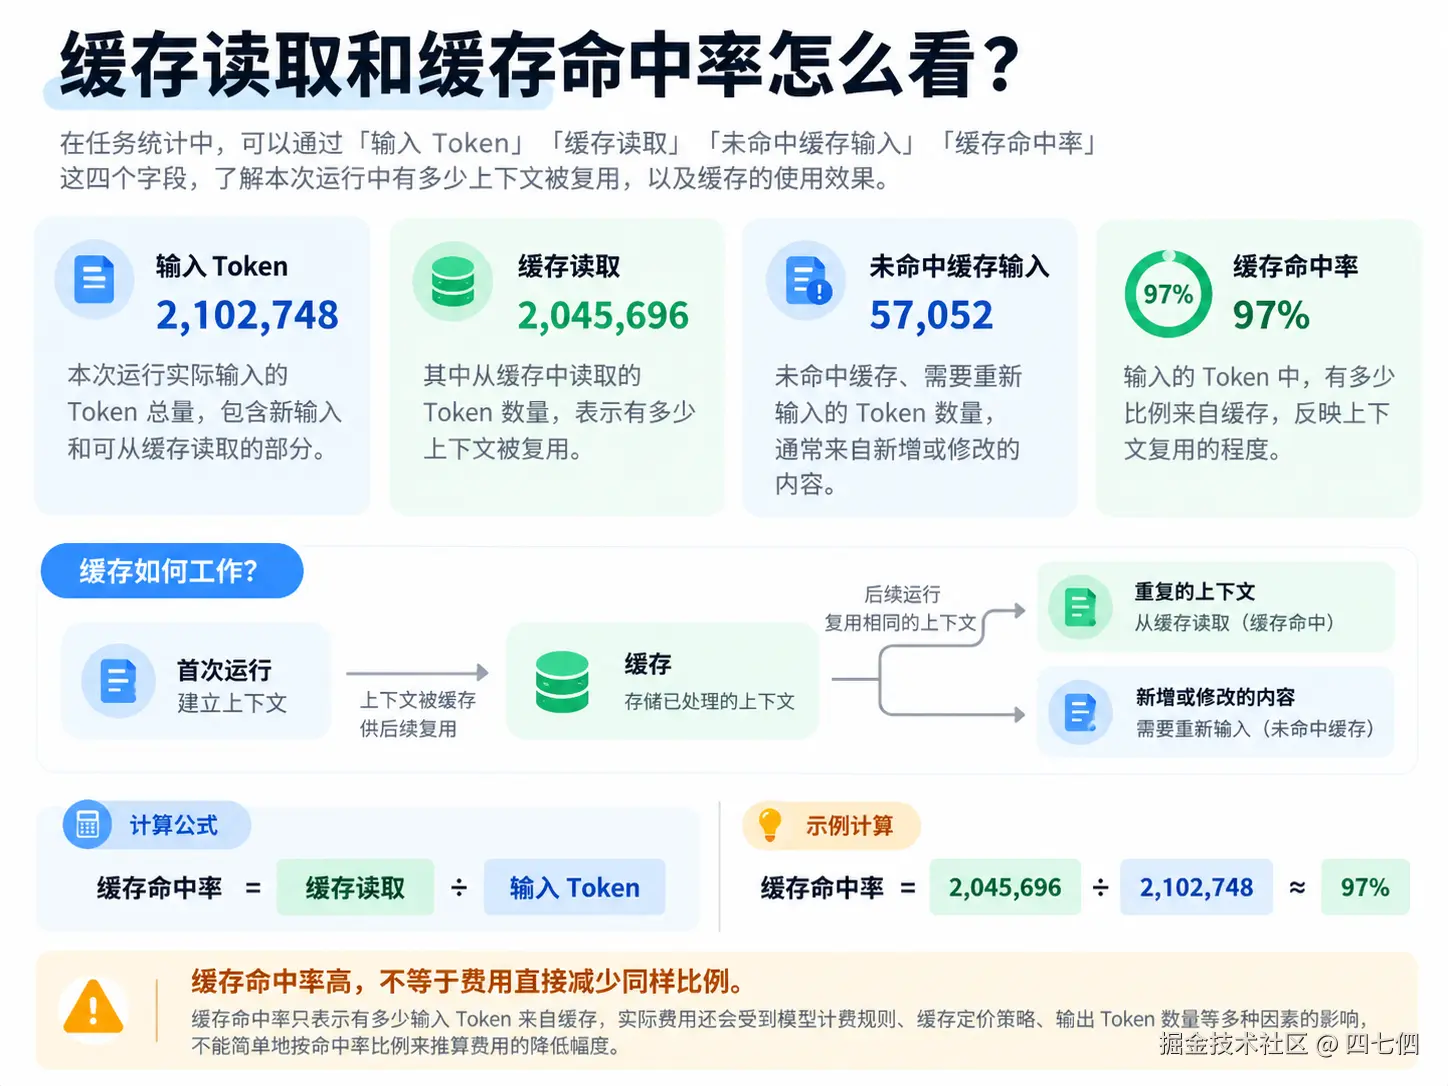
从图中可以看到,这一轮的缓存命中率达到了 97%。
为什么这么高?
因为 Codex 在连续处理任务时,经常需要重复使用之前的上下文。
比如第一次请求读取了项目结构和代码,第二次修改代码时可能还需要这些信息,第三次运行测试后又需要继续参考。
如果满足缓存条件,这些重复的输入就有机会直接使用缓存。
不过需要注意:
缓存命中率达到 97%,不代表费用减少了 97%。
缓存读取仍然属于 Token 用量,实际费用和额度消耗还取决于模型及产品的计费规则。
所以对我来说,缓存命中率主要是用来观察 上下文被复用了多少,而不是直接衡量节省了多少费用。
3. 推理 Token 又是什么?
除了缓存,这次还增加了 推理输出 和 推理占比。
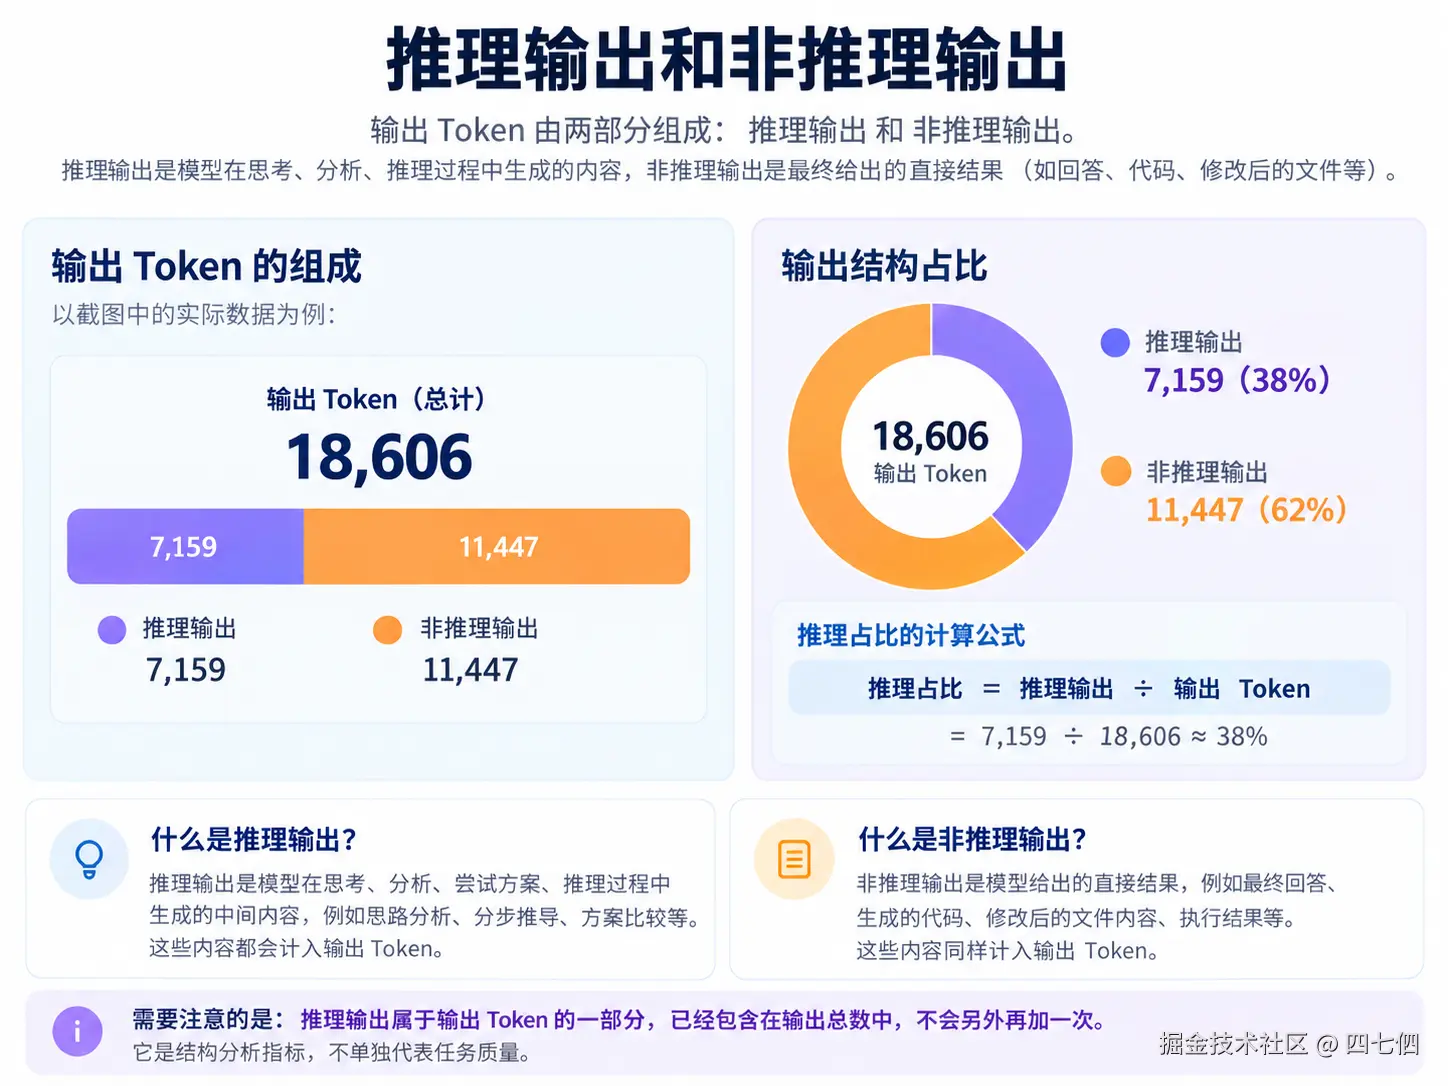
可以看到,这轮输出的 18,606 Token 中,大约 38% 用于推理。
比如让 Codex 排查一个复杂 Bug,它可能需要分析错误原因、比较不同修复方案,再决定如何修改代码。
这些内部推理也会消耗 Token。
有了这个指标,我就能进一步了解输出 Token 的组成。
但推理占比越高,并不代表任务完成得越好。它只是用量统计,不能直接反映代码质量。
4. 为什么区分"本轮"和"累计"?
这也是我觉得比较实用的一个功能。
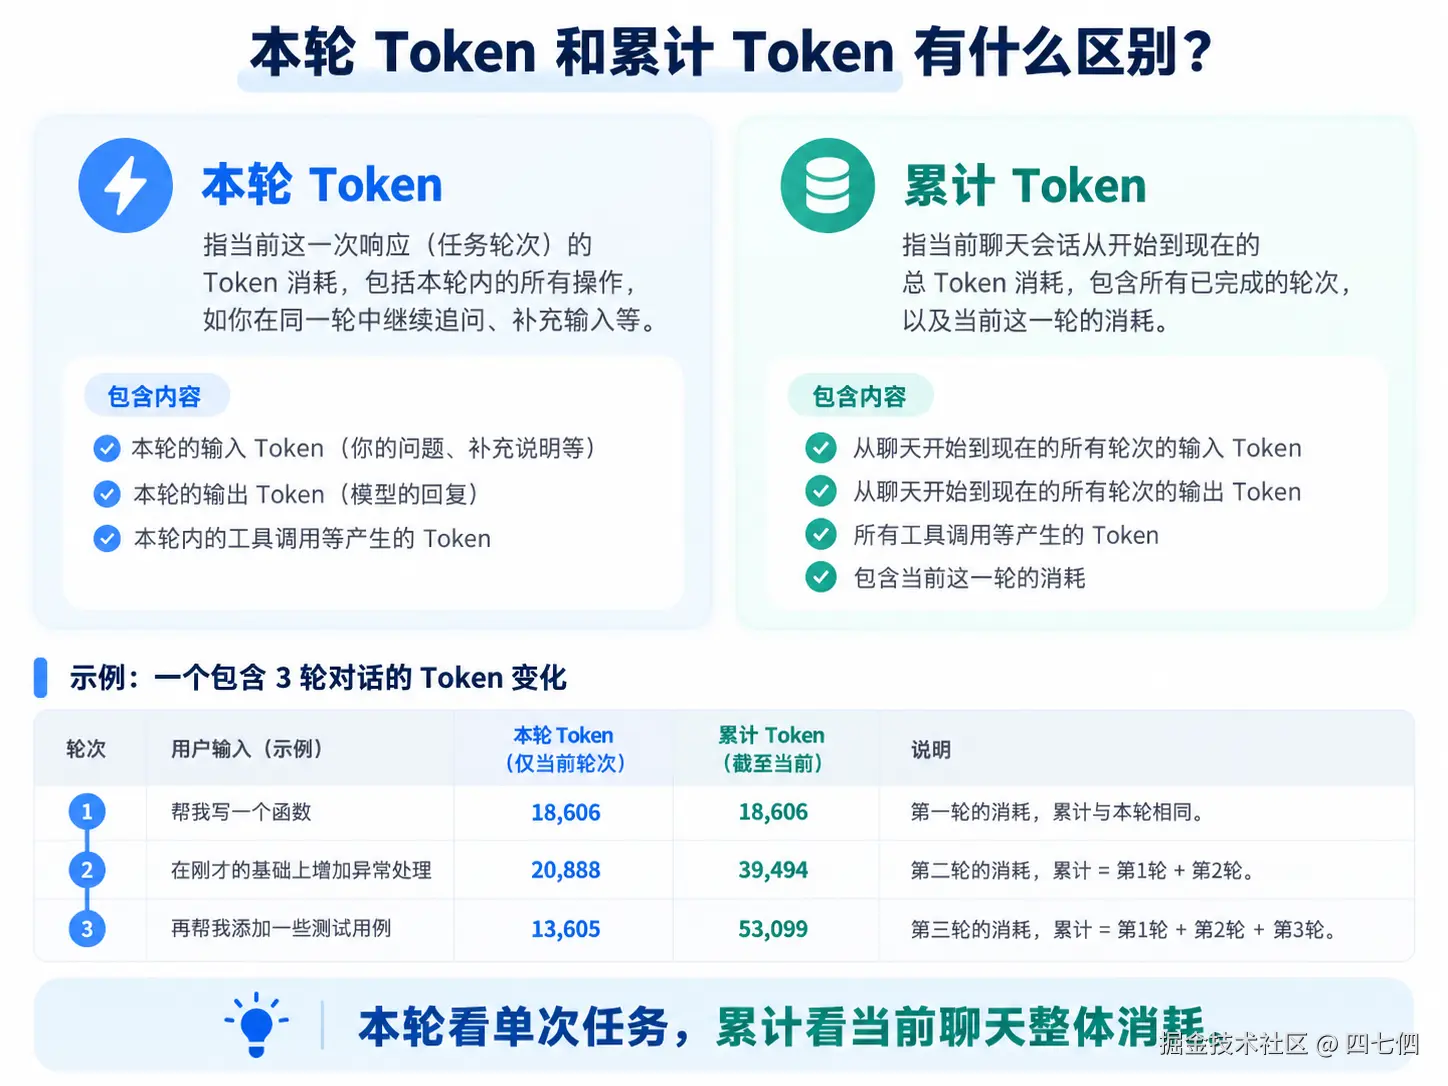
举个例子,我在同一个聊天中,先让 Codex 分析项目,再修改接口,最后补充单元测试。
这时候我既想知道:
- 本轮 Token:这次补充测试消耗了多少?
- 累计 Token:整个聊天到现在一共消耗了多少?
通过两个指标,就能分别查看单次任务和当前聊天的整体消耗。
需要注意,累计只代表当前聊天,不是整个 Codex 账号或所有项目的用量。
5. 这些 Token 数据是怎么来的?
可能有人会好奇:
Hook 本身并不会计算模型的 Token,这些数据从哪里来?
实际上,Codex 的本地会话记录中就包含了模型的 Token 用量信息。
整个统计过程如下:
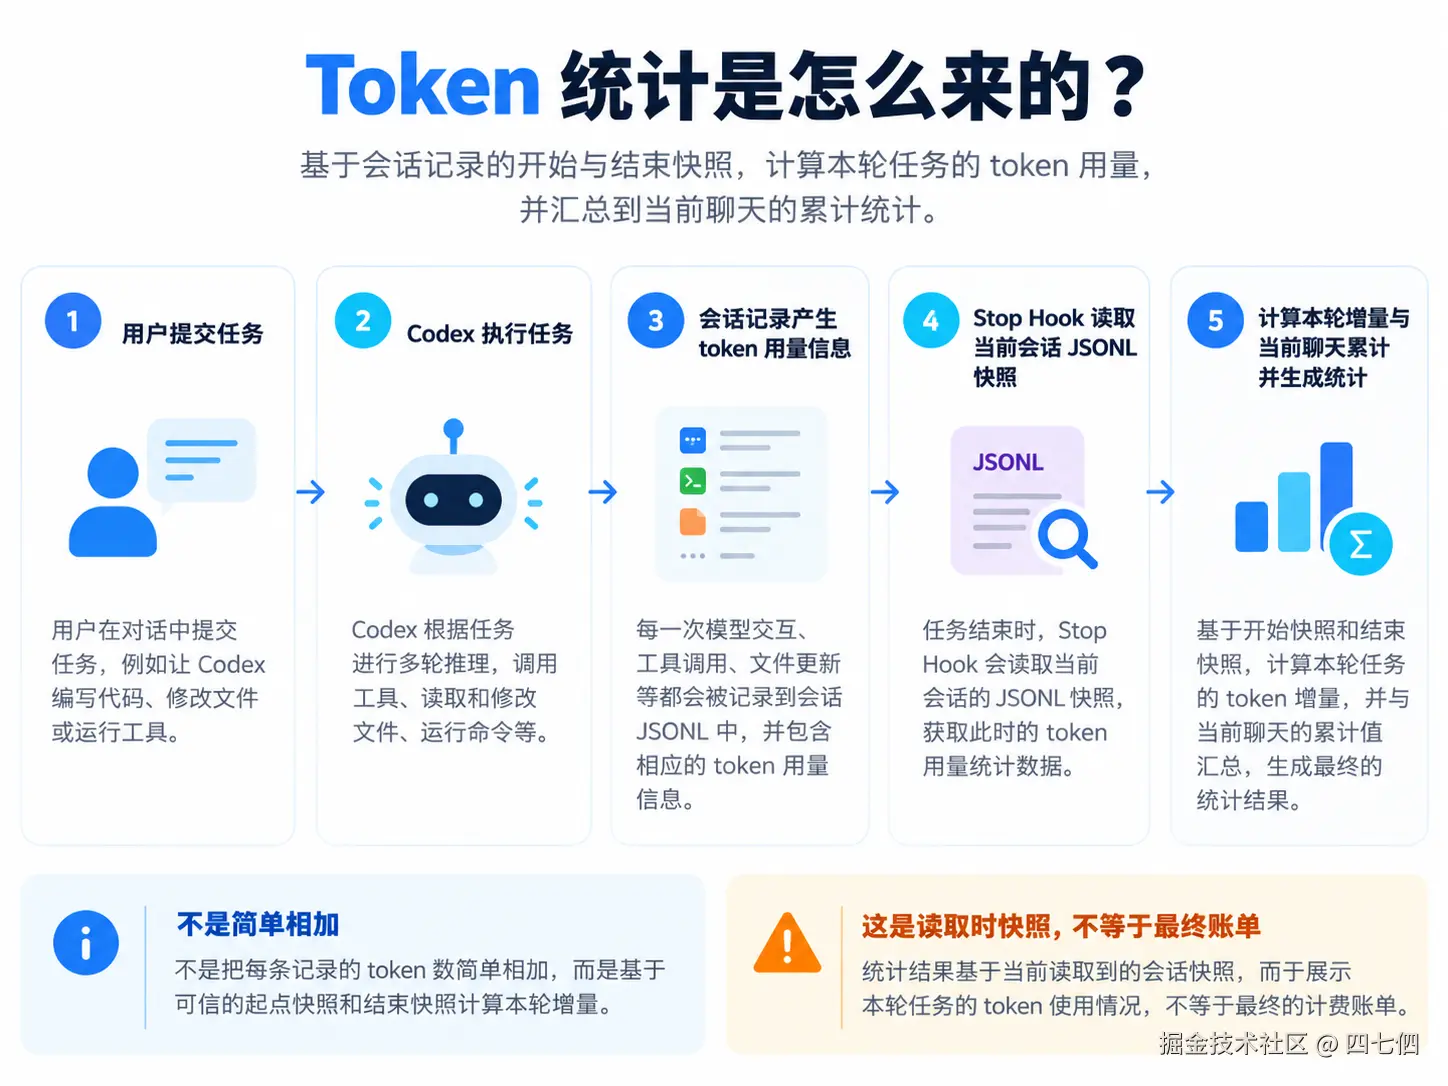
这里有一个比较重要的细节:
不能把每条 Token 记录直接相加。
因为会话记录中可能存在重复的累计快照,简单相加容易重复统计。
所以项目会读取当前主会话 JSONL 中的用量信息,通过可信的起点和终点累计值,计算本轮的 Token 增量。
最后在任务结束时,由 Hook 将结果整理展示出来。
整个过程不需要修改 Codex 的核心程序。
6. 这些统计能保证完全准确吗?
有一点需要明确:
Token 统计属于读取时的用量快照,不等于官方最终计费账单。
因为数据来自本地主会话记录,所以可能存在一些限制:
- 最后一次模型用量尚未完整写入。
- 部分客户端没有提供完整的 Token 字段。
- 独立子 Agent 的消耗未必全部包含在主会话记录中。
对于无法可靠确认的数据,项目会显示 未提供 或 未确认,而不是直接当作零。
因此,我更愿意把它理解为一个 Token 消耗观察工具,方便了解任务的使用情况,而不是拿来核对账单。
另外,默认会展示十项指标。如果觉得内容太多,也可以通过配置只保留总量、缓存命中率、推理输出等关键字段。
具体配置方式已经写在项目 README 中,这里就不展开了。
7. 这些数据到底有什么用?
以前一轮任务结束后,我主要关心:
跑了多久?用了哪些工具?修改了哪些文件?
现在又多了一个维度:
消耗了多少 Token?这些 Token 是怎么组成的?
比如某次 Bug 修复只修改了几个文件,却消耗了大量 Token。
这不一定意味着 Codex 有问题,但至少可以让我进一步检查:是不是进行了多轮分析、反复读取代码,或者多次运行测试?
结合原来的 MCP、Skill、文件变化和 Git 统计,就能更方便地复盘整个任务。
Token 统计不能直接告诉我为什么消耗这么多,但能帮我发现哪些任务值得关注。
结语
从最开始的任务耗时、MCP、Skill 和文件变化,到现在增加 Token 用量统计,我一直想解决的都是同一个问题:
让 Codex 的执行过程更加透明。
现在不仅能看到它做了什么,还能进一步了解它的 Token 消耗情况。
项目已经开源,有需要的可以直接使用:
安装、升级和配置说明都放在 README 中,这里就不重复介绍了。