大模型基础架构之Transformer
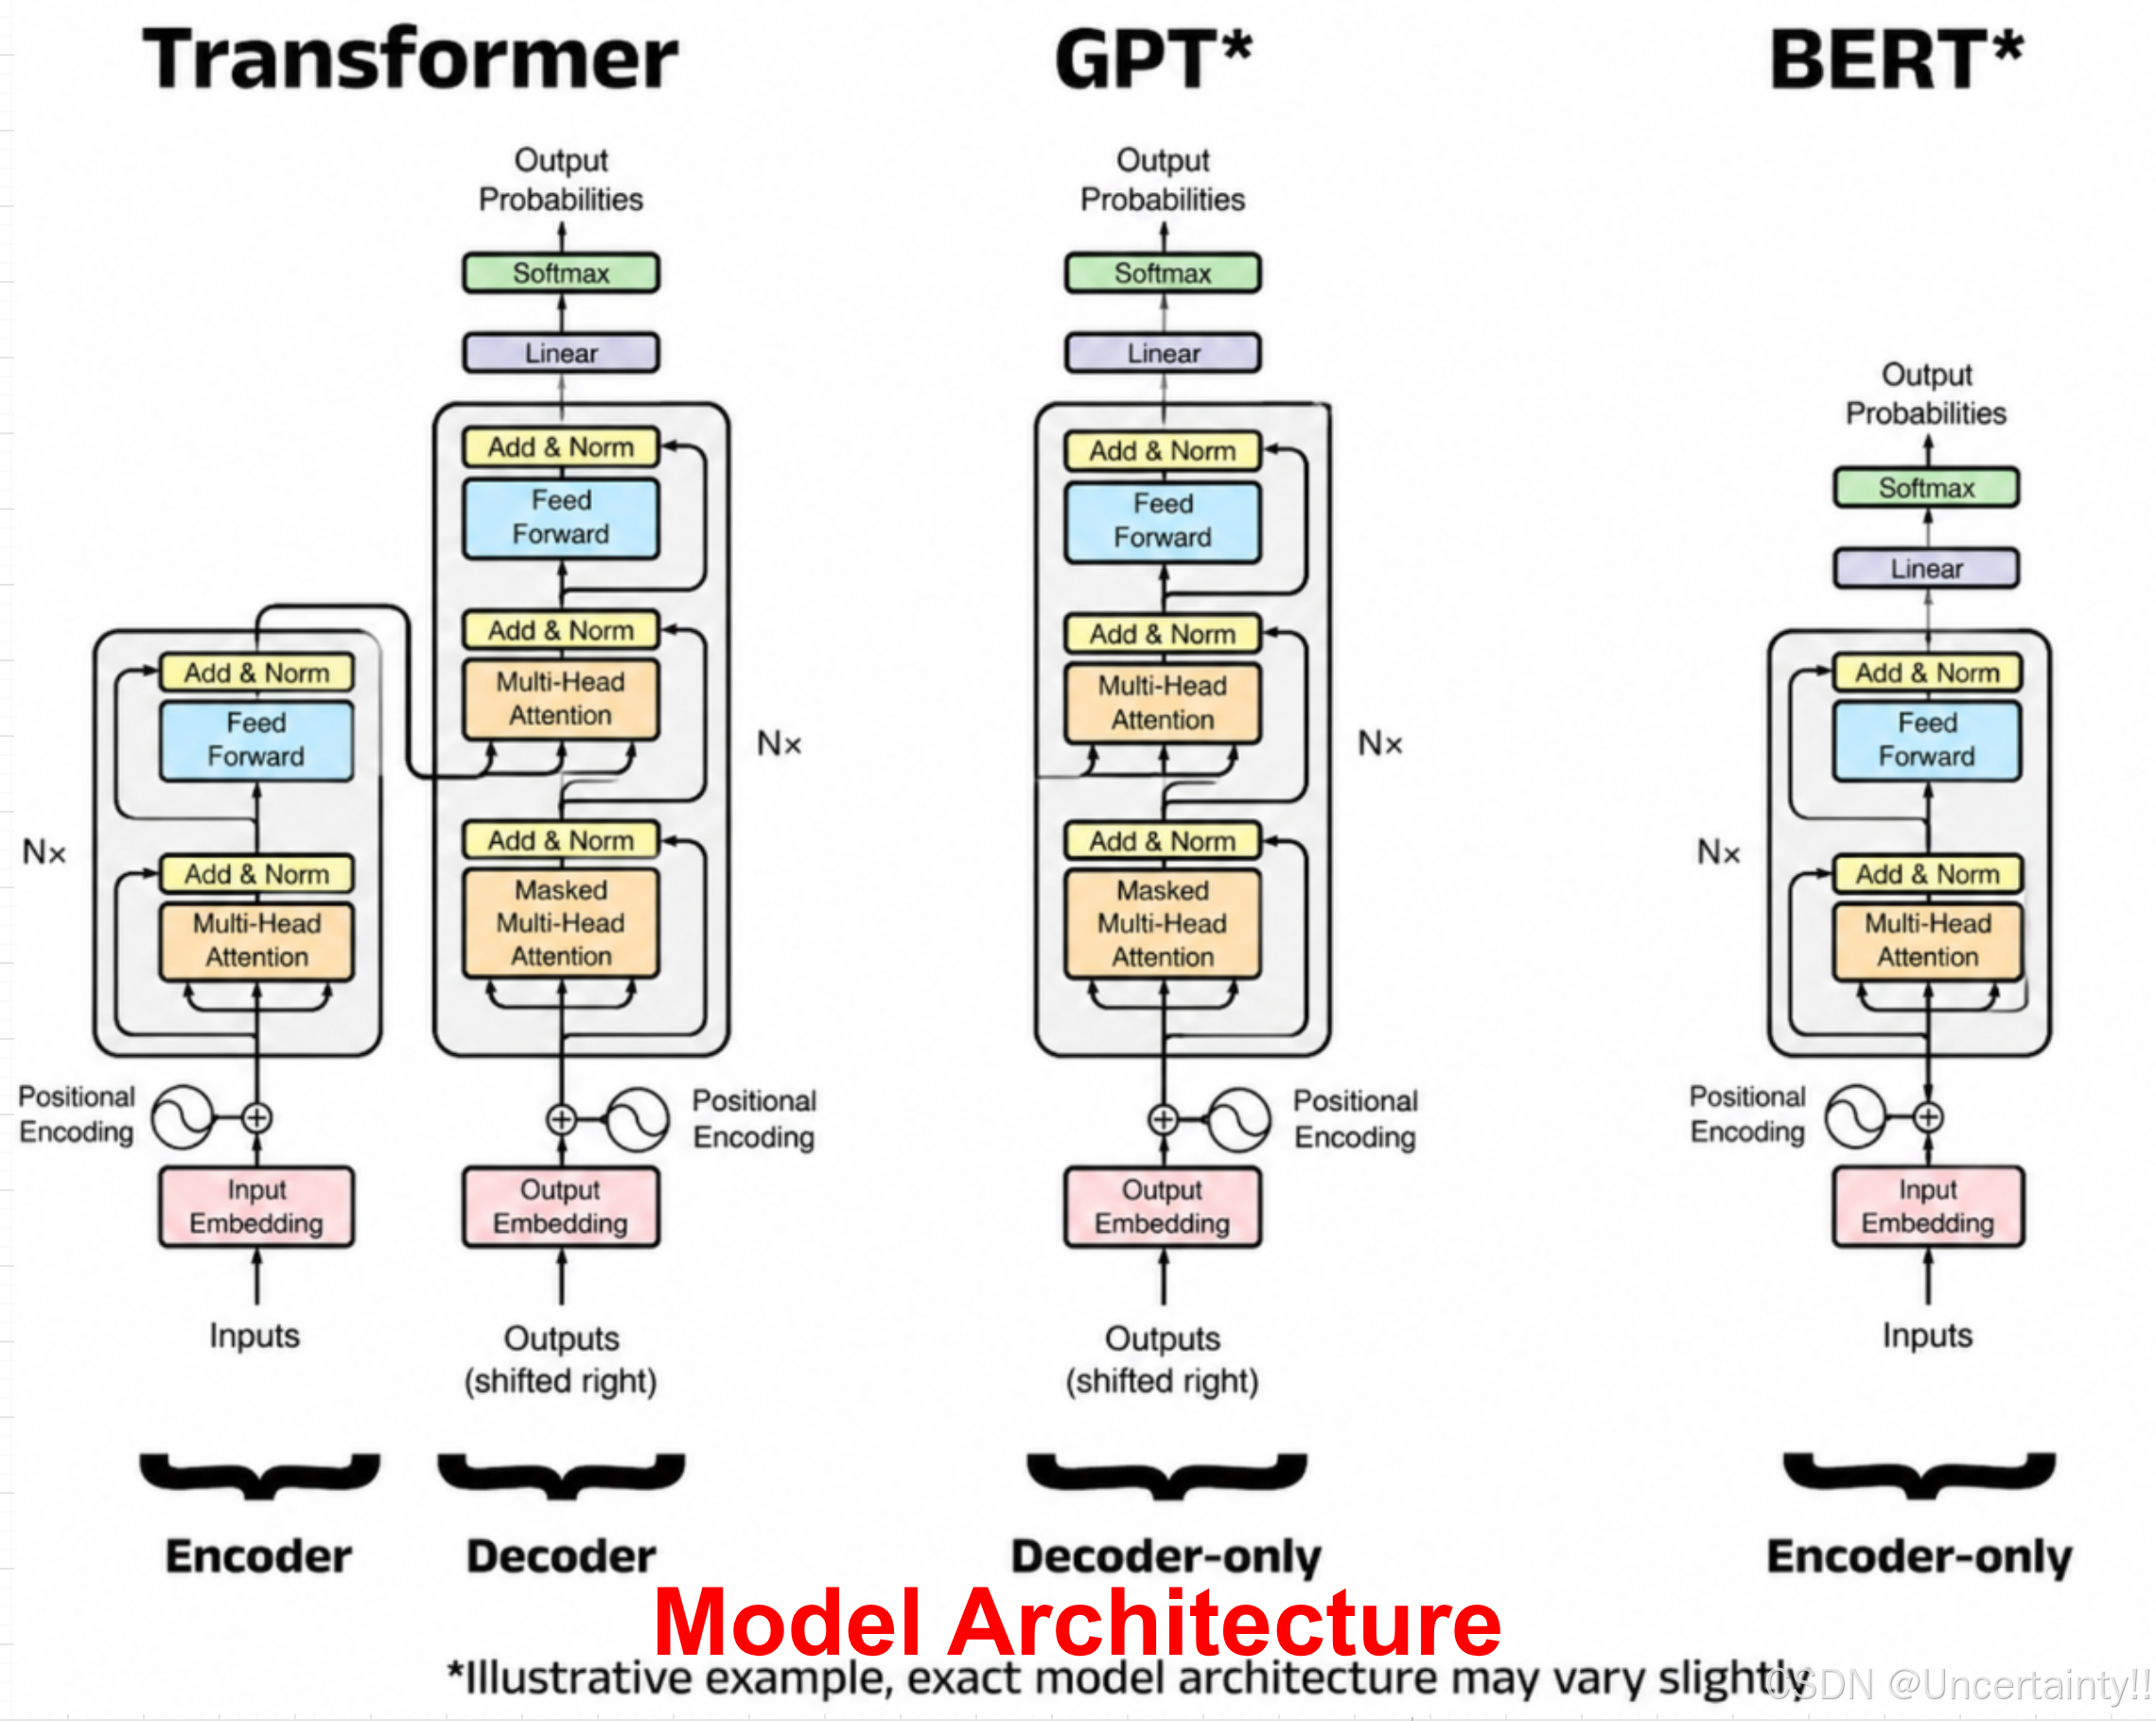
1.1 大模型的三种架构
(1)Encoder-Decoder架构
(2)Decoder-only架构
(3)Encoder-only架构
Encoder-Only=看完整句子做理解
Decoder-Only=只看过去逐步生成,给定上下文 → 预测下一个token → 不断续写
Encoder-Decoder=先理解输入,再生成输出
| 架构 | 注意力方式 | 每个 token 能看什么 | 适合任务 |
|---|---|---|---|
| Encoder-only,BERT | 双向注意力 | 左右所有 token | 理解、分类、匹配、NER |
| Decoder-only,GPT | 单向注意力 | 当前及之前 token | 生成、续写、对话 |
| Encoder-Decoder,T5 | Encoder 双向,Decoder 单向 | 源语言全看,目标语言只看过去 | 翻译、摘要、问答 |
下图来自Understanding BERT: The Simple Guide to Google's Language Model
1.2 Encoder-Decoder架构
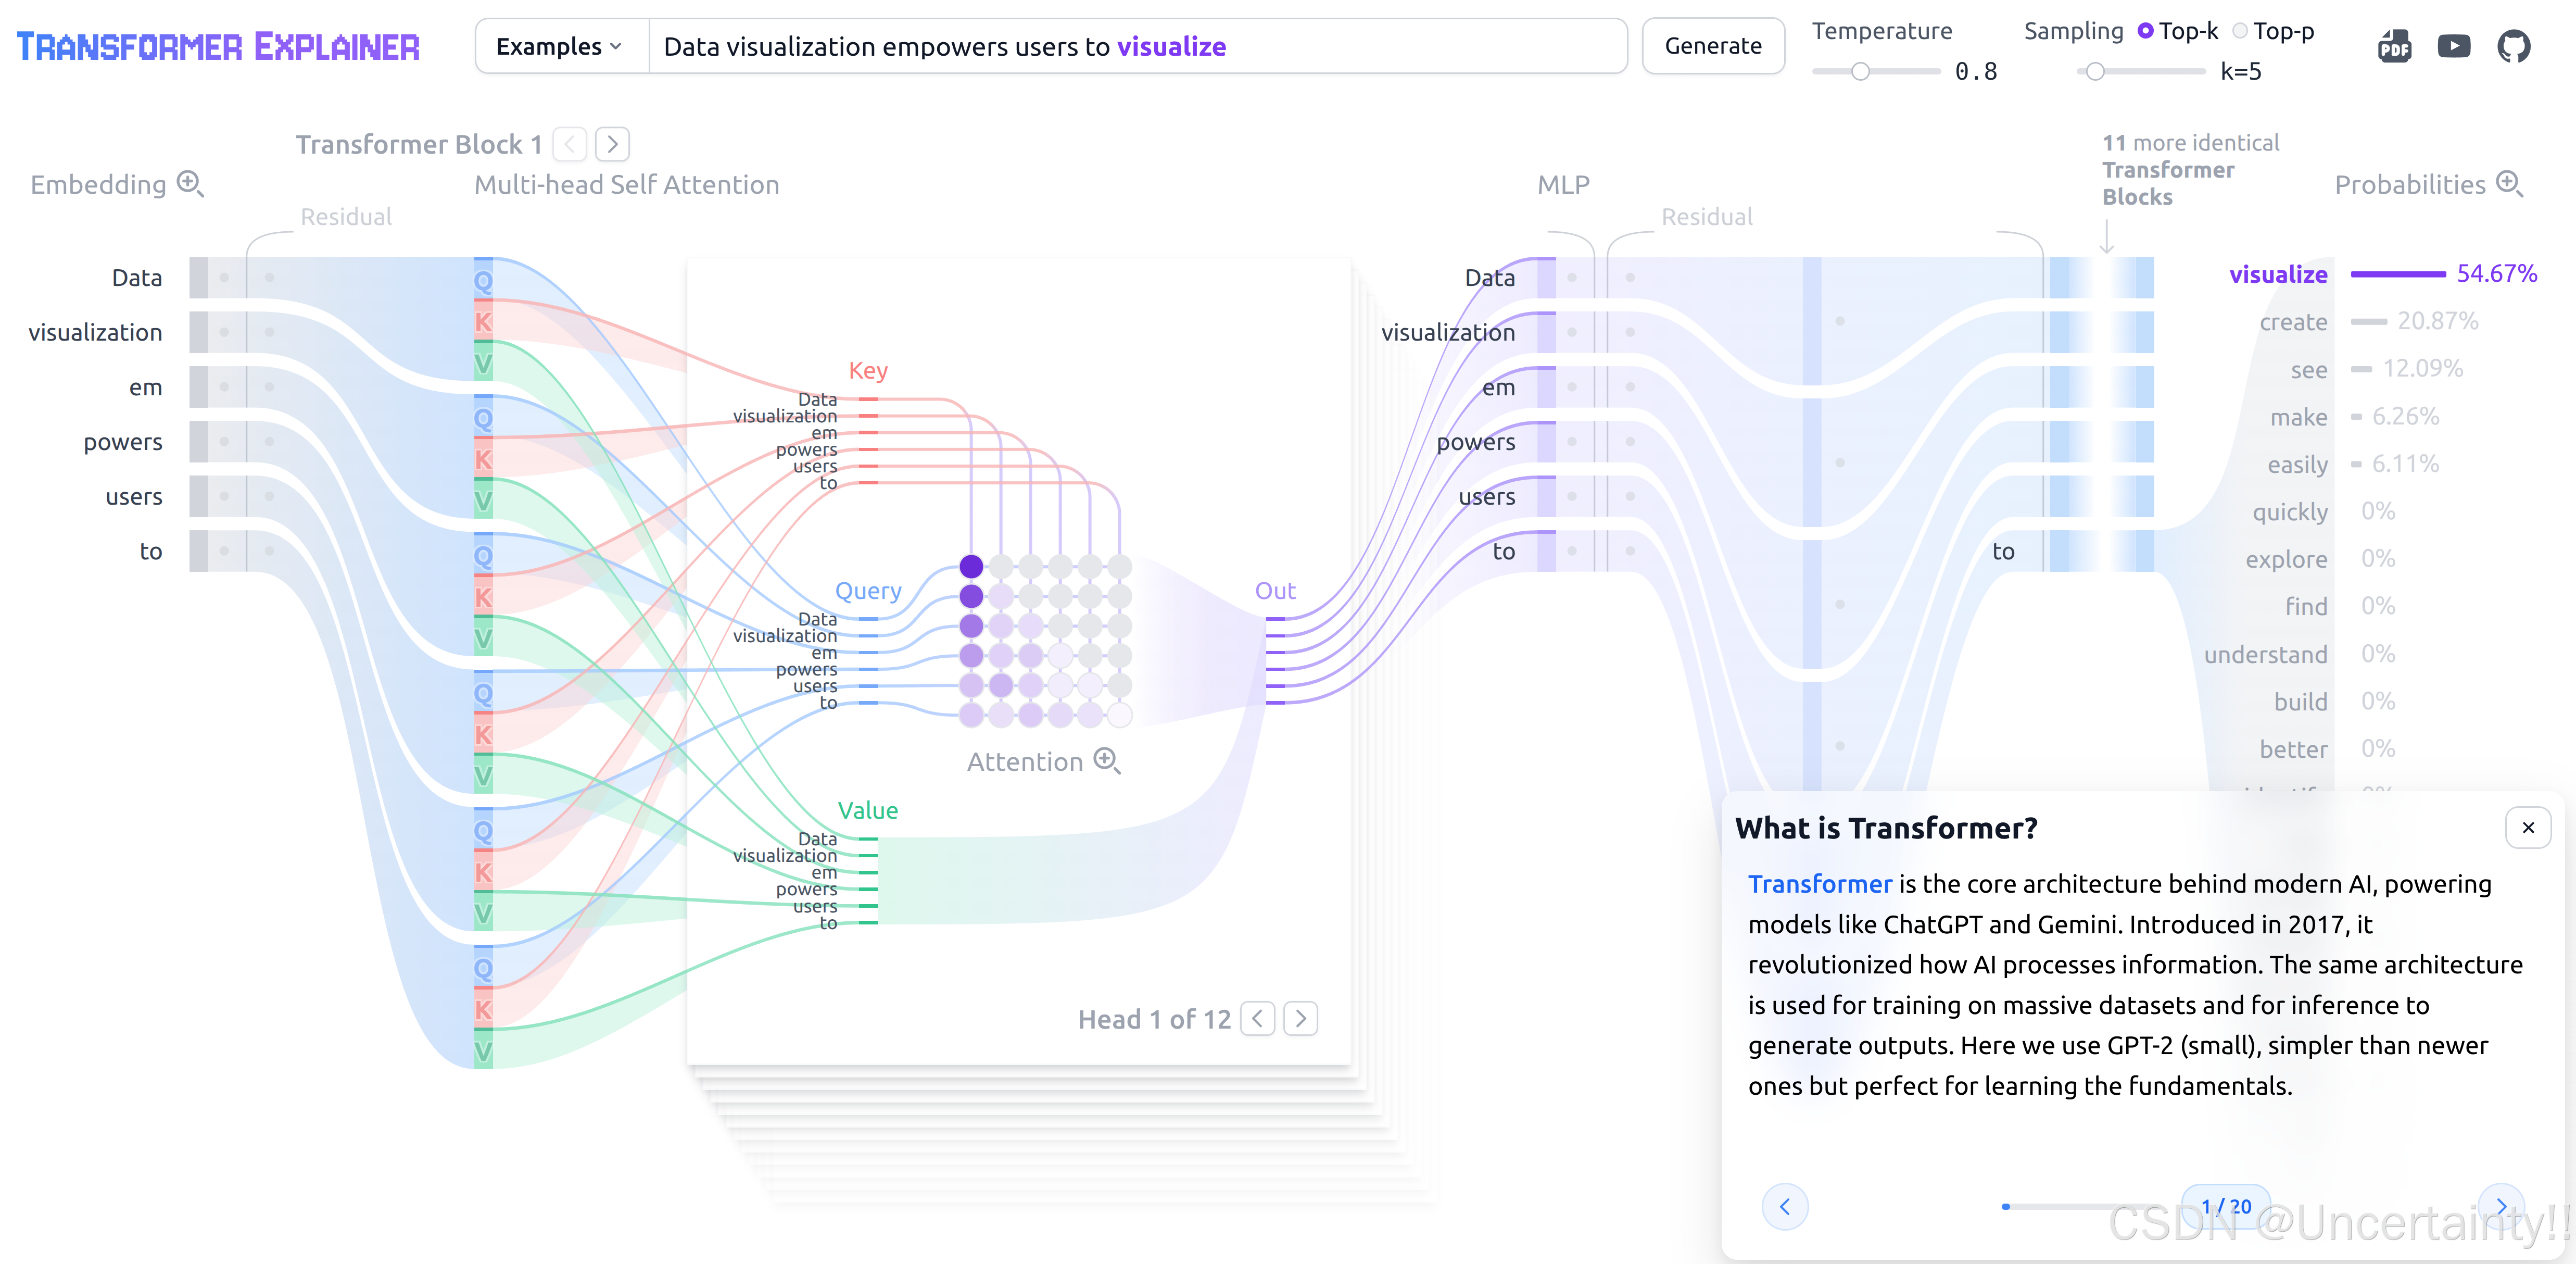
推荐一个超级哇噻的transformer可视化交互的网站
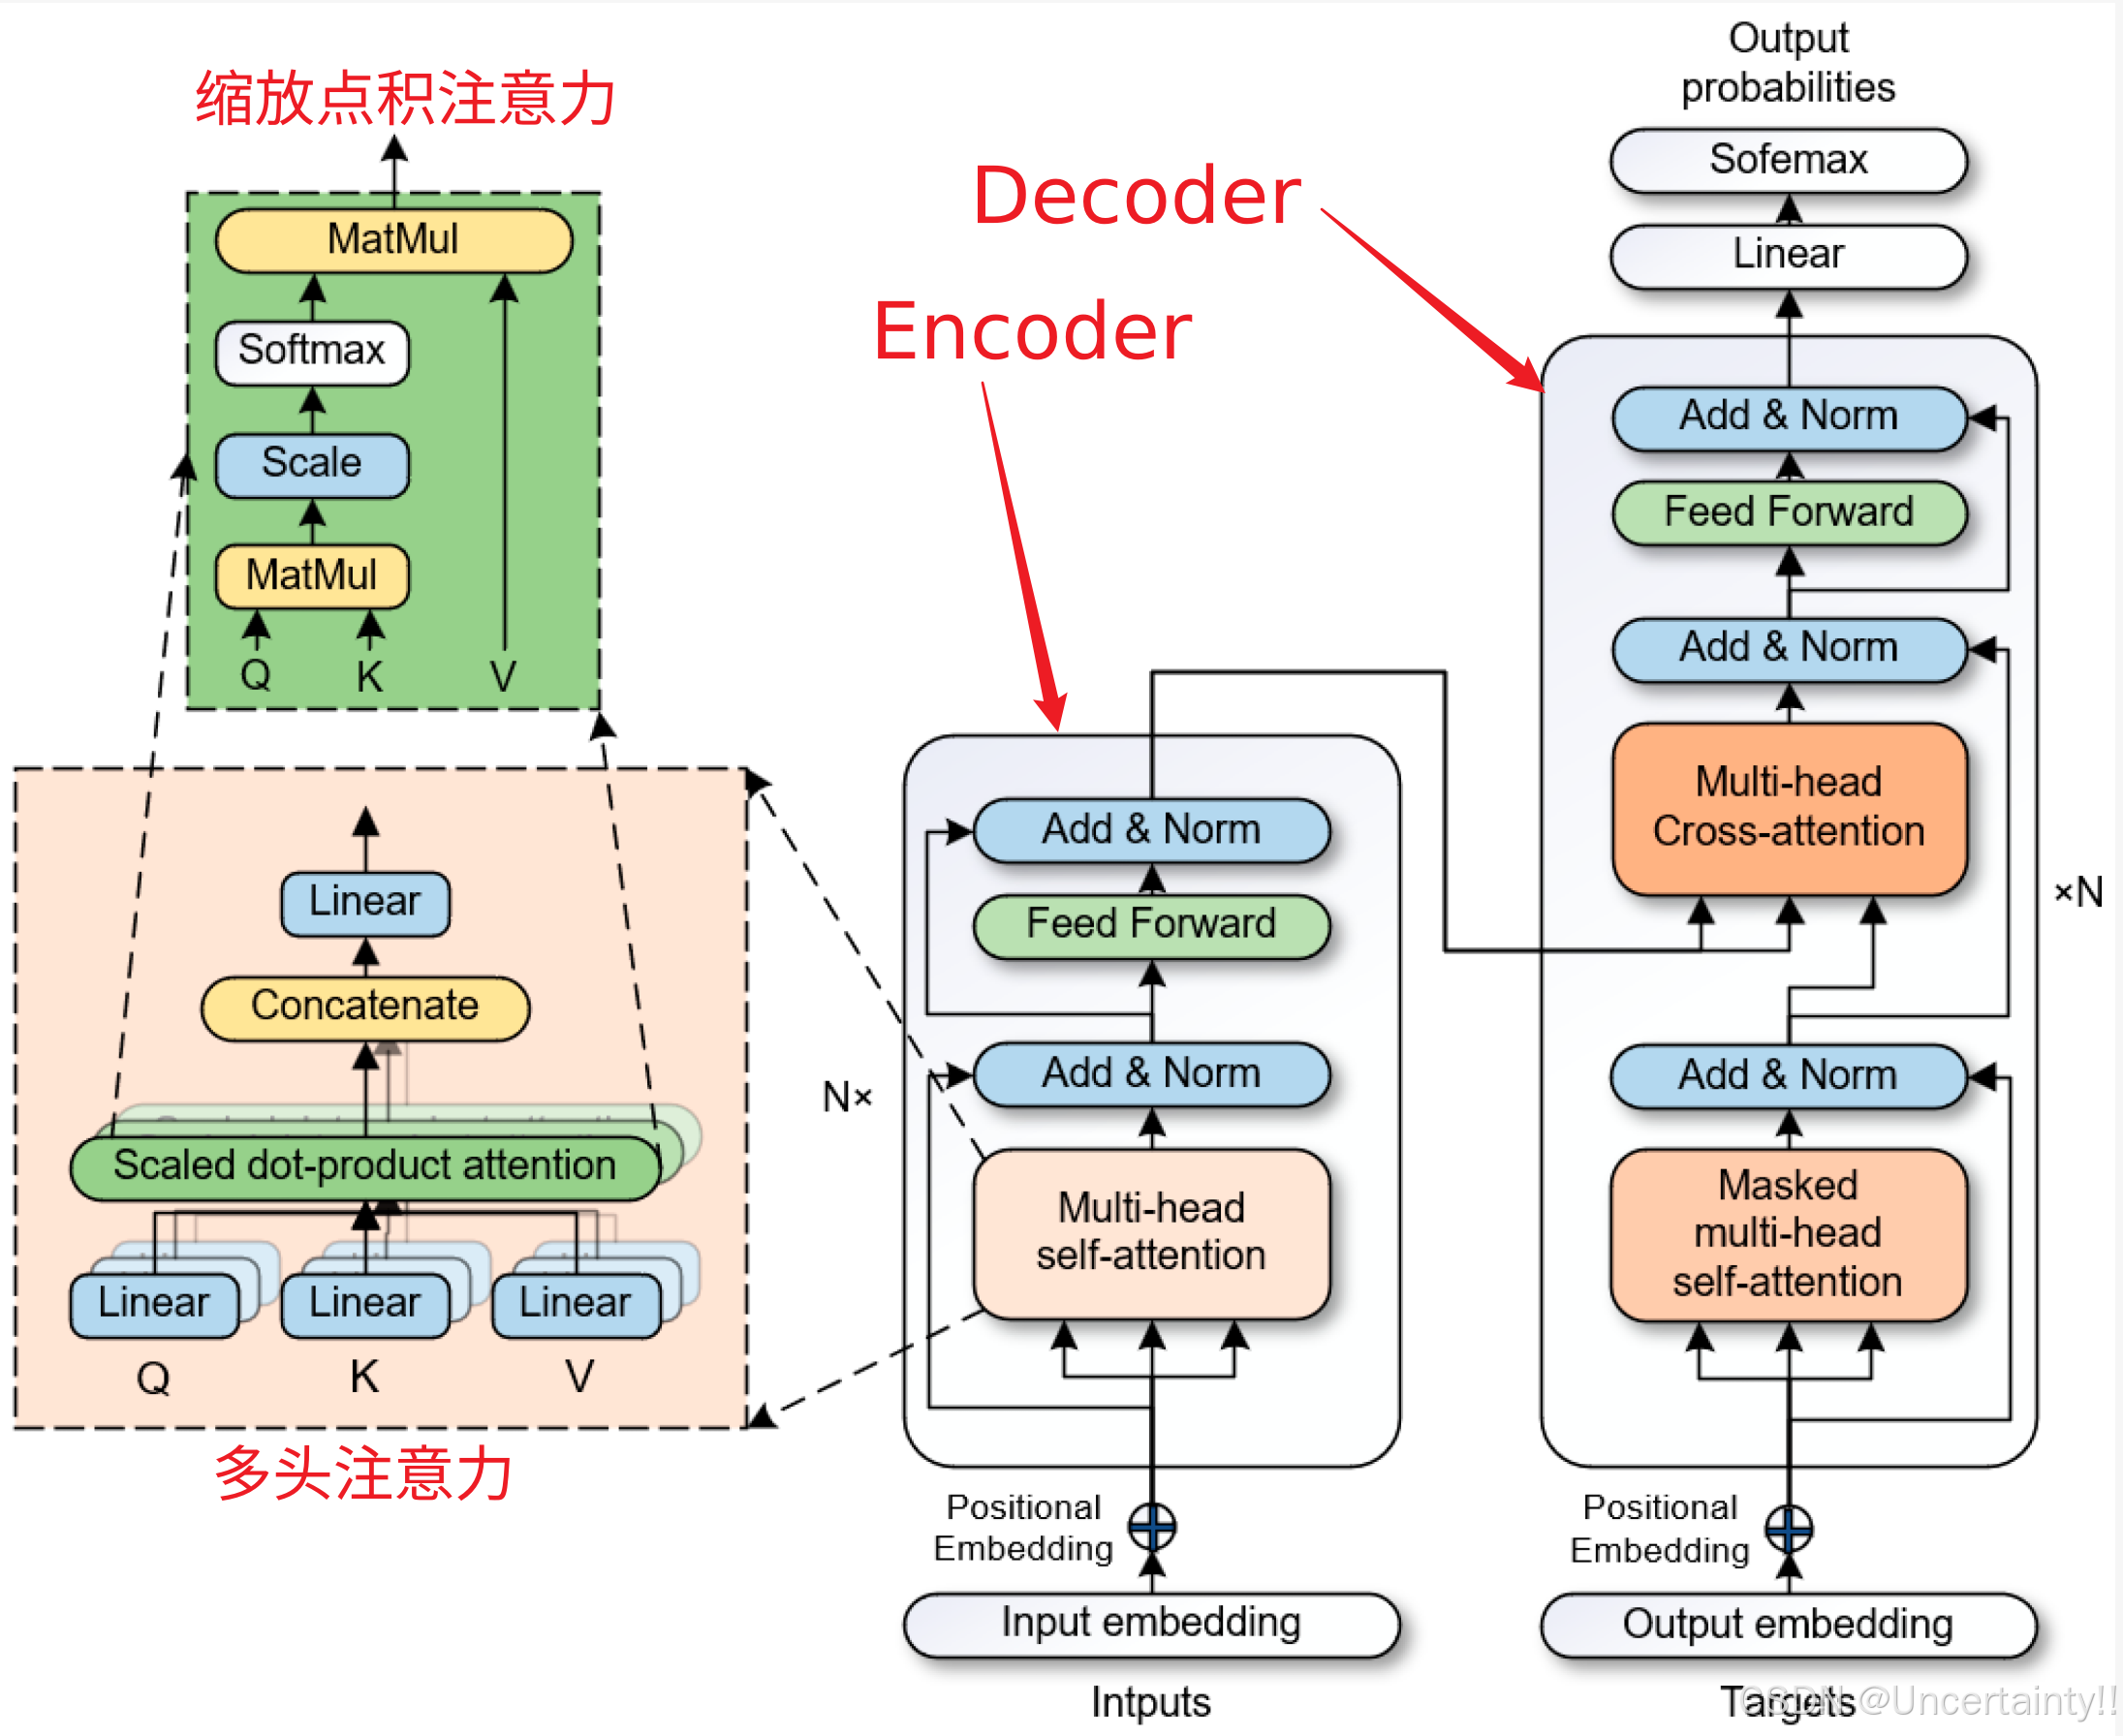
Encoder擅长于理解任务
Decoder擅长于生成任务
1.3 核心处理流程
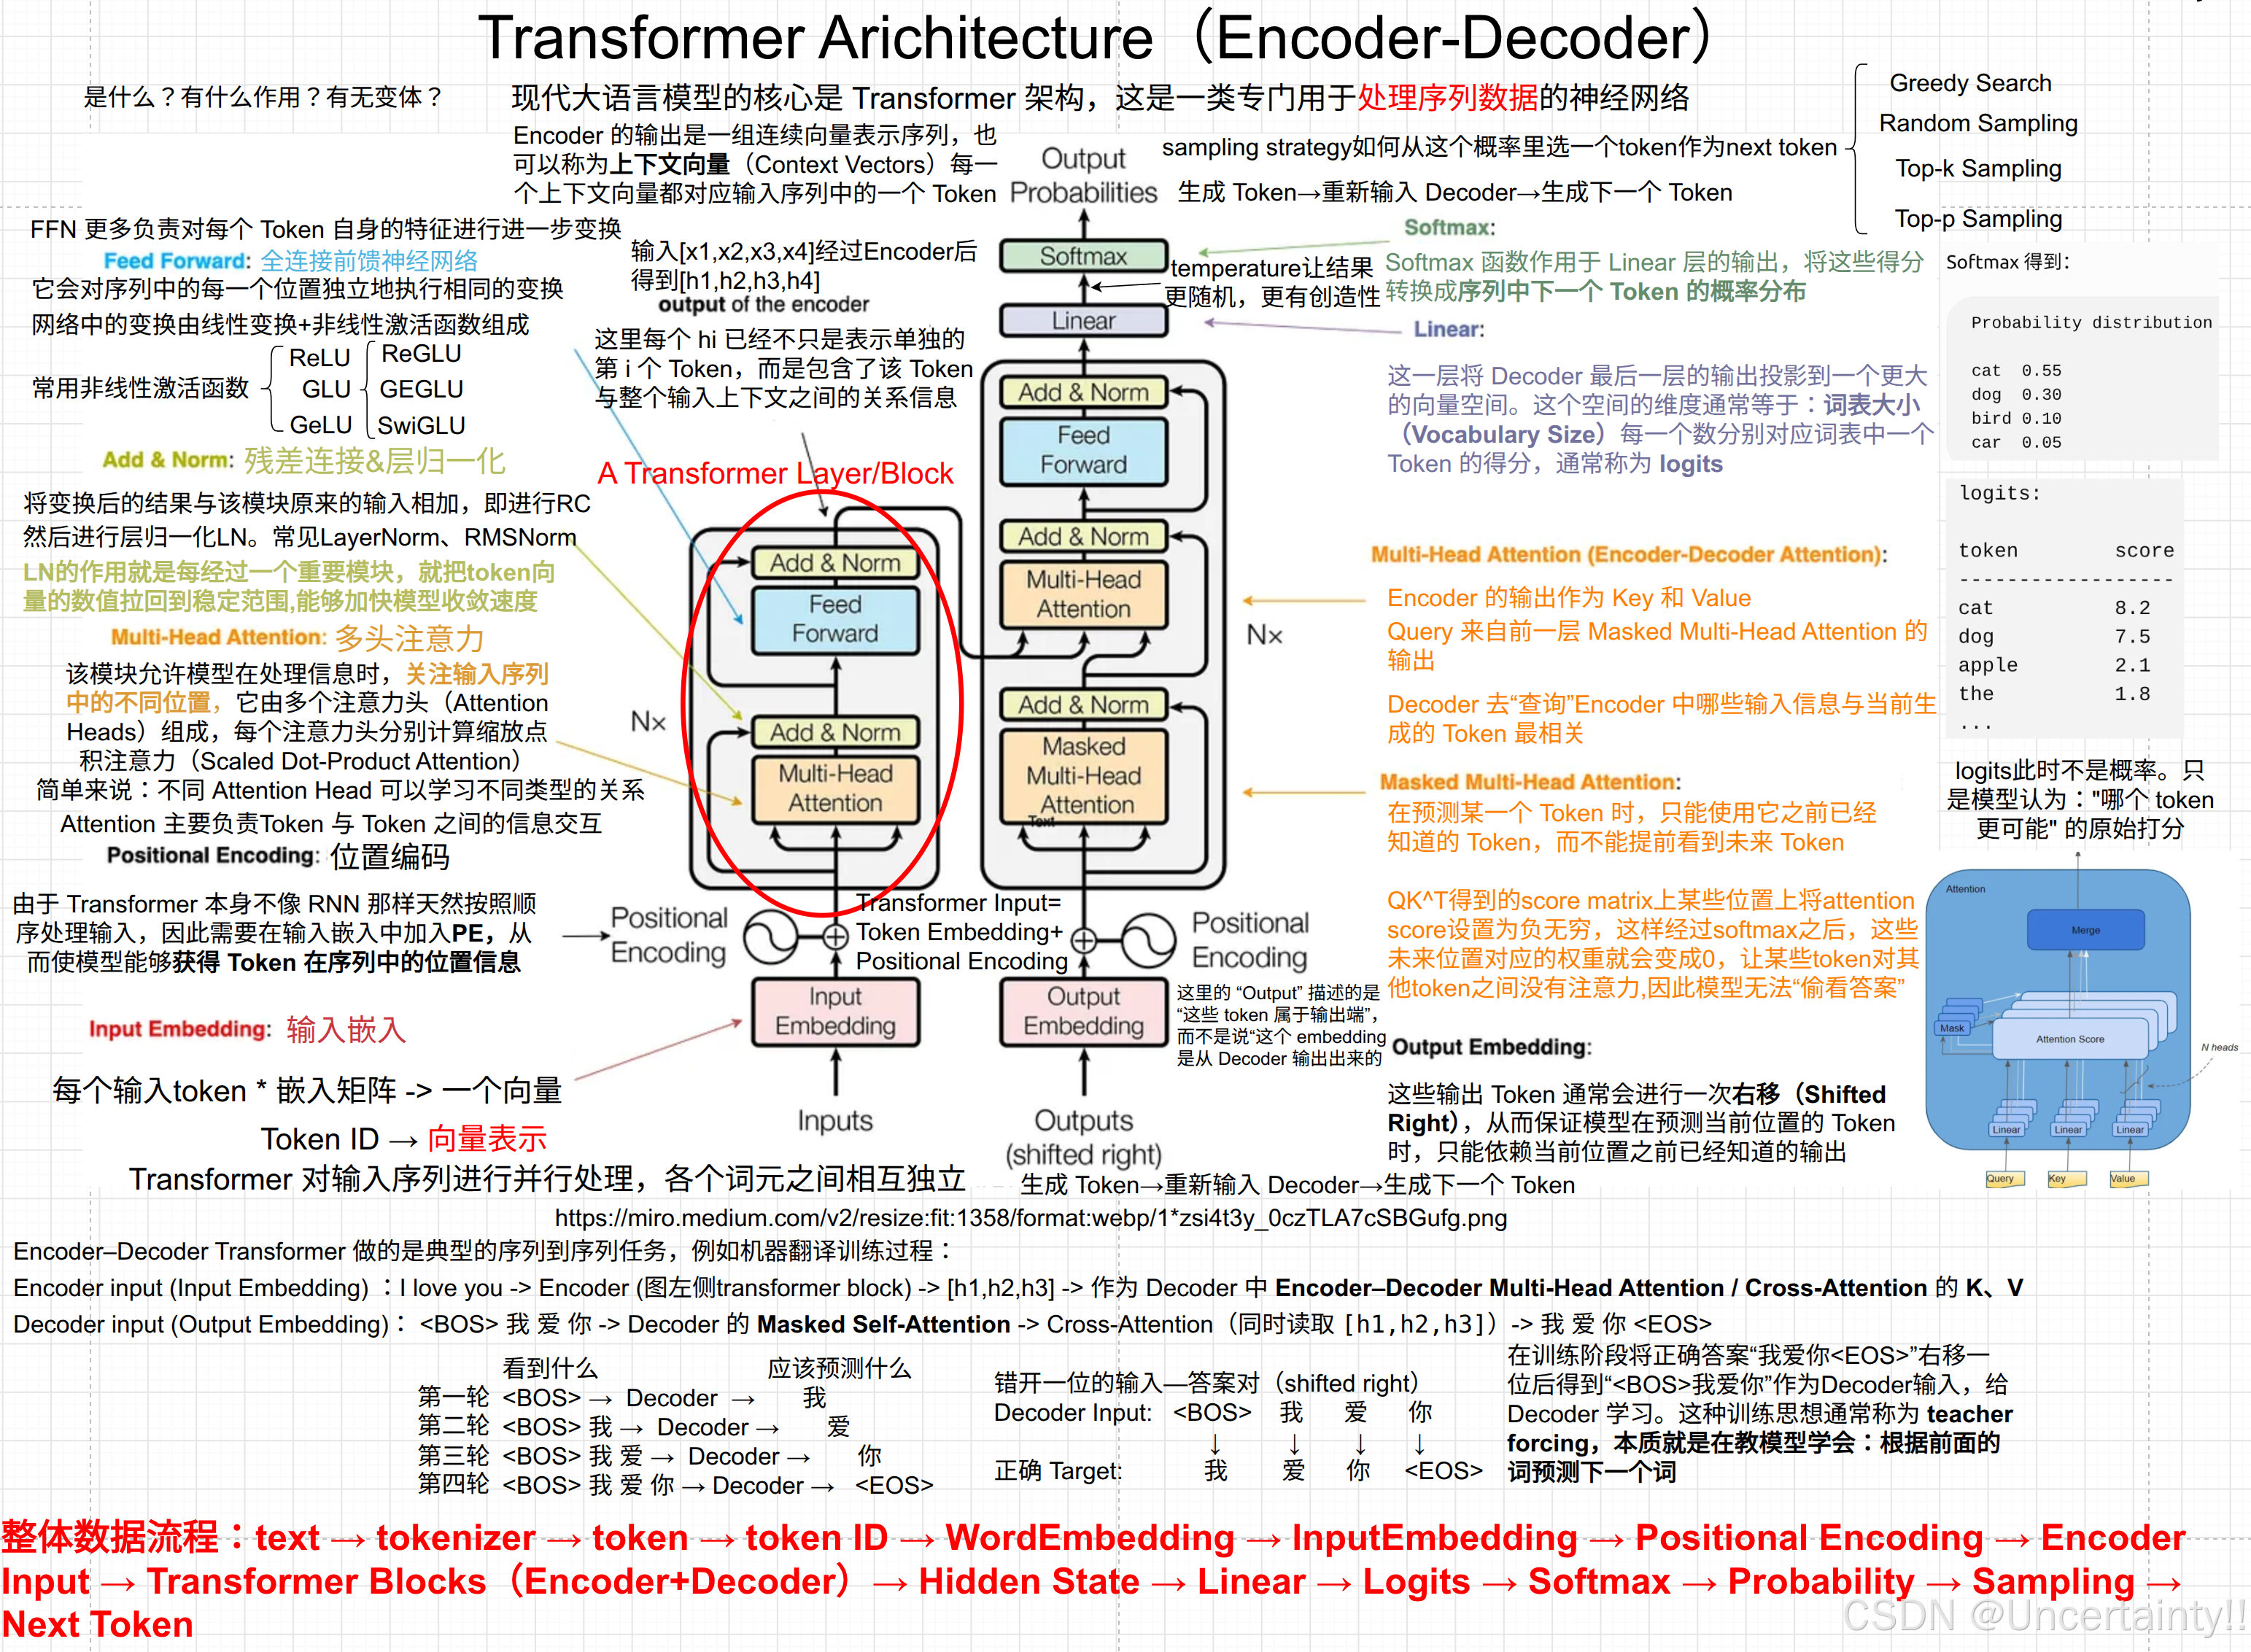
整体流程如下:
用户输入text → tokenizer → token → token ID → WordEmbedding → InputEmbedding → Positional Encoding → Encoder Input → Encoder → Decoder → Hidden State → Linear → Logits → Softmax → Probability → Sampling → Next Token
1.3.1 text → tokenizer → token → token ID
输入文本变为数字的向量表示
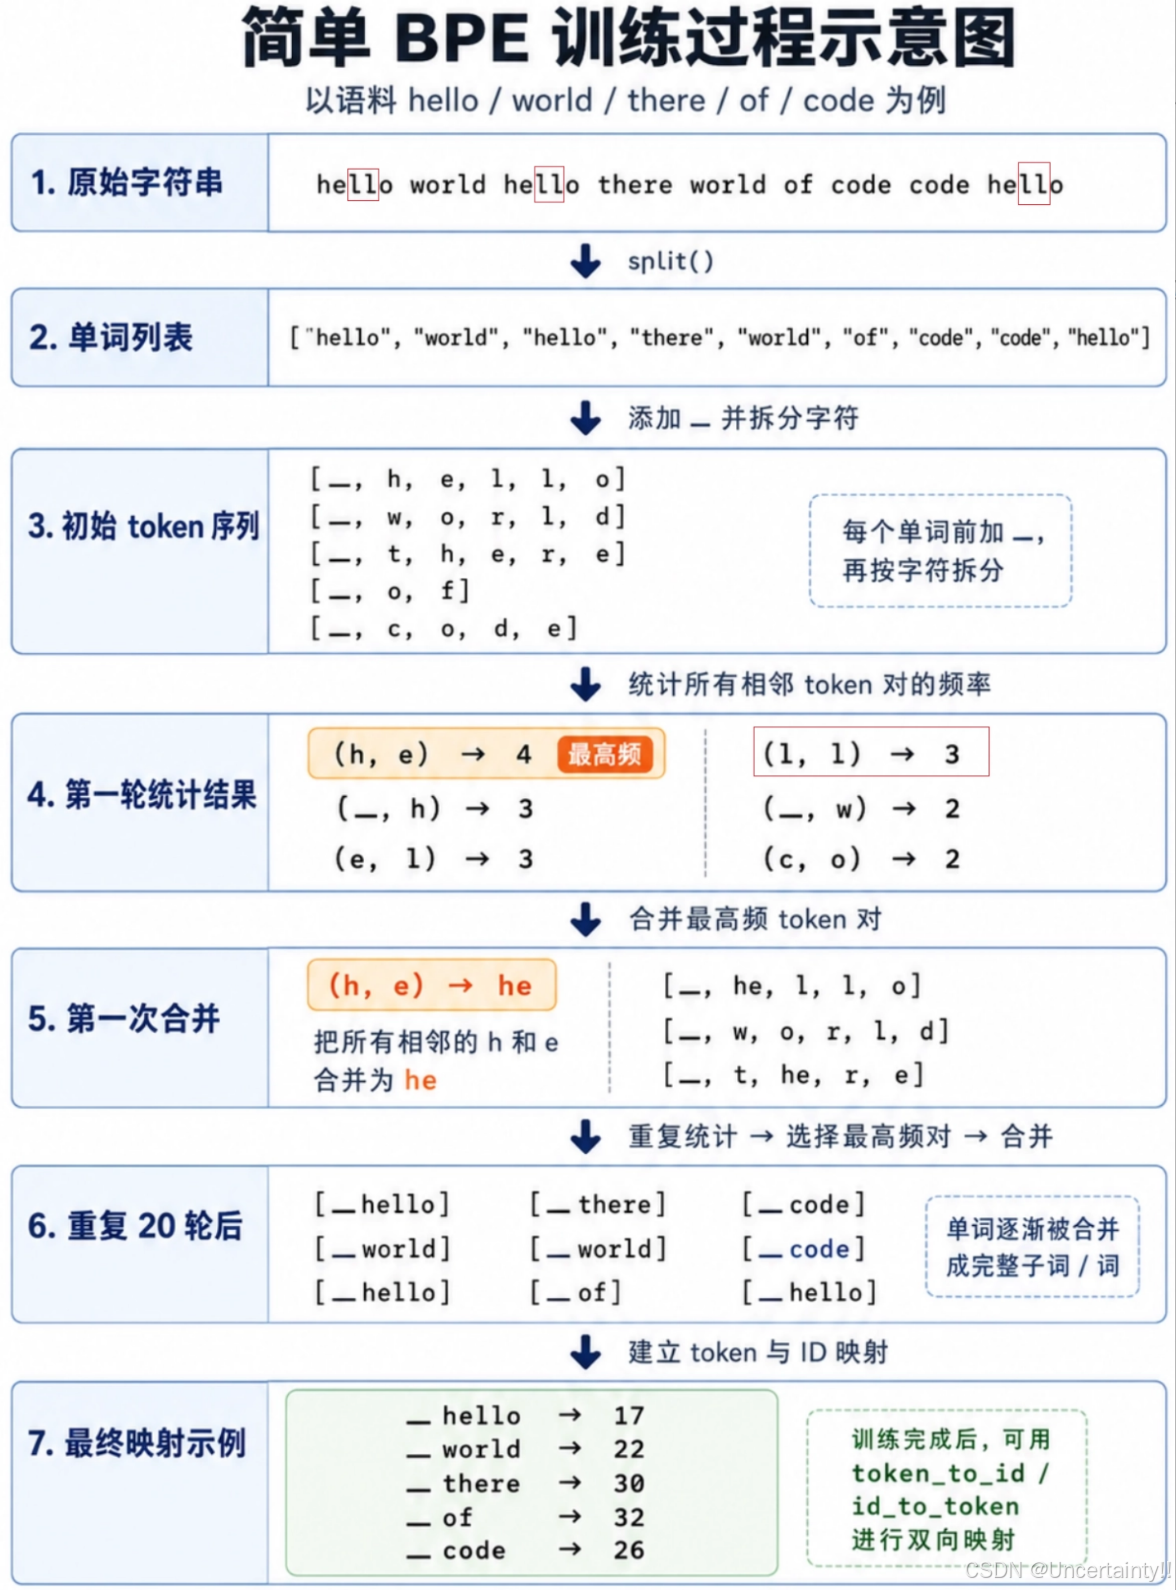
分词器BPE,其作用是将文本切分为token
BPE学习的是输入语料中高频、稳定出现的字符组合规则,并把这些组合保存为新的 token,使文本表示从"字符级"逐渐变成"子词级"
BPE的核心:把词拆分,统计相邻token对出现频次,找最高频,合并
BPE 学习的对象是:哪些字符片段应该作为一个整体 token 保存下来
BPE 学习的结果
包含:"", "", "▁", "h", "e", "l", "o", "he", "▁he", "▁hello", "▁world", "▁code"
特殊字符 ", "", "▁"
基础字符(作用:处理没有见过的新词) 单字母 h、e、l......
高频子词(作用:BPE 真正想学习的东西)ing、tion、pre......
高频完整词(某个词出现特别频繁)_hello、_world
1.3.2 token → token ID → WordEmbedding → InputEmbedding
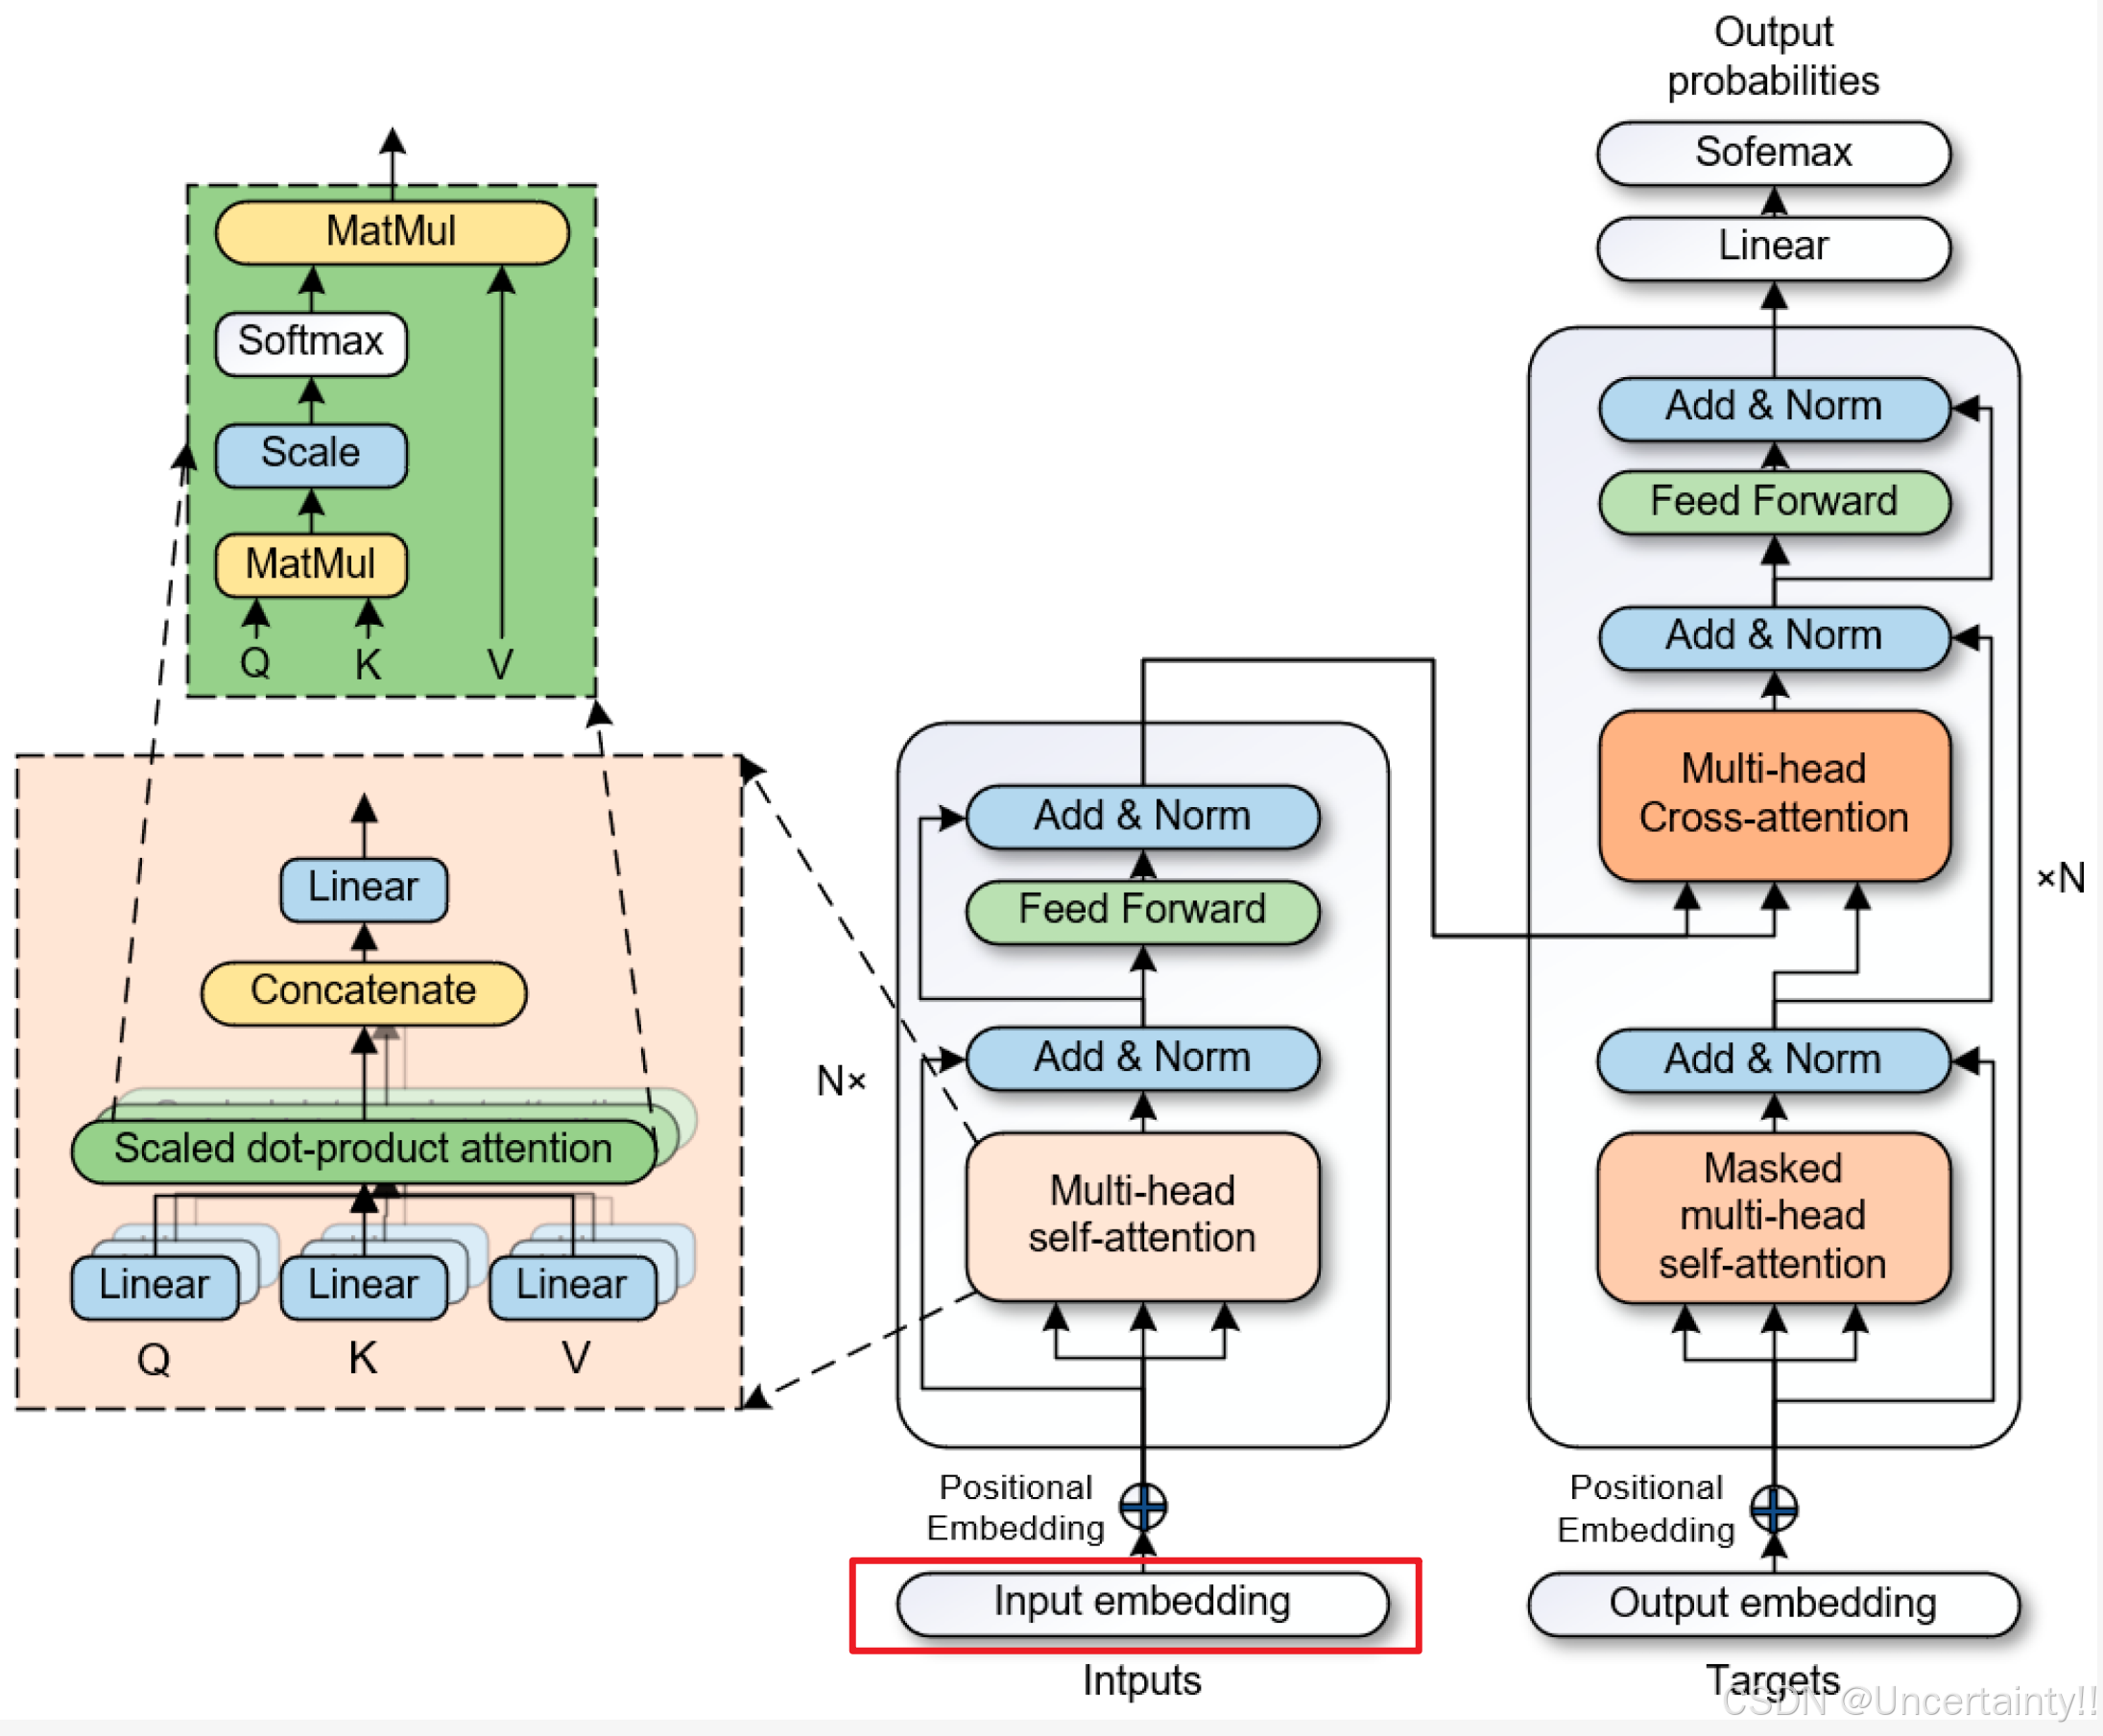
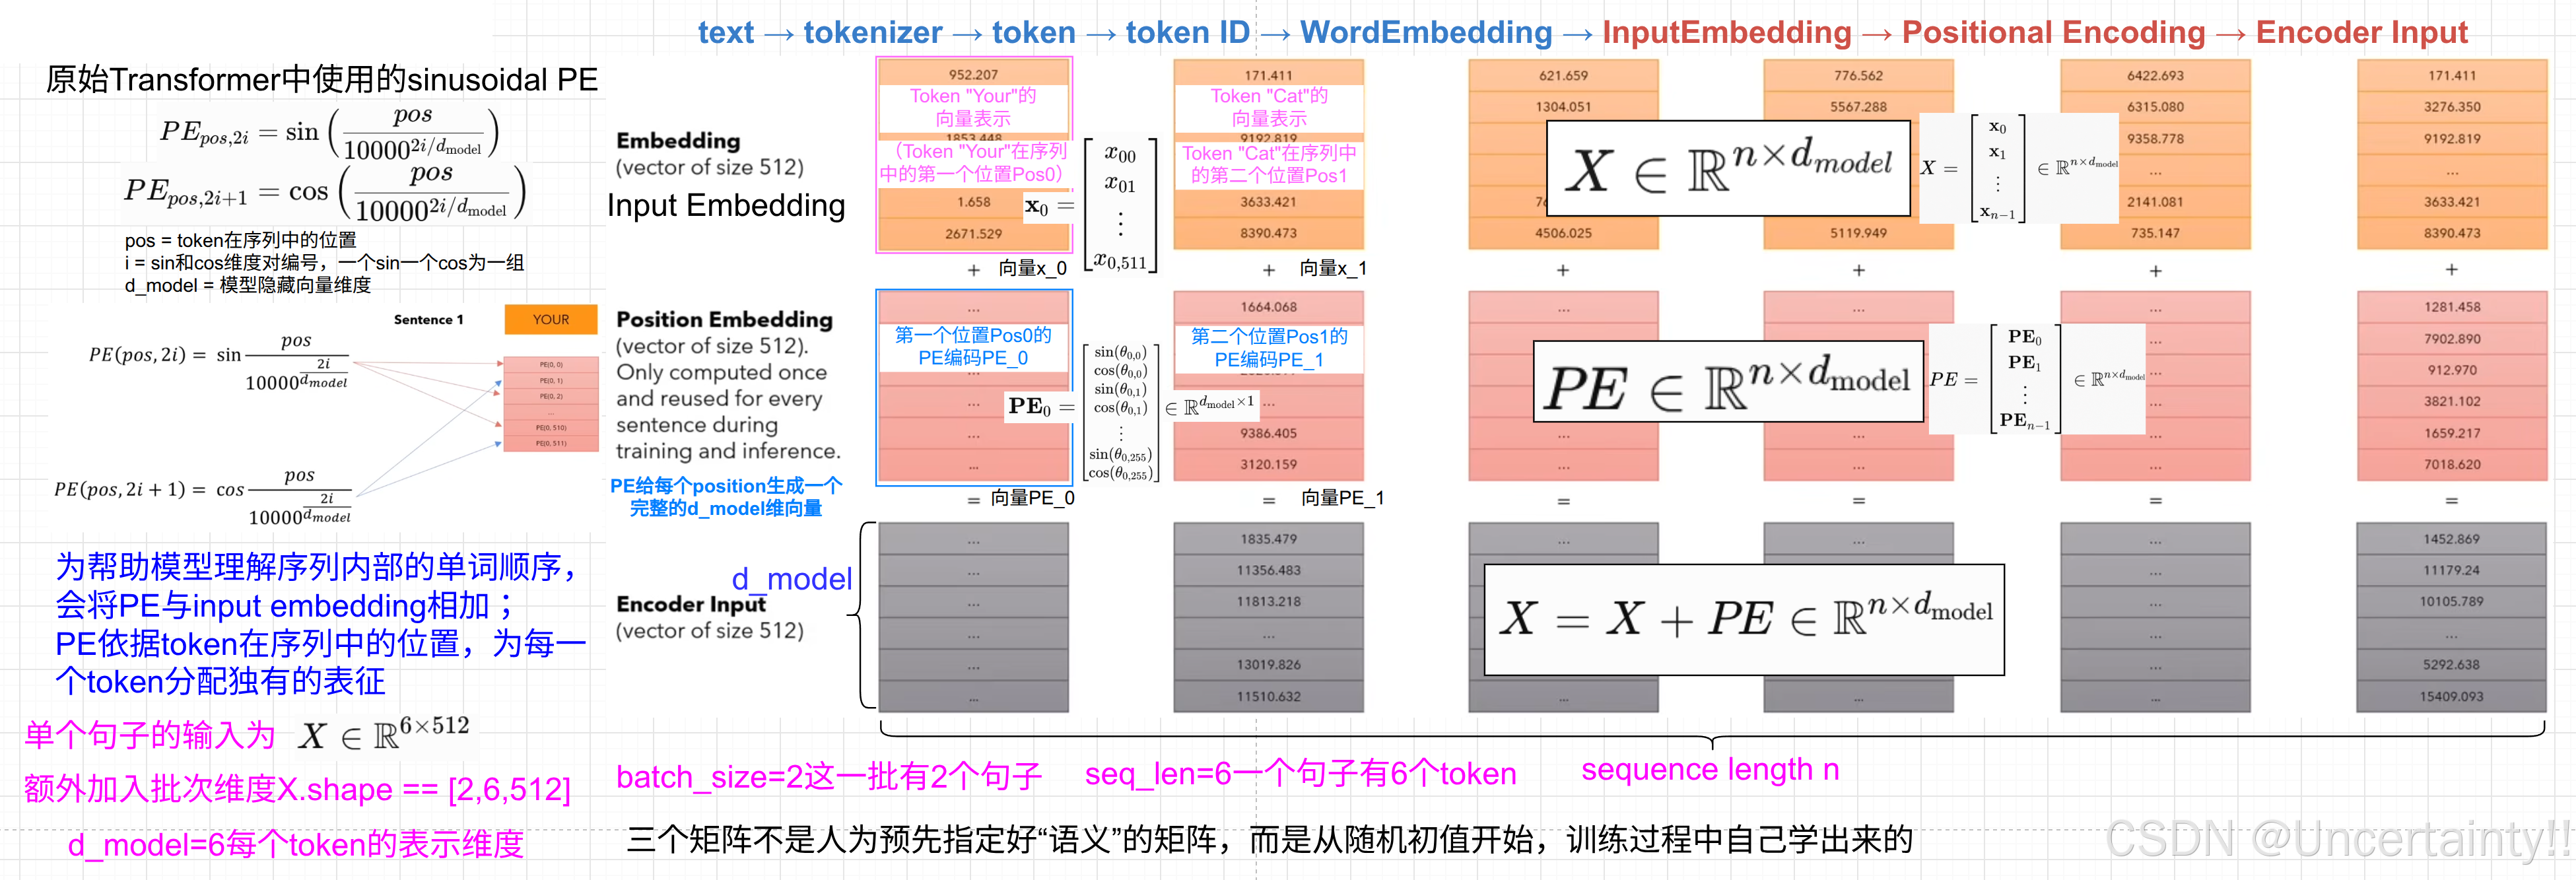
这一步我们得到了输入transformer的input embedding
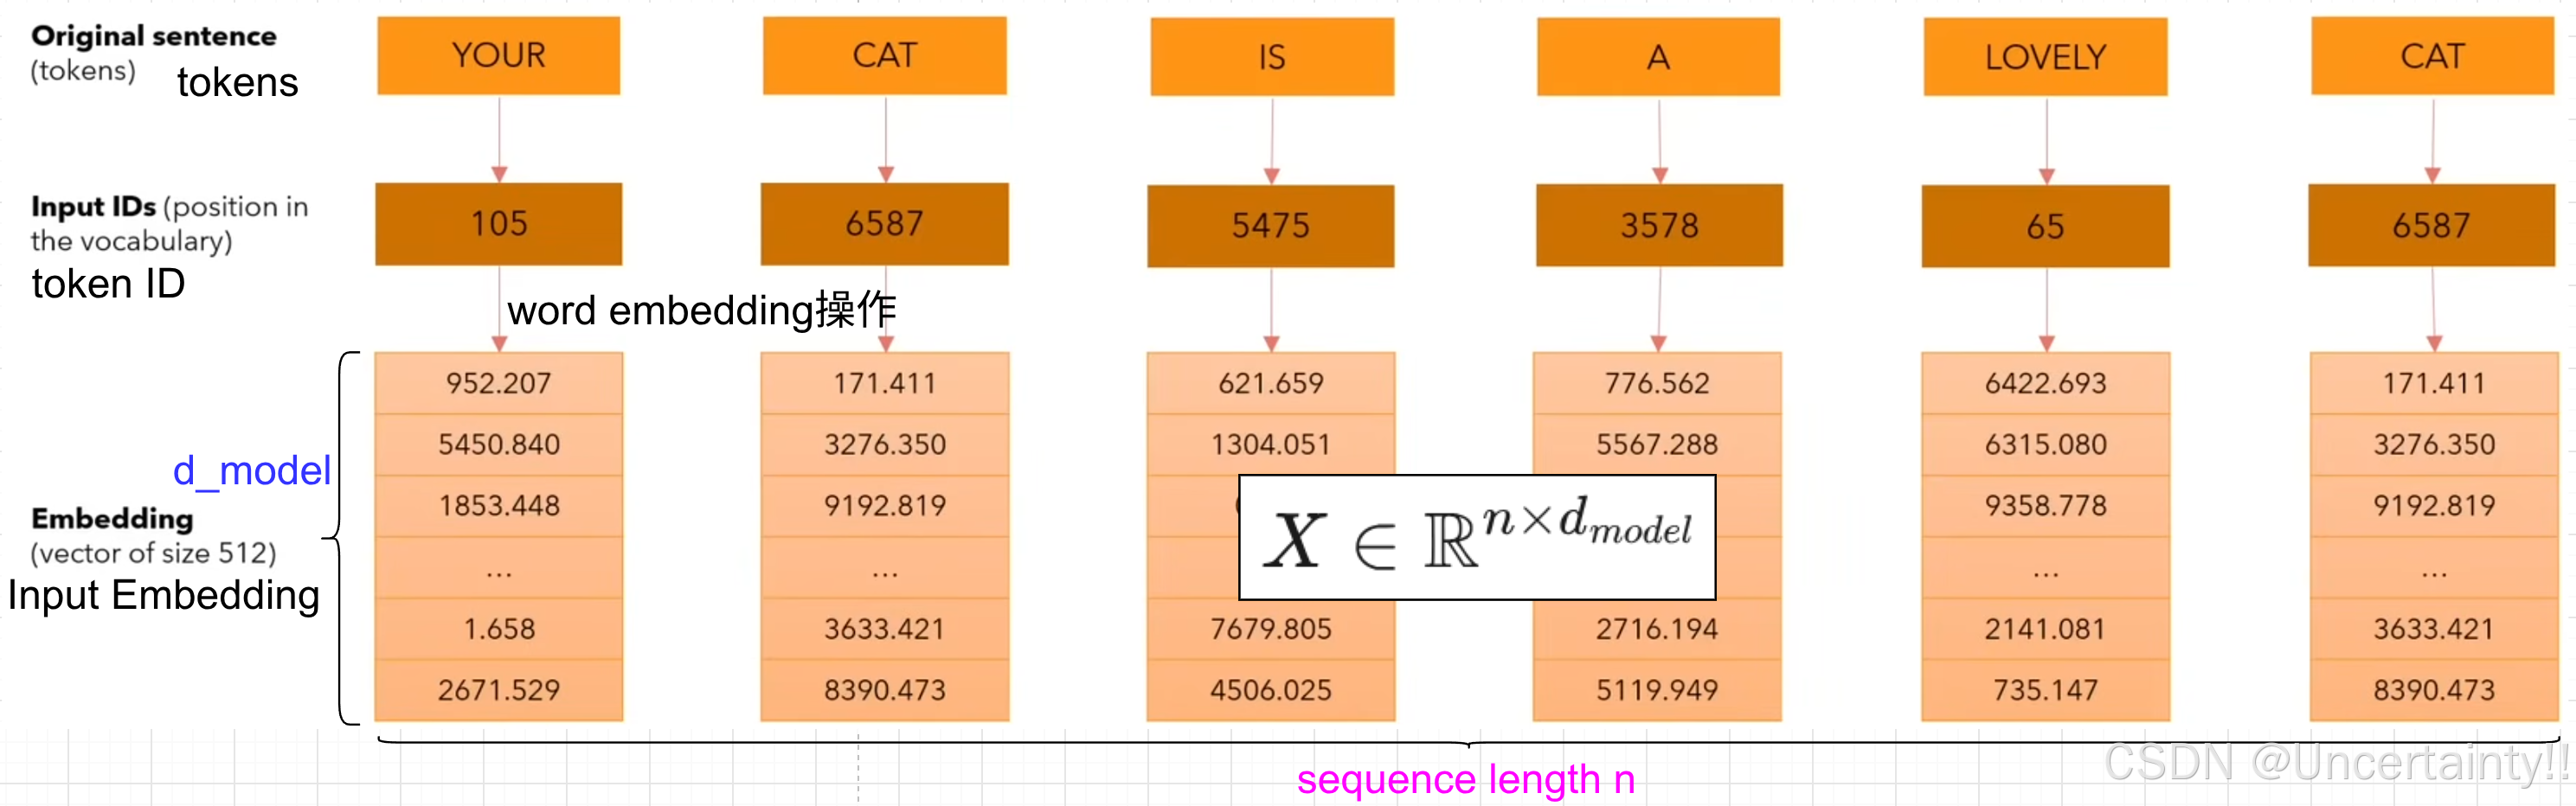
提前熟悉几个变量
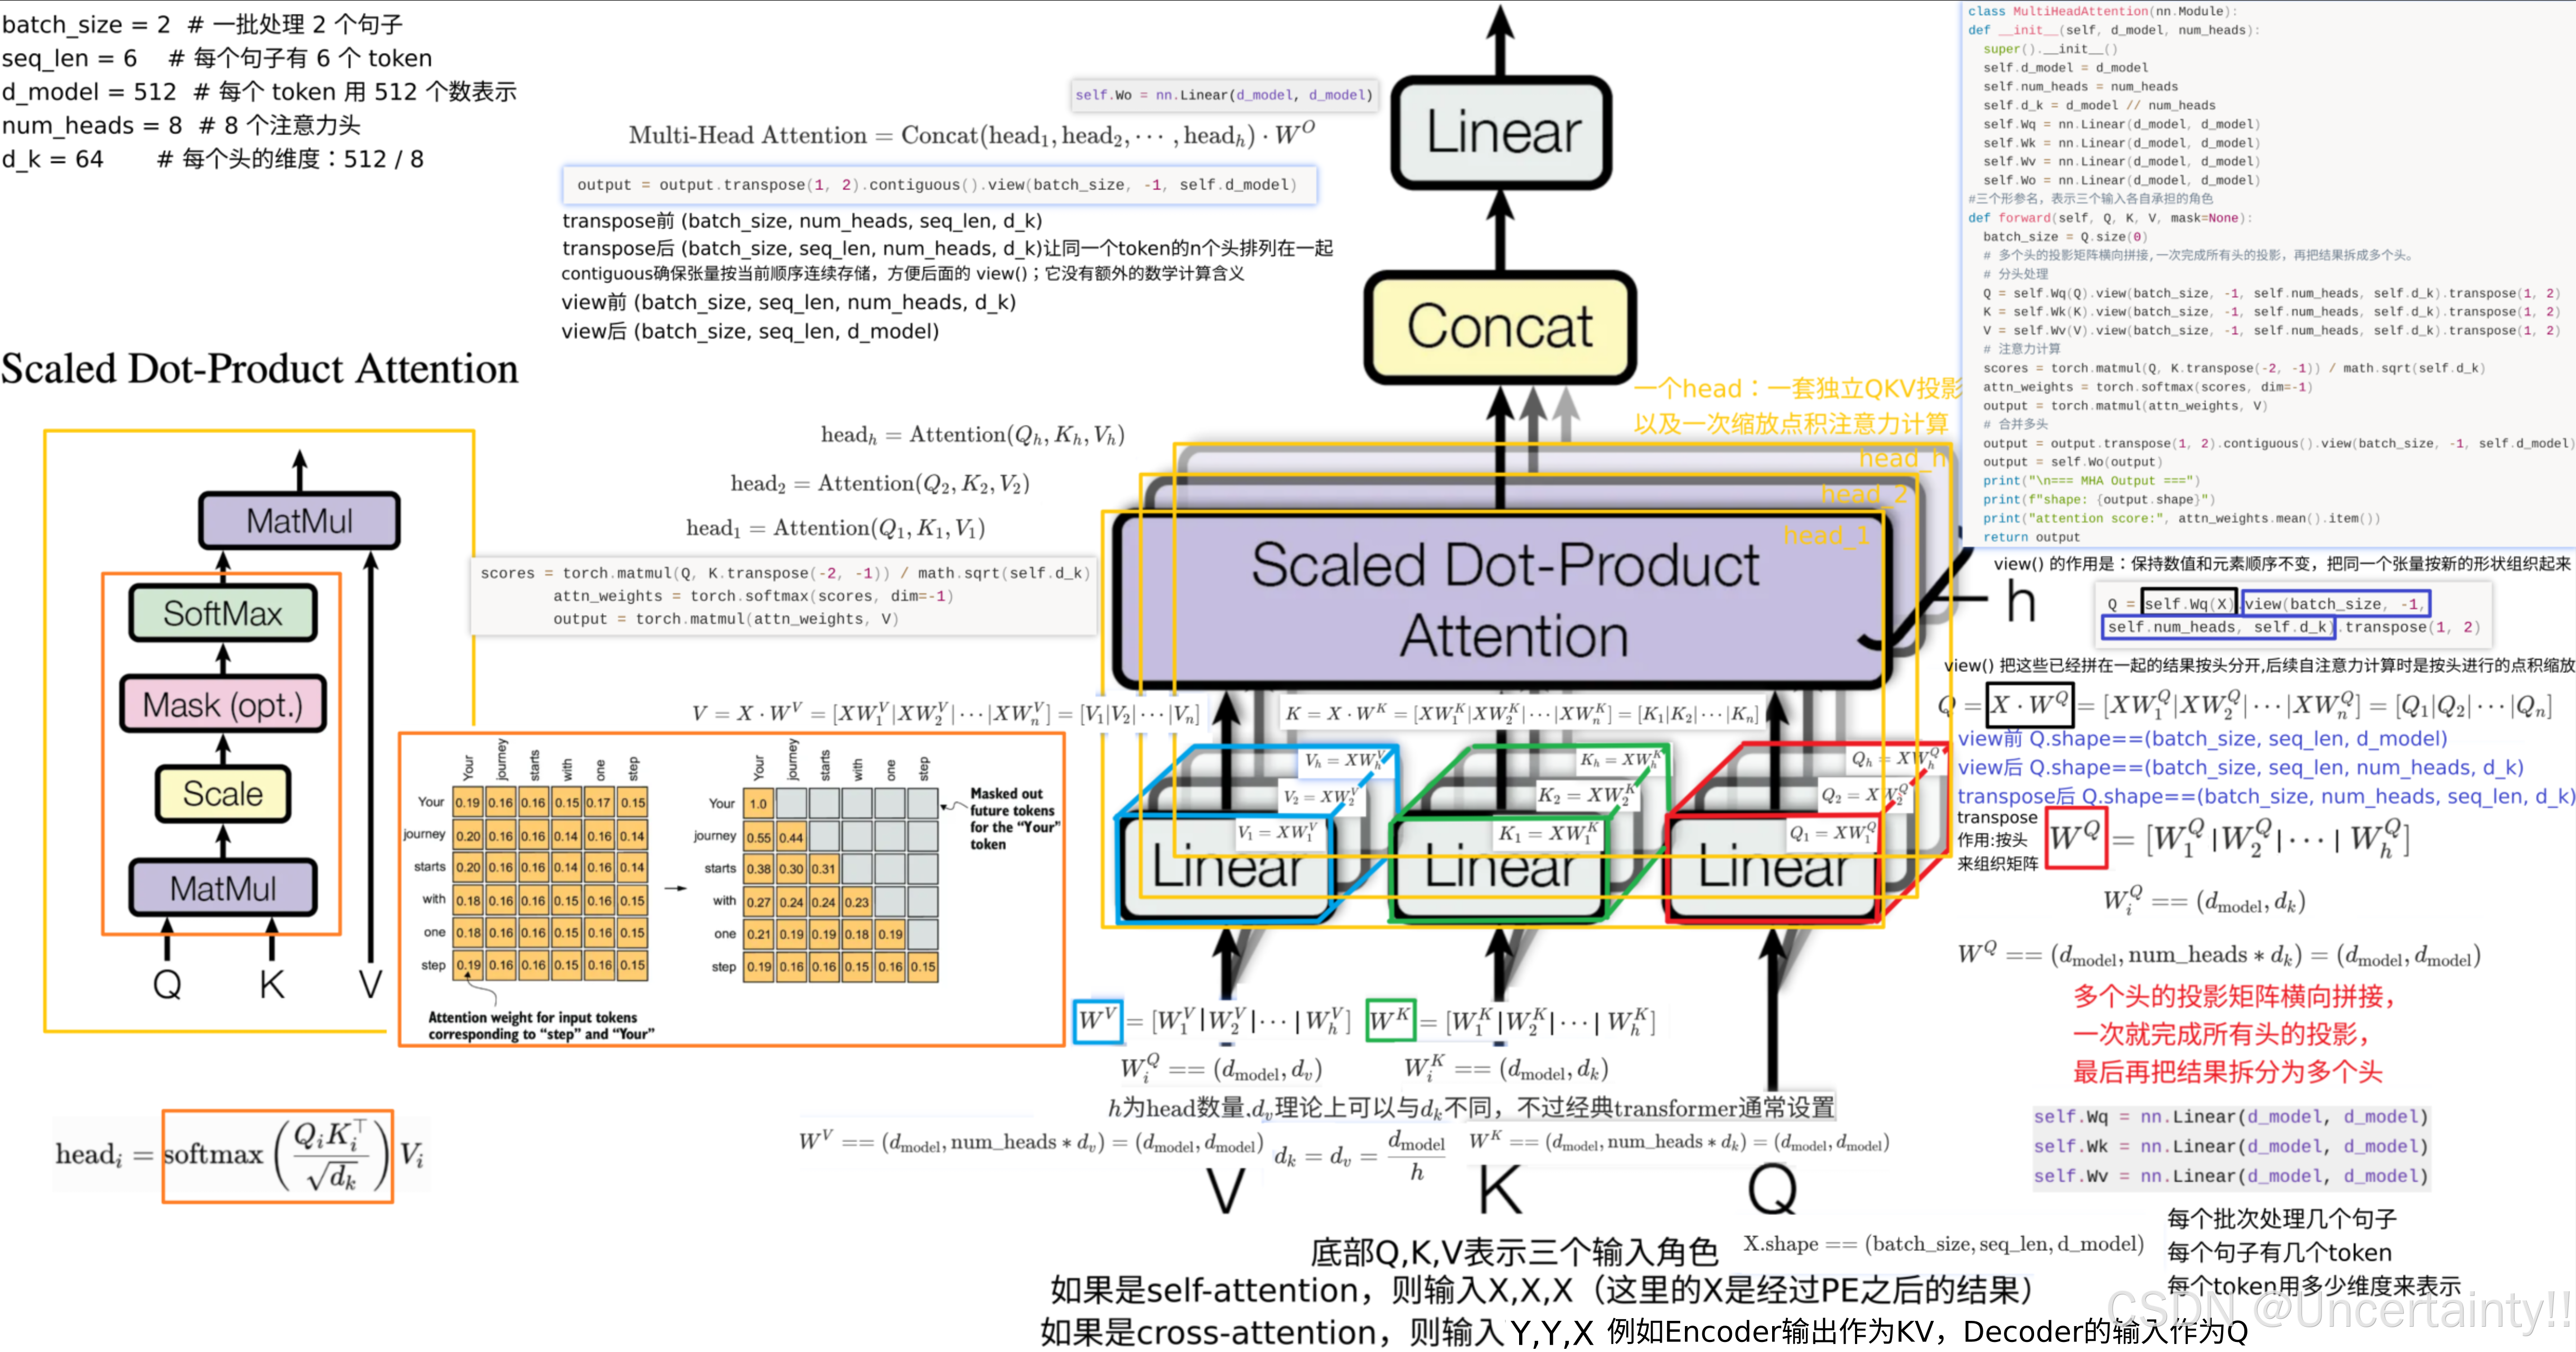
batch_size = 2 # 一批处理 2 个句子
seq_len = 6 # 每个句子有 6 个 token
d_model = 512 # 每个 token 用 512 个数表示
num_heads = 8 # 8 个注意力头
d_k = 64 # 每个头的维度:512 / 8
batch_size 一个批次可能同时处理好几个句子
seq_len 每个句子包含多少token
d_model 模型的隐藏向量维度,一个token用多少个数字(特征)来表示,这里所说的特征指的是语义、语法、词性、上下文等信息,特征越多,表达能力越强
num_heads 单头注意力难以捕捉不同语义关系,多头让不同头专注不同子空间,增强表征能力
d_k = d_model // num_heads 单个头的维度
1.3.3 InputEmbedding → Positional Encoding → Encoder Input
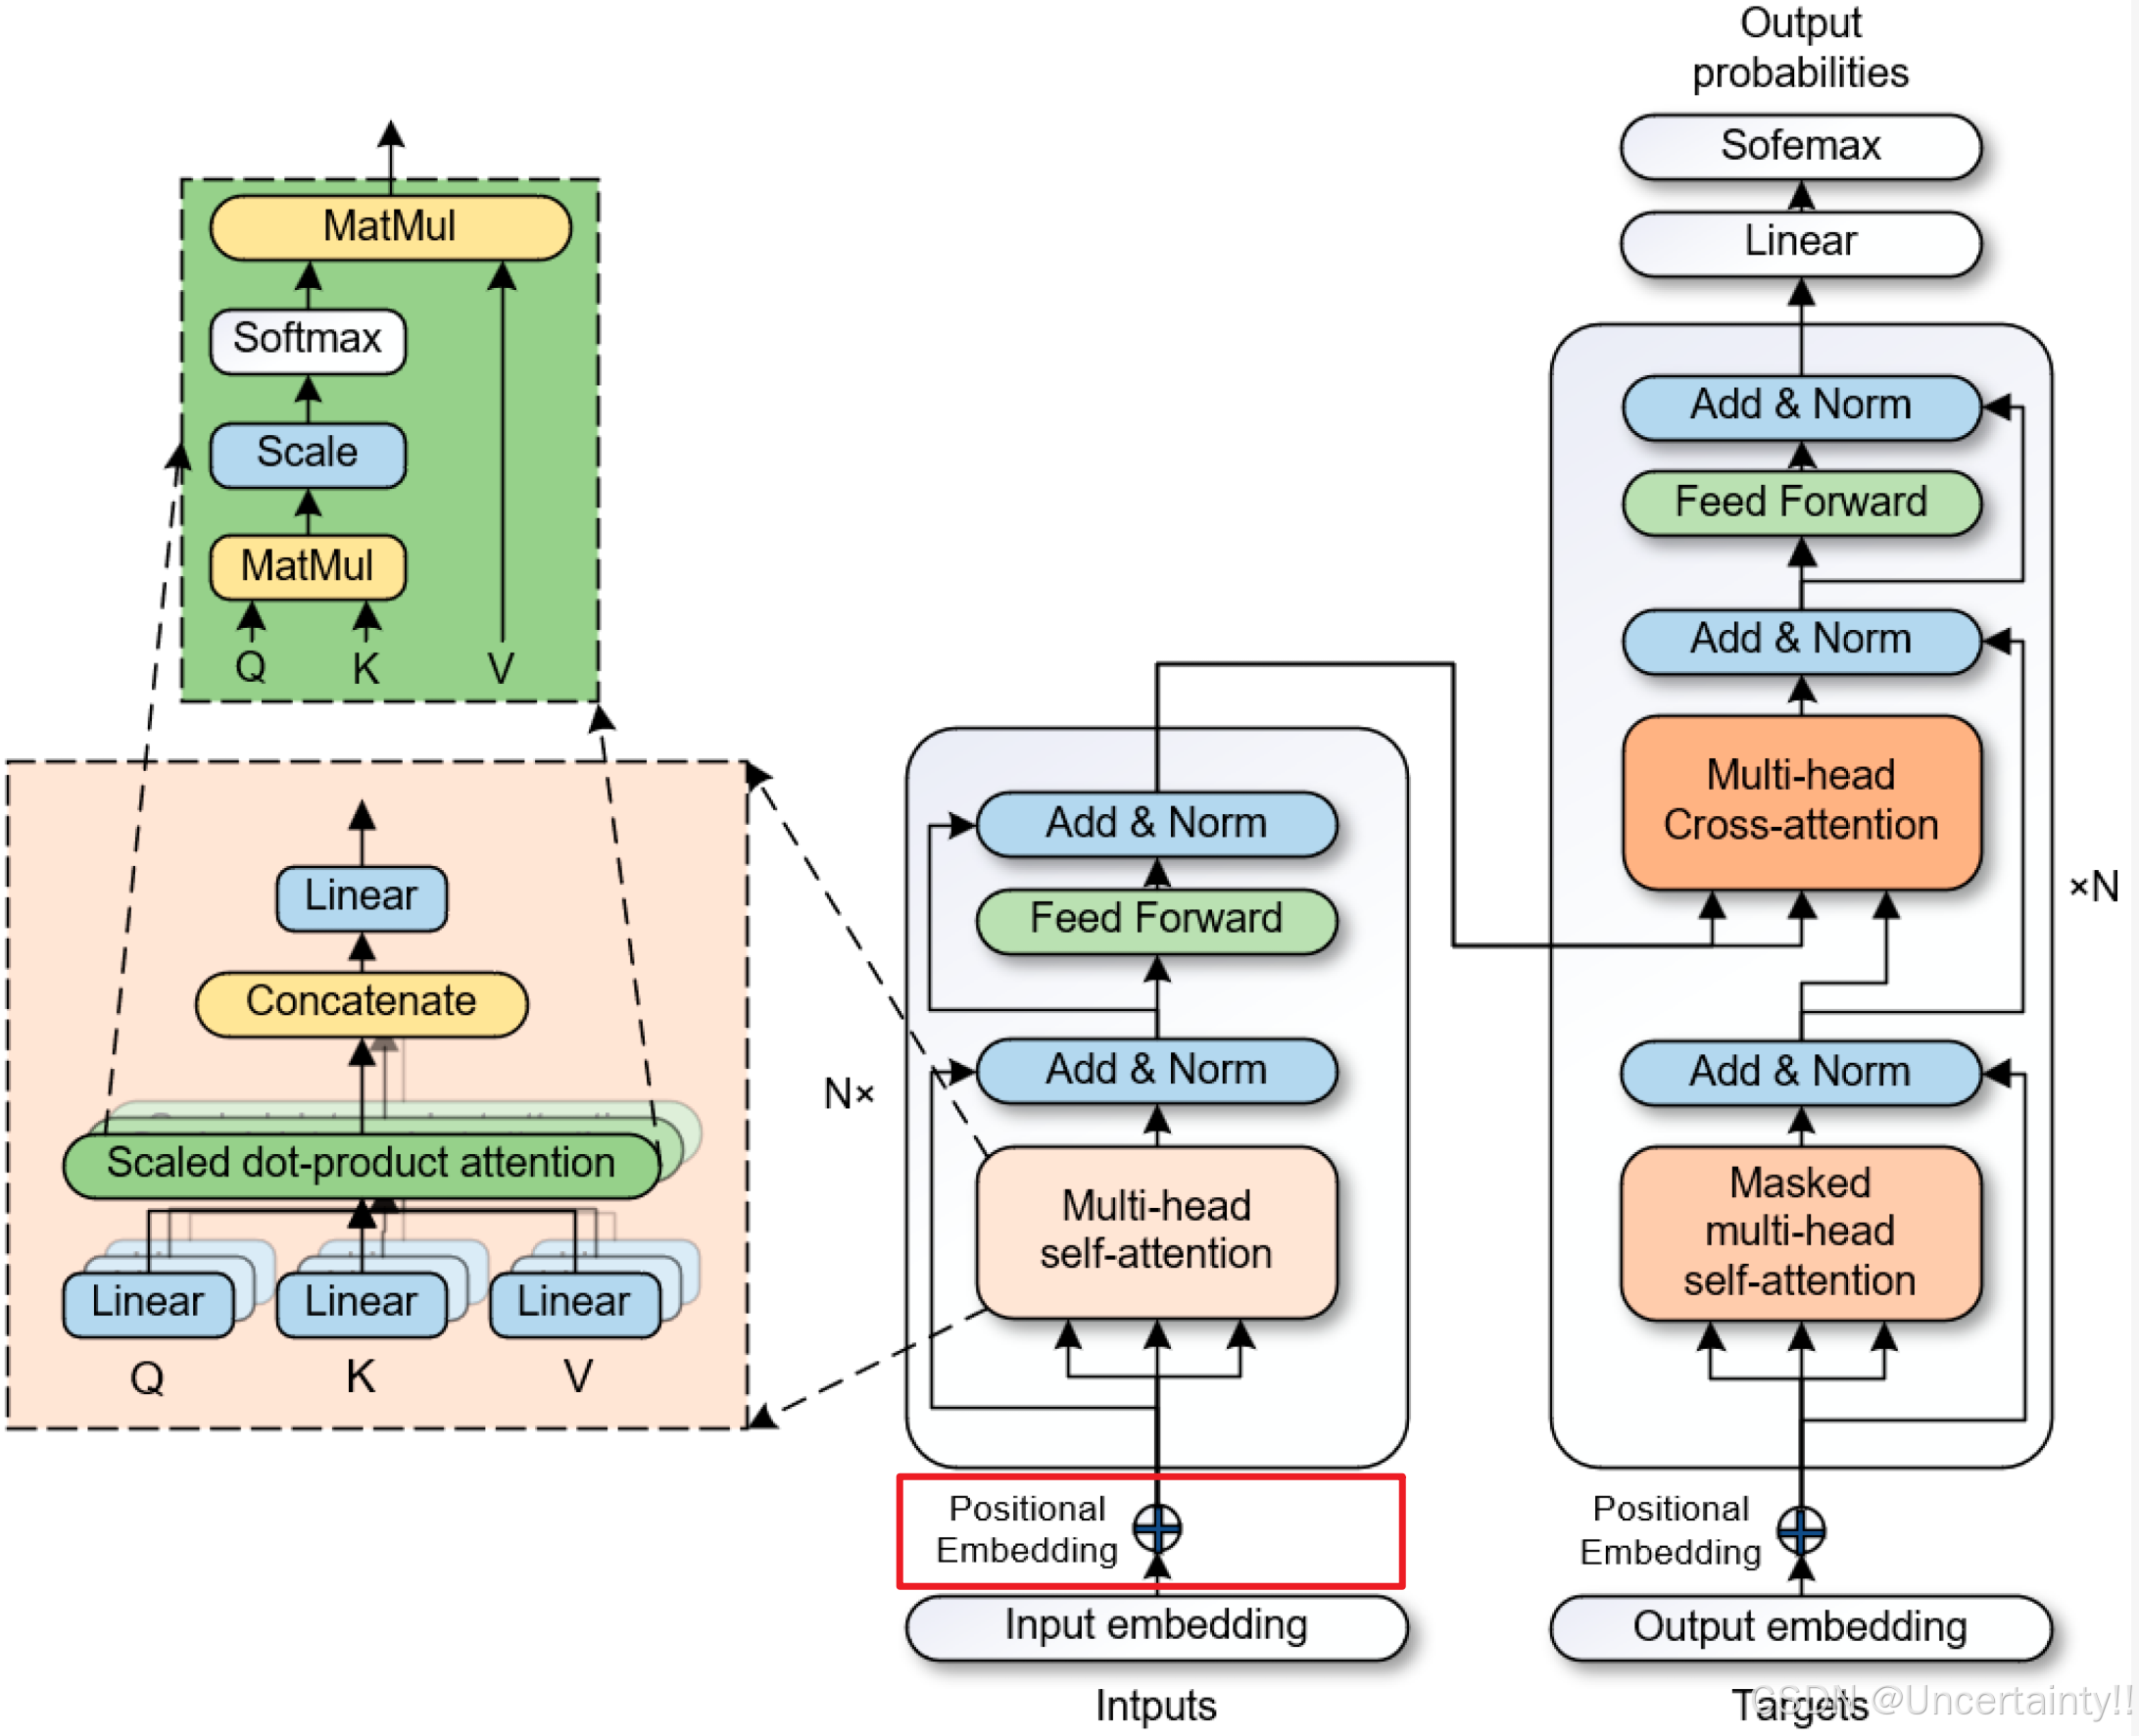
位置编码的必要性:文本并行输入并没有先后输入顺序,为了区别文本的输入顺序确保语义正确,引入位置编码确定输入词向量的先后顺序
1.3.4 Encoder Input → Encoder
(1)Multi-Head self-attention,MHA (多头注意力)
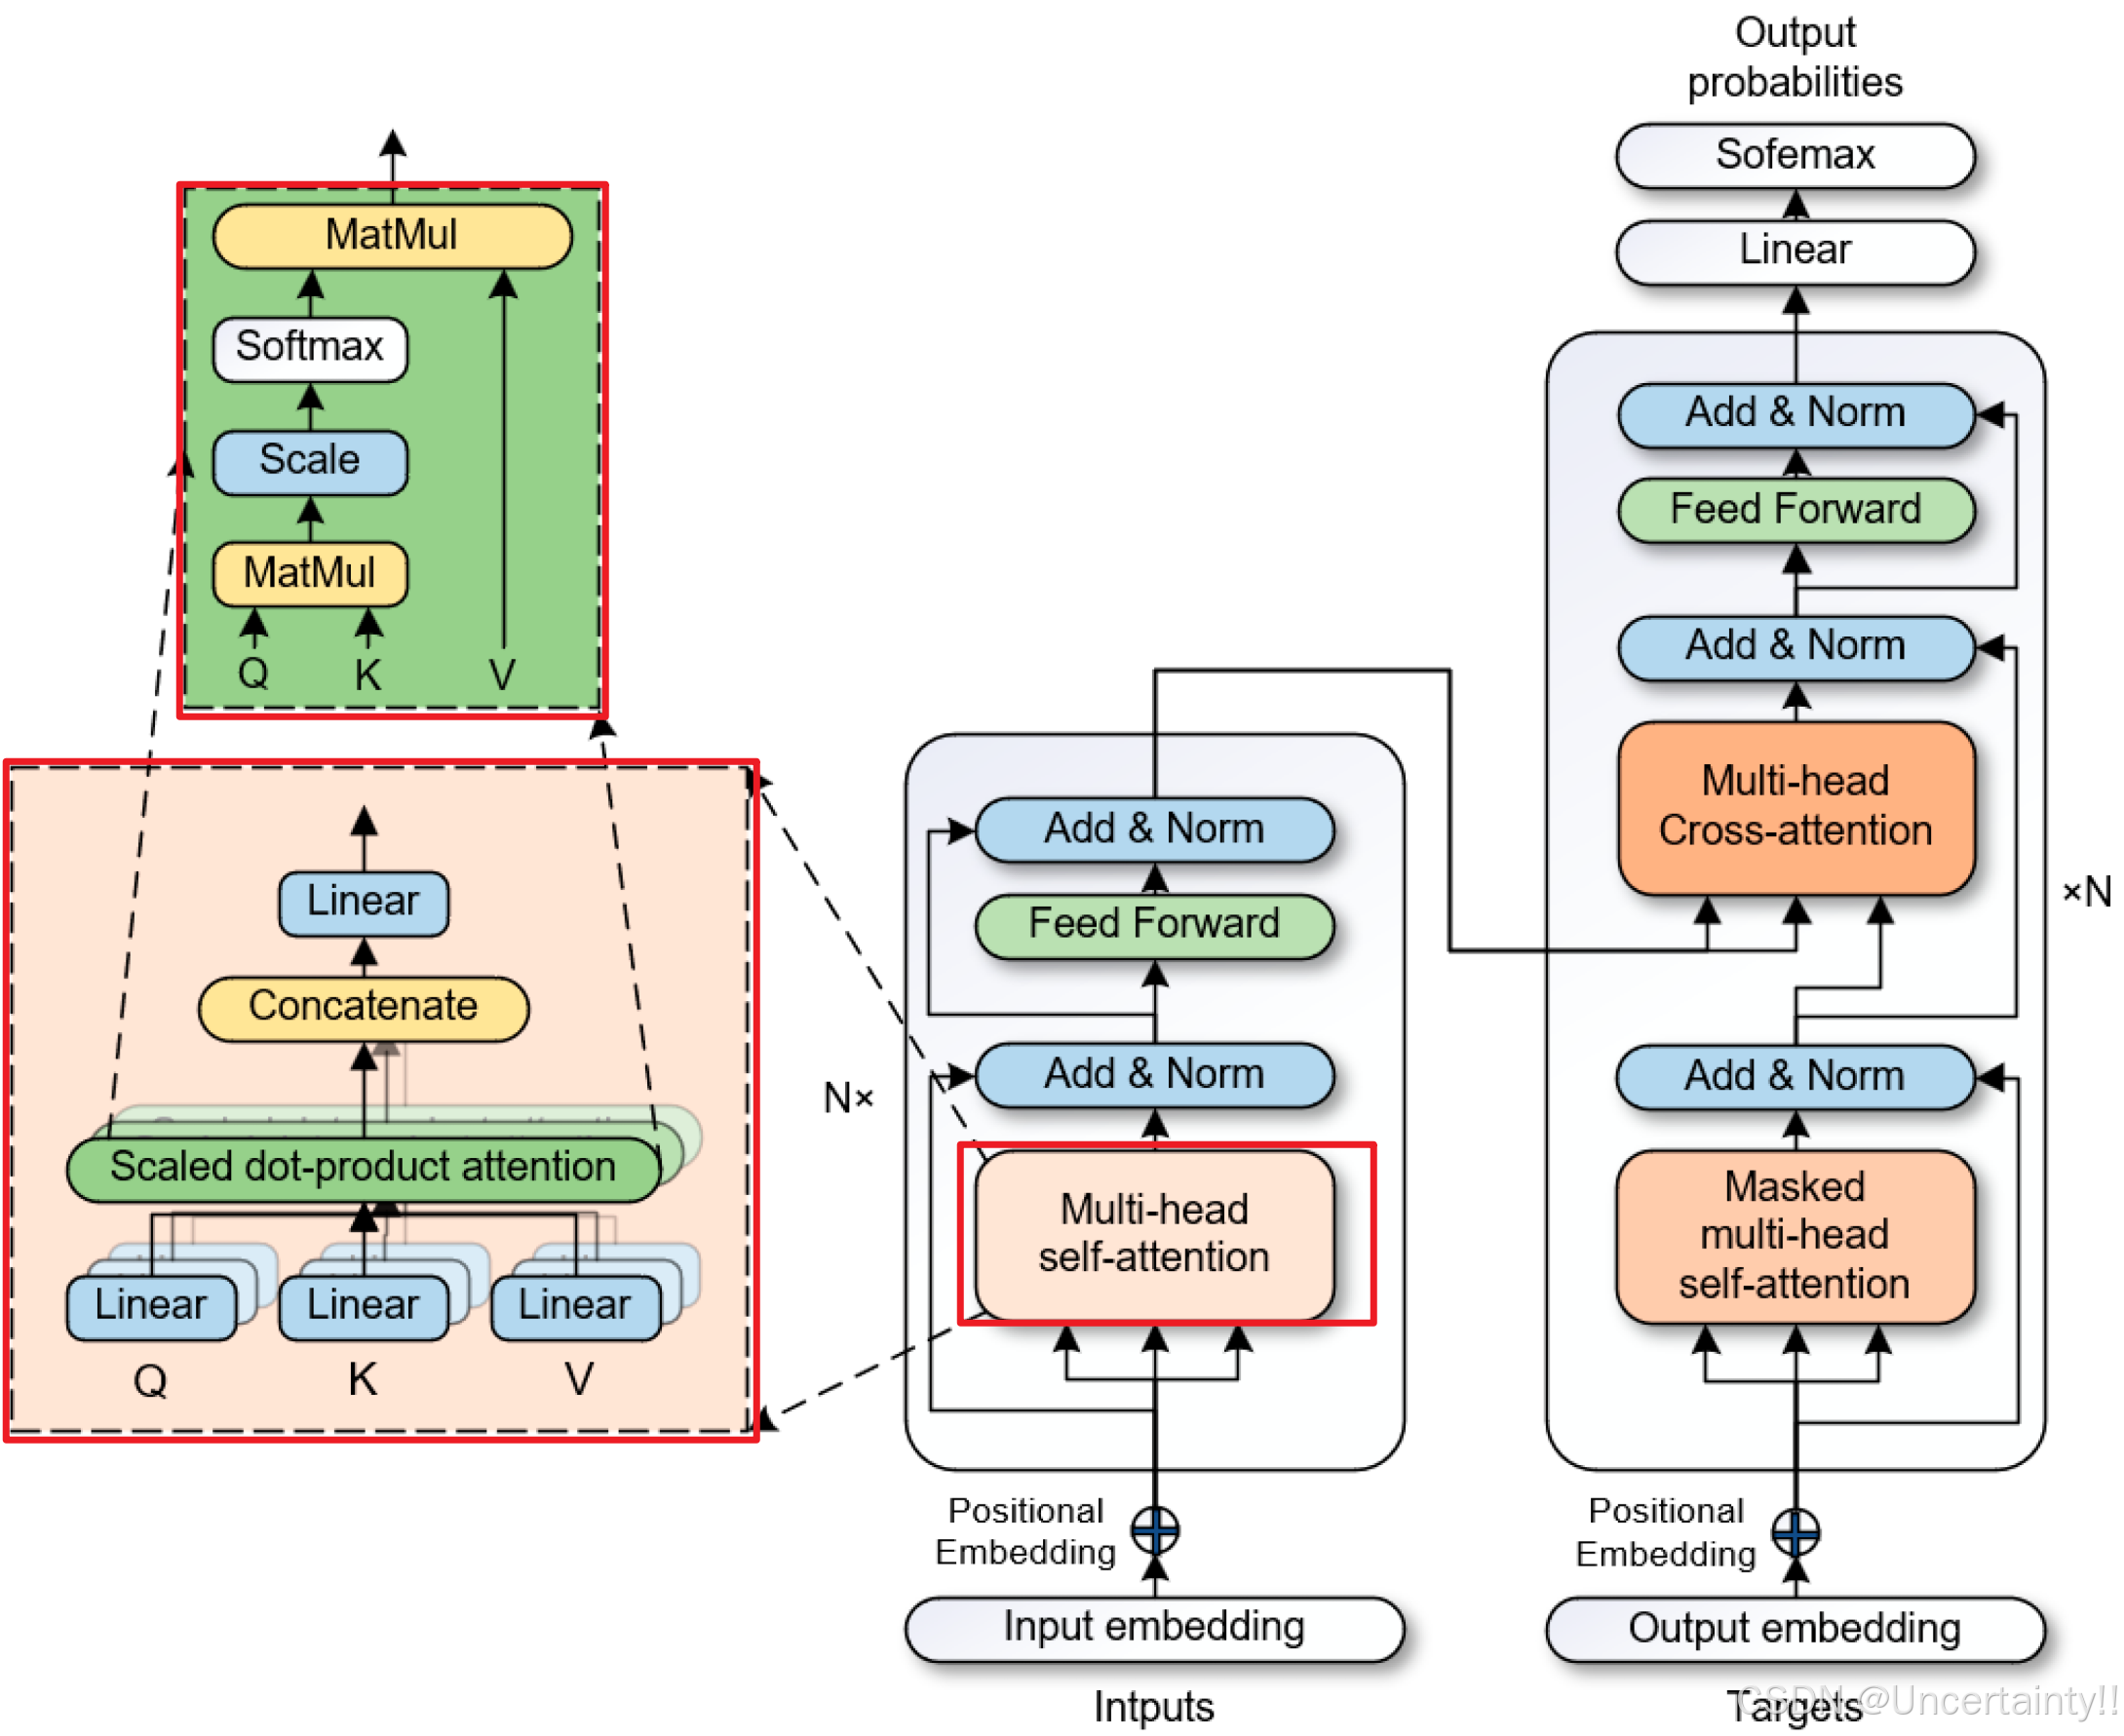
MHA输入的X是经过PE处理后的embedding
MHA输入的三个矩阵QKV (这里QKV只是表示输入角色即query查询,key键,value值,与后续计算得到的QKV无关),如果是self-attention,则QKV来源相同,都来自同一个序列,如果是cross-attention,则QKV来源不同,来自不同序列
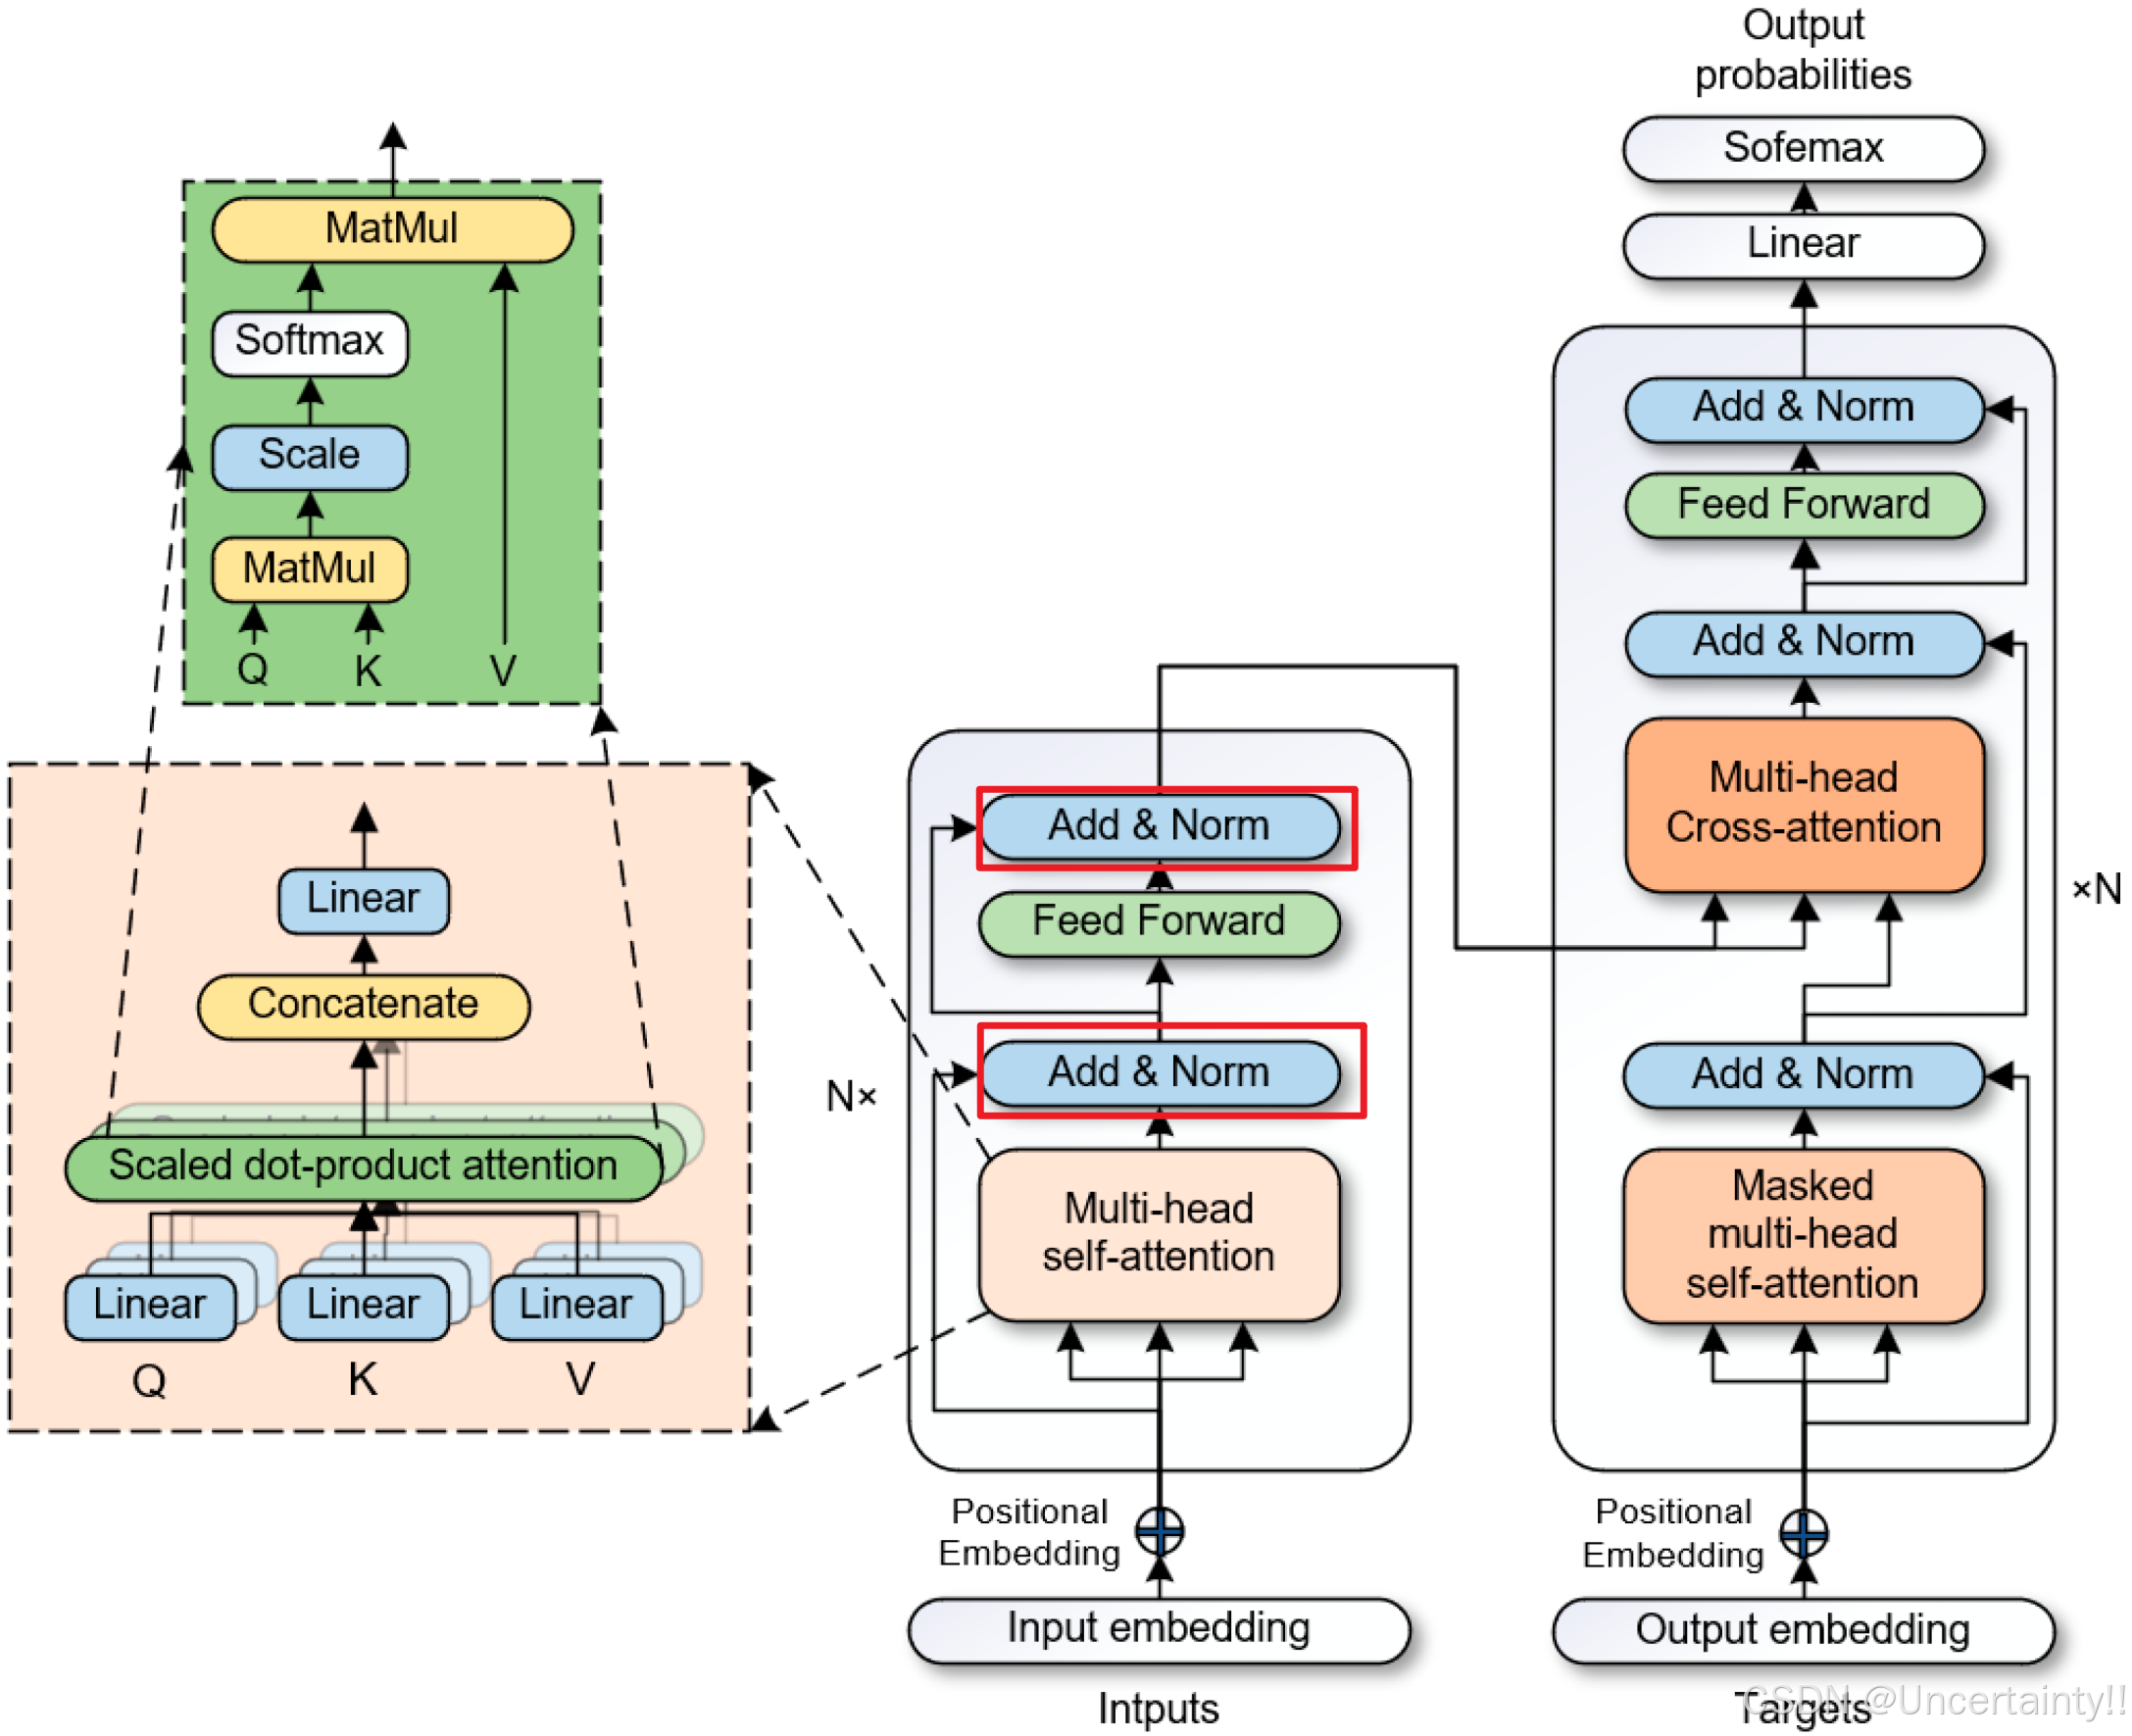
(2)残差连接和层归一化
残差连接:原来输入与变换后结果相加、作用:缓解梯度消失
层归一化:把token向量的数值拉回稳定范围,加快模型收敛速度
Post-LN:先残差再LN(原始transformer)、Pre-LN:先LN再残差(现代主流如GPT-3)
(3)前馈神经网络(FFN)
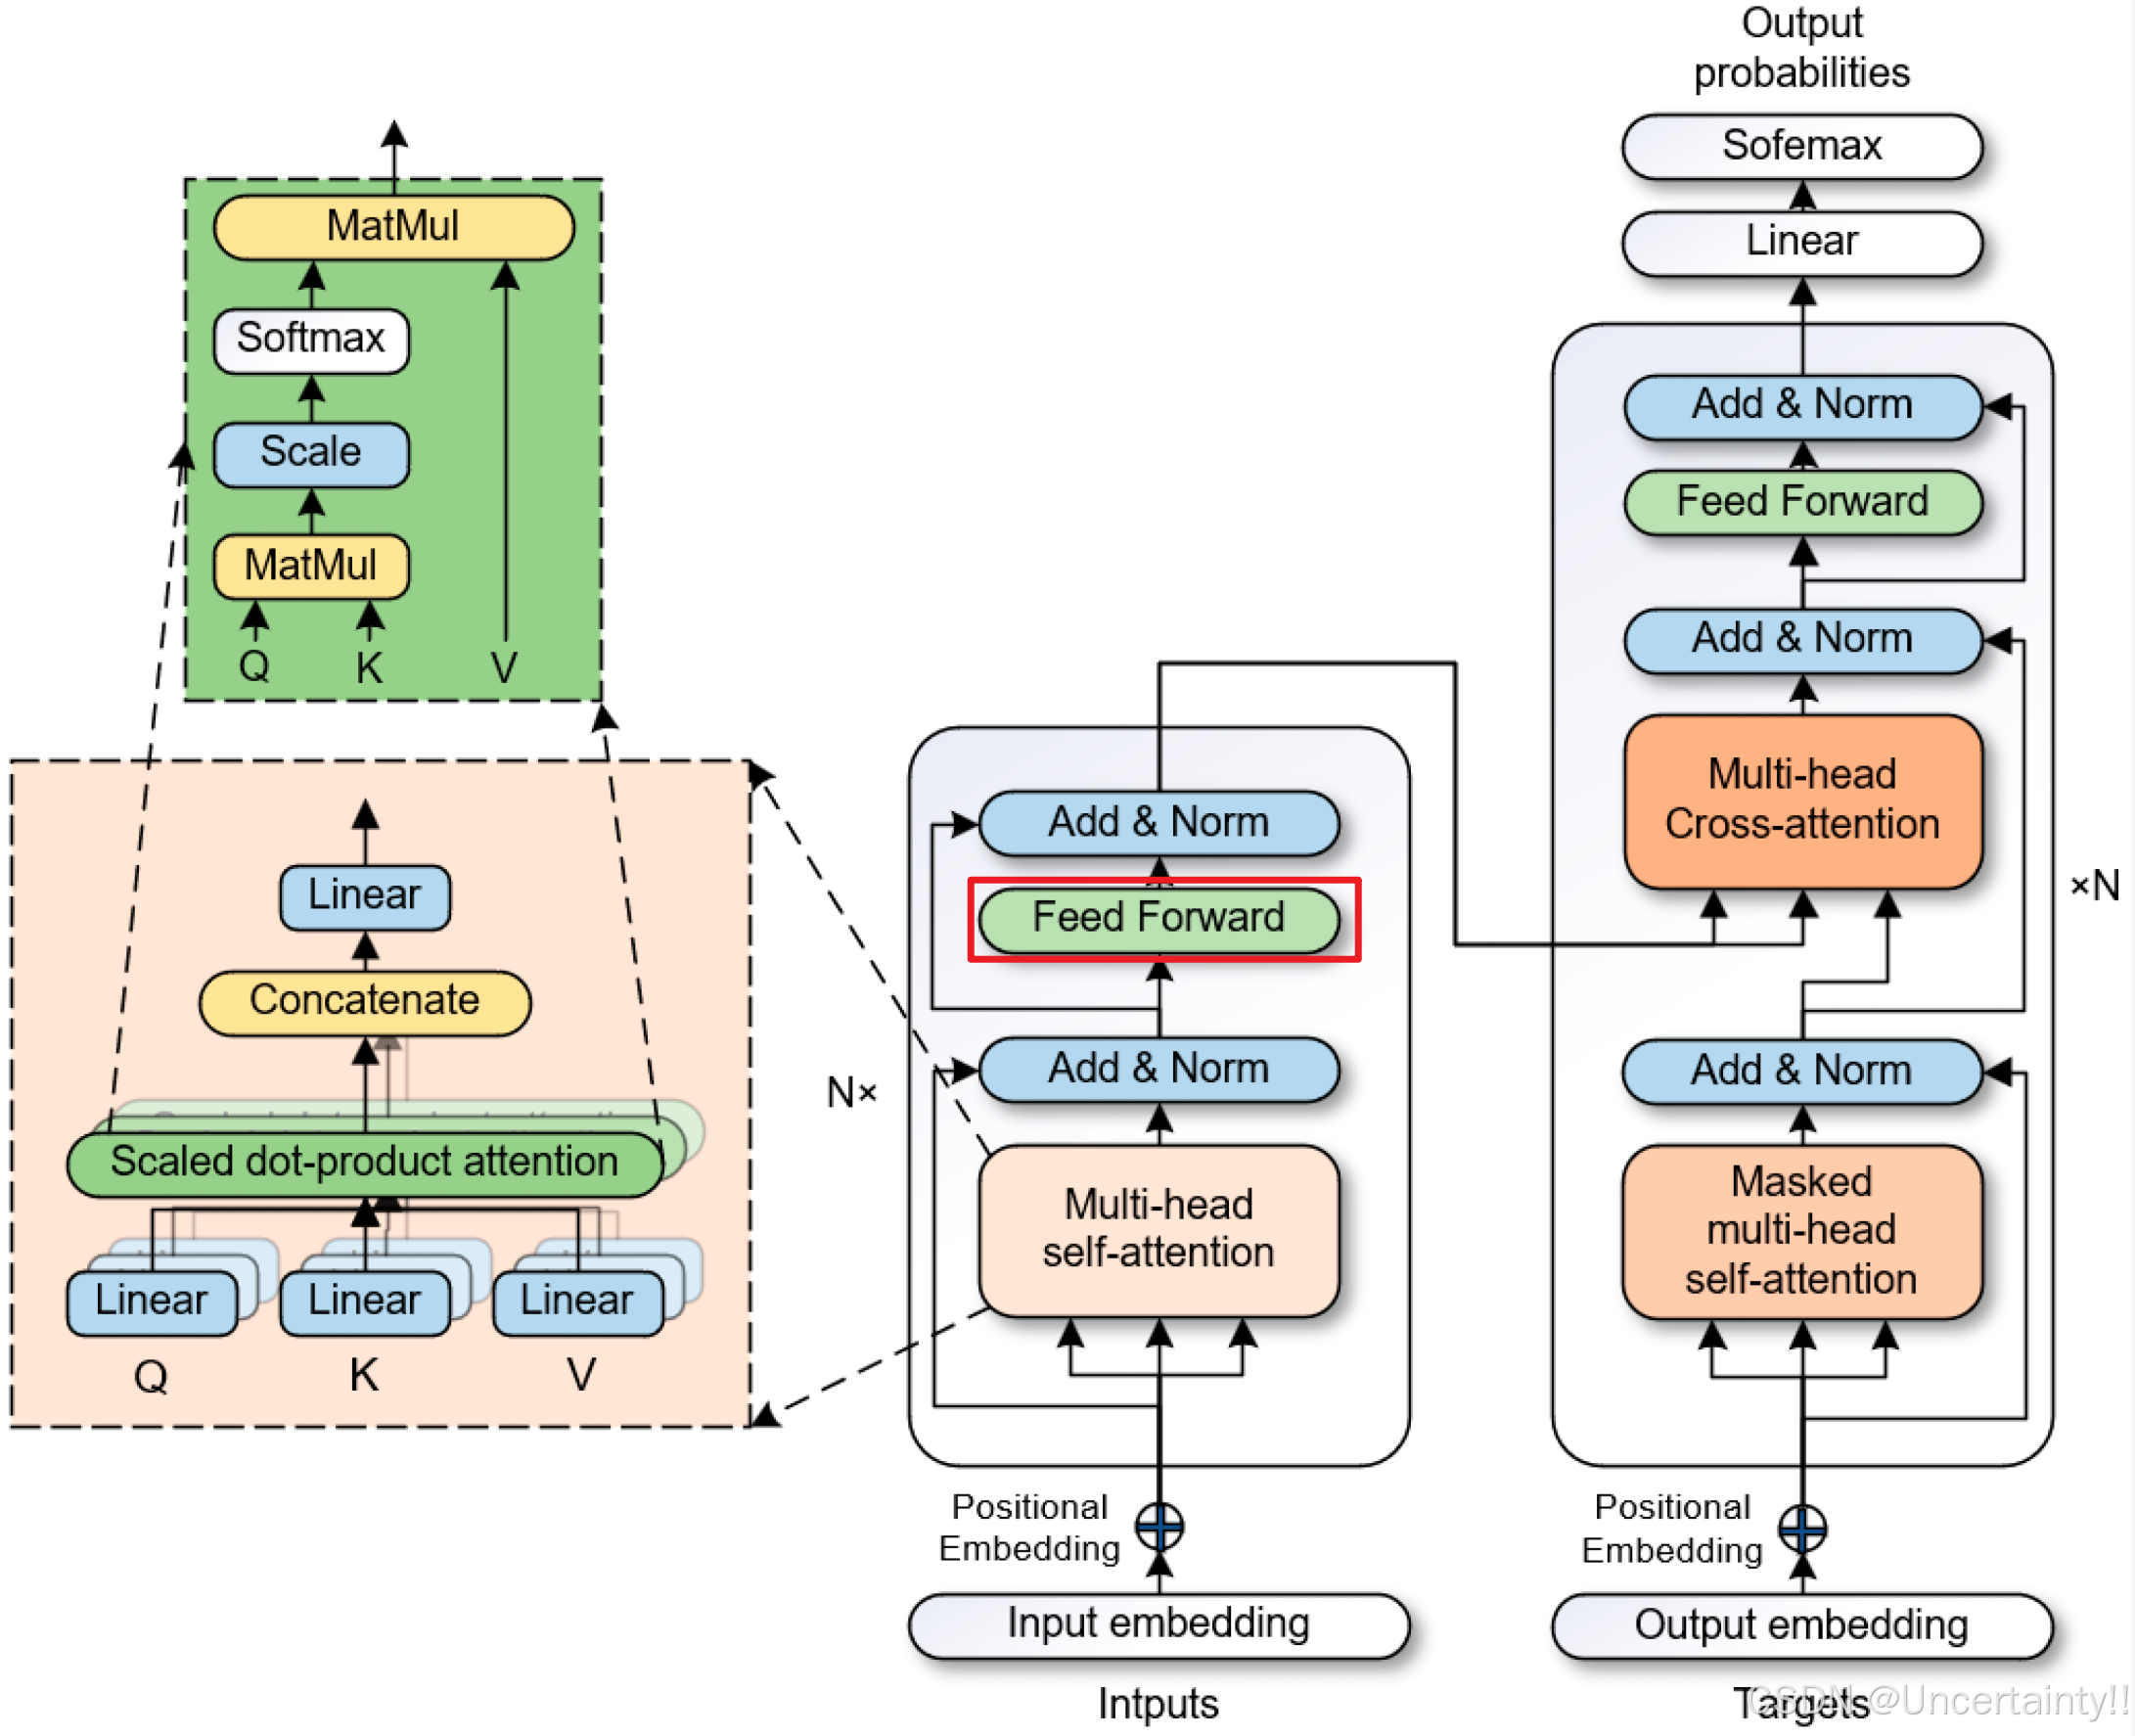
两层Linear线性变换+非线性激活函数ReLU,维度变化d_model → d_ff → d_model
作用:增加非线性变换,FFN 更多负责对每个 Token 自身的特征进行进一步变换
1.3.5 Decoder
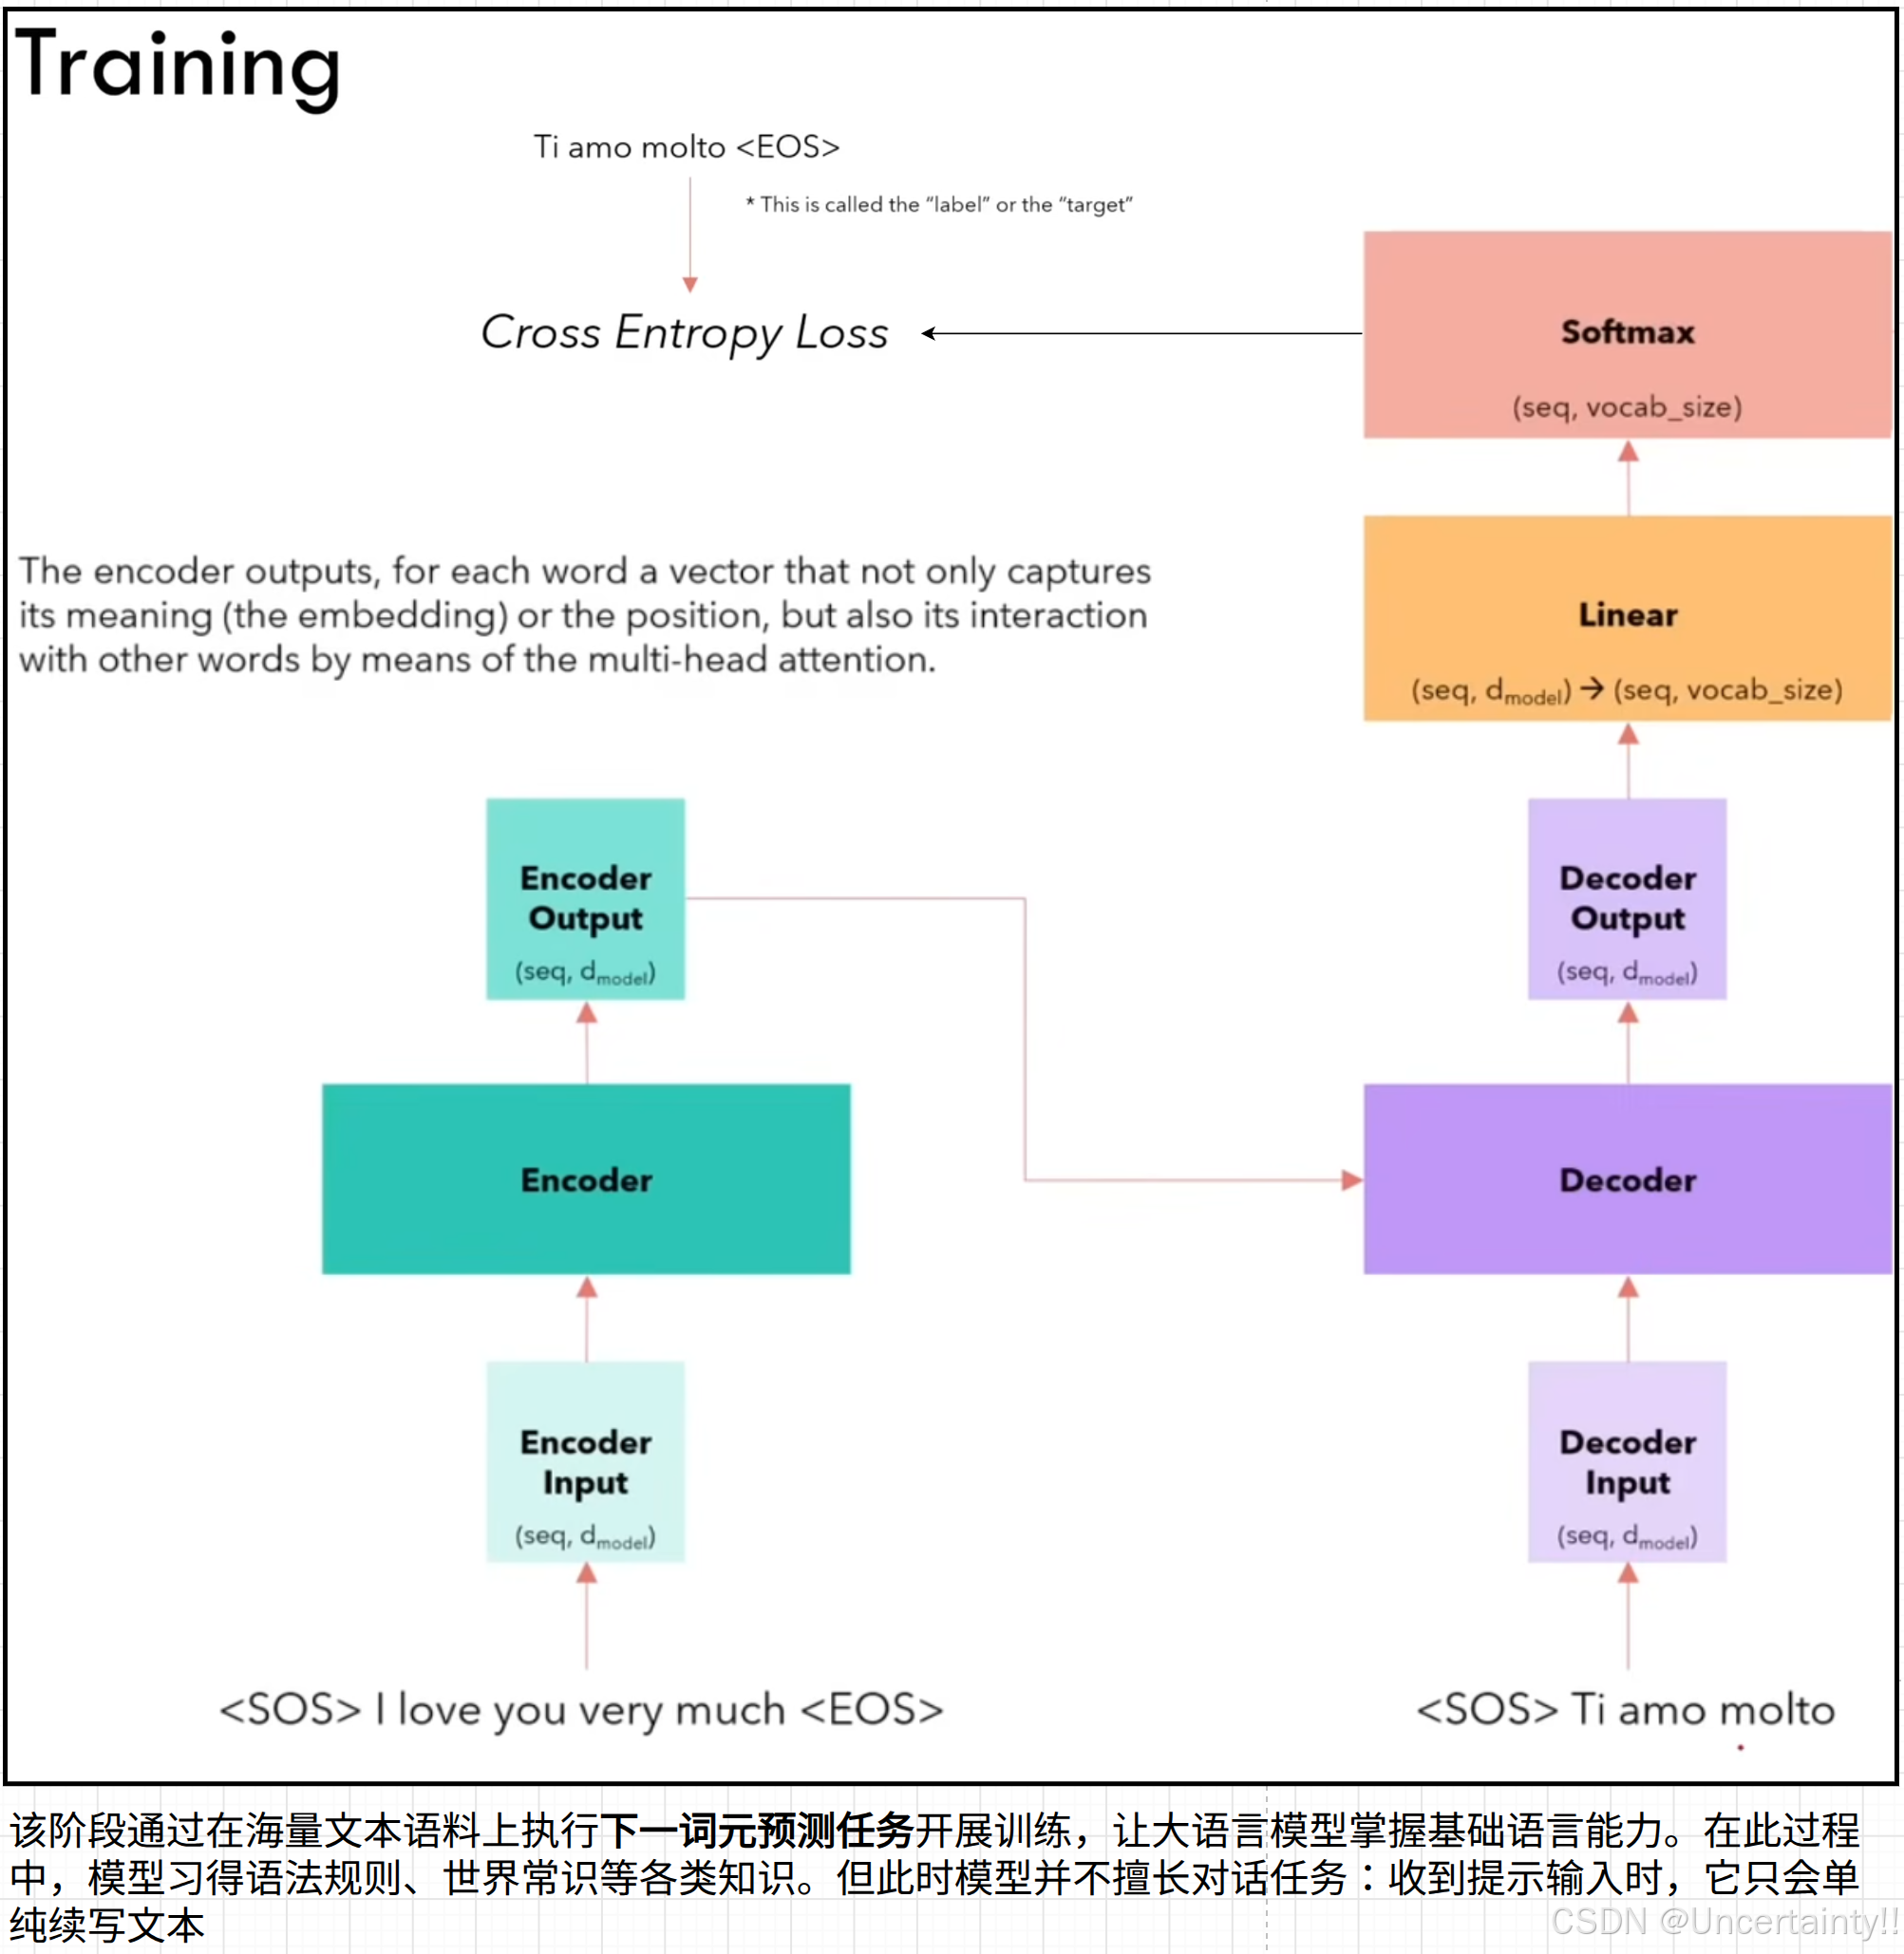
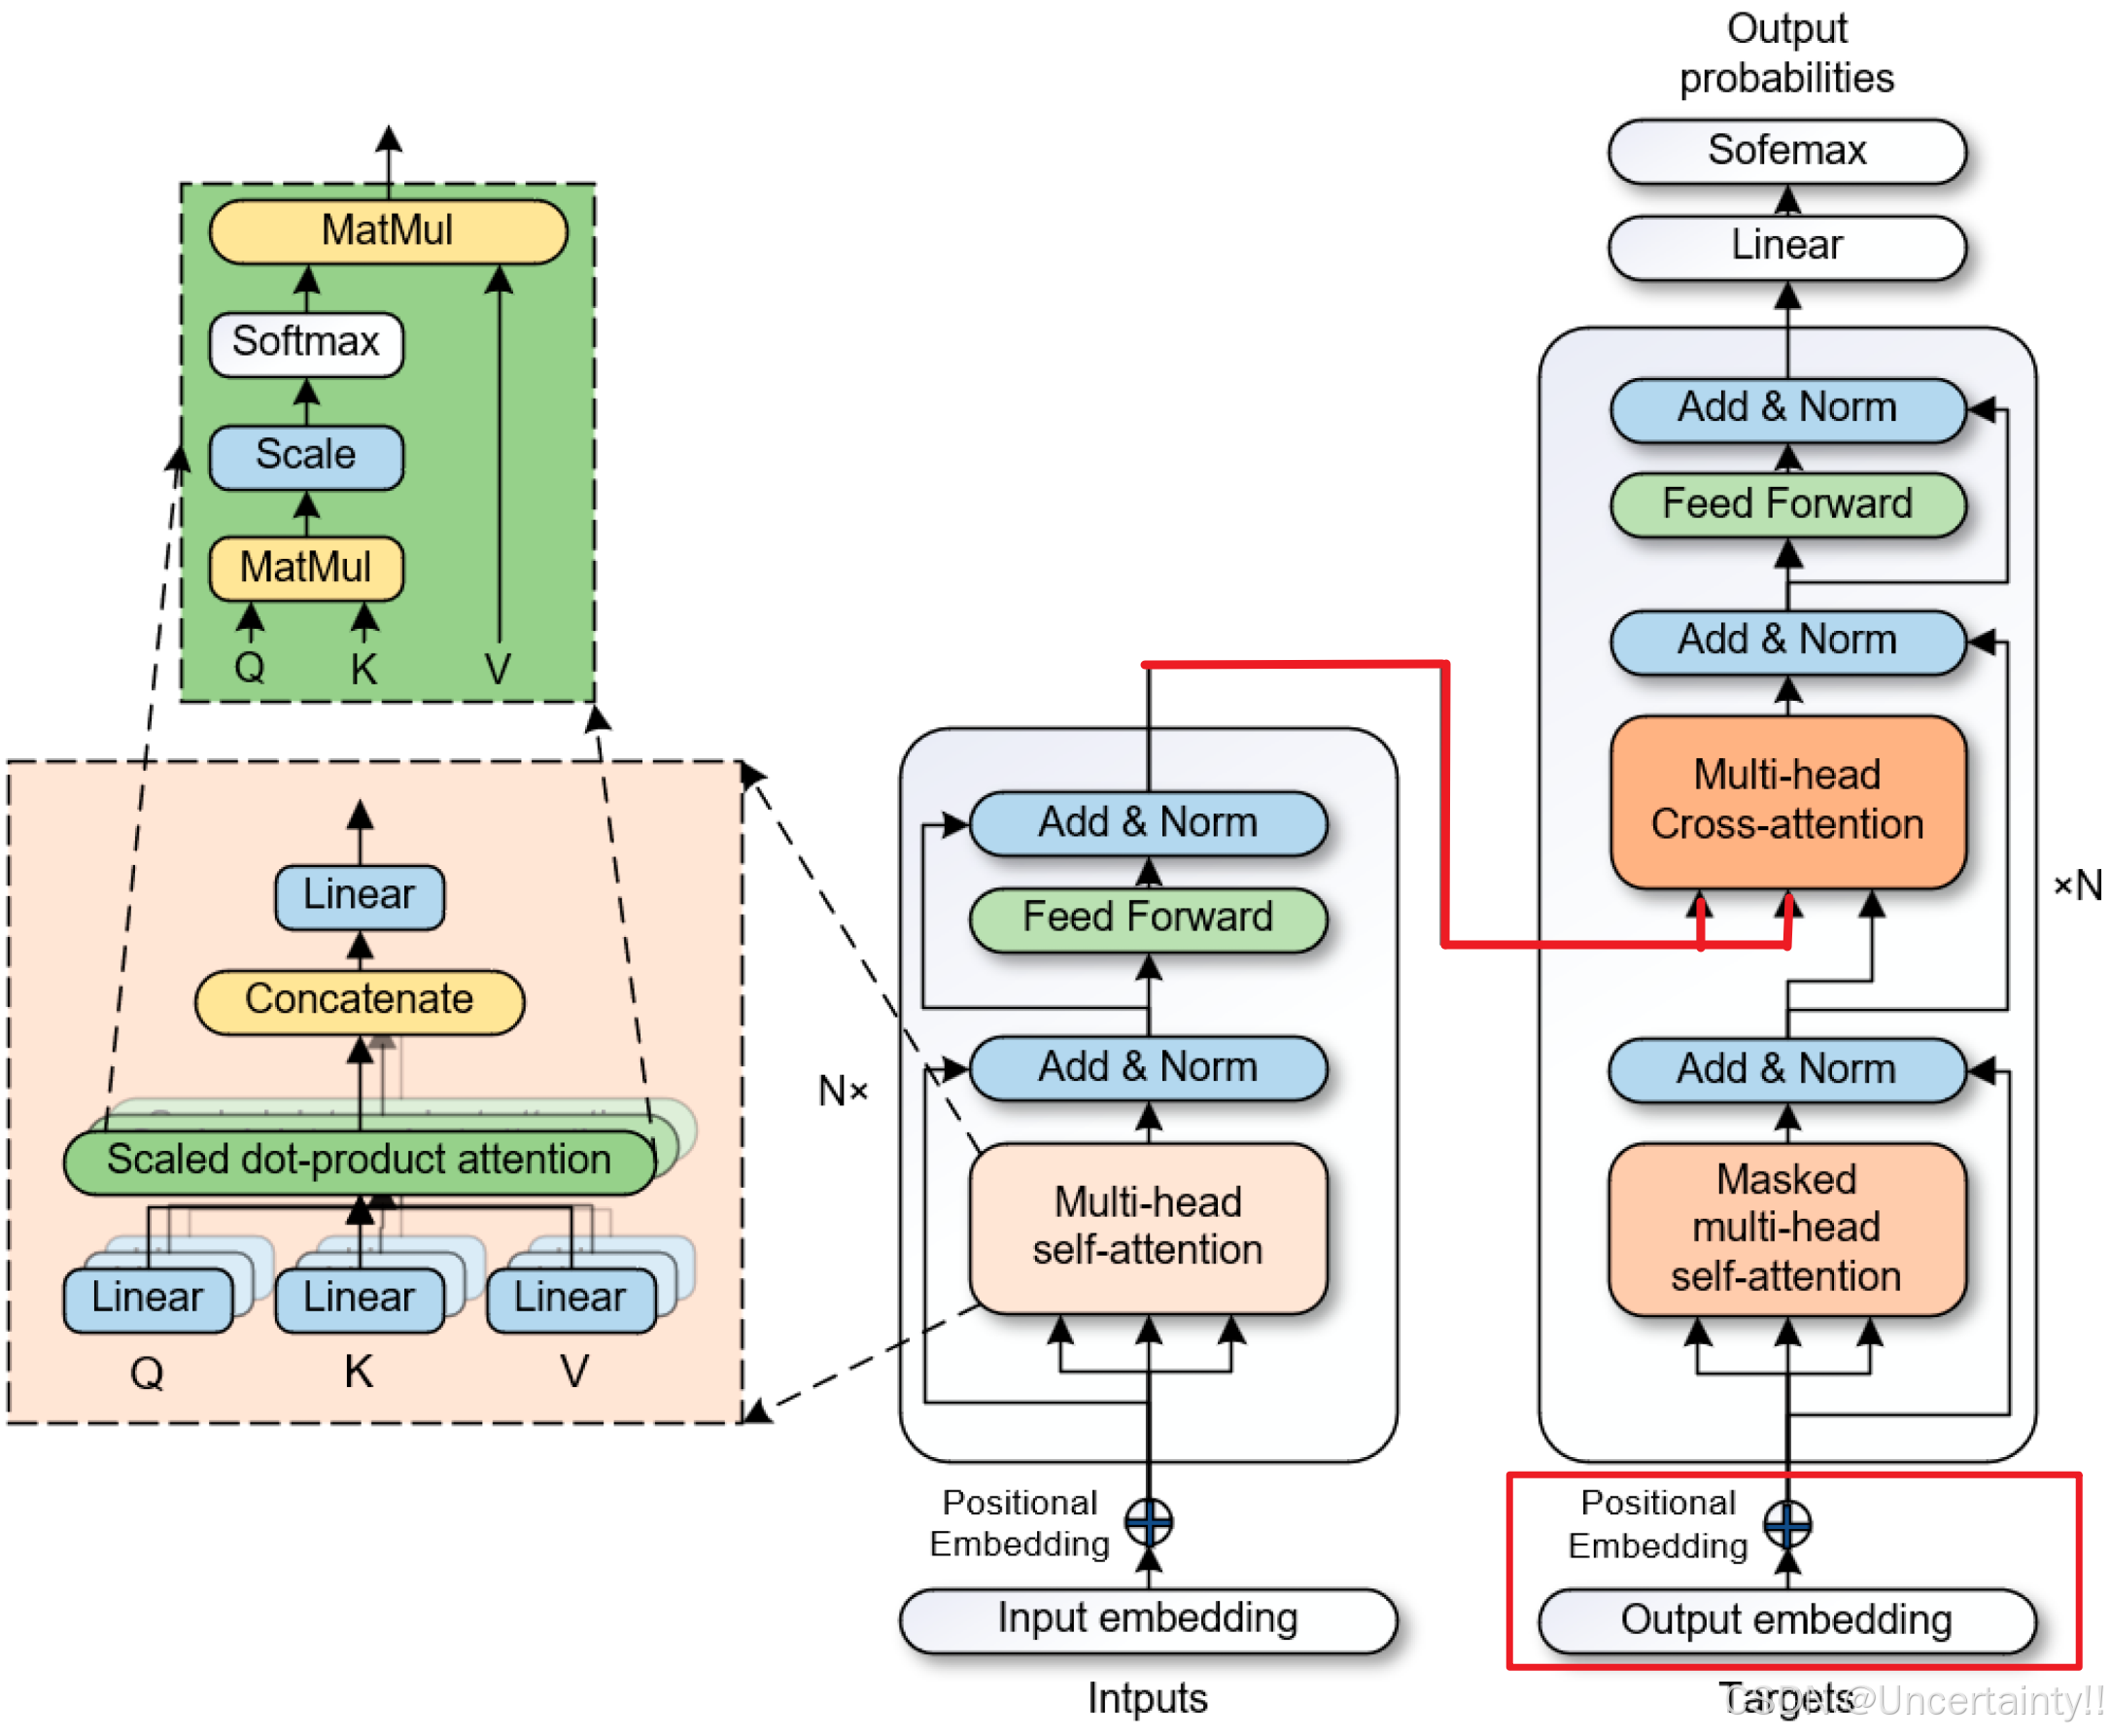
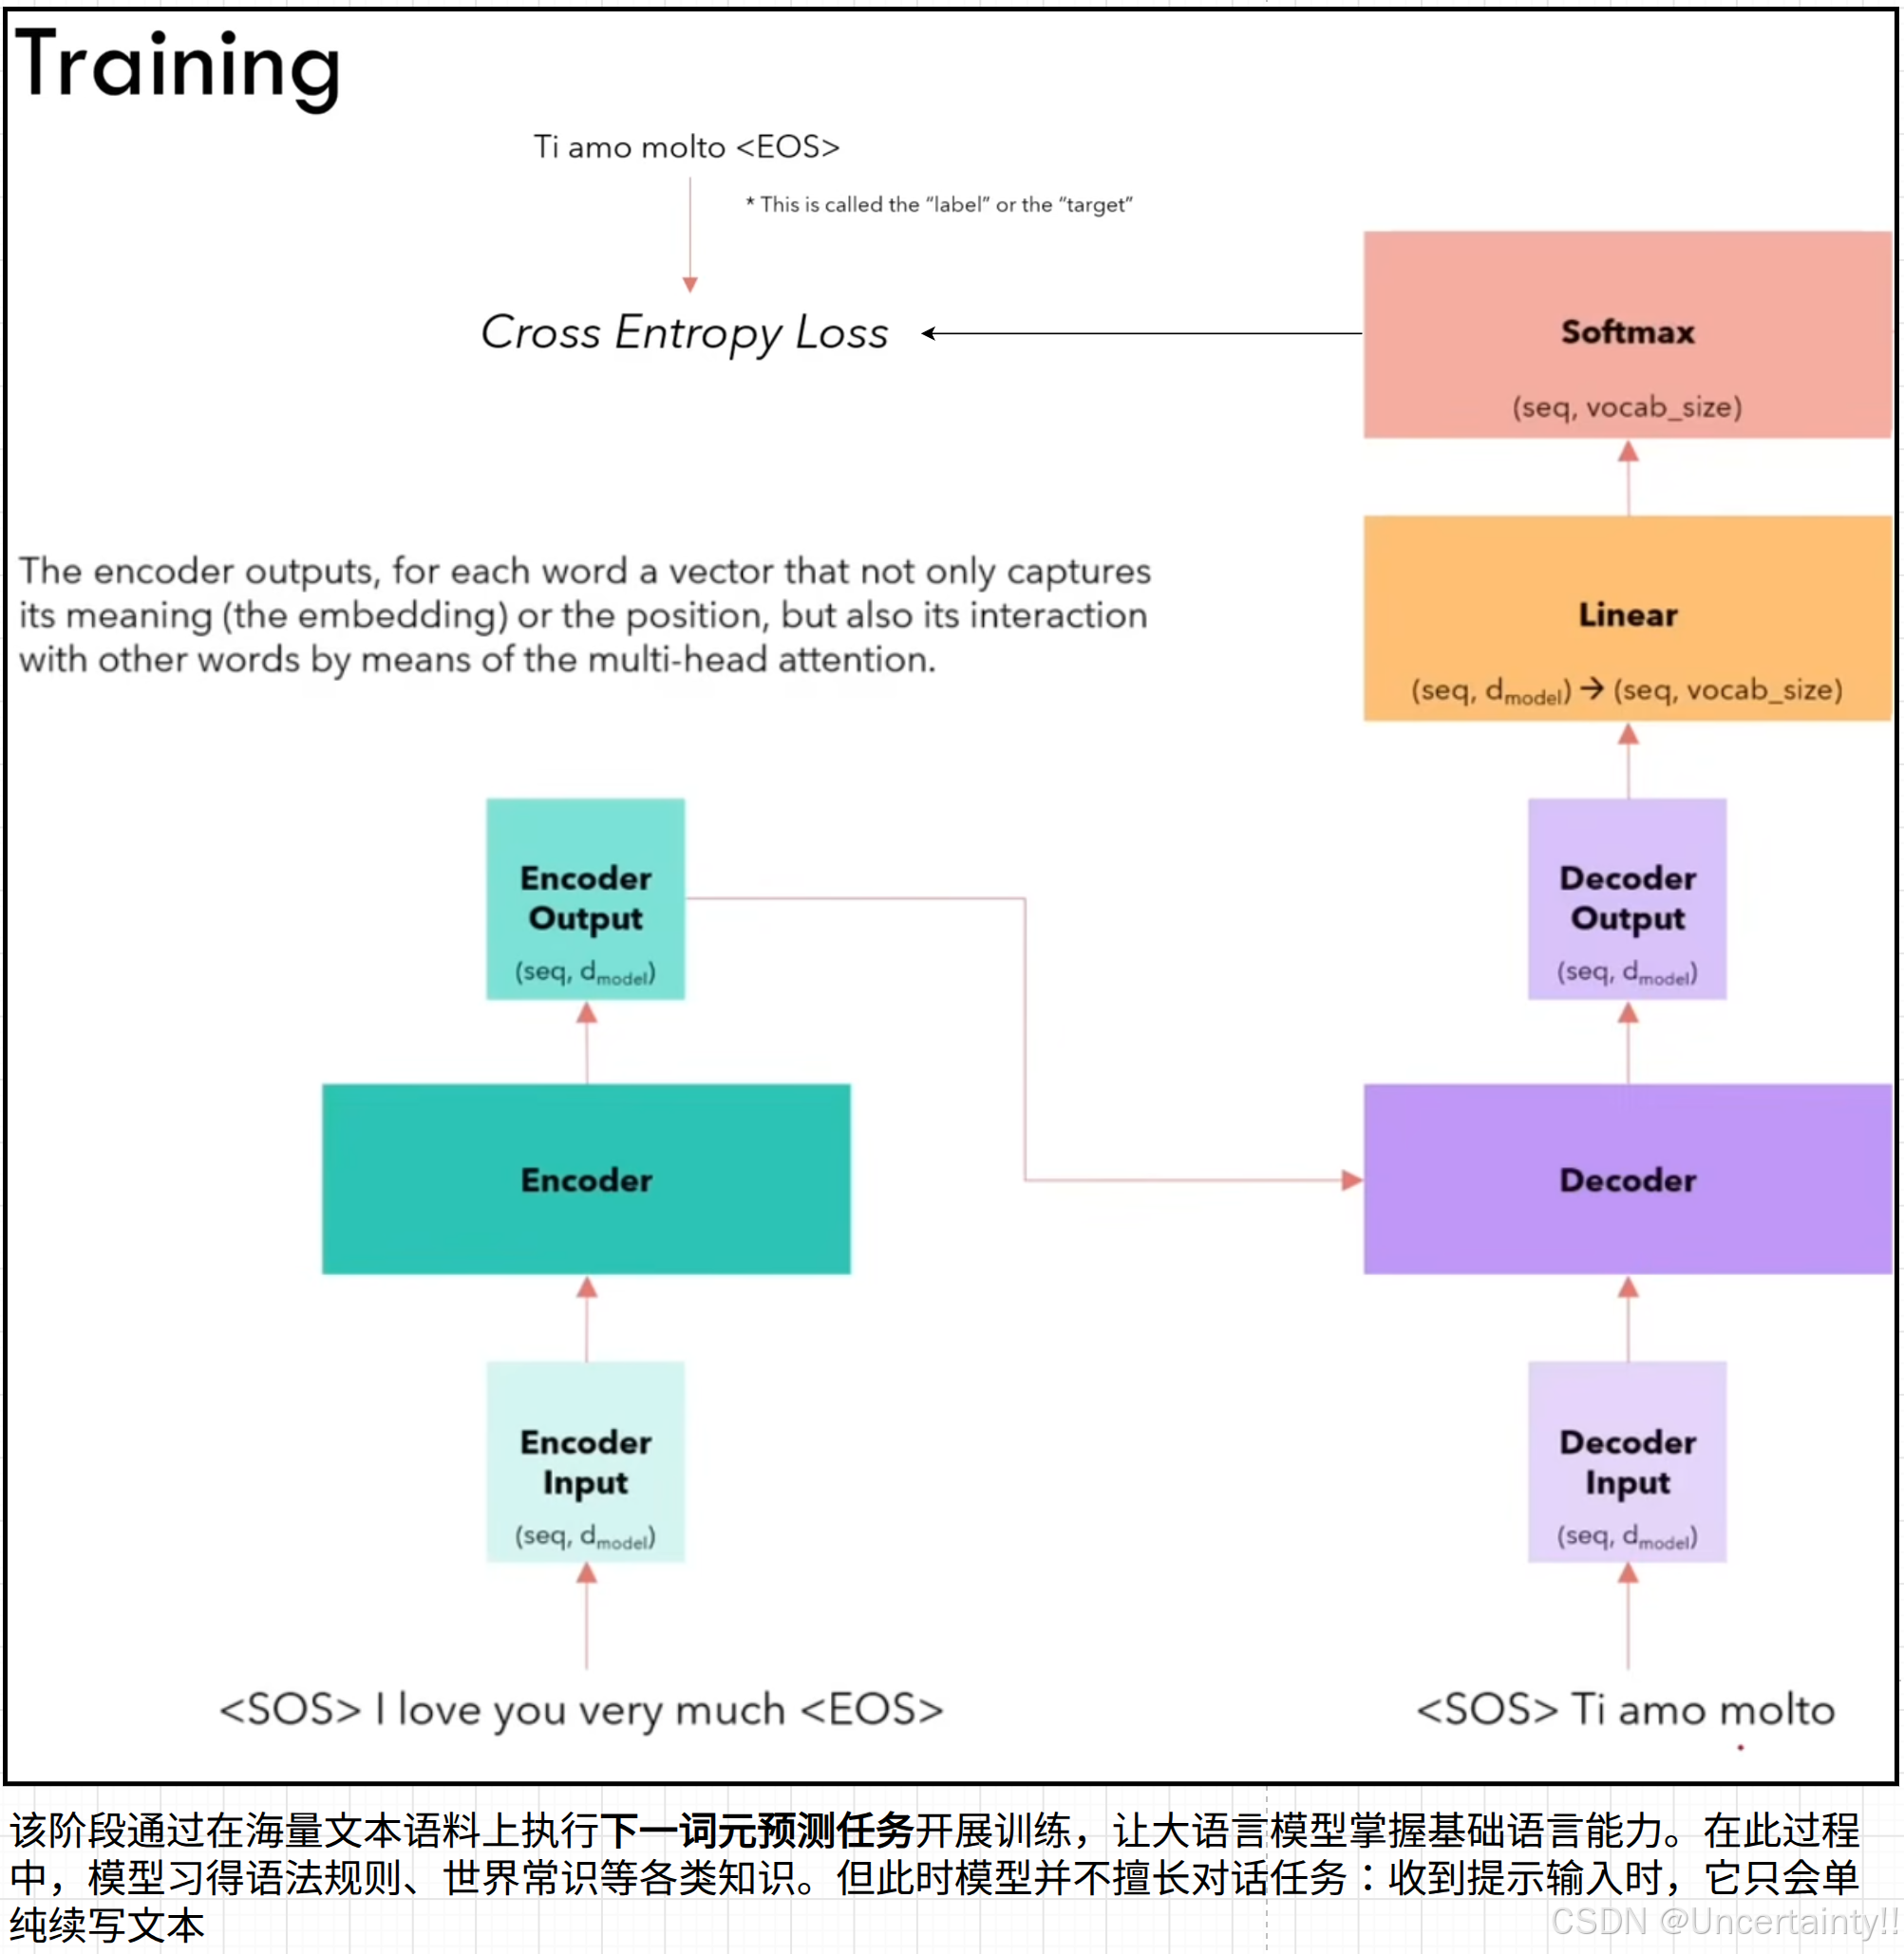
(1)output embedding (Decoder input)
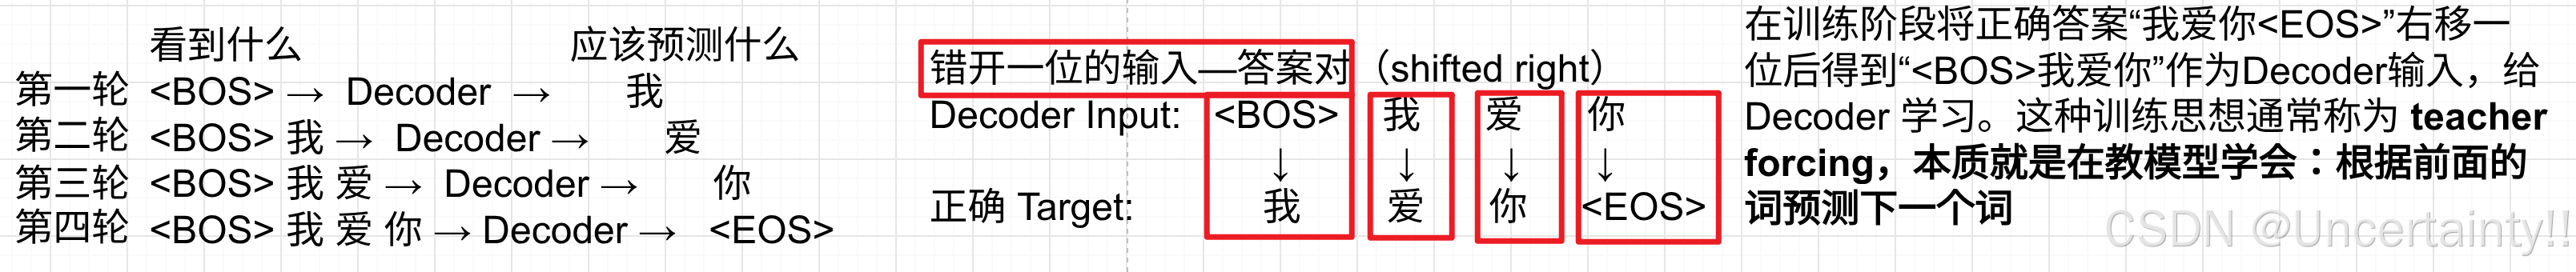
生成 Token→重新输入 Decoder→生成下一个 Token
这些输出 Token 通常会进行一次右移(Shifted Right),从而保证模型在预测当前位置的 Token 时,只能依赖当前位置之前已经知道的输出
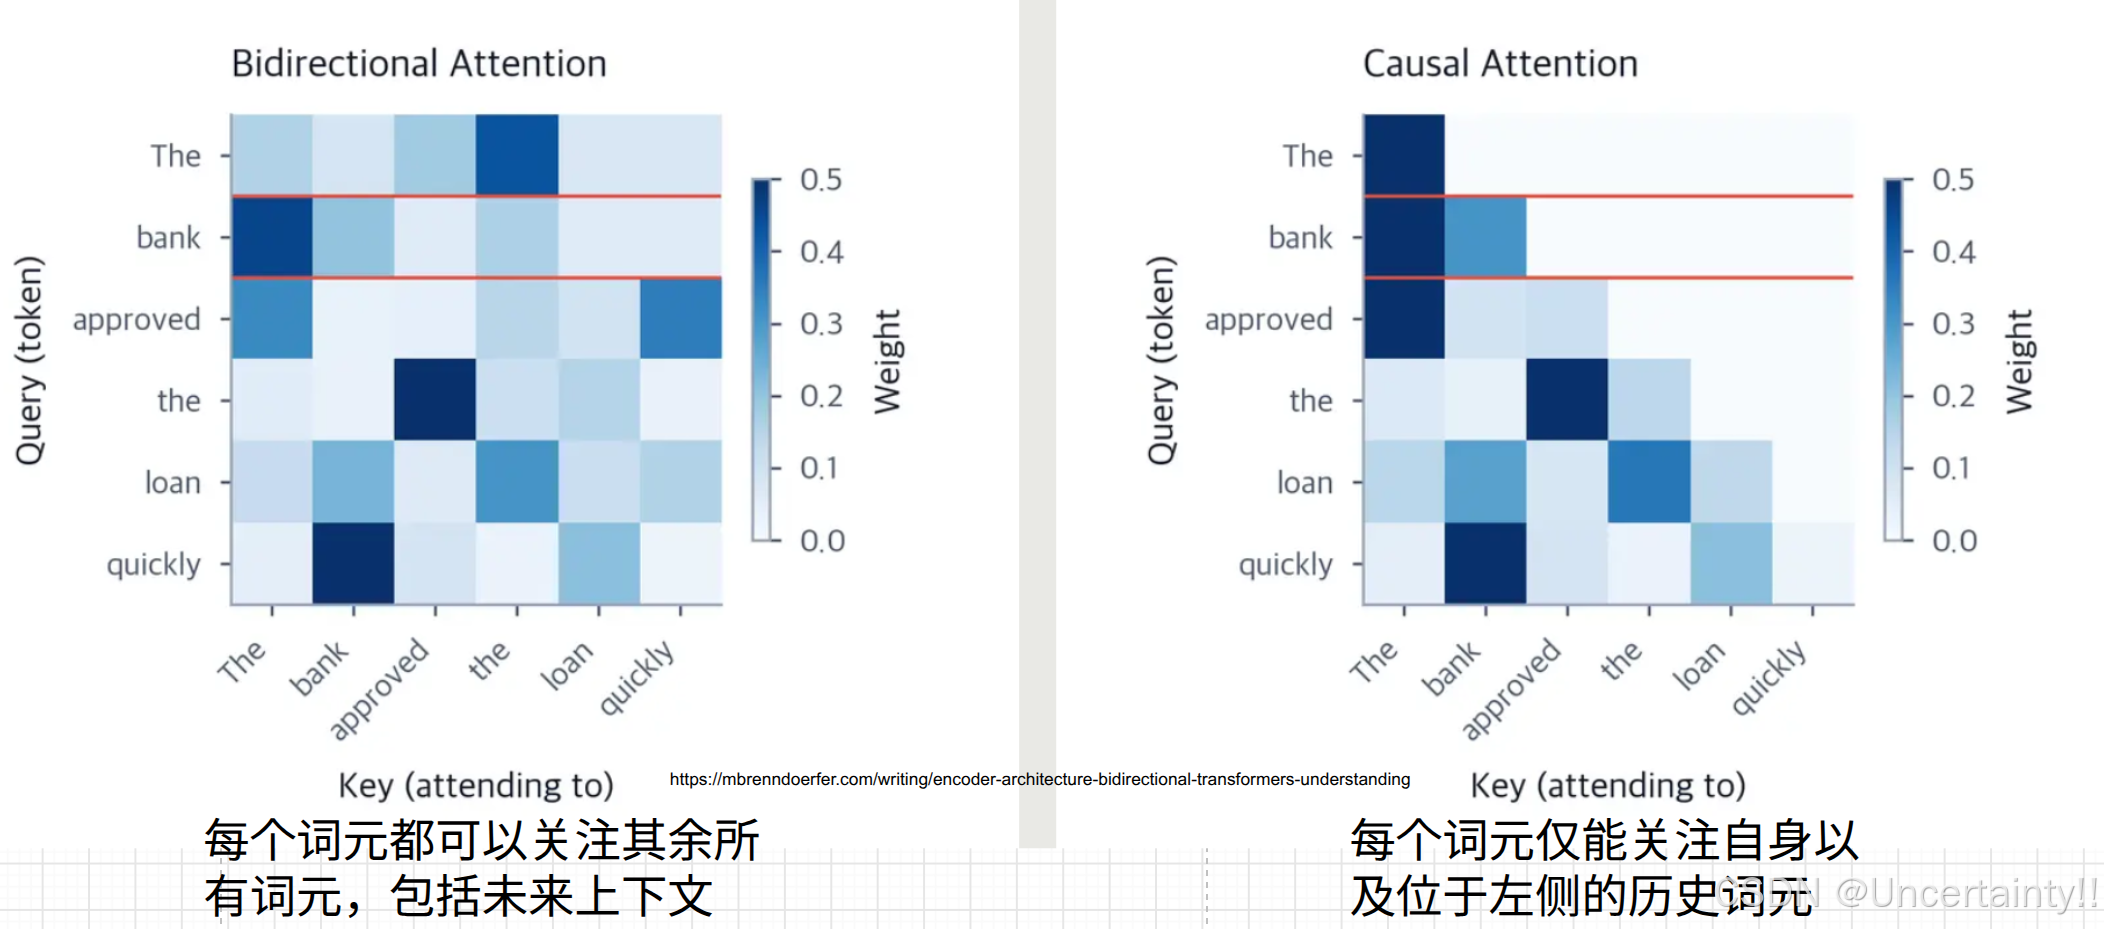
(2)masked multi-head self-attention
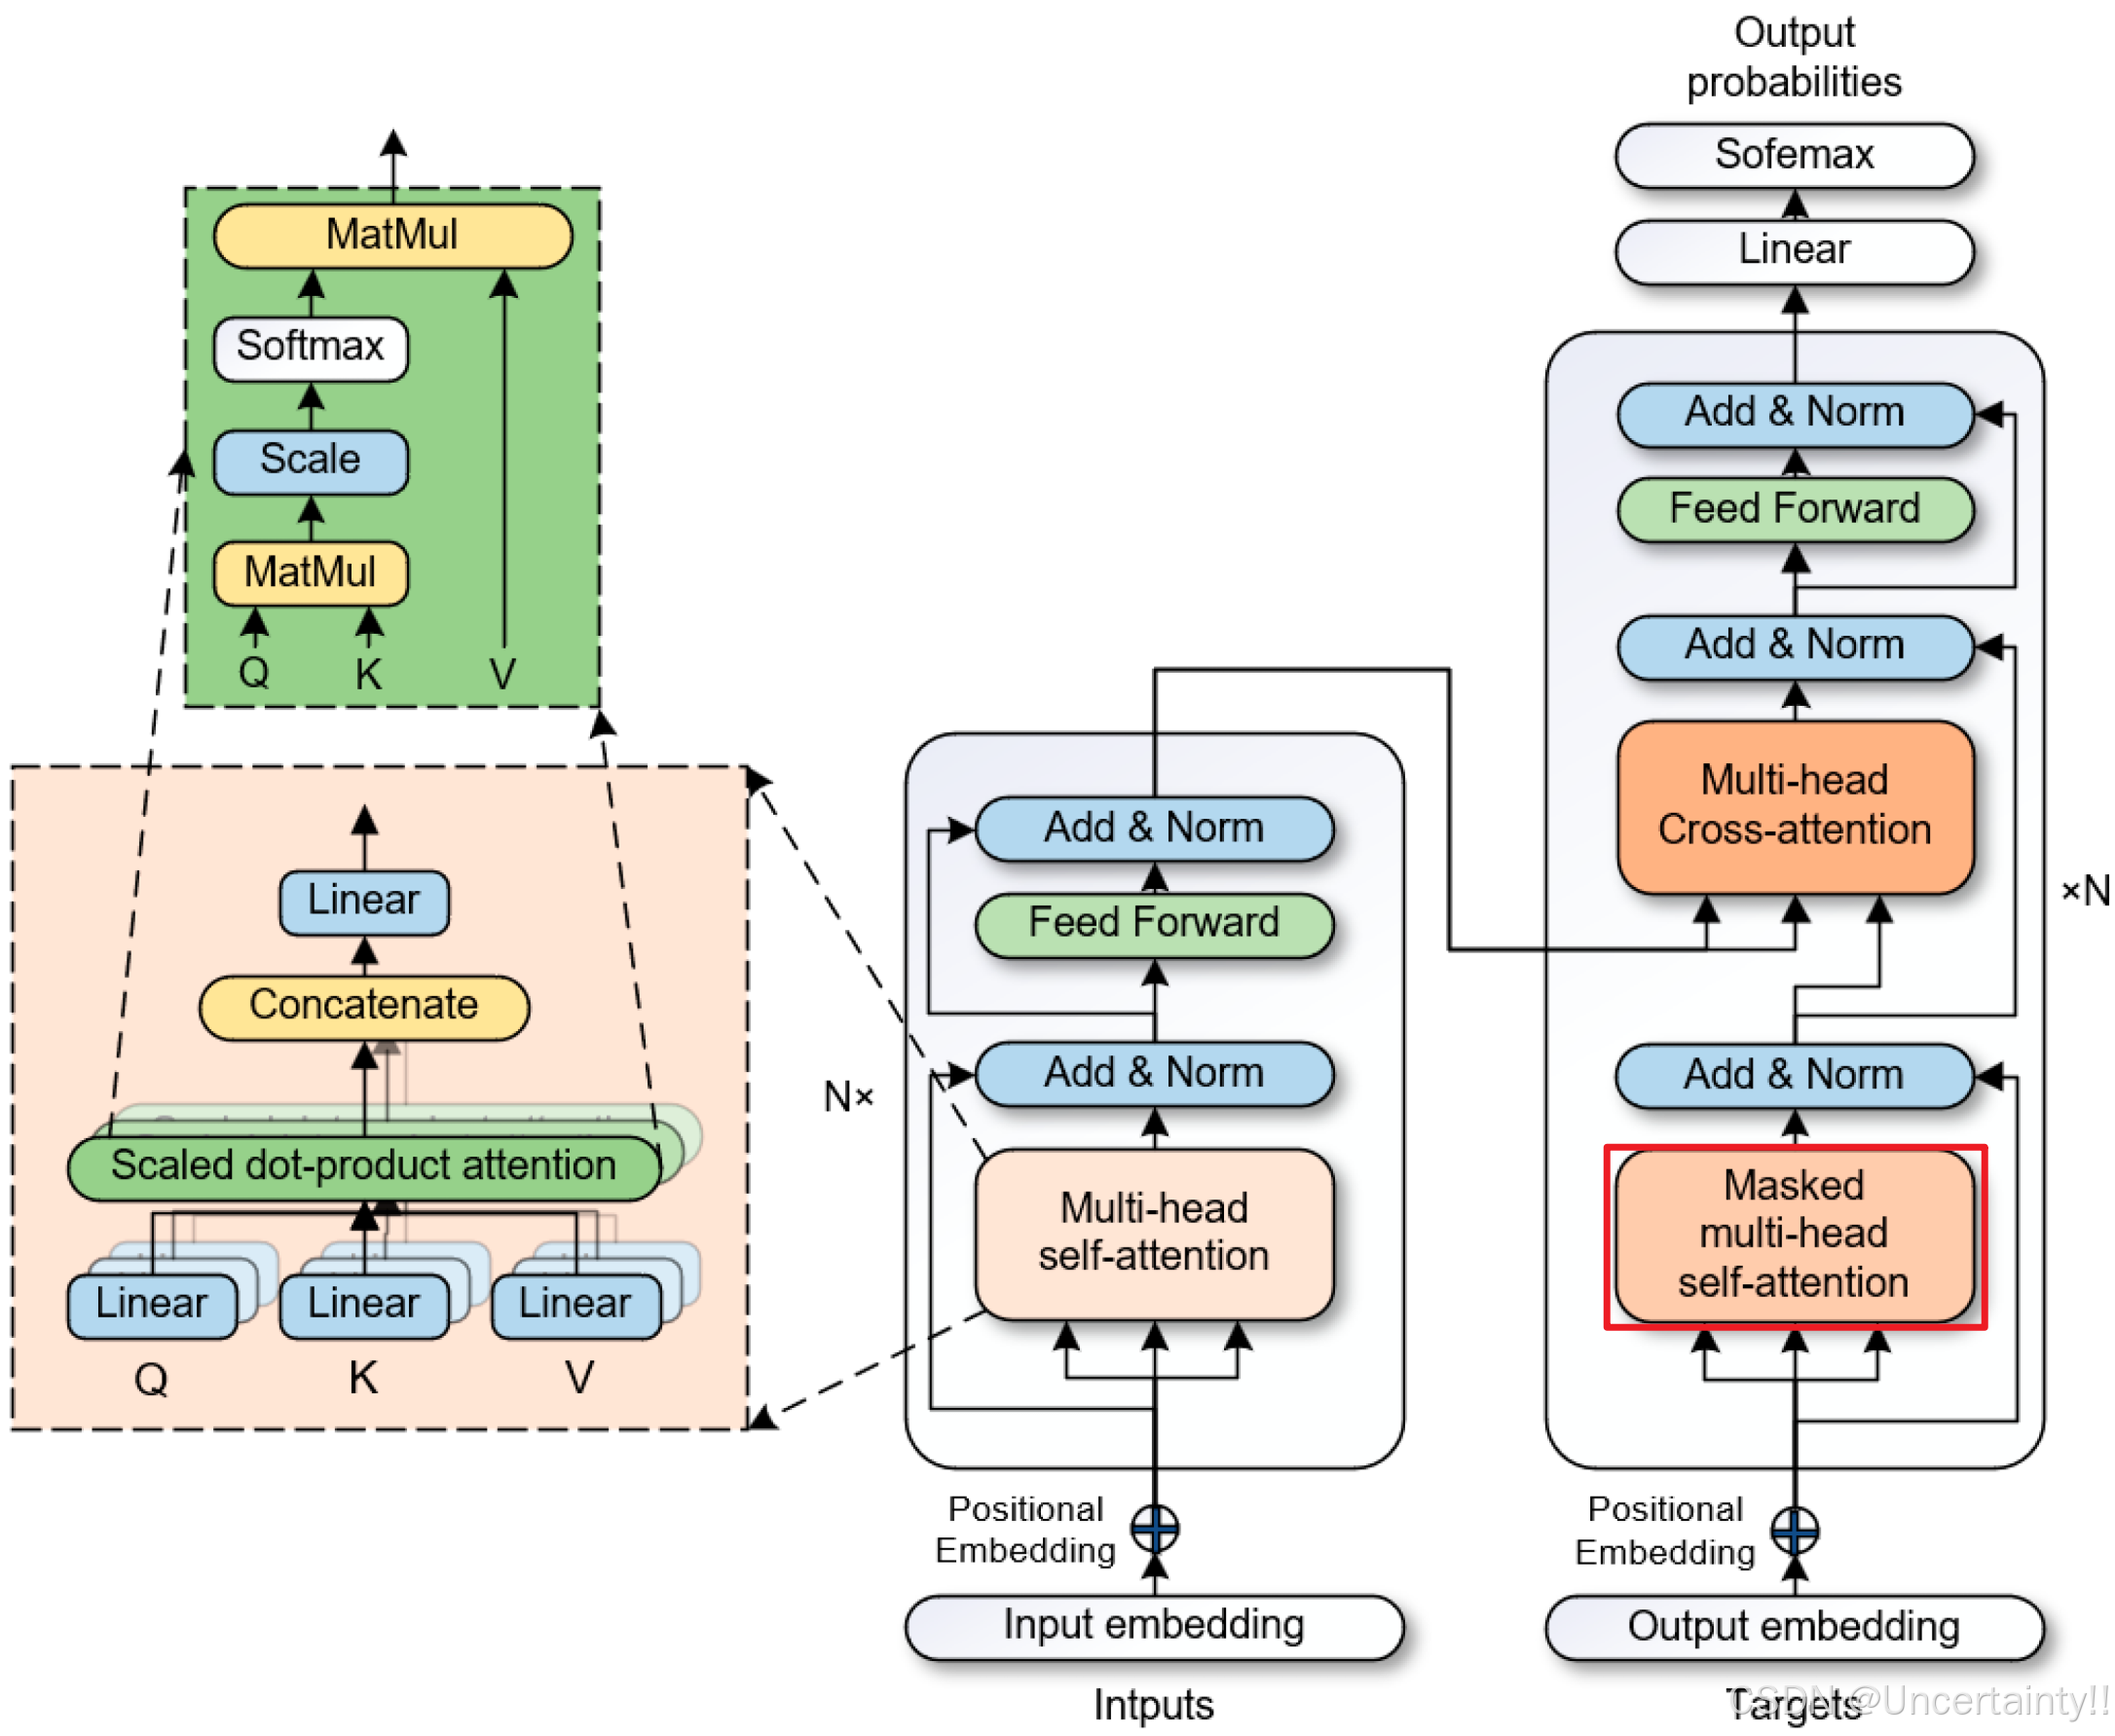
在预测某一个 Token 时,只能使用它之前已经知道的 Token,而不能提前看到未来 Token
softmax(QK^T/sqrt{d_k})得到attention score矩阵,利用mask掩码掉未来token
(3)multi-head cross-attention
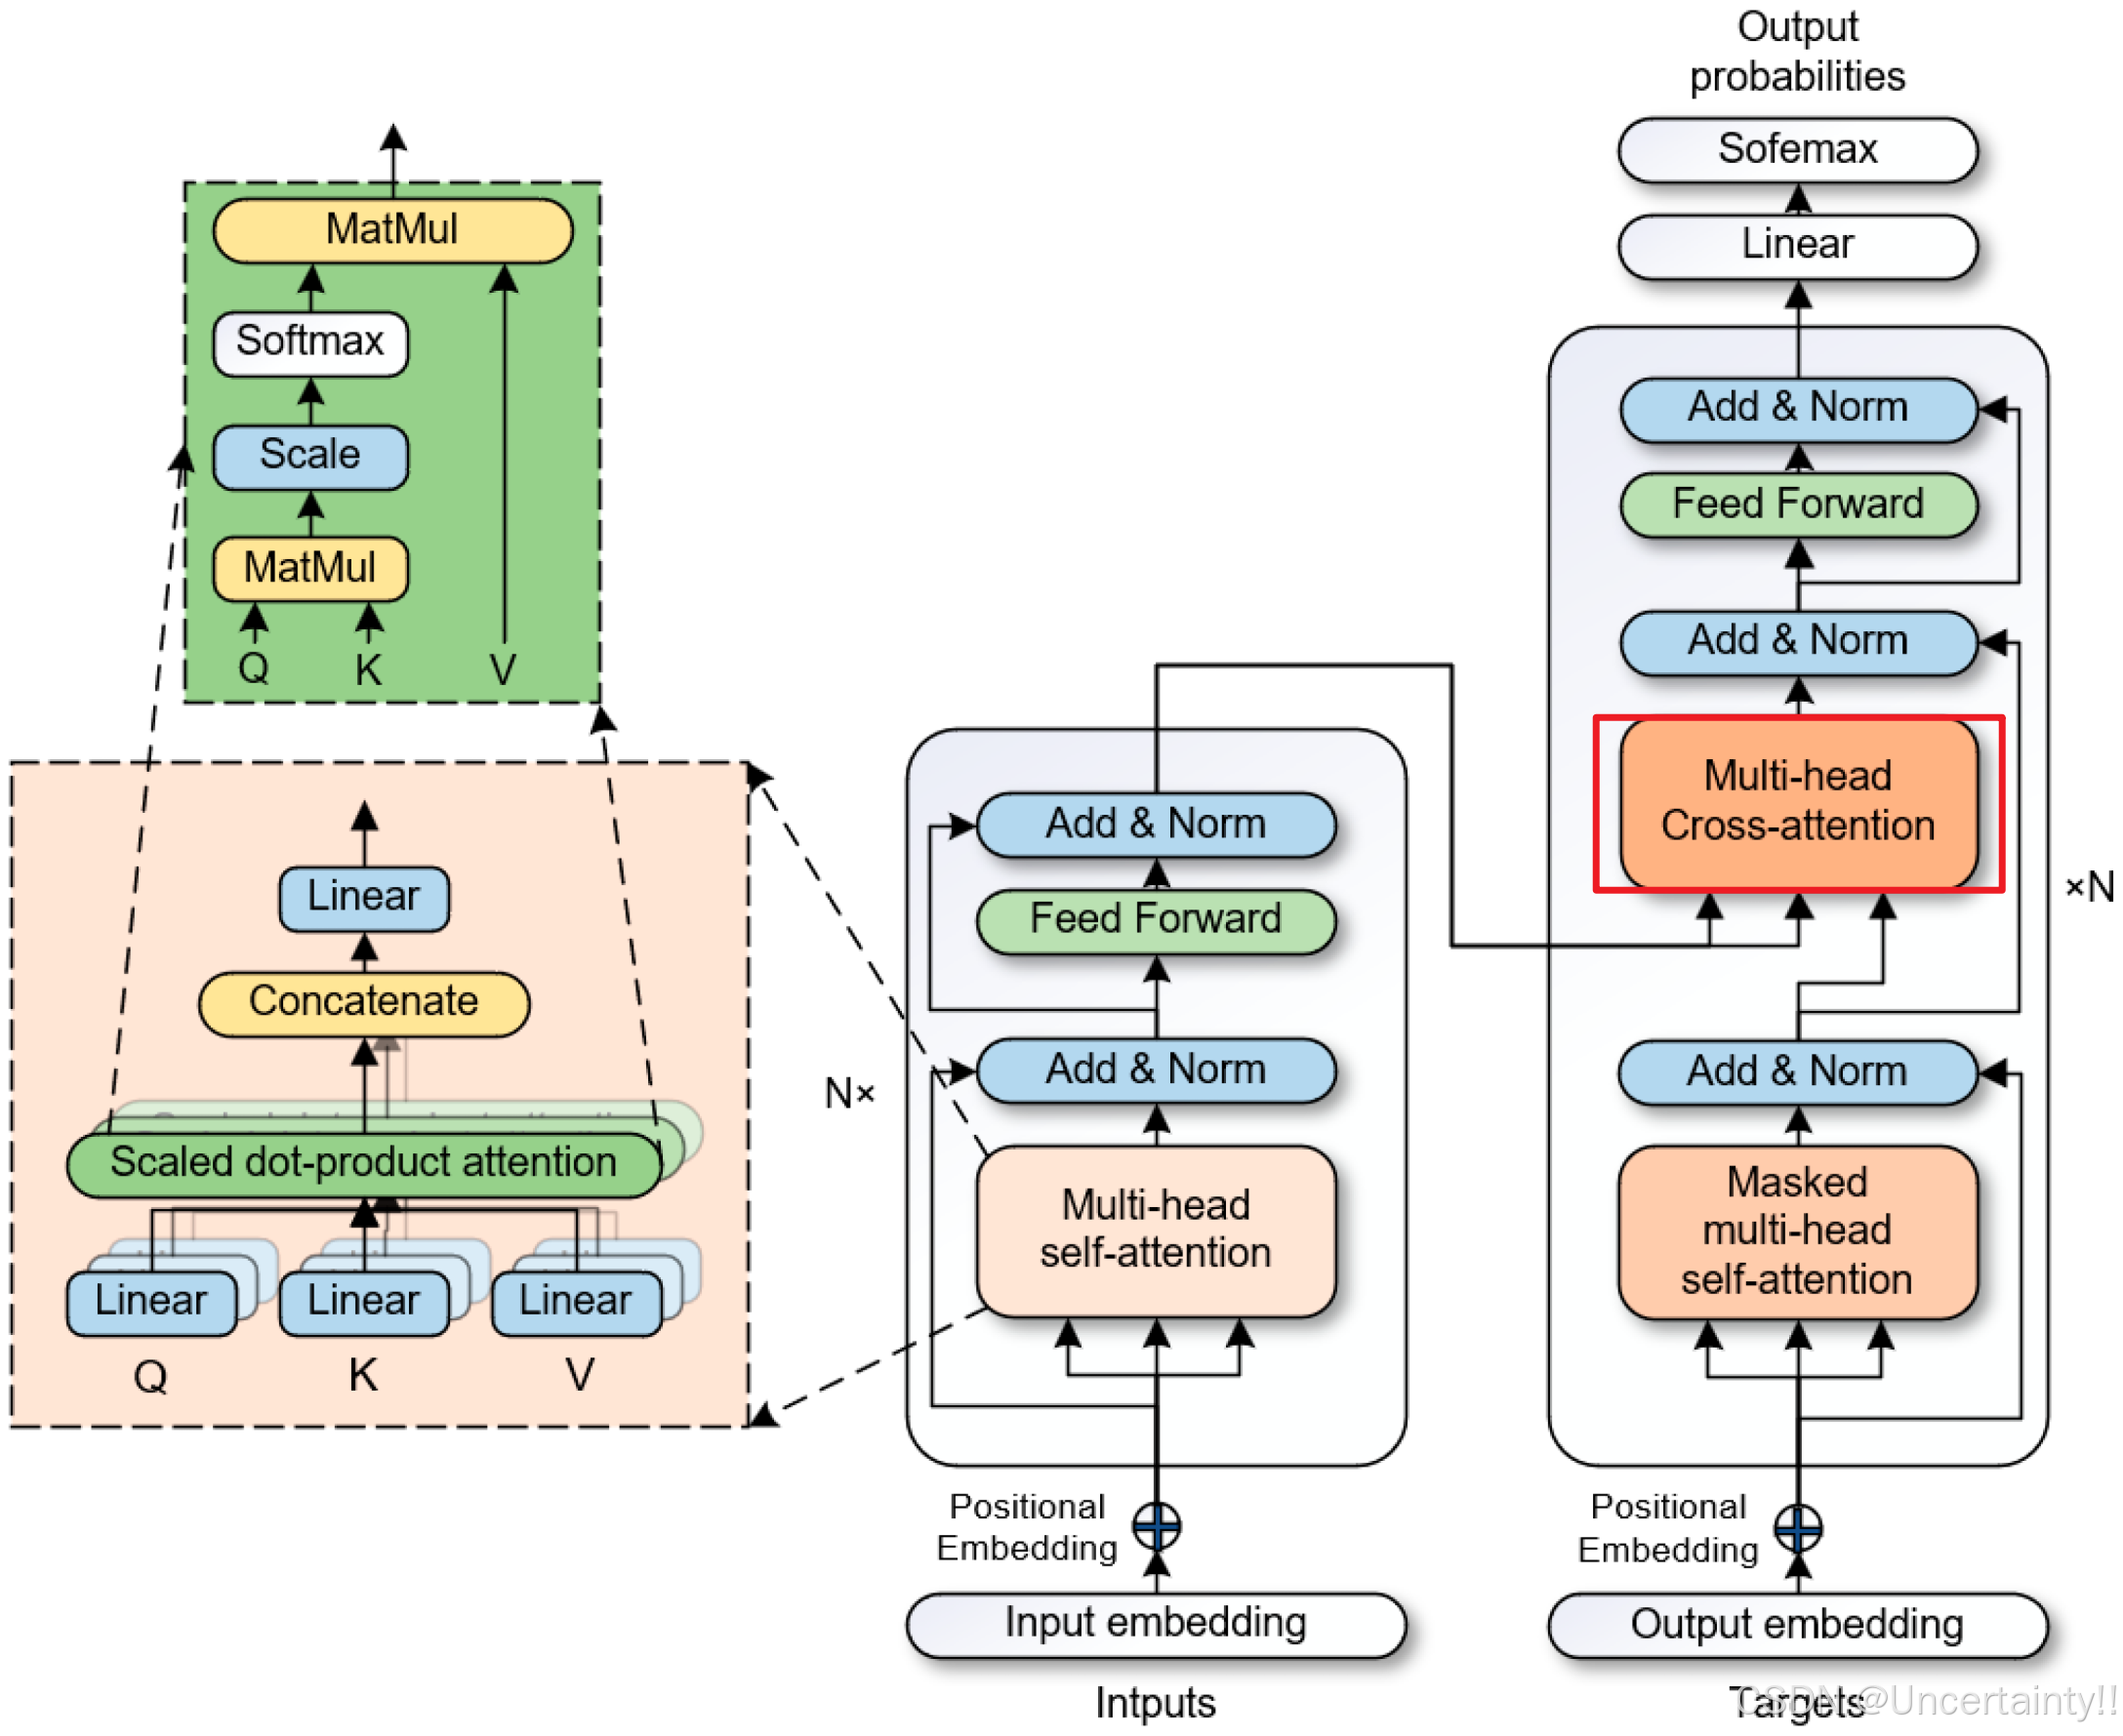
Encoder 的输出作为 Key 和 Value
Query 来自前一层 Masked Multi-Head Attention 的输出
Decoder 去"查询"Encoder 中哪些输入信息与当前生成的 Token 最相关
1.3.6 Decoder → Hidden State → Linear → Logits
这一层将 Decoder 最后一层的输出投影到一个更大的向量空间。
这个空间的维度通常等于:词表大小(Vocabulary Size)每一个数分别对应词表中一个 Token 的得分,通常称为 logits
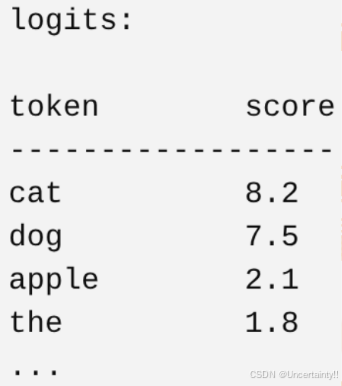
logits此时不是概率,只是模型认为:"哪个 token 更可能作为next token" 的原始打分
1.3.7 Logits → Softmax → Probability
Softmax 函数作用于 Linear 层的输出,将这些得分转换成序列中下一个 Token 的概率分布
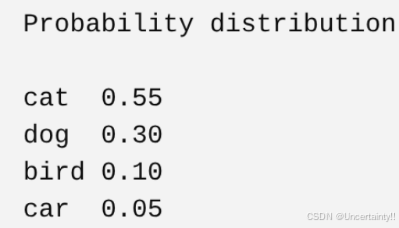
1.3.8 Probability → Sampling → Next Token
sampling strategy如何从这个概率里选一个token作为next token
常见sampling strategy
Greedy Search、Random Sampling、Top-k Sampling、Top-p Sampling