今天我来讲一下归并排序以及归并排序的非递归实现形式,首先提交以下代码
普通归并
cpp
void _MergeSort(int* arr, int* tmp, int left, int right)
{
	if (left >= right)
		return;
	//归
	int begin = left;
	int end = right;
	int mid = begin + (end - begin) / 2;
	//[begin,mid][mid+1,right]
	_MergeSort(arr, tmp, begin, mid);
	_MergeSort(arr, tmp, mid + 1, right);
	//并
	int begin1 = begin;
	int end1 = mid;
	int begin2 = mid + 1;
	int end2 = end;

	int i = begin;
	while (begin1 <= end1 && begin2 <= end2)
	{
		while (begin2 <= end2 && arr[begin1] >= arr[begin2])
		{
			tmp[i] = arr[begin2];
			begin2++;
			i++;
		}
		while (begin1 <= end1 && arr[begin2] > arr[begin1])
		{
			tmp[i] = arr[begin1];
			begin1++;
			i++;
		}

	}
	while (begin1 <= end1)
	{
		tmp[i++] = arr[begin1++];
	}
	while (begin2 <= end2)
	{
		tmp[i++] = arr[begin2++];
	}
	memcpy(arr + begin, tmp + begin, sizeof(int) * (end - begin + 1));

}
void MergeSort(int* arr, int n)
{
	int* tmp = (int*)malloc(sizeof(int) * n);
	if (tmp == NULL)
	{
		perror("malloc");
		return;
	}
	_MergeSort(arr, tmp, 0, n - 1);
	free(tmp);
	tmp = NULL;
}
非递归
cpp
void MergeSortNon(int* arr, int n)
{
	int* tmp = (int*)malloc(sizeof(int) * n);
	if (tmp == NULL)
	{
		perror("malloc");
		return;
	}
	int begin = 0;
	int end = n - 1;
	int mid = begin + (end - begin) / 2;

	//[begin1,end1][begin2,end2]
	//end1越界
	//begin2越界
	//end2越界

	for (int gap = 1; gap < n; gap *= 2)
	{
		for (int j = 0; j < n; j += 2 * gap)
		{
			int begin1 = j;
			int end1 = begin1 + gap - 1;
			int begin2 = end1 + 1;
			int end2 = begin2 + gap - 1;
			int i = j;
			if (end1 >= n|| begin2 >= n)
			{
				break;
			}
			else if (end2 >= n)
			{
				end2 = n - 1;
			}

				while (begin1 <= end1 && begin2 <= end2)
				{
					while (begin2 <= end2 && arr[begin1] >= arr[begin2])
					{
						tmp[i] = arr[begin2];
						begin2++;
						i++;
					}
					while (begin1 <= end1 && arr[begin2] > arr[begin1])
					{
						tmp[i] = arr[begin1];
						begin1++;
						i++;
					}

				}
				while (begin1 <= end1)
				{
					tmp[i++] = arr[begin1++];
				}
				while (begin2 <= end2)
				{
					tmp[i++] = arr[begin2++];
				}
				memcpy(arr + j, tmp + j, sizeof(int) * (2 * gap));
			}
		/*memcpy(arr, tmp, sizeof(int) * n);*/


	}


	free(tmp);
	tmp = NULL;
}
所谓归并排序,自然是分为归和并,我简单演示一下过程
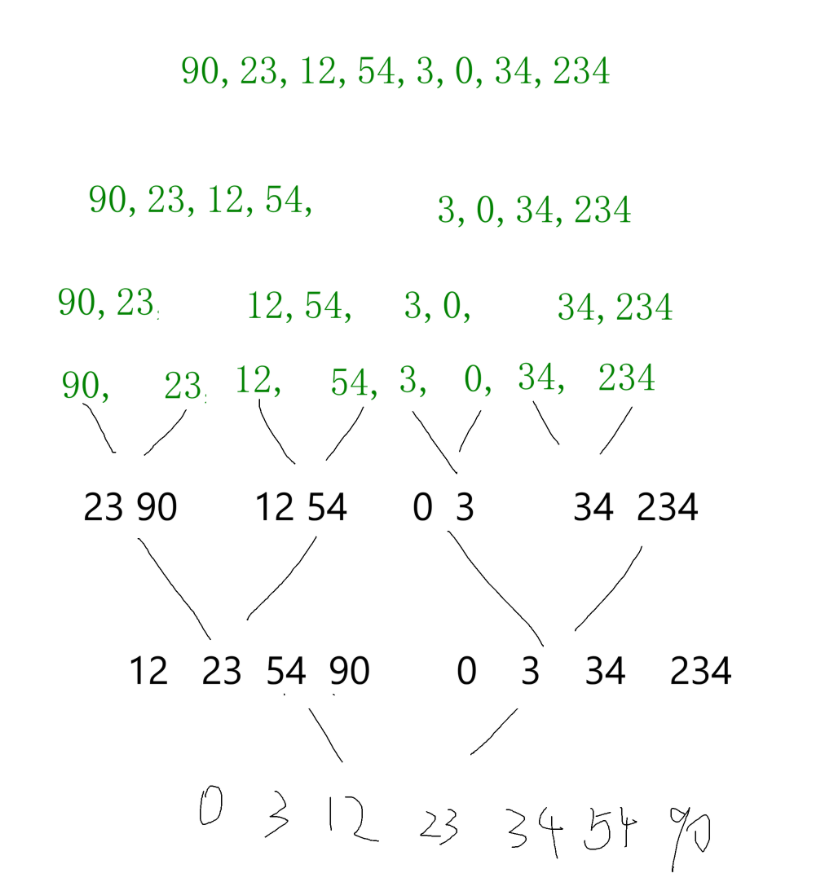
如此图,从中间拆分,然后得到的每组数据再从中间拆分,直到只剩一个数据,这其实就已经有序了,因为一个数据本身就是有序,然后是并,每次选一个最小值插入新数组,这样可以保证局部有序,直至完成归并。
显然,这是一个分而治之的思想,要用递归实现,递归实现的主要逻辑是区间的拆分,后续有序数组的合并过程和我们之前讲的有序链表合并相似,但略有不同,不同点在于归并排序需要新建一个新数组。
然后来讲一下非递归,与上一讲快速排序不同的是,归并的非递归并没有用到栈这一数据结构,其实想想也容易明白,虽然我们这里的黑核心仍然是拆分区间,但拆分后我们还需要合并,你拿栈去搞那拆分一次出栈,回来合并的时候你也找不到之前区间了对吧,所以我们这里直接给他改成循环。
当然你说非要用栈行不行呢?其实是可以的,只不过你得用两个栈拿来存储区间,这里就不多介绍了。
那么非递归的核心又是什么呢?
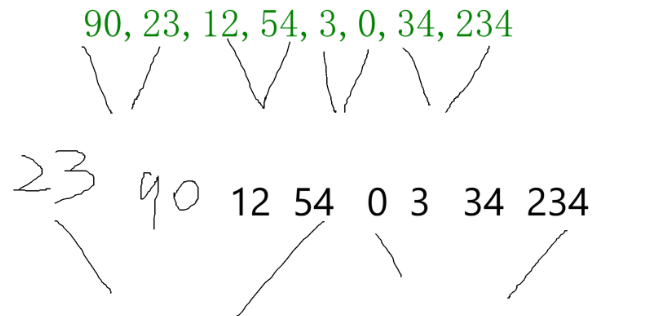
看一下这张图,我们直接前后取相同数进行归并,不从中间拆开,那这样,就需要定义一个变量gap拿来指明每一组的数据个数,比如90 23合并,那90自己就是一组,gap就等于1,同理,往下就不过多赘述了。
其实和递归代码区别不大,但细节方面还是需要处理,首先gap取值,一定不能>=n吧,你比原数组都长,哪来这么多元素呢?那你能等于n吗?等于1的时候是11合并,合并成两个元素的有序数组,那你等于n呢?合并成2n个元素的有序数组?哪来这么多元素给你合并,其次,怎样算是一次gap合并完成呢?就是从前往后都归并一次对吧,那你是不是要在写一层循环,用于标注这次合并是否整体结束,再往这个循环里走,你怎么确定合并各个小组之间的起始和终止?要利用gap的关系进行标注。
到这里看似没啥问题了,但其实还是不行,gap我们设置的是倍乘增加,这种只适用于有2的次方个元素个数的数组,否则会越界,这个越界还要处理三种情况,第一是end1越界,第二是begin2,第三是end2,前两种是一种情况,后者则自己一组,为什么呢?当你end1越界的时候,begin2和end2肯定越界了,end1越界了意味着什么呢?小组成员不够呗,我拿10个元素的数组举例,你最后一步肯定begin1==0end1>10,此时这个数组已经有序了,通过上一组82合并已经合并好了,然后再往下才会出现这情况,同理begin2越界也是如此,所以直接break就好。那第三种情况咋办呢?这就是上边说的82合并,第一组没问题,第二组元素不够,那你第二组有多少就给多少呗,直接把end2置为n-1即可