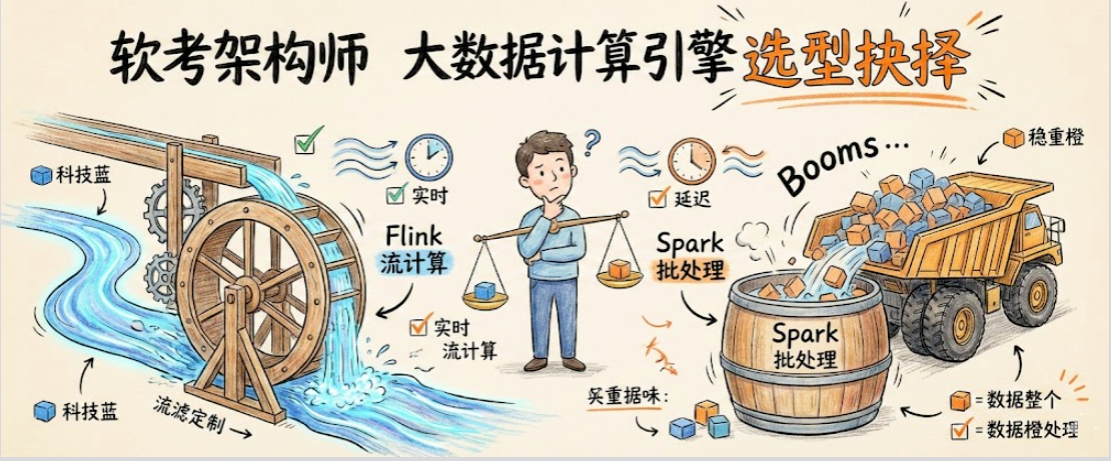
在大数据架构的案例分析中,"数据处理"是必考的一环。
题目经常会给你两个场景:
-
场景 A :老板想看昨天的销售报表,数据极其庞大(TB级),要求绝对准确。
-
场景 B :风控系统要拦截信用卡盗刷,要求刷卡后 1 秒内必须识别出异常,数据允许偶尔丢一条。
这时候,架构师就要像大厨一样,决定是做"大锅炖(批处理)"还是"流水席(流计算)"。
很多同学知道 Hadoop,也听说过 Spark 和 Flink,但真要问选型依据,往往答不到点子上。今天多多就用最朴实的话,聊聊大数据架构的 "时效性之争" 。
一、 批处理(Batch Processing):昨天的故事
代表人物 :MapReduce, Spark (Core/SQL)。
原理 : 把数据攒起来。比如,攒够一整天的数据,或者攒够 1TB。 然后启动一个任务,噼里啪啦算上几个小时,算出结果存到数据库。
特点 :
-
高延迟 :T+1(今天看昨天的数据)。
-
高吞吐 :一次性能处理海量历史数据。
-
高准确 :数据是静态的,反复算几遍结果都一样。
架构师比喻 : 就像坐 公交车 。人没满不走,或者不到发车时间不走。虽然慢,但一次能拉很多人,效率高。
二、 流计算(Stream Processing):当下的瞬间
代表人物 :Storm (已过气), Flink, Spark Streaming。
原理 : 数据像水流一样,来一条处理一条。 刷卡记录一来,立马计算逻辑(比如判断是否异地),立马输出结果。
特点 :
-
低延迟 :毫秒级 / 秒级。
-
动态性 :数据是无界的(Unbounded),永远流不完。
-
复杂性 :要处理乱序(早发生的事情晚到了)、窗口(Window)等难题。
架构师比喻 : 就像坐 出租车 。来一个人就走,随叫随到,速度快,但运力有限。
三、 Spark vs Flink:架构师选型擂台
在软考中,目前主流的对比就是 Spark 和 Flink 。
1. Spark Streaming ------ "微批"处理(Micro-batch)
-
本质 :它不是真流。它是把流数据切成很小很小的片段(比如 1 秒一个切片)。
-
逻辑 :每一秒钟启动一个小型的批处理任务。
-
延迟 :秒级(很难做到毫秒级)。
-
适用场景 :准实时 场景。比如每分钟刷新一次大屏数据。如果你的团队已经很熟悉 Spark 生态,选它最稳。
2. Flink ------ "真流"处理(Native Stream)
-
本质 :真正的来一条算一条。
-
逻辑 :事件驱动(Event-driven)。
-
延迟 :毫秒级。
-
杀手锏 :Watermark(水位线) 机制完美解决乱序问题;Exactly-once 状态一致性。
-
适用场景 :超实时 场景。比如实时风控、即时推荐、实时欺诈检测。
四、 架构演进:从 Lambda 到 Kappa
架构师不仅要选工具,还得搭架构。
1. Lambda 架构(混合双打)
-
思路 :为了兼顾"快"和"准"。 热数据(Speed Layer) :走 Flink/Spark Streaming,算个大概,给用户先看着。 冷数据(Batch Layer) :走 Hadoop/Spark SQL,晚上偷偷重算一遍,第二天把热数据的结果覆盖掉(修正)。
-
缺点 :要维护两套代码(流一套、批一套),开发很痛苦。
2. Kappa 架构(流批一体)
-
思路 :既然 Flink 这么强,能不能全用流? 所有数据都存在 Kafka 里(保留时间长一点)。 历史数据也可以当成"流"重放一遍。 只维护一套 Flink 代码 。
-
趋势 :这是目前大厂都在推的"流批一体"方向。
小结
-
要"准"且数据量巨大 -> 选 Spark 批处理。
-
要"快"且逻辑复杂 -> 选 Flink。
-
选型口诀 :风控监控用 Flink,离线报表用 Spark。