这节内容我们来实现交换机板块的内容,先大致看一下这个类的组成部分:
交换机数据管理
- 定义交换机数据类
a. 交换机名称
b. 交换机类型
c. 是否持久化标志
d. 是否自动删除标志
e. 其他参数
- 定义交换机数据持久化类(数据持久化的 sqlite3 数据库中)
a. 创建 / 删除交换机数据表
b. 新增交换机数据
c. 移除交换机数据
d. 查询所有交换机数据
e. 查询指定交换机数据(根据名称)
- 定义交换机数据管理类
a. 声明交换机,并添加管理(存在则 OK,不存在则创建)
b. 删除交换机
c. 获取指定交换机
d. 销毁所有交换机数据
1.交换机是什么
在消息队列里,生产者不直接把消息丢给队列,而是丢给一个中间角色------交换机(Exchange):
cpp
生产者 ──> 交换机 ──(按路由规则)  ──> 队列A
                                  ├──> 队列B
                                  └──> 队列C
交换机负责根据路由规则,决定这条消息该投给哪些队列。
为什么要多这一层?
有了交换机: 生产者只管把消息丢给交换机的话,队列怎么加、怎么删,生产者完全不用管 实现了 解耦
简单理解这三者就是:
Exchange ------> 数据【长什么样】
ExchangeMapper ------> 数据【怎么进出数据库】
ExchangeManager ------> 数据【在内存里怎么管】
2.三个类的关系
是"数据 --> 存取 --> 管理"的单向依赖链:
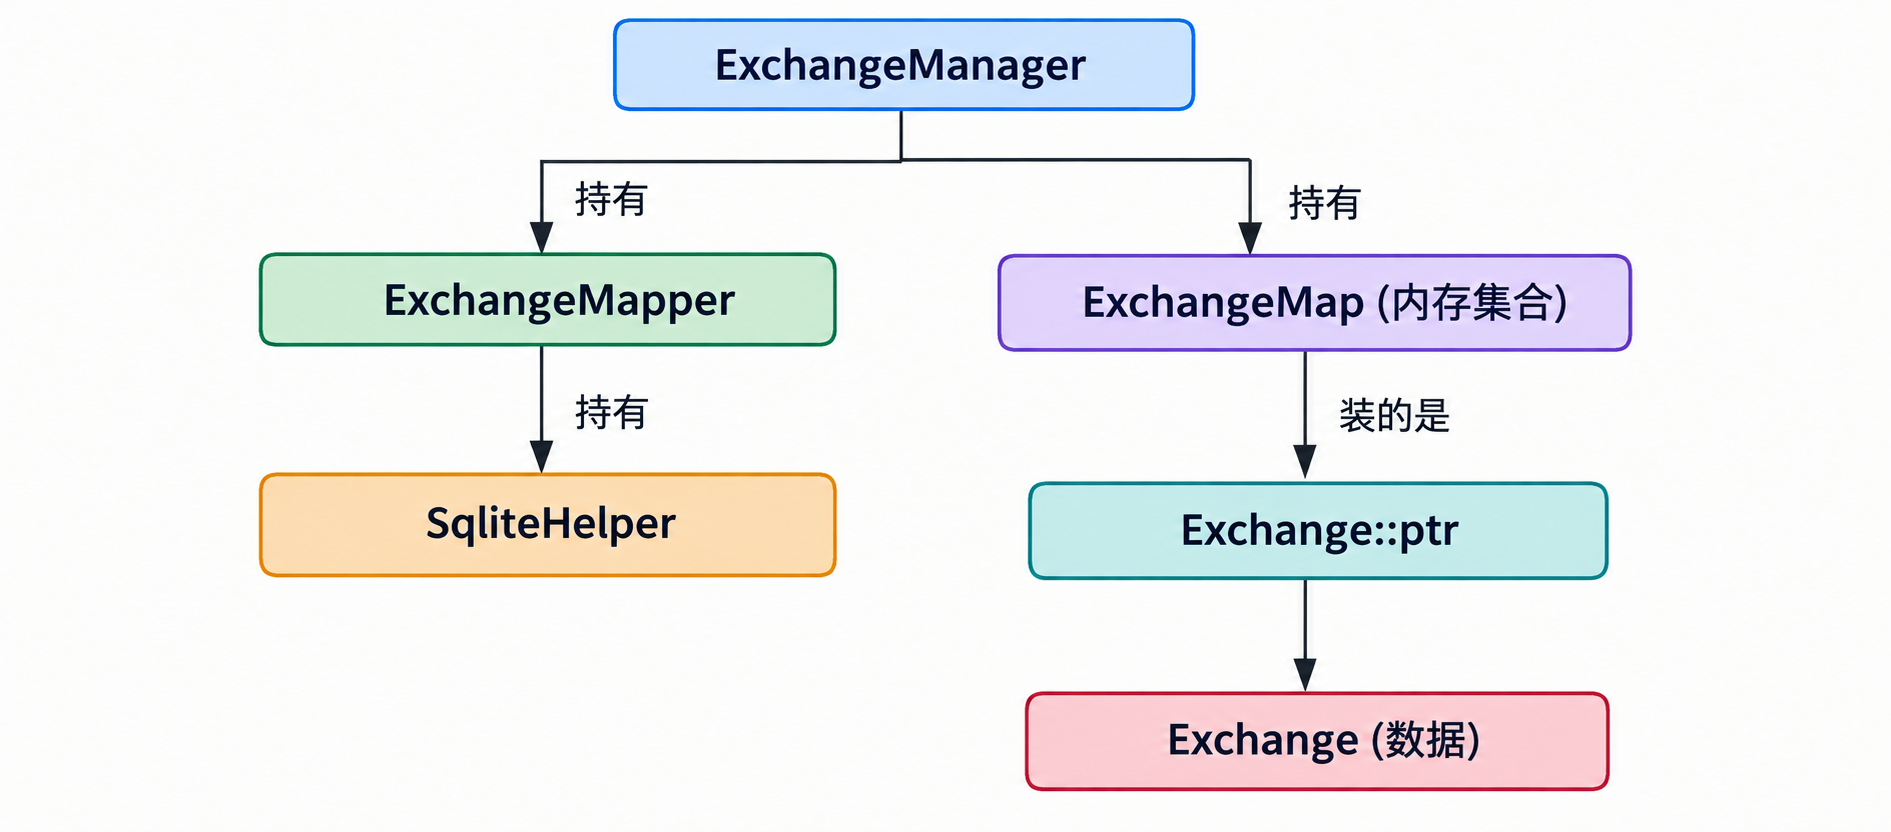
| 类 | 持有谁 | 被谁持有 |
|---|---|---|
| Exchange | 什么都不持有 | 被 ExchangeMapper、ExchangeManager 使用 |
| ExchangeMapper | SqliteHelper | 被 ExchangeManager 持有 |
| ExchangeManager | ExchangeMapper + ExchangeMap | 无(最上层) |
各自的 "地盘":
- Exchange --> 定义一条交换机记录的数据结构
- ExchangeMapper --> 负责交换机数据表的数据库 CRUD
- ExchangeManager --> 管理内存 map 集合、并发控制,对外提供接口
3.函数之间怎么串起来
① 启动时:从数据库恢复(这条链最长,也是回调出场的地方)
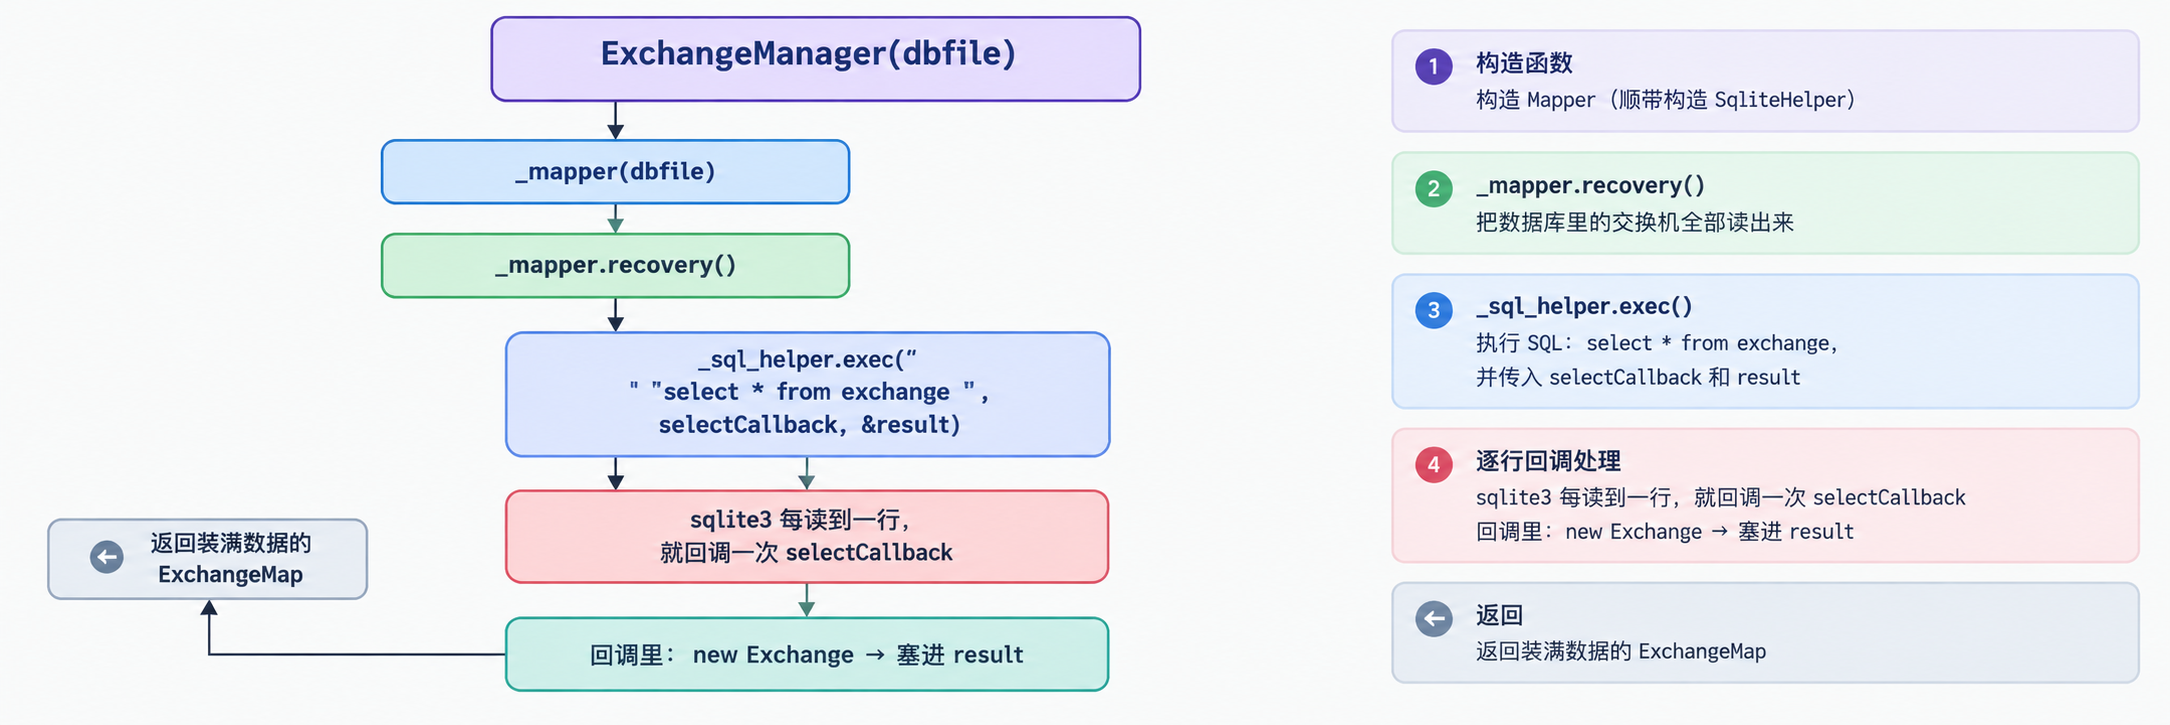
这一串就是持久化 --> 内存镜像的过程。
② 声明交换机:写内存 + 写数据库(两边都要动)
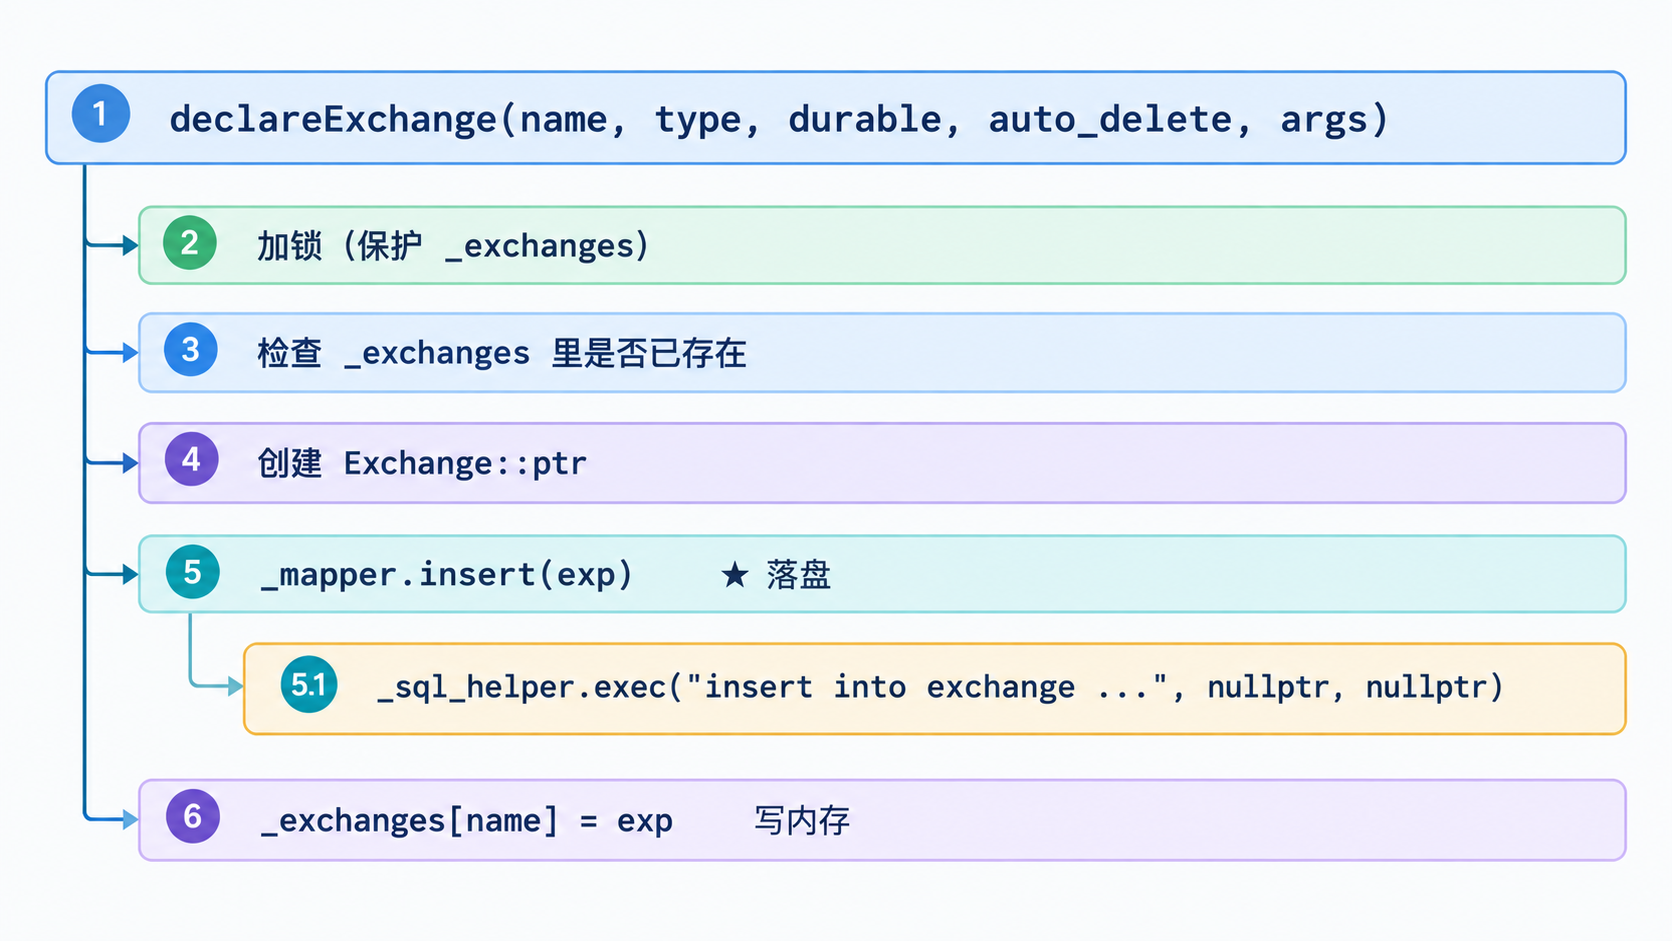
注意 insert 时回调传 nullptr ------ 因为 insert 没有查询结果,不需要逐行回调。
③ 删除交换机:两边都要删
cpp
deleteExchange(name)
    ├─ 加锁
    ├─ _exchanges.erase(name)       删内存
    └─ _mapper.remove(name)         删数据库
④ 查询:只走内存,不碰数据库
cpp
selectExchange(name)   -->   查 _exchanges        <-- 纯内存
exists(name) --> 查 _exchanges <-- 纯内存4.SQLite 回调原理
1.为什么 sqlite3_exec 查询需要回调函数?
我们想要的效果:执行select * from exchange,直接返回一个对象列表。 但 SQLite 底层是 C 语言库,C 没有 C++ 的 vector、map 这类容器,它不知道你要把查询结果存成什么数据结构。
所以 SQLite 采用回调机制:逐行读取数据,每读出一行就调用一次你提供的回调函数,由你自己决定如何解析、存储这行数据。
通俗类比
搬运工(sqlite3_exec)去仓库(数据库)搬箱子(数据行)。 搬运工不知道箱子该放哪里,约定:每搬出一个箱子,就通知你一次,由你来把箱子放到你的车上(自定义容器)。 全部搬完后,你的车上就集齐所有数据。
- 搬运工:sqlite3_exec
- 通知动作:回调函数
- 你的车:用来存放结果的容器(ExchangeMap)
流程拆解
数据表 exchange 两行数据:
| name | type |
|---|---|
| exchange1 | 0 |
| exchange2 | 1 |
- recovery ():创建容器,发起查询
cpp
ExchangeMap recovery()
{
    ExchangeMap result;              // 容器:存放查询结果
    // 传入回调函数,并且把容器地址传给sqlite
    _sql_helper.exec("select * from exchange", selectCallback, &result);
    return result;
}- SQLite 读取到一行数据,触发回调
cpp
static int selectCallback(void *arg, int numcol, char **row, char **fields)
{
    // arg就是我们传入的容器地址,强制类型转换回来
    ExchangeMap *result = (ExchangeMap*)arg;
    // 根据行数据构造Exchange对象
    Exchange::ptr exp(new Exchange());
    exp->name = row[0];
    exp->type = (ExchangeType)atoi(row[1]);
    // 将对象存入容器
    (*result)[exp->name] = exp;
    return 0; // 返回0,通知sqlite继续读取下一行
}读到**exchange1,进入回调构造对象存入 map; 接着读到exchange2**,再次回调存入 map。
- 全部行读取完毕,sqlite3_exec 函数返回 此时 result 容器中已经装载全部交换机数据,recovery 返回内存集合,完成数据库数据加载到内存。
补充:
- 回调是 C 风格接口的妥协,sqlite 不知道上层数据结构;
arg参数用来把上层自定义容器传递进回调;- 回调返回 0 代表继续读取下一行,非 0 终止查询。
5.存镜像 + SQLite 持久化整体流程
上层业务发起调用,请求操作交换机。
请求进入 ExchangeManager。 ExchangeManager 内部维护:
_exchanges:map<name, Exchange::ptr>,作为内存镜像,所有查询操作直接读取这个 map,不访问数据库;_mutex:互斥锁,用来保护内存 map,保证并发安全;_mapper:持久化对象,负责把数据落盘到 SQLite。
当执行新增、删除这类修改操作时,ExchangeManager 会调用 ExchangeMapper。
ExchangeMapper 封装数据库能力:
_sql_helper:SQLite 数据库句柄封装;recovery():从数据库读取全部交换机数据,返回组装好的 ExchangeMap;insert():向数据库新增交换机记录;remove():删除数据库里指定交换机记录。
ExchangeMapper 底层调用 sqlite3_exec(sql, callback, arg) 执行 SQL 查询。 sqlite3_exec每读取到一行数据,就触发一次回调函数 。
回调函数 selectCallback(void *arg, ...): 传入的arg就是 recovery 函数中结果容器的地址。 在回调内部,根据行数据新建 Exchange 对象,放入容器,最后 return 0,告诉 SQLite 继续读取下一行。
总结: 查询走内存,速度快;
增删改同时操作内存 + 数据库,保证内存镜像和磁盘数据一致;
启动阶段依靠 sqlite 回调机制,从数据库加载全部数据构建内存镜像。
6.代码展现:
a.定义交换机数据类
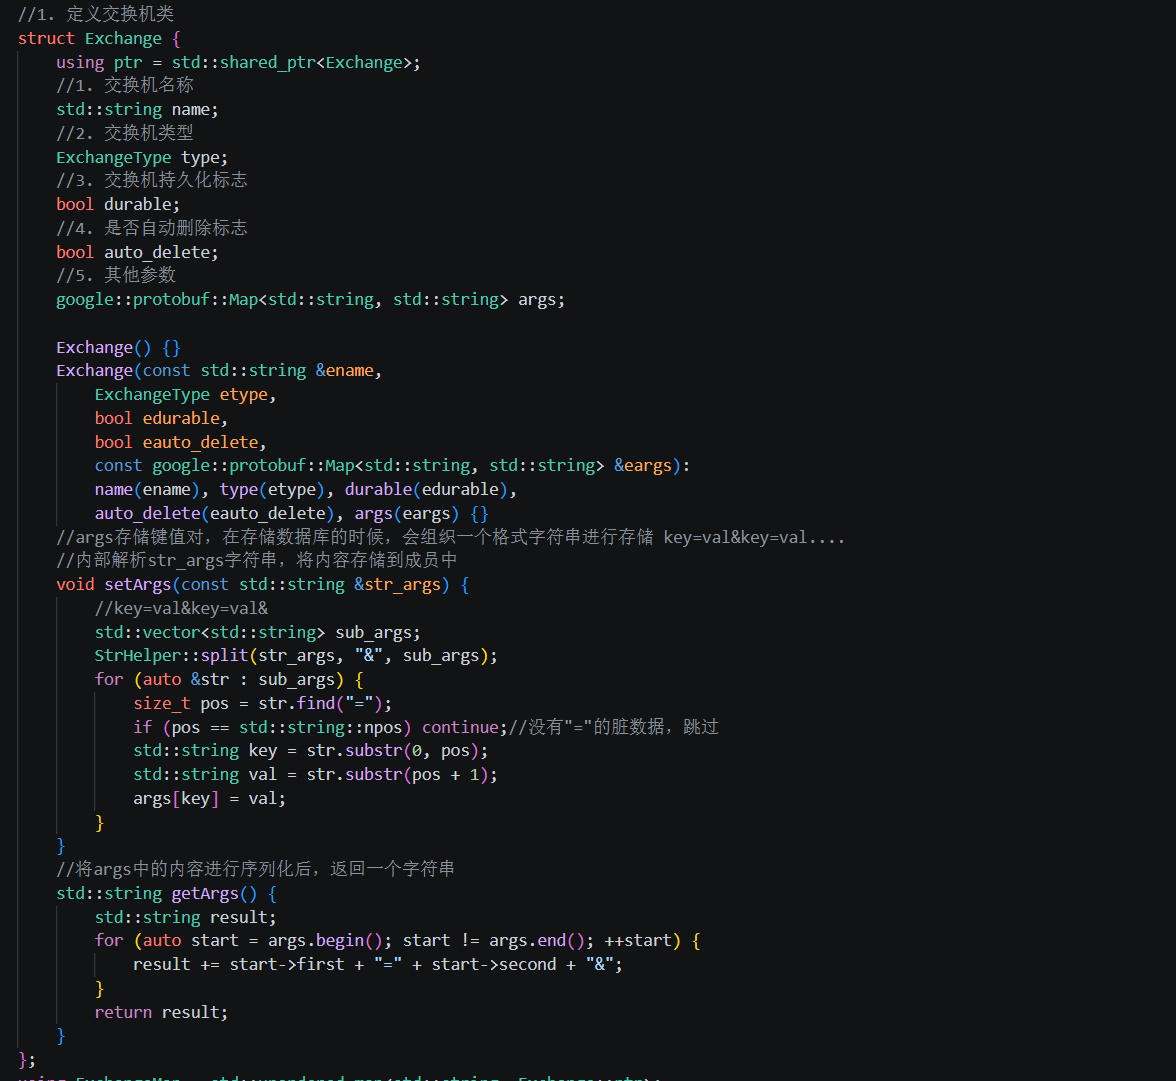
代码分析:
Exchange 类的函数解析
①using ptr = std::shared_ptr<Exchange>;
这不是函数,是类型别名。
cpp
using ptr = std::shared_ptr<Exchange>;作用 :给
std::shared_ptr<Exchange>起个短名字。
用法对比:
cpp
// 不用别名
std::shared_ptr<Exchange> exp = ...;
std::unordered_map<std::string, std::shared_ptr<Exchange>> mymap;

// 用别名
Exchange::ptr exp = ...;
std::unordered_map<std::string, Exchange::ptr> mymap;      //  清爽多了
为什么需要它 :ExchangeMap 的定义就是靠它写出来的:
cpp
using ExchangeMap = std::unordered_map<std::string, Exchange::ptr>;注意 :这里的 Exchange 指的是正在定义的这个类自己 ------ 在类内部可以这么写(类名在类体内部是"可见"的)。
② Exchange() {}
| 项 | 说明 |
|---|---|
| 参数 | 无 |
| 返回值 | 无(构造函数) |
| 函数体 | 空的 |
作用 :造一个"空壳"对象,所有成员取默认值:
cpp
name          ->  ""       (空字符串)
type          ->  0        (枚举第一个值)
durable       ->  false
auto_delete   ->  false
args          ->  空 map
为什么函数体是空的 :成员自己就能初始化好 ,不需要在函数体里做任何事。
cpp
进入函数体之前,成员已经按"默认构造"初始化完了
    -> 函数体里没活可干
-> 所以是 {}谁调用它:
cpp
// ExchangeMapper::selectCallback 里
auto exp = std::make_shared<Exchange>();      // 这里
exp->name = row[0];
exp->type = (ExchangeType)std::stoi(row[1]);
...为什么不直接用带参构造:
因为数据是从 SQLite 一列一列读出来的字符串,还得先
stoi转换、判断空值 ------ 没法在一次构造里全塞进去。
不能删 :只要写了带参构造,编译器就不再生成默认构造,删了 new Exchange() 就编译不过。
③ Exchange(ename, etype, edurable, eauto_delete, eargs)
cpp
Exchange(const std::string &ename,
         ExchangeType etype,
         bool edurable,
         bool eauto_delete,
         const google::protobuf::Map<std::string, std::string> &eargs):
    name(ename), type(etype), durable(edurable),
    auto_delete(eauto_delete), args(eargs) {}
参数表
| 参数 | 类型 | 含义 | 初始化给谁 |
|---|---|---|---|
ename |
const std::string& |
交换机名称 | name |
etype |
ExchangeType |
交换机类型 | type |
edurable |
bool |
是否持久化 | durable |
eauto_delete |
bool |
是否自动删除 | auto_delete |
eargs |
const protobuf::Map& |
其他参数 | args |
作用 :一次把 5 个字段全部填好。
初始化列表的顺序和成员声明顺序一致
cpp
struct Exchange {
    std::string name;          // 第 1 个
    ExchangeType type;         // 第 2 个
    bool durable;              // 第 3 个
    bool auto_delete;          // 第 4 个
    google::protobuf::Map<...> args;   // 第 5 个

    Exchange(...) :
        name(ename), type(etype), durable(edurable),
        auto_delete(eauto_delete), args(eargs) {}   //  顺序一致
};为什么要一致:
C++ 的成员初始化顺序由【声明顺序】决定,和初始化列表的书写顺序无关, 写反了不会报错,但会有 -Wreorder 警告, 而且读代码的人容易被误导
函数体也是空的 :因为所有字段都在初始化列表里赋值了,函数体里没事干。
谁调用它:
cpp
// ExchangeManager::declareExchange 里
auto exp = std::make_shared<Exchange>(name, type, durable, auto_delete, args);业务代码里所有值都齐了,一次构造最干净。
④ void setArgs(const std::string &str_args)
cpp
void setArgs(const std::string &str_args)| 项 | 说明 |
|---|---|
| 参数 | str_args ------ 形如 "k1=v1&k2=v2&" 的字符串 |
| 返回值 | void(结果直接写进成员 args) |
作用 :把字符串解析成 map ,填进
args成员。反序列化。
cpp
void setArgs(const std::string &str_args) {
    // str_args 形如:"key1=val1&key2=val2&"

    std::vector<std::string> sub_args;
    StrHelper::split(str_args, "&", sub_args);
    // ① 按 "&" 切分
    //    "k1=v1&k2=v2&" --> ["k1=v1", "k2=v2"]
    //    (split 内部会跳过空段,所以末尾的 & 不会产生空字符串)

    for (auto &str : sub_args) {
        // ② 逐个处理每一段

        size_t pos = str.find("=");
        // ③ 找 "=" 的位置

        if (pos == std::string::npos) continue;
        // ④ 没有 "=" 的脏数据,直接跳过
        //    不加这行会怎样?
        //        pos = npos = SIZE_MAX
        //        key = str.substr(0, npos)      = 整个字符串
        //        val = str.substr(npos + 1)     = 溢出变 0 -> 又是整个字符串
        //        --> args["abc"] = "abc"  <- 错误数据被写进去

        std::string key = str.substr(0, pos);
        // ⑤ "=" 左边是 key

        std::string val = str.substr(pos + 1);
        // ⑥ "=" 右边是 val

        args[key] = val;
        // ⑦ 存进 map
    }
}谁调用它:
// 1. selectCallback 里(从数据库读出来之后)
if (row[4]) exp->setArgs(row[4]);

// 2. 测试里(往返验证)
bitmq::Exchange tmp;
tmp.setArgs(exp->getArgs());
⑤ std::string getArgs()
cpp
std::string getArgs()| 项 | 说明 |
|---|---|
| 参数 | 无(读的是自己的 args 成员) |
| 返回值 | 形如 "k1=v1&k2=v2&" 的字符串 |
作用 :把 map 拼成字符串 。序列化。
cpp
std::string getArgs() {
    std::string result;
    // ① 准备一个空串

    for (auto start = args.begin(); start != args.end(); ++start) {
        // ② 遍历 map
        //    start->first  = key
        //    start->second = value

        result += start->first + "=" + start->second + "&";
        // ③ 拼成 "key=value&"
    }

    return result;
}举例:
cpp
args = {"k1":"v1", "k2":"v2"}

    第 1 轮:result = "k1=v1&"
    第 2 轮:result = "k1=v1&k2=v2&"

返回 "k1=v1&k2=v2&"
两个细节:
① 末尾会多一个 &
cpp
"k1=v1&k2=v2&"
             多了一个
这不是 bug ------ 因为配对的
setArgs里的split会跳过空段,能正常解析
② args 是 protobuf::Map,遍历顺序不保证
cpp
可能是 "k1=v1&k2=v2&"
也可能是 "k2=v2&k1=v1&"
所以测试里不能直接比对字符串 ------ 要解析回来按 key 验证:
cpp
bitmq::Exchange tmp;
tmp.setArgs(exp->getArgs());
ASSERT_EQ(tmp.args["k1"], "v1");      // <-- 按 key 取,和顺序无关
谁调用它:
// 1. ExchangeMapper::insert 里(拼 SQL 前)
ss << "'" << exp->getArgs() << "');";

// 2. 测试里
tmp.setArgs(exp->getArgs());
总结:四个函数的两组配对
cpp
【配对一:构造函数】
    Exchange()        造空壳  -->  给 selectCallback 用
    Exchange(...)     一次成型  -->  给 declareExchange 用
        ↑ 两个都要有(写了带参构造,默认构造就不会自动生成)

【配对二:序列化】
    getArgs()   map --> 字符串   -->  写数据库前用
    setArgs()   字符串 --> map   -->  从数据库读出后用
↑ 格式必须严格配对,一个拼、一个解b.定义交换机数据持久化类(数据持久化的 sqlite3 数据库中)
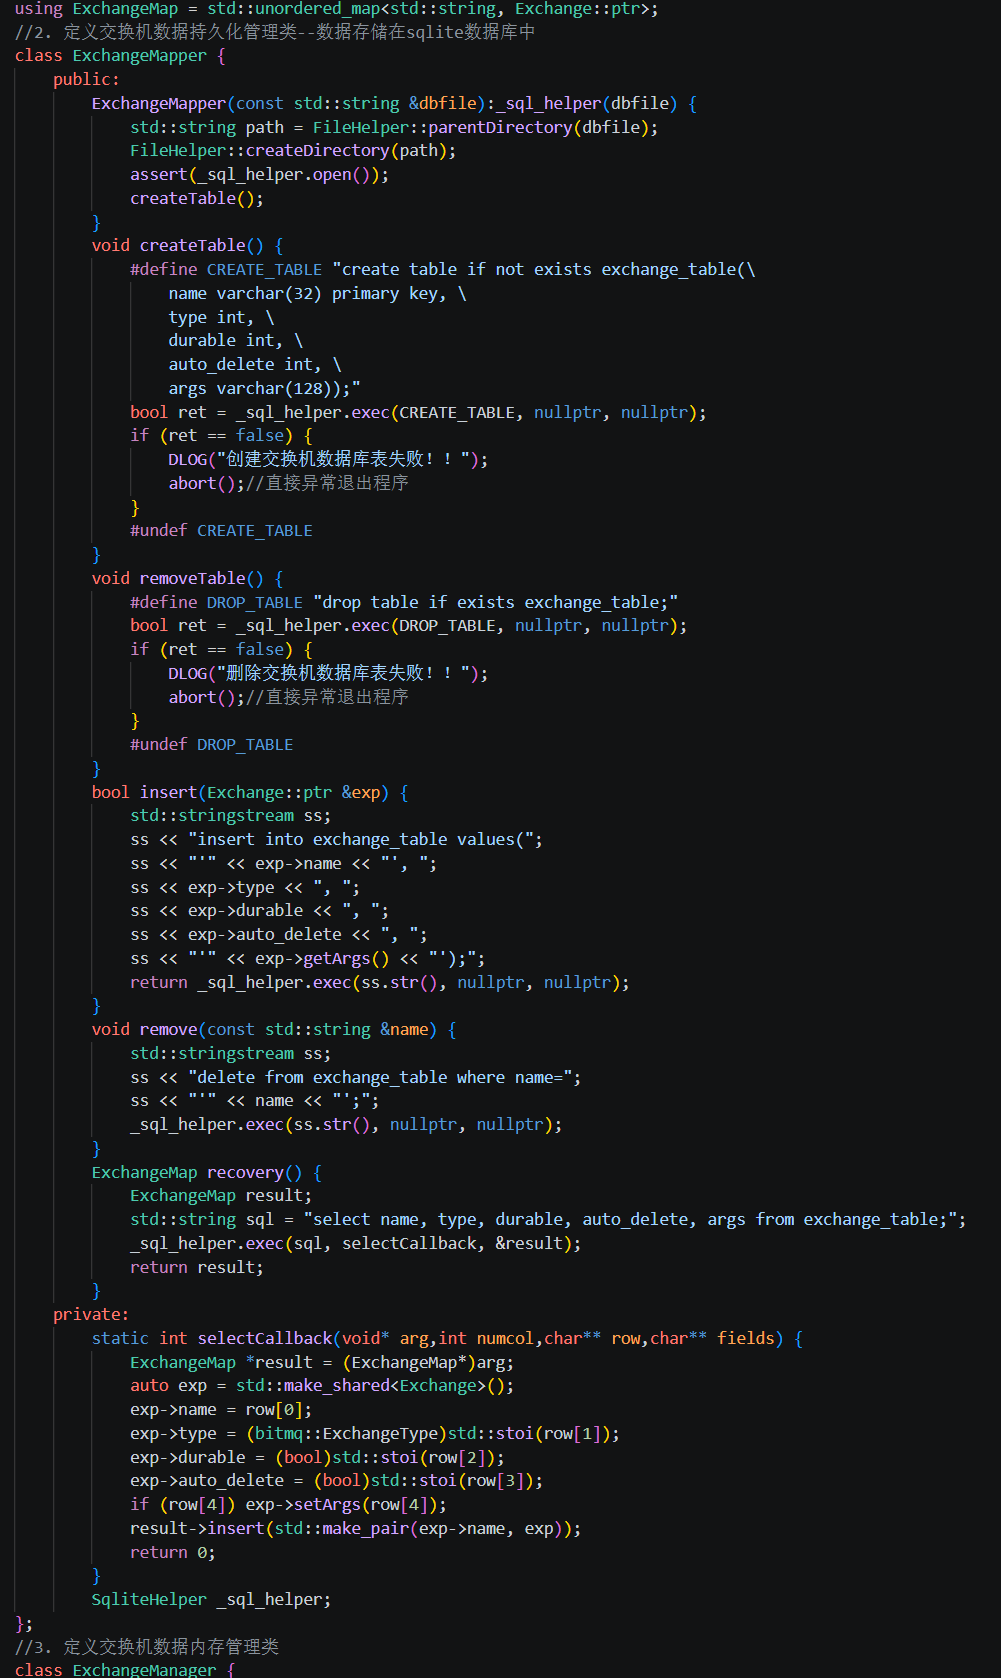
ExchangeMapper 逐行解析
1.构造函数
cpp
ExchangeMapper(const std::string &dbfile):_sql_helper(dbfile) {
    std::string path = FileHelper::parentDirectory(dbfile);
    FileHelper::createDirectory(path);
    assert(_sql_helper.open());
    createTable();
}
cpp
ExchangeMapper(const std::string &dbfile)
// 参数是数据库文件路径,比如 "./data/meta.db"

:_sql_helper(dbfile)
//  初始化列表:构造成员 _sql_helper
//   此刻它只"记住文件名",还没连数据库

    std::string path = FileHelper::parentDirectory(dbfile);
    // 取出目录部分
    // "./data/meta.db"  →  找最后一个 "/"  →  取前面  →  "./data"

    FileHelper::createDirectory(path);
    //  确保 "./data" 存在

    assert(_sql_helper.open());
    // 真正打开数据库(建立连接)

    createTable();
    // 建表
为什么这三步必须按这个顺序
cpp
① parentDirectory    先要知道目录在哪
② createDirectory    目录不存在 --> SQLite 打开会失败
③ open               目录有了才能开
④ createTable        库开了才能建表
假如说漏掉 ② 会怎样
cpp
./data/ 目录不存在
    → sqlite3 打开 "./data/meta.db" 直接失败
    → 后面所有 SQL 全部报错
这就是 FileHelper 那两个函数存在的意义 ------ 它们是"给别人用"的基础设施。
2.createTable ------ 建表
cpp
void createTable() {
    #define CREATE_TABLE "create table if not exists exchange_table(\
        name varchar(32) primary key, \
        type int, \
        durable int, \
        auto_delete int, \
        args varchar(128));"
这段在干什么
cpp
① #define 定义一个宏,值是那条建表 SQL
② 每行末尾的 \ 是[续行符],把 5 行拼成一个字符串
③ 宏的作用范围:从定义处一直到文件末尾(或 #undef)
拼出来的完整 SQL
cpp
create table if not exists exchange_table(
    name varchar(32) primary key,
    type int,
    durable int,
    auto_delete int,
    args varchar(128));
字段设计逐个说
| 字段 | 类型 | 为什么这么定 |
|---|---|---|
name |
varchar(32) primary key |
主键 → 名字唯一,天然去重 |
type |
int |
枚举值(0=DIRECT、1=FANOUT...) |
durable |
int |
SQLite 没有 bool,用 0/1 代替 |
auto_delete |
int |
同上 |
args |
varchar(128) |
存序列化后的 "k=v&k=v&" |
为什么 if not exists 是必须的
cpp
构造函数每次都会调 createTable
    → 第二次启动时表已存在
    → 如果不写 if not exists → 报错 "table already exists" → abort() 退出
cpp
    bool ret = _sql_helper.exec(CREATE_TABLE, nullptr, nullptr);
    // 第 2 个参数 nullptr = 不需要回调
    //    因为建表[没有查询结果],不需要"逐行通知"
    // 第 3 个参数 nullptr = 没有要传给回调的数据

    if (ret == false) {
        DLOG("创建交换机数据库表失败!!");
        abort();//直接异常退出程序
    }
    // 建表失败 --> 记日志 + 直接退出
    // 为什么不 return?
    //   因为建不出表,后面所有操作都是错的 → 不如直接死掉

    #undef CREATE_TABLE
    //  用完撤掉宏,避免污染文件后续代码
}
3.removeTable ------ 删表
cpp
void removeTable() {
    #define DROP_TABLE "drop table if exists exchange_table;"
    bool ret = _sql_helper.exec(DROP_TABLE, nullptr, nullptr);
    if (ret == false) {
        DLOG("删除交换机数据库表失败!!");
        abort();
    }
    #undef DROP_TABLE
}
和 createTable 结构完全对称,只有 SQL 不同。
一个关键区别
cpp
drop table if exists exchange_table;    -- ← 你用的:表【结构+数据】全没
delete from exchange_table;             -- 只清空数据,表还在
cpp
removeTable() 执行的是 drop table
    → 调完之后表就不存在了
    → 如果后面还要用,必须跟一个 createTable()
这就是为什么 ExchangeManager::clear() 里两句话要配套:
cpp
_mapper.removeTable();
_mapper.createTable();     //  删了必须重建
4.insert ------ 写一条
cpp
bool insert(Exchange::ptr &exp) {
    std::stringstream ss;
    // ① 准备"字符串流",用它拼 SQL

    ss << "insert into exchange_table values(";
    // ② 拼开头
    //    注意这里【没写字段名】→ 所以值必须严格按建表顺序给

    ss << "'" << exp->name << "', ";
    // ③ 第 1 个值:name
    //     前后各加一个单引号 → 因为它是字符串字段
    //    拼出来是 'exchange1',

    ss << exp->type << ", ";
    // ④ 第 2 个值:type
    //    枚举会隐式转 int → 输出数字
    //     数字字段【不加引号】

    ss << exp->durable << ", ";
    // ⑤ 第 3 个值:bool 输出成 1 或 0

    ss << exp->auto_delete << ", ";
    // ⑥ 第 4 个值

    ss << "'" << exp->getArgs() << "');";
    // ⑦ 第 5 个值:args
    //     调 getArgs() 把 map 序列化成 "k1=v1&k2=v2&"
    //    再加单引号,最后补 ");"

    return _sql_helper.exec(ss.str(), nullptr, nullptr);
    // ⑧ ss.str() 把 stringstream 转成 std::string
    //    直接 return exec 的结果(成功 true / 失败 false)
}
拼出来的 SQL 长什么样
cpp
// exp 内容:
//     name = "exchange1"
//     type = 0(DIRECT)
//     durable = true
//     auto_delete = false
//     args = {"k1":"v1"}

// 拼出来:
insert into exchange_table values('exchange1', 0, 1, 0, 'k1=v1&');
两个隐患
① 没写字段名 → 顺序不能变
cpp
insert into exchange_table values(...)          -- 依赖建表顺序
insert into exchange_table(name,type,...) values(...)   -- 显式写,更安全
② SQL 注入
cpp
如果 exp->name 含单引号(比如 "it's")
    → 拼出来的 SQL 就坏了
    → 标准做法是 sqlite3_bind_*(参数化查询)
5.remove ------ 删一条
cpp
void remove(const std::string &name) {
    std::stringstream ss;
    ss << "delete from exchange_table where name=";
    ss << "'" << name << "';";
    // 拼出来:"delete from exchange_table where name='exchange2';"

    _sql_helper.exec(ss.str(), nullptr, nullptr);
    // 执行,不关心返回值
}
为什么返回 void 而不是 bool
cpp
删一条不存在的记录,SQL 也返回"成功"(影响 0 行)
    → 报错意义不大
    → 所以干脆不返回
但代价是"信息丢失"
cpp
// ExchangeManager::deleteExchange 里
if (it->second->durable == true) _mapper.remove(name);
_exchanges.erase(name);          // ← 无论数据库删没删成功,内存都删了
如果数据库删除失败,内存和数据库就不一致了 ------ 这就是 void 返回值带来的问题。
6.recovery ------ 读全部(★最关键的一个)
cpp
ExchangeMap recovery() {
    ExchangeMap result;
    // ① 准备"容器"(一个空 map)

    std::string sql = "select name, type, durable, auto_delete, args from exchange_table;";
    // ②  显式列出字段,顺序是刻意安排的

    _sql_helper.exec(sql, selectCallback, &result);
    // ③  把【容器地址】传进去

    return result;
    // ④ 返回装满数据的 map
}
② 的字段顺序 ------ 必须和回调里的下标严格对应
cpp
select name, type, durable, auto_delete, args
       ↑0     ↑1     ↑2        ↑3         ↑4

        ↓ 一一对应

回调里:
    row[0] → exp->name
    row[1] → exp->type
    row[2] → exp->durable
    row[3] → exp->auto_delete
    row[4] → exp->setArgs(...)
这是全文最容易出错的地方
cpp
改了 SQL 的字段顺序 --> 必须同步改回调里的下标
    → 而且错了[不会崩溃],只会"静默地把字段搞混"
    → 是最难查的那种 bug
③ 为什么传 &result 而不是 result
exec 的第 3 个参数类型是 void*
    → 必须传【地址】

回调里再用 (ExchangeMap*)arg 把它转回来
    → 两边是"交出去地址 / 收回来地址"的配对关系
7.selectCallback ------ 逐行回调(最绕的一个)
cpp
static int selectCallback(void* arg,int numcol,char** row,char** fields) {
    ExchangeMap *result = (ExchangeMap*)arg;
    // ①  把 void* 还原成真实类型
    //    exec 传进来的是 &result(ExchangeMap*)
    //    sqlite3 只把它当 void* 存着,这里自己转回来

    auto exp = std::make_shared<Exchange>();
    // ②  调 Exchange 的【默认构造】,造一个空壳
    //    因为数据是一条条字符串,只能先建空对象再逐个填

    exp->name = row[0];
    // ③ 第 0 列 → name(字符串直接赋)

    exp->type = (bitmq::ExchangeType)std::stoi(row[1]);
    // ④ 第 1 列 → 字符串转 int → 强转成枚举

    exp->durable = (bool)std::stoi(row[2]);
    // ⑤ 第 2 列 → "1"/"0" → int → bool

    exp->auto_delete = (bool)std::stoi(row[3]);
    // ⑥ 第 3 列

    if (row[4]) exp->setArgs(row[4]);
    // ⑦  第 4 列
    //    先判空指针(sqilte3 对 NULL 列会传 nullptr)
    //    再调 setArgs 反序列化成 map

    result->insert(std::make_pair(exp->name, exp));
    // ⑧ 装进容器
    //    key = 交换机名字(和数据库的主键一致)
    //    value = 智能指针

    return 0;
    // ⑨  返回 0:告诉 sqlite3"继续读下一行"
    //    返回非 0 → sqlite3_exec 立即中止
}
为什么必须是 static
cpp
sqlite3_exec 要求回调是[普通函数指针]
    → 成员函数隐含 this 参数,签名不匹配
    → 所以声明成 static(不带 this)
    → 代价:访问不到非静态成员(但也不需要,数据都从 arg 来)
这个函数会被调用多少次
表里有 N 条记录 → 就被调用 N 次
    → 每次收到一行,装进同一个 result
完整过程
cpp
recovery()
    ├─ ExchangeMap result;                     准备容器
    ├─ exec(sql, selectCallback, &result)      交出地址
    │      │
    │      ├─ 读到第 1 行 → selectCallback(&result, 5, {"exchange1","0","1","0",""}, ...)
    │      │                    → new Exchange → 填字段 → result["exchange1"] = exp →return 0
    │      │
    │      ├─ 读到第 2 行 → selectCallback(...)   同一套动作
    │      │
    │      └─ 没有更多行 → exec 返回
    │
    └─ return result;                          返回装满的容器
8.成员变量
cpp
private:
    SqliteHelper _sql_helper;
只有一个成员 ------ 因为这一层的职责就是"和数据库打交道",除了数据库句柄,不需要别的东西。
9.七个函数的调用关系
这七个函数可以分成两组:一组由构造函数触发,另一组由上层ExchangeManager触发,最终都会调用到_sql_helper.exec()。
第一组:构造函数触发
构造函数执行时包含三条执行线路,执行顺序有严格要求:
- 文件系统分支:调用
FileHelper::parentDirectory(),从数据库路径提取目录,再调用FileHelper::createDirectory()创建目录。- 数据库连接分支:调用
_sql_helper.open()打开数据库。- 建表分支:调用
createTable(),createTable()内部调用_sql_helper.exec()执行建表 SQL。
执行顺序:先获取并创建目录 → 打开数据库连接 → 创建数据表。
第二组:ExchangeManager 间接触发(4 个函数:insert ()、remove ()、recovery ()、removeTable ())
insert()、remove()、removeTable()三者内部都会调用exec(),只是执行 SQL 语句不同,分别对应插入单行、删除单行、删除整张表。 调用exec()时,回调函数、自定义参数两个参数都传nullptr。
原因:这三类仅执行修改动作,没有查询结果,不需要逐行解析数据,因此不需要回调。
recovery()本组唯一一个需要读取并返回数据的函数。 调用exec()时,第二个参数传入selectCallback回调函数,第三个参数传入&result(结果容器的地址)。 SQLite 每读取一行数据,就触发一次selectCallback;在回调中解析行数据,构造Exchange对象存入容器。全部读取完成后,recovery()返回装满数据的容器。
总结
createTable()、removeTable()、insert()、remove()属于动作型 SQL,无返回结果,调用 exec 时不传回调; 只有recovery()属于查询型 SQL,需要收集结果,传入回调函数与容器地址,依靠回调逐行组装数据。
c.定义交换机数据管理类 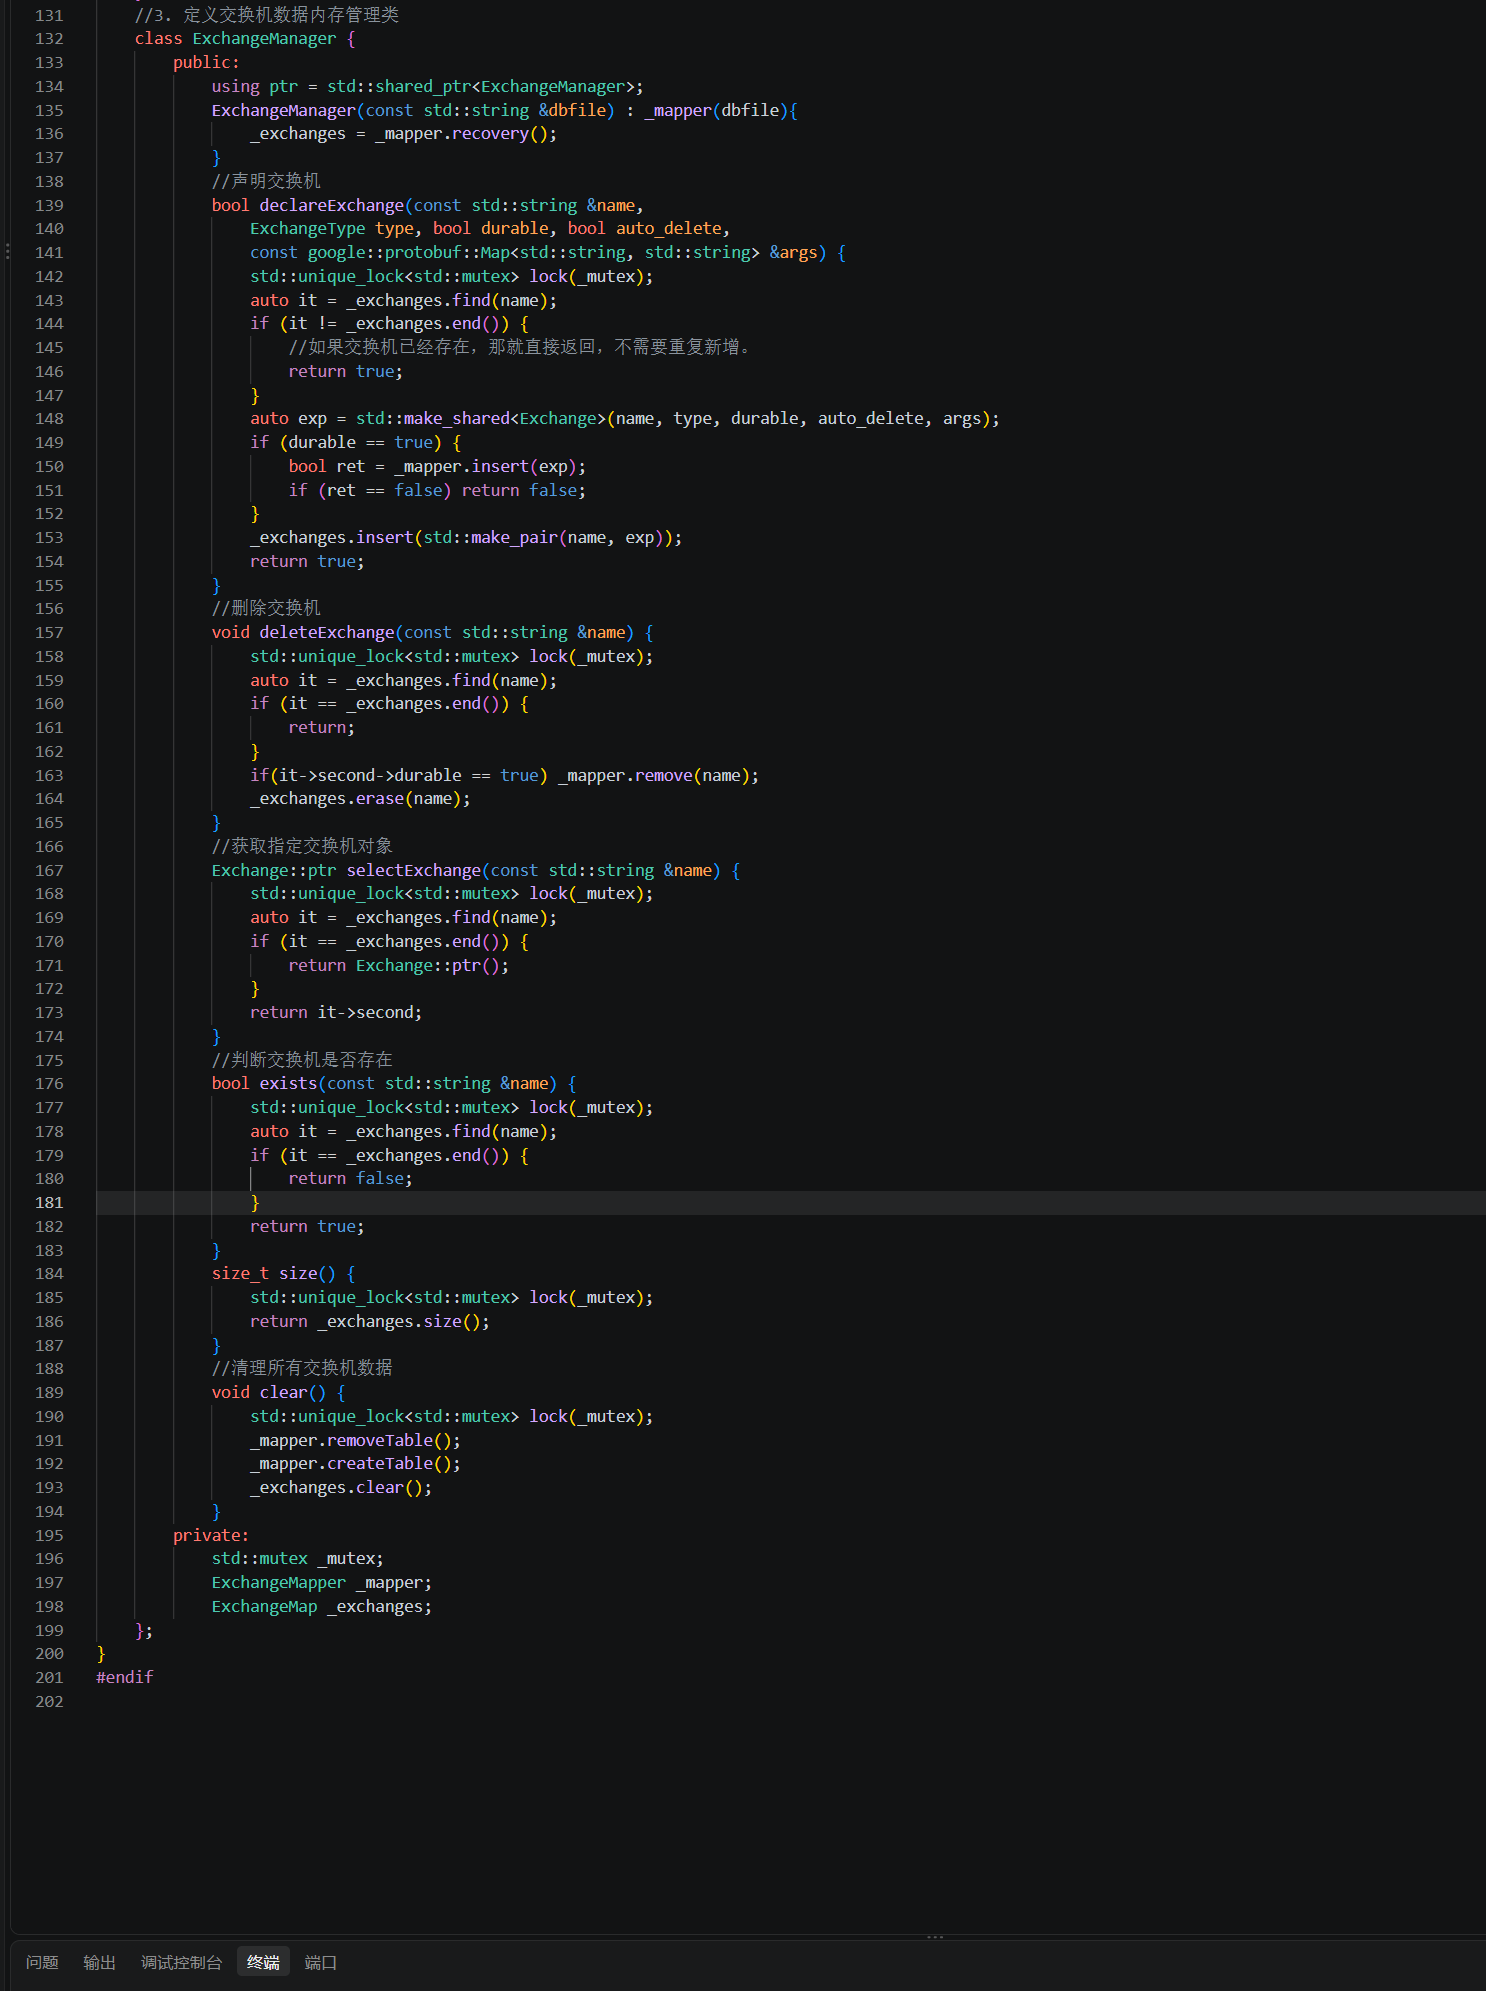
代码解析:
1.declareExchange ------ 声明交换机( 最复杂的一个)
cpp
bool declareExchange(const std::string &name,
    ExchangeType type, bool durable, bool auto_delete,
    const google::protobuf::Map<std::string, std::string> &args) {
五个参数 :名字、类型、是否持久化、是否自动删除、其他参数。正好对应 Exchange 的五个字段。
第 1 步:加锁
cpp
    std::unique_lock<std::mutex> lock(_mutex);
    // 保护 _exchanges(会被多个客户端线程并发访问)
    // unique_lock 出作用域自动解锁 → 中途 return 也不会忘
第 2 步:先查有没有
这就是"幂等" ------ 声明一个已存在的交换机,返回成功,而不是失败。
cpp
为什么必须幂等?
    客户端可能因为网络重发、程序重连而重复声明
    → 每次都报错的话,客户端会很难写
    → 所以"声明已存在的"应该是【成功】
这和建表用 if not exists 是同一个思路。
第 3 步:创建对象
cpp
    auto exp = std::make_shared<Exchange>(name, type, durable, auto_delete, args);
    //  调 Exchange 的【带参构造】,一次把 5 个字段填好
为什么这里用带参构造,而 selectCallback 里用默认构造:
这里:所有值都齐了 → 一次构造最干净
回调里:数据是一条条字符串,还得 stoi 转换 → 只能先造空壳再逐个填
第 4 步:落盘(有条件)
    if (durable == true) {
        bool ret = _mapper.insert(exp);
        if (ret == false) return false;
}两层含义:
cpp
① if (durable == true)  → 只有持久化的才写数据库
      非持久化的重启后本来就会消失,没必要占数据库空间

② if (ret == false) return false;
      落盘失败 → 整个声明失败 → 【此时还没往内存里塞】
→ 内存和数据库保持一致 顺序很讲究:
cpp
先落盘,成功才入内存
    → 数据库和内存永远一致

如果反过来(先入内存、再落盘)
    → 落盘失败时内存里多一条、数据库里没有 → 不一致
第 5 步:入内存
cpp
    _exchanges.insert(std::make_pair(name, exp));
    // key   = name(交换机名字)
    // value = shared_ptr

    return true;
}
为什么 key 用 name :数据库里 name 是主键,业务上所有操作也都按名字找 → 两边保持一致。
4.deleteExchange ------ 删除交换机
cpp
void deleteExchange(const std::string &name) {
    std::unique_lock<std::mutex> lock(_mutex);
    // ① 加锁

    auto it = _exchanges.find(name);
    // ② 找

    if (it == _exchanges.end()) {
        return;
    }
    // ③ 不存在 → 直接返回
    //    删一个不存在的东西,不算错误

    if(it->second->durable == true) _mapper.remove(name);
    // ④  只有持久化的才删数据库
    //    非持久化的数据库里压根没有它

    _exchanges.erase(name);
    // ⑤ 删内存
}
和 declareExchange 是对称的:
cpp
declare:先落盘 → 再入内存
delete :先删库 → 再删内存
顺序的道理一样:数据库先动,出错了内存还没动,状态仍然一致。
但这里有个"信息丢失"
cpp
_mapper.remove(name);       // 返回 void → 失败也不知道
_exchanges.erase(name);     // 无论如何都执行
因为 ExchangeMapper::remove() 返回 void ------ 数据库删失败时,内存照样删了,两边就不一致了。
在你这个场景下影响不大 (删除基本不会失败),但如果要严谨,remove 应该也返回 bool,这里判断一下。
5.selectExchange ------ 取对象(有个关键设计)
cpp
Exchange::ptr selectExchange(const std::string &name) {
    std::unique_lock<std::mutex> lock(_mutex);
    // ① 加锁

    auto it = _exchanges.find(name);
    // ② 找

    if (it == _exchanges.end()) {
        return Exchange::ptr();
    }
    // ③ 没找到 → 返回【空智能指针】(等价于 nullptr)
    //    调用方用 if (exp == nullptr) 就能判断

    return it->second;
    // ④  返回 shared_ptr 的【拷贝】,引用计数 +1
}
为什么返回 shared_ptr 而不是裸指针 ------ 这是本节最值得理解的一点
cpp
函数一返回,锁就释放了
    ↓
如果是裸指针:
    另一个线程可能立刻 deleteExchange(name)
        → 对象被销毁
        → 你手里的指针变成【悬空指针】
        → 一用就崩

返回 shared_ptr 的拷贝:
    引用计数 +1
    → 即使 map 里那份被 erase
→ 你手里这份仍然有效 举个具体例子:
cpp
Exchange::ptr exp = emp->selectExchange("exchange2");
// 引用计数至少是 2(map 里一份 + exp 一份)

// 另一个线程同时:
emp->deleteExchange("exchange2");      // map 里那份被 erase → 计数减 1 → 还剩 1

// 你继续用:
std::cout << exp->name;                //  安全!对象还活着
这就是"智能指针延长生命周期"的价值 ------ 它把"锁的保护"延伸到了函数外面。
6.exists ------ 判断存在
cpp
bool exists(const std::string &name) {
    std::unique_lock<std::mutex> lock(_mutex);

    auto it = _exchanges.find(name);

    if (it == _exchanges.end()) {
        return false;
    }
    return true;
}
逻辑正确。 也可以简写成:
cpp
return _exchanges.count(name) != 0;
// 或
return _exchanges.find(name) != _exchanges.end();
但你的写法更直白,不用改。
为什么要单独提供 exists,而不是让调用方自己 selectExchange 判空
cpp
selectExchange 会返回 shared_ptr → 产生一次引用计数操作(原子操作,有开销)
exists         只查"在不在",不产生对象拷贝 → 更轻
7.size ------ 当前数量
size_t size() {
    std::unique_lock<std::mutex> lock(_mutex);
    return _exchanges.size();
}两点说明:
① 为什么也要加锁
cpp
别的线程可能正在 declareExchange / deleteExchange
    → 不加锁读 size(),可能读到"正在修改中"的值
② 类型天然匹配
cpp
unordered_map::size() 返回 size_t
函数返回类型也是 size_t
    → 不用转换、不会溢出
这是唯一一个没有在原来设计清单里、你后来加的函数 ------ 加得合理(运行时统计、测试断言都用得上)。
8.clear ------ 清空全部
cpp
void clear() {
    std::unique_lock<std::mutex> lock(_mutex);

    _mapper.removeTable();
    // ① 删掉数据库里的表(drop table)

    _mapper.createTable();
    // ②  立刻重建一张空表
    //    不重建的话,后面再 insert 会报 "no such table"

    _exchanges.clear();
    // ③ 清空内存 map
}
顺序和配对
cpp
drop table  →  表【结构和数据】全没
    → 所以必须紧跟一句 createTable()

如果只想清数据、保留表,其实用 delete from 更简单:
    _mapper.exec("delete from exchange_table;")
两种写法都能达到"数据清空"的效果 ,你现在这种"删表 + 重建"也没问题 ------ 关键是这两句必须成对出现。
谁调用它:
cpp
① 测试的 TearDown 里(保证测试可重复运行)
② 上层提供的"清空服务"接口
9.成员变量
cpp
private:
    std::mutex _mutex;          // 保护 _exchanges 的锁
    ExchangeMapper _mapper;     // 持久化层(数据库那一侧)
ExchangeMap _exchanges; // 内存里的交换机集合三个成员的分工:
cpp
_mutex       →  并发控制
_mapper      →  数据库那一侧
_exchanges   →  内存这一侧
注意 _mapper 和 _exchanges 的关系:
cpp
_exchanges 是 _mapper 的"内存镜像"
    → 启动时 recovery() 把数据库搬进内存
    → 之后增删时两边同步
    → 查询只走内存
为什么锁不在 ExchangeMapper 里:
cpp
要保护的是"内存 map 的并发访问"
而"谁在什么时候读写"是 Manager 决定的
    → 锁放在 Manager,保护的是业务层的操作
10.七个函数的整体关系
cpp
   【只读内存 ------ 快】
        selectExchange / exists / size
              │
              └─> 只查 _exchanges,不碰数据库

   【两边同步 ------ 保证持久】
        declareExchange  →  _exchanges +1,_mapper.insert
        deleteExchange   →  _exchanges -1,_mapper.remove
        clear            →  _exchanges 清空,_mapper 删表重建

   【启动时对齐】
构造函数 → _mapper.recovery() → 把数据库搬进内存归纳成一句话:
读操作只走内存(O(1),不碰磁盘),写操作两边同步(保证重启不丢),启动时用
recovery()把两边对齐。
11.三个值得记住的设计点
① 幂等
cpp
if (it != _exchanges.end()) return true; // 已存在 ≠ 失败② shared_ptr 延长生命周期
return it->second; // 返回拷贝 → 锁释放后对象仍安全③ unique_lock 自动解锁
cpp
std::unique_lock<std::mutex> lock(_mutex);
// ...
return xxx; // 中途 return 也不会忘解锁 到这里,三个类的逐行解析就全了:
Exchange          4 个函数(2 构造 + 2 序列化)
ExchangeMapper    7 个函数(1 构造 + 5 操作 + 1 回调)
ExchangeManager   7 个函数(1 构造 + 6 操作)
d.测试函数
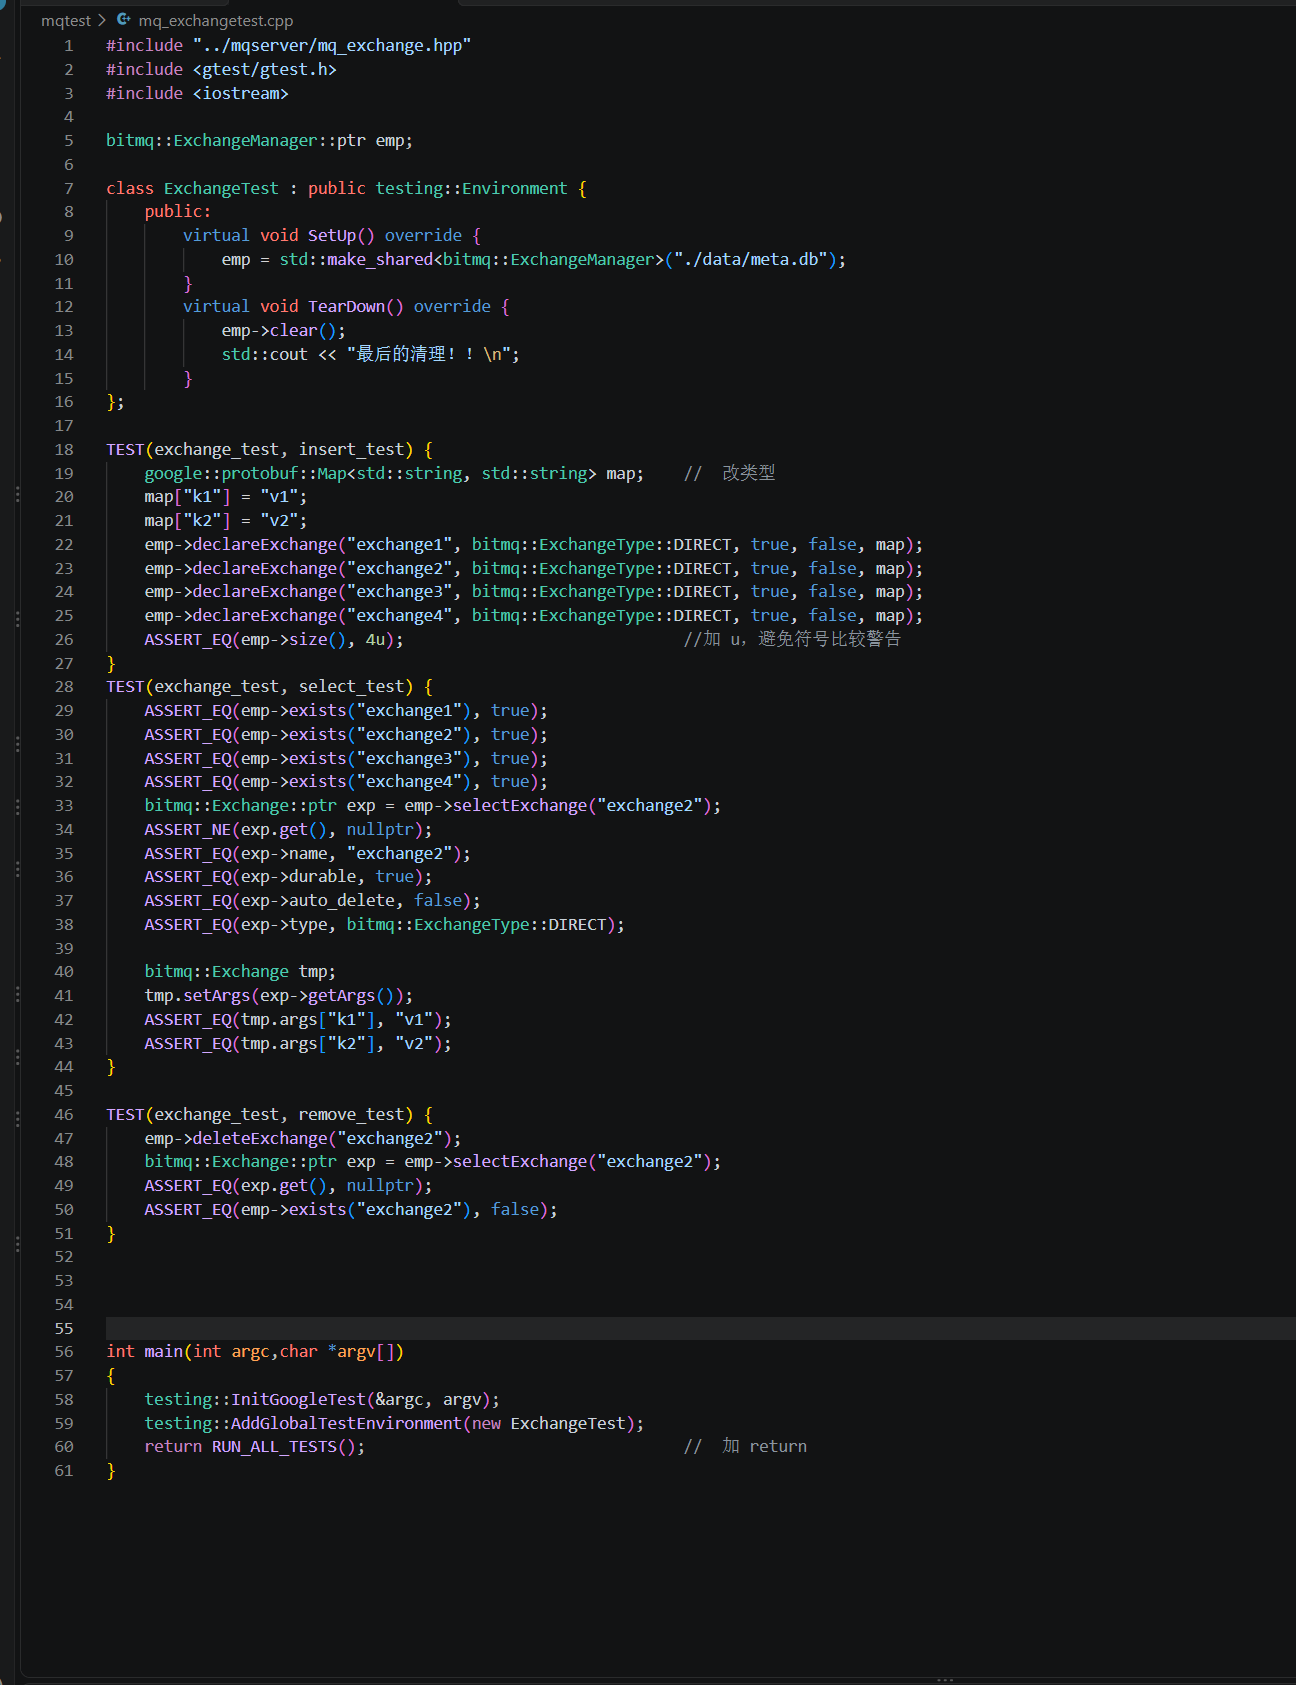
代码解析:
1.头文件与全局变量
cpp
#include "../mqserver/mq_exchange.hpp"
#include <gtest/gtest.h>
#include <iostream>三个头文件各干什么:
cpp
mq_exchange.hpp  →  引入被测对象(ExchangeManager / Exchange)
gtest/gtest.h    →  GTest 框架(TEST 宏、ASSERT_* 宏、Environment 类)
iostream         →  std::cout(TearDown 里要打印)
注意这里 include 的是 mq_exchange.hpp ------ 因为它是头文件(只有一个 .hpp),实现都写在头里,所以测试文件只需要这一个。
bitmq::ExchangeManager::ptr emp;一个全局的管理对象。
① 类型是 shared_ptr<ExchangeManager>
② 现在还是【空的】(默认构造的 shared_ptr 就是 nullptr)
③ 真正的对象在 SetUp 里才创建为什么敢用全局变量:
cpp
三个 TEST 都要用它 → 需要一个共享的容器
而 ExchangeManager 构造很"重"(建目录、开库、建表、恢复数据)
    → 不适合每个用例都 new 一次
    → 所以做成全局,只建一次
2.全局环境类
cpp
class ExchangeTest : public testing::Environment {注意继承的是 testing::Environment,不是 testing::Test。
这个区别是整份测试里最该理解的一点:
cpp
testing::Test          →  SetUp/TearDown 每个【用例】前后各调一次
testing::Environment   →  SetUp/TearDown 所有【用例】前后各调一次
选 Environment 的原因 :ExchangeManager 只需要建一次,三个测试共用。
SetUp
cpp
virtual void SetUp() override {
    emp = std::make_shared<bitmq::ExchangeManager>("./data/meta.db");
}
逐行解析:
cpp
virtual void SetUp() override
// virtual + override:明确"我在重写基类的虚函数"
//   virtual 可省(有 override 就够),但写上更清楚

    emp = std::make_shared<bitmq::ExchangeManager>("./data/meta.db");
    // 构造 ExchangeManager,内部连锁触发:
    //     建目录 ./data
    //     打开 ./data/meta.db
    //     建表 exchange_table
    //     recovery() 把已有数据读进内存
// 赋给全局的 emp这一步做完,emp 就是一个"可用且和数据库对齐"的对象。
TearDown
cpp
virtual void TearDown() override {
    emp->clear();
    std::cout << "最后的清理!! \n";
}
逐行解析:
cpp
    emp->clear();
    //  关键的一句
    // clear() 内部做三件事:
    //     _mapper.removeTable()   删表
    //     _mapper.createTable()   重建空表
    //     _exchanges.clear()      清内存
    // 效果:数据库和内存都回到干净状态

    std::cout << "最后的清理!! \n";
    // 打印一行,方便肉眼确认 TearDown 真的执行了
为什么 clear() 不能省
cpp
不清理的话:
    第一次跑完 → 数据留在 ./data/meta.db
    第二次跑 SetUp → recovery() 把旧数据读回来
        → 内存里已经有 exchange1、3、4(2 被 remove_test 删了)
        → insert_test 再声明一遍 → size 变成 7
        → ASSERT_EQ(size, 4u)   失败

清理之后:
    每次跑都是"空数据库起步" → 可以无限重复运行
这就是"集成测试的隔离" ------ 测试之间不能通过数据库串味。
类结束
};
// 定义完环境类3.第一个测试:insert_test
cpp
TEST(exchange_test, insert_test) {
//   ↑ 测试套名       ↑ 用例名
//   这两个只是"命名",决定了这条用例的全名:
//       exchange_test.insert_test
//   运行时可以按名字筛选:
//       ./mq_exchangetest --gtest_filter=exchange_test.insert_test
第 1 步:准备参数
cpp
    google::protobuf::Map<std::string, std::string> map;   // 改类型
    map["k1"] = "v1";
    map["k2"] = "v2";
逐行解析
cpp
    google::protobuf::Map<std::string, std::string> map;
    //  必须是这个类型,不能用 std::unordered_map
    //    因为 declareExchange 的参数就是 google::protobuf::Map
    //    两者之间【没有隐式转换】------ 这里踩过编译错误

    map["k1"] = "v1";
    map["k2"] = "v2";
    // 往 map 里塞两个键值对
    // 这两个值后面 select_test 会验证
第 2 步:声明四个交换机
cpp
    emp->declareExchange("exchange1", bitmq::ExchangeType::DIRECT, true, false, map);
    emp->declareExchange("exchange2", bitmq::ExchangeType::DIRECT, true, false, map);
    emp->declareExchange("exchange3", bitmq::ExchangeType::DIRECT, true, false, map);
    emp->declareExchange("exchange4", bitmq::ExchangeType::DIRECT, true, false, map);
四个参数的含义
cpp
第 1 个:交换机名字
第 2 个:类型 = DIRECT
第 3 个:durable = true      → 会写进数据库
第 4 个:auto_delete = false
第 5 个:args(带 k1、k2)每次调用内部会做:
cpp
加锁 → 查内存有没有 → 没有 → 造对象 → 落盘 → 入内存注意这里是"代码调用,不是测试断言" ------ 这四行是在"造测试数据",不是"验证"。
第 3 步:断言
    ASSERT_EQ(emp->size(), 4u);                            // 加 u,避免符号比较警告
}
逐行解析
cpp
    ASSERT_EQ(emp->size(), 4u);
    // 断言:内存里确实有 4 个交换机
    // ★ 4u 的 u 是"无符号"后缀
    //    size() 返回 size_t(无符号),4 是 int(有符号)
    //    混着比会有 -Wsign-compare 警告 → 加 u 让两边都是无符号

}
ASSERT_EQ 和 EXPECT_EQ 的区别(顺带记一下):
cpp
ASSERT_*  →  失败就【立即中止当前函数】,后面的代码不跑
EXPECT_*  →  失败也【继续往下跑】,跑完再汇总
这里用 ASSERT_EQ 是对的 ------ 如果这里就错了,后面两个测试也没意义。
4.第二个测试:select_test
cpp
TEST(exchange_test, select_test) {它依赖 insert_test 先跑过 ------ 因为要验证的是刚声明的那四个。
第 1 段:验证存在性
cpp
    ASSERT_EQ(emp->exists("exchange1"), true);
    ASSERT_EQ(emp->exists("exchange2"), true);
    ASSERT_EQ(emp->exists("exchange3"), true);
    ASSERT_EQ(emp->exists("exchange4"), true);
这四条验证 exists() 和 declareExchange 配合是否正常。
第 2 段:取出对象验证字段
cpp
    bitmq::Exchange::ptr exp = emp->selectExchange("exchange2");
    // 取出 exchange2 的智能指针

    ASSERT_NE(exp.get(), nullptr);
    // .get() 取原始指针,判空 → 说明确实取到了
    // 也可以写成 ASSERT_NE(exp, nullptr),GTest 支持 shared_ptr 比较

    ASSERT_EQ(exp->name, "exchange2");
    // 验证名字对

    ASSERT_EQ(exp->durable, true);
    ASSERT_EQ(exp->auto_delete, false);
    ASSERT_EQ(exp->type, bitmq::ExchangeType::DIRECT);
    // 逐个字段验证
cpp
它们验证的是"数据经过数据库一圈之后,字段有没有丢/串"
    → declareExchange 时落盘
    → 这次取出来的是【内存里的对象】

严格说,要真正验证"落盘是否正确",得重新构造一次(走 recovery)
    → 也就是补一个 recovery_test(见最后一节)
第 3 段:验证序列化/反序列化
cpp
    bitmq::Exchange tmp;
    tmp.setArgs(exp->getArgs());
    ASSERT_EQ(tmp.args["k1"], "v1");
    ASSERT_EQ(tmp.args["k2"], "v2");
}
逐行解析
cpp
    bitmq::Exchange tmp;
    // 造一个临时对象

    tmp.setArgs(exp->getArgs());
    //  把 exchange2 的 args 序列化成字符串,再用 setArgs 解析回另一个对象
    //    这是一次完整的"往返(round-trip)"

    ASSERT_EQ(tmp.args["k1"], "v1");
    ASSERT_EQ(tmp.args["k2"], "v2");
    // 按 key 取出来验证
为什么这个写法比"直接比对字符串"好
cpp
 错误写法:
    ASSERT_EQ(exp->getArgs(), std::string("k1=v1&k2=v2&"));

    问题:protobuf::Map 是【哈希表】,遍历顺序不保证
        → 可能是 "k1=v1&k2=v2&"
        → 也可能是 "k2=v2&k1=v1&"
        → 测试会时好时坏(不稳定测试)

 这个写法:
    解析回来按 key 取值
        → 和顺序无关
→ 而且顺带验证了"getArgs 拼的串,setArgs 能解回去"5.第三个测试:remove_test
cpp
TEST(exchange_test, remove_test) {
    emp->deleteExchange("exchange2");
    //  删掉 exchange2(它在前面被声明过)

    bitmq::Exchange::ptr exp = emp->selectExchange("exchange2");
    // 再取一次

    ASSERT_EQ(exp.get(), nullptr);
    // 取到空指针 → 说明内存里确实删掉了

    ASSERT_EQ(emp->exists("exchange2"), false);
    // 再确认一次"不存在"
}两处断言是有意冗余的:
cpp
selectExchange 返回空  →  说明"按名字取不到"
exists 返回 false      →  说明"存在性判断也是 false"

两者都验证,可以区分"是 selectExchange 有问题"还是"exists 有问题"
deleteExchange 内部做:
cpp
加锁 → 找到 → durable=true 所以删数据库 → 删内存6.main
cpp
int main(int argc,char *argv[])
{
    testing::InitGoogleTest(&argc, argv);
    // ① 初始化 GTest,解析命令行参数
    //    比如 --gtest_filter=xxx、--gtest_repeat=3 都是在这里被吃掉的

    testing::AddGlobalTestEnvironment(new ExchangeTest);
    // ②  注册全局环境
    //    注意:此刻只是"登记",SetUp 还没被调用
    //    GTest 接管这个对象的所有权(会自动 delete)

    return RUN_ALL_TESTS();                                // 加 return
    // ③  跑所有测试并返回结果
    //    返回 0 = 全过;返回 1 = 有失败
    //    必须 return 出去,否则测试失败时程序仍然返回 0 → CI 看不出失败
}
这里有个关键顺序
cpp
InitGoogleTest       先初始化
AddGlobalTestEnvironment   再登记环境
RUN_ALL_TESTS        最后才开始跑(此时才调 SetUp)
new ExchangeTest 为什么不用 delete:
cpp
AddGlobalTestEnvironment 会接管所有权
    → 程序结束时由 GTest 负责 delete
    → 你不需要手动 delete(也不能删,否则会 double free)
7.整体执行流程
cpp
程序启动
   │
   ▼
main()
   ├─ InitGoogleTest          解析参数
   ├─ AddGlobalTestEnvironment 登记环境(不执行)
   └─ RUN_ALL_TESTS()
          │
          ├─ ExchangeTest::SetUp()       只调一次
          │      emp = make_shared<ExchangeManager>("./data/meta.db")
          │          建目录 → 开库 → 建表 → recovery()
          │
          ├─ insert_test     造 4 个交换机(都带 k1/k2)→ 断言 size==4
          ├─ select_test     验证存在 → 验证字段 → 验证序列化往返
          ├─ remove_test     删掉 exchange2 → 断言查不到
          │
          └─ ExchangeTest::TearDown()    只调一次
                 emp->clear()          清库 + 清内存
                 cout << "最后的清理!!"


返回 RUN_ALL_TESTS() 的结果(0 / 1)
三个测试是"串联"的:
cpp
insert_test  造数据
    ↓ 依赖
select_test  验证数据
    ↓ 依赖
remove_test  删数据
8.补充的测试
现在的测试覆盖了"增、查、删"的内存部分,但没有覆盖"持久化"。
① recovery 测试(最关键)
思路:销毁再重建,相当于"服务器重启"。
cpp
TEST(exchange_test, recovery_test) {
    emp.reset();                                                    // 销毁
    emp = std::make_shared<bitmq::ExchangeManager>("./data/meta.db"); // 重建 → recovery()

    ASSERT_EQ(emp->exists("exchange1"), true);      // 持久化的还在
    ASSERT_EQ(emp->exists("exchange2"), false);     // 被删的没回来
}为什么必须补:
cpp
现在的断言只验证了"内存里对不对"
    → 如果 _mapper.insert() 是个空函数
    → 现在这 3 个测试【照样全过】
    → 但数据根本没落盘

加了 recovery_test:
    insert 没生效 → 重建后 exists 全 false → 失败
    remove 没生效 → exchange2 又回来了 → 失败
② 非持久化测试
cpp
TEST(exchange_test, not_durable_test) {
    // 声明一个 durable = false 的
    // 重建后 → 应该消失
}
验证的是 :if (durable == true) 那个判断有没有生效。
③ 幂等测试
cpp
TEST(exchange_test, duplicate_test) {
    size_t before = emp->size();
    emp->declareExchange("exchange1", ...);     // 重复声明已存在的
    ASSERT_EQ(emp->size(), before);             // size 不应变
}验证的是:"已存在就直接返回"那段逻辑。
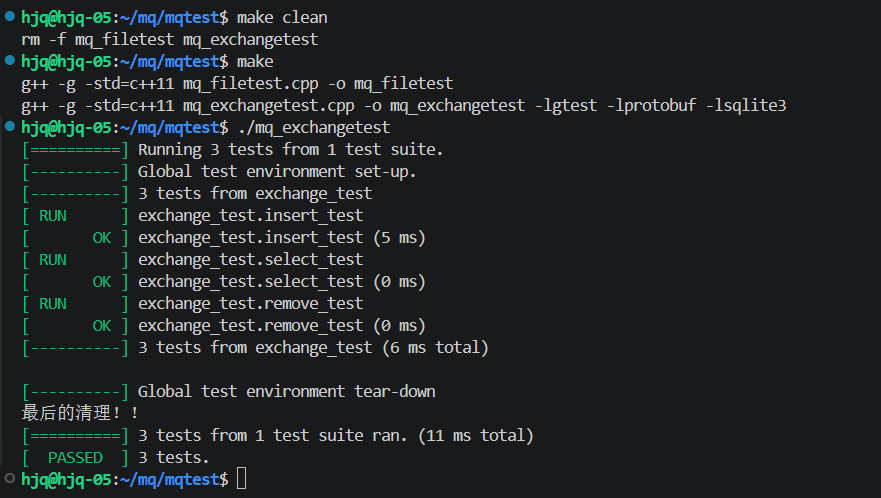
7.运行结果:
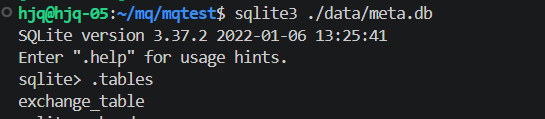
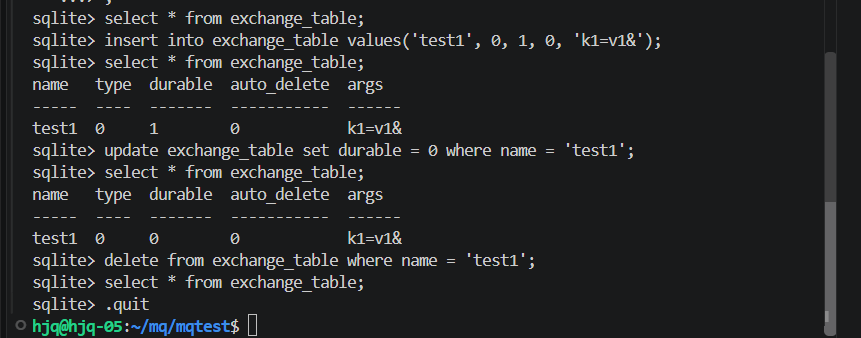
这就是一个完整的增删改查的内容了:
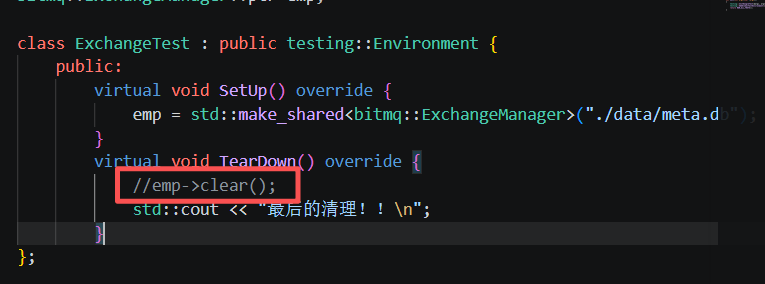
做这个关键的测试:
先注释这一行:
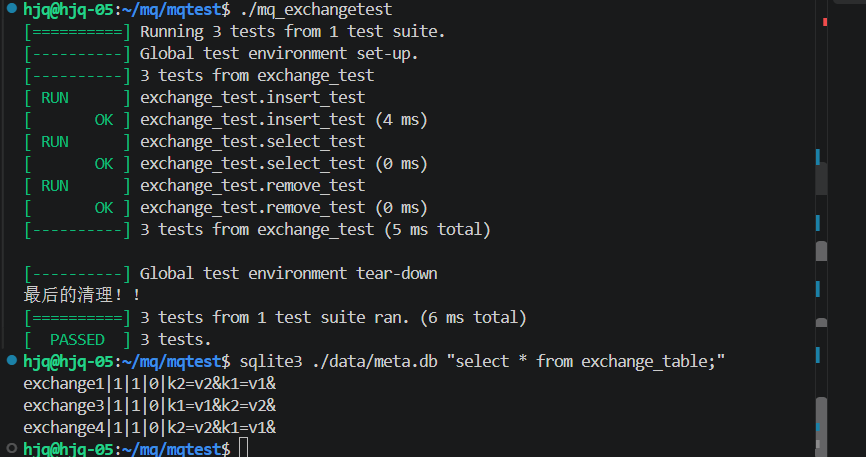
我们会发现:为什么是三个、而且没有 exchange2:
答案是:
insert_test 声明了 1、2、3、4 --> 数据库里 4 条
remove_test 删掉了 exchange2 --> 数据库里剩 3 条
这一步验证了两件事
cpp
① declareExchange 真的写了数据库(insert 生效)
② deleteExchange 真的删了数据库(remove 生效)
如果查出来是空的 --> 说明落盘逻辑没生效,需要回头查 insert。