先说结论:这场争论的焦点早就不是"要不要数字化",而是"在什么规模上,人工信息分发会先崩"。
两年前还有人反对给每场会配小程序,理由通常是没必要、浪费。现在争议小了,但理由换了。以前配小程序是为了让会议看起来有档次;现在配,是因为三件底层的东西同时变了:参会者的默认入口变了,要分发的信息结构变了,主办方的人力承接能力变了。这三条里任何一条过线,人工模式就开始掉链子。
下面不按功能清单讲,只沿着一条线拆:参会者想知道一件事的时候,他的请求走了哪条路径,这条路径在什么规模上会堵。说白了,这是一道查询路径的设计题。
一、入口迁移:从同步调用到本地读取
十年前参会,人不认识路会去问工作人员。现在人到现场,第一反应是掏手机。
查日程看手机,找座位看手机,问午餐在哪还是在手机上翻。手机翻不到,才会去问人。
这个变化的工程含义在于:"问人"是一次同步调用,会阻塞服务员这条线;"自己查"是本地读取,不占服务端资源。
参会者的预期已经默默从"会有人来告诉我"换成了"我自己能看到"。当他翻遍手机都找不到答案,最后走到签到台问你的时候,这个请求其实已经积压了一段时间,负面情绪也一并带了过来。
所以现在办会,要保证的不只是"信息发布出去了",而是"信息在手机上找得到"。这两句话看着很像,工程上完全不是一回事:前者是发一次广播,后者要求信息处在可检索、可达、可用的状态。
二、请求侧变了:信息维度上升,变更频率上升
以前的会,一本手册能讲清楚所有事。议程两天,一个主会场,日程表印在一页纸上就够。
现在的会不一样。多日、多场地、多分论坛,同一时间段可能有四场平行论坛同时开;嘉宾名单几十位,每位要写单位和职务;住宿分两家酒店,用餐分三个餐厅,车辆按批次接送。
从数据结构看,这是从"一页静态表格"变成了多张互相关联的表:议程表、嘉宾表、座位表、住宿表、车辆表、用餐表,彼此还要按人名和时间做关联。靠一本手册承载不了。
更难处理的是变更频率。议程改一条是常有的事,改厅、改时间、加环节,往往发生在会前最后一天。三种载体的版本一致性完全不在一个量级:
| 载体 | 本质 | 改一条的代价 |
|---|---|---|
| 纸质手册 | 一次性生成的静态快照 | 整批重印,周期以天计 |
| 群文件 | 多副本分发,无版本管理 | 旧副本收不回来,无法确认谁手里是新版 |
| 结构化线上入口 | 单一数据源,改完即生效 | 一次写入,所有端同时更新 |
三、服务侧变了:兼职团队加志愿者,容量本来就低
这一点最容易被忽略。
大部分单位办会的人不是专职做会务的。他可能做行政、做市场、或者在办公室,会务只是他手上的一件事,一年占用几天。会议期间他还有本职工作要处理。
一个兼职团队加上临时志愿者,要应付几百个人的重复提问。而被问得最多的那几类问题,其实一直是同一批:几点开始、我在哪个厅、午餐在哪、资料在哪下载、明天怎么坐车。
这些问题每一条都有答案,但答案长在某个人脑子里。从请求处理的角度看,这相当于每来一次请求就重新算一遍,既没有缓存,也没有副本。人连着被问八十遍之后,漏答和答错版本的情况就会陆续出现,结果开始漂移。
而这些被反复问的问题,绝大多数是确定性的、可以提前算好的。
四、三层结构:把"信息放在哪"这件事拆开
所以"配一个会务小程序",配的到底是什么?说清楚这个,比讲功能清单重要。按分层看,它提供的是三层:
接入层   常驻信息入口     日程 / 手册 / 座位 / 住宿 / 车辆 / 用餐 / 对接人
   |
服务层   自助查询         参会者查得到的,就不会来问
   |
数据层 单一数据源 改一处,所有端同时是新的- 接入层解决"在哪打开"。把信息收在一个随时能进的入口,不用一页页翻文件,也不用问人。
- 服务层解决"谁来应答"。把重复应答从人身上挪走,主办方省下来的不只是回消息的时间,是整个会期被反复打断的状态。
- 数据层解决"哪份是准的"。这一层最容易被低估,因为它不出现在功能清单上,但在高频变更的场景里它最值钱。
五、查询路径只有两类,AI 助理补的是第二类
这是本文的核心。参会者想找一样东西,路径无非两条。
路径 A:确定性导航。菜单、底部 tab、搜索框都属于这一类。它的本质是一台有限状态机,从首页出发走几步到目标页,路径是确定的。优点是响应快、成本低、结果可预期;缺点是要求用户自己知道该走哪条路,并且在设计阶段就得把入口穷举出来。
"资料在哪下载""日程在哪看"这类问题,路径 A 完全够用,点两下就到了。
路径 B:意图检索。有些问题没法靠菜单穷举。"我明天上午的会议和下午的会议之间有空档吗""从我的酒店过去要多久""我的座位是不是靠后,能不能换"。这几类问题有共同特征:条件组合多、约束隐含在自然语言里、答案要跨表算出来。菜单要么放不下,要么得设计成十几层的问答树,没人愿意走。
AI 助理补的就是路径 B:参会者用日常说法提问,系统在本场会议自己的知识库里完成意图识别和答案检索。
| 路径 A:确定性导航 | 路径 B:意图检索 | |
|---|---|---|
| 实现 | 菜单 / tab / 搜索框,有限状态机 | 意图识别 + 本场知识库检索 |
| 适用 | 入口固定的单点查询 | 条件组合多、约束隐含的查询 |
| 成本 | 低,一次配置长期可用 | 需要维护知识库,答案质量取决于库里的内容 |
| 边界 | 穷举不了的问题覆盖不到 | 库里没覆盖的问题答不准 |
这里要说清楚一句:不是所有会都需要路径 B。几十人的小会,把日程和座位放好,配几个预置问题就够用了。硬上一套问答,等于多养一个要维护的知识库,收益是负的。
六、降级设计:哪几类会不该上系统
光说"都要配"不实在。有几类会,一个微信群可能就够:
- 规模很小,几十个人,大部分互相认识
- 会期短,半天或一天,中间不变更
- 没有需要反复查询的信息,日程就一页纸
- 没有外部来宾,信息不对称小
这类会配一套系统,是给自己找活干。会务工具的价值随规模和复杂度上升,规模不到,价值就是负的:你要多花时间配置,参会者还要多下载一次。
七、按规模分层:配置矩阵
| 规模 | 建议配置 | 要解决的问题 |
|---|---|---|
| 小型会(几十到一两百人) | 一个入口,报名、签到、日程 | 人到了能签到,能知道几点开始 |
| 中型会(两三百到上千人) | 加个人参会中心和完整信息发布 | 参会者能自己查座位、住宿、用餐、乘车;主办方能实时改信息 |
| 大型会 / 多日会 / 涉外会(上千人,或多日多场地) | 再加 AI 助理、多语言支持、会期值守 | 信息一旦不同步,损失按千人计 |
分层的依据不是"功能越多越好",而是咨询量什么时候超过人力能顺畅承接的量。中型会是这条线开始被跨过去的区间。
八、自查清单:按查询路径来问
判断该不该配、配到哪一档,可以按下面六条自查:
- 把参会者最常问的十个问题列出来,有几个能被现有菜单穷举覆盖?
- 这十个问题里,有几个的答案要跨两张以上的表才能算出来?
- 会前会中最多改几次信息,改完之后到所有人拿到新版,中间隔多长时间?
- 上会期被重复问最多的三类问题,各被问过多少次,主要靠谁在答?
- 如果引入意图检索,这场会的知识库由谁来维护,答错了谁兜底?
- 会前一天临时改一个厅,现在走一遍通知链要多久?
第 6 条最直接。如果答案是两个小时以上、还得挨个打电话确认,那这件事就有工具能帮的空间。
九、附:一个可以对照的架构样本
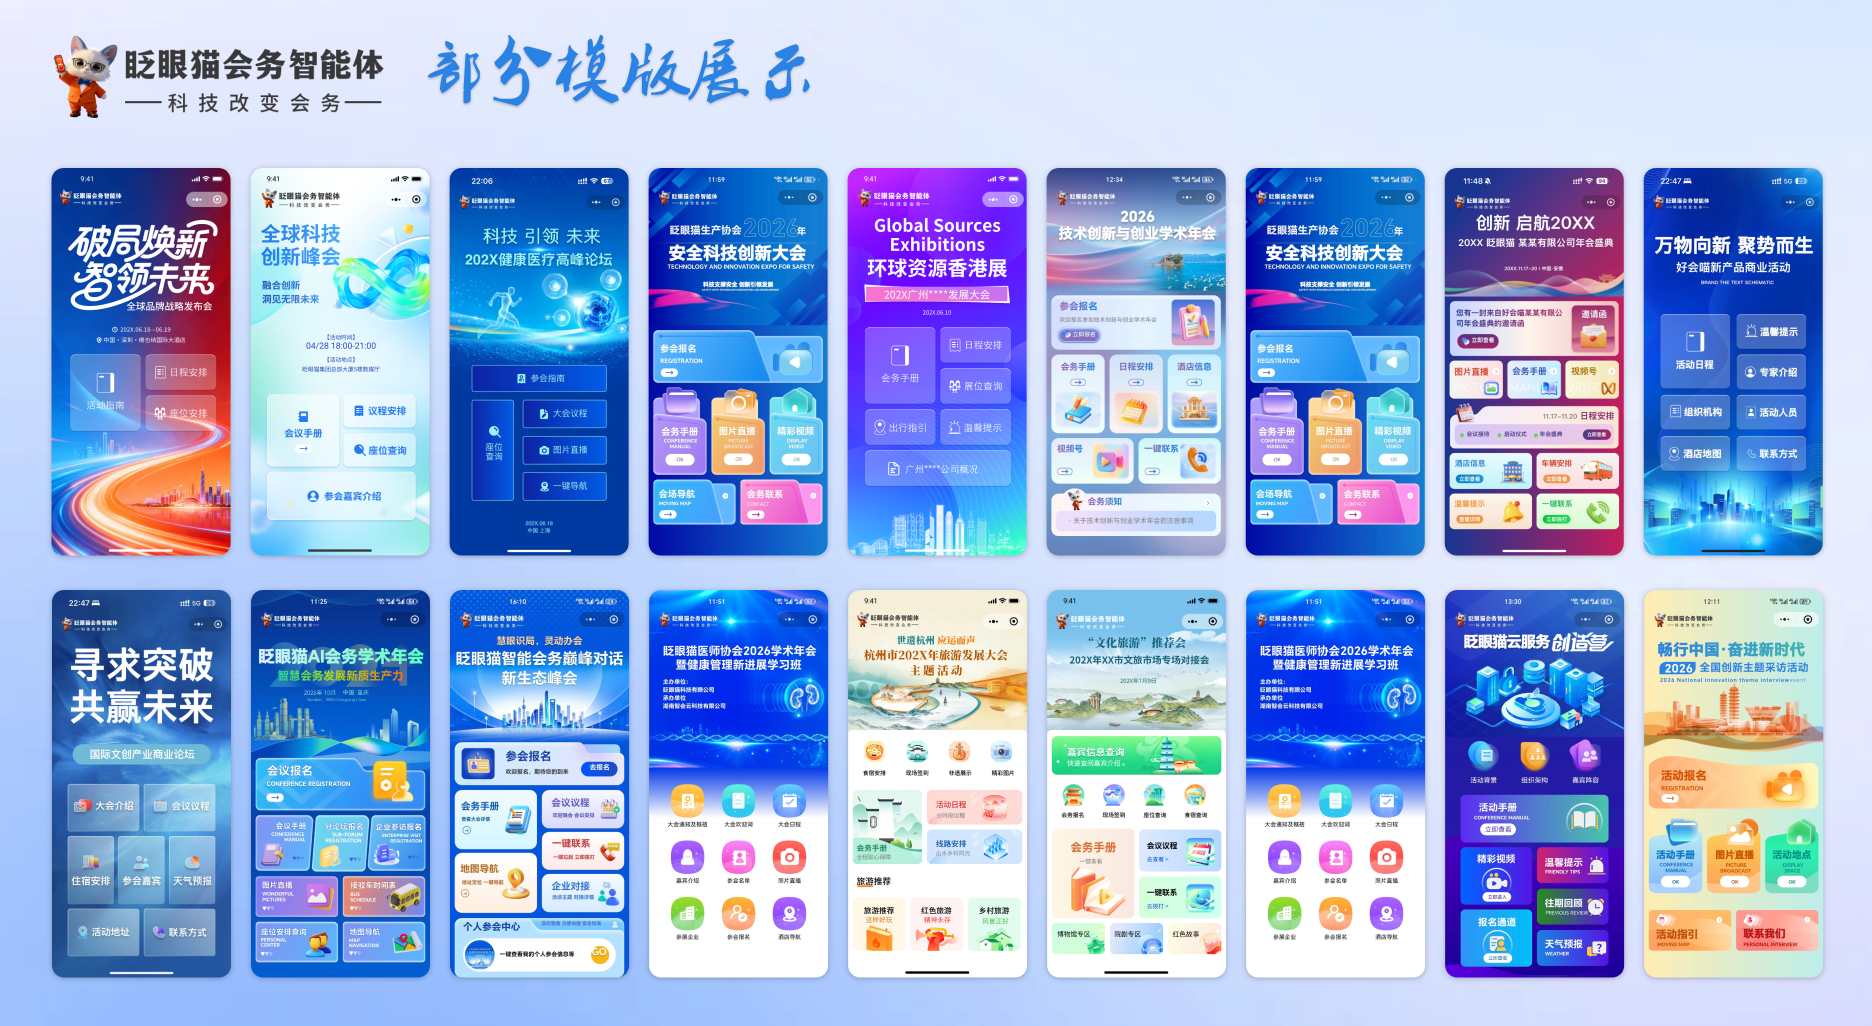
市面上有一款叫眨眼猫会务智能体的产品,分层和上面这套对得上。它把会务前中后二十多个模块收在一个小程序入口里,报名签到、会务信息发布、个人参会中心、座位车辆住宿查询、资料下载、调查问卷、图片和视频直播共用同一个数据源,后台改完即时生效,常规更新不走反复审核。第五点说的路径 B 它也有,叫智会助理,24 小时在线,靠本场会议自己的知识库加通用大模型来答。档位按规模分:探索版 59 元起、模块按需付费、可以先试用;标准版 998 元,按需求搭好交付、带一对一培训;大型重要会议有全程托管的服务档。
本文无实测数据背书,不构成采购建议。