26年10月来自港大、星尘智能(Astribot)和南方科技大学的论文"MobiAgent: Dual-Loop Recursive Policy Self- Improvement for Long-Horizon Mobile Manipulation"。
MobiAgent 最有价值的地方,是把"长任务中的纠错"与"执行经验再训练"连成闭环。它说明了:在移动操作中,除了提高单个动作策略的能力,还需要判断动作是否真正完成、失败后是否应改变步骤,以及如何把部署数据转化为下一轮训练数据。
如图 1 所示MobiAgent概述:
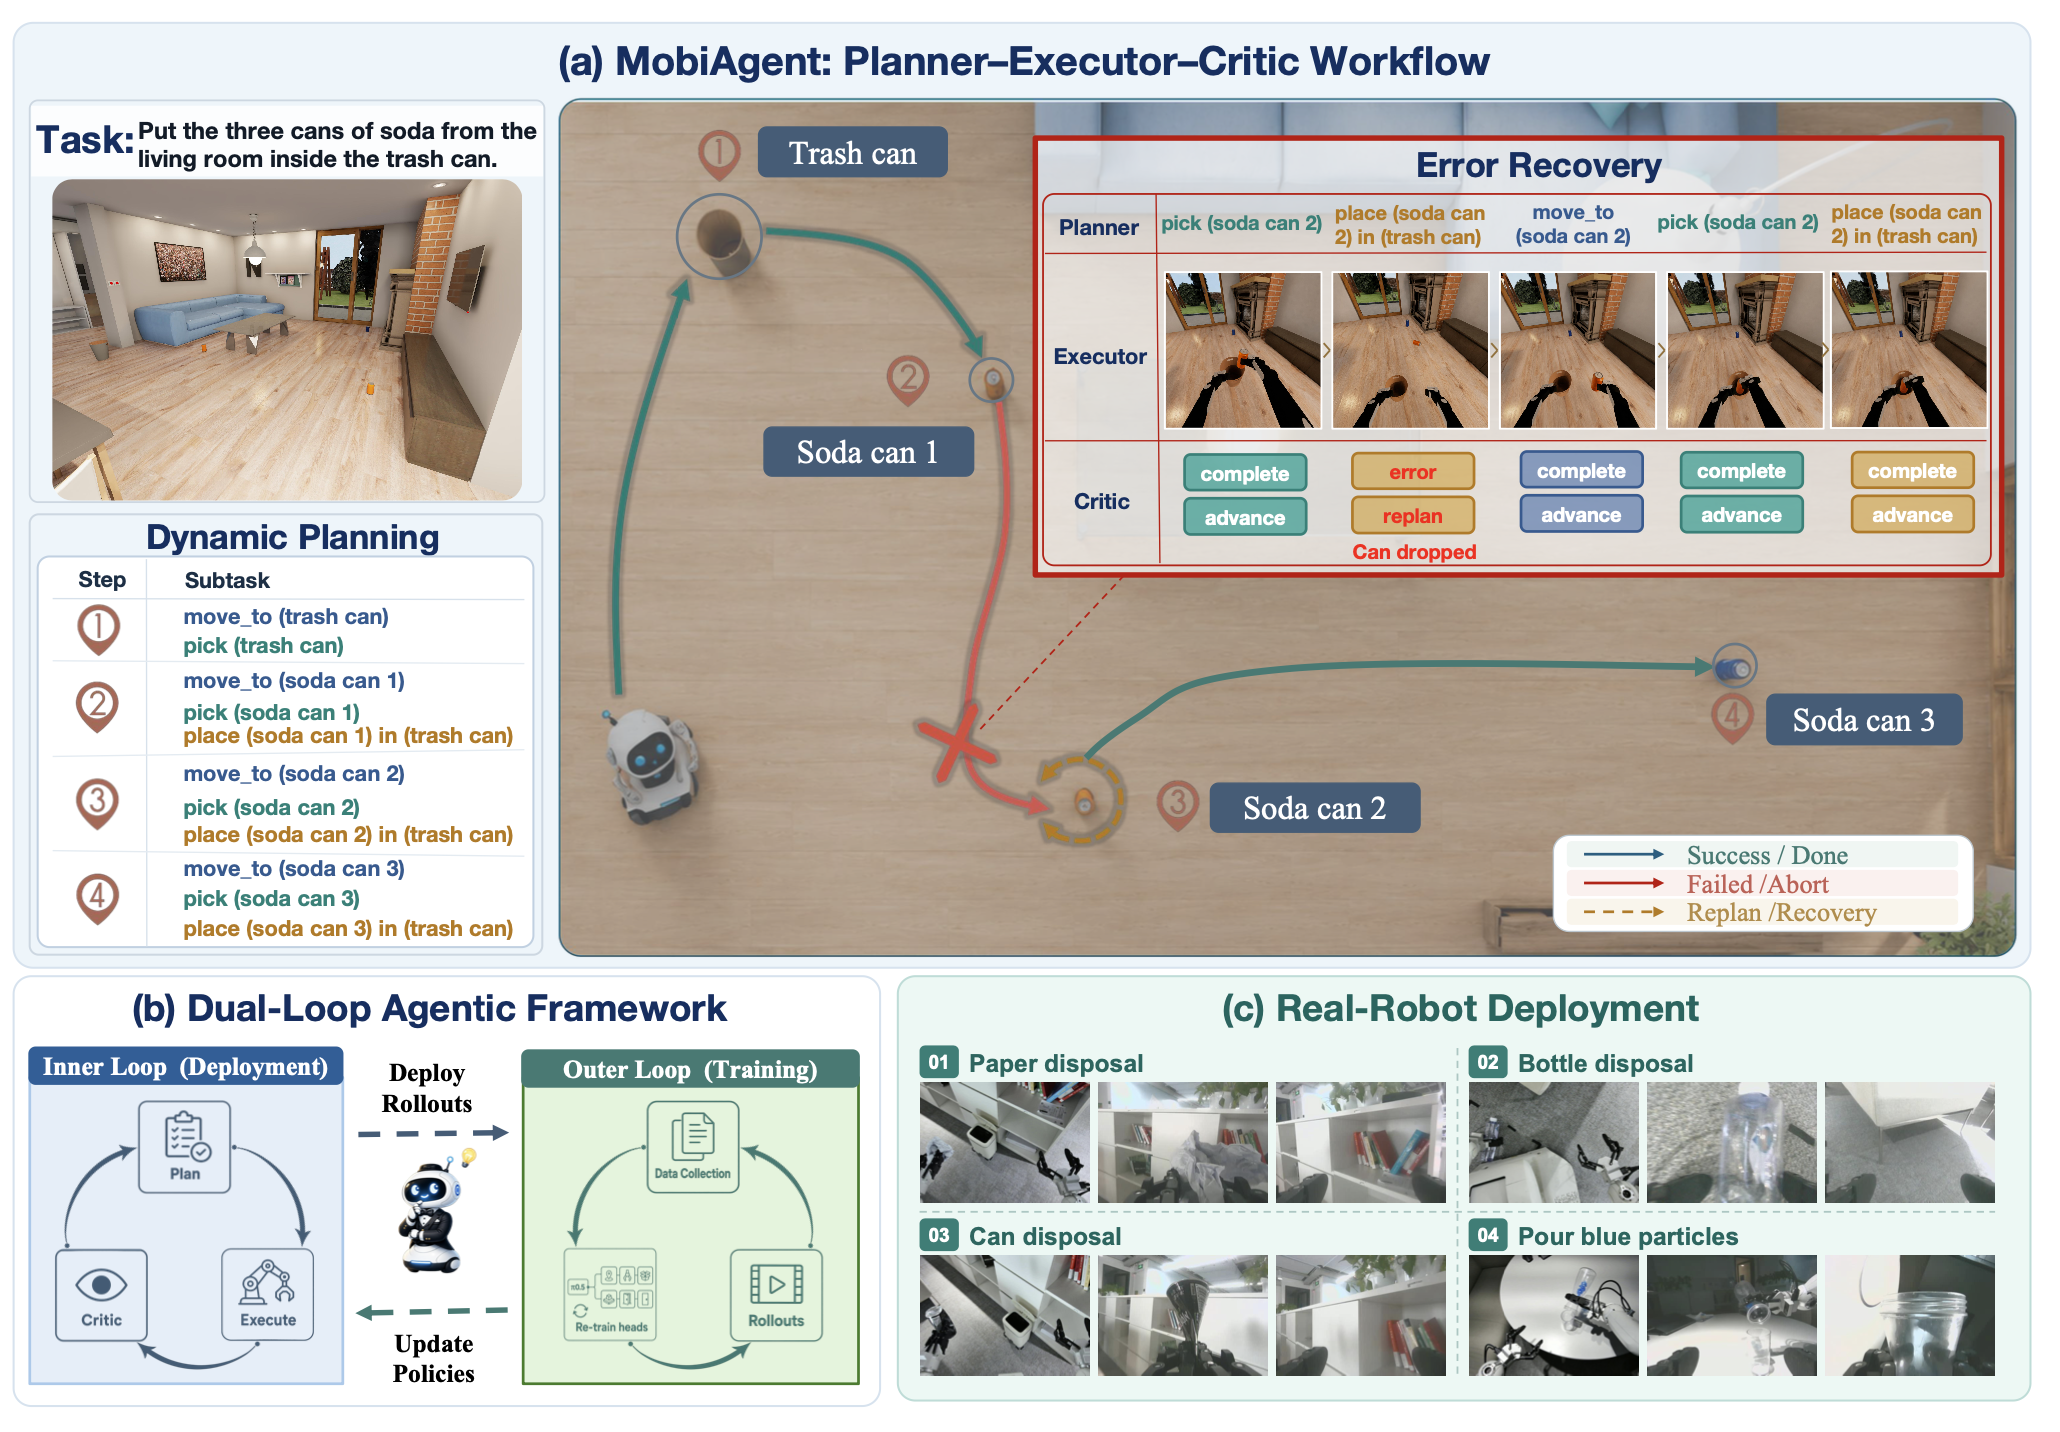
但论文的证据更适合支持"固定技能库上的闭环执行与迭代改进",还不足以证明开放式技能发现或长期自主进化。
一、方法要点:用两个时间尺度解决两个问题
论文针对长时程移动操作的三个瓶颈:
- 错误累积:导航偏一点、抓取姿态差一点,后续放置就可能失败。
- 不同动作之间的学习干扰:底盘移动和精细操作的控制规律不同,共用动作头可能互相影响。
- 部署经验无法沉淀:系统执行失败后,即使重新规划成功,底层策略也未必因此变好。
MobiAgent 的对应方案是:
| 层次 | 核心机制 | 解决的问题 |
|---|---|---|
| 内循环:部署时 | 规划 → 技能执行 → 结果检查 → 继续或重规划 | 如何完成当前任务 |
| 外循环:离线训练时 | 轨迹分段 → 验证与归类 → 技能策略微调 | 如何改善以后的执行 |
例如,机器人把罐子扔到垃圾桶外:内循环先发现放置失败,再安排"重新靠近---重新抓取---重新放置";外循环则处理部署轨迹,将可用片段加入训练。
这里的"递归自改进",具体是部署---数据整理---离线微调---再次部署,不是执行过程中实时更新模型参数。
二、模型框架:高层语义推理,低层技能专门化
如图 2 所示MobiAgent框架:
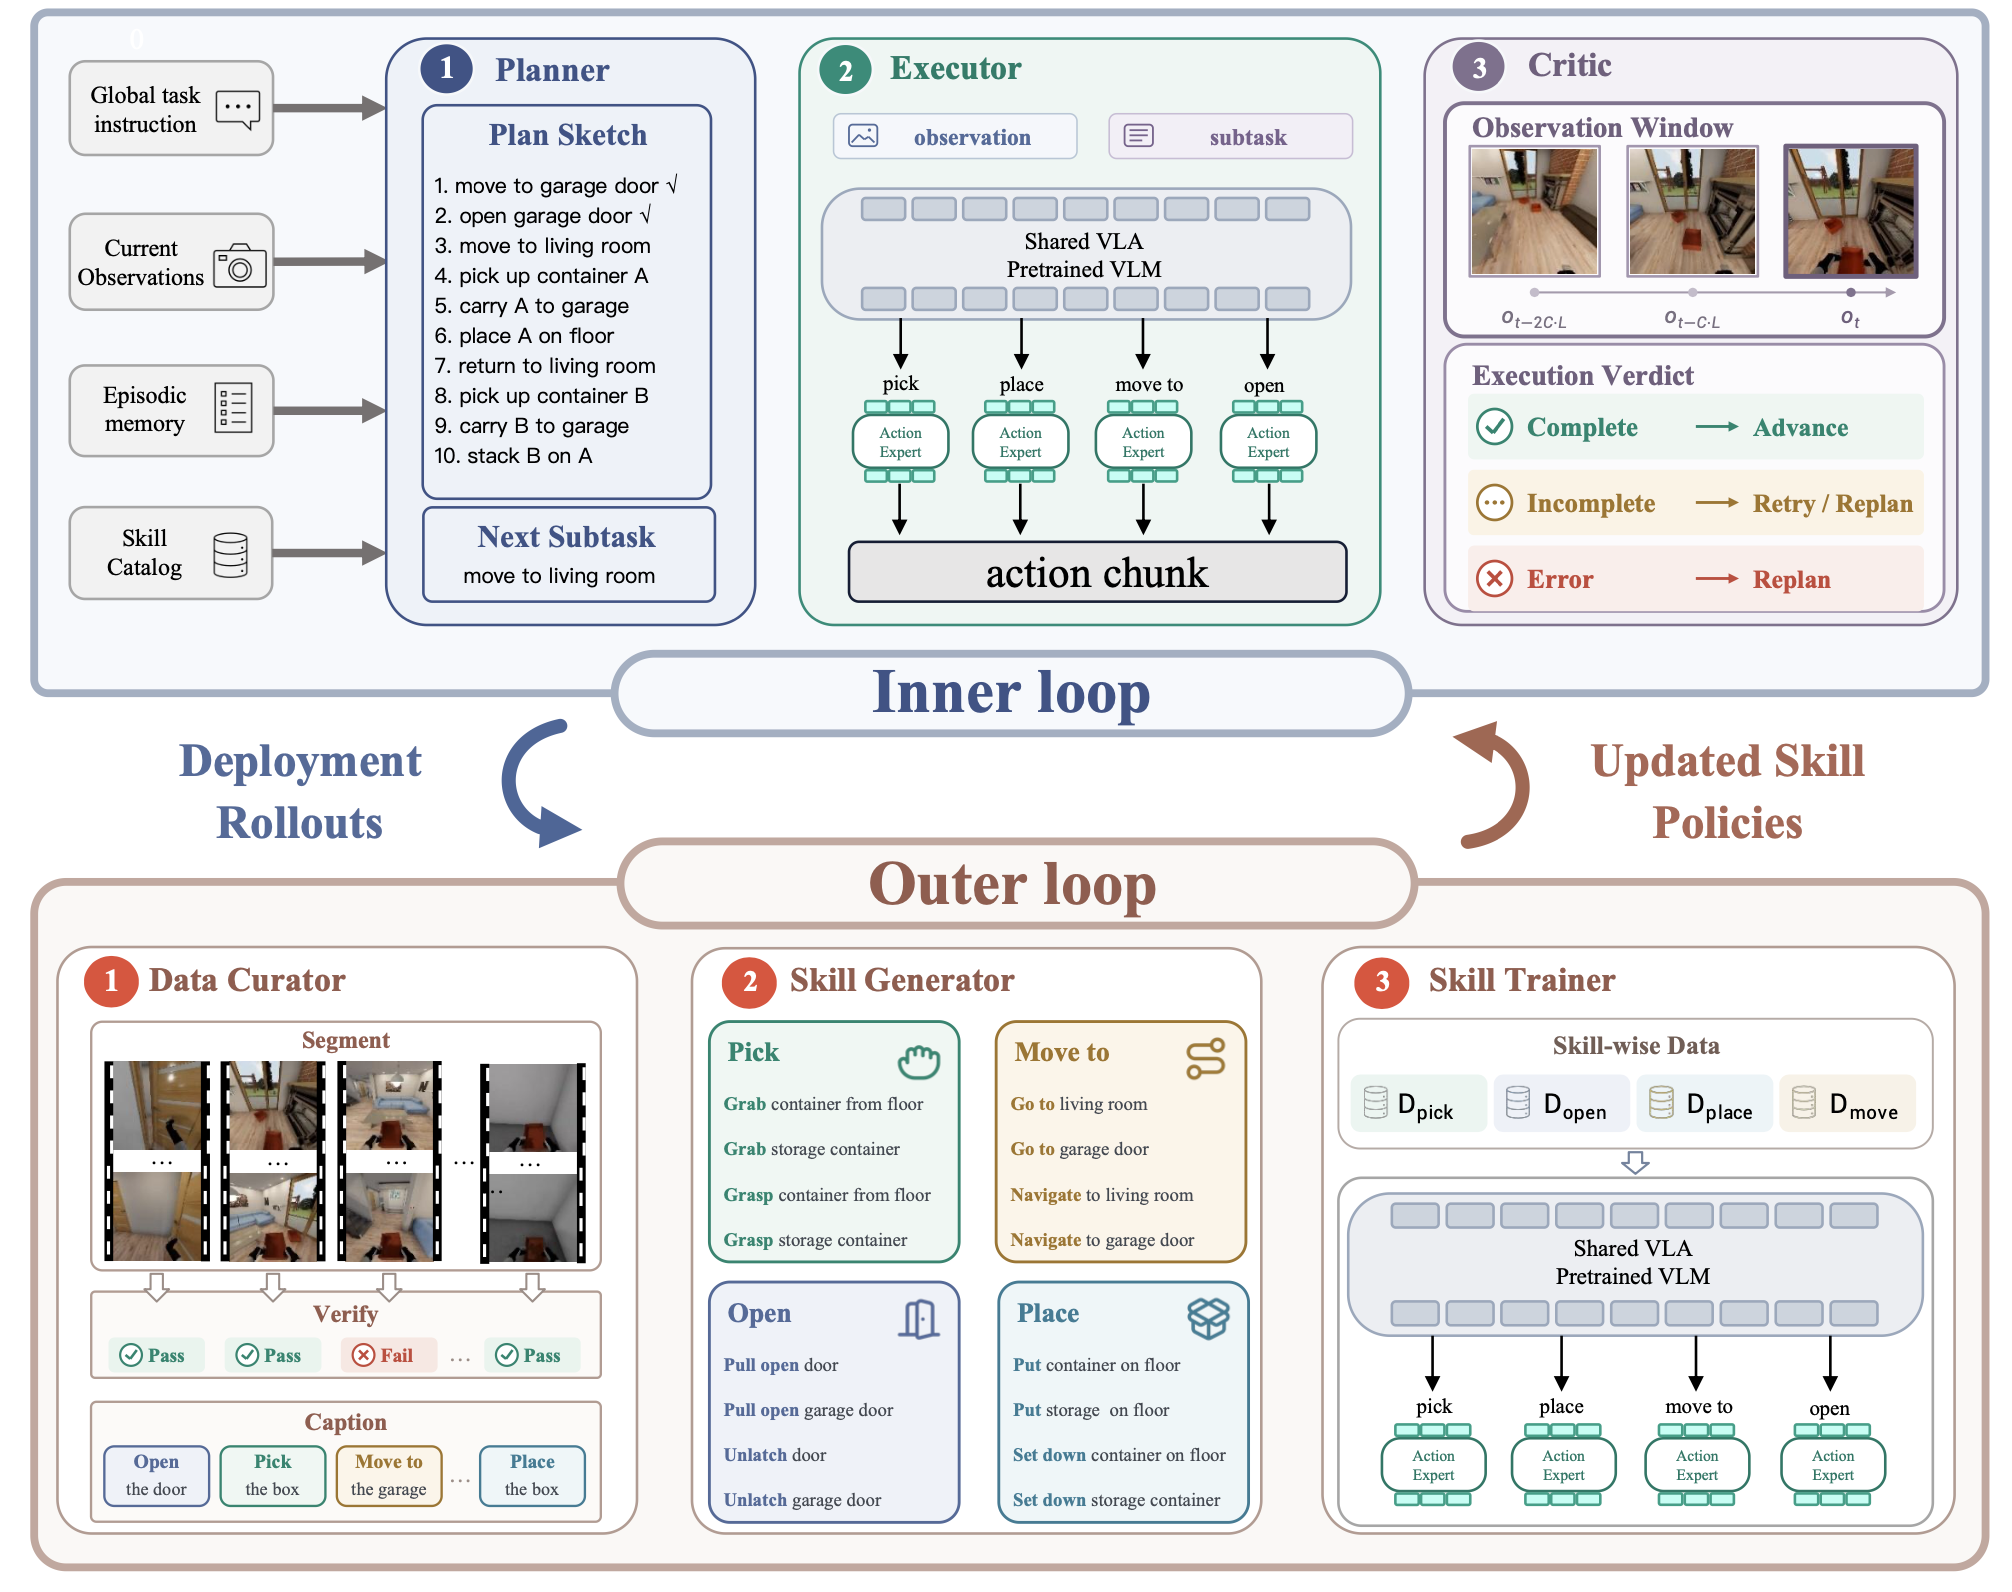
整体结构可以概括为:
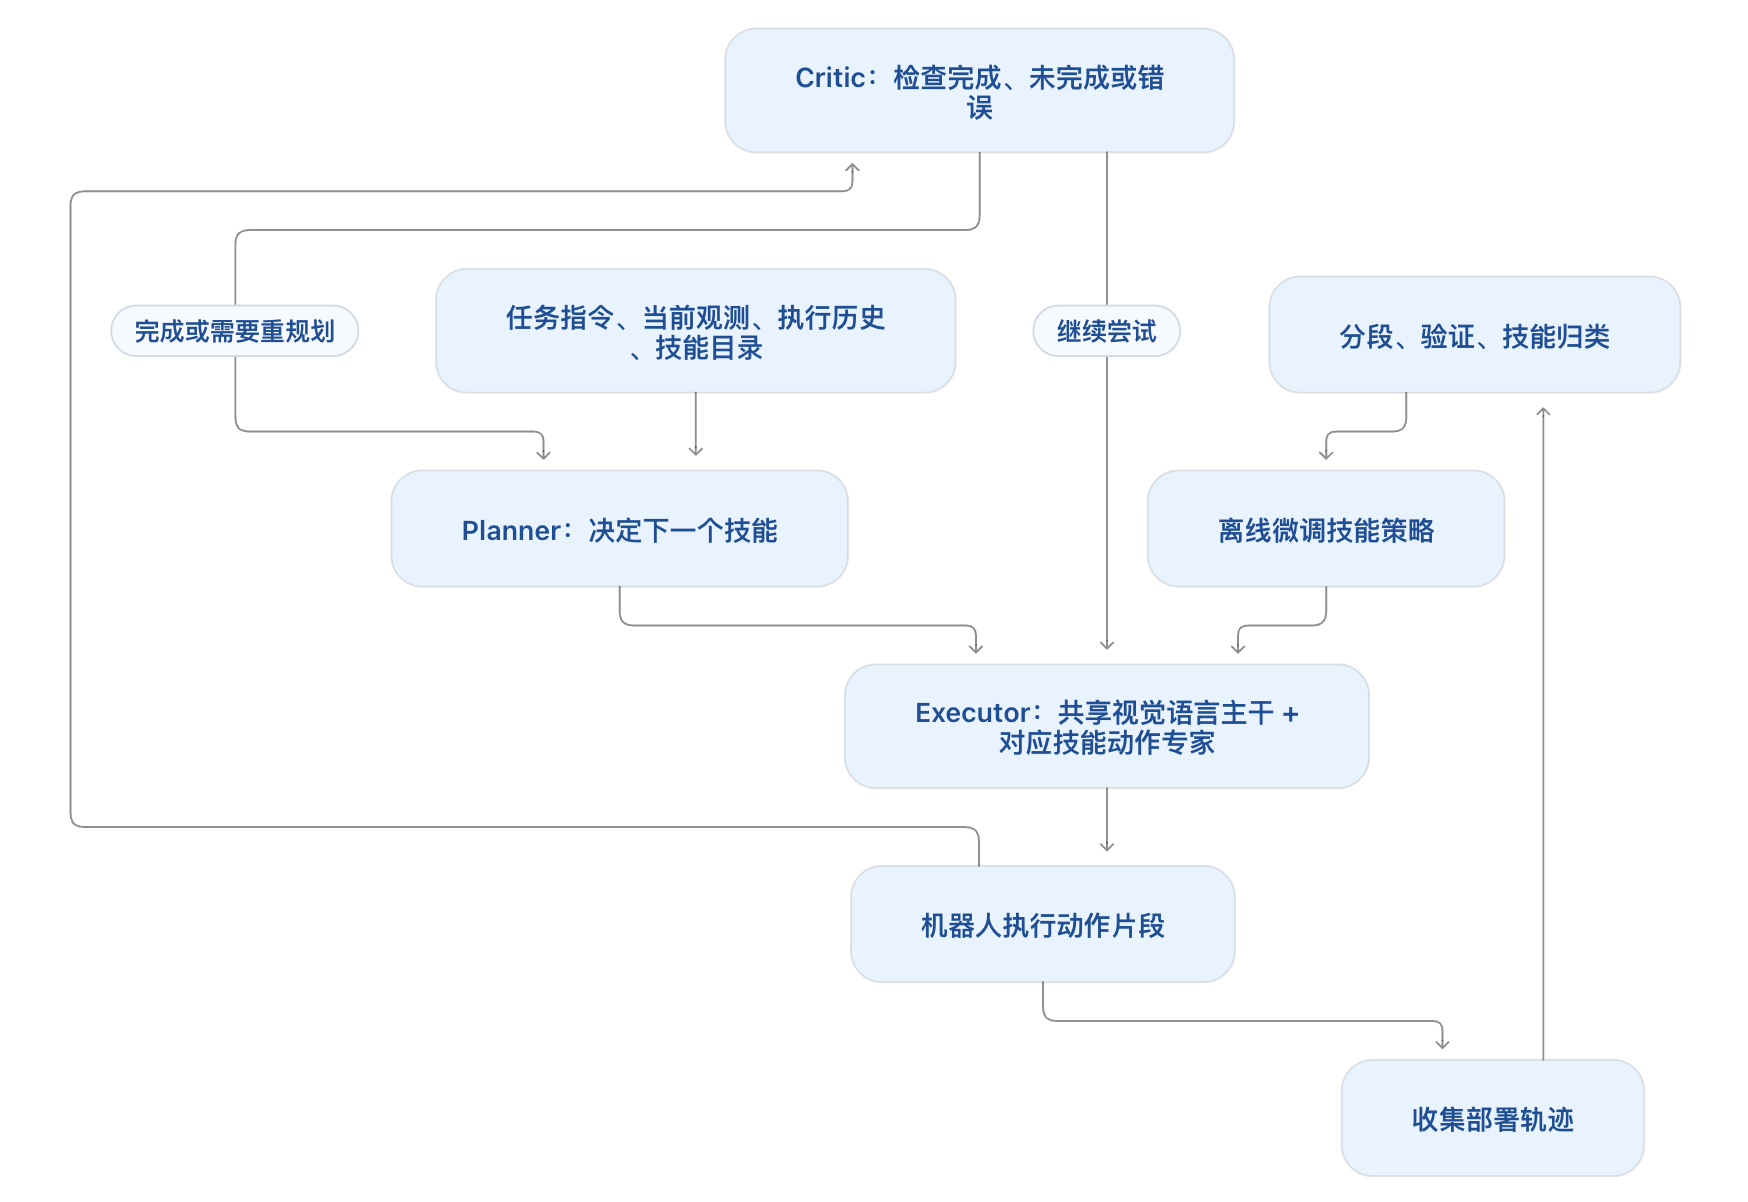
1. Planner:滚动规划,而非一次性执行完整计划。
它根据全局目标、当前多视角观测、历史执行结果和技能目录,输出下一条子任务及技能标识:
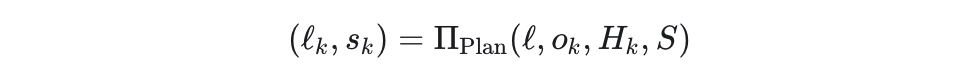 例如,子任务是"抓取红色罐子",技能标识是
pick。即使生成完整计划草稿,也只执行当前第一步;技能完成或失败后,再根据最新状态规划。
因此,它的灵活性来自已有技能的动态组合。自然语言目标可以变化,但可执行行为仍受技能目录约束。
2. Executor:共享主干,每类技能使用独立动作专家。
执行器基于 π₀.₅:
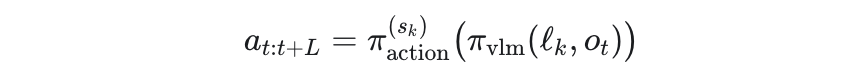
附录给出的结构是共享 PaliGemma/Gemma 2B 主干,各技能配备约 300M 的动作专家,通过 flow matching 生成连续动作片段。
这里共享的是执行器内部各技能的视觉语言主干,不是 Planner、Critic 与执行器共用一个模型。论文中 Planner、Critic 等使用 GPT-5.4,视频分段使用 Gemini-3.1-Pro。
这种设计兼顾了视觉语义知识复用和动作专门化,但只能说缓解干扰:共享主干仍可能存在跨技能干扰,专家数量增加也会增加参数与维护成本。
3. Critic:检查当前技能是否真正完成。
Critic 周期性读取近期观测窗口;附录提示词还使用夹爪开度、底盘和末端运动等本体信息。它输出:
complete:结束当前技能,交回 Planner;incomplete:继续尝试,或请求重规划;error:重规划。
一个确定性的控制器负责执行这些决定,并限制重试次数。因此,所谓"连续反思"实际是周期性检查,并非每个控制时刻都进行高层推理。
4. 外循环:自动整理数据,再做行为克隆。
启动阶段,系统从已有示范中分段、描述和聚类,建立技能目录与动作专家;后续阶段,新轨迹被归入已有技能,用于微调现有策略。
因此,"无需人工标注"主要指轨迹整理流程自动化。真实机器人仍使用每项任务 100 条人工遥操作示范启动,也不是不依赖示范的强化学习。
三、贡献:哪些实验真正支持了它?
| 实验 | 论文报告的结果 | 可以支持的结论 |
|---|---|---|
| BEHAVIOR-1K,选取4项任务 | π₀.₅-TA:42.5%;MobiAgent:65.0% | 技能共享与闭环编排在这些任务上有效 |
| RoboCasa,16项任务 | 基础 π₀.₅:7.50%;R1:18.75%;R3:27.50%;R6:26.25% | 部署数据回收有收益,但较快进入平台期 |
| Astribot S1,4项任务 | π₀.₅:10.0%;MobiAgent 启动轮:32.5%;两轮更新后:57.5% | 框架改造和后续数据更新都带来提升 |
有以下三点。
第一,恢复动作可以通过已有技能重新组合出来。
物体掉落后,仅重复"放置"无效,必须先重新靠近和抓取。移除全局重规划后,成功率从 65.0% 降至 40.0%,说明它确实超越了局部重试。
第二,动作专家专门化具有实证价值。
保持 Planner、Critic 和训练数据不变,改用单一动作头后成功率降至 42.5%。这支持按技能分离动作建模,但还不能完全排除参数容量差异的影响。
第三,展示了实际可运行的部署数据回收流程。
真实机器人从 32.5% 提高到 57.5%,比仅展示一个概念性的"终身学习框架"更扎实。
总体上,其贡献主要在系统架构、模块接口和学习流程的整合;论文没有提出新的基础视觉语言模型或新的 flow-matching 原理。
四、主要问题:能力边界与证据缺口
1. "开放式自我进化"的表述强于实际验证。
第3.2节明确说明:后续 rollout 绕过重新聚类和命名,直接匹配已有技能,训练时不扩展模型目录。
因此,它证明的是既有技能的迭代改进,没有证明:
- 系统能自主发现此前没有的动作能力;
- 能学会新技能而不遗忘旧技能;
- 能在长期开放环境中持续提升。
此外,RoboCasa 后期在 25%---27.5% 波动,说明当前外循环没有突破持续增长的瓶颈。
2. 自动验证的正文描述与附录实现存在重要差距。
正文将 Data Curator 的验证描述为检查片段、边界和行为实现情况;但附录 A.4 明确规定,验证器只看文本分段,不观看录像。
这意味着它可以检查"描述是否合理、顺序是否连贯",却不能独立确认"视频中的动作是否真的发生、时间边界是否准确"。视频分段器的错误可能以合理文本的形式通过验证,再进入训练。
这不是说整个外循环不使用视觉,而是它缺少一个独立的、直接基于视频的验收环节。
3. 原子技能完成,不等于下一技能能够接续。
这是最值得深入研究的问题。
论文附录给出例子:机器人成功抓住罐子,但手臂停在抬高、偏转的位置,下一步放置策略无法处理。Critic 只判断"抓到了",没有判断"当前状态是否适合放入桶中"。
换言之:
当前技能成功 /=》 下一技能可执行
自然语言层面的技能可组合,不代表控制状态层面的技能可组合。
4. Critic 是核心增益来源,也成为新的失效点。
去掉 Critic,成功率降至 10.0%,显示它非常重要;但附录也记录了遮挡、距离误判和过早宣布完成等问题。
需要注意,这个消融同时影响技能终止判断,因此不能将全部增益都归因于高层"反思推理"。更严谨的比较应加入学习式终止分类器、几何判据等替代方案。
5. 评估规模和消融设计不足以支撑很强的泛化结论。
- BEHAVIOR-1K 主实验只有4项任务,每项10次;不能理解为覆盖了整个1K任务集。
- Astribot S1 主实验同样每项10次;一次成败就改变该任务10个百分点。
- "去掉 Planner"同时取消了动态规划和跨任务技能共享,无法单独测出规划贡献。
- 外循环缺少等量新增数据、等训练步数的对照,难以分离"更多数据"和"自动整理机制"的收益。
- 多种机器人上的分别训练与验证,不等于跨机器人直接迁移。
6. 成功率提升伴随明显的运行开销。
附录表 S8 中,成功轨迹的运行时间约为 π₀.₅-TA 的 2.8---3.0倍。例如取啤酒任务由 538 秒增至 1556 秒,其中 API 时间为792秒。
所以当前结果更接近"花更多时间换取更高成功率"。后续应同时报告单位时间完成任务数、每次成功的总成本,并纳入失败轨迹的开销。
五、下一步工作:优先做什么,以及怎样验证
下面是研究建议:
| 优先方向 | 具体方法 | 最关键的验证 |
|---|---|---|
| 技能衔接感知 | 给技能增加可启动状态与结束状态约束;策略额外条件化下一技能;必要时插入重定位或姿态调整 | 在不同上游结束姿态下,测量技能对接续成功率 |
| 可信的结果验证 | 融合视频、深度、接触和本体信息;输出不确定性;模糊时主动换视角 | 测量误报完成率、漏报率及遮挡条件下的恢复能力 |
| 真正利用失败数据 | 从失败任务中保留成功片段;识别失败原因;定向采集恢复轨迹 | 固定交互预算,与仅使用成功轨迹的训练比较 |
| 持续扩展技能库 | 检测已有技能无法解释的新行为,再新增专家或适配器;配合旧数据回放 | 同时报告新技能学习速度和旧技能遗忘程度 |
| 降低高层推理成本 | 蒸馏本地 Critic,采用事件触发检查,减少冗余调用 | 绘制成功率---延迟---费用曲线,而非只报成功率 |
| 更严格的泛化评估 | 保留未见任务组合、物体、布局和扰动;匹配数据与计算预算 | 区分任务内提升、组合泛化与跨环境迁移 |
如果只选择一个方向,我优先推荐"面向下一技能的终止判断与衔接学习"。
可以把当前的单技能判断扩展为两个独立问题:
当前目标是否完成_{任务完成} 当前状态能否启动下一技能_{接续可行}
例如,抓取已经成功,但放置尚不可行时,系统保留"已抓取"的进展,只执行姿态调整。训练时同时覆盖不同起始姿态,并让抓取策略考虑下一步放置需求。
这个方向直接对应论文记录的失败模式,实验范围可控,也能把"可组合技能"从语言接口推进到物理执行层面的可组合性。