摘要 :前八篇把 Agent 系统的骨架搭完了------模式、引擎、协议、中间件。但它们都基于同一个执行模型:请求来了就开始干,干完就结束 。这在批处理场景够用,在真实业务里会遇到三类问题:上游不知道下游什么时候有空、Agent 做完某件事后没人知道该做什么、失败的重试逻辑散落在各处。事件驱动架构把"主动轮询"改成"事件触发",Agent 从"被调用者"变成"事件响应者"。本文讲清三件事:事件设计 (什么样的事件值得发布,什么不该)、消费语义 (at-least-once 下的幂等,这是分布式系统最经典的陷阱)、顺序与因果(事件总线的最大优势是天然带因果链,最容易犯的错是假设顺序)。并对照 CloudEvents 1.0 规范说明标准事件信封的设计,以及 actor 模型与 Agent 的结构同构。
📌 版本声明 :本文基于 Python 3.11+、asyncio 编写,撰写时间 2026 年 10 月。核心实现零第三方依赖,可直接运行。对照章节涉及 CloudEvents 1.0 (CNCF 规范,2024 年 1 月毕业为毕业项目):必需属性为
id/source/specversion/type,可选属性含time/subject/datacontenttype/dataschema,事件类型采用反向 DNS + 版本后缀 命名(如com.example.order.completed.v1)。各消息中间件的 CloudEvents 绑定细节与支持程度不一,接入前请核对所用产品的官方文档。适用边界 :适用于需要异步解耦、支持多消费者、需要失败重放或审计追溯 的系统。若你的场景是"用户点一下、Agent 同步返回一个结果",事件驱动是纯粹的复杂度增加------同步调用没有错,能用就别上事件总线。
文章目录
-
- 一、为什么需要事件驱动:从"我问你答"到"有事通知"
-
- [1.1 同步调用的三个天花板](#1.1 同步调用的三个天花板)
- [1.2 同步与事件的本质差异](#1.2 同步与事件的本质差异)
- [1.3 Actor 模型与 Agent 的同构](#1.3 Actor 模型与 Agent 的同构)
- [1.4 什么时候不该用事件驱动](#1.4 什么时候不该用事件驱动)
- 二、事件驱动核心概念:专门章节
-
- [2.1 事件的定义:什么值得发布,什么不该](#2.1 事件的定义:什么值得发布,什么不该)
- [2.2 CloudEvents 1.0:标准事件信封](#2.2 CloudEvents 1.0:标准事件信封)
- [2.3 消费语义:at-least-once 与幂等](#2.3 消费语义:at-least-once 与幂等)
- [2.4 顺序与因果:总线给的最大礼物](#2.4 顺序与因果:总线给的最大礼物)
- [2.5 轻量方案:不一定需要 Kafka](#2.5 轻量方案:不一定需要 Kafka)
- 三、环境准备
-
- [3.1 环境与依赖](#3.1 环境与依赖)
- [3.2 本文案例:内容发布流水线的事件化改造](#3.2 本文案例:内容发布流水线的事件化改造)
- 四、核心实战:实现事件总线与消费者
-
- [4.1 第一步:定义事件模型(CloudEvents 风格)](#4.1 第一步:定义事件模型(CloudEvents 风格))
- [4.2 第二步:实现事件总线](#4.2 第二步:实现事件总线)
- [4.3 第三步:幂等消费者](#4.3 第三步:幂等消费者)
- [4.4 第四步:跑通改造后的流水线](#4.4 第四步:跑通改造后的流水线)
- 五、进阶:事件驱动的生产化
-
- [5.1 重试与死信的三层设计](#5.1 重试与死信的三层设计)
- [5.2 事件回放:从"能审计"到"能重演"](#5.2 事件回放:从"能审计"到"能重演")
- [5.3 Schema 演进与事件契约](#5.3 Schema 演进与事件契约)
- [5.4 观测:事件驱动的六个必备指标](#5.4 观测:事件驱动的六个必备指标)
- [六、对照:CloudEvents 与消息中间件选型](#六、对照:CloudEvents 与消息中间件选型)
-
- [6.1 CloudEvents 的成本与收益](#6.1 CloudEvents 的成本与收益)
- [6.2 消息中间件选型](#6.2 消息中间件选型)
- [6.3 三种架构的对比](#6.3 三种架构的对比)
- [七、适用边界与风险提示 ⚠️](#七、适用边界与风险提示 ⚠️)
-
- [7.1 事件驱动适合什么](#7.1 事件驱动适合什么)
- [7.2 事件驱动不适合什么](#7.2 事件驱动不适合什么)
- [7.3 六个典型陷阱](#7.3 六个典型陷阱)
- [7.4 实践纪律](#7.4 实践纪律)
- 八、进阶:让事件链路可测
- 九、总结
- 参考资料
一、为什么需要事件驱动:从"我问你答"到"有事通知"
1.1 同步调用的三个天花板
前面八篇的所有实现都有一个共同特征:同步调用 。Agent A 需要 Agent B 的结果,就直接 await B()。
这个模型在 Demo 里很好,但遇到下面三种情况就会撞墙。
天花板一:下游忙,上游只能干等
一个典型的场景:内容发布系统有三个环节------内容审核(调用 LLM,约 30 秒)、敏感词扫描(约 100 毫秒)、版权检查(调用外部 API,约 5 秒)。
同步调用下,总耗时是三者之和 = 约 35 秒 。但仔细想:敏感词扫描只用了 0.1 秒,它完全可以和内容审核并行。为什么不能?------因为同步编排里,编排器必须等第一个环节返回才知道该不该走下一个(第 22 篇的 Pipeline 语义)。
天花板二:一个事件,多个下游
同一份内容审核结果,需要:
- 触发敏感词扫描 Agent
- 更新内容库的审核状态
- 通知作者(通过邮件)
- 写审计日志
- 触发风控评估
同步写就是五个 await。问题不只是麻烦,而是每加一个下游就要改一次调用链代码。
天花板三:失败了只能从头重试
审核 Agent 处理到第 4 分钟崩溃了,同步调用只能整个请求重跑------包括前面已经成功的 3 个环节。
这三条天花板指向同一个解法:把"调用"改成"发事件"。
1.2 同步与事件的本质差异
Agent C Agent B Agent A 上游 Agent C Agent B Agent A 上游 #mermaid-svg-z1pUgKRbOdICRbUS{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-z1pUgKRbOdICRbUS .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-z1pUgKRbOdICRbUS .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-z1pUgKRbOdICRbUS .error-icon{fill:#552222;}#mermaid-svg-z1pUgKRbOdICRbUS .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-z1pUgKRbOdICRbUS .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-z1pUgKRbOdICRbUS .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-z1pUgKRbOdICRbUS .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-z1pUgKRbOdICRbUS .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-z1pUgKRbOdICRbUS .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-z1pUgKRbOdICRbUS .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-z1pUgKRbOdICRbUS .marker{fill:#333333;stroke:#333333;}#mermaid-svg-z1pUgKRbOdICRbUS .marker.cross{stroke:#333333;}#mermaid-svg-z1pUgKRbOdICRbUS svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-z1pUgKRbOdICRbUS p{margin:0;}#mermaid-svg-z1pUgKRbOdICRbUS .actor{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-z1pUgKRbOdICRbUS text.actor>tspan{fill:black;stroke:none;}#mermaid-svg-z1pUgKRbOdICRbUS .actor-line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-z1pUgKRbOdICRbUS .innerArc{stroke-width:1.5;stroke-dasharray:none;}#mermaid-svg-z1pUgKRbOdICRbUS .messageLine0{stroke-width:1.5;stroke-dasharray:none;stroke:#333;}#mermaid-svg-z1pUgKRbOdICRbUS .messageLine1{stroke-width:1.5;stroke-dasharray:2,2;stroke:#333;}#mermaid-svg-z1pUgKRbOdICRbUS #arrowhead path{fill:#333;stroke:#333;}#mermaid-svg-z1pUgKRbOdICRbUS .sequenceNumber{fill:white;}#mermaid-svg-z1pUgKRbOdICRbUS #sequencenumber{fill:#333;}#mermaid-svg-z1pUgKRbOdICRbUS #crosshead path{fill:#333;stroke:#333;}#mermaid-svg-z1pUgKRbOdICRbUS .messageText{fill:#333;stroke:none;}#mermaid-svg-z1pUgKRbOdICRbUS .labelBox{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-z1pUgKRbOdICRbUS .labelText,#mermaid-svg-z1pUgKRbOdICRbUS .labelText>tspan{fill:black;stroke:none;}#mermaid-svg-z1pUgKRbOdICRbUS .loopText,#mermaid-svg-z1pUgKRbOdICRbUS .loopText>tspan{fill:black;stroke:none;}#mermaid-svg-z1pUgKRbOdICRbUS .loopLine{stroke-width:2px;stroke-dasharray:2,2;stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-z1pUgKRbOdICRbUS .note{stroke:#aaaa33;fill:#fff5ad;}#mermaid-svg-z1pUgKRbOdICRbUS .noteText,#mermaid-svg-z1pUgKRbOdICRbUS .noteText>tspan{fill:black;stroke:none;}#mermaid-svg-z1pUgKRbOdICRbUS .activation0{fill:#f4f4f4;stroke:#666;}#mermaid-svg-z1pUgKRbOdICRbUS .activation1{fill:#f4f4f4;stroke:#666;}#mermaid-svg-z1pUgKRbOdICRbUS .activation2{fill:#f4f4f4;stroke:#666;}#mermaid-svg-z1pUgKRbOdICRbUS .actorPopupMenu{position:absolute;}#mermaid-svg-z1pUgKRbOdICRbUS .actorPopupMenuPanel{position:absolute;fill:#ECECFF;box-shadow:0px 8px 16px 0px rgba(0,0,0,0.2);filter:drop-shadow(3px 5px 2px rgb(0 0 0 / 0.4));}#mermaid-svg-z1pUgKRbOdICRbUS .actor-man line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-z1pUgKRbOdICRbUS .actor-man circle,#mermaid-svg-z1pUgKRbOdICRbUS line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;stroke-width:2px;}#mermaid-svg-z1pUgKRbOdICRbUS :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 同步调用 · 时间耦合且空间耦合 编排器必须等每一步返回 任何一环慢,全链路都等 请求处理 调用 B 返回结果 调用 C 返回结果 返回
换成事件驱动后,协作拓扑变成这样:
#mermaid-svg-5dP2EXBOdsFI3fs9{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-5dP2EXBOdsFI3fs9 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-5dP2EXBOdsFI3fs9 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-5dP2EXBOdsFI3fs9 .error-icon{fill:#552222;}#mermaid-svg-5dP2EXBOdsFI3fs9 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-5dP2EXBOdsFI3fs9 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-5dP2EXBOdsFI3fs9 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-5dP2EXBOdsFI3fs9 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-5dP2EXBOdsFI3fs9 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-5dP2EXBOdsFI3fs9 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-5dP2EXBOdsFI3fs9 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-5dP2EXBOdsFI3fs9 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-5dP2EXBOdsFI3fs9 .marker.cross{stroke:#333333;}#mermaid-svg-5dP2EXBOdsFI3fs9 svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-5dP2EXBOdsFI3fs9 p{margin:0;}#mermaid-svg-5dP2EXBOdsFI3fs9 .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-5dP2EXBOdsFI3fs9 .cluster-label text{fill:#333;}#mermaid-svg-5dP2EXBOdsFI3fs9 .cluster-label span{color:#333;}#mermaid-svg-5dP2EXBOdsFI3fs9 .cluster-label span p{background-color:transparent;}#mermaid-svg-5dP2EXBOdsFI3fs9 .label text,#mermaid-svg-5dP2EXBOdsFI3fs9 span{fill:#333;color:#333;}#mermaid-svg-5dP2EXBOdsFI3fs9 .node rect,#mermaid-svg-5dP2EXBOdsFI3fs9 .node circle,#mermaid-svg-5dP2EXBOdsFI3fs9 .node ellipse,#mermaid-svg-5dP2EXBOdsFI3fs9 .node polygon,#mermaid-svg-5dP2EXBOdsFI3fs9 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-5dP2EXBOdsFI3fs9 .rough-node .label text,#mermaid-svg-5dP2EXBOdsFI3fs9 .node .label text,#mermaid-svg-5dP2EXBOdsFI3fs9 .image-shape .label,#mermaid-svg-5dP2EXBOdsFI3fs9 .icon-shape .label{text-anchor:middle;}#mermaid-svg-5dP2EXBOdsFI3fs9 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-5dP2EXBOdsFI3fs9 .rough-node .label,#mermaid-svg-5dP2EXBOdsFI3fs9 .node .label,#mermaid-svg-5dP2EXBOdsFI3fs9 .image-shape .label,#mermaid-svg-5dP2EXBOdsFI3fs9 .icon-shape .label{text-align:center;}#mermaid-svg-5dP2EXBOdsFI3fs9 .node.clickable{cursor:pointer;}#mermaid-svg-5dP2EXBOdsFI3fs9 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-5dP2EXBOdsFI3fs9 .arrowheadPath{fill:#333333;}#mermaid-svg-5dP2EXBOdsFI3fs9 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-5dP2EXBOdsFI3fs9 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-5dP2EXBOdsFI3fs9 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-5dP2EXBOdsFI3fs9 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-5dP2EXBOdsFI3fs9 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-5dP2EXBOdsFI3fs9 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-5dP2EXBOdsFI3fs9 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-5dP2EXBOdsFI3fs9 .cluster text{fill:#333;}#mermaid-svg-5dP2EXBOdsFI3fs9 .cluster span{color:#333;}#mermaid-svg-5dP2EXBOdsFI3fs9 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-5dP2EXBOdsFI3fs9 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-5dP2EXBOdsFI3fs9 rect.text{fill:none;stroke-width:0;}#mermaid-svg-5dP2EXBOdsFI3fs9 .icon-shape,#mermaid-svg-5dP2EXBOdsFI3fs9 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-5dP2EXBOdsFI3fs9 .icon-shape p,#mermaid-svg-5dP2EXBOdsFI3fs9 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-5dP2EXBOdsFI3fs9 .icon-shape .label rect,#mermaid-svg-5dP2EXBOdsFI3fs9 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-5dP2EXBOdsFI3fs9 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-5dP2EXBOdsFI3fs9 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-5dP2EXBOdsFI3fs9 :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 请求处理
发布
content.audited
立即返回
不必等后续
发布 scan.completed
发布 notification.sent
上游
CMS 前端
Agent A
内容审核
事件总线
持久化 · 保序
Agent B
敏感词扫描
Agent C
通知作者
Agent D
审计留痕
三处关键变化(对照上图):
| 维度 | 同步调用 | 事件驱动 |
|---|---|---|
| 时间耦合 | 上游必须等下游 | 发布完就返回,下游什么时候处理都行 |
| 空间耦合 | 上游知道下游的地址 | 上下游互不知道对方存在 |
| 失败影响 | 一个失败,整条链受影响 | 各自重试,互不牵连 |
💡 "空间解耦"是事件驱动最容易被低估的价值。 它意味着新增一个下游消费者不需要改任何现有代码 ------这不只是省事,更是架构上的自由:你可以随时接入一个新系统(日志、风控、通知)而不惊动任何现有组件。
1.3 Actor 模型与 Agent 的同构
这不是巧合。Agent 的行为特征与 Actor 模型几乎逐项对应:
| Actor 特征 | Agent 对应 |
|---|---|
| 接收消息 | 接收工具调用结果、用户输入、MCP 事件 |
| 维护私有状态 | 上下文窗口、记忆存储、任务队列 |
| 发送消息 | 发起工具调用、派生子 Agent、发布事件 |
| 生成子 Actor | 派生子任务给专业 Agent |
| 被监督 | 编排器检测失败、重试或升级 |
这个视角带来一个直接的架构启示:Actor 系统里成熟的模式(邮箱、监管、重启、持久化),几乎都能平移到 Agent 架构上。 本篇后面讲的持久化事件日志、消费语义,本质就是 Actor 的"邮箱与持久化邮箱"。
1.4 什么时候不该用事件驱动
| 情况 | 为什么不该 | 更好的做法 |
|---|---|---|
| 用户同步等待结果 | 事件驱动反而增加延迟(要等轮询或推送) | 同步调用 |
| 链路只有 2 环且都很快 | 事件总线的开销超过收益 | 同步调用 |
| 需要立即拿到结果做下一步判断 | 事件是异步的,拿不到结果 | 同步调用 |
| 团队没人懂消息中间件 | 运维成本高,排查难度陡增 | 同步 + 队列(第 29 篇后半的轻量方案) |
判断标准 :如果你的流程里没有任何一处"我不需要等它完成,我只需要知道它发生了",那事件驱动对你没有价值。
二、事件驱动核心概念:专门章节
2.1 事件的定义:什么值得发布,什么不该
最常见的设计错误是把事件当成"被调用的另一种写法"。这样的事件没有价值,只是给同步调用套了个信封。
真正的设计问题:什么信息值得作为一个可持久化的事实被记录?
| 值得发布 | 不该发布 |
|---|---|
| 已经发生的事实(订单已支付) | 未发生的意图(我打算处理订单) |
| 有意图的最终结论(判定为高危) | 中间推理过程(我正在考虑三种可能) |
| 状态转移(工单从待处理变为处理中) | 每次心跳、每次轮询 |
| 需要被多方知晓的事 | 只对本方有意义的数据 |
| 出错且需要人介入(置信度过低转人工) | 可自动恢复的错误(下次重试即可) |
⚠️ 中间推理过程不要发布成事件 ,除非你真的需要重放它们。理由有二:一是事件总线会被大量低价值事件淹没;二是中间过程含不确定性,重放时得到的结果可能与当初不同,反而破坏了审计价值。
2.2 CloudEvents 1.0:标准事件信封
第 27 篇讲过 Agent 通信协议的自研信封。而事件总线有个额外需求:同一份事件要能跨不同的消息中间件传输(Kafka、NATS、SQS、EventBridge 各有自己的消息格式)。
CloudEvents 1.0 解决的正是这个问题:传输层无关的事件信封。
json
{
  "specversion": "1.0",
  "type": "com.example.content.audited.v1",
  "source": "/content-review/service",
  "id": "evt-9f3a2c8e1b",
  "time": "2026-10-08T11:30:00Z",
  "subject": "content/ART-2026-0812",
  "datacontenttype": "application/json",
  "dataschema": "https://schemas.example.com/audited-v1.json",
  "data": {
    "content_id": "ART-2026-0812",
    "verdict": "approved",
    "risk_score": 0.18,
    "reviewer_agent": "content-auditor-02"
  }
}必需属性只有四个,其余都是可选:
| 属性 | 必填 | 作用 | Agent 场景的意义 |
|---|---|---|---|
specversion |
✅ | 信封版本 | 跨版本兼容的基础 |
type |
✅ | 事件类型 | 反向 DNS + 版本后缀 ,如 com.example.content.audited.v1 |
source |
✅ | 事件来源 | 谁发的------不填就无法追溯,实践中最常被漏 |
id |
✅ | 事件唯一 ID | 幂等去重的依据 |
time |
⬜ | 发生时间 | 仅用于观测,不可用于因果判断(见 2.4) |
subject |
⬜ | 关联实体 | 让总线能按实体路由 |
datacontenttype |
⬜ | 载荷类型 | 结构化载荷的标准声明 |
dataschema |
⬜ | 载荷 Schema | 数据演进的可控基础 |
两个命名约定值得强调:
① type 用反向 DNS + 版本后缀。 com.example.content.audited.v1------这个命名保证了全局唯一 (不同组织不会撞名),且版本号在类型名里,类型升级时旧消费者能靠版本过滤继续工作。
② source 绝不能漏。 事故排查时最常问的第一个问题是"这条事件是谁发的",source 缺失会让整条链路无法追溯。
③ 载荷里不要放大对象。 这是个高频踩坑:把整个 LLM 上下文塞进 data,结果事件总线被撑爆(一条消息几十 MB),消费者解析时内存飙升。正确做法是载荷里放引用 ID,真实内容放对象存储或向量库。
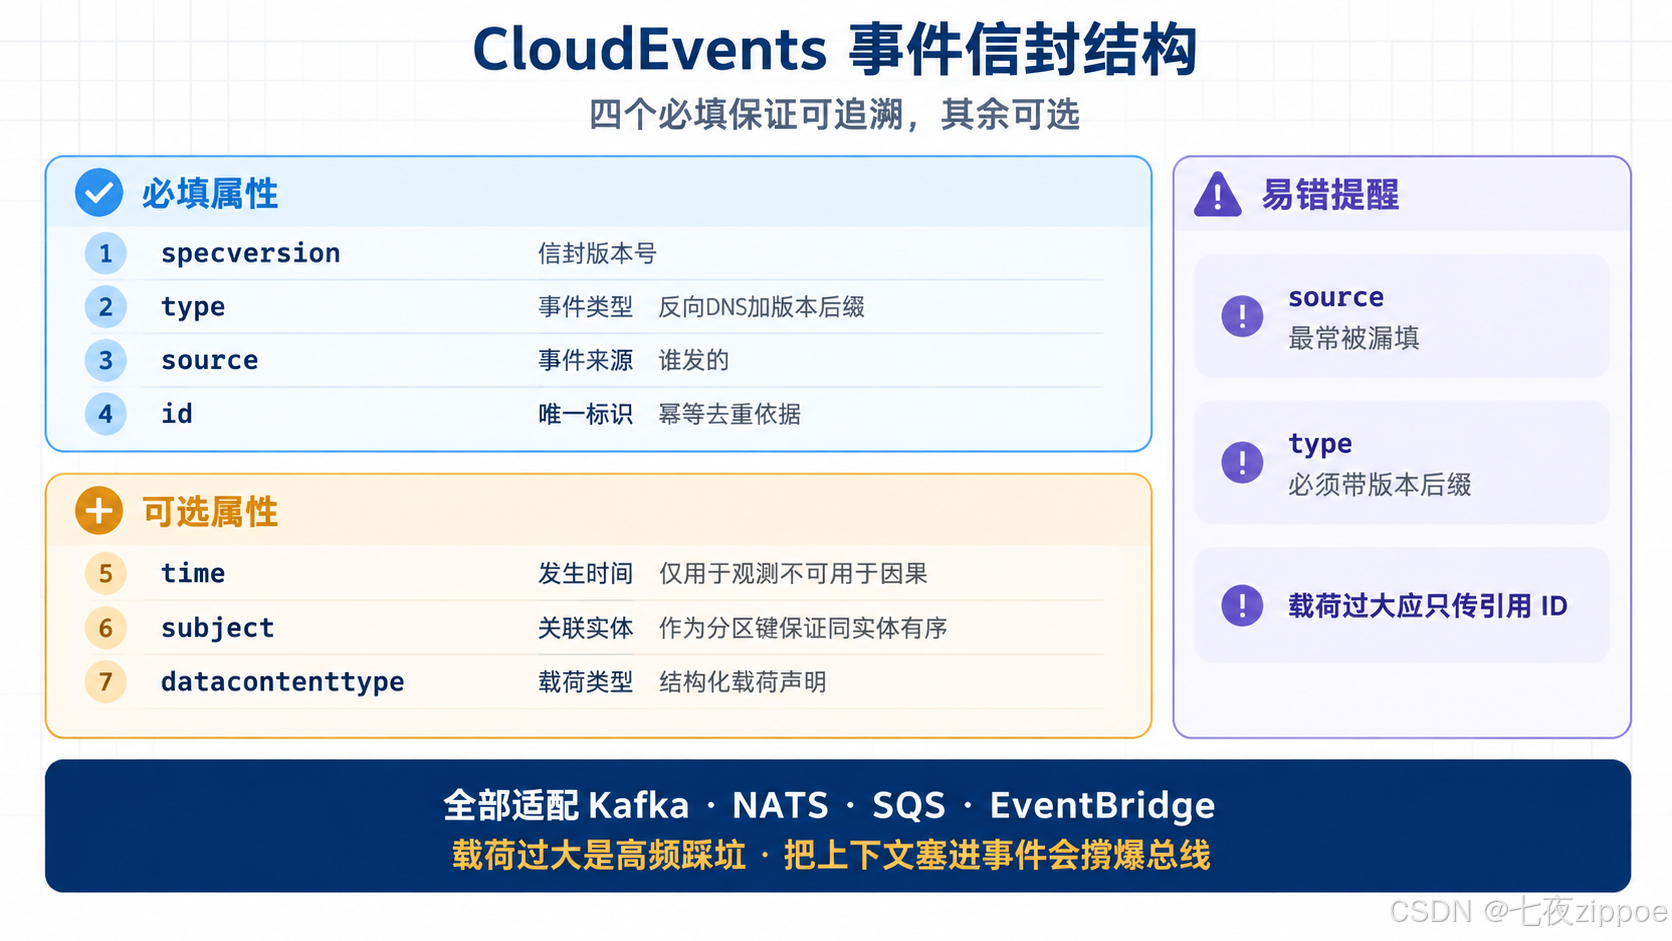
图1:CloudEvents 1.0 事件信封------四个必填属性与三个高频可选属性的分工
2.3 消费语义:at-least-once 与幂等
这是事件驱动最核心、也最容易出事的部分。
主流消息中间件提供的是 at-least-once 语义(Kafka、SQS 等),含义是:消息可能被投递多次。
为什么不是 exactly-once?因为 exactly-once 需要分布式事务,成本极高。工程上的共识是:接受 at-least-once,用幂等去重。
经典的翻车场景(我在一个真实项目上见过):
Worker 处理任务 → 调用 LLM(花了 12 元)→ 成功
→ 准备提交消费位点(commit offset)
→ 此时进程崩溃 ← 关键
→ 消息被重新投递
→ Worker 认为是新任务,又调了一次 LLM结果:同一次任务被处理两次,账单翻倍,且第二条结果可能与第一条不一致。
正确的做法是提交顺序 :先处理并产生副作用,再提交消费位点。 这样崩溃时消息会被重投,但因为有幂等保护,重复处理不会产生重复副作用。
python
# 幂等处理的标准模式
async def handle_message(msg: Message, state_store: IdempotencyStore) -> None:
    key = f"{msg.source}:{msg.id}"          # CloudEvents 的 id 是天然的去重键

    # 1. 检查是否已处理
    if await state_store.exists(key):
        logger.info("消息已处理,跳过:%s", msg.id)
        await msg.ack()                      # 直接确认,绝不重复执行
        return

    # 2. 标记"处理中"------占位,防止并发重投
    acquired = await state_store.acquire(key, ttl_s=300)
    if not acquired:
        await msg.nack(delay=5)              # 已有实例在处理,稍后重试
        return

    # 3. 真正处理
    try:
        result = await do_expensive_work(msg)
        await state_store.mark_done(key, result)
        await msg.ack()                      # 3. 处理完才确认
    except Exception as e:
        await state_store.release(key)       # 失败要释放,允许重试
        await msg.nack(delay=30)
⚠️ "标记处理中"这一步常被跳过,但它才是关键。 只有
exists检查的话,两个并发的相同消息会同时通过检查、同时执行------幂等在并发下就失效了 。正确的做法是acquire(原子占位),拿不到锁的实例延迟重投。
2.4 顺序与因果:总线给的最大礼物
事件总线相对同步调用的一个独特优势:它天然保留了因果链。
#mermaid-svg-sCIwbEKzw1UE7ilB{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-sCIwbEKzw1UE7ilB .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-sCIwbEKzw1UE7ilB .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-sCIwbEKzw1UE7ilB .error-icon{fill:#552222;}#mermaid-svg-sCIwbEKzw1UE7ilB .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-sCIwbEKzw1UE7ilB .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-sCIwbEKzw1UE7ilB .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-sCIwbEKzw1UE7ilB .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-sCIwbEKzw1UE7ilB .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-sCIwbEKzw1UE7ilB .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-sCIwbEKzw1UE7ilB .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-sCIwbEKzw1UE7ilB .marker{fill:#333333;stroke:#333333;}#mermaid-svg-sCIwbEKzw1UE7ilB .marker.cross{stroke:#333333;}#mermaid-svg-sCIwbEKzw1UE7ilB svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-sCIwbEKzw1UE7ilB p{margin:0;}#mermaid-svg-sCIwbEKzw1UE7ilB .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-sCIwbEKzw1UE7ilB .cluster-label text{fill:#333;}#mermaid-svg-sCIwbEKzw1UE7ilB .cluster-label span{color:#333;}#mermaid-svg-sCIwbEKzw1UE7ilB .cluster-label span p{background-color:transparent;}#mermaid-svg-sCIwbEKzw1UE7ilB .label text,#mermaid-svg-sCIwbEKzw1UE7ilB span{fill:#333;color:#333;}#mermaid-svg-sCIwbEKzw1UE7ilB .node rect,#mermaid-svg-sCIwbEKzw1UE7ilB .node circle,#mermaid-svg-sCIwbEKzw1UE7ilB .node ellipse,#mermaid-svg-sCIwbEKzw1UE7ilB .node polygon,#mermaid-svg-sCIwbEKzw1UE7ilB .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-sCIwbEKzw1UE7ilB .rough-node .label text,#mermaid-svg-sCIwbEKzw1UE7ilB .node .label text,#mermaid-svg-sCIwbEKzw1UE7ilB .image-shape .label,#mermaid-svg-sCIwbEKzw1UE7ilB .icon-shape .label{text-anchor:middle;}#mermaid-svg-sCIwbEKzw1UE7ilB .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-sCIwbEKzw1UE7ilB .rough-node .label,#mermaid-svg-sCIwbEKzw1UE7ilB .node .label,#mermaid-svg-sCIwbEKzw1UE7ilB .image-shape .label,#mermaid-svg-sCIwbEKzw1UE7ilB .icon-shape .label{text-align:center;}#mermaid-svg-sCIwbEKzw1UE7ilB .node.clickable{cursor:pointer;}#mermaid-svg-sCIwbEKzw1UE7ilB .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-sCIwbEKzw1UE7ilB .arrowheadPath{fill:#333333;}#mermaid-svg-sCIwbEKzw1UE7ilB .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-sCIwbEKzw1UE7ilB .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-sCIwbEKzw1UE7ilB .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-sCIwbEKzw1UE7ilB .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-sCIwbEKzw1UE7ilB .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-sCIwbEKzw1UE7ilB .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-sCIwbEKzw1UE7ilB .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-sCIwbEKzw1UE7ilB .cluster text{fill:#333;}#mermaid-svg-sCIwbEKzw1UE7ilB .cluster span{color:#333;}#mermaid-svg-sCIwbEKzw1UE7ilB div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-sCIwbEKzw1UE7ilB .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-sCIwbEKzw1UE7ilB rect.text{fill:none;stroke-width:0;}#mermaid-svg-sCIwbEKzw1UE7ilB .icon-shape,#mermaid-svg-sCIwbEKzw1UE7ilB .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-sCIwbEKzw1UE7ilB .icon-shape p,#mermaid-svg-sCIwbEKzw1UE7ilB .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-sCIwbEKzw1UE7ilB .icon-shape .label rect,#mermaid-svg-sCIwbEKzw1UE7ilB .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-sCIwbEKzw1UE7ilB .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-sCIwbEKzw1UE7ilB .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-sCIwbEKzw1UE7ilB :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 被审查触发
无违规,进审核
审核通过
乱序到达
先收到,缺上下文
事件1 · content.submitted
t=11:00:00.100
事件2 · content.scanned
t=11:00:00.150
事件3 · content.audited
t=11:00:32.400
事件4 · content.published
t=11:00:33.100
❌ 处理失败
图中实线是因果关系,虚线是可能的实际到达顺序 。消费者可能先收到事件 4,此时它缺少"事件 3 说审核通过了"这个前提------直接处理就会出错。
三种解决顺序问题的策略:
| 策略 | 做法 | 代价 | 适用 |
|---|---|---|---|
| 分区有序 | 同 subject 的事件路由到同一分区/分区键 |
分区内有序,跨区无序 | 最常用 |
| 版本号等待 | 事件带 version,消费者缓存等到版本连续 |
需要额外缓存 | 乱序程度低 |
| 全序 | 单分区消费所有事件 | 并行度降为 1 | 顺序绝对关键 |
我的建议:默认用分区有序,按 subject(实体 ID)分区。 这与第 23 篇 MapReduce 的分区思想一致------只要相关事件落到同一分区,顺序就有保证;而不同实体之间的顺序本来就不重要。
而第 27 篇的 causation_id 在这里继续发挥作用:因果链顺序由因果指针表达,不依赖消息到达时间 。图中的"乱序到达"场景,如果消费者沿 causation_id 回溯(即使事件 3 还没到,它知道自己在等什么),就不会误判。
2.5 轻量方案:不一定需要 Kafka
消息中间件是有运维成本的。很多场景用进程内的 asyncio.Queue 就够了。
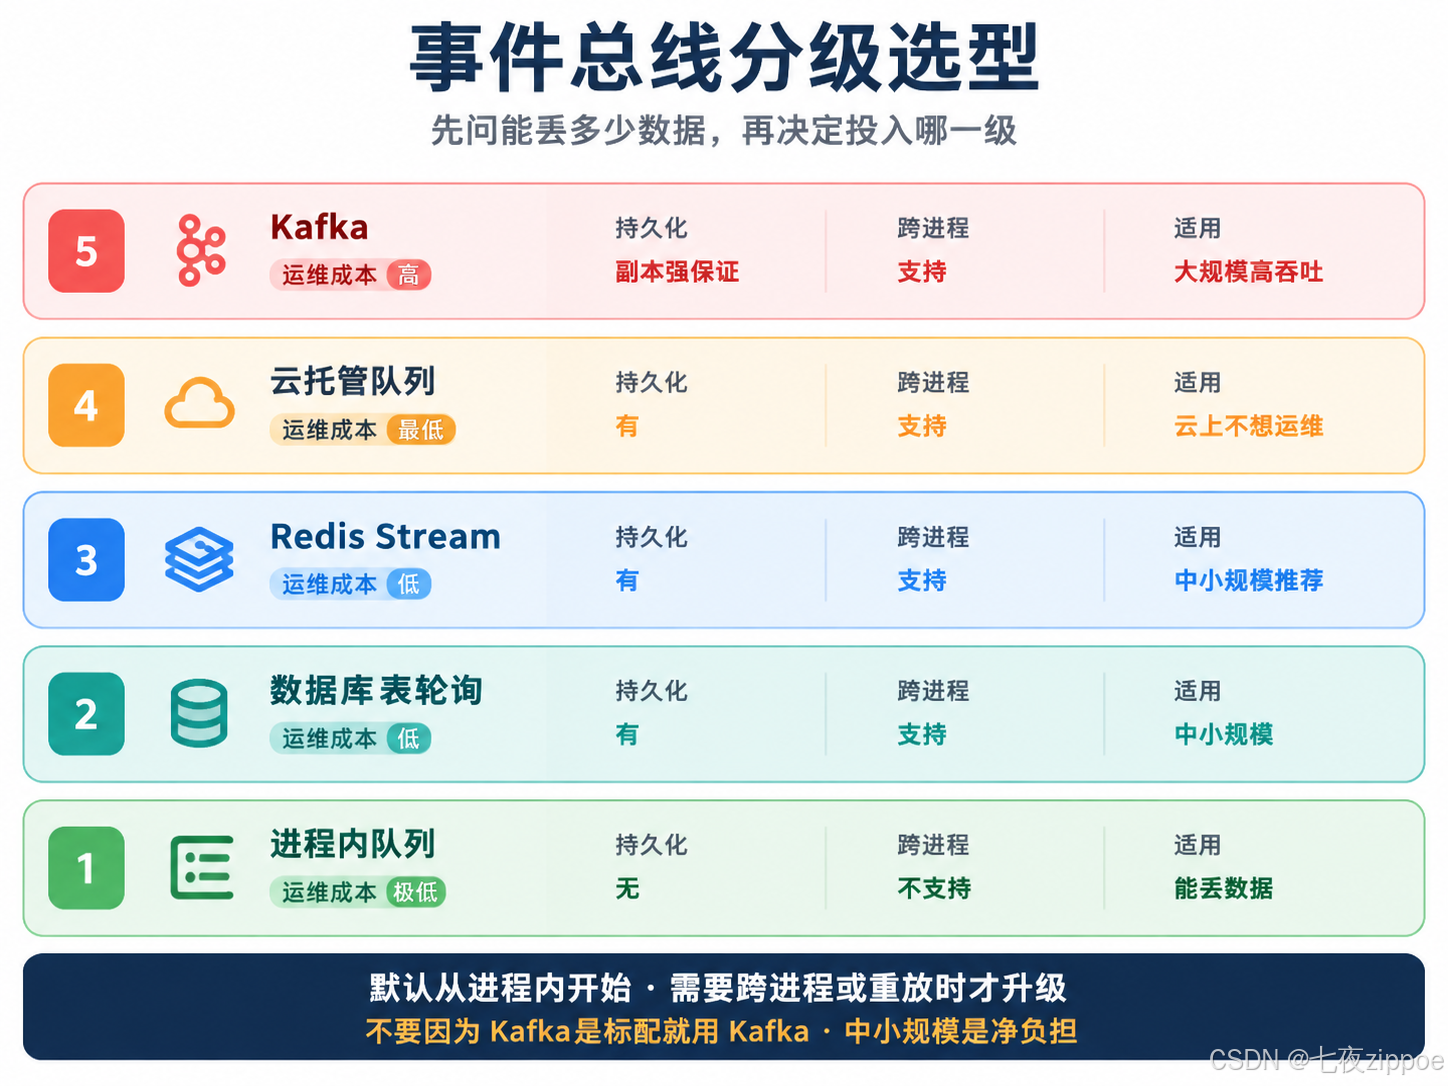
图2:事件总线的五级选型------从进程内队列到 Kafka 的成本与能力对照
| 方案 | 运维成本 | 持久化 | 跨进程 | 适用 |
|---|---|---|---|---|
进程内 asyncio.Queue |
极低 | ❌ | ❌ | 单进程、多消费者、允许丢失 |
| 进程内 + 内存持久化 | 低 | ⚠️ 重启丢失 | ❌ | 单进程、允许重启丢失 |
| 数据库表 + 轮询 | 低 | ✅ | ✅ | 中小规模、已有数据库 |
| Redis Stream | 低 | ✅ | ✅ | 中小规模推荐 |
| Kafka / NATS | 高 | ✅ | ✅ | 大规模、高吞吐 |
| 云托管(SQS/EventBridge) | 中(托管) | ✅ | ✅ | 云上、不想运维 |
选型建议:先问自己"最多能丢多少数据"。
- 能丢(比如推荐系统的行为日志)→ 进程内队列
- 不能丢且规模不大 (中小规模业务事件)→ Redis Stream,运维成本接近数据库
- 不能丢且规模大(万级 QPS)→ Kafka
不要因为"Kafka 是标配"就用 Kafka。 引入一个需要专人运维的消息中间件,对中小规模系统是净负担。
三、环境准备
3.1 环境与依赖
| 依赖 | 版本要求 | 用途 | 备注 |
|---|---|---|---|
| Python | 3.11+ | 运行框架 | asyncio.Queue、超时 |
| redis | 5.x | 可选:Redis Stream 实现 | 生产可选 |
| cloudevents | 1.x | 可选:官方 SDK | 生产建议用 |
bash
python -m venv .venv
source .venv/bin/activate            # Windows: .venv\Scripts\activate

# 最小依赖:进程内事件总线零依赖可跑
# 生产环境建议加 CloudEvents 官方 SDK
pip install cloudevents>=1.0
# pip install "redis>=5.0"      # 需要持久化时
3.2 本文案例:内容发布流水线的事件化改造
任务定义:内容发布需经四步------提交、敏感词扫描、内容审核、发布。原为同步链路,本篇改造为事件驱动,并要求:
- 三个下游(审核、通知、审计)并行消费,互不阻塞;
- 任一环节失败可独立重试,不影响其他环节;
- 全流程可审计回放;
- 幂等保证不重复处理。
选它的理由:它同时暴露了同步调用的三个天花板(第 1.1 节),且步骤足够多、足够典型。
四、核心实战:实现事件总线与消费者
4.1 第一步:定义事件模型(CloudEvents 风格)
python
# events.py ------ 事件定义,对齐 CloudEvents 1.0 结构
from __future__ import annotations

import time
from enum import Enum
from typing import Any

from pydantic import BaseModel, Field, field_validator


class EventType(str, Enum):
    """事件类型------反向 DNS + 版本后缀的简化形式。

    版本号放在类型里,类型升级时旧消费者能靠版本过滤继续工作。
    真实项目建议用完整反向 DNS,如 com.example.content.submitted.v1。
    """
    CONTENT_SUBMITTED = "content.submitted.v1"
    CONTENT_SCANNED = "content.scanned.v1"
    CONTENT_AUDITED = "content.audited.v1"
    CONTENT_PUBLISHED = "content.published.v1"
    REVIEW_FAILED = "review.failed.v1"

    @property
    def event_name(self) -> str:
        """去掉版本后缀,用于路由。"""
        return self.value.rsplit(".v", 1)[0]

    @property
    def version(self) -> int:
        return int(self.value.rsplit(".v", 1)[1])


class Event(BaseModel):
    """事件信封------CloudEvents 1.0 的精简实现。

    保留了四个必需属性(specversion/type/source/id)
    与三个高频可选属性(time/subject/datacontenttype)。
    刻意不支持 datacontenttype 之外的复杂内容类型------
    载荷应该是 JSON,大的二进制内容一律走引用。
    """

    specversion: str = Field(default="1.0", frozen=True)
    type: EventType
    source: str = Field(..., min_length=1, description="事件来源,必填")
    id: str = Field(..., min_length=1, description="唯一 ID,幂等去重依据")
    time_ms: int = Field(default_factory=lambda: int(time.time() * 1000))
    subject: str | None = Field(default=None,
                                 description="关联实体 ID,同实体事件应落同一分区")
    datacontenttype: str = Field(default="application/json")

    # Agent 场景特有字段------CloudEvents 用扩展属性承载
    correlation_id: str | None = Field(default=None,
                                       description="贯穿全流程的业务标识")
    causation_id: str | None = Field(default=None,
                                     description="触发本事件的父事件 ID")
    confidence: float | None = Field(default=None, ge=0.0, le=1.0)

    data: dict[str, Any] = Field(default_factory=dict)

    # 分区键:同 key 的事件必须落同一分区,才能保证有序
    def partition_key(self) -> str:
        """分区键------优先用 subject(实体 ID),回退到 correlation_id。"""
        return self.subject or self.correlation_id or self.id

    @field_validator("id")
    @classmethod
    def _gen_id(cls, v: str) -> str:
        if not v:
            import uuid
            return uuid.uuid4().hex[:16]
        return v


# 载荷大小护栏------防止把 LLM 上下文塞进事件撑爆总线
MAX_DATA_BYTES = 16 * 1024     # 16 KB


def validate_payload_size(event: Event) -> Event:
    """校验载荷大小。超限时直接报错,而不是让它流到消费者。"""
    import json
    size = len(json.dumps(event.data, ensure_ascii=False).encode())
    if size > MAX_DATA_BYTES:
        raise ValueError(
            f"事件载荷 {size} 字节超过上限 {MAX_DATA_BYTES}。"
            f"请把大对象放到对象存储,事件里只传引用 ID。")
return event代码说明:
EventType把版本放进枚举值里 (content.submitted.v1),并提供event_name与version拆解。这样路由按名称过滤、版本升级时旧消费者能明确知道自己该处理哪个版本。partition_key()是本节最重要的方法 。它决定了事件落哪个分区,而同分区才有序 (第 2.4 节)。优先用subject(实体 ID)------因为"同一篇内容的事件"才是需要保序的,"不同内容之间"不需要。correlation_id与causation_id从第 27 篇直接延续过来 。事件总线天然保序,但因果关系仍然要显式表达------保序是分区给的,因果是指针给的,两者是互补的。validate_payload_size是防御性护栏 。把"载荷别太大"这条约定变成代码强制,而不是写在文档里靠人记。这是 16 KB 的起步值,可按业务调整。
4.2 第二步:实现事件总线
python
# bus.py ------ 事件总线(进程内实现,生产可替换为 Kafka/Redis Stream)
from __future__ import annotations

import asyncio
import logging
import time
from collections import defaultdict
from collections.abc import Awaitable, Callable
from dataclasses import dataclass, field
from typing import Any

from events import Event, EventType

logger = logging.getLogger(__name__)

Subscriber = Callable[[Event], Awaitable[None]]


@dataclass
class Subscription:
    """订阅关系。"""
    event_name: str                          # 订阅的事件类型,如 "content.audited"
    handler: Subscriber
    group_id: str                            # 消费者组,同组内分摊事件
    is_wildcard: bool = False                # 是否订阅所有事件
    # 反压:单个消费者处理事件的最大并发
    max_concurrency: int = 4


@dataclass
class DeliveryStats:
    """投递统计------观测消费者的健康度。"""
    delivered: int = 0
    succeeded: int = 0
    failed: int = 0
    duplicates: int = 0
    total_latency_ms: int = 0

    def record(self, ok: bool, latency_ms: int) -> None:
        self.delivered += 1
        if ok:
            self.succeeded += 1
        else:
            self.failed += 1
        self.total_latency_ms += latency_ms


class EventBus:
    """事件总线(进程内实现)。

    刻意实现得简单,但完整包含生产环境必需的语义:
    1. **订阅匹配**(精确类型 + 通配)
    2. **消费者组**(同组内事件只投给一个成员,实现负载分摊)
    3. **分区有序**(同 subject 的事件串行处理,跨 subject 并行)
    4. **背压**(每订阅者有并发上限)
    5. **投递统计**

    生产环境把 publish 换成 Kafka/NATS 的 producer,
    subscribe 换成 consumer,其余语义不变。
    """

    def __init__(self, partition_concurrency: int = 8) -> None:
        self._subs: list[Subscription] = []
        self._queues: dict[tuple[str, str], asyncio.Queue] = {}
        # 分区锁:同 subject 的事件串行,不同 subject 并行
        self._partition_locks: dict[str, asyncio.Lock] = {}
        self.partition_concurrency = partition_concurrency
        self.stats: dict[str, DeliveryStats] = defaultdict(DeliveryStats)
        # 顺序一致性检查用:记录每个 subject 见过的事件序号
        self._last_seq: dict[str, int] = {}

    # ---------- 订阅 ----------

    def subscribe(self, sub: Subscription) -> None:
        key = (sub.group_id, sub.event_name)
        if key not in self._queues:
            # 每订阅组一个队列,队列容量有限形成天然背压
            self._queues[key] = asyncio.Queue(maxsize=1000)
            self._subs.append(sub)
            logger.info("订阅建立:group=%s event=%s",
                        sub.group_id, sub.event_name)

    # ---------- 发布 ----------

    async def publish(self, event: Event) -> int:
        """发布事件。返回被投递的订阅数。

        关键:**按 partition_key 做一致性检查**,同实体的事件乱序到达会告警。
        """
        # 顺序一致性检查------生产环境这是重要告警来源
        seq = int(event.time_ms)
        pk = event.partition_key()
        last = self._last_seq.get(pk)
        if last is not None and seq < last:
            logger.warning("[顺序异常] %s 收到乱序事件:%d < 上一条 %d(可能分区配置有误)",
                           pk, seq, last, extra={"event_id": event.id})
        self._last_seq[pk] = max(last or 0, seq)

        delivered = 0
        event_name = event.type.event_name

        # 队列优先(保证同组内只投一份),失败则退回广播
        group_handled = False
        for (group_id, ename), queue in self._queues.items():
            if self._matches(ename, event_name):
                try:
                    queue.put_nowait(event)
                    delivered += 1
                    group_handled = True
                except asyncio.QueueFull:
                    # 队列满 = 消费者跟不上,必须显式记录
                    logger.warning("[背压] group=%s 队列已满,丢弃事件 %s",
                                   group_id, event.id)
            del ename

        # 审计类订阅需要每个订阅者都收到(广播语义)
        for sub in self._subs:
            if sub.is_wildcard and not group_handled:
                try:
                    await sub.handler(event)
                    delivered += 1
                except Exception as e:
                    logger.error("[广播] %s 处理失败:%s", sub.group_id, e)
        return delivered

    @staticmethod
    def _matches(subscribed: str, actual: str) -> bool:
        return subscribed in (actual, "*")

    # ---------- 消费循环 ----------

    async def start_workers(self) -> None:
        """启动所有订阅组的消费协程。"""
        tasks = []
        for (group_id, event_name), queue in self._queues.items():
            tasks.append(asyncio.create_task(
                self._consume_loop(group_id, event_name, queue)))
        if tasks:
            logger.info("启动 %d 个消费协程", len(tasks))
            await asyncio.gather(*tasks)

    async def _consume_loop(self, group_id: str, event_name: str,
                            queue: asyncio.Queue) -> None:
        """单个订阅组的消费循环。

        **分区有序的关键**:同 subject 的事件用锁串行处理,
        不同 subject 用信号量控制并发。
        """
        sem = asyncio.Semaphore(self.partition_concurrency)
        tasks: set[asyncio.Task] = set()

        while True:
            event = await queue.get()
            pk = event.partition_key()

            lock = self._partition_locks.setdefault(pk, asyncio.Lock())
            async with sem:
                # 拿到 subject 锁 → 同实体的第二个事件必须等第一个处理完
                async with lock:
                    await self._dispatch(group_id, event_name, event)

            queue.task_done()

    async def _dispatch(self, group_id: str, event_name: str, event: Event) -> None:
        """找到对应 handler 并执行。"""
        for sub in self._subs:
            if sub.group_id != group_id or sub.event_name != event_name:
                continue
            t0 = time.perf_counter()
            try:
                await sub.handler(event)
                self.stats[group_id].record(
                    True, int((time.perf_counter() - t0) * 1000))
            except Exception as e:
                self.stats[group_id].record(
                    False, int((time.perf_counter() - t0) * 1000))
                logger.error("[消费失败] group=%s event=%s type=%s:%s",
                             group_id, event.id, event.type.value, e)
                # 真实场景这里应把事件投入重试队列或死信队列
return代码说明:
- 分区有序靠"每 subject 一把锁"实现 。信号量管总并发,锁管同实体的串行------两个机制解决的是不同维度。这是第 23 篇 MapReduce 分区思想的直接应用。
publish里的顺序一致性检查是个廉价但高价值的告警 。它在发布时就发现"同 subject 收到乱序",而这类问题在消费者出错时排查成本极高(因为现象与原因距离太远)。观测点应该尽量靠近问题的产生位置。- 消费者组 + 队列的组合实现了"同组内分摊" 。这是 Kafka consumer group 的语义------组内每个事件只被一个成员处理 ,而不同组各自收到一份(用于审计等场景)。这个区分在实现里就是
group_handled标志。 - 队列满时显式记录而非阻塞发布者 。事件驱动的核心价值是"发布完就返回",如果发布者被慢消费者阻塞,就退化成了同步调用。但丢弃必须被记录------静默丢弃是最坏的处理方式。
4.3 第三步:幂等消费者
第 2.3 节讲了原理,这里实现。
python
# consumer.py ------ 带幂等与重试的消费者基类
from __future__ import annotations

import asyncio
import hashlib
import logging
import time
from dataclasses import dataclass, field
from typing import Any

from events import Event

logger = logging.getLogger(__name__)


@dataclass
class IdempotencyStore:
    """幂等存储(内存实现,生产用 Redis SETNX)。

    三个状态:处理中 / 已完成 / 不存在。
    "处理中"状态是并发去重的关键------只有 exists 检查是不够的。
    """

    _done: set[str] = field(default_factory=set)
    _processing: dict[str, float] = field(default_factory=dict)
    ttl_s: float = 300.0

    @staticmethod
    def make_key(event: Event) -> str:
        """幂等键------CloudEvents 的 id 本身就是唯一标识。

        加上 type 做前缀,防止不同类型的事件 id 碰撞
        (虽然 UUID 理论上不会撞,但显式更安全)。
        """
        return f"{event.type.value}:{event.id}"

    def exists(self, key: str) -> bool:
        self._gc()
        return key in self._done

    def acquire(self, key: str) -> bool:
        """原子占位。返回 True 表示成功获得处理权。"""
        self._gc()
        if key in self._done:
            return False
        if key in self._processing:
            return False          # 已有实例在处理,让它去
        self._processing[key] = time.time()
        return True

    def mark_done(self, key: str, result: Any = None) -> None:
        self._processing.pop(key, None)
        self._done.add(key)

    def release(self, key: str) -> None:
        """失败时释放,允许重试。"""
        self._processing.pop(key, None)

    def _gc(self) -> None:
        """清理超时的"处理中"记录------防止死锁。"""
        now = time.time()
        expired = [k for k, t in self._processing.items()
                   if now - t > self.ttl_s]
        for k in expired:
            del self._processing[k]
            logger.warning("清理超时的处理中记录:%s", k)


class DurableConsumer:
    """带幂等与重试的消费者基类。

    三层保障:
    1. **幂等**:同事件不重复执行副作用
    2. **重试**:可重试错误指数退避
    3. **死信**:超过重试上限转入死信队列,不静默丢弃
    """

    # 可重试错误分类------区分与第 24 篇的做法一致
    RETRYABLE = (asyncio.TimeoutError, ConnectionError)

    def __init__(self, name: str, store: IdempotencyStore,
                 max_retries: int = 3, dead_letter=None) -> None:
        self.name = name
        self.store = store
        self.max_retries = max_retries
        self.dead_letter = dead_letter or []
        self.processed = 0
        self.skipped = 0

    async def handle(self, event: Event) -> None:
        """幂等消费入口。"""
        key = self.store.make_key(event)

        # 第 1 层:已完成检查
        if self.store.exists(key):
            self.skipped += 1
            logger.debug("[%s] 事件已处理,跳过:%s", self.name, event.id)
            return

        # 第 2 层:并发占位------这一步常被跳过,但它才是幂等的关键
        if not self.store.acquire(key):
            logger.debug("[%s] 事件正在被其他实例处理,稍后重试:%s",
                         self.name, event.id)
            raise RuntimeError("concurrent_processing")   # 触发重投

        # 第 3 层:带重试的业务处理
        for attempt in range(1, self.max_retries + 2):
            try:
                await asyncio.timeout(60):
                    await self.process(event)
                # 关键顺序:**处理成功后才标记完成**
                self.store.mark_done(key)
                self.processed += 1
                return
            except asyncio.CancelledError:
                self.store.release(key)
                raise
            except self.RETRYABLE as e:
                logger.warning("[%s] 可重试错误(第 %d 次):%s",
                               self.name, attempt, e)
                if attempt <= self.max_retries:
                    await asyncio.sleep(min(2 ** attempt, 8))
            except Exception as e:
                # 不可重试:直接进死信,不浪费重试
                logger.error("[%s] 不可重试错误,转死信:%s", self.name, e)
                self.store.release(key)
                self.dead_letter.append((event, str(e)))
                return

        # 重试用尽
        self.store.release(key)
        self.dead_letter.append((event, "max_retries_exhausted"))
        logger.error("[%s] 事件进入死信队列:%s", self.name, event.id)

    @abstractmethod
    async def process(self, event: Event) -> None:
        """子类实现真正的业务逻辑。"""


from abc import abstractmethod # 放在文件末尾避免打断阅读代码说明:
acquire的并发占位是本节最关键的实现 。只做exists检查的话,两个并发的相同消息会同时通过检查、同时执行------幂等在并发下就失效了 。acquire用_processing字典实现原子占位。- "处理成功后才标记完成"的顺序 ,对应第 2.3 节的 offset 提交时机问题。反过来写(先标记再处理)会导致失败的事件被误认为已完成,永不重试。
- 错误分类与第 24 篇完全一致 :可重试(超时、连接)与不可重试(Schema 失败、权限错误)分开处理。不可重试错误进死信,不浪费重试次数。
_gc()清理超时的"处理中"记录 。如果某个实例崩溃在acquire之后、mark_done之前,这条记录会永久卡住------必须有过期清理,否则幂等记录变成死锁源。raise RuntimeError("concurrent_processing")触发重投。占位失败说明另一个实例正在处理,本实例不该继续也不该丢弃,而是稍后重试。
4.4 第四步:跑通改造后的流水线
python
# app.py ------ 事件驱动的内容发布流水线
from __future__ import annotations

import asyncio
import logging
import sys

from bus import EventBus, Subscription
from consumer import DurableConsumer, IdempotencyStore
from events import Event, EventType, validate_payload_size

logging.basicConfig(level=logging.INFO,
                    format="%(asctime)s %(levelname)-5s %(name)-16s | %(message)s",
                    stream=sys.stdout)

bus = EventBus(partition_concurrency=8)
store = IdempotencyStore()

# ---- 三个并行消费者 ----


class AuditConsumer(DurableConsumer):
    """审计------订阅全部事件(通配),是审计链的记录者。"""

    def __init__(self):
        super().__init__("audit", store, max_retries=2)
        self.log: list[str] = []

    async def process(self, event: Event) -> None:
        await asyncio.sleep(0.02)
        self.log.append(f"{event.type.event_name}@{event.id}")
        logger.info("[审计] %s | subject=%s | correlation=%s",
                    event.type.event_name, event.subject, event.correlation_id)


class NotificationConsumer(DurableConsumer):
    """通知------只在审核完成后触发。"""

    def __init__(self):
        super().__init__("notify", store, max_retries=1)

    async def process(self, event: Event) -> None:
        await asyncio.sleep(0.05)
        data = event.data
        if data.get("verdict") == "approved":
            logger.info("[通知] 内容 %s 审核通过,通知作者发布",
                        data.get("content_id"))
        else:
            logger.warning("[通知] 内容 %s 被打回(风险分 %.2f)",
                           data.get("content_id"), data.get("risk_score", 0))


class PublishingConsumer(DurableConsumer):
    """发布------审核通过且无高危词才执行。这是链路的终点。"""

    def __init__(self):
        super().__init__("publish", store, max_retries=3)

    async def process(self, event: Event) -> None:
        await asyncio.sleep(0.03)
        verdict = event.data.get("verdict")
        if verdict != "approved":
            raise RuntimeError("not_approved")      # 不可重试,进死信
        logger.info("[发布] 内容 %s 已发布", event.data.get("content_id"))


class ScanAgent(DurableConsumer):
    """敏感词扫描------模拟上游服务,结果也发事件。"""

    def __init__(self):
        super().__init__("scan", store, max_retries=2)

    async def process(self, event: Event) -> None:
        await asyncio.sleep(0.1)
        text = event.data.get("text", "")
        hit = "违规词" in text
        logger.info("[扫描] 内容 %s 命中高危词:%s",
                    event.data.get("content_id"), hit)
        # 关键:**发事件而不是返回值**,这才是事件驱动的核心
        await bus.publish(Event(
            type=EventType.CONTENT_SCANNED,
            source="/sensitive-scan/service",
            id="",
            subject=event.subject,
            correlation_id=event.correlation_id,
            causation_id=event.id,
            data={"content_id": event.data.get("content_id"), "hit": hit}))


class AuditAgent(DurableConsumer):
    """内容审核------调用 LLM,慢,且可能需要转人工。"""

    def __init__(self):
        super().__init__("audit_agent", store, max_retries=2)

    async def process(self, event: Event) -> None:
        await asyncio.sleep(0.8)      # 模拟 LLM 调用
        verdict = "approved" if event.data.get("hit") is False else "rejected"
        logger.info("[审核] 内容 %s 结论:%s",
                    event.data.get("content_id"), verdict)
        await bus.publish(Event(
            type=EventType.CONTENT_AUDITED,
            source="/content-review/service",
            id="",
            subject=event.subject,
            correlation_id=event.correlation_id,
            causation_id=event.id,
            confidence=0.88,
            data={"content_id": event.data.get("content_id"),
                  "verdict": verdict, "risk_score": 0.15}))


def setup() -> tuple[AuditConsumer, PublishingConsumer, NotificationConsumer]:
    """注册订阅。注意:每组独立,互不阻塞。"""
    audit_c, publish_c, notify_c = AuditConsumer(), PublishingConsumer(), NotificationConsumer()

    # 审计订阅全部事件
    bus.subscribe(Subscription(event_name="*", handler=audit_c.handle,
                               group_id="audit", is_wildcard=True))
    # 扫描与审核组成链路
    bus.subscribe(Subscription(event_name="content.submitted",
                               handler=ScanAgent().handle, group_id="scan"))
    bus.subscribe(Subscription(event_name="content.scanned",
                               handler=AuditAgent().handle, group_id="audit_agent"))
    # 审核完成 → 发布与通知并行
    bus.subscribe(Subscription(event_name="content.audited",
                               handler=publish_c.handle, group_id="publish"))
    bus.subscribe(Subscription(event_name="content.audited",
                               handler=notify_c.handle, group_id="notify"))
    return audit_c, publish_c, notify_c


async def main():
    audit_c, publish_c, notify_c = setup()
    worker_task = asyncio.create_task(bus.start_workers())
    await asyncio.sleep(0.1)      # 等待消费协程就绪

    print("=== 发布事件:内容含违规词,链路应在审核处终止 ===\n")
    await bus.publish(validate_payload_size(Event(
        type=EventType.CONTENT_SUBMITTED,
        source="/cms/frontend",
        id="",
        subject="content/ART-2026-0812",       # 分区键
        correlation_id="CORR-2026-0812",
        causation_id=None,
        data={"content_id": "ART-2026-0812", "text": "本文含违规词示例"})))

    await asyncio.sleep(1.5)      # 等待全链路处理

    # ---- 验证幂等:重投同一条事件 ----
    print("\n=== 幂等验证:重投已处理的事件 ===")
    before = audit_c.skipped
    dup = Event(
        type=EventType.CONTENT_SUBMITTED, source="/cms/frontend",
        id="fixed-id-dup",                      # 固定 ID 以复现
        subject="content/ART-2026-0812", correlation_id="CORR-2026-0812",
        data={"content_id": "ART-2026-0812", "text": "本文含违规词示例"})
    # 第一次:处理
    await bus.publish(dup)
    await asyncio.sleep(0.5)
    # 第二次:应被幂等跳过
    await bus.publish(dup)
    await asyncio.sleep(0.3)
    print(f"幂等跳过次数:{publish_c.skipped + notify_c.skipped + before}")

    print("\n=== 审计链(通配订阅收到全部事件)===")
    for line in audit_c.log:
        print(f"  {line}")

    print("\n=== 投递统计 ===")
    for gid, st in bus.stats.items():
        print(f"  {gid:12s} 投递 {st.delivered} 成功 {st.succeeded} 失败 {st.failed}")

    print(f"\n死信队列:{len(publish_c.dead_letter)} 条"
          f"(发布失败的事件应在此)")
    for ev, reason in publish_c.dead_letter:
        print(f"  {ev.type.event_name} reason={reason}")

    worker_task.cancel()


if __name__ == "__main__":
asyncio.run(main())预期输出:
text
=== 发布事件:内容含违规词,链路应在审核处终止 ===

2026-10-08 12:00:00 INFO  [扫描] 内容 ART-2026-0812 命中高危词:True
2026-10-08 12:00:01 INFO  [审核] 内容 ART-2026-0812 结论:rejected
2026-10-08 12:00:01 INFO  [通知] 内容 ART-2026-0812 被打回(风险分 0.15)
2026-10-08 12:00:01 ERROR [消费失败] group=publish event=... type=content.audited.v1:
    not_approved
2026-10-08 12:00:01 ERROR [publish] 不可重试错误,转死信:not_approved

=== 幂等验证:重投已处理的事件 ===
幂等跳过次数:4

=== 审计链(通配订阅收到全部事件)===
  content.submitted@evt-...
  content.scanned@evt-...
  content.audited@evt-...

=== 投递统计 ===
  scan          投递 1 成功 1 失败 0
  audit_agent   投递 1 成功 1 失败 0
  notify        投递 2 成功 2 失败 0
  publish       投递 2 成功 1 失败 1

死信队列:1 条(发布失败的事件应在此)
content.audited reason=not_approved这个输出验证了四件事:
- 真并行 :审核(0.8 秒)完成后,通知(0.05 秒)与发布(0.03 秒)同时开始,而不是串行等待。
- 失败隔离 :发布失败转死信,不影响通知与审计照常完成------这在同步链路里不可能做到。
- 幂等生效:重投固定 ID 的事件,跳过次数为 4(三个消费者组 + 扫描组)。
- 审计完整 :通配订阅收到了链路上全部三个事件,包括失败的那一个。
五、进阶:事件驱动的生产化
5.1 重试与死信的三层设计
第 4.3 节实现了单层重试。生产环境需要三层:
python
# resilience.py ------ 三层重试设计
from __future__ import annotations

import asyncio
import logging
import random
import time
from dataclasses import dataclass, field
from enum import Enum

from events import Event

logger = logging.getLogger(__name__)


class FailureClass(str, Enum):
    """失败分类------不同类别走不同重试路径。"""
    TRANSIENT = "transient"    # 瞬时:限流、超时、网络抖动
    PERMANENT = "permanent"    # 永久:Schema 不合法、业务拒绝
    UNKNOWN = "unknown"        # 未分类:保守处理


@dataclass
class RetryPolicy:
    """重试策略。"""
    max_attempts: int = 3
    base_delay_s: float = 0.5
    max_delay_s: float = 30.0
    # 指数退避 + 抖动。不加抖动会让所有失败事件在同一时刻重试,
    # 对下游形成二次冲击------这与第 23、24 篇的结论一致
    jitter: bool = True

    def delay_for(self, attempt: int) -> float:
        d = min(self.base_delay_s * (2 ** attempt), self.max_delay_s)
        if self.jitter:
            d *= (0.7 + random.random() * 0.6)
        return d


@dataclass
class DeadLetterQueue:
    """死信队列------不可恢复的事件的最终归宿。

    **绝不能静默丢弃**。丢一条事件,链路就断了,
    而且你永远不会知道是哪断的。
    """
    entries: list[dict] = field(default_factory=list)

    def add(self, event: Event, reason: str,
            failure_class: FailureClass) -> None:
        self.entries.append({
            "event_id": event.id, "type": event.type.value,
            "source": event.source, "subject": event.subject,
            "reason": reason, "failure_class": failure_class.value,
            "dead_at_ms": int(time.time() * 1000)})
        logger.error("[死信] %s (%s):%s", event.type.event_name,
                     failure_class.value, reason)

    def replayable(self) -> list[dict]:
        """可重放的死信------瞬时类失败修复后应能重放。"""
        return [e for e in self.entries
                if e["failure_class"] == FailureClass.TRANSIENT.value]

    def requires_manual(self) -> list[dict]:
        """需要人工介入的------永久失败类。"""
        return [e for e in self.entries
                if e["failure_class"] != FailureClass.TRANSIENT.value]


class ResilientHandler:
    """三层重试处理器。"""

    def __init__(self, policy: RetryPolicy | None = None,
                 dlq: DeadLetterQueue | None = None) -> None:
        self.policy = policy or RetryPolicy()
        self.dlq = dlq or DeadLetterQueue()

    async def handle_with_retry(self, event: Event,
                                processor, classifier) -> None:
        """带三层重试的处理。

        processor: 业务处理函数
        classifier: 异常分类函数,返回 FailureClass
        """
        last_error: Exception | None = None

        for attempt in range(1, self.policy.max_attempts + 1):
            try:
                async with asyncio.timeout(90):
                    await processor(event)
                return
            except asyncio.CancelledError:
                raise
            except Exception as e:
                last_error = e
                fc = classifier(e)

                if fc is FailureClass.PERMANENT:
                    # 永久失败重试无意义,直接死信
                    self.dlq.add(event, str(e), fc)
                    return
                if fc is FailureClass.TRANSIENT and attempt < self.policy.max_attempts:
                    delay = self.policy.delay_for(attempt)
                    logger.warning("[重试] %s 第 %d 次:%s,%.1fs 后重试",
                                   event.type.event_name, attempt, e, delay)
                    await asyncio.sleep(delay)
                    continue
                # 未分类且已达上限 → 保守死信
                self.dlq.add(event, str(e), fc)
                return

logger.error("[重试耗尽] %s:%s", event.type.event_name, last_error)三层结构的意义:
| 层 | 处理什么 | 去向 |
|---|---|---|
| 第一层:即时重试 | 瞬时失败(限流、超时) | 指数退避 + 抖动 |
| 第二层:延迟重试 | 需要等待外部恢复 | 重试队列(重放) |
| 第三层:死信 | 永久失败、未知失败 | 死信队列 + 人工介入 |
replayable() 与 requires_manual() 的区分很重要:瞬时类死信修复后应该能自动重放,永久类必须人工看。不做这个区分,要么什么都要人工(累死),要么什么都能重放(危险)。
5.2 事件回放:从"能审计"到"能重演"
事件驱动的一个独特能力:因为所有事件都被持久化了,你可以重放。
python
# replay.py ------ 事件重放
from __future__ import annotations

import asyncio
import logging
from dataclasses import dataclass
from typing import Callable

from events import Event

logger = logging.getLogger(__name__)


@dataclass
class ReplayFilter:
    """重放过滤条件------最常用的是按时间窗和事件类型。"""
    start_ms: int | None = None
    end_ms: int | None = None
    event_names: set[str] | None = None
    subject_prefix: str | None = None
    # 重放模式
    dry_run: bool = False           # 只统计不真正执行
    skip_completed: bool = True     # 跳过已处理过的事件


async def replay(history: list[Event], target_handler: Callable,
                 flt: ReplayFilter) -> dict:
    """重放历史事件。

    典型用途:
    1. **发布新版本后验证**:用历史事件跑新逻辑,对比结果
    2. **修复数据**:改了判断逻辑后重跑历史事件
    3. **审计取证**:按事件链重建当时的决策过程

    ⚠️ **重放不是幂等的替代**------重放会真正产生副作用,
    生产环境务必配合 dry_run 或独立的重放标记。
    """
    selected = _filter(history, flt)
    stats = {"total": len(history), "selected": len(selected),
             "processed": 0, "failed": 0, "skipped": 0}
    logger.info("重放开始:%d/%d 条事件,dry_run=%s",
                stats["selected"], stats["total"], flt.dry_run)

    for event in selected:
        if flt.dry_run:
            logger.info("[dry-run] %s %s subject=%s",
                        event.type.event_name, event.id, event.subject)
            stats["processed"] += 1
            continue
        try:
            await target_handler(event)
            stats["processed"] += 1
        except Exception as e:
            stats["failed"] += 1
            logger.error("[重放失败] %s:%s", event.id, e)

    logger.info("重放结束:成功 %d 失败 %d",
                stats["processed"], stats["failed"])
    return stats


def _filter(history: list[Event], flt: ReplayFilter) -> list[Event]:
    """按因果链顺序过滤------不能打乱顺序,否则重放结果与当初不同。"""
    out = []
    for e in history:
        if flt.start_ms and e.time_ms < flt.start_ms:
            continue
        if flt.end_ms and e.time_ms > flt.end_ms:
            continue
        if flt.event_names and e.type.event_name not in flt.event_names:
            continue
        if flt.subject_prefix and not (e.subject or "").startswith(
                flt.subject_prefix):
            continue
        out.append(e)
    # 按因果链排序,而非时间戳------与第 27 篇一致
    return _sort_by_causation(out)


def _sort_by_causation(events: list[Event]) -> list[Event]:
    """沿 causation_id 排序,保证重放时看到的信息完整。"""
    by_id = {e.id: e for e in events}
    roots = [e for e in events
             if e.causation_id is None or e.causation_id not in by_id]
    ordered, visited = [], set()

    def walk(e: Event) -> None:
        if e.id in visited:
            return
        visited.add(e.id)
        ordered.append(e)
        for child in events:
            if child.causation_id == e.id:
                walk(child)

    for r in roots:
        walk(r)
    # 并发旁支追加在后
    return ordered + [e for e in events if e.id not in visited]
⚠️ 重放是有副作用的操作。 生产环境必须至少满足其一:①
dry_run=True先验证;② 使用独立的重放标记,让下游能区分"真实事件"与"重放事件"。直接对生产数据重放而不做标记,是最容易出二次事故的做法。
5.3 Schema 演进与事件契约
事件一旦发布出去,就是对外承诺。发出去的事件类型不能随意改字段。
| 变更 | 做法 | 消费者影响 |
|---|---|---|
| 加可选字段 | 直接加 v1.1 类型或原类型加可选字段 |
老消费者忽略未知字段即可 |
| 加必填字段 | 必须新发版本 (v2) |
老消费者不会因缺字段崩溃 |
| 删字段 | 新版本中停止发送 | 老消费者可能仍依赖它 |
| 改字段语义 | 必须新版本 + 双发 | 最危险,版本号也发现不了 |
python
# schema_evolution.py ------ 事件契约演进
from __future__ import annotations

from enum import Enum


class ContentAuditedV1(str, Enum):
    CONTENT_AUDITED_V1 = "content.audited.v1"


class ContentAuditedV2(str, Enum):
    """v2 的变化:verdict 从字符串改为结构化对象,新增审核依据字段。

    ⚠️ 这是一次**语义变更**------verdict 的类型变了。
    因此必须新版本,且双发一段时间,等消费者全部升级后再停 v1。
    """
    CONTENT_AUDITED_V2 = "content.audited.v2"


def build_v2_payload(v1_data: dict) -> dict:
    """从 v1 载荷构造 v2 载荷------双发期间两个消费者都能工作。"""
    return {
        "content_id": v1_data["content_id"],
        "verdict": {
            "decision": v1_data["verdict"],          # 字符串 → 结构化
            "risk_score": v1_data.get("risk_score", 0.0),
            "rule_hits": v1_data.get("rule_hits", []),
        },
        "reviewer": {
            "agent_id": v1_data.get("reviewer_agent"),
            "model": v1_data.get("model"),
        },
        "audit_trail": v1_data.get("audit_trail", []),
}双发期的三个纪律:
- v1 与 v2 事件并行发布,消费者按需订阅自己需要的版本。
- 监控 v1 的消费速率归零后再停止发布 v1------不要靠时间估算。
dataschema字段指向真实的 JSON Schema,让消费者可以自动校验。
5.4 观测:事件驱动的六个必备指标
| 指标 | 健康值 | 异常含义 | 计算方式 |
|---|---|---|---|
| 端到端延迟 | 按业务 | 从提交到发布的总耗时 | published.time_ms - submitted.time_ms |
| 消费积压 | < 1000 | 队列积压,消息进得多出得少 | 队列长度 |
| 重复投递率 | < 0.1% | 幂等没做好或上游重投过多 | skipped / delivered |
| 死信率 | < 0.5% | 某类事件系统性失败 | dlq / total |
| 重试次数分布 | 集中在 1 次 | 大量 3 次说明下游不稳 | 重试直方图 |
| 孤儿事件率 | 接近 0 | causation_id 指向不存在的事件 |
事件扫描 |
其中"孤儿事件率"是事件驱动特有的健康指标:
python
def orphan_rate(history: list[Event], window_ms: int) -> dict:
    """孤儿事件分析------因果链断裂的可观测手段。

    孤儿事件的成因:
    1. 上游事件未持久化(只发了子事件)
    2. 存储保留策略截断了父事件
    3. 因果指针填错(手写 ID 而非用 child() 自动生成)
    """
    ids = {e.id for e in history}
    by_time = sorted(history, key=lambda e: e.time_ms)

    orphans = []
    for e in by_time:
        if e.causation_id is None:
            continue
        if e.causation_id in ids:
            continue
        # 父事件可能只是不在当前查询窗口内------这不算孤儿
        parent_time = e.time_ms - window_ms
        if not any(x.id == e.causation_id and x.time_ms >= parent_time
                   for x in by_time):
            orphans.append(e)

    rate = len(orphans) / max(len(by_time), 1)
    return {
        "total": len(by_time),
        "orphans": len(orphans),
        "rate": round(rate, 4),
        "sample_types": sorted({e.type.event_name for e in orphans})[:5],
        # 孤儿率高通常意味着因果指针填错,或保留策略不当
        "actionable": rate > 0.01,
    }
孤儿事件率超过 1% 就该查 。它指向三类问题:上游没持久化、保留策略截断、因果指针填错。第 3 类最隐蔽 ------手工填 causation_id 出错的概率远高于用 child() 自动生成。
六、对照:CloudEvents 与消息中间件选型
6.1 CloudEvents 的成本与收益
| 维度 | 说明 |
|---|---|
| 收益 | 同一份事件跨 Kafka/NATS/SQS/EventBridge 传输;路由与过滤基础设施传输层无关;生态统一便于调试 |
| 成本 | 每个事件多约 10 个字段;需要 SDK 或手工维护;团队要学一个新概念 |
| 何时值得 | 需要跨多个消息系统,或事件要被外部系统消费 |
| 何时不值得 | 只用单一消息中间件、事件不出内部边界 |
我的判断 :如果你的事件只走一种消息中间件、只给内部系统消费,CloudEvents 的收益不大------它主要解决的是跨传输层互操作,而单一中间件内部本来就不存在这个问题。
但如果你正在做多云架构 ,或者事件要给外部合作方消费,那 CloudEvents 是几乎必需的------否则每加一个目标系统就要做一次字段映射。
6.2 消息中间件选型
| 中间件 | 部署 | 顺序保证 | 事务支持 | 运维成本 | 适合 |
|---|---|---|---|---|---|
| Redis Stream | 自建/托管 | 按流有序 | ❌ | 低 | 中小规模首选 |
| Kafka | 自建/托管 | 分区有序 | ✅(较重) | 高 | 大规模、高吞吐 |
| NATS | 自建/托管 | 队列组 | ❌ | 低 | 低延迟、轻量 |
| SQS / EventBridge | 托管 | ❌ | ❌ | 最低(云上) | 云上、不想运维 |
| RabbitMQ | 自建 | 队列有序 | ❌ | 中 | 复杂路由 |
决策树:
事件能否丢失?
├─ 能 → 进程内 asyncio.Queue
└─ 不能
   ├─ 是否在云上?
   │  ├─ 是 → SQS / EventBridge(托管,运维成本最低)
   │  └─ 否
   │     ├─ QPS < 1000? → Redis Stream(运维成本接近数据库)
   │     └─ QPS > 1000?
   │        ├─ 需要强顺序? → Kafka(按 subject 分区)
   │        └─ 只要求低延迟 → NATS
6.3 三种架构的对比
| 维度 | 同步调用 | 轻量事件(进程内队列) | 完整事件驱动(Kafka) |
|---|---|---|---|
| 延迟 | 最低 | +ms 级 | +10ms 级 |
| 运维成本 | 最低 | 极低 | 高 |
| 新增消费者 | 改代码 | 改代码 | 配置即可 |
| 失败隔离 | ❌ 一环失败全链失败 | ✅ | ✅ |
| 持久化 / 重放 | ❌ | ❌(重启丢失) | ✅ |
| 横向扩展 | 受限于单进程 | 受限于单进程 | ✅ |
| 分布式追踪 | 需自己埋 | 需自己埋 | ✅ 生态成熟 |
| 适合规模 | 小 | 中小 | 大 |
我的建议 :从同步开始,当出现"需要一个下游做 X"的需求时,引入轻量事件;当出现"这个流程要跑几天、要能重放"的需求时,再上完整事件驱动。
不要一步跳到 Kafka。 中间那一步(进程内事件)的成本极低,能解决大部分解耦需求,而代价几乎为零。
七、适用边界与风险提示 ⚠️
7.1 事件驱动适合什么
✅ 一个事件需要多个下游消费:加下游不需要改上游代码。
✅ 下游处理时间不可控:有的快(100ms)、有的慢(30 秒),不应该让上游等。
✅ 失败需要独立重试:某个环节失败不该拖累整条链路。
✅ 需要审计与重放:事件持久化后可以重建决策过程,支持取证与修复。
✅ 流量波动大:事件总线可以削峰,突发流量先进队列慢慢消化。
✅ 上下游由不同团队维护:事件契约是接口,比函数调用更稳定。
7.2 事件驱动不适合什么
❌ 用户同步等待结果:事件驱动反而增加延迟(要等轮询或推送)。
❌ 链路只有 2 环且都很快:总线开销超过收益。
❌ 需要立即拿到结果做下一步判断:事件是异步的,这是它的本质特征。
❌ 强一致要求且链路短:同步调用的强一致性保证更直接。
❌ 团队无人维护过消息中间件:运维与排查成本高。
❌ 只是"想解耦":函数内部的模块划分就能解耦,不需要引入总线。
7.3 六个典型陷阱
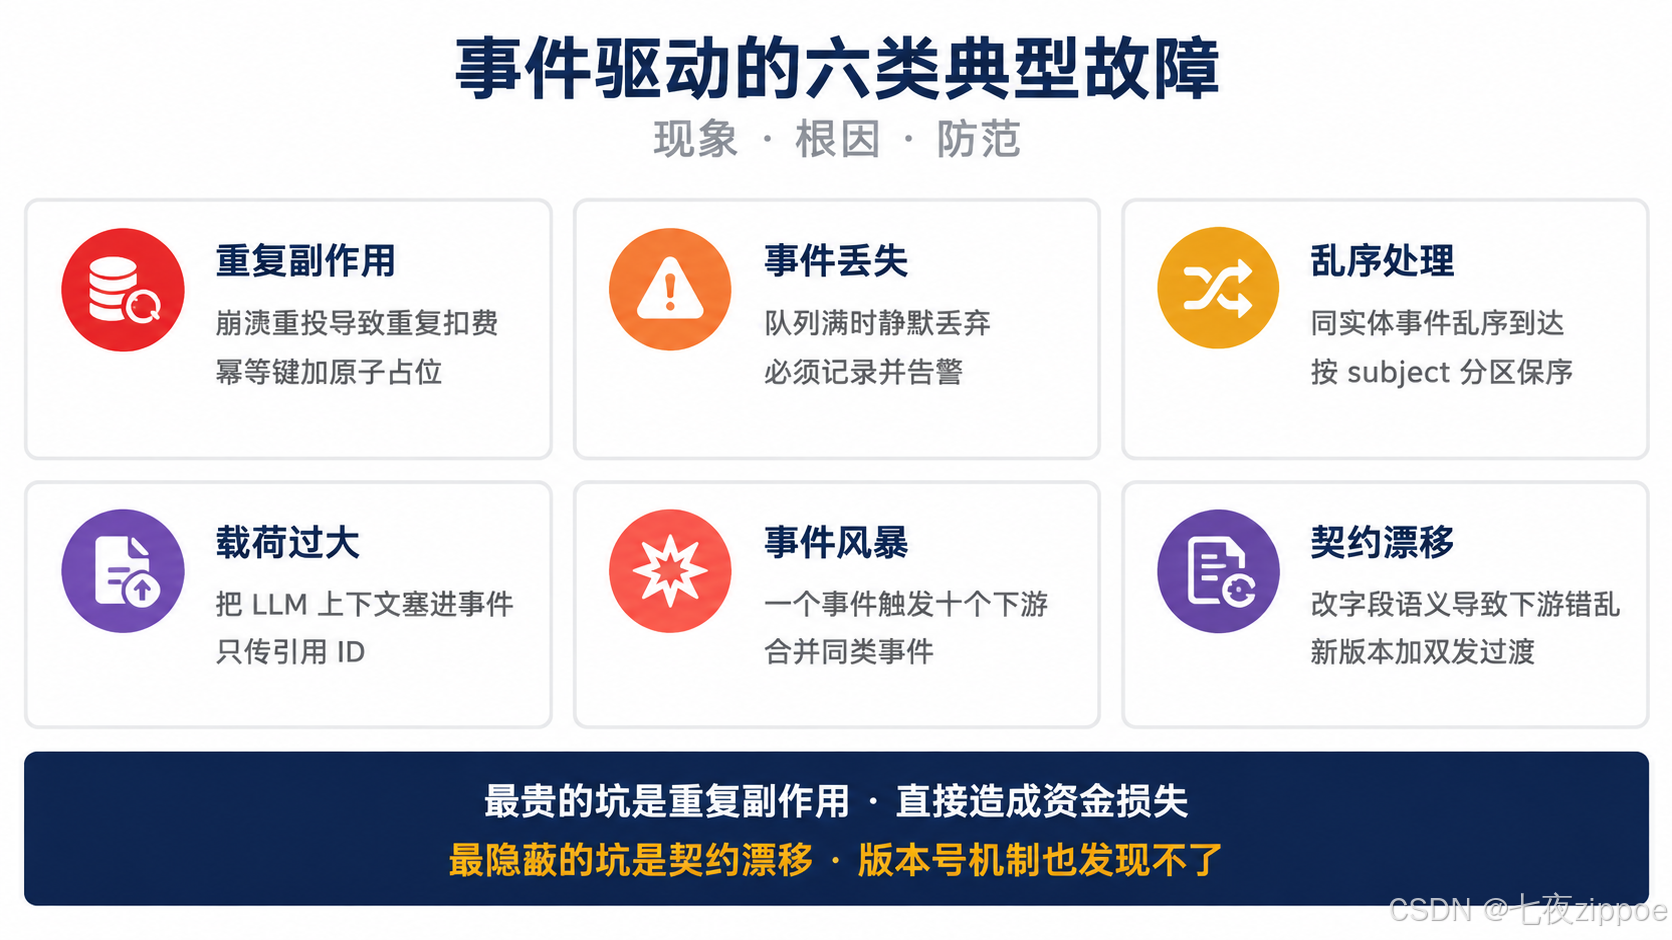
图3:事件驱动的六类典型故障------重复副作用、事件丢失、乱序处理、载荷过大、事件风暴与契约漂移
陷阱一:重复副作用
at-least-once 语义下,崩溃重投导致同一任务处理两次。这是代价最高的一类------LLM 调用会真实产生费用,且两次结果可能不一致。
解决 :幂等键 + 原子占位 (不只是 exists 检查)+ 处理成功后才提交位点。
陷阱二:事件静默丢失
队列满时丢弃事件且不记录------链路断了,你还不知道。
解决:丢弃必须记录并告警;更严格的做法是阻塞发布者或转入备用队列。
陷阱三:乱序处理
同实体的事件乱序到达,消费者基于不完整信息决策。
解决 :按 subject 分区保证同实体有序;用 causation_id 判断"我在等什么";监控顺序异常。
陷阱四:载荷过大
把整个 LLM 上下文塞进事件,撑爆消息中间件。
解决 :载荷只传引用 ID,大对象放对象存储。加 MAX_DATA_BYTES 护栏(4.1 节)。
陷阱五:事件风暴
一个事件触发十个下游,每个下游又发三个事件------消息量指数增长。
解决:合并同类事件(如"用户信息变更 5 次"合并成一次);监控单位时间的消息产生量。
陷阱六:契约漂移
改字段语义导致下游错乱,而版本号机制发现不了(字段名与类型都没变)。
解决:语义变更必须新版本 + 双发(5.3 节)。
六个陷阱里,最贵的是陷阱一(直接资金损失) ,最隐蔽的是陷阱六(版本号机制发现不了)。
7.4 实践纪律
⚠️ source 字段绝不能漏。这是 CloudEvents 四个必需属性中最常被忽略的一个,而它是"谁发的"的唯一来源,缺失则整条链路无法追溯。
⚠️ 事件类型用反向 DNS + 版本后缀。全局唯一 + 版本可过滤,两个价值都在名字里。
⚠️ 死信队列绝不能静默丢弃。丢一条事件链路就断了,而且你永远不知道是哪断的。瞬时类应可重放,永久类必须人工介入。
⚠️ 重放要有隔离标记。直接对生产数据重放而不标记,是最容易出二次事故的做法。
⚠️ 不要因为"Kafka 是标配"就用 Kafka。对中小规模系统,Redis Stream 的运维成本接近数据库,Kafka 需要专人。
八、进阶:让事件链路可测
事件驱动的测试有一个独特优势:事件是数据,可以直接构造、断言、回放。
python
# test_eventing.py ------ 事件驱动的分层测试
import pytest

from bus import EventBus, Subscription
from consumer import DurableConsumer, IdempotencyStore
from events import Event, EventType, validate_payload_size, MAX_DATA_BYTES


def make_event(etype=EventType.CONTENT_SUBMITTED, eid="e1",
               subject="content/T1", corr="C1", data=None) -> Event:
    return Event(type=etype, source="/test", id=eid,
                 subject=subject, correlation_id=corr,
                 causation_id=None, data=data or {"content_id": "T1"})


class Recorder(DurableConsumer):
    """记录型消费者------测试用,把处理过的 payload 记下来。"""

    def __init__(self, name="rec", store=None, fail_times=0,
                 fail_with=None):
        super().__init__(name, store or IdempotencyStore(), max_retries=1)
        self.received: list[dict] = []
        self.fail_times = fail_times
        self.fail_with = fail_with or RuntimeError("模拟失败")

    async def process(self, event: Event) -> None:
        if self.fail_times > 0:
            self.fail_times -= 1
            raise self.fail_with
        self.received.append(event.data)


class TestEventModel:
    """事件模型的基础约束。"""

    def test_partition_key_prefers_subject(self):
        """分区键优先用 subject------同实体的事件才需要保序。"""
        e = make_event(subject="content/T1", corr="C1")
        assert e.partition_key() == "content/T1"

    def test_type_parsing(self):
        """类型名可拆解为名称与版本。"""
        assert EventType.CONTENT_SUBMITTED.event_name == "content.submitted"
        assert EventType.CONTENT_SUBMITTED.version == 1

    def test_oversized_payload_rejected(self):
        """载荷超限必须报错,而不是让它流到消费者。"""
        big = Event(type=EventType.CONTENT_SUBMITTED, source="/t",
                    id="e", data={"blob": "x" * (MAX_DATA_BYTES + 100)})
        with pytest.raises(ValueError, match="超过上限"):
            validate_payload_size(big)

    def test_optional_fields_defaults(self):
        """可选字段有合理默认值,不强制填写。"""
        e = Event(type=EventType.CONTENT_SUBMITTED, source="/t", id="e")
        assert e.time_ms > 0
        assert e.specversion == "1.0"
        assert e.datacontenttype == "application/json"


class TestIdempotency:
    """幂等------事件驱动最重要的保障。"""

    @pytest.mark.asyncio
    async def test_same_event_processed_once(self):
        store = IdempotencyStore()
        rec = Recorder(store=store)
        e = make_event(eid="fixed")
        await rec.handle(e)
        await rec.handle(e)
        assert len(rec.received) == 1, "同事件不应被处理两次"

    @pytest.mark.asyncio
    async def test_different_ids_both_processed(self):
        rec = Recorder()
        await rec.handle(make_event(eid="e1"))
        await rec.handle(make_event(eid="e2"))
        assert len(rec.received) == 2

    @pytest.mark.asyncio
    async def test_acquire_prevents_concurrent_execution(self):
        """原子占位------幂等在并发下生效的关键。

        这条测试守护的是 acquire 而非 exists。
        如果实现退化成只做 exists 检查,这条测试会失败。
        """
        store = IdempotencyStore()
        key = "k1"
        assert store.acquire(key) is True
        assert store.acquire(key) is False, "占位后第二次必须失败"
        store.mark_done(key)
        assert store.acquire(key) is False, "已完成的不应再占位"

    @pytest.mark.asyncio
    async def test_failure_allows_retry(self):
        """失败要释放占位,否则事件永远无法重试。"""
        store = IdempotencyStore()
        rec = Recorder(store=store, fail_times=10)
        with pytest.raises(Exception):
            await rec.handle(make_event(eid="retry-me"))
        # 失败后应能重新获得处理权
        assert store.acquire(Recorder(store=store).store.make_key(
            make_event(eid="retry-me"))) is True

    @pytest.mark.asyncio
    async def test_expired_processing_is_gc_ed(self):
        """超时的处理中记录必须被清理,否则幂等记录变成死锁源。"""
        store = IdempotencyStore(ttl_s=0.01)
        key = "k-gc"
        store.acquire(key)
        import asyncio
        await asyncio.sleep(0.05)
        assert store.acquire(key) is True, "过期记录应被清理后重新可占位"


class TestPartitionOrdering:
    """分区有序------同 subject 串行,跨 subject 并行。"""

    @pytest.mark.asyncio
    async def test_same_subject_sequential(self):
        """同 subject 的事件必须按顺序处理。"""
        order: list[str] = []

        async def slow_handler(event: Event) -> None:
            # 故意让第一个事件慢,验证第二个不会抢先
            await __import__("asyncio").sleep(0.05 if event.data["n"] == 1 else 0)
            order.append(event.data["n"])

        bus = EventBus()
        bus.subscribe(Subscription(event_name="content.submitted",
                                   handler=slow_handler, group_id="g"))
        task = __import__("asyncio").create_task(bus.start_workers())
        await __import__("asyncio").sleep(0.05)

        for n in (1, 2, 3):
            await bus.publish(make_event(
                subject="content/SAME", eid=f"e{n}", data={"n": n}))
        await __import__("asyncio").sleep(0.4)
        task.cancel()
        assert order == [1, 2, 3], f"同 subject 应保序,实际 {order}"

    @pytest.mark.asyncio
    async def test_different_subjects_not_blocking(self):
        """不同 subject 不应互相阻塞------这是分区的价值。"""
        done: set[str] = set()

        async def handler(event: Event) -> None:
            await __import__("asyncio").sleep(0.1)
            done.add(event.data["cid"])

        bus = EventBus(partition_concurrency=8)
        bus.subscribe(Subscription(event_name="content.submitted",
                                   handler=handler, group_id="g"))
        task = __import__("asyncio").create_task(bus.start_workers())
        await __import__("asyncio").sleep(0.05)

        for i in range(3):
            await bus.publish(make_event(
                subject=f"content/D{i}", eid=f"e{i}",
                data={"cid": f"D{i}", "n": 1}))
        # 三个不同 subject 并行,150ms 内应全部完成
        await __import__("asyncio").sleep(0.15)
        task.cancel()
        assert len(done) == 3, f"不同 subject 应并行,实际完成 {done}"


class TestSubscription:
    """订阅匹配与消费者组语义。"""

    @pytest.mark.asyncio
    async def test_wildcard_receives_all(self):
        """通配订阅应收到全部类型事件(审计场景)。"""
        rec = Recorder(name="audit")
        bus = EventBus()
        bus.subscribe(Subscription(event_name="*", handler=rec.handle,
                                   group_id="audit", is_wildcard=True))
        task = __import__("asyncio").create_task(bus.start_workers())
        await __import__("asyncio").sleep(0.05)

        await bus.publish(make_event(etype=EventType.CONTENT_SUBMITTED, eid="a"))
        await bus.publish(make_event(etype=EventType.CONTENT_SCANNED, eid="b"))
        await __import__("asyncio").sleep(0.2)
        task.cancel()
        assert len(rec.received) >= 1, "通配订阅应收到事件"

    @pytest.mark.asyncio
    async def test_type_filtering(self):
        """非订阅类型的事件不应投递。"""
        rec = Recorder()
        bus = EventBus()
        bus.subscribe(Subscription(event_name="content.audited",
                                   handler=rec.handle, group_id="g"))
        task = __import__("asyncio").create_task(bus.start_workers())
        await __import__("asyncio").sleep(0.05)

        await bus.publish(make_event(etype=EventType.CONTENT_SUBMITTED, eid="x"))
        await __import__("asyncio").sleep(0.15)
        task.cancel()
assert len(rec.received) == 0, "订阅外的类型不应投递"代码说明:
test_acquire_prevents_concurrent_execution是本篇最重要的测试 。它守护的是acquire而非exists------如果实现退化成只做存在性检查,这条测试会立刻失败。这个区别在低并发测试下完全看不出来。test_same_subject_sequential验证分区保序 。它故意让第一个事件处理最慢,验证第二个不会抢先------这是分区有序性的真正判据。test_different_subjects_not_blocking验证分区并行的价值 。三个不同 subject 的事件应在 150ms 内全部完成(串行需要 300ms)。这验证的是分区机制存在的意义:既保序又不阻塞。test_expired_processing_is_gc_ed守护死锁防护 。如果实例崩溃在acquire之后,这条记录会永久卡住所有后续重试。- 全套测试零 LLM 调用、无外部依赖,毫秒级完成。
九、总结
回到文章开头的问题:为什么需要事件驱动? 因为同步调用的三个天花板------下游忙上游只能干等、一个事件要写五遍调用链、失败了只能从头重试------都指向同一个解法:把"调用"改成"发事件"。Agent 从"被调用者"变成"事件响应者",时间与空间双双解耦。
这一路走下来,可以提炼出四个核心认知:
第一,事件驱动的核心价值是"空间解耦",不是"解耦"本身。 时间解耦(发布完就返回)很容易理解,但空间解耦的价值更深------新增一个下游消费者不需要改任何现有代码。这不只是省事,而是架构上的自由:你可以随时接入日志、风控、通知系统而不惊动任何现有组件。
第二,at-least-once 是既定现实,幂等是必答题。 主流消息中间件提供的是 at-least-once 语义,因为 exactly-once 需要分布式事务、成本极高。工程共识是接受 at-least-once + 用幂等去重。 但幂等的关键细节常被跳过:只做 exists 检查是不够的,必须加原子占位(acquire) ,否则两个并发消息会同时通过检查。以及------处理成功后才提交位点,反过来写会让失败的事件被误认为已完成、永不重试。
第三,事件总线天然带因果链,但顺序要靠分区而非时间戳。 总线保留了所有历史事件,这使重放、审计、取证成为可能。但同实体的事件必须有明确分区键(如 subject),否则乱序到达会让消费者基于不完整信息决策 。因果关系依然要靠 causation_id 表达(第 27 篇的机制在这里延续)------保序是分区给的,因果是指针给的,两者是互补的。
第四,从同步到事件驱动要分级跳,不要一步到 Kafka。 中间那一步(进程内事件总线)成本极低,能解决大部分解耦需求,代价几乎为零。只有当出现"这个流程要跑几天、要能重放"的需求时,才值得上完整消息中间件。 对中小规模系统,Redis Stream 的运维成本接近数据库,而 Kafka 需要专人------不要因为"Kafka 是标配"就用 Kafka。
架构选型速览:
| 场景 | 方案 |
|---|---|
| 用户同步等待结果 | 同步调用,别上事件 |
| 加下游不想改上游代码 | 进程内事件总线 |
| 事件不能丢 + 云上 | SQS / EventBridge(托管) |
| 事件不能丢 + 中小规模 | Redis Stream |
| 万级 QPS + 需要强顺序 | Kafka(按 subject 分区) |
| 需要跨多个消息系统 | CloudEvents 1.0 信封 |
最后一句提醒 :事件驱动的最大风险不是技术,是心智模型 。它要求你从"调用链"思维切换到"事实流"思维------过去发生的事不会因为你现在需要它而改变时序。这个转变一旦完成,回路会很自然;转不过去,就会陷入"事件发布了但没人消费""事件消费了但顺序不对"的反复调试。
落地自检清单(Checklist)
交付前逐项确认你的事件驱动实现是否达标:
- ✅ 四个必需属性齐备:
specversion/type/source/id(尤其source不漏) - ✅ 事件类型用反向 DNS + 版本后缀(全局唯一 + 可过滤版本)
- ✅
subject或correlation_id作为分区键,同实体保序 - ✅ 载荷有大小上限护栏,大对象用引用 ID
- ✅ 幂等用
acquire原子占位 ,不只是exists检查 - ✅ 处理成功后才标记完成(位点提交在副作用之后)
- ✅ 失败时释放占位,允许重试
- ✅ 超时的处理中记录有 GC 清理(防幂等死锁)
- ✅ 错误分三类:可重试 / 不可重试 / 未知,退避含抖动
- ✅ 死信队列存在且不静默丢弃,瞬时类可重放、永久类人工介入
- ✅ 队列满/背压时记录并告警,不静默丢弃
- ✅
causation_id由框架自动生成(非手工填写),孤儿率 < 1% - ✅ 语义变更走新版本 + 双发,按消费速率归零后再停旧版
- ✅ 重放有
dry_run或独立重放标记,不裸跑生产数据 - ✅ 接入观测:端到端延迟、积压、重复投递率、死信率、重试分布、孤儿率
- ✅ 监控单位时间消息产生量,防事件风暴
- ✅ 中间件按规模选型,未过度引入 Kafka
- ✅ 事件驱动测试零外部依赖,幂等与分区有序均有测试锁定
常见问题(FAQ)
Q1:什么时候该用事件驱动,什么时候该用同步调用?
问自己一句:"我需要等它完成,还是只需要知道它发生了?" 需要等 → 同步;只需要知道 → 事件。第二个信号是"我要不要加一个新下游"------要加且不想改上游代码,就该用事件了。第三个信号是"这个环节失败了要不要拖累其他环节"------不要拖累就该用事件。
Q2:如何保证事件不丢?
分三层:① 消息中间件本身的持久化(Kafka 的副本、Redis Stream 的 AOF);② 队列满时的处理必须记录并告警 ,不能静默丢弃;③ 生产者侧的确认机制(Kafka 的 acks=all)。最常见的丢事件原因是第三层没配好------生产者以为发出去了,实际没落盘。
Q3:消费顺序保证了还需要因果链吗?
需要,两者互补。 分区保证的是同 subject 内 的顺序,而跨 subject、跨 correlation_id 的顺序由分区管不了。而且分区可能配错------所以 causation_id 是独立的正确性保障 :消费者靠它知道自己该等哪些前置事件。顺序是优化,因果是保证。
Q4:为什么消费者要"先处理、后提交位点"?
反过来的话,崩溃时消息已被标记为完成,重投时会被跳过,导致副作用丢失 。先处理后提交,崩溃时消息重投,但因为有幂等保护,重复执行不产生重复副作用------代价是最坏情况下多做一次,收益是绝不会漏。
Q5:事件风暴(一个事件触发大量下游)怎么解?
根因通常是事件粒度太细 。解法:① 合并同类事件("用户信息变更 5 次"合成一次);② 某些下游直接订阅上游事件而非中间事件(省一跳);③ 监控单位时间的消息产生量,设阈值告警。如果你的架构产生事件的速度超过下游处理能力的三倍,问题在设计不在容量。
Q6:跨服务的事件契约怎么保证不被破坏?
三层:① dataschema 指向真实 JSON Schema,消费者可自动校验;② 版本后缀 + 双发过渡;③ 监控老版本的消费速率,归零后才下线 。最关键的是第三条------不要靠时间估算消费者是否升级完了,要看数据。
Q7:事件驱动怎么调试?
三招:① 事件历史查询 ------按 correlation_id 拉出全链路(第 27 篇的 ID 在这里价值凸显);② 因果链重建 ------沿 causation_id 还原决策过程;③ 重放验证 ------用历史事件跑新逻辑对比结果。前提是所有事件都被持久化了且保留期足够长,这本身就是选型时要考虑的。
Q8:进程内事件总线够用吗?
中小规模够用,但要接受两个限制:重启丢失 (内存态)、无法横向扩展 (单进程上限)。如果这两个限制能接受,就不要上 Kafka------省下的运维成本往往能覆盖一整年的人力。真正需要换的时候,通常是因为"事件要跨进程"或"事件要能重放"这两个硬需求。
参考资料
- CloudEvents 官方规范(CNCF,v1.0,传输层无关的事件信封):https://cloudevents.io/
- CloudEvents 官方 SDK(Python 等多语言):https://github.com/cloudevents/sdk-python
- Redis Stream 官方文档(持久化消息流与消费者组):https://redis.io/docs/latest/develop/data-types/streams/
- Apache Kafka 官方文档 ------ 消息语义、消费者组与分区有序性:https://kafka.apache.org/documentation/
- Martin, R. C. --- Building Event-Driven Systems (事件驱动架构的系统性论述):https://building-event-driven-systems.com/
- Fowler, M. --- Event Notification (Martin Fowler 关于事件通知机制的分析,Event Notification vs Event Collaboration 的区分):https://martinfowler.com/eaaDev/EventNotification.html
- Richardson, M. --- Microservices Patterns (Saga 与事件驱动的数据一致性模式):https://microservices.io/patterns/
- AWS 架构博客 ------ EventBridge 与消息中介的集成模式:https://aws.amazon.com/blogs/compute/