读完阿里百炼网关团队那篇《限流比降 10 倍:百炼网关如何用 RocketMQ LiteTopic 重构大模型限流》,给了我很大启发------网关还能这么玩。前半段复盘百炼限流的核心思路(固定窗口+漏桶、LiteTopic 分布式漏桶矩阵、Suspend 控速),后半段补上原文跳过的关键一环:消费端调模型后,流式响应怎么回到客户端。这部分是我自己推的,不是百炼的实现。
大模型时代限流变了什么
以前的限流,主要解决"防刷"和"防雪崩"。CPU、内存、带宽都能快速扩,处理起来比较直接。
大模型不一样。GPU 扩容周期长、单价高,供给受硬件交付节奏限制。百炼是阿里云的大模型服务平台,百万级用户同时调千问等几十种大模型。用户从千级涨到百万级后,限流要解决的问题变成了"有限的 GPU 池子怎么分给百万租户,还要各自独立、按需弹性"。
限流误判一次,用户侧就是超时重试甚至业务中断;过载放行一次,就是稀缺 GPU 算力的浪费,还殃及其他租户。
算法选择:固定窗口 + 漏桶
百炼面对的不是单一限流场景,是三类叠在一起:
- SLA 基础限流,要稳定、可计量、可观测
- User + Model 维度的细粒度管控,客户内部多账号也要交叉约束
- 超大客户的突发承接------额度调到很大,突发真来了 GPU 顶不住,硬限大面积 503,放过去又过载
算法上最终选了固定窗口 + 漏桶:
固定窗口而不是滑动窗口,因为滑动窗口太严格,边界处的突发都会精确算到,固定窗口对短期波动更宽容。
漏桶而不是令牌桶,因为漏桶匀速放行,契合 GPU 稳态友好、尖峰敏感的特点。令牌桶天然允许突发,正好是 GPU 最怕的形态。
漏桶必须搬出进程
算法定了,新问题来了:超大客户的突发流量堆在网关进程内存里,几十万请求直接把网关自己打挂。
**漏桶必须从进程内搬到进程外,用一个足够大、足够隔离的外部存储承接缓冲。**把"接住请求"和"按节奏放行"在物理上拆开------这是 LiteTopic 进入视野的起点。
传统 Topic / Group 撑不住
百炼最早用传统 RocketMQ Topic 做漏桶,每个 User + Model 单独建 Topic 和 Consumer Group,再部署一组消费机器。但头部客户接进来后三个痛点全暴露了:
元数据重、生效慢。传统 Topic/Group 要预先创建,生效几十秒,新用户突发流量到了还没建好。
机器利用率低。共享消费模型要求同一 Consumer Group 下订阅完全相同的 Topic 集合,否则堆积甚至丢消息。要隔离客户就得每个客户单独建 Group、单独切机器,哪怕今天一条消息没有,那组机器也常驻。
单 Topic 暴涨株连。硬把多客户塞进同一 Topic,某个用户消息激增,几乎所有消费线程被它占住,其他用户全堵。最后只能退回"一客户一组机器",用机器规模换隔离。
传统方案能服务几个头部突发客户,但没法让任意中大型客户都自动接入漏桶。限流要从"VIP 待遇"变成"平台基础能力",底层得重做。
LiteTopic 的三个差异
LiteTopic 是 RocketMQ 5.x 的轻量级队列,跟传统 Topic 三个关键差异正好对应上面三个痛点。
轻量元数据:单 Broker 撑百万级 LiteTopic,运行时按需创建、按 TTL 自动回收。客户端往不存在的 LiteTopic 发消息就自动建出来,没活动一段时间 Broker 自动清理。
差异化订阅:同一 Consumer Group 下不同实例可以订阅不同的 LiteTopic 子集,不会堆积也不会丢。所有租户共享一组消费 Pod,不再需要一客户一组机器。
Suspend 消费控制:消费回调里返回 Suspend N(毫秒),Broker 就在 N 毫秒内暂停拉取这个 LiteTopic,不影响其他 LiteTopic。这是漏桶在 Broker 层落地的关键开关。
重构后的架构
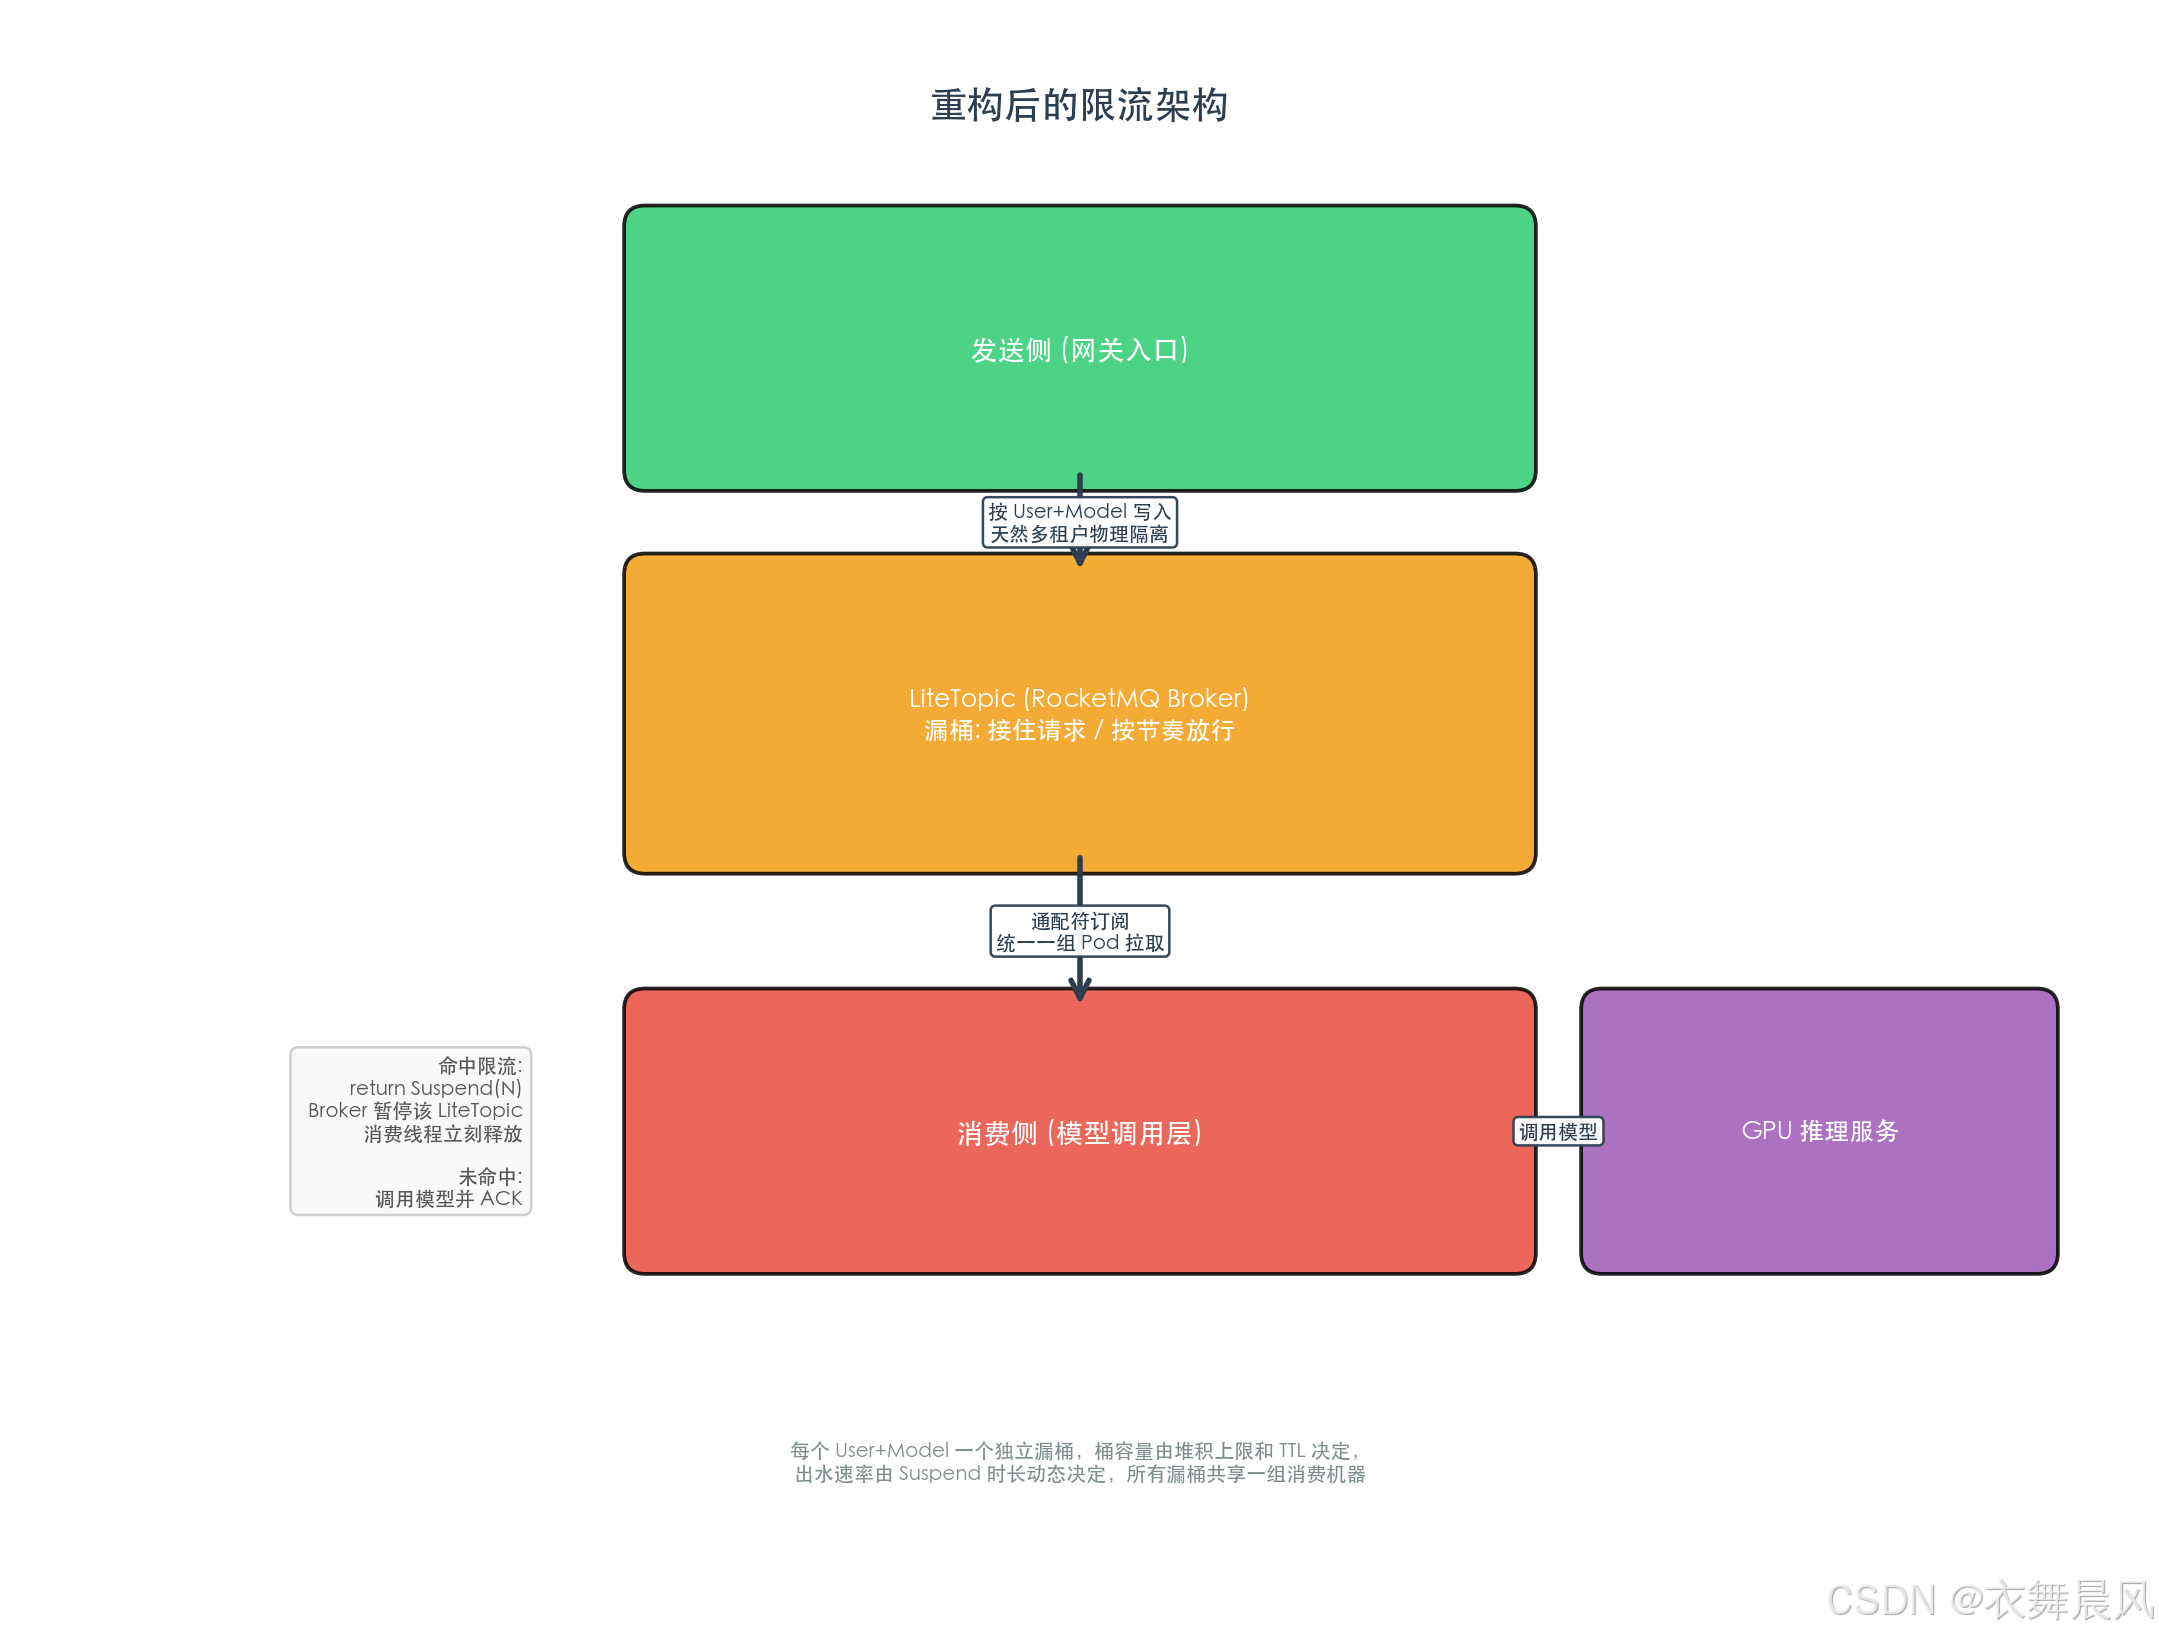
每个 User + Model 一个独立漏桶,桶容量由 LiteTopic 堆积上限和 TTL 决定,出水速率由消费侧 Suspend 时长动态决定。所有漏桶共享一组消费机器,资源随总流量伸缩,不按客户数线性增长。
Suspend 到底做了什么
架构图里那行"命中限流 → return Suspend(N),Broker 暂停该 LiteTopic",展开讲一下。
消费端拉到一条消息后,先跑限流判断。判断结果是要么放行、要么暂停。如果暂停,消费端不调模型、不 ACK,而是告诉 Broker:"这个 LiteTopic 的下一条消息,N 毫秒之后再给我。"然后消费线程立刻返回,去拉别的 LiteTopic 的消息。
关键在于暂停是 Broker 侧的,不是消费端自己 sleep。Broker 收到 Suspend(N) 后,在这 N 毫秒内不会再把这个 LiteTopic 的消息投递给这个消费端。但同一消费端对其他 LiteTopic 的拉取完全不受影响------其他 LiteTopic 有消息照样拉、照样消费。
时刻 0ms:
  消费端拉到 liteTopic-A-X 的一条消息
  限流判断:需要暂停
  消费端 return Suspend(500) → 消费线程立刻释放

  同时:
  消费端拉到 liteTopic-B-Y 的一条消息    ← 不受影响
  限流判断:放行
  消费端调用模型,正常 ACK

时刻 500ms:
  Broker 恢复对 liteTopic-A-X 的投递
  消费端再次拉到这条消息
  限流判断:可以放行了
  消费端调用模型,正常 ACK
对比一下如果用 Thread.sleep(500) 会怎样:消费线程卡在 sleep 上 500 毫秒不动,这 500 毫秒内这个线程既不消费 liteTopic-A-X 的后续消息,也不消费其他任何 LiteTopic 的消息。如果被限流的 LiteTopic 多了,线程池被占满,没被限流的租户也跟着堆积。
原文有个 POC 对比:订阅 50 个 LiteTopic,前 5 个随机触发 300ms 限流。Thread.sleep(300) 时,被限流的各占一个线程不释放,限流数增到 40 个时线程池几乎耗尽,剩下 10 个正常的全堆积。Suspend(300) 时,消费线程返回后立即释放回线程池,转头服务其他 LiteTopic,被 Suspend 的由 Broker 在 300ms 后重投,结果只有被限流的 5 个堆积,其余 45 个正常。
所以 Suspend 和 Sleep 的区别不是"等不等"------两个都要等 300ms。区别是等待期间那个消费线程能不能去干别的。Suspend 把"等"这件事交给 Broker 计时,消费线程不等,立刻去服务其他租户。
这个机制也是漏桶"匀速放行"的物理实现。假设某个 User + Model 的配额是每秒 10 个请求,消费端每次放行一条消息后 return Suspend(100),Broker 每 100ms 才投递下一条,正好每秒 10 条。配额变了,改 Suspend 的 N 就行,不用重启、不用改配置。
当前 Suspend 最小粒度是 30 毫秒。更细的速率控制需要消费端自己局部 sleep 补充。百炼的实际做法是 Suspend 承担主要漏桶调速,极少数亚 30ms 精度场景用 Sleep 补充。
为什么 LiteTopic 适合当漏桶
桶的容量工程意义上近似无限。进程内队列容量是写死的数字,桶满即拒。LiteTopic 持久化到 Broker 磁盘,单实例百万级队列,堆积上限远超进程内队列,彼此物理隔离。客户尖峰被接住、攒起来、按节奏放行,等几秒再处理几乎总比直接 429 好。
每个 User + Model 一个独立漏桶。隔离变成了命名规则问题:客户 A 的 Model X 进 liteTopic-A-X,客户 B 的进 liteTopic-B-X,Broker 层物理隔离,A 堵了不会传染到 B。租户隔离从"靠业务代码维护"变成"靠基础设施天然提供"。
每个漏桶速率可独立动态调整。Suspend N 由业务策略实时算,毫秒级调整任意一个漏桶的放行速度:重要客户在模型负载高时仍能拿到较高节奏;模型扩容到位后矩阵速率同步上调;某款模型有拥塞苗头,单独收紧那一列漏桶就行。不重启消费组、不改配置、不需要客户感知。
原文没展开的问题:响应怎么回去
文章把核心改动浓缩成三段代码,消费回调这段最关键:
java
@Override
public ConsumeResult consume(MessageView msg) {
    String liteTopic = msg.getLiteTopic();
    long suspendMs = rateLimitPolicy.acquireOrSuspend(liteTopic);
    if (suspendMs > 0) {
        return ConsumeResult.Suspend(suspendMs);
    }
    invokeModel(msg);        // 不限流就直接调模型
    return ConsumeResult.SUCCESS;
}
invokeModel(msg) 这一行,原文没展开。下面的分析是我自己推的,不是百炼的实现------原文没有给出响应回传的细节,这里是我根据这个架构的约束推导出来的一个可行方案。
问题是这样的:客户端的 HTTP 连接握在生产端(网关入口),模型调用却发生在消费端(另一组 Pod)。LLM 响应又是流式的,一个个 token 往外吐。消费端拿到的流式响应,怎么实时回到生产端那条还挂着的客户端连接上?
还有个硬约束:消费线程很宝贵,POC 才 50 个,不能让一个流式响应占住线程 20 秒什么都不干。
为什么响应通道不用 LiteTopic
既然请求通道已经用了 LiteTopic,响应通道为什么不再用一个?因为两个通道要的东西不一样。
请求通道要限流(Suspend 控速)、要缓冲(堆积削峰)、要隔离(百万租户)、可以等几十秒。响应通道这些一个都不需要------chunk 来了就该立刻送,读完即删,天然一对一(按 reqId),每个 chunk 多几毫秒延迟用户都能感知到。
LiteTopic 的三件套能力是给请求通道量身定做的,响应通道用不上。LLM 逐 token 吐,每个 token 间隔几十毫秒,如果响应通道每个 chunk 都走一遍 Broker 的完整链路(路由、持久化、就绪集合通知),每个 token 多 3-5ms。一条响应几百个 token,累积下来流畅度明显下降。Redis 的 XADD/XREAD 是内存操作,亚毫秒级,没有多余动作。
还有队列数量的问题。百炼已经百万级 LiteTopic,响应通道再建一个,每个请求一个,Broker 承载翻倍到 200 万队列。Redis 这边百万个 key 就是一堆字符串,内存占用小一个数量级。
用 Redis Streams 做响应通道
我的思路是用 Redis Streams 做生产端和消费端之间的响应管道,每个请求一个独立 Stream,key 是 response:{reqId}。整条链路有两条通道:请求走 LiteTopic,响应走 Redis,reqId 把它们串起来。
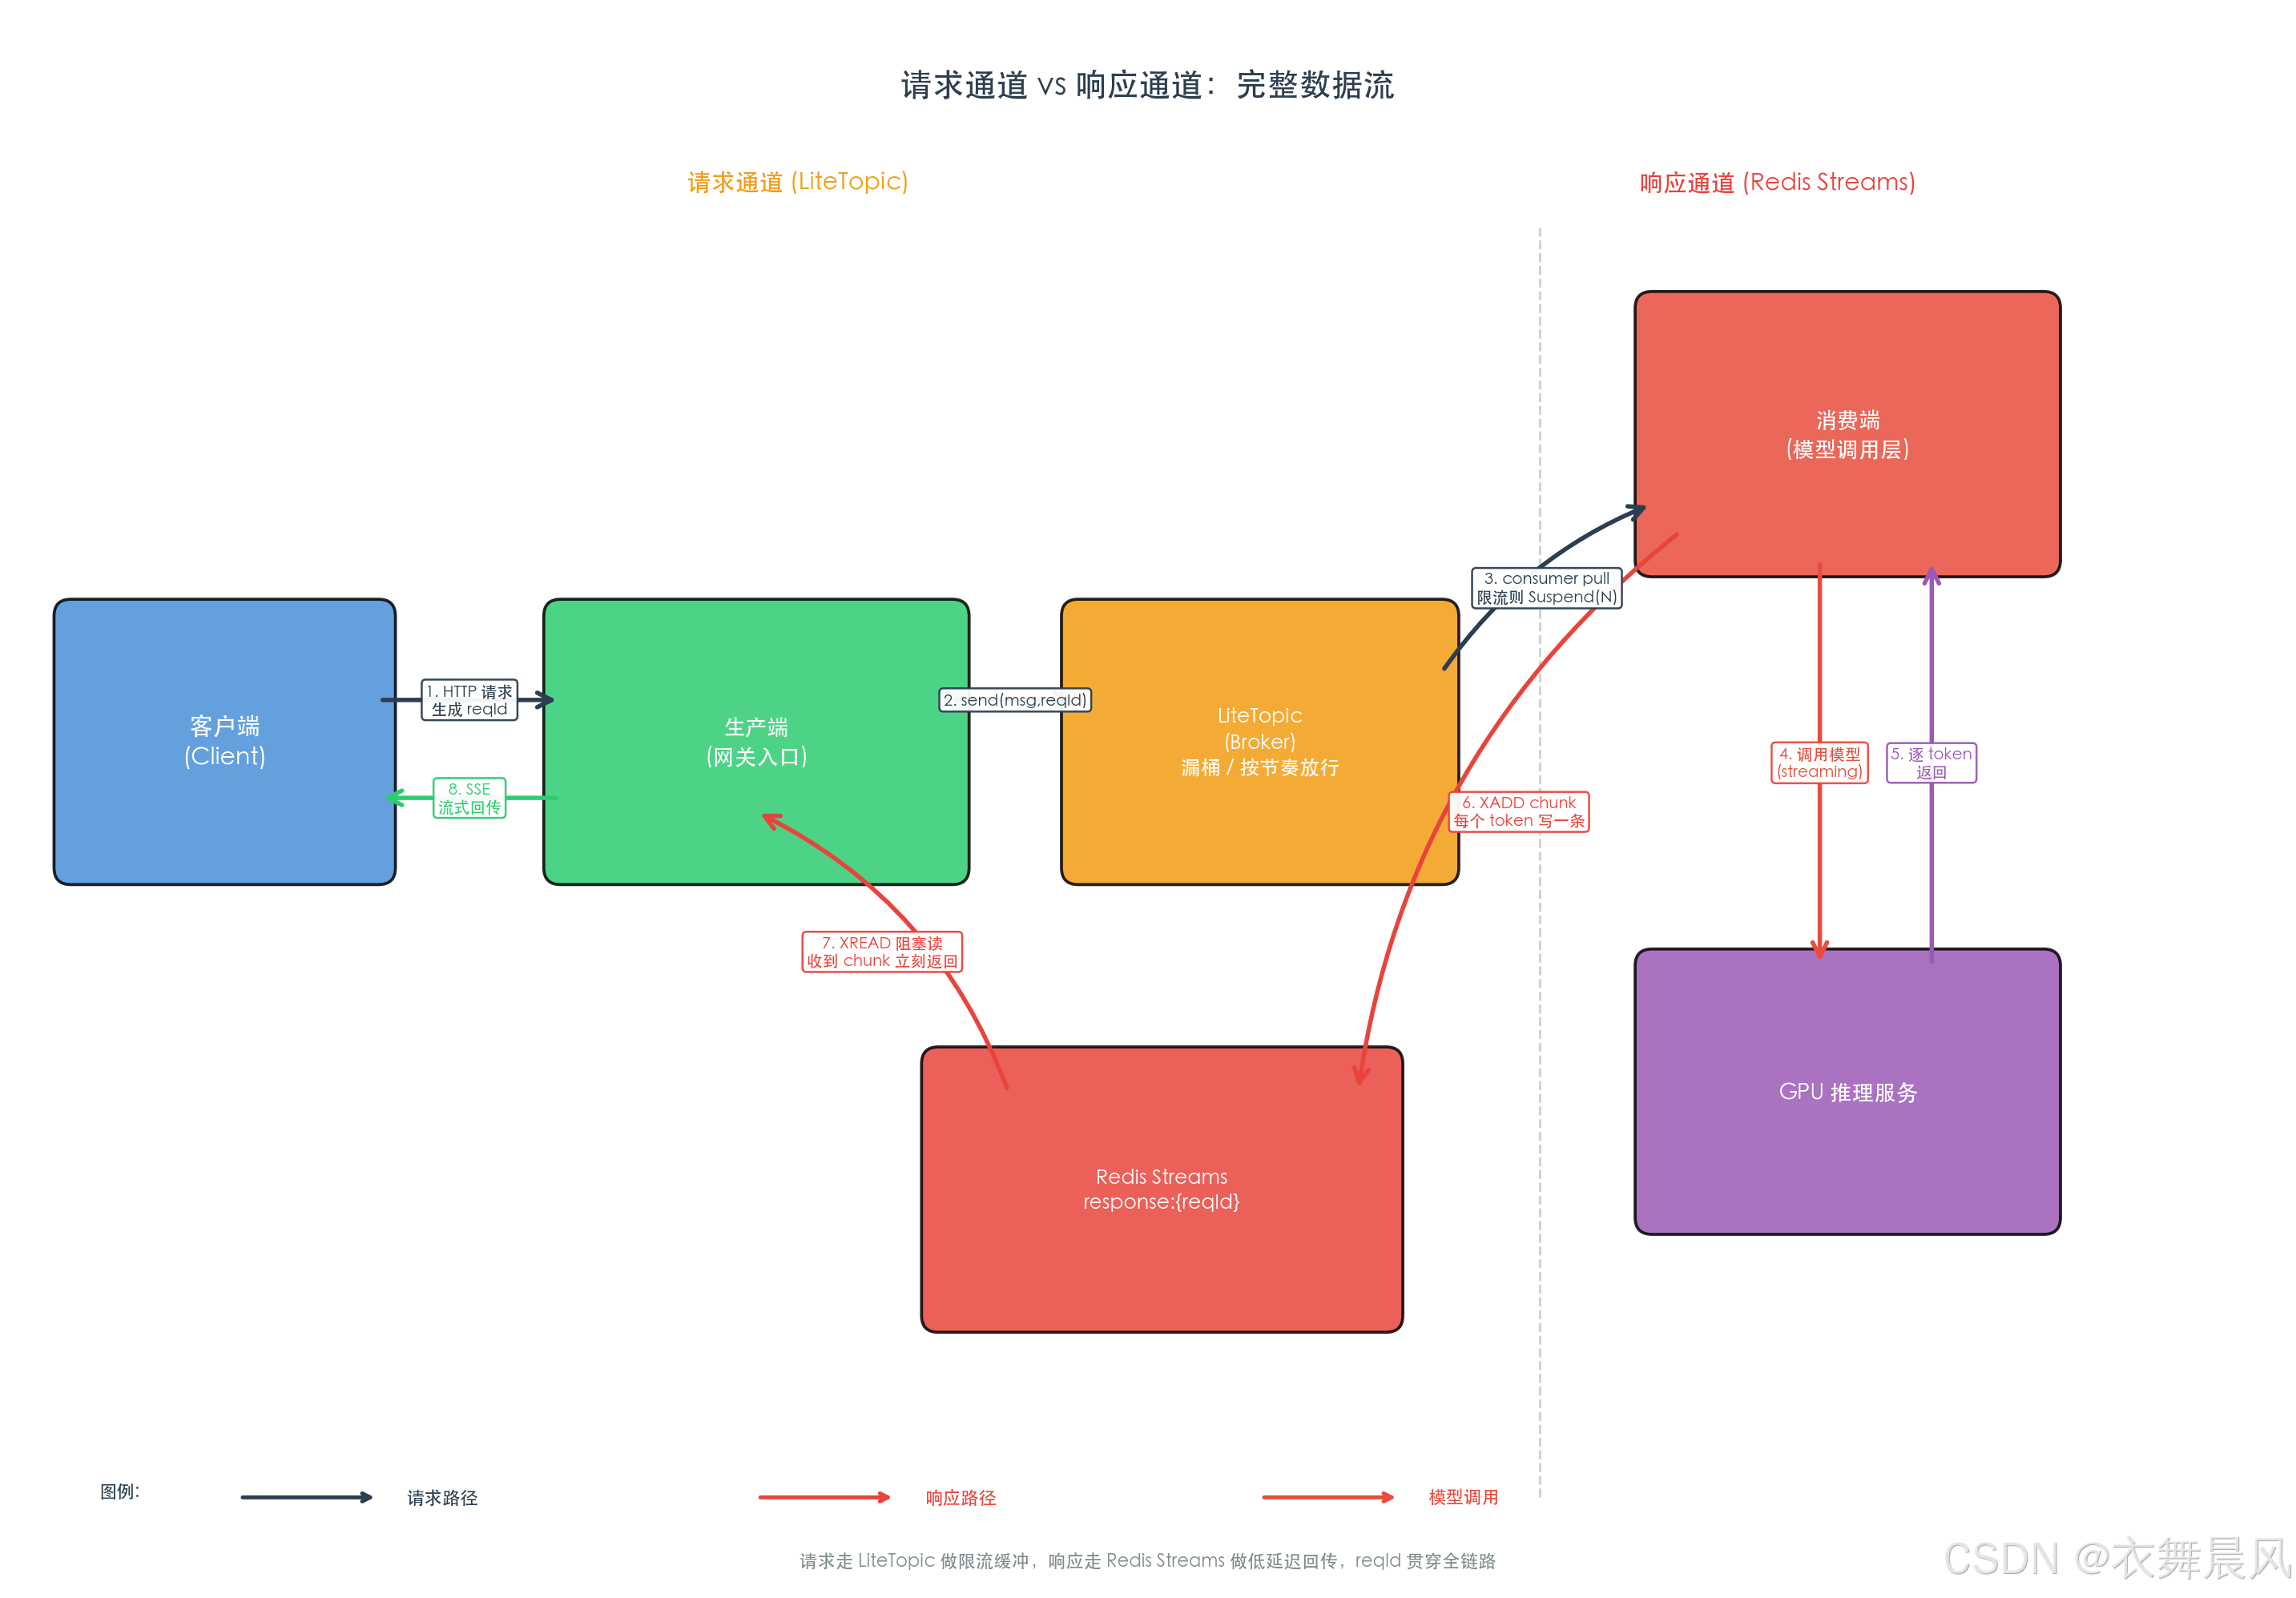
流程按编号看:
- 客户端发 HTTP 请求到生产端,生产端生成 reqId
- 生产端把请求消息连同 reqId 写入 LiteTopic(按 User+Model 路由)
- 消费端从 LiteTopic 拉到消息,命中限流则
return Suspend(N)等待,不命中继续 - 消费端用 reqId 作为关联标识,向 GPU 推理服务发起流式调用
- GPU 逐 token 返回响应
- 消费端每收到一个 chunk,XADD 写入
response:{reqId}这个 Redis Stream - 生产端一直在用 XREAD 阻塞读这个 Stream,收到 chunk 立刻推给客户端
- 生产端通过 SSE 把 chunk 流式推回客户端,循环直到收到 done 标记
两条通道各管各的:LiteTopic 管"请求按什么节奏放行给 GPU",Redis Stream 管"响应以什么延迟回到客户端"。
reqId 贯穿全链路
生产端生成 reqId,随消息写进 LiteTopic 的 header。消费端从消息里取出来,用同样的规则拼出 Redis Stream key 去写响应。生产端用同一个 key 去读。两边不需要额外通知,key 规则是约定好的,reqId 对上就行。
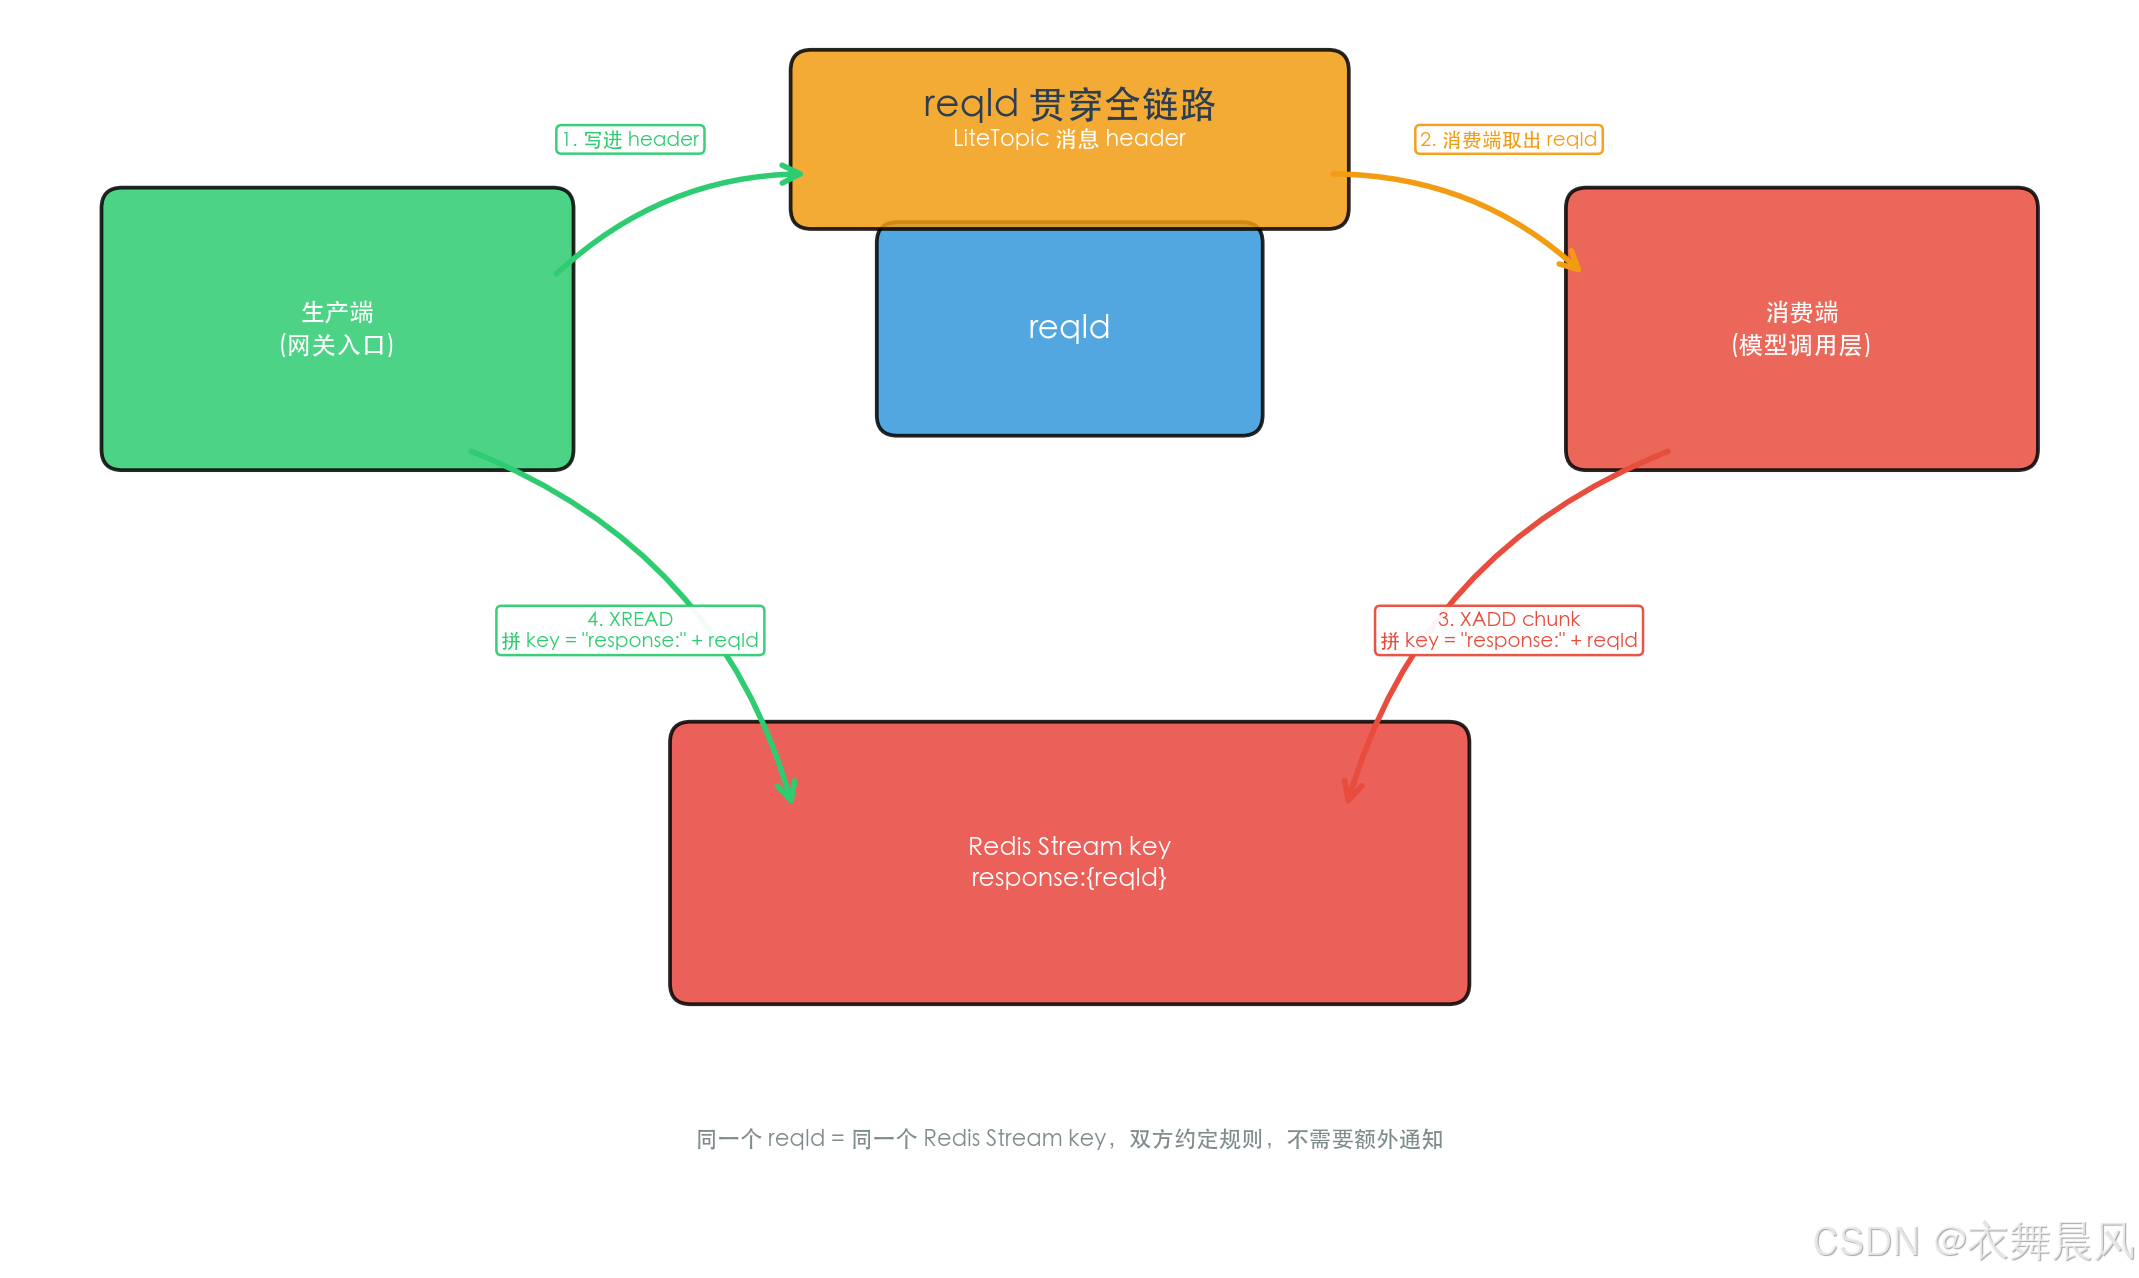
生产端核心:XREAD 阻塞循环
生产端写完 LiteTopic 后,从 Redis Stream 阻塞读响应。XREAD 的 BLOCK 参数让等待过程不耗 CPU,数据来了自动唤醒。还加了一个总超时,防止消费端崩溃后生产端无限等:
go
func (g *GatewayProducer) HandleRequest(w http.ResponseWriter, r *http.Request) {
    reqID := uuid.New().String()
    streamKey := "response:" + reqID

    // 构造消息,reqId 塞进 header,按 user+model 路由到 LiteTopic
    msg := &primitive.Message{Topic: g.parentTopic, Body: payload}
    msg.SetLiteTopic(fmt.Sprintf("litetopic-%s-%s", user, model))
    msg.WithProperty("reqId", reqID)
    g.mqProducer.SendSync(r.Context(), msg)

    // 开启 SSE,从 Redis Stream 流式读响应推给客户端
    w.Header().Set("Content-Type", "text/event-stream")
    flusher, _ := w.(http.Flusher)
    lastID := "0" // 从头读,不漏第一条 chunk

    // 总超时:消费端崩溃或 Redis 挂了时,防止生产端无限等
    // LLM 流式响应一般不超过 60 秒,120 秒兜底
    ctx, cancel := context.WithTimeout(r.Context(), 120*time.Second)
    defer cancel()

    for {
        // XREAD BLOCK:没数据卡住等,有数据立刻返回
        result, err := g.rdb.XRead(ctx, &redis.XReadArgs{
            Streams: []string{streamKey, lastID},
            Count:   10,
            Block:   30 * time.Second,
        }).Result()

        if err == redis.Nil {
            continue // 超时无数据,继续等(消息可能还在 Suspend 排队)
        }
        if err != nil {
            // context deadline 超时,或客户端断连,或 Redis 连接异常
            if ctx.Err() == context.DeadlineExceeded {
                fmt.Fprintf(w, "event: timeout\ndata: response incomplete\n\n")
                flusher.Flush()
            }
            return
        }

        for _, stream := range result {
            for _, message := range stream.Messages {
                lastID = message.ID // 推进游标,下次从这里之后读

                switch message.Values["type"] {
                case "chunk":
                    fmt.Fprintf(w, "data: %s\n\n", message.Values["chunk"])
                    flusher.Flush() // 立即推给客户端
                case "done":
                    fmt.Fprintf(w, "event: done\ndata: [DONE]\n\n")
                    flusher.Flush()
                    return
                case "error":
                    fmt.Fprintf(w, "event: error\ndata: %s\n\n", message.Values["error"])
                    return
                }
            }
        }
    }
}
XREAD 按 ID 游标拉取:告诉 Redis 上次读到哪个 ID,它返回那个 ID 之后的所有新消息,没有就阻塞等。lastID 是生产端自己存在内存里的,每读到一条就往前推,不重复、不遗漏、顺序一致。Count: 10 限制单次最多返回 10 条,防止消费端瞬间写入大量 chunk 时一次性全部返回导致处理卡顿。这个值不影响正确性------lastID 游标保证不丢消息,设 5 或 20 都行。
这个 for 循环不会死循环,也不会空转占 CPU。不死循环是因为有四个出口:收到 done 正常 return、收到 error 异常 return、客户端断连时 r.Context() 自动 cancel 导致 XREAD 返回错误走 if err != nil 分支 return、总超时 120 秒到了 context deadline exceeded 也 return。不占 CPU 是因为 XREAD BLOCK 30000 是服务端阻塞,goroutine 挂起在 IO 等待上不消耗 CPU,Redis 服务端没数据时也把连接挂起等新消息唤醒。30 秒没数据返回 Nil,continue 再发一次 XREAD,又挂起等。百万并发就是百万个 goroutine 各自挂起等自己的 key,CPU 消耗接近零。
总超时是兜底措施。消费端崩溃、Redis 挂了、消息进了死信队列------这些情况最终都表现为"生产端收不到 done"。没有总超时,生产端会一直 continue 下去,客户端无限挂起。120 秒内没收到 done,就认定消费端出了问题,给客户端返回 timeout 事件。需要注意的是,如果消费端 Suspend 很久(比如限流 60 秒),期间 HTTP 连接一直挂着,网关前面的 LB、Nginx 超时设置要大于最大 Suspend 时长,否则 LB 先把连接断了。
消费端核心:回调里调模型,chunk 写 Redis
消费端除了限流判断和幂等检查,还加了 processing:{reqId} 标记防止消息重投时重复调模型,以及 WriteChunk 失败时中断模型调用:
go
func (c *GatewayConsumer) Consume(ctx context.Context, msgs ...*primitive.MessageExt) (consumer.ConsumeResult, error) {
    for _, msg := range msgs {
        reqID := msg.GetProperty("reqId")
        liteTopic := msg.GetLiteTopic()

        // 限流判断:返回 >0 表示需要 Suspend
        suspendMs := c.rateLimitPolicy(liteTopic)
        if suspendMs > 0 {
            return consumer.Suspend(suspendMs), nil // 消费线程立刻释放
        }

        // 幂等检查:消息重投时防止重复调模型
        // done 标记:上次已经完整处理过
        if exists, _ := c.rdb.Exists(ctx, "done:"+reqID).Result(); exists > 0 {
            continue
        }
        // processing 标记:上一次调了一半崩了,还没写 done
        // 重投后不应该重新调模型,否则客户端会收到两段拼起来的响应
        if exists, _ := c.rdb.Exists(ctx, "processing:"+reqID).Result(); exists > 0 {
            // 写 error 通知客户端重新发起请求
            WriteError(ctx, c.rdb, reqID, "previous attempt incomplete, please retry")
            continue
        }

        // 标记正在处理,120 秒后自动过期(兜底,防止崩了不清理)
        c.rdb.Set(ctx, "processing:"+reqID, "1", 120*time.Second)

        // 流式调用模型,每个 chunk 写 Redis Stream
        err := c.modelClient.Invoke(ctx, model, prompt, func(chunk string) error {
            // 检查客户端是否已断连
            if n, _ := c.rdb.Exists(ctx, "cancel:"+reqID).Result(); n > 0 {
                return fmt.Errorf("client disconnected") // 中断模型调用,省 GPU
            }
            // WriteChunk 失败说明 Redis 挂了,响应回不去,继续调模型也是白花 GPU
            if err := WriteChunk(ctx, c.rdb, reqID, chunk); err != nil {
                return fmt.Errorf("redis unavailable, abort model call: %w", err)
            }
            return nil
        })

        if err != nil {
            // 模型调用被中断(客户端断连或 Redis 挂)
            // 写 error 通知生产端(如果 Redis 还活着的话),然后 ACK 当前消息
            // 当前消息处理完毕(含失败),继续处理下一条
            WriteError(ctx, c.rdb, reqID, err.Error())
            c.rdb.Del(ctx, "processing:"+reqID)
            continue
        }

        // 写 done 标记,清理 processing 标记,ACK
        WriteDone(ctx, c.rdb, reqID)
        c.rdb.Del(ctx, "processing:"+reqID)
    }
    return consumer.ConsumeSuccess, nil
}消费端多了两个防御。processing:{reqId} 标记解决的是"调模型中途崩溃,消息重投后重新调模型"的问题------上一次已经往 Redis Stream 写了几个 chunk,客户端收到了部分响应,重投后再调一次模型,客户端会收到两段拼起来的响应。加上这个标记后,重投时发现有 processing 标记说明上次没干完,写一个 error 让客户端重新发起请求,而不是重复调用。
WriteChunk 失败中断模型调用解决的是"Redis 挂了但还在白花 GPU"的问题。Redis 挂了之后消费端写的 chunk 没人能读到,继续调模型纯粹浪费算力。回调返回 error,Invoke 中断,不 ACK(Redis 挂了算基础设施异常,让 MQ 重投,等 Redis 恢复)。
变体:生产端和消费端同进程时,用 channel 替代 Redis
前面假设生产端和消费端是分开的 Pod,响应必须跨进程传递所以用了 Redis Streams。但如果生产端和消费端在同一个进程里------网关进程既负责接收 HTTP 请求写 LiteTopic,又作为消费端从 LiteTopic 拉消息调模型------响应通道根本不需要 Redis,用 Go channel 在进程内传递就行。
请求还是走 LiteTopic(限流、缓冲、隔离这些能力仍然需要 Broker 提供),只是响应从"跨进程走 Redis"变成"进程内走 channel":
同一个网关进程
┌──────────────────────────────────────────────────────┐
│                                                      │
│  HTTP Handler (goroutine A)     Consumer (goroutine B)│
│  ┌──────────────┐               ┌──────────────────┐ │
│  │ 生成 reqId    │               │ 拉到消息          │ │
│  │ 写 LiteTopic  │               │ 限流判断          │ │
│  │              │               │ 调模型            │ │
│  │ 等 chan       │ ◄─────────── │ chunk 写 chan     │ │
│  │ 推给客户端    │   Go channel  │ done 写 chan      │ │
│  └──────────────┘               └──────────────────┘ │
│                                                      │
│         ┌─────────────────────┐                      │
│         │  sync.Map            │                      │
│         │  reqId → chan chunk  │                      │
│         └─────────────────────┘                      │
└──────────────────────────────────────────────────────┘
生产端用 reqId 注册一个 channel,消费端通过 reqId 找到这个 channel 直接写:
go
// 进程内响应注册表
var responseChans sync.Map // reqId -> chan StreamEvent

type StreamEvent struct {
    Type  string // "chunk" / "done" / "error"
    Chunk string
    Error string
}

// 生产端:注册 channel,写 LiteTopic,然后阻塞等
func (g *Gateway) HandleRequest(w http.ResponseWriter, r *http.Request) {
    reqID := uuid.New().String()
    ch := make(chan StreamEvent, 100) // 带缓冲,消费端写不阻塞
    responseChans.Store(reqID, ch)
    defer responseChans.Delete(reqID)

    // 写 LiteTopic(跟之前一样)
    msg := &primitive.Message{Topic: g.parentTopic, Body: payload}
    msg.SetLiteTopic(fmt.Sprintf("litetopic-%s-%s", user, model))
    msg.WithProperty("reqId", reqID)
    g.mqProducer.SendSync(r.Context(), msg)

    // SSE,从 channel 读响应推给客户端
    w.Header().Set("Content-Type", "text/event-stream")
    flusher, _ := w.(http.Flusher)

    ctx, cancel := context.WithTimeout(r.Context(), 120*time.Second)
    defer cancel()

    for {
        select {
        case <-ctx.Done():
            fmt.Fprintf(w, "event: timeout\ndata: response incomplete\n\n")
            flusher.Flush()
            return
        case event := <-ch:
            switch event.Type {
            case "chunk":
                fmt.Fprintf(w, "data: %s\n\n", event.Chunk)
                flusher.Flush()
            case "done":
                fmt.Fprintf(w, "event: done\ndata: [DONE]\n\n")
                flusher.Flush()
                return
            case "error":
                fmt.Fprintf(w, "event: error\ndata: %s\n\n", event.Error)
                return
            }
        }
    }
}

// 消费端:拉到消息后,通过 reqId 找到 channel 直接写
func (g *Gateway) Consume(ctx context.Context, msgs ...*primitive.MessageExt) (consumer.ConsumeResult, error) {
    for _, msg := range msgs {
        reqID := msg.GetProperty("reqId")
        liteTopic := msg.GetLiteTopic()

        suspendMs := g.rateLimitPolicy(liteTopic)
        if suspendMs > 0 {
            return consumer.Suspend(suspendMs), nil
        }

        // 从注册表找到对应的 channel
        val, ok := responseChans.Load(reqID)
        if !ok {
            continue // 生产端已经走了(客户端断连),跳过
        }
        ch := val.(chan StreamEvent)

        // 调模型,每个 chunk 直接写 channel
        err := g.modelClient.Invoke(ctx, model, prompt, func(chunk string) error {
            // 检查 channel 是否还在(客户端断连后生产端会 defer Delete)
            _, ok := responseChans.Load(reqID)
            if !ok {
                return fmt.Errorf("client disconnected")
            }
            ch <- StreamEvent{Type: "chunk", Chunk: chunk}
            return nil
        })

        if err != nil {
            ch <- StreamEvent{Type: "error", Error: err.Error()}
        } else {
            ch <- StreamEvent{Type: "done"}
        }
    }
    return consumer.ConsumeSuccess, nil
}
channel 方案不需要 Redis,不需要 XADD/XREAD,不需要 Stream key 的 TTL 清理,不需要 done/processing/cancel 这些 Redis 标记。客户端断连就是生产端 goroutine 退出,defer responseChans.Delete(reqID) 自动清理,消费端 Load 找不到 channel 就知道客户端走了,直接中断模型调用。少了一整个 Redis 依赖。
但代价也明显。生产端和消费端绑在同一个进程里,进程挂了两边一起没。Redis 方案里消费端挂了,MQ 重投给另一个消费实例就行;同进程方案下进程重启后,在途的请求全丢了,客户端只能靠总超时感知到然后重试。另外消费端调模型如果涉及 CPU 密集的预处理(比如图片编码),可能跟 HTTP handler 抢 CPU,分进程方案没这个问题。
中小规模------租户几千到几万------同进程 + channel 够用,少一个 Redis 依赖。百炼这种百万租户规模,生产端和消费端必须分开部署独立伸缩,Redis Streams 是更现实的选择。
几个工程细节
ACK 时机
invokeModel 之后紧接着 ACK,但要分情况:
模型调用成功      → 写 done  → ACK
模型业务失败      → 写 error → ACK(不重投,重试只会再花一次 GPU 算力)
Redis/基础设施异常 → 不 ACK   → Broker 重投
模型业务错误不重投,重试结果大概率一样,白花 GPU。只有基础设施异常才重投。
幂等性
Broker 和消费端之间 ACK 可能丢,同一条消息被投两次。消费端代码里有两层检查:done:{reqId} 标记防的是"已完整处理的请求被重投",直接跳过不重复调模型;processing:{reqId} 标记防的是"调了一半崩了的请求被重投",写 error 让客户端重新发起,不重复调模型。LLM 推理一次消耗数秒 GPU 时间,重复调用是纯浪费。
客户端断连
客户端关了浏览器,生产端检测到连接断开(Go 里 r.Context().Done() 自动触发),往 cancel:{reqID} 写取消标记。消费端在每个 chunk 之间检查,发现取消就中断模型调用。不做这个处理,用户断连后模型还在推理,一次调用几秒到几十秒 GPU 时间就白花了。
小结
百炼从"进程内漏桶"走到"分布式漏桶矩阵",核心不是算法多新颖------固定窗口和漏桶都是几十年的老东西。真正的问题是规模到了百万租户之后,瓶颈不在算法,在于你用什么物理载体去承载那个拆出来的结构。算法选型之外,漏桶的物理载体、租户隔离的成本模型、响应通道的延迟特性,这些才是决定方案能不能 scale 的东西。
文章把响应回传这块全部藏在了 invokeModel(msg) 一行里,但这是整个方案能不能真正跑起来的关键。响应通道的选择取决于部署形态:生产端和消费端同进程时用 Go channel,进程内传递最简单;分进程部署时用 Redis Streams,跨进程传递但有容错。请求走 LiteTopic 做限流缓冲,响应按部署形态选 channel 或 Redis,两条通道各干各的,不要强行统一。
Suspend vs Sleep 的选择、消息重投的幂等处理、生产端总超时兜底、客户端断连时中断模型调用------这些看起来是细节,但在百万租户场景下任何一个出问题都是生产事故。百炼原文聚焦在限流架构本身,这些工程细节需要自己补上。
参考资料
- 限流比降 10 倍:百炼网关如何用 RocketMQ LiteTopic 重构大模型限流 --- 阿里云千问AI平台(PDF 存档)
- RocketMQ 5.x LiteTopic 文档 --- Apache RocketMQ
- Redis Streams 官方文档 --- Redis
- go-redis 文档 --- go-redis
- 构建高效业务网关:基于 Gin 与 ReverseProxy 的实现方案 --- 本博客
- 从模型管理到 AI 网关:把资产、流量与成本串成闭环 --- 本博客(总量节流之外的另一条限流线:按令牌分账的裁决)