文章目录
-
- [1. 先把问题讲清楚:文本模型为什么不能直接看图](#1. 先把问题讲清楚:文本模型为什么不能直接看图)
- [2. VLM 三个核心模块怎么配合](#2. VLM 三个核心模块怎么配合)
- [3. 图片 token 成本怎么估算](#3. 图片 token 成本怎么估算)
- [4. CLIP 对齐的直觉](#4. CLIP 对齐的直觉)
- [5. VLM 训练阶段通常不止一步](#5. VLM 训练阶段通常不止一步)
- [6. OCR、表格、图表、UI 为什么难](#6. OCR、表格、图表、UI 为什么难)
- [7. 输出要带证据:页码、区域、原文](#7. 输出要带证据:页码、区域、原文)
- [8. 多图和长文档评估](#8. 多图和长文档评估)
- [9. VLM 与 OCR/RAG/规则如何配合](#9. VLM 与 OCR/RAG/规则如何配合)
- [10. 常见误区](#10. 常见误区)
- [11. 小结](#11. 小结)
- 大模型视角
- 下一篇
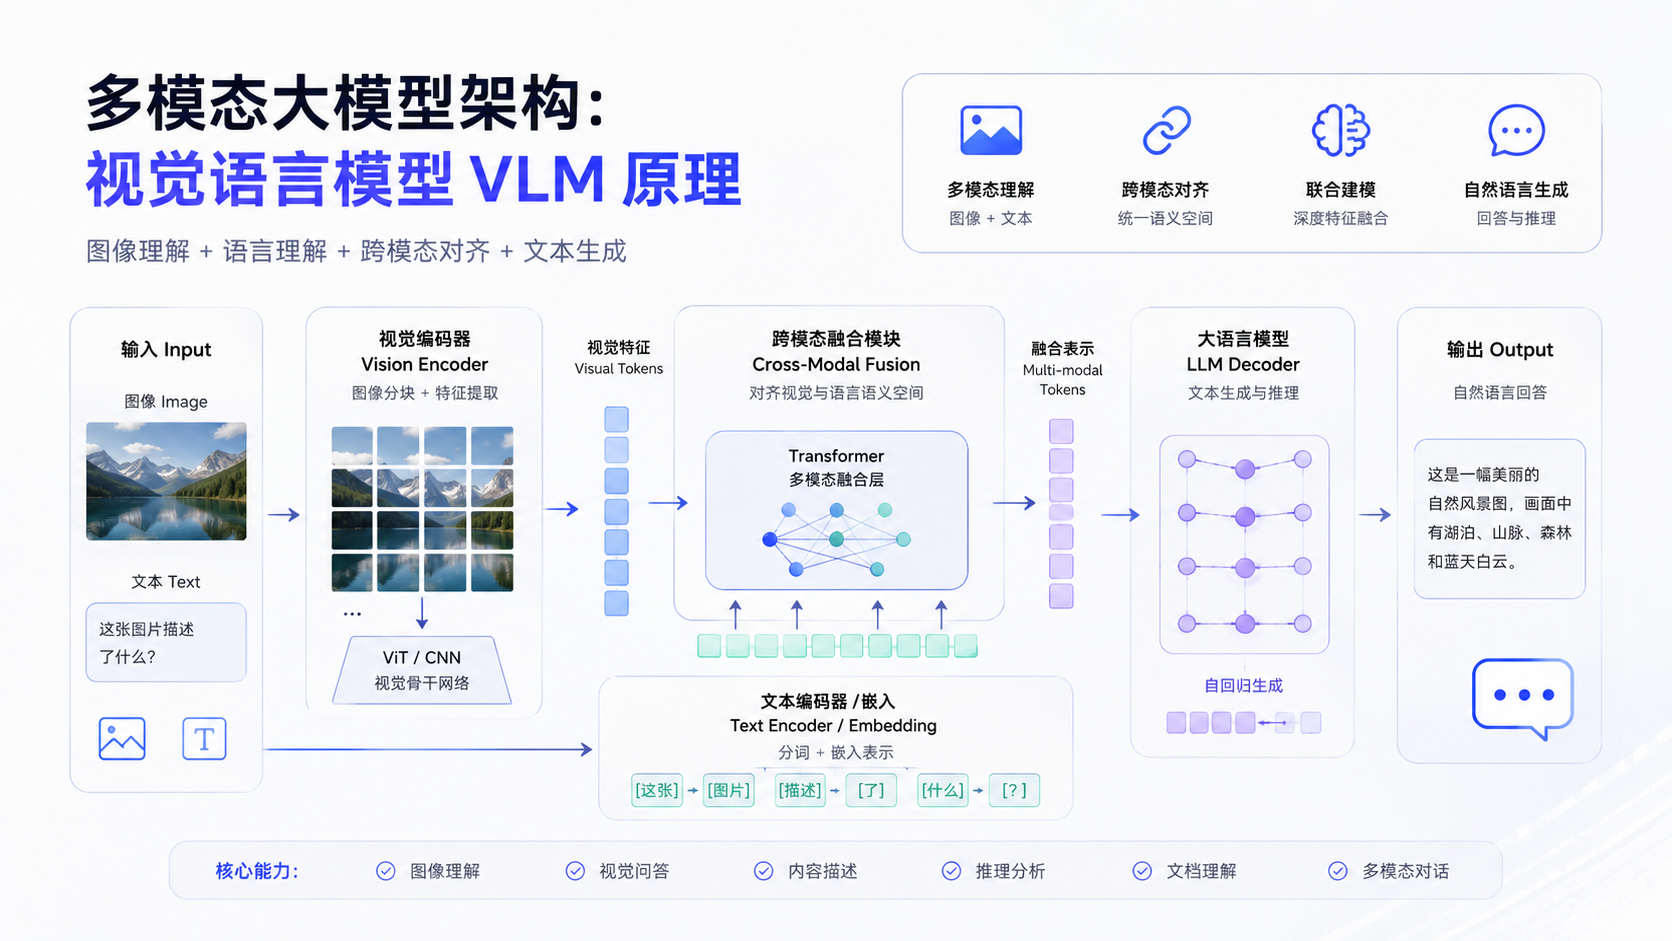
摘要:VLM(Vision-Language Model,视觉语言模型)让大模型同时处理图片和文字。它不是简单"OCR 后交给文本模型",而是通过视觉编码器、投影模块和语言模型,把图像特征接入生成过程。本文会从一张图片如何变成视觉 token 讲起,解释 Vision Encoder、Projector、CLIP 对齐、多模态指令微调、图像 token 成本、OCR/表格/图表/UI 难点、证据输出和评估闭环,并给出可运行的成本估算和结构化校验代码。
- 前置知识:专栏一 Transformer、 Tokenization;专栏二 Gemini 多模态
- 阅读时间:60-75 分钟
- 代码环境:Python 3.10+,示例只依赖标准库
- 读完目标:能解释 VLM 的典型结构,能理解图片 token 成本和训练阶段,能为 OCR、图表、截图、文档问答任务设计评估集
1. 先把问题讲清楚:文本模型为什么不能直接看图
文本大模型输入的是 token id,例如"合同""金额""JSON"这些文本片段会被 tokenizer 转成整数。图片不是 token 序列,而是像素矩阵,通常包含宽、高和 RGB 通道。
所以 VLM 要解决的第一个问题是:怎么把像素变成语言模型能理解的向量。
典型流程是:
text
image -> vision encoder -> visual embeddings -> projector -> visual tokens + text tokens -> LLM -> answer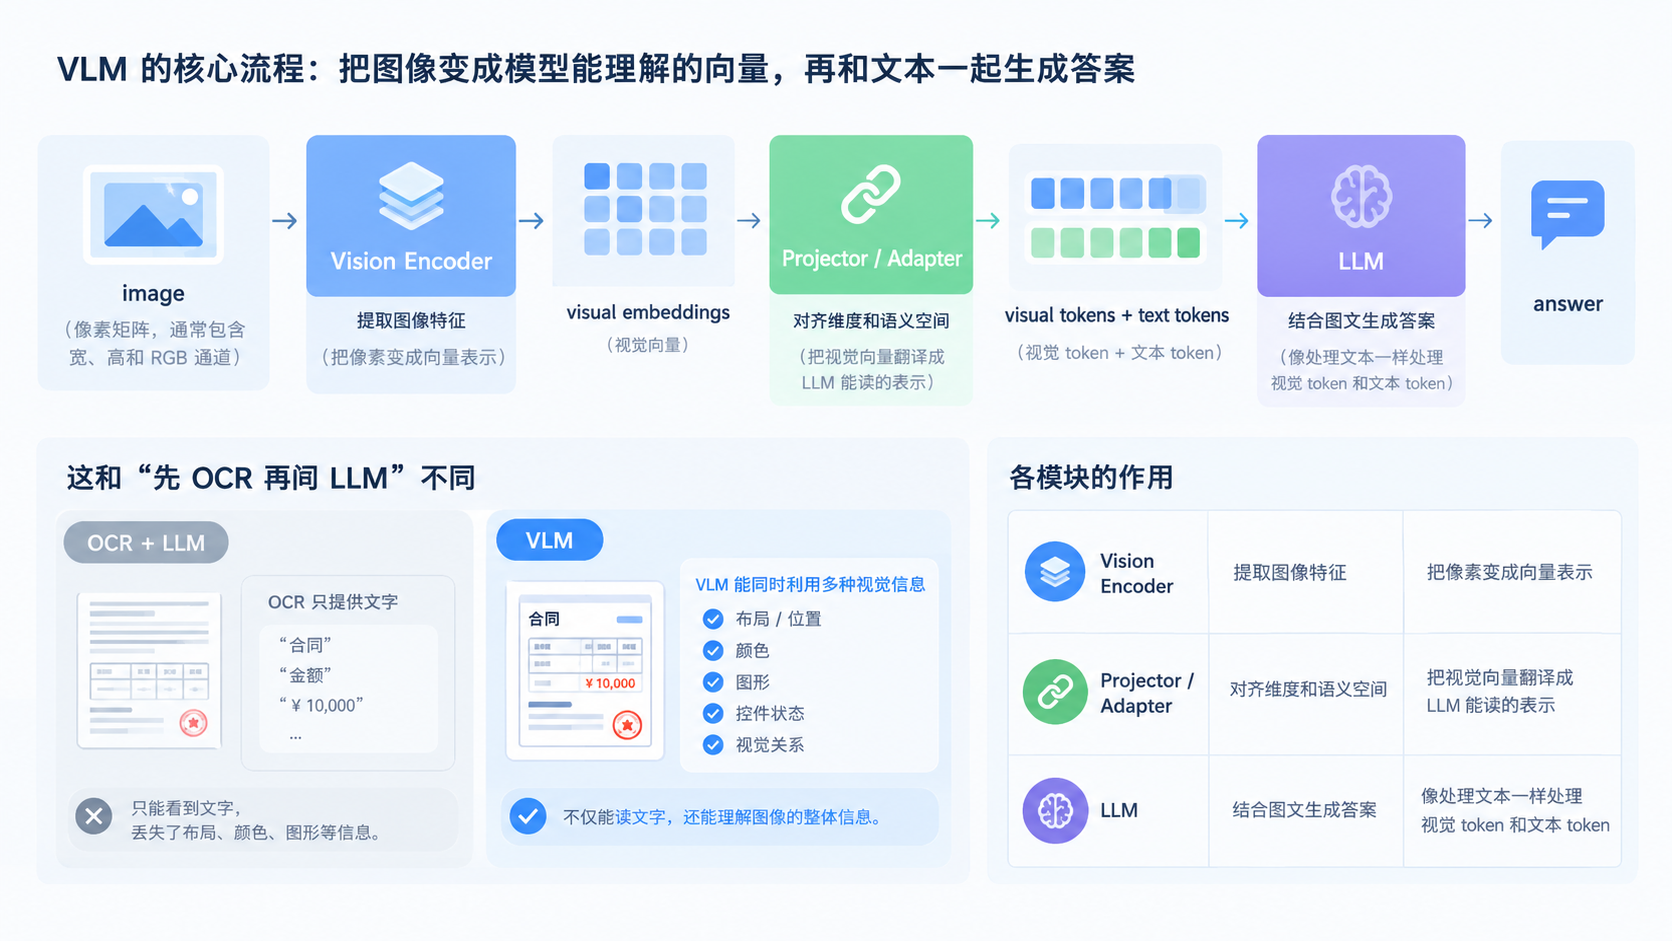
其中:
| 模块 | 作用 | 大白话理解 |
|---|---|---|
| Vision Encoder | 提取图像特征 | 把像素变成向量表示 |
| Projector/Adapter | 对齐维度和语义空间 | 把视觉向量翻译成 LLM 能读的表示 |
| LLM | 结合图文生成答案 | 像处理文本一样处理视觉 token 和文本 token |
这和"先 OCR 再问 LLM"不同。OCR 只提供文字;VLM 还有机会利用布局、位置、颜色、图形、控件状态和视觉关系。
2. VLM 三个核心模块怎么配合
可以用公式写成:
V = VisionEncoder ( I ) V = \text{VisionEncoder}(I) V=VisionEncoder(I)
Z = Projector ( V ) Z = \text{Projector}(V) Z=Projector(V)
Y = LLM ( Z , X ) Y = \text{LLM}(Z, X) Y=LLM(Z,X)
逐项解释:
- I I I:输入图片;
- V V V:视觉编码器提取出的图像特征;
- Z Z Z:投影后、能接入语言模型的视觉 token;
- X X X:用户问题等文本 token;
- Y Y Y:模型生成的答案。
大白话:先把图片变成视觉特征,再把视觉特征映射到语言模型的表示空间,最后让语言模型在"图像信息 + 问题文本"的条件下回答。
这个结构解释了为什么 VLM 训练通常不止一步。视觉编码器、投影层、语言模型之间要对齐,否则 LLM 看到的视觉 token 就像陌生语言。
3. 图片 token 成本怎么估算
很多 VLM 会把图片切成 patch。patch 越小,图片越大,视觉 token 越多。视觉 token 会占用上下文窗口、计算和费用。
用代码估算 patch 数:
python
# Python 3.10+
import math


def patch_count(width, height, patch_size):
    return math.ceil(width / patch_size) * math.ceil(height / patch_size)

for width, height in [(224, 224), (1024, 768), (1920, 1080), (2480, 3508)]:
    print((width, height), "patch16=", patch_count(width, height, 16))
真实模型可能会缩放、裁剪、动态分辨率、多尺度编码或压缩视觉 token。但这个估算能说明:高分辨率图片不是免费输入。
业务系统要问:
text
1. 是否需要整张图,还是只需要关键区域?
2. 小字 OCR 是否要求高分辨率?
3. 多图输入是否会挤占文本上下文?
4. PDF 是否逐页处理更合适?
5. 图片和 OCR 文本是否都要传给模型?
4. CLIP 对齐的直觉
CLIP 类方法让匹配的图片和文本在向量空间里更接近,不匹配的更远。
直觉流程:
text
图片编码器:image -> image embedding
文本编码器:caption -> text embedding
训练目标:匹配图文相似度高,不匹配图文相似度低
可以用简单余弦相似度理解"接近":
python
# Python 3.10+
import math


def cosine(a, b):
    dot = sum(x * y for x, y in zip(a, b))
    na = math.sqrt(sum(x * x for x in a))
    nb = math.sqrt(sum(y * y for y in b))
    return dot / (na * nb)

image_embed = [0.8, 0.1, 0.2]
caption_good = [0.7, 0.2, 0.2]
caption_bad = [-0.1, 0.9, 0.1]
print("good:", round(cosine(image_embed, caption_good), 3))
print("bad:", round(cosine(image_embed, caption_bad), 3))
CLIP 对齐能帮助模型建立图文语义联系,但它不等于完整 VLM。完整图文问答还需要把视觉表示接入生成模型,并通过指令微调学会回答用户问题。
5. VLM 训练阶段通常不止一步
一个 VLM 常见训练路线可以粗略分为:
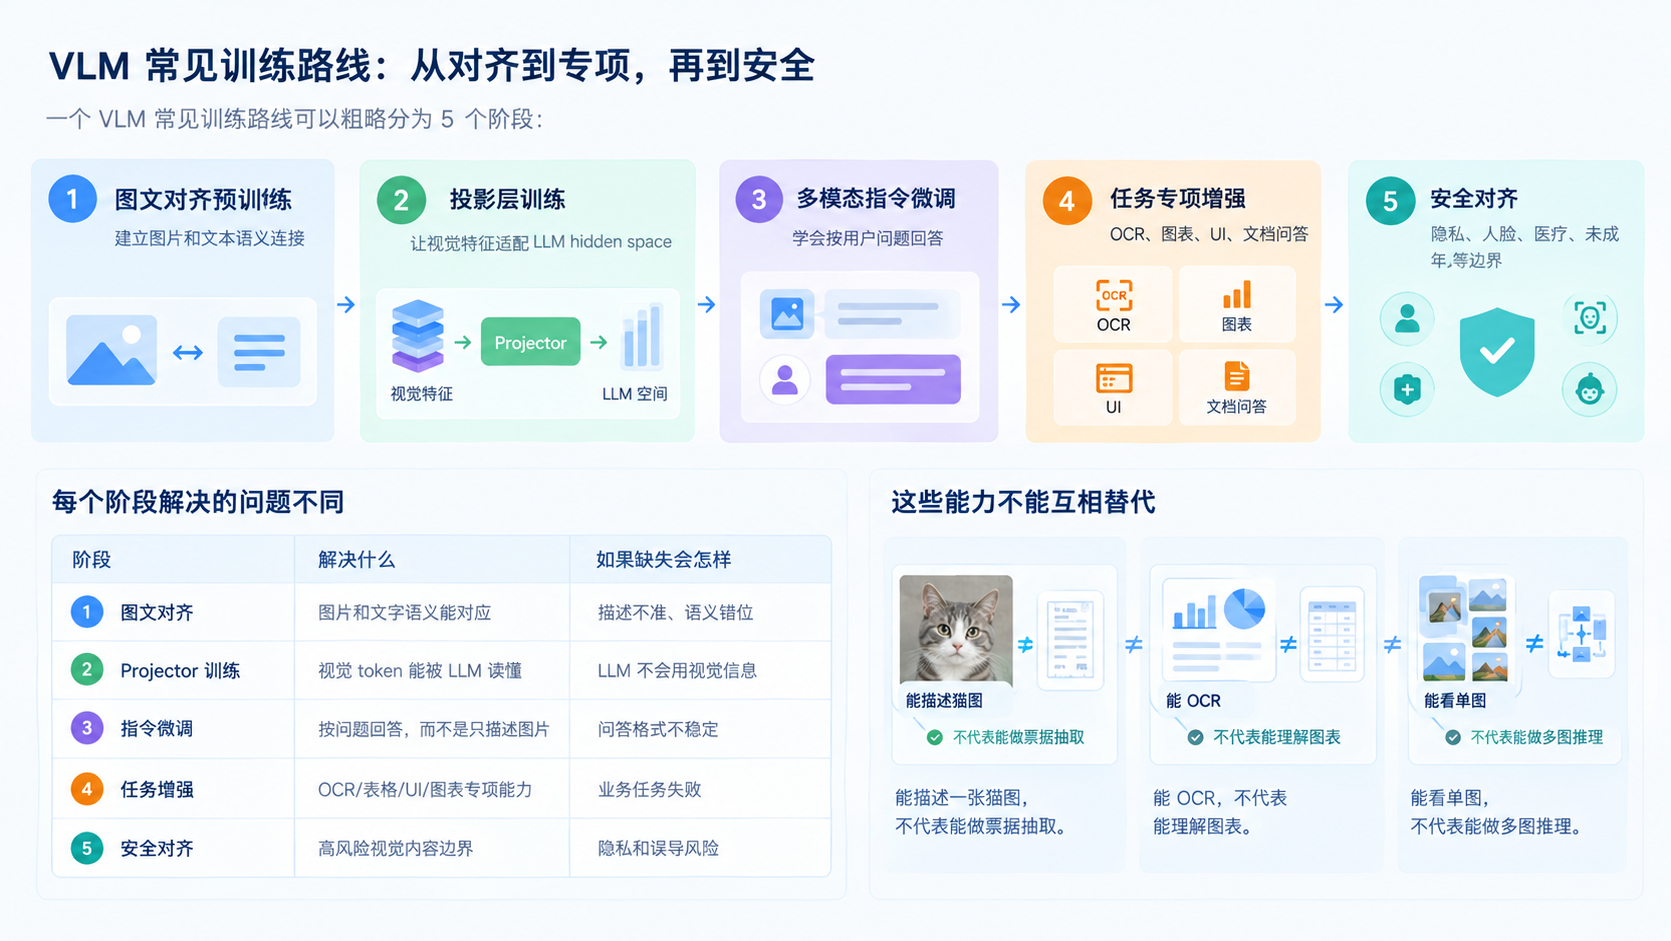
每个阶段解决的问题不同:
| 阶段 | 解决什么 | 如果缺失会怎样 |
|---|---|---|
| 图文对齐 | 图片和文字语义能对应 | 描述不准、语义错位 |
| Projector 训练 | 视觉 token 能被 LLM 读懂 | LLM 不会用视觉信息 |
| 指令微调 | 按问题回答,而不是只描述图片 | 问答格式不稳定 |
| 任务增强 | OCR/表格/UI/图表专项能力 | 业务任务失败 |
| 安全对齐 | 高风险视觉内容边界 | 隐私和误导风险 |
能描述一张猫图,不代表能做票据抽取;能 OCR,不代表能理解图表;能看单图,不代表能做多图推理。
6. OCR、表格、图表、UI 为什么难
VLM 业务任务难点通常不在"大物体识别",而在细节和结构。
| 场景 | 难点 | 失败表现 |
|---|---|---|
| OCR | 小字、模糊、旋转、多语言、遮挡 | 漏字、错字、编造文字 |
| 表格 | 行列结构、合并单元格、跨页 | 字段串行、行列错位 |
| 图表 | 坐标轴、单位、图例、趋势 | 读错数值、忽略单位 |
| UI 截图 | 控件位置、状态、错误提示 | 把禁用按钮当可点 |
| 票据合同 | 字段抽取、印章、编号、条款引用 | 抽错字段、无法给证据 |
| 多图 | 图像编号、跨图对比 | 把 A 图内容说成 B 图 |
这也是为什么业务 VLM 需要证据输出,而不是只要自然语言答案。
7. 输出要带证据:页码、区域、原文
业务 VLM 最好输出证据位置,便于人工复核和系统审计。
示例:
json
{
  "answer": "第二项费用可能不合规,因为发票日期晚于报销周期。",
  "evidence": [
    {"page": 1, "region": "费用明细第2行", "text": "发票日期:2026-03-18"},
    {"page": 1, "region": "报销周期", "text": "2026-03-01 至 2026-03-10"}
  ],
  "confidence": "medium"
}
写个结构校验器:
python
# Python 3.10+
import json


def validate_vlm_output(text):
    try:
        obj = json.loads(text)
    except json.JSONDecodeError:
        return ["invalid json"]

    errors = []
    for key in ["answer", "evidence", "confidence"]:
        if key not in obj:
            errors.append(f"missing {key}")
    if "evidence" in obj and not isinstance(obj["evidence"], list):
        errors.append("evidence must be list")
    return errors

sample = '{"answer":"...","evidence":[{"page":1,"region":"A1","text":"..."}],"confidence":"medium"}'
print(validate_vlm_output(sample))
结构化输出不能保证答案正确,但能让评估和复核变得可执行。
8. 多图和长文档评估
多图和长文档比单图更难,因为模型要维持编号、页码和跨页关系。
评估集应包含:
text
1. 单图描述:基础视觉理解;
2. 多图顺序:不要混淆图1和图2;
3. 截图定位:按钮、错误提示、状态;
4. 票据字段:金额、日期、税号、发票号;
5. 表格结构:行列、合并单元格、跨页;
6. 图表趋势:坐标轴、单位、极值、异常;
7. 文档页码:答案来自哪一页;
8. 无证据拒答:图里没有就不能编;
9. 看不清承认:模糊、遮挡、低分辨率时不硬答。
一个多图样本可以这样记录:
json
{
  "id": "multi_image_001",
  "images": ["page1.png", "page2.png"],
  "question": "第二张图中的审批状态是什么?",
  "expected": "待财务复核",
  "must_reference_image": 2
}
如果模型答对文字但引用错图片,也应算失败。业务系统关心可追溯性。
9. VLM 与 OCR/RAG/规则如何配合
很多项目不是"VLM 单独解决一切",而是组合系统:
text
图片/PDF -> OCR/版面分析 -> 文档分块 -> 向量/关键词检索 -> VLM/LLM 生成 -> 证据校验 -> 人工复核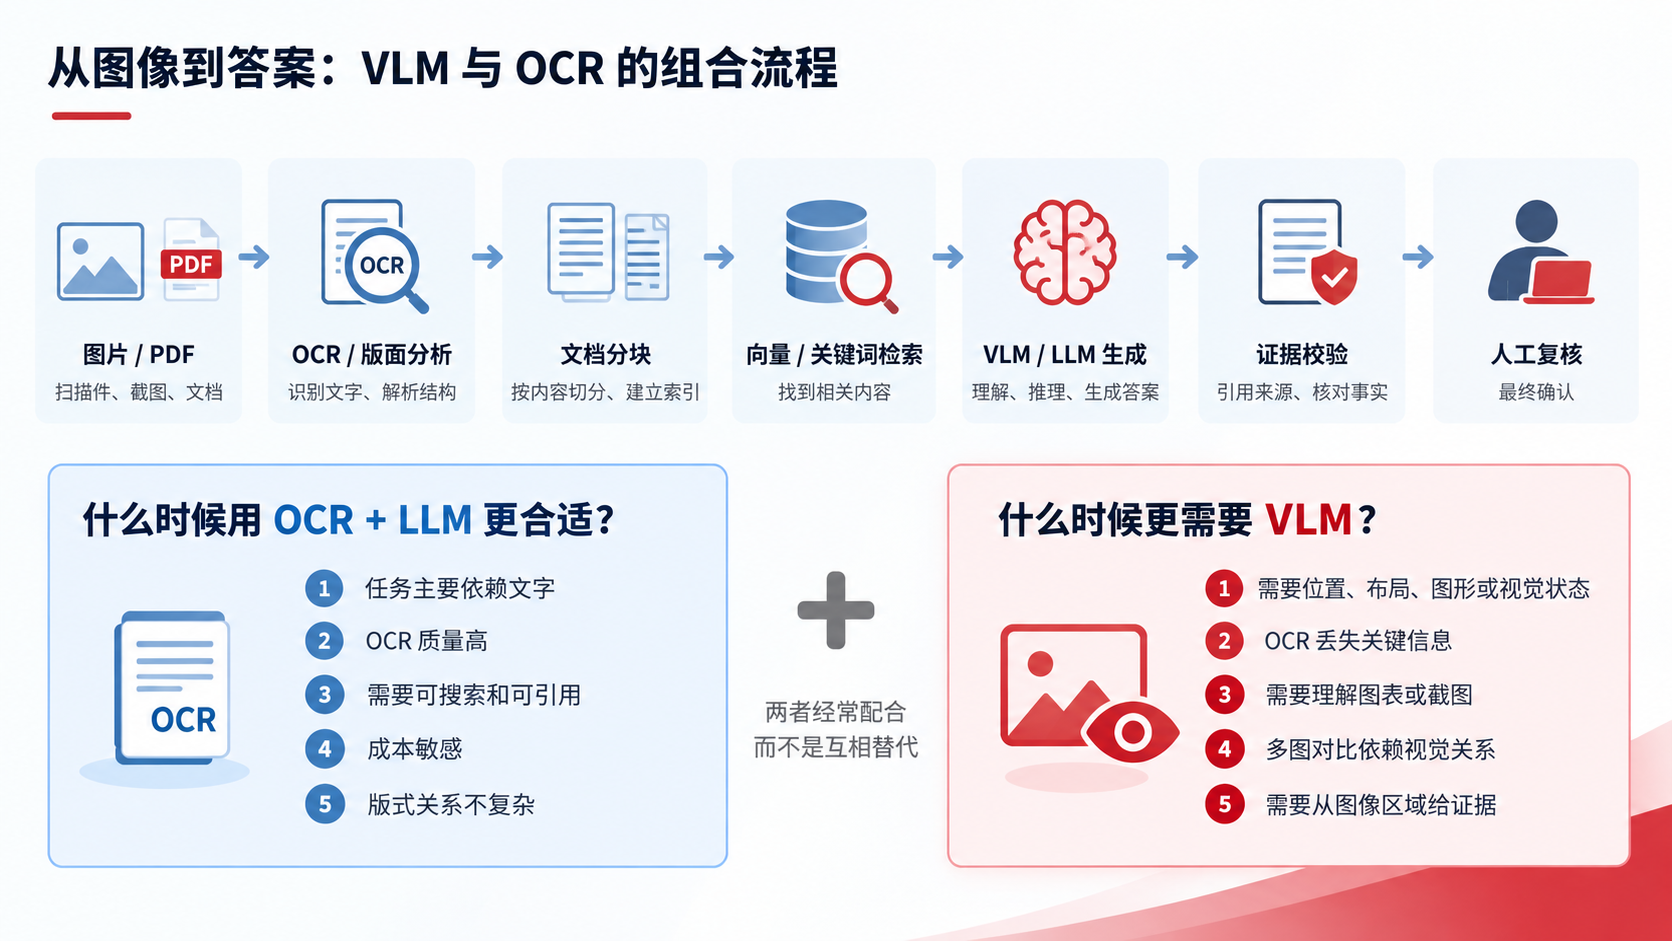
什么时候用 OCR + LLM 更合适?
text
1. 任务主要依赖文字;
2. OCR 质量高;
3. 需要可搜索和可引用;
4. 成本敏感;
5. 版式关系不复杂。
什么时候更需要 VLM?
text
1. 需要位置、布局、图形或视觉状态;
2. OCR 丢失关键信息;
3. 需要理解图表或截图;
4. 多图对比依赖视觉关系;
5. 需要从图像区域给证据。
两者经常配合,而不是互相替代。
10. 常见误区
误区一:VLM 看图等于人看图。 模型可能看对大物体,却漏掉小字、位置关系和单位。
误区二:OCR 做好了就不需要 VLM。 OCR 提供文字,VLM 还能利用版式、空间关系和视觉证据;二者常常配合。
误区三:图片越清晰越好,不管成本。 高分辨率可能带来更多视觉 token 和延迟,要按任务裁剪。
误区四:视觉答案不需要证据。 业务场景必须可复核,证据区域、页码和原文很重要。
误区五:能描述图片就能做业务抽取。 描述、OCR、表格、图表、UI 和文档问答是不同能力。
11. 小结
VLM 的核心是把视觉信息接入语言模型:视觉编码器提取图像特征,projector 对齐到语言模型空间,LLM 结合视觉 token 和文本 token 生成回答。真正难点在 OCR、表格、图表、UI 截图、多图、长文档和证据定位。
做多模态项目时,必须评估视觉 token 成本、输入质量、证据可追溯、无证据拒答和人工复核流程。不要用几个图片描述 demo 判断业务可用性。
大模型视角
从大模型应用角度看,VLM 把语言模型从文本世界连接到视觉世界。但连接越多,错误类型也越多:看错、读错、定位错、引用错。系统必须有证据、评估和人工复核机制。
下一篇
下一篇会讲小语言模型 SLM。它关注的不是把模型做得更大,而是在端侧、本地和低成本场景中做到足够可用。