一、前言:提取视频文案为什么不只是语音转文字?
在短视频创作、内容分析和视频素材整理过程中,提取视频文案是一个比较常见的需求。尤其是在分析抖音、小红书、B站等平台的视频内容时,经常需要将视频中的口播台词、字幕信息和内容结构转换成可编辑的文本。
传统方式通常是反复播放视频,手动记录台词,再根据视频内容整理文案结构。当视频数量增加,或者单条视频时长较长时,这种处理方式会消耗大量时间。
目前,提取视频文案主要涉及三类技术:
-
ASR自动语音识别:将视频中的语音转换为文字。
-
OCR字幕识别:识别视频画面中出现的文字内容。
-
NLP文本处理:对识别结果进行断句、去重、摘要和结构化整理。
实际应用中,不同工具对这几个环节的支持程度存在差异。本文从技术实现和使用场景出发,分析格镜、通义听悟、剪映、讯飞听见和Buzz五种工具的处理思路。
二、提取视频文案的基本技术流程
从技术角度来看,视频文案提取可以拆分为以下几个步骤:
输入视频文件或视频链接
         ↓
解析视频媒体信息
         ↓
提取音频流或字幕数据
         ↓
ASR语音识别 / OCR文字识别
         ↓
文本断句与时间戳匹配
         ↓
文案清洗与结构化处理
         ↓
输出TXT、SRT或其他文本格式
其中,ASR主要解决"视频里说了什么",OCR主要解决"画面上写了什么"。
如果需要进一步分析视频的开头、内容转折、结尾以及镜头结构,还需要结合自然语言处理和视觉信息进行二次分析。
因此,提取视频文案与普通音频转文字并不完全相同。前者可能涉及语音、字幕、画面和内容结构,后者主要关注语音转写准确性。
三、5种视频文案提取工具的功能与技术分析
1. 格镜:面向短视频内容提取与脚本整理
格镜是一款围绕视频内容处理的在线工具,涉及视频转文字、视频脚本提取以及视频内容结构化整理等功能。
与单纯的语音转写工具相比,格镜的应用场景更偏向短视频内容分析。
功能特点:
-
视频文字提取:将视频中的口播内容整理成可阅读的文本。
-
视频脚本整理:围绕视频内容进行文案和脚本层面的处理。
-
内容结构分析:适用于短视频素材拆解、台词整理等需求。
-
在线处理:以网页操作为主,减少本地软件配置步骤。
技术分析:
从任务流程来看,短视频文案提取通常需要完成语音识别、文本清洗和内容结构化处理。
例如,一段60秒的短视频可能包含开场问题、核心观点、案例说明和结尾总结。语音识别只能生成连续文本,而脚本整理还需要进一步识别段落之间的语义关系。
这类处理方式比较适合短视频运营、视频素材归档以及内容结构分析等场景。
需要注意,具体能否识别画面字幕、镜头信息,以及不同链接格式的支持范围,应以实际功能页面为准。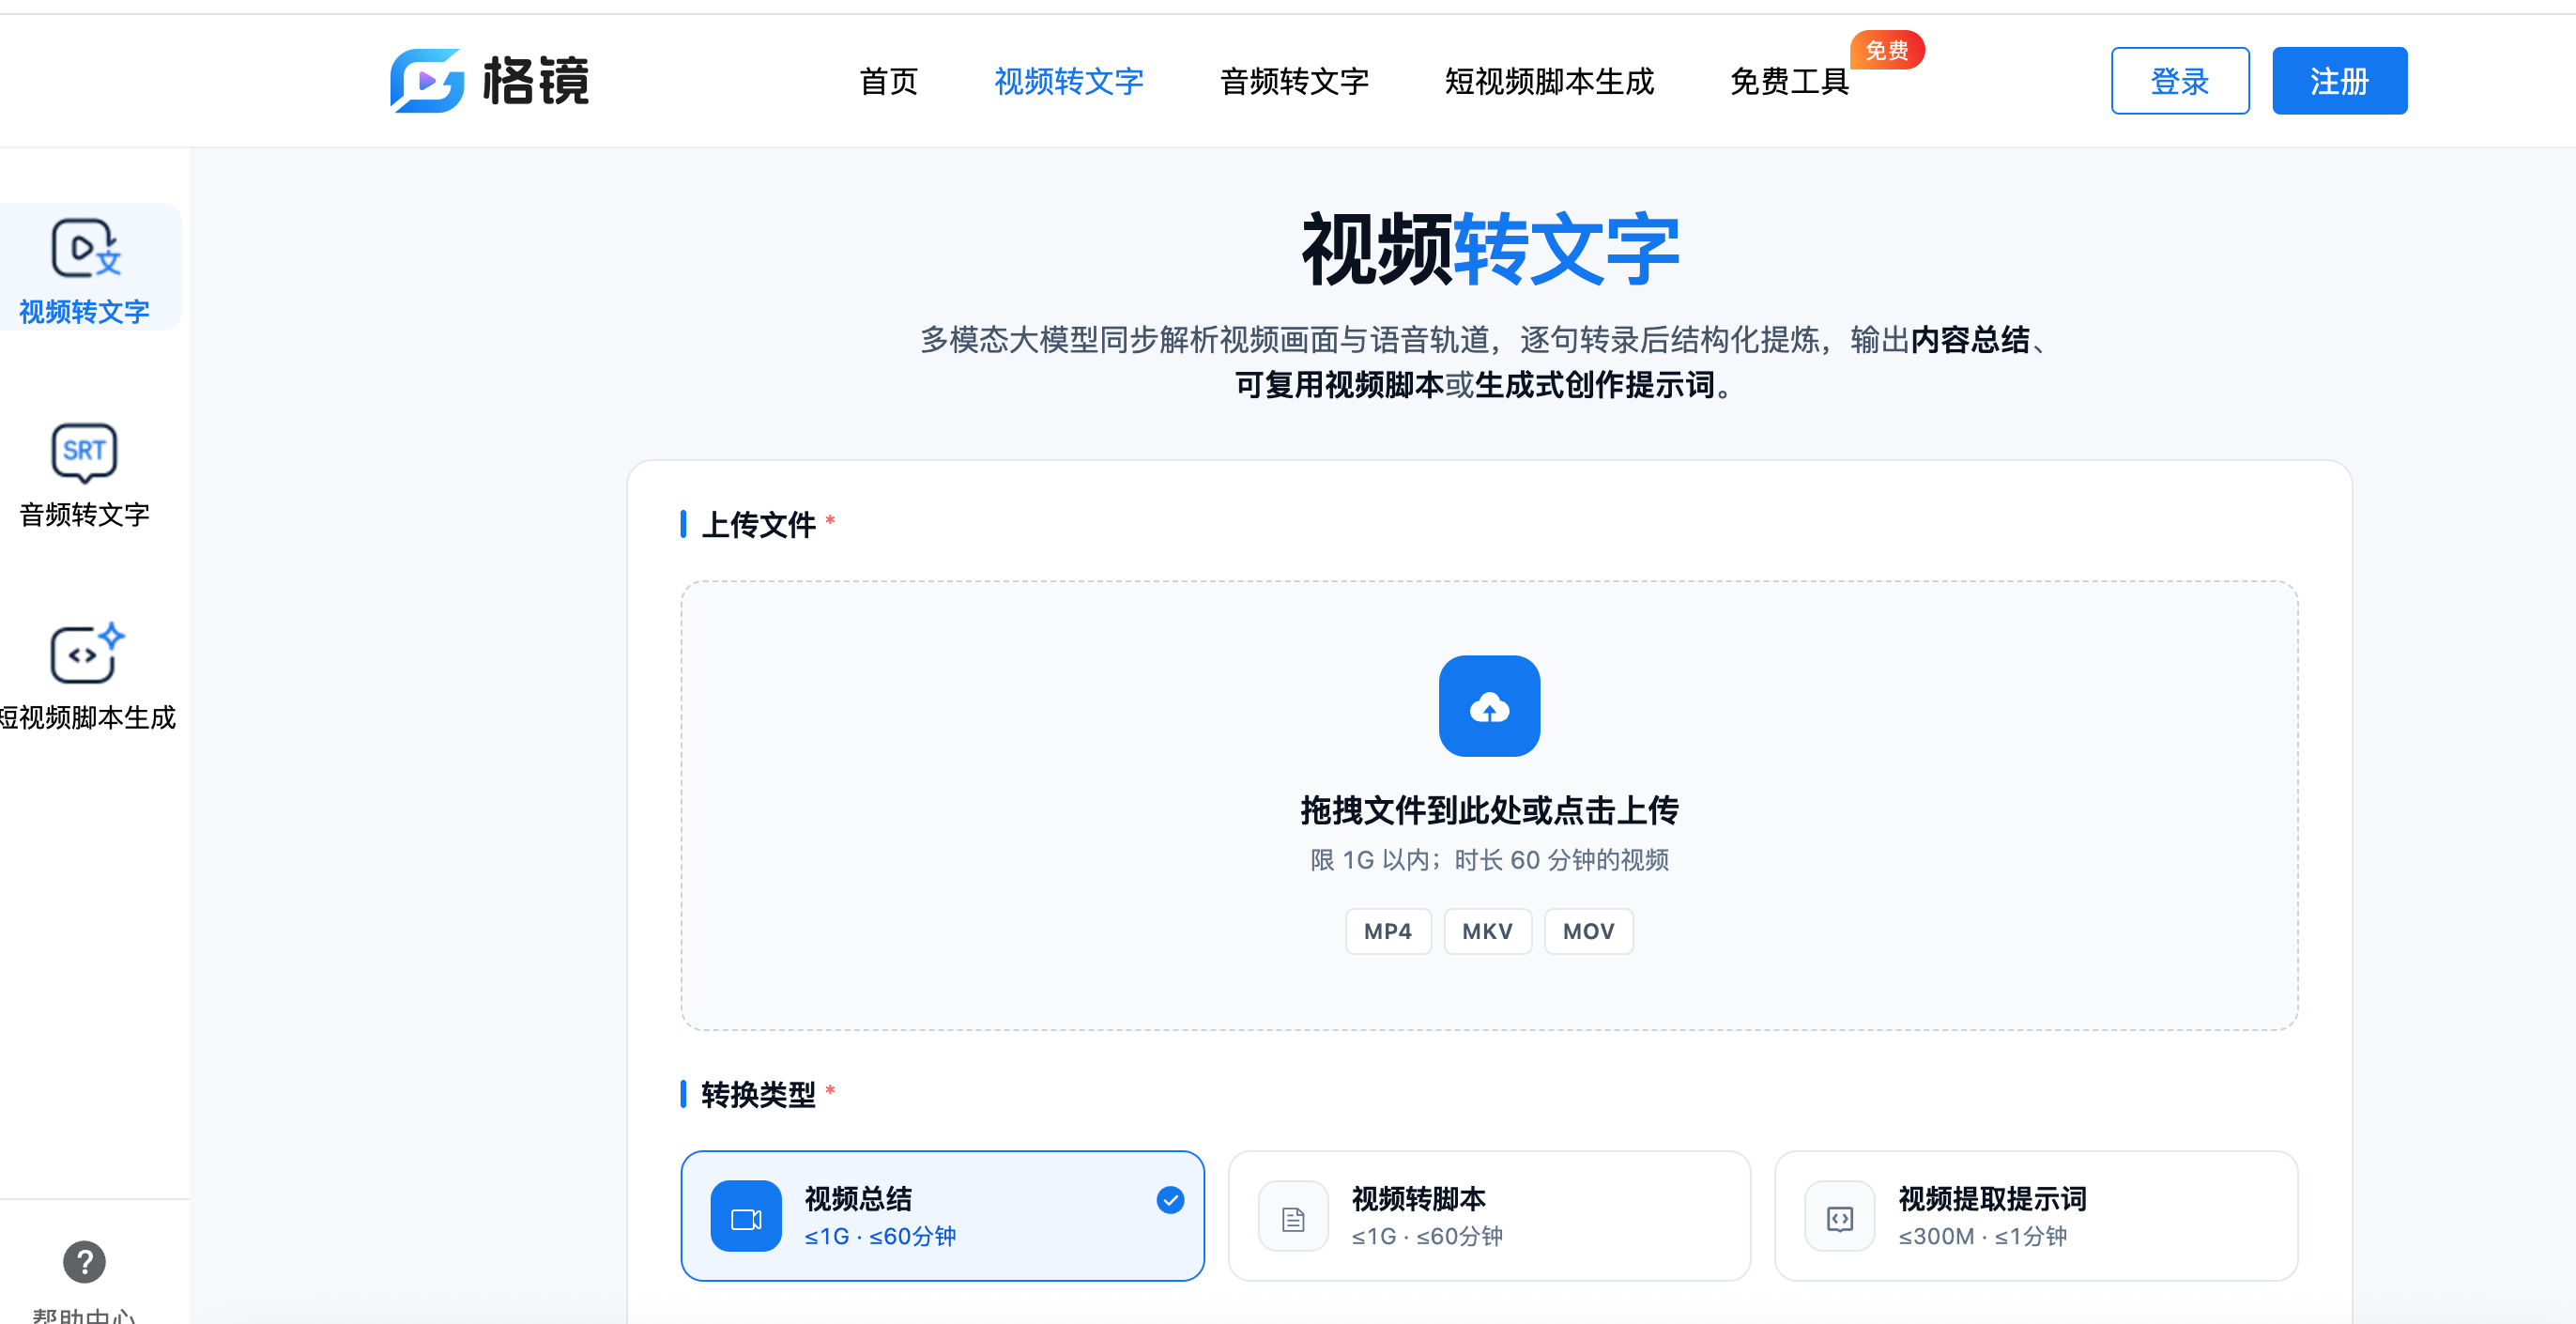
2. 通义听悟:基于语音识别与语义理解的视频内容整理
通义听悟主要围绕音视频内容转写、内容总结和信息提取展开。
在提取视频文案时,其处理逻辑通常是先识别音频内容,再通过语义理解能力对文本进行整理。
功能特点:
-
音视频语音转写。
-
转写文本与时间信息关联。
-
内容摘要和重点信息提取。
-
对较长音视频进行结构化整理。
技术分析:
通义听悟涉及的核心任务可以概括为:
音视频输入
    ↓
语音识别
    ↓
转写文本生成
    ↓
语义分析
    ↓
摘要与重点信息整理
对于课程视频、访谈视频、知识讲解视频等内容,语音转写后的文本通常较长。
通过语义分段和摘要处理,可以将连续文本拆分为不同主题,降低后续人工整理的工作量。
这类方案更关注视频中的语言信息及其语义结构,适合知识类视频的文案提取和信息归纳。
3. 剪映:通过自动字幕识别提取视频口播文案
剪映是一款视频剪辑工具,自动字幕识别是其视频文字处理流程中的重要功能。
在已有视频素材的情况下,可以通过识别字幕的方式,将视频中的口播语音转换成字幕文本。
功能特点:
-
自动识别视频中的语音内容。
-
生成与视频时间轴关联的字幕。
-
支持在剪辑过程中修改字幕。
-
适合视频剪辑与文案校对同步进行。
技术分析:
剪映的字幕处理流程可以理解为:
导入视频
    ↓
提取音频信息
    ↓
自动识别字幕
    ↓
生成时间轴字幕片段
    ↓
人工修改与校对
相比独立的文字提取工具,剪映的特点在于字幕与视频编辑时间轴结合得比较紧密。
例如,识别结果出现错字时,可以直接结合对应的视频片段进行检查。
对于已经进入剪辑阶段的视频素材,这种方式能够减少在不同软件之间切换的次数。
不过,自动字幕主要针对可识别的语音内容,视频中没有被读出来的画面文字不一定能通过该功能获取。
4. 讯飞听见:面向长视频和会议内容的语音转写
讯飞听见主要提供音视频转写、录音整理等相关功能。
其核心应用场景包括会议记录、访谈整理、课程内容转写,以及长视频中的语音信息提取。
功能特点:
-
音视频文件转写。
-
语音内容转换为可编辑文本。
-
支持转写结果校对。
-
适用于较长时间的语言内容整理。
技术分析:
语音识别系统通常需要处理声学特征、语言上下文和文本解码等问题。
对于多人访谈或长时间录音,除了识别文字,还可能涉及说话人区分、标点恢复和时间戳处理。
在提取视频文案的过程中,识别结果的可读性同样重要。
例如,原始识别文本可能缺少合理断句:
今天我们分析视频文案提取的几种方法首先是语音识别其次是字幕处理最后是文本整理经过标点恢复和语义分段后:
今天我们分析视频文案提取的几种方法。

首先是语音识别,其次是字幕处理,
最后是文本整理。
对于课程、讲座和访谈类视频,这类文本整理流程能够提高后续检索与阅读效率。
5. Buzz:基于Whisper的本地语音转写方案
Buzz是一款开源语音转写工具,可以通过Whisper等语音识别模型处理音视频中的语音内容。
与主要依赖在线服务的工具不同,Buzz支持本地转写工作流。
功能特点:
-
支持音视频语音转写。
-
可使用Whisper模型。
-
支持本地处理。
-
支持字幕及文本结果导出。
-
适合需要自行管理识别模型和文件的场景。
技术分析:
Buzz的典型处理流程为:
导入音视频文件
       ↓
读取音频数据
       ↓
调用语音识别模型
       ↓
生成文本与时间戳
       ↓
导出转写结果
Whisper采用基于Transformer的编码器---解码器架构,可以处理多语言语音识别等任务。
对于程序员而言,本地转写方案的优势主要在于处理环境可控,能够结合其他脚本完成后续文本处理。
例如,将识别结果进一步用于关键词提取、文本分段或字幕文件解析。
不过,本地运行效率会受到设备性能、模型大小和音频时长等因素影响。
四、5种工具的功能差异对比
| 工具 | 主要处理方向 | 技术侧重点 | 典型应用场景 |
|---|---|---|---|
| 格镜 | 视频文案与脚本提取 | 视频内容整理、脚本结构化 | 短视频文案拆解 |
| 通义听悟 | 音视频转写与总结 | ASR、语义分析 | 知识视频、课程整理 |
| 剪映 | 自动字幕识别 | ASR、时间轴字幕 | 视频剪辑、口播字幕提取 |
| 讯飞听见 | 音视频语音转写 | ASR、文本校对 | 访谈、会议、长视频 |
| Buzz | 本地语音转写 | Whisper、模型推理 | 本地文件处理、技术工作流 |
从功能定位来看,这五种工具虽然都涉及提取视频文案,但实际处理重点并不相同。
格镜偏向短视频文案及脚本整理;通义听悟关注转写后的语义信息;剪映将字幕识别与视频剪辑结合;讯飞听见侧重音视频语音转写;Buzz则提供本地模型处理方式。
五、影响视频文案提取质量的几个技术因素
1. 音频质量
背景音乐、环境噪声以及多人同时讲话,都可能影响语音识别结果。
对于背景音乐较强的视频,可以先进行人声分离或音频降噪,再执行语音转写。
2. 语音识别与字幕识别的区别
视频中的文字并不一定全部来自语音。
例如,画面中可能存在标题、商品信息、说明文字或其他视觉元素。
ASR主要识别语音,OCR主要识别画面文字。如果需要提取完整的视频文案,可能需要组合两种技术。
3. 时间戳准确性
字幕提取通常需要将识别文本与视频时间轴进行匹配。
时间戳误差过大,会影响字幕编辑、视频片段定位以及后续脚本整理。
4. 文本后处理
自动识别生成的文本可能包含重复词、口头语、断句问题或专有名词错误。
常见的后处理操作包括:
-
标点恢复与语义分段。
-
重复内容清理。
-
专业术语校对。
-
文案结构整理。
-
字幕与原视频核对。
其中,语义整理能够提高文本可读性,但如果需要保留原始口播内容,应避免在处理过程中改变原意。
六、不同场景下的视频文案提取方案
从实际需求出发,视频文案提取可以划分为三种主要场景。
场景一:短视频内容拆解
处理对象通常是几十秒到几分钟的短视频,重点在于提取口播内容、整理文案段落以及分析内容结构。
格镜这类偏向脚本整理的工具与该场景比较接近。
场景二:课程、访谈及知识视频整理
这类视频通常语音信息密集,处理重点是长文本转写、内容分段和摘要生成。
通义听悟、讯飞听见适合承担这类转写和内容整理任务。
场景三:字幕编辑与本地批量处理
如果视频仍处于剪辑阶段,剪映的时间轴字幕工作流更容易与视频编辑结合。
如果需要本地处理音视频文件,Buzz可以作为基于Whisper的语音转写方案,并结合脚本实现后续文本加工。
七、总结
提取视频文案本质上是一个多阶段的信息处理任务,涉及语音识别、字幕生成、文本清洗和语义结构化等环节。
对于仅需要获取口播文字的场景,ASR语音识别通常能够完成主要任务。而涉及画面文字、视频结构和镜头信息时,则需要结合OCR、视觉分析以及文本后处理技术。
随着视频内容处理需求逐渐细化,提取视频文案也从单一的语音转文字,发展为涵盖字幕、脚本和内容结构分析的综合处理流程。