成为全栈·Flutter App 篇·分类、标签与搜索:移动端内容发现
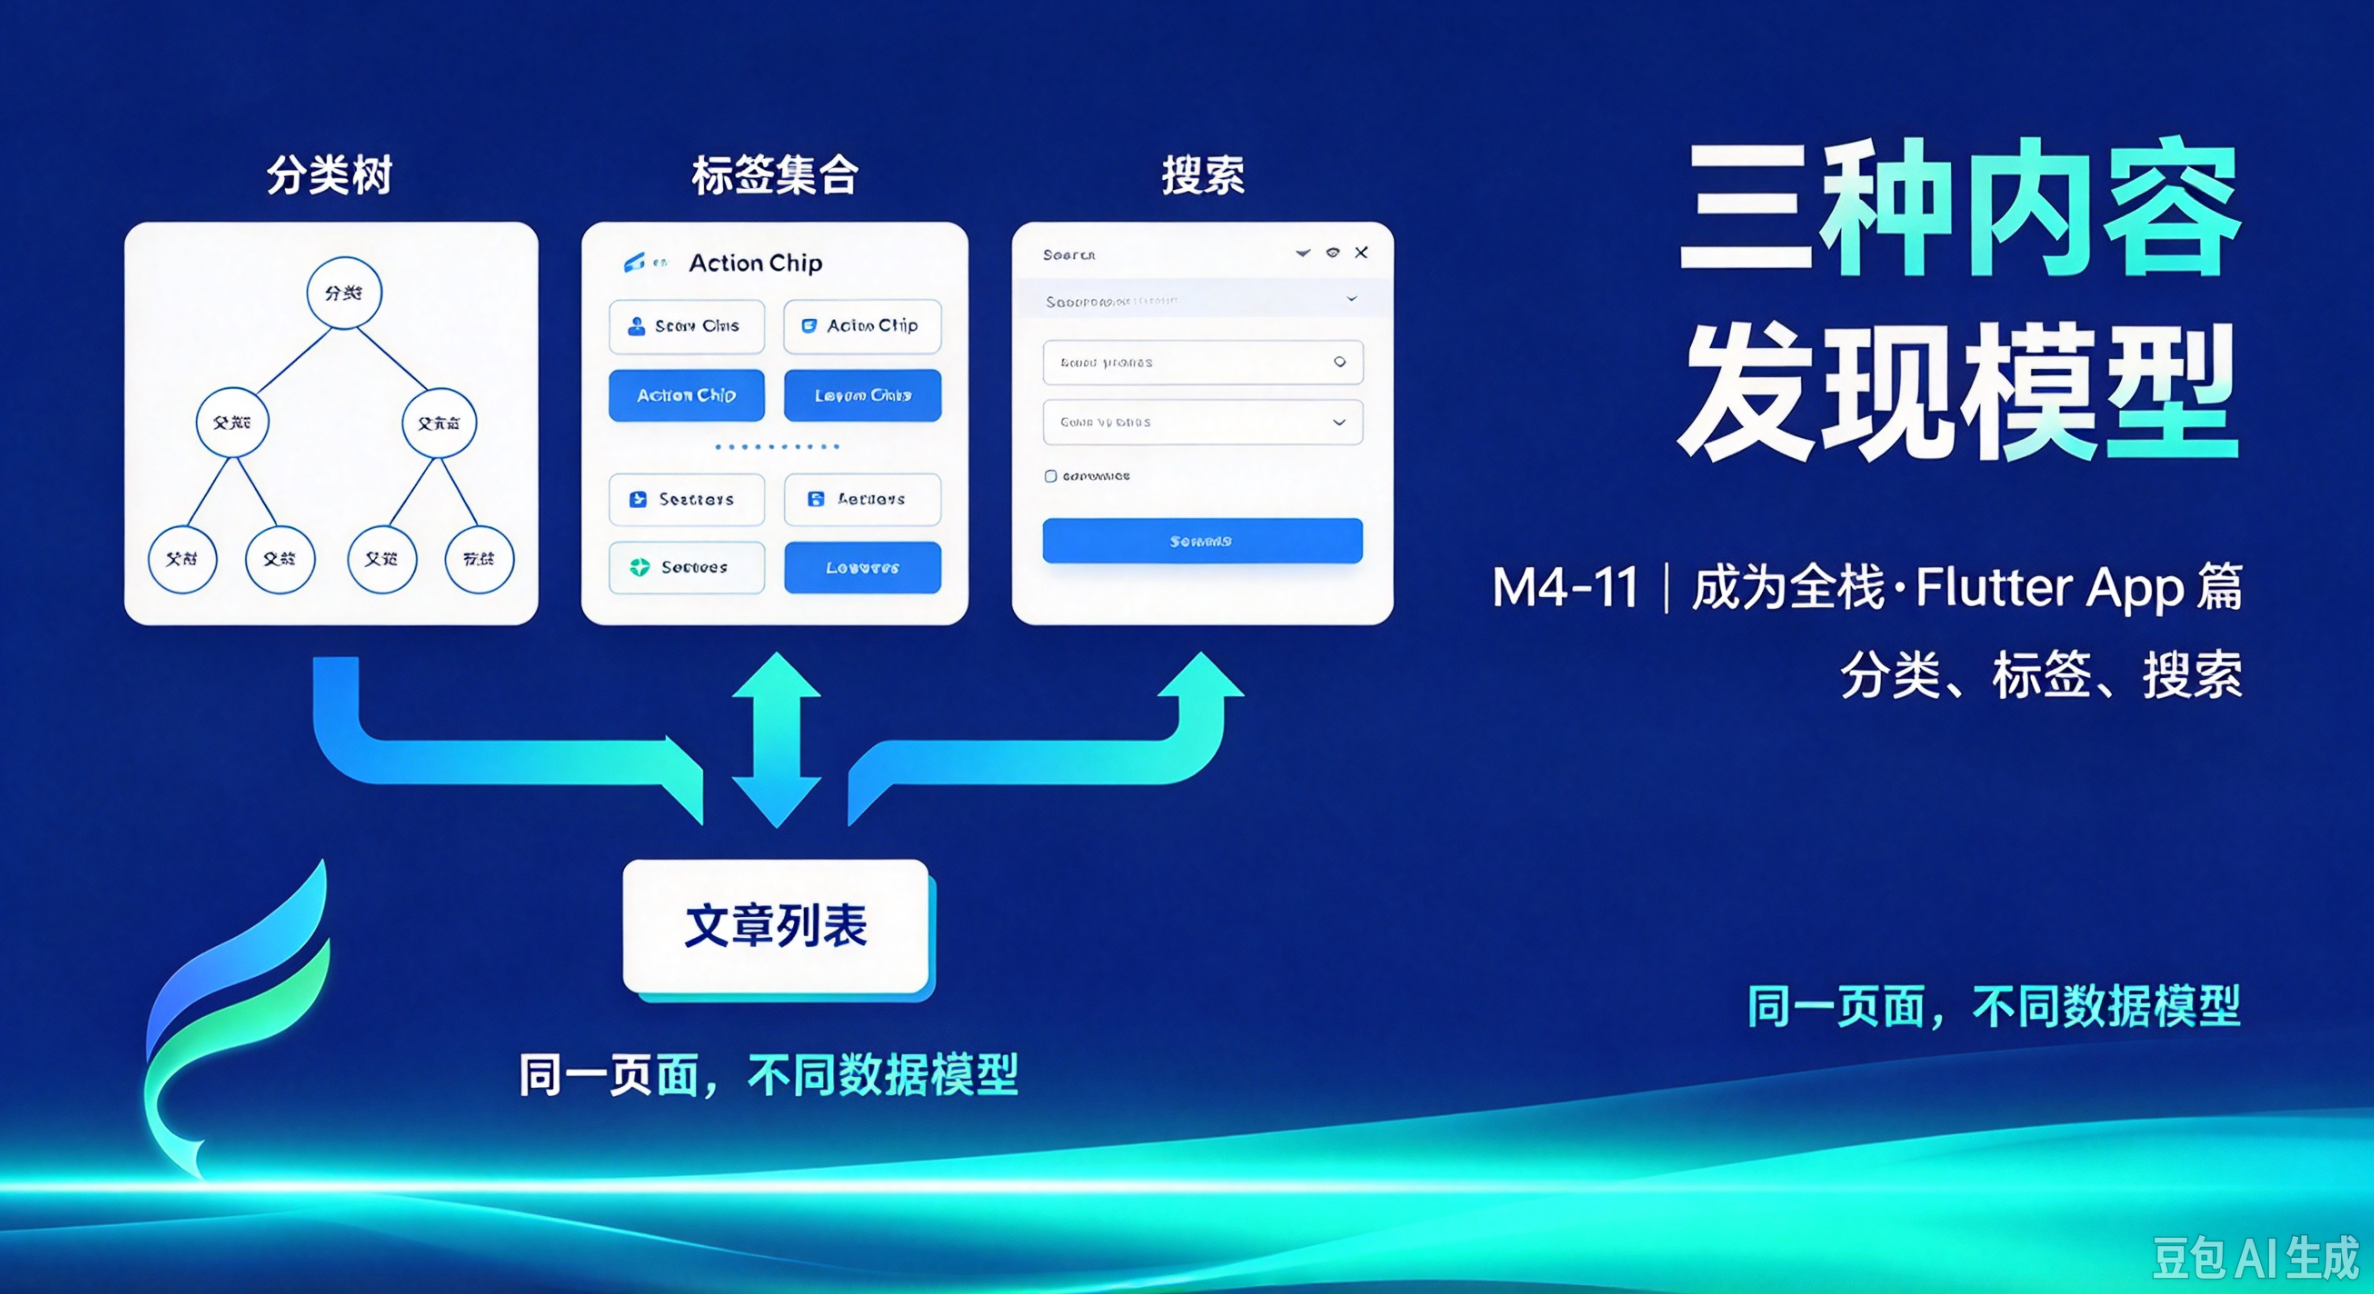
上一篇把首页接上了真实接口。接下来是内容发现的三个入口:分类、标签、搜索。
这三个功能看起来是三个页面,实际做完才发现它们共享一个核心难题,而且这个难题的解法写在契约里------如果我们没仔细读契约,会写出三份互相不兼容的代码。
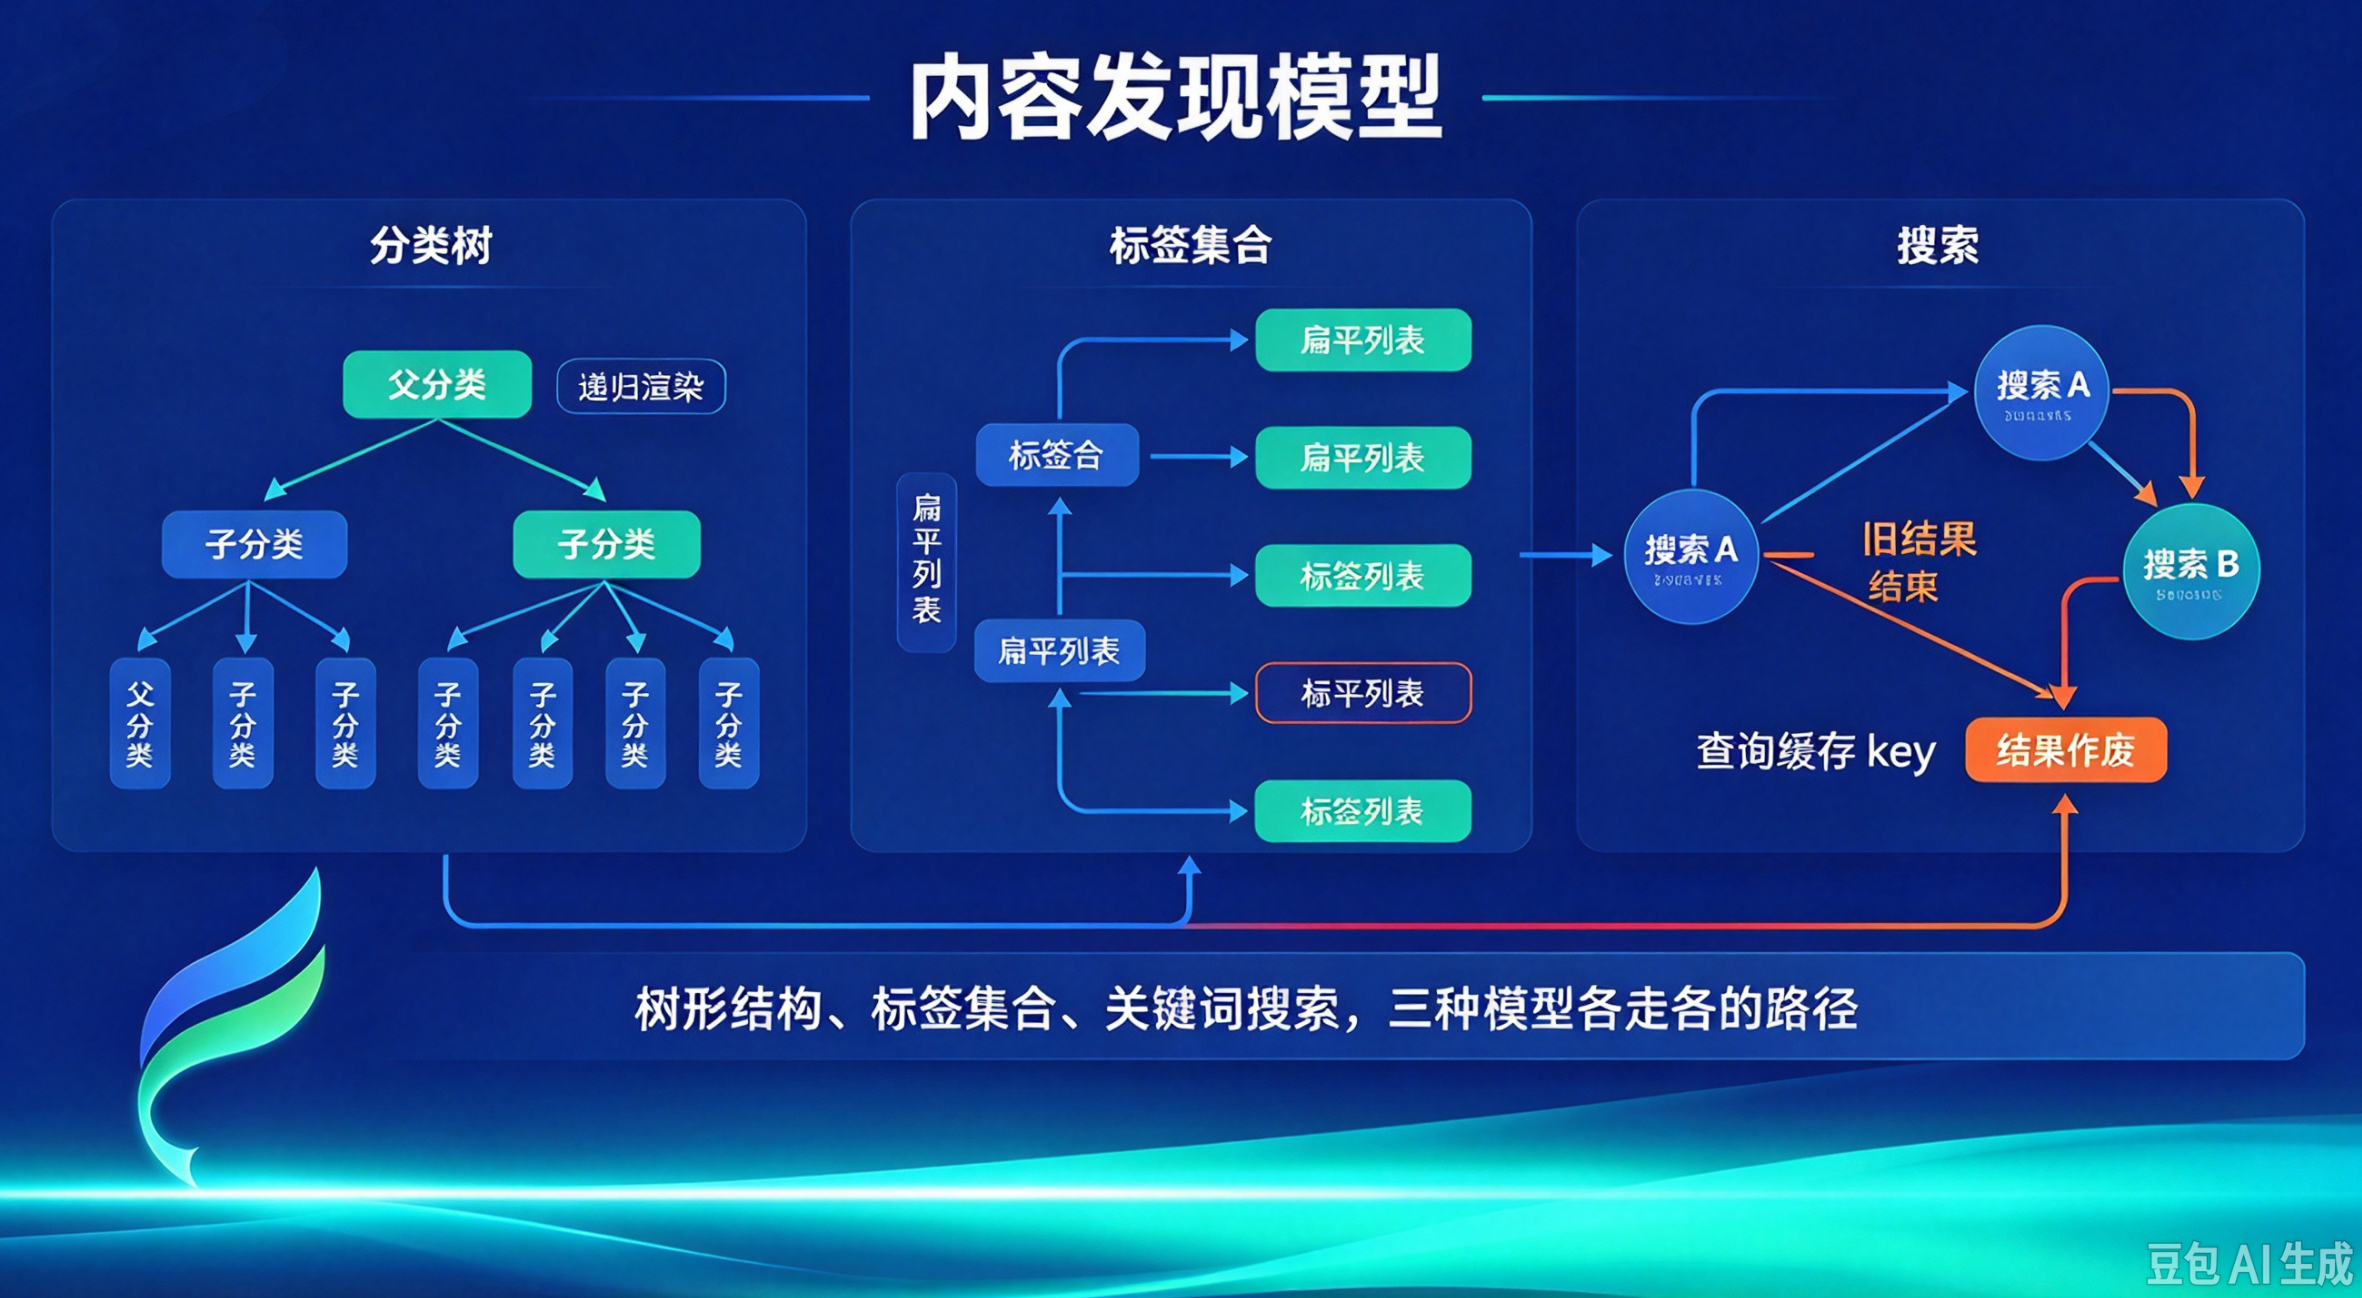
先说分类树。这个需求本身很清楚:无限级分类树,点父节点看"全部后代"的文章,每行右边显示文章数。
接口返回了树。我递归渲染就行了。
写完发现文章数显示不出来。
那个不存在的 articleCount
我先是检查了生成的模型,ApiCategoryNode 长这样:
dart
class ApiCategoryNode {
  ApiCategoryNode.fromJson(Map<String, dynamic> value)
    : json = Map.unmodifiable(value);
  final Map<String, dynamic> json;
  int? get id => (json['id'] as num?)?.toInt();
  String? get name => json['name'] as String?;
  String? get slug => json['slug'] as String?;
  String? get description => json['description'] as String?;
  int? get sortOrder => (json['sortOrder'] as num?)?.toInt();
  List<ApiCategoryNode> get children => (json['children'] as List? ?? [])
      .map((e) => ApiCategoryNode.fromJson(Map<String, dynamic>.from(e as Map)))
      .toList();
}六个字段,id / name / slug / description / sortOrder / children。没有 articleCount。
第一反应是"后端忘了返回"。但翻到契约才明白------这不是遗漏,是有意的设计。因为父分类的文章数 = 它自己和所有后代的文章数之和。如果把这个数存在分类表里,每次写文章都要更新整条祖先链,而分类树可能很深、可能有并发写。
所以契约把它拆成了两个接口:树给结构,统计单独给。
这个决定的连带影响是:Category 和 CategoryStat 是两个 schema,不是同一个。 而 articleCount 只存在于后者。
于是页面要发两个请求,还要把两个结果拼起来:
dart
child: AsyncPane<(List<ApiCategoryNode>, Map<int, int>)>(
  load: () async {
    final categories = await ref.read(repositoryProvider).categories();
    final stats =
        await ref.read(repositoryProvider).read(Endpoints.categoriesStats)
            as List;
    return (
      categories,
      {for (final c in stats) c['id'] as int: c['articleCount'] as int},
    );
  },
注意泛型是 (List<ApiCategoryNode>, Map<int, int>) 这个元组------因为这两个数据必须一起到齐才能渲染。分开渲染意味着"树先出来、数字后补",那还不如一起等。
而 AsyncPane 恰好能处理这种"一次 load 内部串两个请求"的情况,它只关心 load() 返回什么。
最后那个集合字面量 {for (final c in stats) c['id'] as int: c['articleCount'] as int} 把统计数组变成 id→count 的映射。用 Map 而不是 List 是为了 O(1) 查------渲染每个节点都要查它的数字,分类最多几十个但这个习惯值得养成。
为什么计数可以查不到
树里某个分类如果不在统计结果里(比如它是新加的、统计还没跑),counts[n.id] ?? 0 会得到 0。
这时候显示"0 篇"是撒谎------用户点进去可能明明有 8 篇文章。
不过这里我选择了显示 0,理由是:统计接口和树接口来自同一套后端,不一致的情况基本不存在;而如果真的不一致,显示空白反而会让用户以为是 bug。
这是个小判断,但它提醒我一件事:?? 0 这个默认值的合理性,取决于"缺数据"意味着什么。 在这里它意味着"没查到",而我判断"没查到"和"确实是 0"在用户看来没区别,所以可以合并。换个场景------比如文章总数------同样的写法就是错的。
无限级树的渲染:递归函数就够
树的渲染本身是标准递归,没什么可讲的:
dart
Widget node(BuildContext context, ApiCategoryNode n, Map<int, int> counts) =>
    n.children.isEmpty
        ? ListTile(
            leading: const SizedBox(width: 15),
            minLeadingWidth: 15,
            horizontalTitleGap: 8,
            contentPadding: AppInsets.pageHorizontal,
            title: Text(n.name ?? ''),
            trailing: Text('${counts[n.id] ?? 0} 篇', style: context.text.labelSmall),
            onTap: () => context.push(
              '/browse?category=${n.slug}&title=${Uri.encodeComponent(n.name ?? '分类文章')}',
            ),
          )
        : ExpansionTile(
            leading: const PrototypeIcon('chevr', size: 15),
            title: Text(n.name ?? ''),
            children: [
              ListTile(
                title: Text('全部${n.name}文章'),
                onTap: () => context.push(
                  '/browse?category=${n.slug}&title=${Uri.encodeComponent(n.name ?? '分类文章')}',
                ),
              ),
              for (final child in n.children)
                Padding(padding: AppInsets.nestedLeft, child: node(context, child, counts)),
            ],
          );
但有两个细节值得说。
一、叶子节点和父节点的交互不同。 父节点用 ExpansionTile(可展开看子分类),叶子用普通 ListTile(点击直接进列表)。如果叶子也给个展开箭头,点了没反应,那是最让人恼火的交互。
二、父节点额外插了一条"全部XX文章"。 因为父节点本身不是叶子,它不能只用来导航------用户看到"前端"这个分类,想要的是"前端下面所有文章",而不是"前端这一层的文章"。
页面里那句 PageIntro 把这个规则写清楚了:
按学习路径划分,父分类包含全部后代分类的文章。
这是契约之外的产品约定 。如果后端只按 category_id = 前端 过滤,用户点进去看到的就只有直接挂在"前端"下的那几篇,和他预期不符。这种语义必须在界面上说清楚,否则用户会以为数据错了。
导航参数用应用路由,不是 API 地址
注意 onTap 里那一串:
dart
context.push('/browse?category=${n.slug}&title=${Uri.encodeComponent(n.name ?? '分类文章')}');这里有个我差点写错的地方:我想当然地用了 n.id,后来改成了 n.slug。
理由是可读性和稳定性。路由里的 URL 会出现在浏览器历史、可能被分享、可能被收藏。用 slug 而不是 id 有两个好处:人看得懂;分类改名后 id 不变、slug 可能变,但用户收藏的旧链接至少有据可查。
而 title 参数需要 Uri.encodeComponent------分类名是用户可编辑的内容,里面可能有空格、&、# 。不转义的话 分类 & 标签 这种名字会直接把 URL 结构冲掉,点进去就 404 了。
这是个很容易漏的 bug:测试时用的分类名都是"前端""后端"这种纯中文无特殊字符,所以没问题;等有人建了个叫"A&B" 的分类才暴露。
顺带一句:/browse 这个路由是应用路由(M4-05 会讲 go_router),不是 API 地址。两者容易混淆,因为都在项目里出现。
标签:一个纯列表页
标签页比分类简单得多,因为它不需要树:
dart
final policies = CachePolicyTable();
// ...
ResourceFamily.statistics: _ReadRule(
  CachePolicy(Duration(minutes: 5), _day, disk: true),
  _Shape.list,
),
标签和分类统计在缓存表里属于同一个家族 dictionaries / statistics,缓存 5 分钟到 1 天,落盘。
给标签这么长的缓存是合理的,因为它们几乎不变------分类和标签是运营配置,不是用户内容。真正需要新鲜的是文章列表本身。
搜索:返回的东西不一样
搜索是这个系列里唯一一个响应形状完全不同的接口,M4-07 提过但没细说。
看仓库里那行代码:
dart
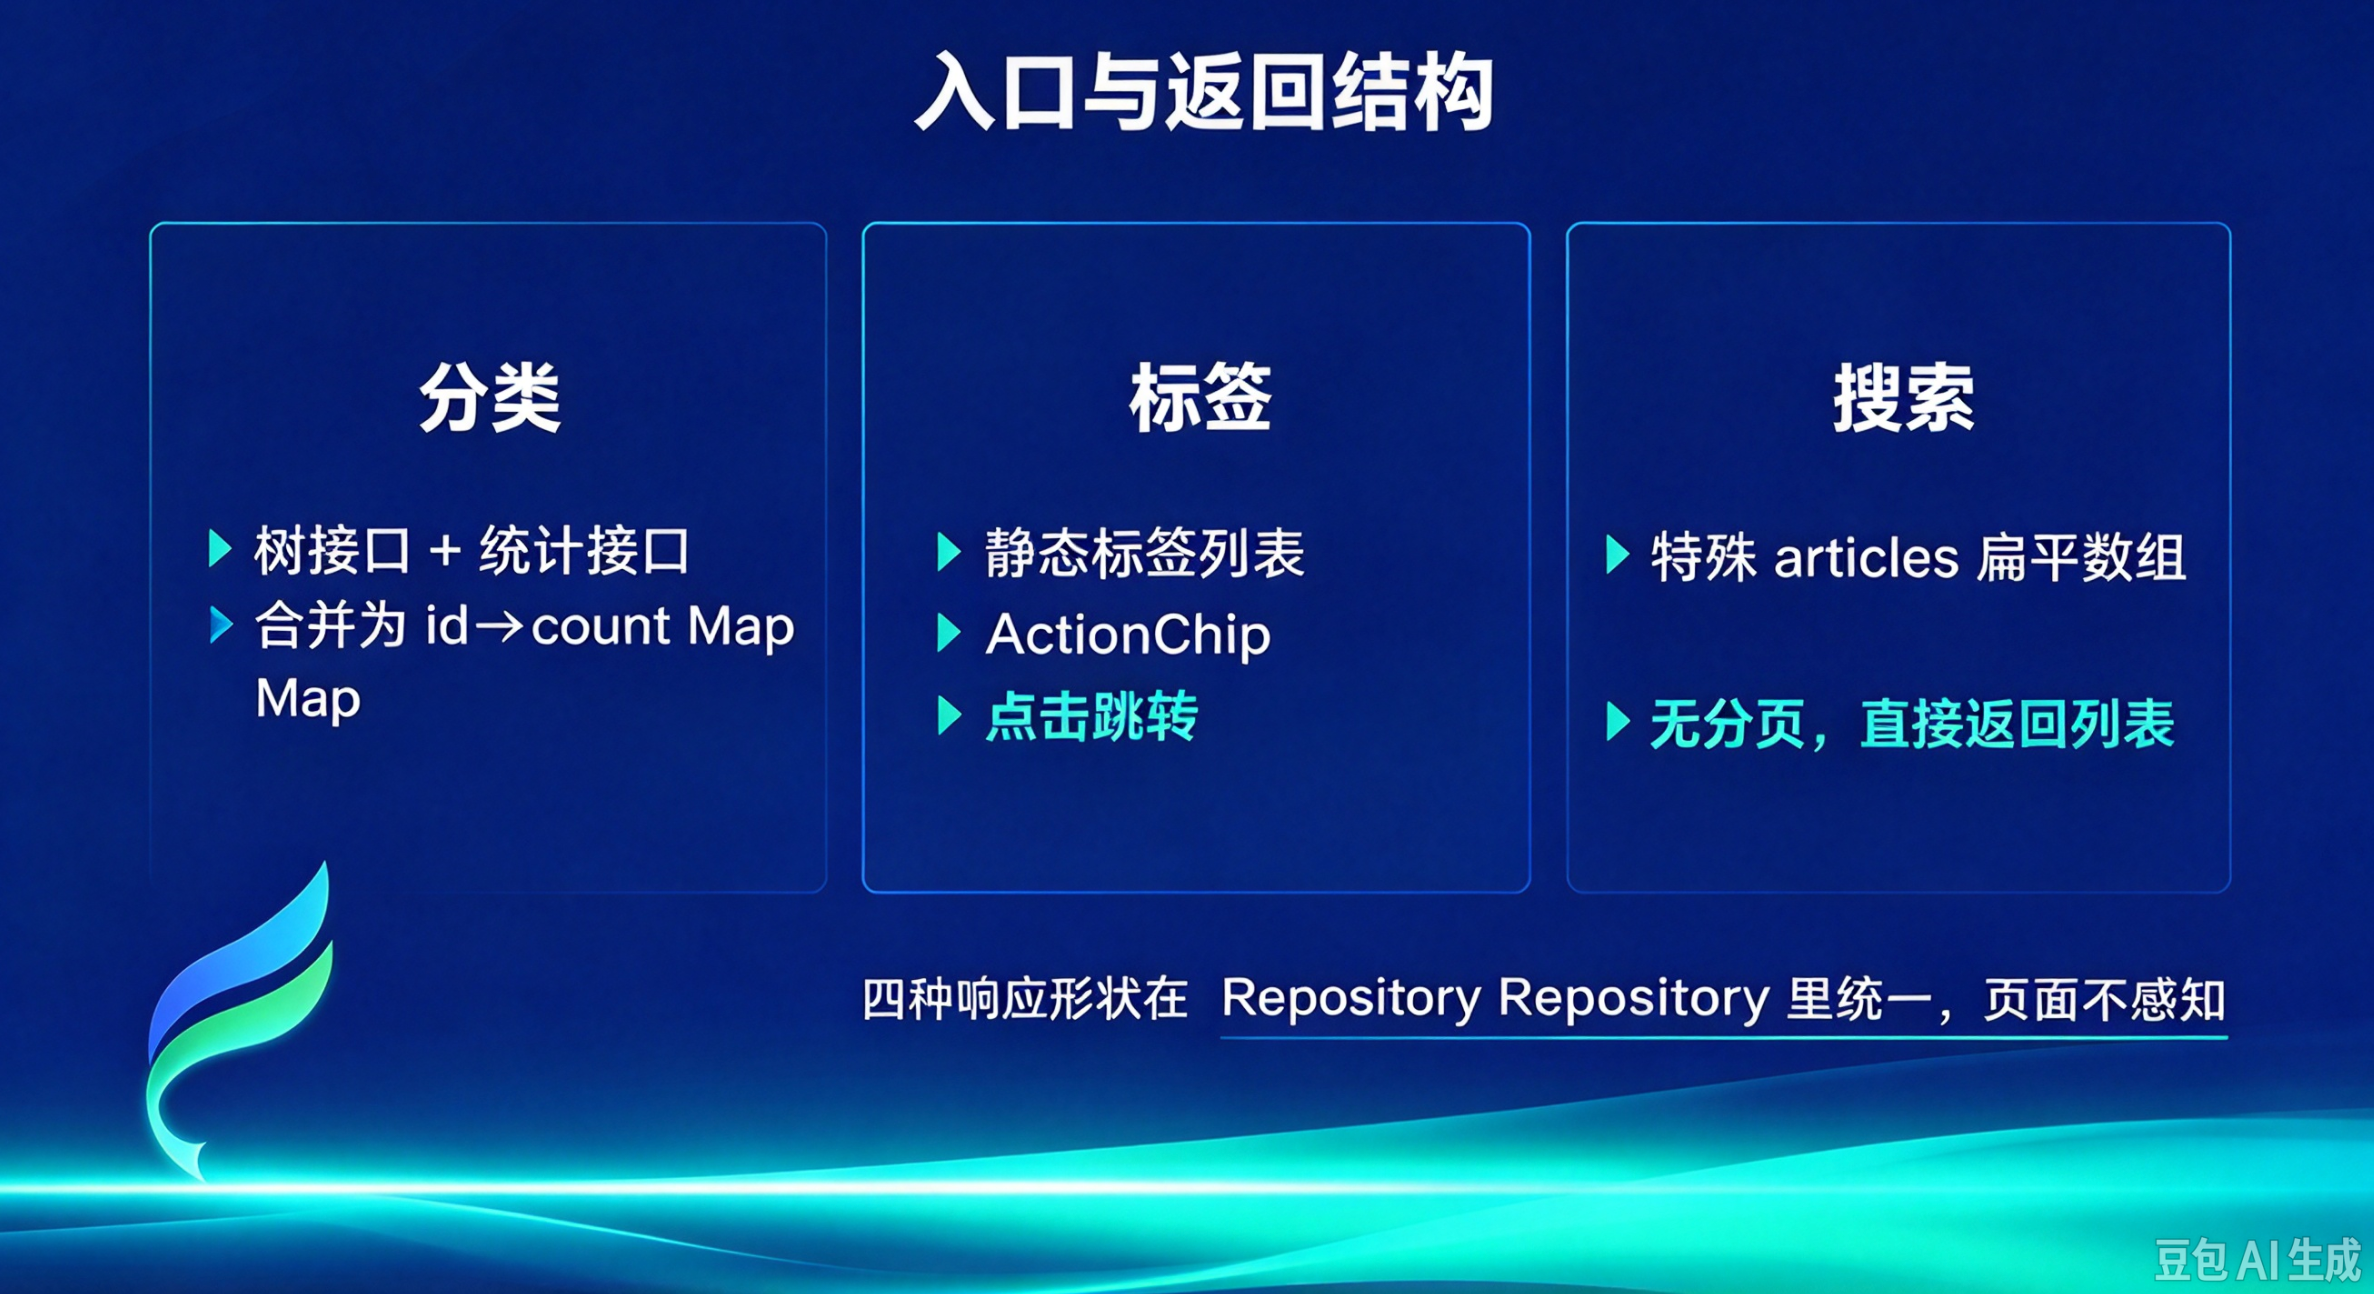
if (path == Endpoints.search) data = data['articles'];正常列表返回 {list, pagination},搜索返回 {articles: [...]}。为什么?
因为搜索的结果页需要展示"找到多少条",但搜索通常不分页------用户输入关键词,得到一个相关性排序的列表,没有"第 2 页"的概念(至少 v1 没有)。
所以服务端干脆不分页,直接给一个扁平的列表加总数。
这就是 M4-07 里那张表的实际应用:
| 端点 | 返回 | 分页 |
|---|---|---|
GET /articles |
{list, pagination} |
有 |
GET /articles/search |
{articles: []} |
无 |
GET /me/likes |
[] 裸数组 |
无 |
GET /me/history |
{list: [{article, progress}]} |
有 |
四种形状,四种处理方式,全在 Repository 里消化。 页面调用 repo.articles(path: searchEndpoint) 拿到的永远是 PageResult<Article>。
而搜索页自己是怎么用的:
dart
AsyncPane<List<ApiTag>>(
  load: ref.read(repositoryProvider).tags,
  builder: (tags, reload) => Padding(
    padding: AppInsets.page,
    child: Wrap(
      spacing: 8,
      runSpacing: 8,
      children: [
        for (final t in tags.take(8))
          ActionChip(
            label: Text(t.name ?? ''),
            onPressed: () => search(t.name),
          ),
      ],
    ),
  ),
)
搜索入口页展示"搜索历史 + 热门标签",点标签直接以它为关键词搜索。没有搜索结果也要有内容可看------一个空白的搜索框在用户进来时是完全无方向的。
tags.take(8) 是有意的:搜索入口页不是标签页,塞满标签会让首屏很长。真正的标签页在 /tags 路由。
搜索历史存在本地,不上传服务端。这是产品判断不是技术限制------搜索历史属于个人行为,不该进用户资料。这也和 M1 定的"注册只收必要的四件事"(username / email / password / nickname)一致。
三个入口的共性
分类、标签、搜索做完,回头看它们共享了四件事:
| 共性 | 体现 |
|---|---|
| 都是纯读取,不涉及写操作 | 不需要 mutationTags,不需要乐观更新 |
| 都是低频变更,只有搜索例外 | 缓存策略给得很长,分类统计 5 分钟到 1 天 |
都复用同一个 AsyncPane |
同一套加载中/错误/保旧值逻辑 |
| 都读同一个 Repository | 响应形状差异在 Repository 消化,页面不感知 |
第四点是最省事的地方。如果每个页面各写一套请求,搜索那处很可能忘了处理 {articles} 而不是 {list},而这个 bug 只在"点搜索"时才出现------测试环境和手动点一遍很容易漏过。
一条我一开始想省掉的事
分类页那个 AsyncPane 里,我最初是把两个请求写成并行的:
dart
// 错误示范:并行发,但没有处理部分失败
final categories = await ...categories();
final stats = await ...read(categoriesStats);
改成这样是因为我在意请求总数------首页会同时开好几个,两个串行请求会让最坏情况下的等待时间翻倍。
但这么写有问题:两个请求串行意味着第二个要等第一个。而它们其实没有依赖关系,可以并发。
正确写法是 Future.wait:
dart
final results = await Future.wait([
  ref.read(repositoryProvider).categories(),
  ref.read(repositoryProvider).read(Endpoints.categoriesStats),
]);
final categories = results[0] as List<ApiCategoryNode>;
final stats = results[1] as List;这两个改动的差别不大,但反映了一个更值得琢磨的点:串行和并行不只是"快一点慢一点",它会改变错误的性质。
串行时,第一个失败会抛异常,第二个根本不发------用户看到的是"分类加载失败",但其实统计接口是好的。并行时两个都发,第二个失败会让 Future.wait 抛异常,而第一个的结果白拿到了。
并行下部分失败要怎么处理,取决于业务。 这里的答案是"整体失败"(因为树和数字必须配套),但代码里必须写清楚这是有意的选择,否则下一个人会以为写漏了错误处理。
小结
分类、标签、搜索这三个功能,技术上都不复杂,但它们是"读契约"这件事最好的例子:
articleCount不在Category里 ------ 拆分统计接口是为了避免深层祖先链的并发写,代价是客户端要发两个请求再拼起来。- 搜索返回
{articles}而不是{list, pagination}------ 因为搜索不分页。四种响应形状在 Repository 里统一,页面完全不感知。 - 分类树要能任意深度 ------ 递归渲染不难,难的是"父分类包含全部后代"这个语义必须在界面上说明。
- 导航用 slug 而不是 id ------ 顺带提醒:分类名是用户输入,
encodeComponent不能省。
真正省下来的力气来自复用:AsyncPane 管加载状态,Repository 管响应形状,CachePolicyTable 管缓存时长。这三个页面本身只有几十行,而且没有一行和网络细节有关。
下一篇讲 Markdown 阅读器------那是另一个量级的复杂度:把一份不可控的文本安全地变成 Widget。
延伸阅读
如果这篇文章对你有帮助,欢迎订阅我的 CSDN 专栏 「成为全栈」:
🔗 专栏地址:https://blog.csdn.net/fungleo/category_13204651.html
📦 本系列配套代码仓库:https://github.com/fengcms/become-a-full-stack-developer