写语音转写的调用时,我习惯把热词当效果开关:加一个参数,期待专名被认对,然后只看转写文本对不对。这一轮拆下来,参数面比想象中大,bl speech recognize 上有三个互不相同的入口,bl speech vocabulary 下面还有一组建表命令,三条通道的生效模型范围、取值约束、配错之后的行为都不一样。错配那一条我连试了三次,三次结果一样,和帮助文本写的相反。
帮助文本给的是每个 flag 的取值和范围,不给"配错之后返回里会露出什么"。这篇把这张映射表补出来,用的是阿里云百炼 CLI(bl 2.1.0)里的 bl speech 命令组。
取数口径先摆明:转写模型 qwen-audio-3.0-asr-flash,素材是我用语音合成现做的两段(不是真实录音),所有输出是 2026-10-14 我在自己电脑上跑出来的。语音识别有随机性,每条读数后面都跟着重复次数。工具在 CLI 安装页,一条 npm 命令。
一、基线:三个模型里只有一个会听错
热词有没有增量,得先有一个会听错的基线。我合成了一段塞满生僻专名的话:
请把 XQ-7734 号工单转给岑巩县的冉雍,抄送珞珈三号项目组的仇池和濮阳办事处。
bash
bl speech recognize --url audio2.mp3 --model qwen-audio-3.0-asr-flash --language zh| 模型 | 基线结果 |
|---|---|
| fun-asr | 全对 |
| fun-asr-flash-2026-06-15 | 全对 |
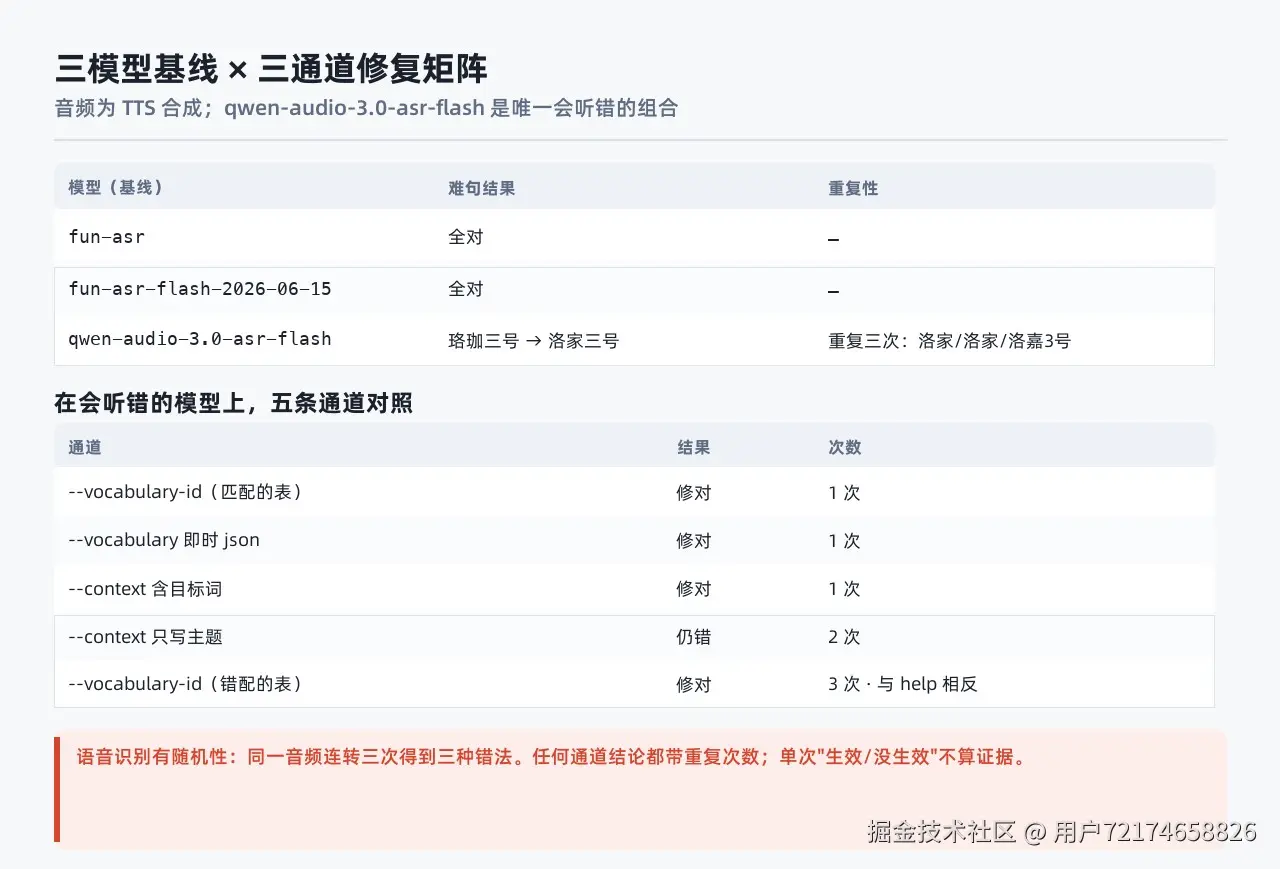
| qwen-audio-3.0-asr-flash | 珞珈三号 → 洛家三号,其余全对 |
只有第三个模型听错,后面的对照都在它身上做。它的错本身不稳定:同一段合成音频连转三次,拿到过"洛家三号""洛家三号""洛嘉3号"三种写法。
对写代码的直接影响是:单次结果不能当判据,采样本身在抖。下面每条读数我都标了重复次数,你的实现里也应该把重复次数写进测试用例。
想用的第四个模型 qwen3-asr-flash 没跑起来,返回 HTTP 403 AllocationQuota.FreeTierOnly,口径是免费额度用尽、要续费用或者去控制台关掉"仅用免费额度"模式。余量数字我这边查不到(控制台会话过期),去控制台额度页看当天读数。
二、三条通道的参数面
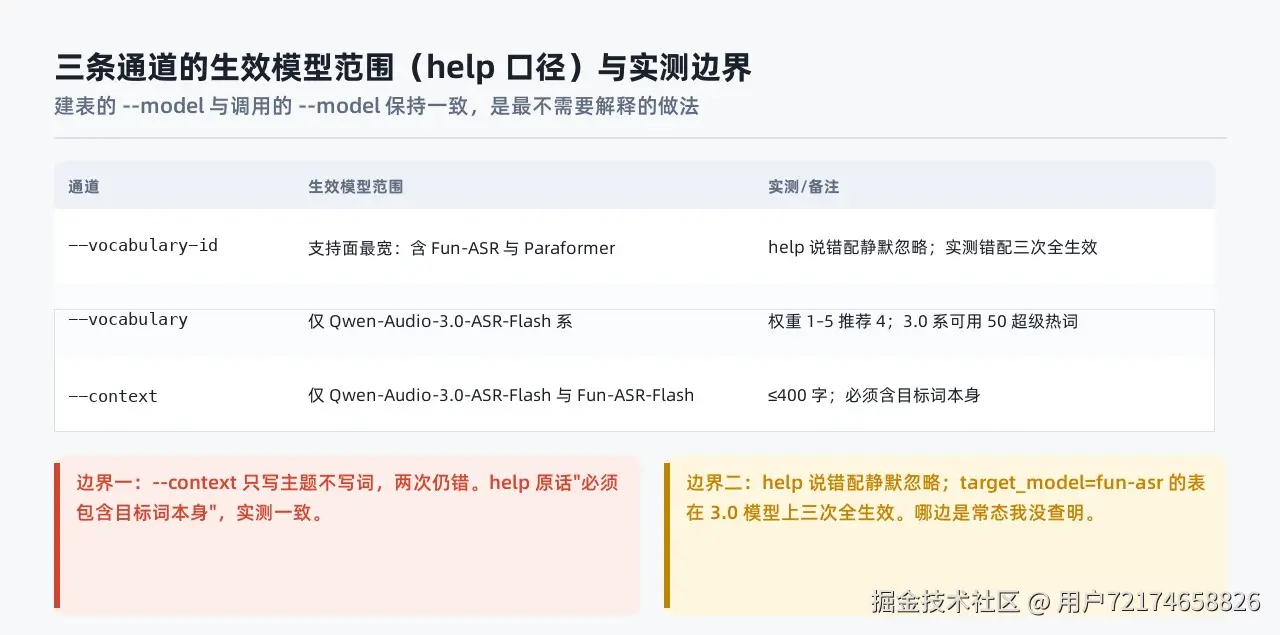
| 通道 | 参数写法 | 要不要预建资源 | 取值约束 | 帮助文本写的生效范围 | 这段合成音频上的读数 |
|---|---|---|---|---|---|
| 预编译热词表 | --vocabulary-id <表 ID> |
要,先 vocabulary create |
权重 1 到 5,帮助文本推荐 4;Qwen-Audio-3.0 系可用 50 的超级热词;--prefix 小写字母加数字、最长 10 位 |
建表 --model 与调用 --model 一致 |
1 次,珞珈三号修对 |
| 即时热词 | --vocabulary '{"珞珈三号":4,"仇池":4}' |
不要 | 权重口径同上 | 只对 Qwen-Audio-3.0-ASR-Flash 系列生效 | 1 次,修对 |
| 上下文词表 | --context "珞珈三号 仇池" |
不要 | 最长 400 字,必须含目标词本身 | Qwen-Audio-3.0-ASR-Flash 与 Fun-ASR-Flash | 1 次,修对 |
三条通道的写法:
bash
bl speech vocabulary create --model qwen-audio-3.0-asr-flash --prefix hw1014a --words '{"珞珈三号":4,"仇池":4}'
bash
bl speech recognize --url audio2.mp3 --model qwen-audio-3.0-asr-flash --language zh --vocabulary-id <表 ID>
bash
bl speech recognize --url audio2.mp3 --model qwen-audio-3.0-asr-flash --language zh --vocabulary '{"珞珈三号":4,"仇池":4}'
bash
bl speech recognize --url audio2.mp3 --model qwen-audio-3.0-asr-flash --language zh --context "珞珈三号 仇池"建表返回一个 vocab- 开头的 ID,那是通道一的引用键。选型落到实现上就是三句话:词表长期不变、多个服务共用,建一次表反复引用;一次性的调用直接内联 JSON;手里只有一份词清单、不想给权重,用 --context。
表里三条通道各只有 1 次读数,够说明这条通道能把词修对,不够当稳定性结论。写进你们自己的测试用例之前,按第八节第 2 条重复跑。
三、错配 --vocabulary-id:与帮助文本相反的一组读数
这一节的现象我重复了三次。帮助文本对 --vocabulary-id 和建表时的 --model 写着同一句话:必须与之后 recognize 传的完全一致,否则热词表被静默忽略。
我按这句话设计了一次错配:另建一张表,建的时候声明给 fun-asr,然后喂给 qwen-audio-3.0-asr-flash。表的归属事后核过,bl speech vocabulary get --id <表 ID> 返回的 target_model 字段确实是 fun-asr。
bash
bl speech recognize --url audio2.mp3 --model qwen-audio-3.0-asr-flash --language zh --vocabulary-id <fun-asr 的表>连试三次,三次都把珞珈三号修对了,没有被忽略。
反方向观察不到:把 3.0 的表喂给 fun-asr,而 fun-asr 基线本来就全对,修没修在输出上看不出差别。
所以这一节只报现象:帮助文本的"错配静默忽略"在我这个组合上没复现,重复三次;哪边是常态、是不是同族模型之间本来就互通,我没查明,也不给一个听起来合理的推测。
写进实现的那一句是:不要把"错配会被自动忽略"当兜底逻辑。建表的 --model 和调用的 --model 保持一致,把这条不确定性从代码路径里拿掉。
四、--context 的两条硬约束
第一条是范围:只对 Qwen-Audio-3.0-ASR-Flash 和 Fun-ASR-Flash 生效,别的模型上带了也白戴。第二条是内容形态,这条我专门验了:
bash
bl speech recognize --url audio2.mp3 --model qwen-audio-3.0-asr-flash --language zh --context "卫星工单项目组办事处"参数里只有主题词,一个目标词都没有。连试两次,两次都还是洛家三号。帮助文本原话是"必须包含目标词本身,只写主题描述作用很小",这一条实测与它一致,可以当结论用。
也就是说 --context 是词表,不是话题提示器。想靠"告诉模型这段在讲什么"把专名救回来,这条路不通;400 字的上限要留给词本身。
五、错误码与拦截行为对照表
| 触发条件 | 返回 | 口径与处理 |
|---|---|---|
调 qwen3-asr-flash |
HTTP 403 AllocationQuota.FreeTierOnly |
免费额度用尽;续费用或去控制台关掉"仅用免费额度"模式。余量去控制台额度页看,别写死在代码里 |
vocabulary delete 不带 --yes |
命令被拦下,提示永久删除、不可撤销、加 --yes 重跑 |
高风险闸;脚本里要显式传 --yes,并把这个分支当失败处理 |
vocabulary get 一个已删的 ID |
400 资源不存在 | 删除生效的复核信号 |
vocabulary get --vocabulary-id <id> |
未知参数 | get 与 delete 用 --id,recognize 才用 --vocabulary-id |
六、参数名对照表
参数名不统一是这组命令里最容易抄错的地方,我自己在 get 上写成 --vocabulary-id 报过一次"未知参数"。
| 命令 | 参数 | 作用 |
|---|---|---|
bl speech vocabulary create |
--model / --prefix / --words |
表的目标模型 / 前缀(小写字母加数字,最长 10 位)/ 词与权重的 JSON |
bl speech vocabulary list |
无 | 列出工作空间里的表 |
bl speech vocabulary get |
--id |
查单张表,可读 target_model 字段 |
bl speech vocabulary delete |
--id / --yes |
删除;不加 --yes 被拦 |
bl speech recognize |
--vocabulary-id |
引用预编译热词表 |
bl speech recognize |
--vocabulary |
即时热词 JSON,内联不建表 |
bl speech recognize |
--context |
上下文词表,纯词无权重 |
七、资源纪律:别人的表只读,自建的表测完删
工作空间里原本有三张别人 09-09 建的表,我全程只 list 和 get,没有改也没有删。自己建的两张用了独立前缀,测完删掉,删完做两次复核:bl speech vocabulary list 里只剩那三张,bl speech vocabulary get --id <已删 ID> 返回 400 资源不存在。
共享工作空间里跑实验,这两步值得写进流程:用独立前缀让资源可辨识,删完用 list 加 get 双向确认。只跑 delete 不看复核,等于不知道删掉的是哪一张。
鉴权口径顺带记一句:合成音频、转写、建表删表都要 Key,list 和 get 同样要,这组命令没有完全免鉴权的那一档。Key 在 API Key 签发页 签发。
八、可以抄进代码的六条
- 先跑基线,确认你的合成音频与模型组合真的会听错再上热词;全对的组合加热词没有可测量的增量
- 语音识别有随机性,任何通道结论至少重复两次,把重复次数写进用例
- 长期词表走
vocabulary create+--vocabulary-id;临时调用走--vocabulary;只有词清单走--context --context必须含目标词本身,写主题没用(实测两次仍错)- 建表的
--model与调用的--model保持一致;帮助文本的"错配静默忽略"这次没复现,别拿它当兜底逻辑 delete有高风险闸,不加--yes会被拦;删完 list + get 双重复核
九、读数汇总,和会变的部分
| 读数 | 值(2026-10-14) | 命令 |
|---|---|---|
| 三模型基线(难句) | 两家全对、一家珞珈三号 → 洛家三号 | bl speech recognize --url <合成音频> --model <m> --language zh |
| 听错那家的基线重复 | 三次三种写法:洛家三号 / 洛家三号 / 洛嘉3号 | 同上 ×3 |
| 三通道修复 | 各 1 次均修对 | 加 --vocabulary-id / --vocabulary / --context |
--context 只写主题 |
两次仍错 | --context "卫星工单项目组办事处" |
错配 --vocabulary-id |
三次全生效,与帮助文本相反 | 表 target_model=fun-asr,调用 --model 为 3.0 |
qwen3-asr-flash |
HTTP 403 AllocationQuota.FreeTierOnly |
免费额度用尽口径 |
| 删除闸 | 不带 --yes 拦截,带 --yes 删除,复核为空 |
bl speech vocabulary delete --id <id> |
会变的是模型在架名单、额度状态、热词表清单这三类,命令签名相对稳定。重跑一遍就有你当天的读数,映射表按你那次的返回重画一次即可。
下一轮我想把错配这件事换几个模型族组合再跑一遍,看能不能把"哪边是常态"这个问题查清楚;查清楚了再回来补第三节。
十、这次没覆盖的
字幕链路(识别加翻译加时间轴)是另一篇的事,这篇只共用 recognize 一条命令。实时流式识别(realtime 系列模型)不在范围内。真实带噪素材我手里没有,这一篇用的是合成音频,噪声环境下的表现以你自己那次为准。花费与额度走控制台账单页与额度页,查不到就不写数字。
你们的转写服务里热词是怎么下发的,每次调用内联 JSON,还是建一张长期表共用?另外错配 --vocabulary-id 这件事,你们在自己的模型组合上试过吗,我想知道三次全生效是不是只有我这边这样。