Qwen-Image-2.1-Turbo 发布:8 步出图,文生图与图像编辑合二为一
摘要 :Qwen-Image-2.1-Turbo 是通义千问团队在 2026 年 10 月 9 日发布的图像生成模型,权重同步开放。它沿用 7B 视觉生成架构 ,却是 Qwen-Image-2.1 的官方加速版 ------去噪步数从常规水平压到 8 步 ,并把推荐采样 schedule 直接写进 checkpoint。更重要的是,它承接了 2.1 这一代的核心变化:文生图与图像编辑不再分成两个模型 ,还原生支持透明图像 、最多可输入 10 张参考图。本文按"能力 → 提升 → 加速原理 → 规格"的顺序做一次完整介绍。
关键词 :
QwenQwen-Image文生图图像编辑透明图层多参考图扩散模型DiffusersAI绘画
文章目录
- [Qwen-Image-2.1-Turbo 发布:8 步出图,文生图与图像编辑合二为一](#Qwen-Image-2.1-Turbo 发布:8 步出图,文生图与图像编辑合二为一)
-
- 一、模型速览
- 二、能力升级:这一代新增了什么
-
- [2.1 把文生图与图像编辑合二为一](#2.1 把文生图与图像编辑合二为一)
- [2.2 原生透明图像:生成与编辑都能带 Alpha 通道](#2.2 原生透明图像:生成与编辑都能带 Alpha 通道)
- [2.3 多参考图:最多可输入 10 张](#2.3 多参考图:最多可输入 10 张)
- [2.4 局部精修:圈选、涂画与独立蒙版](#2.4 局部精修:圈选、涂画与独立蒙版)
- [2.5 文字排版与人像质感](#2.5 文字排版与人像质感)
- 三、体验提升:比上一代好在哪
- [四、Turbo 加速:8 步出图是怎么做到的](#四、Turbo 加速:8 步出图是怎么做到的)
-
- [4.1 三条改动互相配合](#4.1 三条改动互相配合)
- [4.2 一个必须知道的细节](#4.2 一个必须知道的细节)
- [4.3 它带来的实际变化](#4.3 它带来的实际变化)
- 五、规格与官方优势总结
-
- [5.1 官方总结的四大核心优势](#5.1 官方总结的四大核心优势)
- [5.2 支持的分辨率预设](#5.2 支持的分辨率预设)
- [5.3 权重文件构成](#5.3 权重文件构成)
- 六、怎么用上它
-
- [6.1 本地部署(Diffusers)](#6.1 本地部署(Diffusers))
- [6.2 云端调用](#6.2 云端调用)
- [6.3 关于显存的说明](#6.3 关于显存的说明)
- 七、使用前要留意的两点
- 八、小结
- 相关链接
一、模型速览
一句话定位 :Qwen-Image-2.1-Turbo 是 Qwen/Qwen-Image-2.1 的加速版 checkpoint,官方对它的定位是------"目前 Qwen-Image 系列中综合表现与性价比最优的开源图像生成模型"。
| 项目 | 内容 |
|---|---|
| 模型名称 | Qwen-Image-2.1-Turbo |
| 发布方 | 通义千问(Qwen)团队 |
| 发布时间 | 2026-10-09(权重同步开放) |
| 基座模型 | Qwen/Qwen-Image-2.1(该版本于 9 月 20 日开源) |
| 架构 | 70 亿参数视觉生成架构,32 层单流 DiT |
| 去噪步数 | 8 步 |
| 精度 / 框架 | BF16 / PyTorch、diffusers、safetensors |
| 加载方式 | Diffusers 的 QwenImage21Pipeline |
| 许可证 | Qwen Research License Agreement |
| 在线体验 | 支持(含图生图在线微件) |
截至 2026-10-11,该模型在魔搭社区的公开数据为:下载 2,100 次、Star 85、收藏 34、已生成图片 435 张。
它最值得关注的一点 :这不是一次单纯的"提速"------加速版和基座共享的是同一条能力主线,所以理解 2.1 这一代带来了什么,才是理解这个模型的关键。
二、能力升级:这一代新增了什么
2.1 把文生图与图像编辑合二为一
这是 2.1 这一代最核心的架构性变化。
以往做 AI 作图,通常要面对两个割裂的模型:一个负责"从零生成",一个负责"改图"。而 Qwen-Image-2.1 把两者整合进同一个模型 ,官方把它概括为"原生透明,生成与编辑一体化"。
| 能力项 | 说明 |
|---|---|
| 输入模态 | 文本 + 图像 |
| 输出模态 | 图像 |
| 任务形态 | 文生图、图生图、图像编辑统一在同一模型内 |
这个变化带来的是工作流层面的简化:不再需要在"生成模型"和"编辑模型"之间反复切换、来回导数据。
2.2 原生透明图像:生成与编辑都能带 Alpha 通道
这是 2.1 系列最能直接改变创作流程 的能力。它不是在生成后再去抠图,而是模型原生支持透明通道:
| 场景 | 能力 |
|---|---|
| 直出素材 | 用提示词直接生成带透明通道的图像 |
| 改透明图 | 修改透明图层中的人物表情或文字 |
| 提取主体 | 从真实照片中把主体提取出来,便于后续排版与合成 |
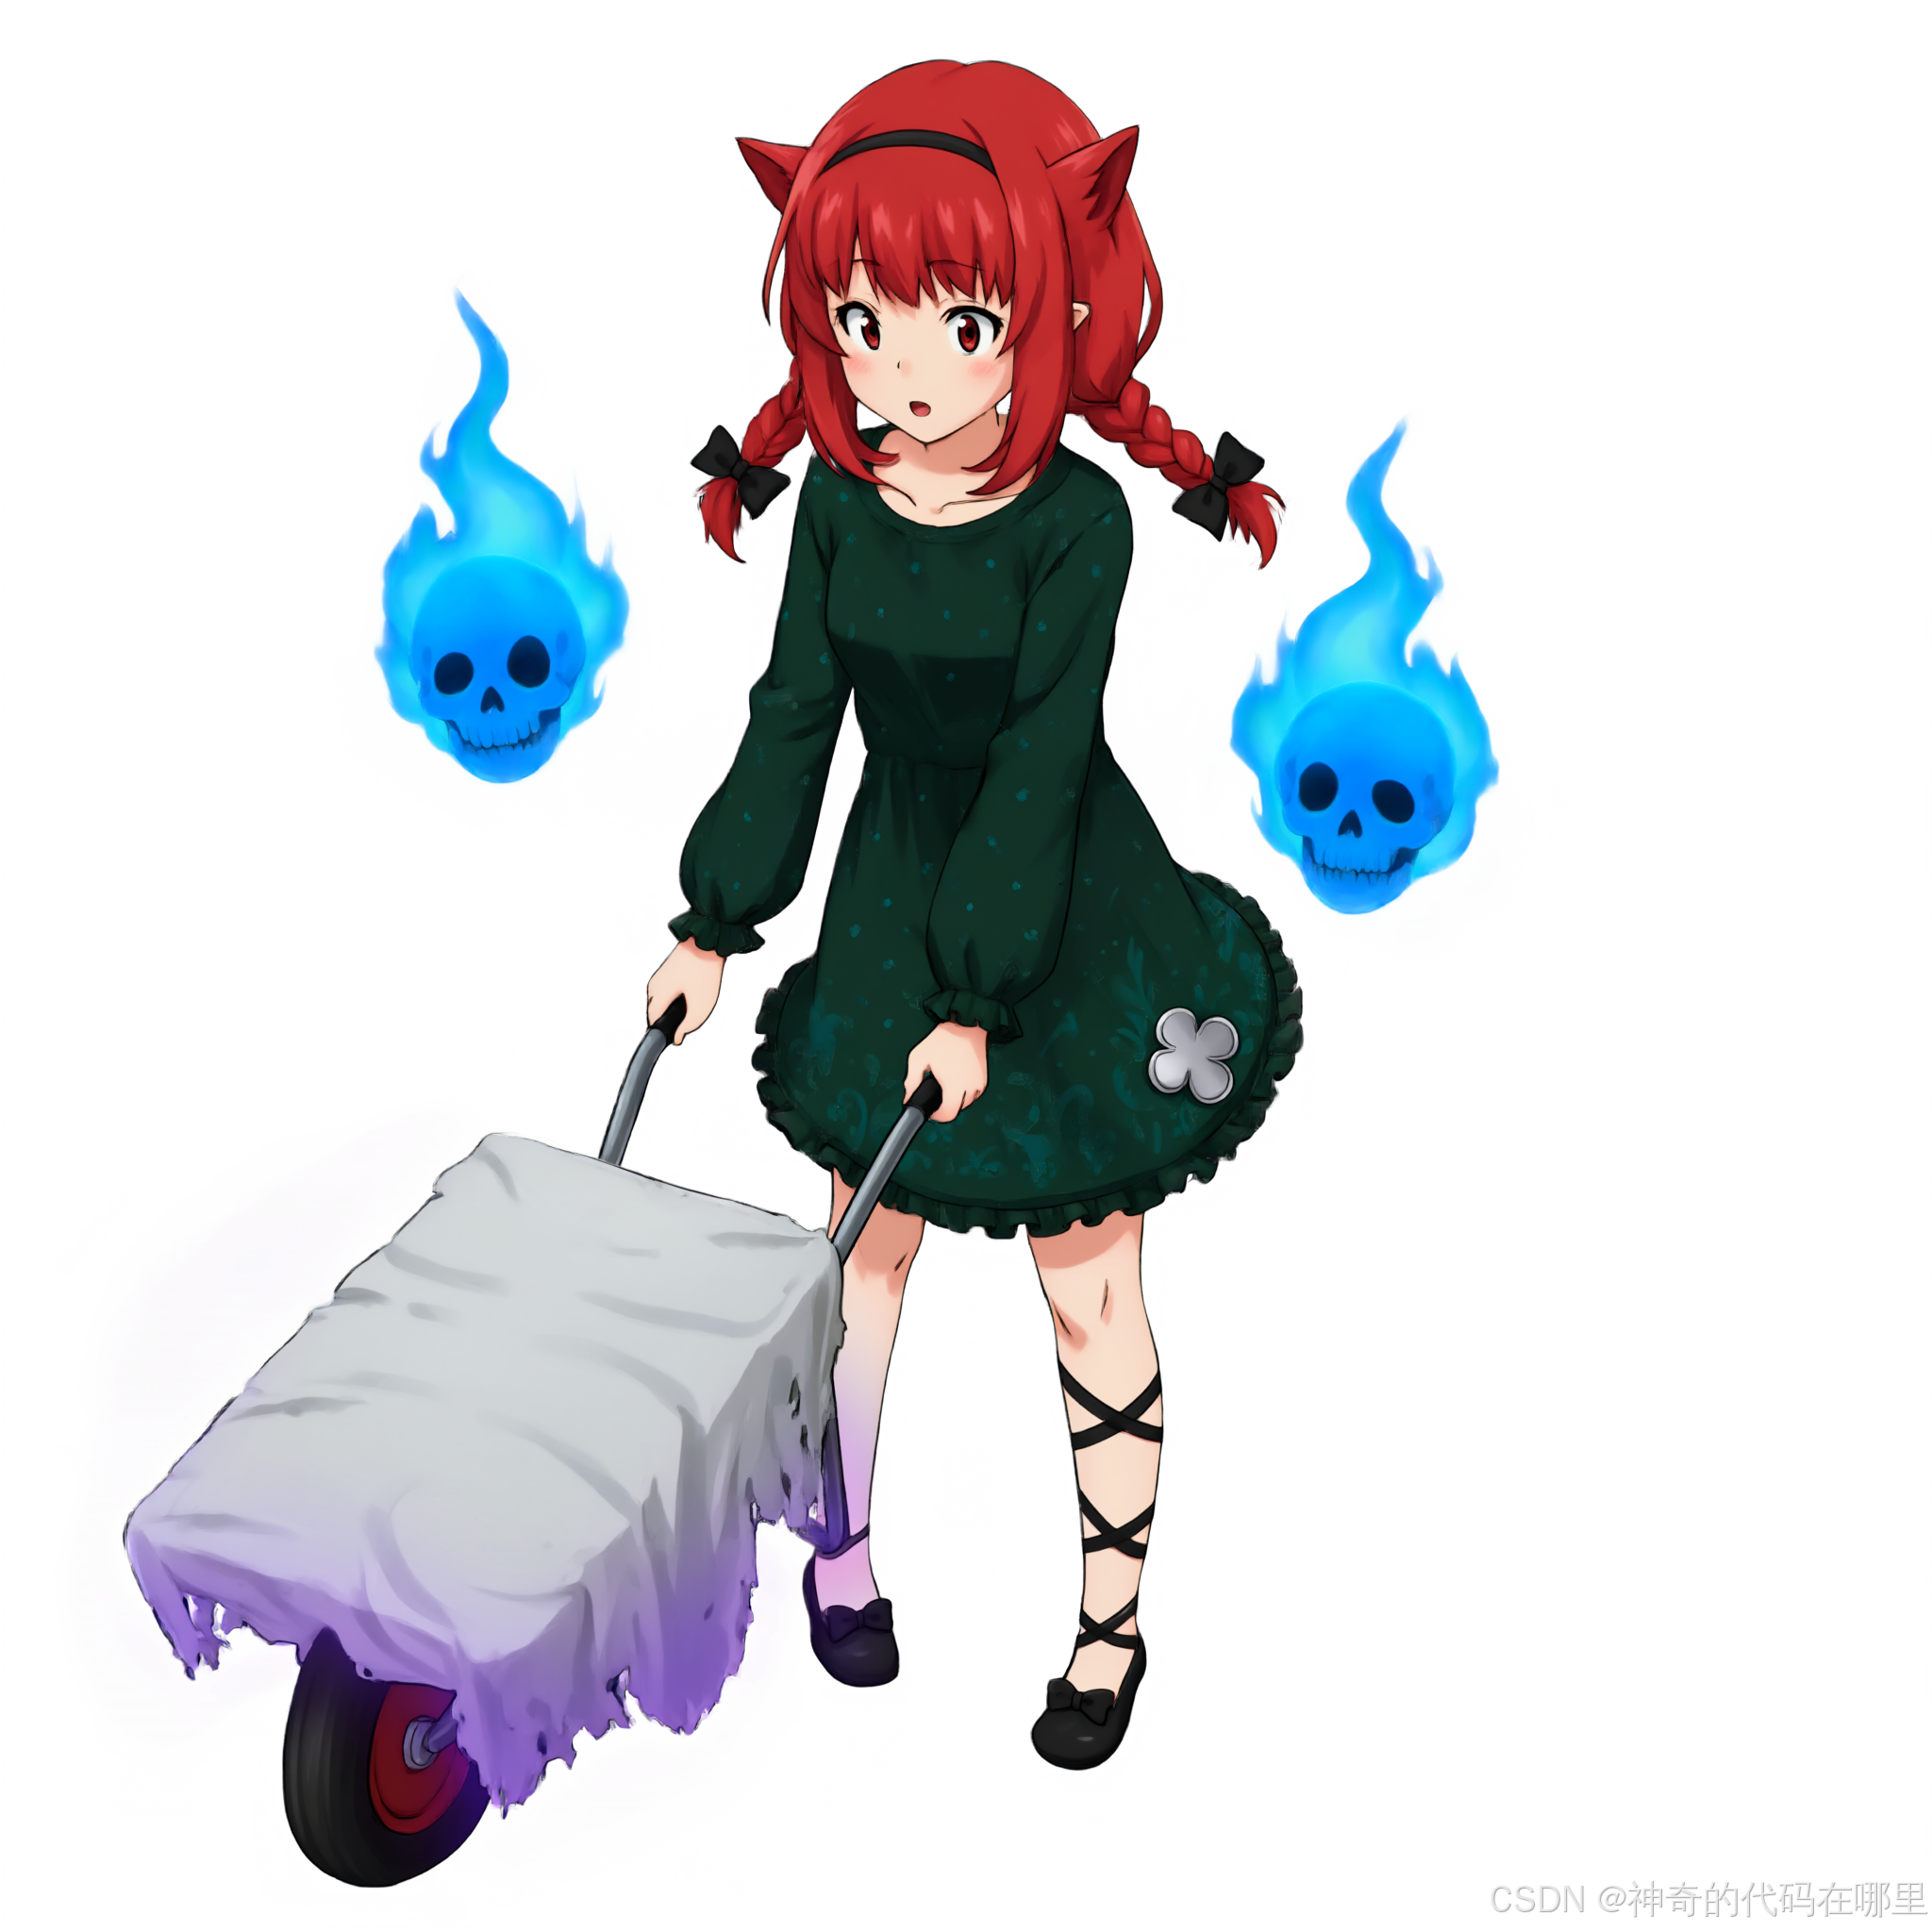
对设计场景来说这一点价值很大:过去"生成 → 抠图 → 手动修边缘"要三步,现在可以直接产出可用素材。
2.3 多参考图:最多可输入 10 张
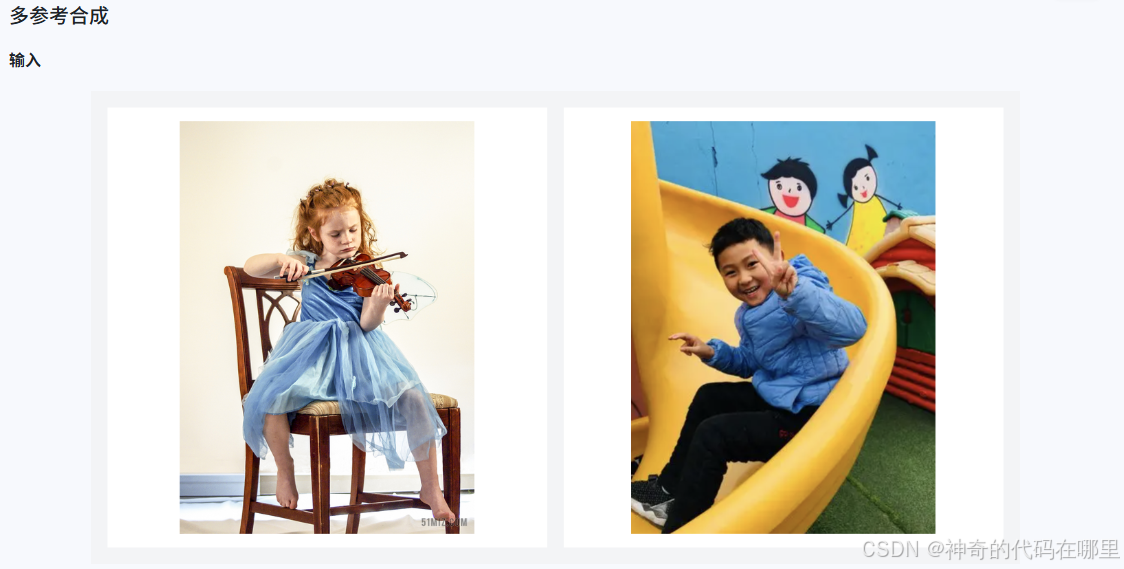
模型支持最多 10 张参考图输入,可以把人物、服饰、家居等不同来源的素材组合起来。
这解决的是组合类需求------比如"让人物 A 穿上服饰 B,站在家居 C 的场景里",用多张参考图分别锁定不同元素,比单张图或纯文字描述可控得多。
2.4 局部精修:圈选、涂画与独立蒙版
改图最怕"改一处、崩一片"。这一代提供了三种指定修改区域的方式:
| 方式 | 适用场景 |
|---|---|
| 圈选 | 快速指定一个矩形/范围区域 |
| 涂画 | 手绘出不规则区域 |
| 独立蒙版 | 用已有的 mask 精确控制 |
配合 2.2 的透明图层能力,"只改透明图层里的一行字"这类需求也有了落地路径。
2.5 文字排版与人像质感
官方把"真实质感,优雅排版,精美人像"列为四大核心优势之一。从模型卡给出的能力范围也能看出侧重:
| 能力方向 | 具体表现 |
|---|---|
| 排版与海报设计 | 强文字渲染能力,可产出教学图、信息图、海报 |
| UI 与信息版式 | 可生成界面草图与信息布局 |
| 人像摄影 | 人像风格生成 |
| 人体姿态与运动 | 姿态与动作控制 |
| 多参考图合成 | 单图变换、多参考图合成、四图室内构图 |
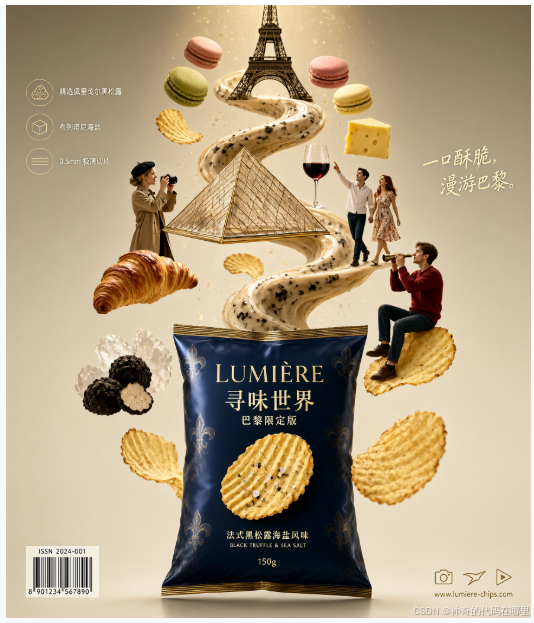
模型卡的文生图示例是一个化学教学海报------含化学方程式、反应活性序列、性质对比表、实验装置插图以及 KEY POINTS / SUMMARY 等大量文字与版式,能够说明它在"图里塞进成段文字并保持版式"这件事上的能力定位。
三、体验提升:比上一代好在哪
这一代的改进,官方与媒体报道集中在三个定性方向:
| 提升方向 | 具体内容 |
|---|---|
| 人物与产品一致性 | 改善了人物身份与产品特征的保持能力------用多张图时,角色不容易"变脸",商品不容易"变形" |
| 排版、光照与细节 | 提升了文字排版、人像光照和细节表现 |
| 多图场景的推理开销 | 通过推理优化降低计算与显存开销,尤其针对多图输入的编辑场景 |
其中第三条值得单独说一句:它优化的是"多图输入"这个最贵的场景。多参考图输入会显著推高计算量,把这一块的开销降下来,等于让"10 张参考图"这种能力真正可用,而不是停留在参数表上。
需要坦白的一点 :以上提升均为官方与媒体的定性描述 。截至目前,官方模型卡与百炼文档中均未公布量化评测分数或对比基准。所以本文不引用任何"某某榜单得分"之类的数字------如果你需要硬指标,建议等官方技术报告。
四、Turbo 加速:8 步出图是怎么做到的
"快"是这个版本名字里的关键词,但它不是简单少跑几步就完事的。
4.1 三条改动互相配合
| 改动 | 作用 |
|---|---|
| 去噪步数压到 8 步 | 最直接的速度来源 |
| 采样 schedule 写进 checkpoint | 为这 8 步专门调好一条路径,加载即生效 |
| 默认 CFG = 1 + prefix KV cache | 不再跑两遍前向计算;并在去噪步之间复用文本与参考图上下文 |
关键在于它们是一体的:单独把步数砍到 8,画面会崩;配上专门调好的 schedule,以及复用上下文的缓存机制,才谈得上"8 步可用"。
4.2 一个必须知道的细节
不要指望用 num_inference_steps 去调节它的速度。 这个 checkpoint 的采样 schedule 是内置的,单独设置该参数不会生效;要实验只能在调用时显式传 sigmas 覆盖------而官方明确说明:其他 schedule 未针对该 checkpoint 评估过。
4.3 它带来的实际变化
"同样的 7B 架构,把去噪步数砍到 8 步"------这句话的含义是:本地部署的门槛和等待时间都降下来了。8 步相比常规数十步的采样,推理耗时是数量级的差别,这让消费级设备跑完整文生图/编辑工作流变得现实。
五、规格与官方优势总结
5.1 官方总结的四大核心优势
摘录自阿里云百炼的官方模型文档:
| 序号 | 官方表述 |
|---|---|
| 1 | 模型轻量,性能强劲,性价比卓越 |
| 2 | 原生透明,生成与编辑一体化 |
| 3 | 灵活编辑:支持多参考图、局部控制、高保真还原与全面编辑能力 |
| 4 | 真实质感,优雅排版,精美人像 |
这四条正好对应了本文第二章与第三章讲的内容------能力升级集中在"统一、透明、可控",体验提升集中在"一致性、质感、开销"。
5.2 支持的分辨率预设
模型提供 7 组长宽比预设:
| 长宽比 | 分辨率 |
|---|---|
| 1:1 | 2048 × 2048 |
| 4:3 | 2400 × 1792 |
| 3:4 | 1792 × 2400 |
| 3:2 | 2528 × 1696 |
| 2:3 | 1696 × 2528 |
| 16:9 | 2752 × 1536 |
| 9:16 | 1536 × 2752 |
模型卡的文生图示例使用 1680 × 2512 竖版,图像编辑示例使用 2048 × 2048。
5.3 权重文件构成
| 文件 | 大小 |
|---|---|
text_encoder/model.safetensors |
≈ 17.5 GB |
transformer/...-00001-of-00002.safetensors |
≈ 10.0 GB |
transformer/...-00002-of-00002.safetensors |
≈ 4.3 GB |
vae/diffusion_pytorch_model.safetensors |
≈ 0.68 GB |
| 合计 | ≈ 32.4 GB |
可以看出两个特点:文本编码器占了整体的一半以上(这是它在文字渲染上表现突出的代价);transformer 本体约 14.2 GB。
六、怎么用上它
6.1 本地部署(Diffusers)
bash
pip install git+https://github.com/huggingface/diffusers.git
pip install "transformers>=5.17.0" accelerate pillow
需要较新版本的 Diffusers(以支持在 pipeline 配置采样 sigmas,对应 PR #14950),并先装好 CUDA 兼容的 PyTorch。典型调用:
python
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1-Turbo", dtype=torch.bfloat16
).to("cuda")

image = pipe(
    prompt=prompt, width=1680, height=2512,
    use_kv_cache=True,                # 在多个去噪步之间复用上下文
    generator=torch.Generator("cpu").manual_seed(42),
).images[0]
要做图像编辑,只需多传一个 image 参数即可进入编辑模式------同一个 pipeline,同样的调用方式,这也是"生成与编辑一体化"最直观的体现。
6.2 云端调用
如果不想本地部署,也可以通过阿里云百炼调用。官方文档给出的调用原价为 0.1 元/张 (华北2北京等地域),限流 120 RPM。
6.3 关于显存的说明
官方页面与元数据中都没有提供最低或推荐的显存要求。 能确定的只是客观事实:BF16 权重合计约 32.4 GB,完整加载需要相当大的显存或内存;能否跑起来取决于是否启用 offload、CPU 卸载或量化,而这些模型卡都没有说明。因此不建议按"7B 模型"的直觉去估算显存需求,最好先实测。
七、使用前要留意的两点
| 事项 | 说明 |
|---|---|
| 许可证 | 采用 Qwen Research License Agreement ,不是 Apache-2.0 这类宽松开源许可 。有商用计划的话,务必先阅读仓库中的 LICENSE 全文,确认使用场景是否被覆盖,必要时联系官方获取授权 |
| 采样参数 | 内置 schedule 无法用 num_inference_steps 覆盖,详见 4.2 节 |
八、小结
| 维度 | 结论 |
|---|---|
| 是什么 | Qwen-Image-2.1 的官方加速版 checkpoint,权重开放 |
| 最大变化(能力) | 文生图与图像编辑合一、原生透明图像、最多 10 张参考图、局部精修 |
| 最大变化(速度) | 8 步去噪 + 内置 schedule + CFG=1 与 KV cache |
| 比上一代提升 | 人物身份与产品特征保持、文字排版与人像光照细节、多图场景推理开销 |
| 官方定位 | 系列中综合表现与性价比最优的开源图像生成模型 |
| 需要注意 | 研究许可(非宽松开源)、显存要求官方未公布、无量化评测数据 |
一句话总结 :这一代的重点不是"画得更好看"这么笼统,而是把创作流程真正串了起来------同一个模型既能生成素材、又能局部修改、还能直出带透明通道的成品,同时用 8 步采样把等待时间压下来。如果你本来就在意"从想法到可用素材"的完整链路,这个版本值得优先试。
相关链接
- 魔搭社区模型页:Qwen/Qwen-Image-2.1-Turbo
- 阿里云百炼官方模型文档
- Qwen 官方博客(Qwen-Image-2.1)
- Hugging Face 镜像:Qwen/Qwen-Image-2.1-Turbo
- GitHub:QwenLM/Qwen-Image-2.1
- Diffusers 官方仓库