文章摘要:本文面向 RabbitMQ 初学者,从消息队列的使用场景讲起,系统介绍 RabbitMQ 架构、四种交换机、六种常见工作模式,并通过 Docker、Python 和 Spring Boot 代码演示消息收发,最后讲解 ACK、发布确认、消息持久化、幂等性、死信队列、TTL、Quorum Queue 等生产环境重点。
适用读者:Java / Spring Boot 后端开发者、微服务学习者、消息中间件初学者。
版本说明:文章以 RabbitMQ 4.x 为背景;涉及 4.3 专属能力时会特别标注。不同版本与客户端配置可能略有差异。
一、RabbitMQ 是什么?为什么要使用消息队列?
RabbitMQ 是一个开源的消息代理(Message Broker),负责接收、路由、存储和投递消息。可以把它想象成快递中转站:生产者寄送包裹,队列临时保管包裹,消费者领取并处理包裹。
以电商订单系统为例。用户支付成功后,业务可能还需要:
- 更新订单状态;
- 扣减库存;
- 增加积分;
- 发送短信或邮件。
如果所有服务都由订单服务同步调用,接口的总耗时可能增加,而且下游服务故障也可能影响主流程。
引入 RabbitMQ 后,可以让已完成关键事务的订单服务发布一条事件,由不同业务服务各自消费:
text
                       订单服务
                          |
                    发布订单事件
                          |
                       RabbitMQ
                          |
                 交换机(Exchange)
                   /      |      \
                  /       |       \
            库存队列   积分队列   通知队列
               |          |         |
            库存服务   积分服务   通知服务
RabbitMQ 的三个常见价值:
- 异步:把不需要在用户请求中完成的任务放到后台处理;
- 解耦:生产者只发布事件,不需要直接依赖所有下游系统;
- 削峰:在消息量短时突增时,队列缓冲部分压力,消费者按自身能力处理。
需要注意:消息队列不是无限容量的存储器。如果生产速度长期大于消费速度,消息仍然会堆积。支付成功、数据库事务提交等关键步骤,也不能因为使用了 MQ 就随意改成异步。
二、RabbitMQ 的核心架构
理解 RabbitMQ,先认识六个概念。
| 概念 | 中文名称 | 主要职责 |
|---|---|---|
| Producer | 生产者 | 发布消息 |
| Exchange | 交换机 | 根据规则将消息路由到队列 |
| Queue | 队列 | 保存等待消费的消息 |
| Binding | 绑定 | 建立交换机与队列之间的关系 |
| Routing Key | 路由键 | 为路由提供匹配信息 |
| Consumer | 消费者 | 接收消息并执行业务 |
消息基本流向:
text
Producer
   |
   | 发布消息(带 Routing Key)
   v
Exchange
   |
   | 根据 Binding 路由
   v
Queue
   |
   | 投递消息
   v
Consumer
   |
   | 业务处理成功后 ACK
   v
RabbitMQ 确认该次投递已完成
重点记住三句话:
- Exchange 决定消息发往哪些队列。
- Queue 保存尚待处理的消息。
- Consumer 执行真正的业务逻辑。
生产者实际上总是向交换机发布消息。即便使用 exchange="",也是在使用 RabbitMQ 的默认交换机;此时可用队列名称作为 Routing Key。
RabbitMQ 客户端还经常涉及两个概念:
- Connection:客户端与 Broker 的网络连接,通常是 TCP 长连接。
- Channel:复用在 Connection 上的逻辑信道,执行发布和消费等操作。
实际项目通常复用连接及客户端管理的信道,而不是每发一条消息就创建新 TCP 连接。
加强理解:Exchange(交换机)、Binding(绑定关系)、Routing Key(路由键)三者之间的关系
可以简单理解为:
- Exchange:负责接收消息,并决定消息发往哪个队列。
- Binding:建立 Exchange 和 Queue 之间的绑定关系,相当于一条路由规则。
- Routing Key:生产者发送消息时指定的路由标识,Exchange 根据它和绑定规则决定消息的去向。
关系图(例子使用的是 Direct Exchange):
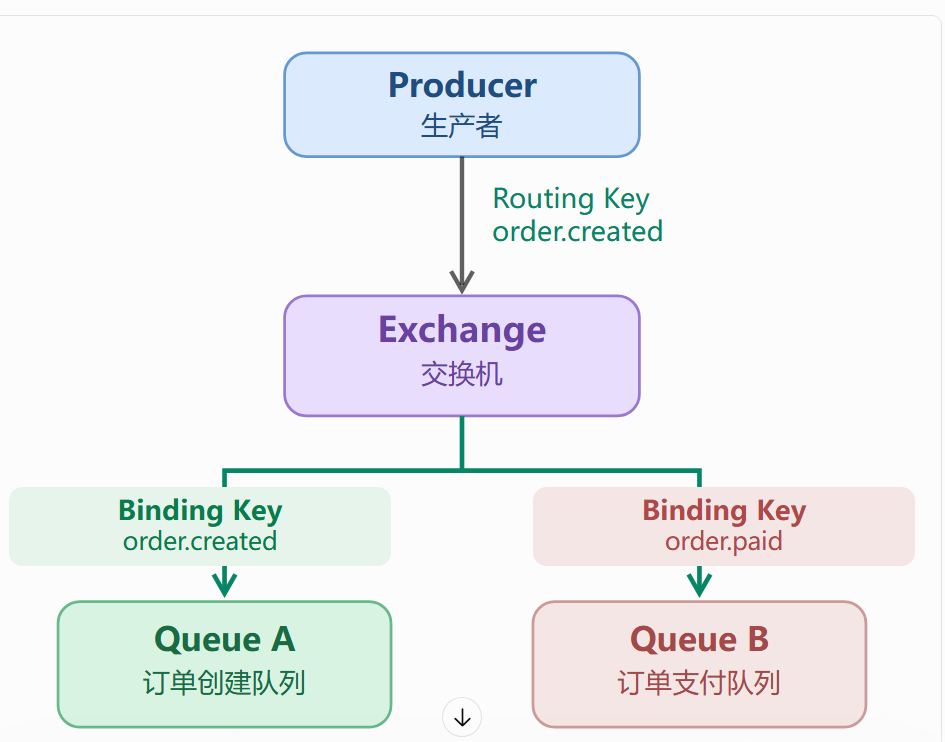
Routing Key 是消息携带的,Binding Key 是绑定关系中配置的。 两者不一定相同,是否匹配由 Exchange 类型决定。
三、四种交换机(Exchange)
3.1 Direct:精确匹配
Direct Exchange 使用 Binding Key 与消息 Routing Key 进行精确匹配。
text
                  Direct Exchange
                     /       \
          key=error /         \ key=info
                   v           v
             error.queue    info.queue
例如:
python
channel.basic_publish(
    exchange="log.exchange",
    routing_key="error",
    body="数据库连接失败".encode("utf-8")
)
如果 error.queue 绑定了 error,它就会接收这条消息。多个队列也可以绑定同一个 Key,所以 Direct 并不意味着只能路由到一个队列。
3.2 Fanout:广播
Fanout Exchange 忽略 Routing Key,将消息复制给所有绑定的队列。
text
                   Fanout Exchange
                    /      |      \
                   v       v       v
               邮件队列  积分队列  统计队列
适合"用户注册成功后,同时通知多个业务系统"等事件广播场景。
3.3 Topic:通配符匹配
Topic Exchange 根据由点号分隔的 Routing Key 进行模式匹配:
*:匹配一个单词;#:匹配零个或多个单词。
| 绑定规则 | 消息 Routing Key | 是否匹配 |
|---|---|---|
order.* |
order.created |
是 |
order.* |
order.pay.success |
否 |
order.# |
order.pay.success |
是 |
order.# |
order |
是 |
user.* |
order.created |
否 |
例如订单服务订阅 order.#,即可匹配订单创建、支付、取消等多类事件。
3.4 Headers:按消息头匹配
Headers Exchange 不依赖 Routing Key,而是按消息头字段匹配。可以用 x-match=all(全部满足)或 x-match=any(满足任意条件)控制路由。一般入门优先掌握 Direct、Fanout 和 Topic。
四、六种常见消息工作模式
不少教程会将 RabbitMQ 的入门使用方式分成六种:
| 模式 | 核心特点 | 典型场景 |
|---|---|---|
| Simple | 一个生产者、一个队列、一个消费者 | 最简单的消息收发 |
| Work Queues | 多个消费者竞争同一个队列 | 后台任务分摊 |
| Publish/Subscribe | Fanout 广播到多个队列 | 用户注册通知 |
| Routing | Direct 精确路由 | 按日志级别分流 |
| Topics | Topic 通配符路由 | 订单事件订阅 |
| RPC | 请求消息与响应消息配合 | 远程调用式交互 |
这里要特别区分:
- 一个队列,多个消费者:一般是竞争消费,同一条投递消息通常由其中一个消费者处理。
- 多个队列绑定同一个交换机:每个匹配的队列都可以获得该消息的一份副本。
五、Docker + Python:搭建第一个可运行示例
下面以订单创建事件为例,使用一个 Direct Exchange 和一个持久化队列。
5.1 启动 RabbitMQ
确保已安装 Docker,然后运行:
bash
docker run -d \
  --name rabbitmq-study \
  --hostname rabbitmq-study \
  -p 5672:5672 \
  -p 15672:15672 \
  -e RABBITMQ_DEFAULT_USER=demo \
  -e RABBITMQ_DEFAULT_PASS=demo123 \
  rabbitmq:4-management
端口说明:
5672:AMQP 客户端连接端口;15672:RabbitMQ Web 管理后台。
浏览器访问 http://localhost:15672,使用 demo / demo123 登录。以上凭据仅用于本地学习,生产环境应使用安全凭据与合理的网络访问控制。上线时也建议固定 Docker 镜像的具体版本。
5.2 安装客户端
bash
python -m pip install pika5.3 编写消费者:receive.py
python
import json
import pika

credentials = pika.PlainCredentials("demo", "demo123")
connection = pika.BlockingConnection(
    pika.ConnectionParameters(host="localhost", credentials=credentials)
)
channel = connection.channel()

# 声明交换机、队列和绑定
channel.exchange_declare(
    exchange="order.events", exchange_type="direct", durable=True
)
channel.queue_declare(queue="order.created.queue", durable=True)
channel.queue_bind(
    exchange="order.events",
    queue="order.created.queue",
    routing_key="order.created"
)

# 每个消费者最多持有一条尚未确认的消息
channel.basic_qos(prefetch_count=1)

def callback(ch, method, properties, body):
    try:
        order = json.loads(body.decode("utf-8"))
        print("收到订单:", order)

        # TODO: 在这里编写业务处理逻辑
        print("处理完成")
        ch.basic_ack(delivery_tag=method.delivery_tag)
    except Exception as exc:
        print("处理失败:", exc)
        # 演示:重新入队。生产环境必须限制重试,避免死循环。
        ch.basic_nack(delivery_tag=method.delivery_tag, requeue=True)

channel.basic_consume(
    queue="order.created.queue",
    on_message_callback=callback,
    auto_ack=False
)

print("等待订单消息...")
channel.start_consuming()
5.4 编写生产者:send.py
python
import json
import uuid
import pika

credentials = pika.PlainCredentials("demo", "demo123")
connection = pika.BlockingConnection(
    pika.ConnectionParameters(host="localhost", credentials=credentials)
)
channel = connection.channel()

channel.exchange_declare(
    exchange="order.events", exchange_type="direct", durable=True
)
channel.queue_declare(queue="order.created.queue", durable=True)
channel.queue_bind(
    exchange="order.events",
    queue="order.created.queue",
    routing_key="order.created"
)

# 发布者确认模式
channel.confirm_delivery()

order = {"orderId": "1001", "userId": "2001", "amount": 99.9}

channel.basic_publish(
    exchange="order.events",
    routing_key="order.created",
    body=json.dumps(order).encode("utf-8"),
    mandatory=True,
    properties=pika.BasicProperties(
        delivery_mode=2,
        content_type="application/json",
        message_id=str(uuid.uuid4())
    )
)

print("消息发布已被 RabbitMQ 确认")
connection.close()
代码中:
durable=True:使队列/交换机定义在 Broker 重启后保留;delivery_mode=2:将消息标记为持久化;confirm_delivery():让发布者等待 Broker 确认;mandatory=True:消息无法路由时要求 Broker 返回;Pika 的确认模式可以据此发现不可路由问题;auto_ack=False:采用消费端手动确认。
5.5 运行测试
打开两个终端。
终端一:
bash
python receive.py终端二:
bash
python send.py消费者将打印类似结果:
text
等待订单消息...
收到订单: {'orderId': '1001', 'userId': '2001', 'amount': 99.9}
处理完成
可以在 RabbitMQ 管理后台查看 Exchanges、Queues、Connections,进一步理解消息流转。
六、消息可靠性:生产环境最重要的部分
6.1 发布者确认(Publisher Confirm)
生产者写入网络不代表 Broker 一定收到消息。开启 Publisher Confirm 后,Broker 会对发布结果进行确认。
text
Producer --发送消息--> RabbitMQ
Producer <--Confirm---- RabbitMQ
注意:Publisher Confirm 不表示消费者已完成业务处理。 它解决的是生产者到 Broker 的发布确认问题。即使收到 Confirm ACK,也应该检查消息是否成功路由到预期队列;无法路由时可配合 mandatory 返回机制处理。
6.2 消费者确认(Consumer ACK)
消费者接收到消息后,不应直接等同于"业务完成"。手动 ACK 的推荐流程是:
text
收到消息 -> 执行业务 -> 数据库事务提交成功 -> 发送 basic_ack| API | 含义 |
|---|---|
basic_ack |
确认消息处理成功 |
basic_nack(requeue=True) |
拒绝并重新入队 |
basic_nack(requeue=False) |
拒绝且不重新入队 |
basic_reject |
拒绝单条消息 |
若配置了死信交换机,符合条件的拒绝消息可转入死信处理;否则不重新入队的消息可能被丢弃。
6.3 消息持久化
要分别考虑:
- 交换机是否持久化;
- 队列是否持久化;
- 消息本身是否被标记为持久化;
- 是否使用发布确认判断 Broker 已安全接管消息。
"持久化"并不意味着绝对零丢失。 磁盘故障、集群配置、发布确认以及队列类型都会影响实际的数据安全性。
6.4 为什么还需要幂等性?
例如积分消费者已经修改数据库,但在发送 ACK 前宕机:
text
消息到达 -> 增加积分成功 -> 消费者宕机 -> ACK 未到达
                                              |
                                              v
Broker 重新投递消费者可能重复处理同一条消息。因此重要业务需要保证幂等,即重复处理不会重复产生业务效果。
常见做法:消息包含唯一 messageId 或业务 orderId,使用唯一约束和数据库事务去重。例如:
sql
CREATE TABLE processed_message (
    message_id VARCHAR(100) PRIMARY KEY
);实际处理时,在同一个数据库事务中完成"插入去重记录"和"修改积分"。如果唯一键已存在,就跳过重复业务操作。只做"先查询是否处理过"还不够,因为并发消费者可能同时查到未处理。
6.5 数据库与 MQ 的双写一致性
考虑下面的情况:
text
订单数据库提交成功 -> 发送 MQ 消息失败 -> 下游没有收到订单事件一种常见解决方案是 Transactional Outbox(事务性发件箱):在同一个数据库事务中写入业务数据和待发布事件,由后台任务发布事件,并在获得确认后更新发送状态。该方案仍可能重复发布,因此消费端幂等不能省略。
七、死信队列、TTL、延迟处理与重试
7.1 死信队列(DLQ)
消息被拒绝且不重新入队、到期过期、超出队列长度限制等情况下,消息可能成为死信。
text
业务队列
   |
   | 被拒绝 / 过期 / 超限
   v
死信交换机(DLX)
   |
   v
死信队列(DLQ)
   |
   v
排查异常、补偿、人工处理
DLQ 通常是自己声明的普通队列,通过 DLX 及 Binding 来接收死信,不是一个自动生成的特殊队列类型。
7.2 TTL:消息生存时间
例如:
python
channel.queue_declare(
    queue="temporary.queue",
    durable=True,
    arguments={"x-message-ttl": 30000}
)
30000 的单位是毫秒,表示消息在队列中的生存时间为 30 秒。到期后消息不再作为正常消息交付;若正确配置 DLX,可以进一步做死信转发。TTL 不等于高精度定时任务。
7.3 延迟消息与延迟重试不是同一件事
典型延迟业务:订单创建 30 分钟后检查支付状态,仍未支付则关闭订单。传统实现常采用 TTL + DLX 等方案,但它不是精确调度器。
版本补充:RabbitMQ 4.3 的 Quorum Queue 支持延迟重试,可以对返回队列的消息设置延迟和线性退避,减少反复立即重新投递带来的压力。该能力针对失败后重投,不应直接等同于通用定时任务。旧版本不能默认使用这一能力。
无论使用哪种重试方式,都应考虑最大重试次数、重试间隔、死信兜底和告警,避免无限重试。
八、Prefetch:控制消费者的未确认消息数量
python
channel.basic_qos(prefetch_count=10)常见的消费设置下,表示单个消费者最多可同时持有 10 条未确认消息。
- 太小:吞吐可能受限;
- 太大:消费者可能积压大量尚未确认的消息;
- 合适的值:根据耗时、并发和消息大小进行压测。
在初学示例中设置为 1 很直观,但不一定适合高吞吐量生产场景。
九、Classic Queue、Quorum Queue 和 Stream
| 类型 | 主要特点 | 适合场景 |
|---|---|---|
| Classic Queue | 传统消息队列,配置与使用相对简单 | 常规消息任务 |
| Quorum Queue | 基于 Raft 的复制队列,强调数据安全和高可用 | 关键订单、重要事件 |
| Stream | 面向追加式日志和消息重放 | 高吞吐事件流、历史事件回放 |
Quorum Queue 声明示例:
python
channel.queue_declare(
    queue="critical.orders",
    durable=True,
    arguments={"x-queue-type": "quorum"}
)
Quorum Queue 的跨节点高可用需要真正的多节点部署和正确的副本配置。只在一台机器上声明 Quorum Queue 并不会自动实现跨节点容灾。
十、Spring Boot 整合 RabbitMQ
10.1 添加依赖
xml
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-amqp</artifactId>
</dependency>
10.2 application.yml
yaml
spring:
  rabbitmq:
    host: localhost
    port: 5672
    username: demo
    password: demo123
10.3 声明交换机、队列和绑定
java
@Configuration
public class RabbitConfig {

    @Bean
    public DirectExchange orderExchange() {
        return new DirectExchange("order.events", true, false);
    }

    @Bean
    public Queue orderQueue() {
        return new Queue("order.created.queue", true);
    }

    @Bean
    public Binding orderBinding(
            Queue orderQueue, DirectExchange orderExchange) {
        return BindingBuilder.bind(orderQueue)
                .to(orderExchange)
                .with("order.created");
    }
}
所需 @Configuration、@Bean 等注解及 Queue、BindingBuilder 等类可通过 IDE 自动导入对应的 Spring 和 Spring AMQP 包。
10.4 生产者
java
@Service
public class OrderProducer {

    private final RabbitTemplate rabbitTemplate;

    public OrderProducer(RabbitTemplate rabbitTemplate) {
        this.rabbitTemplate = rabbitTemplate;
    }

    public void sendOrderMessage(String orderId) {
        rabbitTemplate.convertAndSend(
                "order.events", "order.created", orderId);
    }
}
10.5 消费者
java
@Component
public class OrderConsumer {

    @RabbitListener(queues = "order.created.queue")
    public void receive(String orderId) {
        System.out.println("收到订单:" + orderId);
        // TODO: 执行业务逻辑
    }
}
注意一个容易踩的坑:Spring AMQP 的 AUTO 确认模式并不是 AMQP 协议层的 auto_ack=true。 在 Spring AMQP AUTO 模式下,监听容器通常在方法正常完成后确认消息;如果希望由业务代码明确调用 basicAck,可配置 MANUAL 并处理异常场景。
上面是最基础的收发示例,尚未包含生产必需的发布确认、异常重试、幂等和数据库一致性处理。
十一、RabbitMQ 和 Kafka 的区别
| 维度 | RabbitMQ | Kafka |
|---|---|---|
| 核心定位 | 通用消息代理 | 分布式事件流平台 |
| 路由方式 | Exchange + Binding + Routing Key | Topic + Partition |
| 常用模式 | 任务队列、竞争消费、广播和复杂路由 | 事件日志、消费组、分区处理 |
| 消息重放 | 普通队列不是主要面向重放设计;Stream 支持 | 消息重放是核心能力 |
| 常见场景 | 异步任务、业务事件分发、工作队列 | 事件流、日志采集、数据管道 |
可以粗略理解:RabbitMQ 更注重消息路由与任务分发,Kafka 更注重持久化事件日志与重放。选型还要看吞吐量、消息保留、可靠性和团队技术栈。
十二、生产环境检查清单
| 检查项 | 建议 |
|---|---|
| 发布可靠性 | 开启发布确认,处理不可路由消息 |
| 消费可靠性 | 使用恰当的 ACK 策略 |
| 消息安全 | 按需设置持久化和复制队列 |
| 重复消费 | 通过数据库唯一键等手段保证幂等 |
| 异常处理 | 有限重试、退避、死信和告警 |
| 消息积压 | 监控 Ready、Unacked 和消费吞吐 |
| 并发控制 | 调整消费者数量与 Prefetch |
| 数据一致性 | 重要业务考虑事务性 Outbox |
| 安全配置 | 使用强密码、权限隔离、必要时启用 TLS |
管理后台中重点关注:
- Ready:已在队列中、等待交付的消息;
- Unacked:已经投递但尚未确认的消息;
- Total:队列中的消息总量(通常包含 Ready 与 Unacked)。
Ready 长期增长,通常意味着生产速度高于消费速度;Unacked 长期偏高,可能说明消费者处理慢、阻塞或确认逻辑有问题。
十三、常见面试问题
Q1:消息一定会被消费一次吗?
不一定。存在网络失败、重投和 ACK 丢失等情况,常见可靠消费设计通常需要考虑至少一次投递带来的重复处理,因此业务幂等非常重要。
Q2:Publisher Confirm 与 Consumer ACK 有什么区别?
Confirm 表示 Broker 对生产者发布的消息作出确认;Consumer ACK 表示消费者对 Broker 的投递作出确认。两者属于不同阶段。
Q3:一个队列绑定多个消费者会广播吗?
通常不会。它属于竞争消费,一条投递消息一般由其中一个消费者处理。广播需要多条队列分别绑定交换机。
Q4:持久化队列就不会丢消息了吗?
不能这样理解。还需结合持久化消息、发布确认、磁盘与集群容灾等因素判断。
Q5:RabbitMQ 消息积压怎么办?
先排查消费者故障和下游数据库瓶颈,再根据业务能力调整消费者并发、Prefetch 或扩容;同时防止无限堆积,必要时采用限流、降级与告警。
十四、学习路线总结
建议按以下顺序循序渐进:
- 基础概念:Producer、Exchange、Queue、Binding、Routing Key;
- 消息模式:Direct、Fanout、Topic 和竞争消费;
- 代码实战:Docker 启动、Python 或 Spring Boot 收发消息;
- 可靠性设计:发布确认、手动 ACK、消息持久化和幂等;
- 高级功能:DLX、TTL、重试、Prefetch、Quorum Queue;
- 项目实践:设计完整的订单事件流,并考虑数据库事务一致性、监控和故障恢复。
一句话总结:RabbitMQ 通过交换机决定消息如何路由,通过队列承接消息,通过消费者异步处理业务,再利用确认、持久化、重试、死信和幂等机制提升可靠性。
参考资料
- RabbitMQ 官方文档:https://www.rabbitmq.com/docs
- RabbitMQ 官方教程:https://www.rabbitmq.com/tutorials
- RabbitMQ 发布确认与消费确认:https://www.rabbitmq.com/docs/confirms
- RabbitMQ Quorum Queue:https://www.rabbitmq.com/docs/quorum-queues
- Spring AMQP 文档:https://docs.spring.io/spring-amqp/reference/
作者笔记:本文适合先收藏、边阅读边运行示例。学习 RabbitMQ 时,建议不仅跑通"发送成功",还要亲自模拟消费者异常、消息重试和重复消费,才能真正理解可靠性机制。