DeerFlow 2.x 源码拆解:多智能体委派、Skills、沙箱与 Linux 部署实战
摘要:沿着 DeerFlow 2.x 的真实代码,拆解 Gateway、主 Agent、子任务执行器、上下文快照、Skills 与父侧验收。配合 Linux 配置与端口说明,讲清多智能体如何协作、工具在哪运行,以及二次开发时需要守住哪些边界。
让两个模型互相聊天,并不等于搭建了一套多智能体系统。真正落地时,你需要回答更具体的问题:谁能创建子任务,子 Agent 能看到什么,工具在哪执行,任务失败怎么反馈,生成的文件怎么交给用户,以及"做完了"到底有什么证据。
DeerFlow 值得研究,正是因为它把这些问题放进一个完整应用。本文从当前源码出发,拆解它的入口、委派机制、执行环境和持久化,再给出 Linux 部署与二次开发的路线。
文章目录
- [DeerFlow 2.x 源码拆解:多智能体委派、Skills、沙箱与 Linux 部署实战](#DeerFlow 2.x 源码拆解:多智能体委派、Skills、沙箱与 Linux 部署实战)
-
- [一、DeerFlow 是什么:从研究流程走向 Agent Harness](#一、DeerFlow 是什么:从研究流程走向 Agent Harness)
- 二、技术栈与目录:先分清应用层和执行层
- [三、整体架构:为什么不需要另外启动 LangGraph Server](#三、整体架构:为什么不需要另外启动 LangGraph Server)
- [四、主 Agent 如何组装:模型只是其中一部分](#四、主 Agent 如何组装:模型只是其中一部分)
- [五、多 Agent 的协作底层:工具调用、执行器和结果回传](#五、多 Agent 的协作底层:工具调用、执行器和结果回传)
-
- [5.1 委派是一份有边界的任务,不是给另一个模型发"帮我看看"](#5.1 委派是一份有边界的任务,不是给另一个模型发“帮我看看”)
- [5.2 默认 isolated:上下文并不是越多越好](#5.2 默认 isolated:上下文并不是越多越好)
- [5.3 snapshot 是历史数据快照,不是权限继承](#5.3 snapshot 是历史数据快照,不是权限继承)
- [5.4 它们怎样通信:不要想象成一个隐式群聊](#5.4 它们怎样通信:不要想象成一个隐式群聊)
- [5.5 并发、总量、超时和模型限流是不同预算](#5.5 并发、总量、超时和模型限流是不同预算)
- 六、"完成了"如何验收:执行凭据与父侧检查
- 七、Skills、Tools、MCP:三种能力不要混用
-
- [7.1 Skills 如何被识别和加载](#7.1 Skills 如何被识别和加载)
- [7.2 写一个适合业务使用的 Skill](#7.2 写一个适合业务使用的 Skill)
- [7.3 MCP 接入不等于授权所有外部操作](#7.3 MCP 接入不等于授权所有外部操作)
- [八、沙箱与文件交付:Agent 的代码到底在哪运行](#八、沙箱与文件交付:Agent 的代码到底在哪运行)
-
- [8.1 Local 模式不能被理解为安全隔离](#8.1 Local 模式不能被理解为安全隔离)
- [8.2 AIO 模式提供容器执行,但不等于绝对安全](#8.2 AIO 模式提供容器执行,但不等于绝对安全)
- [8.3 虚拟路径、主机路径与容器路径是三种东西](#8.3 虚拟路径、主机路径与容器路径是三种东西)
- [九、Linux 部署:从固定版本到可安全访问](#九、Linux 部署:从固定版本到可安全访问)
-
- [9.1 准备工具与源码](#9.1 准备工具与源码)
- [9.2 配置模型,不要只填一把 Key](#9.2 配置模型,不要只填一把 Key)
- [9.3 选择沙箱并启动生产栈](#9.3 选择沙箱并启动生产栈)
- [9.4 在首次初始化前不要开放到不可信网络](#9.4 在首次初始化前不要开放到不可信网络)
- [9.5 SQLite、PostgreSQL、Redis 各用在什么地方](#9.5 SQLite、PostgreSQL、Redis 各用在什么地方)
- [9.6 验证要沿着依赖链做](#9.6 验证要沿着依赖链做)
- [十、二次开发路线:优先扩展契约,不先 Fork 全部核心](#十、二次开发路线:优先扩展契约,不先 Fork 全部核心)
-
- [10.1 低侵入:Skill 与只读 MCP](#10.1 低侵入:Skill 与只读 MCP)
- [10.2 中侵入:自定义 Agent 与扩展中间件](#10.2 中侵入:自定义 Agent 与扩展中间件)
- [10.3 高侵入:自建 Sandbox Provider 与业务运行时](#10.3 高侵入:自建 Sandbox Provider 与业务运行时)
- [十一、如何选型:DeerFlow、GPT Researcher 与自建编排](#十一、如何选型:DeerFlow、GPT Researcher 与自建编排)
- 十二、总结与资料
一、DeerFlow 是什么:从研究流程走向 Agent Harness
DeerFlow 是采用 MIT 许可的开源 Agent 项目。2.x 围绕主 Agent、子 Agent、Skills、工具、沙箱、记忆和应用服务组织能力。
Harness 可以理解为模型外面的执行装置:模型负责决策与生成,但装置负责提供工具、保持状态、限制行为、组织委派和处理交付。它不是另一个模型,也不是换一个 System Prompt。
用一个具体场景理解:用户上传 CSV,要求调查业务变化、绘图并生成报告。系统需要读取文件、执行分析程序、创建图片和报告、检验产物是否存在,再通过网页交付。中途可能遇到代码错误、依赖缺失或模型断流,这些不能全靠自然语言保证。
DeerFlow 是比较完整的应用基础,但"完整"不意味着默认配置就适合公开给所有人。它包含高权限文件和命令能力,部署与权限边界必须一起设计。
二、技术栈与目录:先分清应用层和执行层
| 层次 | 技术/组件 | 主要职责 |
|---|---|---|
| 浏览器界面 | Next.js、React | 对话、任务进度、文件与产物展示 |
| 统一入口 | Nginx | 页面和 API 转发、统一访问路径 |
| Gateway | Python、FastAPI | 认证、会话、执行请求、管理 API、SSE |
| Agent Harness | LangChain Agent、LangGraph | 模型工具循环、中间件与图状态 |
| 持久化 | SQLite / PostgreSQL | 按部署模式保存业务与执行相关状态 |
| 流桥接 | Redis Streams 等配置路径 | 跨 Worker 的流事件传递 |
| 执行环境 | Local、AIO 等 Sandbox Provider | 文件操作、命令执行和环境管理 |
| 能力复用 | Skills、MCP、扩展 | 工作方法、外部工具和运行时扩展 |
注意,Redis 在这里不是"把模型回答缓存起来"的同义词;它在官方 Docker 栈中承担流桥接相关职责。数据库状态、事件流和产物文件也不是一份东西。
text
frontend/                                  Next.js 应用
backend/app/gateway/                       FastAPI 与 API 路由
backend/app/subagent_batches/              持久化批量子任务相关应用逻辑
backend/app/scheduler/                     后台调度应用逻辑
backend/packages/harness/deerflow/
  agents/lead_agent/agent.py               主 Agent 组装入口
  agents/middlewares/                      上下文、工具与安全等中间件
  subagents/                              委派执行、容量、验收、报告契约
  skills/                                 解析、安装、权限、投影与扫描
  sandbox/                                沙箱抽象与本地实现
  community/                              集成实现
  runtime/                                执行与检查点机制
  persistence/                            持久化相关支持
  tools/                                  内置工具与加载
backend/packages/extension-api/            扩展契约
skills/public/                             随项目提供的技能
docker/                                    容器部署配置
scripts/deploy.sh                          生产部署脚本
config.example.yaml                        配置样例
阅读路径建议:先看官方架构文档,然后看 make_lead_agent,再追 task_tool 与 SubagentExecutor,最后按需要阅读 Skills、沙箱和 Gateway。
三、整体架构:为什么不需要另外启动 LangGraph Server
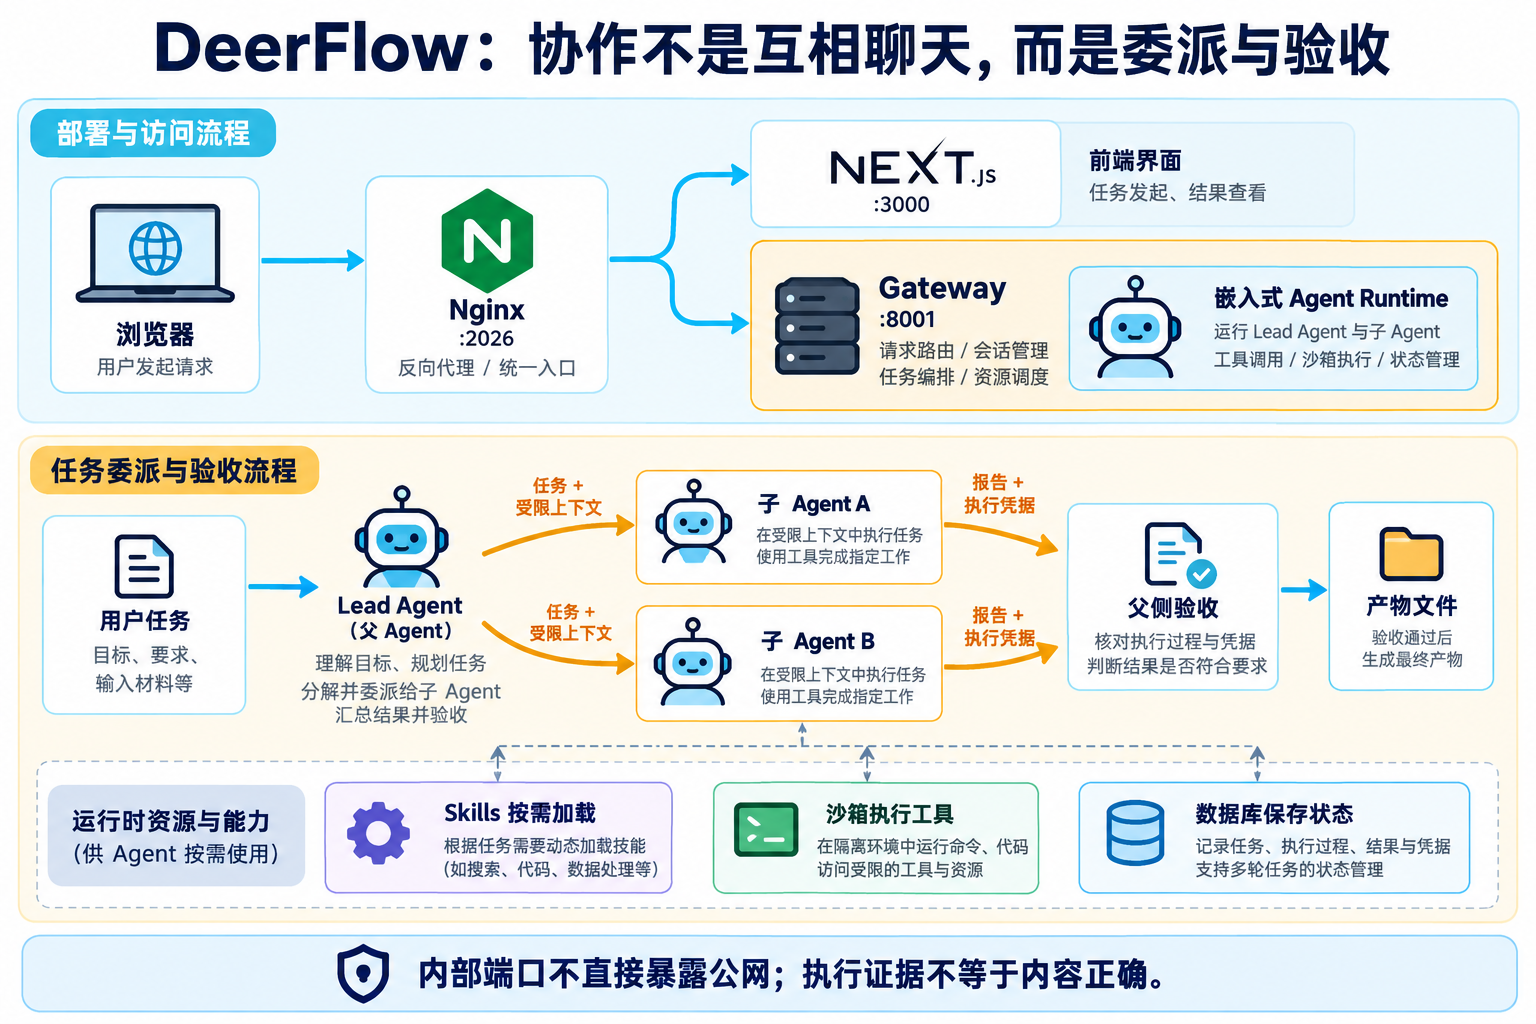
图为简化讲解模型:产物文件可能在子任务执行过程中就已写出,父侧验收不会自动保证内容正确;实际沙箱隔离强度取决于 Provider 与部署配置。
当前默认应用结构是:浏览器访问 Nginx 2026;网页请求转发到 Next.js 3000;API 请求进入 Gateway 8001。Agent Runtime 嵌入 Gateway。
官方架构文档明确说明,/api/langgraph/* 经 Nginx 转写到 Gateway 的兼容路由。langgraph.json 仍可用于相关工具和兼容场景,但它不是默认生产服务入口。
这意味着旧教程里出现的"再起一个 LangGraph 服务端口",不应该机械地应用到当前版本。多一个不必要的服务,会增加路由、认证、升级和排障的混乱。
这里有三条流:
- 请求流:用户请求 → Gateway 权限与执行入口 → Agent;
- 事件流:模型/工具/子任务事件 → SSE → 前端;
- 文件流:工具写入工作空间 → 产物注册与服务 → 用户查看或下载。
SSE 传递事件,不负责替代数据库;文件下载也不是把完整二进制塞进每次对话历史。
四、主 Agent 如何组装:模型只是其中一部分
agents/lead_agent/agent.py 引入 create_agent,并按配置组装模型、工具、状态结构和中间件。这里不是把所有逻辑都写成一个 Prompt。
当前源码可看到的机制包括:工具授权、循环检测、摘要、记忆、Token 使用记录、子任务限制、图像兼容、终止响应,以及可配置扩展中间件。
可以把一次模型回合理解为:
text
准备当前上下文和工具视图
    ↓
调用模型
    ↓
若产生 tool_calls:检查权限、执行工具、处理结果
    ↓
结果进入下一轮上下文
    ↓
直到正常结束、达到限制、需要用户输入或发生失败
这是机制示意,不是源码固定的全部中间件顺序。具体链条受配置、运行模式与工具集合影响,二次开发时应以组装入口为准。
一个细节值得借鉴:追踪回调附着在图调用根部,而图内创建模型时避免重复附着追踪回调。否则同一次调用可能产生重复 span,并影响会话和用户归属的关联。观测不是"加一个日志库"就完成了,还需要确定事件从哪里开始、属于哪次运行。
五、多 Agent 的协作底层:工具调用、执行器和结果回传
5.1 委派是一份有边界的任务,不是给另一个模型发"帮我看看"
主 Agent 通过 task 工具发起普通子任务。源码实际函数是 tools/builtins/task_tool.py 中的 task_tool。关键参数如下,其他运行时参数省略:
python
# 根据真实签名节选,仅展示接口,不是可独立运行的函数
async def task_tool(
    prompt: str,
    subagent_type: str,
    acceptance_criteria: list[str] | None = None,
    description: str = "",
    context_mode: Literal["isolated", "snapshot"] = "isolated",
    # ... 由框架注入的运行时与调用标识
):
    ...
这几个字段分别回答:做什么、由哪类 Agent 做、如何检查、在界面怎样描述,以及是否需要父任务历史。
内部流程会构建 SubagentExecutor,创建执行 ID,启动执行,再整理终态结果和使用量。模型发起委派不代表可以跳过运行时约束;执行器和容量控制负责把意图变成实际工作。
5.2 默认 isolated:上下文并不是越多越好
context_mode="isolated" 默认只传递当前委派任务相关输入,不自动复制完整父会话。这样可以减少噪声,避免把父 Agent 的失败尝试和无关讨论带入子任务。
适合 isolated 的任务是边界明确、材料路径清楚的工作,例如"读取指定 CSV,输出指定位置的统计 JSON"。如果关键约束散落在父对话里,可以选择 snapshot,但要承担额外输入成本。
5.3 snapshot 是历史数据快照,不是权限继承
subagents/context_snapshot.py 用不可变对象保存序列化的父会话数据。它保留相关历史与摘要,把历史工具调用整理为数据,而不是可直接重放的工具协议帧。
这设计解决了两个问题:子任务不应把父任务以前执行的动作当作自己刚完成的动作;历史指令也不能覆盖子任务的系统规则和当前授权范围。
还要记住,快照不接收父会话后续消息。如果用户后来更改要求,需要宿主显式处理取消、重新委派或更新任务,不能假设正在运行的子 Agent 自动知道。
5.4 它们怎样通信:不要想象成一个隐式群聊
普通任务路径主要是父子通信:父 Agent 提供任务,执行器启动子 Agent,子 Agent 使用自己的模型工具循环,终态结果回传给父侧。
通信内容包含自然语言任务,也包含结构化运行身份、上下文、结果状态和执行证据。它通常发生在同一应用进程的运行时边界及事件机制中;不能因为有多个 Agent,就说它们已经是独立网络微服务。
子任务可能共享线程工作空间,所以"上下文隔离"不等于"文件系统隔离"。两个子任务同时编辑同一文件仍然会冲突。更好的分工是分别输出独立文件,再由主任务合并,或者明确文件所有权。
5.5 并发、总量、超时和模型限流是不同预算
源码分别存在容量控制、单次运行的子任务限制、子任务轮数和超时等机制。SubagentConfig 还定义了工具允许/禁止列表、Skills 范围以及模型继承规则。
默认的 disallowed_tools 包含 task,用于限制子任务继续嵌套委派;不要把它写成"子 Agent 永远不能创建子 Agent",自定义配置可能改变行为。
max_turns 是模型加工具的 Agent 回合预算,不应机械地等同于 LangGraph super-step 数。源码有专门的换算路径。
真正线上预算还需要模型 RPM/TPM、沙箱容量、用户配额和全局执行数量共同约束。提高子任务并发,可能只是更快撞到服务商限流。
六、"完成了"如何验收:执行凭据与父侧检查
子 Agent 说"文件已经生成、测试已经通过",仅是自述。当前实现增加了执行凭据和验收机制,让父侧可以检查部分可判定要求。
acceptance_checks.py 能处理文件存在、非空、JSON 语法,以及记录中的特定测试执行证据。无法判定的要求会保留为 UNVERIFIED,而不是默认为通过。
例如委派时可以提出如下条件,这是任务参数示例,不是完整 SDK 请求:
json
{
  "prompt": "分析上传的 CSV,输出统计 JSON 和一份中文说明,不修改原始文件。",
  "subagent_type": "general-purpose",
  "context_mode": "isolated",
  "acceptance_criteria": [
    "file:/mnt/user-data/outputs/statistics.json json-valid",
    "file:/mnt/user-data/outputs/report.md non-empty"
  ]
}
当前 JSON 语法检查有读取大小限制,并明确不等于业务 Schema 或语义校验。文件非空不能证明计算正确;一个有可信执行记录的测试,也不能证明测试覆盖了全部需求。
这就是需要区分的三层质量:
- 执行证据:工具是否真的执行、文件是否真的写出;
- 结构验收:JSON 是否合法、字段是否齐全、命令是否成功;
- 业务正确性:数值是否准确、结论是否有依据、是否满足真实需求。
第 3 层需要参考答案、领域规则、人工审查或更严格的评估,不能由第 1 层替代。
七、Skills、Tools、MCP:三种能力不要混用
工具是一段可执行能力;MCP 提供外部工具/资源的连接协议;Skill 通常是一份可复用的工作说明和支持文件。Skill 指导如何使用能力,不会仅靠存在一个 Markdown 文件就创造一个不存在的工具。
7.1 Skills 如何被识别和加载
skills/parser.py 解析 SKILL.md 的 YAML frontmatter,要求有效的 name 和 description。它支持 allowed-tools、所需密钥等额外字段。
这里同样有两层:宿主在管理阶段可能读取文件以提取元信息;模型上下文则可以先获得可用能力摘要,真正激活后才加载正文和相关策略。宿主读取文件,不等于全部内容已经计入每次模型输入。
当前版本将 SKILL.md 所在目录视为运行时包边界,嵌套的同名文件不应被误当成独立技能。/mnt/skills 也是受管理的投影目录,而不是任意主机目录挂载点。
7.2 写一个适合业务使用的 Skill
下面可作为自建 Skill 的内容,导入或安装后通过管理界面启用;安装位置及权限以当前版本配置为准,不要绕过管理机制直接写入沙箱投影目录。
markdown
---
name: csv-quality-review
description: 审查用户上传的 CSV 数据质量,生成统计摘要与问题清单。
---

# CSV 数据质量审查

仅处理当前用户明确提供的文件,不修改原始数据。

## 工作步骤
1. 确认文件路径、编码、列名和样本行。
2. 分别统计缺失值、重复行、数值范围和异常格式。
3. 只把规则能够解释的异常列入问题清单。
4. 输出 statistics.json 与 report.md 到当前线程 outputs。
5. 回读输出文件,检查 JSON 语法和统计口径。

## 交付约束
- 标明总行数与缺失值计算方式。
- 不把缺失值自动解释为业务错误。
- 没有执行过的操作不能写为已完成。
- 发现数据不充分时,给出限制与补充建议。
这个 Skill 的价值是把流程和验收口径固定下来,不是"让模型自动获得 pandas"。如果需要 Python 执行,沙箱必须有解释器和必要依赖;如果需要外部数据,必须另行配置工具与权限。
7.3 MCP 接入不等于授权所有外部操作
extensions_config.json 可以配置 MCP servers。以下是与官方字段一致的 HTTP server 配置示意,地址需要替换为你自己的可信服务:
json
{
  "mcpServers": {
    "company-knowledge": {
      "enabled": true,
      "type": "http",
      "url": "https://mcp.example.com/mcp",
      "headers": {"Authorization": "Bearer $KNOWLEDGE_MCP_TOKEN"},
      "description": "只读内部文档检索服务"
    }
  },
  "skills": {}
}
变量引用应由受控配置提供,不能把真实密钥写入文章或仓库。服务端仍要执行身份验证与数据权限过滤,不能依赖模型遵守"只读"。
stdio MCP 还会启动程序,管理员可配置启动器因此具有很高权限。官方明确将 Gateway 管理员权限视为接近代码执行能力;应仅安装可信依赖。
八、沙箱与文件交付:Agent 的代码到底在哪运行
8.1 Local 模式不能被理解为安全隔离
LocalSandboxProvider 是宿主侧便利模式,默认 allow_host_bash: false。它不是一个安全的 shell 隔离边界。Docker 生产部署下,"Local"指 Gateway 容器内的执行视角,不一定是你的 Docker 宿主文件系统。
如果 Skill 需要执行脚本,却只启用了不允许 bash 的 Local 模式,就可能出现"模型能解释,但不能实际生成文件"的情况。应补齐执行环境,不应让 Prompt 谎称已经完成。
8.2 AIO 模式提供容器执行,但不等于绝对安全
yaml
# 合并到完整 config.yaml;不要只保留这一个区块
sandbox:
  use: deerflow.community.aio_sandbox:AioSandboxProvider
  port: 8080
  container_prefix: deer-flow-sandbox
这是官方支持的配置形式。沙箱还应考虑资源上限、网络出口、挂载权限和命令超时。若通过 Docker socket 管理容器,该 socket 本身是高权限控制接口,不能当作普通只读数据卷公开。
8.3 虚拟路径、主机路径与容器路径是三种东西
Agent 常看到 /mnt/user-data/... 虚拟路径;真实文件由宿主和沙箱 Provider 映射。Compose 中的挂载路径又属于容器运行环境。
排错时要逐层检查:Gateway 能否访问配置中的 host_path;沙箱能否看到对应 container_path;产物服务是否读取当前线程的 outputs。不要为了修复文件找不到就挂载整个主机根目录。
历史 Issue #1405 提到复杂产物任务缺少执行环境的问题。这类报告提示了排查维度,但它描述的是当时环境,不能直接证明今天的每种 Provider 都存在相同故障。
九、Linux 部署:从固定版本到可安全访问
9.1 准备工具与源码
准备 Git、Docker Engine、Compose v2、GNU Make;需要运行配置向导时再准备 uv 和项目要求的 Python。安装方式按发行版和官方安装说明选择,不在同一篇文章里混用 apt、yum 和 Windows 命令。
bash
git --version
docker --version
docker compose version
make --version

git clone https://github.com/bytedance/deer-flow.git
cd deer-flow
git checkout 8cec46973885c4d24d649d4cbb1782674a8625c0
make config
make config 从模板创建本地配置,已有配置时会避免覆盖。之后编辑 config.yaml,或在依赖已准备好的情况下使用 make setup 向导。不要把 make clean 当成普通重启命令,它会删除本地运行数据。
9.2 配置模型,不要只填一把 Key
在完整配置文件的 models 中加入你实际可访问的模型:
yaml
models:
  - name: main-model
    display_name: 主模型
    use: langchain_openai:ChatOpenAI
    model: 替换为供应商真实模型ID
    api_key: $OPENAI_API_KEY
    timeout: 120
    max_retries: 2
这是一段配置片段,需替换真实模型 ID 才能调用。兼容服务还需按官方字段提供正确 API 地址,并确认工具调用、上下文长度和推理参数支持;不要为了"能启动"随意声明不支持的 vision/thinking 能力。
在根目录 .env 设置:
dotenv
OPENAI_API_KEY=填入自己的模型密钥
BIND_HOST=127.0.0.1
PORT=2026
GATEWAY_WORKERS=1
默认单 Worker 是有意选择。不要先开 4 个 Worker 再补持久化与流协调;多实例需要共同设计数据库、运行所有权、事件后端和 Redis 流桥接。
9.3 选择沙箱并启动生产栈
根据上一节设置沙箱。需要 AIO 时先准备镜像:
bash
make setup-sandbox
make up
docker compose -p deer-flow -f docker/docker-compose.yaml ps
make prod-logs
make up 进入 scripts/deploy.sh,构建并启动生产 Docker 栈;make docker-start 是开发路径,不应混写为同一种生产启动方式。
部署脚本还处理配置文件位置、数据目录、持久化密钥以及就绪检查等。自己改写启动脚本时,不能只留下 docker compose up 而丢掉这些前置约束。
默认入口 http://127.0.0.1:2026;内部 Gateway 8001 和前端 3000 不需要直接开放云安全组。
9.4 在首次初始化前不要开放到不可信网络
先通过 SSH 隧道访问:
bash
ssh -N -L 2026:127.0.0.1:2026 your-user@your-server然后浏览器打开本地 http://127.0.0.1:2026/setup 完成管理员初始化。公开入口前先完成账号设置,不能让陌生人抢先初始化。
团队访问建议用 HTTPS 反向代理、IP 白名单或 VPN,再按官方配置设置公开站点 URL。BIND_HOST=0.0.0.0 会扩大入口可达范围,不是部署完成必需的一步,更不是安全配置。
只开放入口必要端口;不要把 Redis、数据库和沙箱执行 API 暴露公网。沙箱的 8080 与网页入口的 2026 不是同一种服务。
9.5 SQLite、PostgreSQL、Redis 各用在什么地方
当前完整样例默认数据库为 SQLite,适合单机起步:
yaml
database:
  backend: sqlite
  sqlite_dir: .deer-flow/data
多实例需要共享 PostgreSQL,配置片段如下:
yaml
database:
  backend: postgres
  postgres_url: $DATABASE_URL
  postgres_schema: deerflow
还需安装/构建 postgres extra,准备实际 PostgreSQL 服务。官方 Compose 当前提供 Redis 服务,但不是自动为你提供任意生产 PostgreSQL 集群。别复制一个 DATABASE_URL 就宣称中间件部署完成。
迁移到多实例还必须核对 run_ownership.heartbeat_enabled、run_events.backend、stream bridge 和调度器配置。数据库解决共享持久化,Redis 解决流桥接,租约解决运行归属,三者不能互相替代。
单机项目先用默认单 Worker 与持久化文件完成可靠闭环,再按真实负载升级;这是容量设计,不是把技术名词堆齐。
9.6 验证要沿着依赖链做
bash
docker compose -p deer-flow -f docker/docker-compose.yaml ps
curl -I http://127.0.0.1:2026/
docker compose -p deer-flow -f docker/docker-compose.yaml logs --tail=100 gateway
ss -lntp
Gateway 区分 /health 的存活检查与 /health/ready 的就绪检查,后者包含有界数据库探测。容器健康不等于模型和全部 Skill 已验证。
最小业务验证可以分三步:普通对话;只读工具任务;生成一个小文件并从网页下载。每一步都检查日志与文件,不要只看模型回复"成功"。
常见故障:
| 现象 | 优先检查 |
|---|---|
| 本地能访问,远程不能 | 默认回环绑定、SSH 隧道、代理、安全组 |
| 页面正常,但模型报错 | 模型 ID、Key、接口兼容、供应商网络 |
| 生成代码但没有文件 | 沙箱能力、解释器依赖、工具权限、输出目录 |
| 文件写出却下载失败 | 虚拟路径映射、线程归属、产物注册 |
| 扩容后状态错乱 | 共享数据库、运行归属、流桥接和多实例设置 |
十、二次开发路线:优先扩展契约,不先 Fork 全部核心
10.1 低侵入:Skill 与只读 MCP
适合增加业务流程和知识入口。例如内部发布说明整理、数据质量报告、接口文档审查。先验证能力边界与输出契约,不急着改主 Agent 循环。
10.2 中侵入:自定义 Agent 与扩展中间件
可以为不同角色限定工具、Skills、模型和系统说明。也可以通过受信任配置加载中间件,加入领域检查或观测。当前配置支持主/子 Agent 共享的扩展中间件列表,但并不是任意位置都可插入,也不是每项都能区分 lead-only 与 subagent-only。
yaml
# 自有可信 Python 包的类加载配置示意;类须满足 AgentMiddleware 契约
extensions:
  middlewares:
    - class: my_company.deerflow_middlewares:DomainGuardMiddleware
      kwargs:
        policy_name: internal-readonly
此代码块只说明正式扩展点,不是假装已经实现 DomainGuardMiddleware。编写类之前应阅读中间件运行时与官方扩展契约,并为异常路径和状态持久化写测试。
当前 Makefile 提供了安装可信扩展的命令:
bash
make extension-install SOURCE=/absolute/path/to/your-trusted-extension
make extension-list
Python 扩展会执行代码,不是无权限的纯文本插件。不要允许任意普通用户指定一个包路径就由 Gateway 安装运行。
10.3 高侵入:自建 Sandbox Provider 与业务运行时
当你需要专用执行环境、受限网络、预装依赖或 Kubernetes 隔离时,再考虑 Provider。实现不只是"调用 Docker":需要遵守路径映射、文件操作、命令超时、创建/回收、容量限制和产物读取的完整契约。
要做对外产品,还需补充或验证计费、租户隔离、配额、管理员权限、审计与业务验收;这些能力不能因为上游有登录页面就被默认为全部完成。
十一、如何选型:DeerFlow、GPT Researcher 与自建编排
| 需求 | 更合理的起点 |
|---|---|
| 主要目标是有来源的研究报告 | GPT Researcher,聚焦研究流水线 |
| 需要交互工作台、工具执行、多文件产物与委派 | DeerFlow,理解其运行和安全边界后扩展 |
| 流程高度固定、需要自定义业务状态机 | 用 LangGraph 等编排库自建,减少不必要应用能力 |
| 少量确定性脚本和表单 | 普通后端加任务队列,未必需要多 Agent |
DeerFlow 的优势是很多应用工程环节已经存在,代价是依赖更多、版本变化更快、运行边界也更复杂。与其说它"效果更好",不如说它更适合需要执行和交付的任务;真正效果应在自己的任务集上测量。
面试或项目介绍时,比"我部署了几个 Agent"更有价值的内容是:如何分工和验收,怎样控制并发和费用,如何防止文件冲突,怎样保证重启后状态和产物可恢复。基于开源项目的贡献与上游能力要明确区分。
十二、总结与资料
DeerFlow 的核心不是让多个模型自由对话,而是通过主 Agent、受约束的委派、工具执行、状态保存与产物交付构成工作闭环。上下文快照是数据,不是权限;执行凭据是证据,不是业务正确性保证;容器是执行环境,也不是自动完成安全隔离。
建议按三步学习:先跑通单机最小任务,再读 task_tool 和父侧验收,最后选择 Skill、MCP 或扩展契约完成一个自己的业务功能。只有能解释失败路径与交付边界,才算理解了这类系统。
资料采集日期:2026-10-12~2026-10-13。本文示例基于源码与官方配置核对,不虚构云部署结果、模型产出或性能提升。