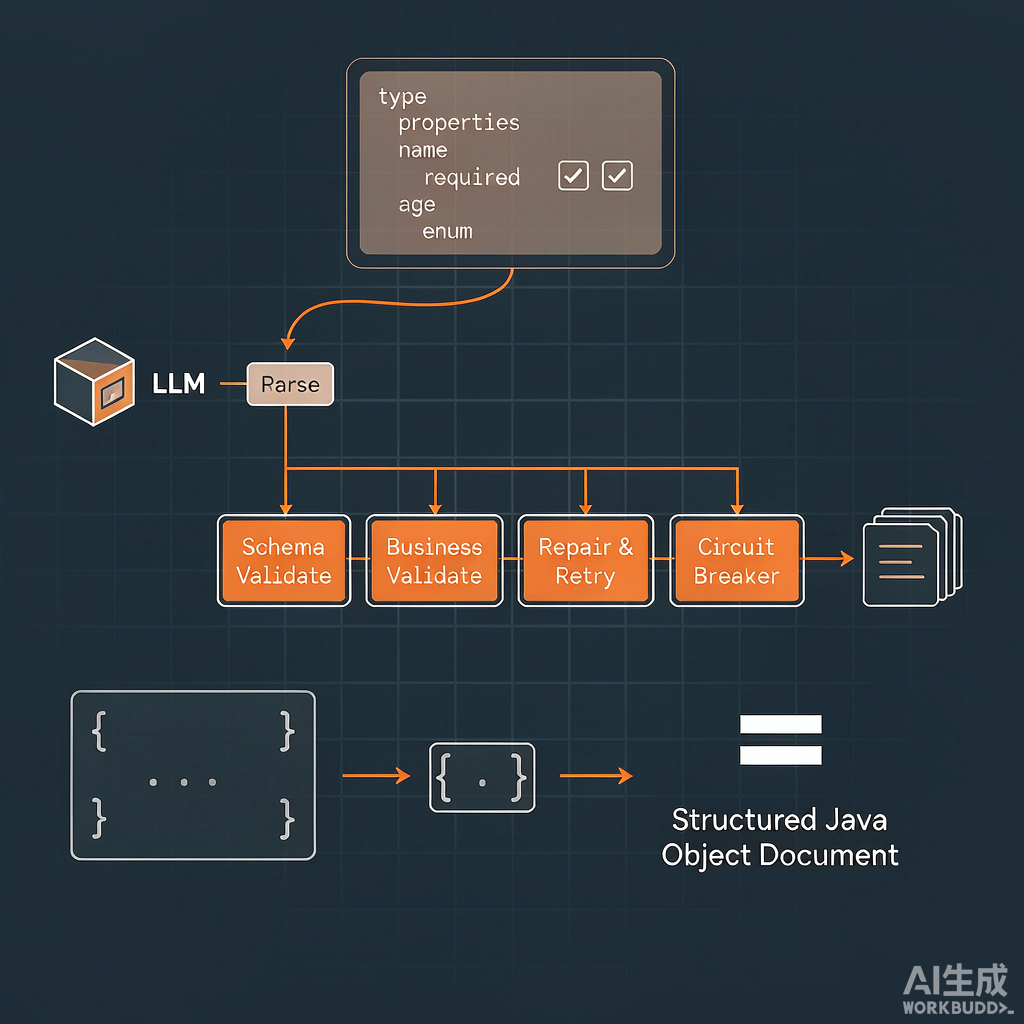
模型说"我返回 JSON 了"和你的系统能解析出业务对象,中间隔着 Markdown 围栏、字段漂移、枚举幻觉和 maxTokens 截断。结构化输出不是格式偏好,而是一份 API 契约------这篇文章把 Spring AI 2.0 的结构化输出机制拆到源码层,再给你一套带修复重试和降级熔断的生产级解析管道。
一、为什么结构化输出是 2026 年 Java 团队的第一优先级
最近开发者社区有一篇流传很广的文章《2026 AI Priorities for Java Developers》,把结构化输出、RAG、可观测性列为今年 Java 团队最该投入的三个方向,而不是继续追逐炫酷的 Agent 演示。理由很朴素:当 AI 功能进入真实业务系统,"模型说得漂亮"一文不值,"输出能被 Java 对象可靠承接"才是一切的前提。
想想这些场景:
- 订单抽取:从用户混乱的自然语言描述里抽出商品、数量、地址,写入订单系统;
- 工单分类:把客服对话分类到 20 个业务类目并打优先级,路由到不同队列;
- 合同审查:从 PDF 抽取甲方、金额、违约条款,进入风控流程。
这些任务里,模型输出的每一个字段都会被下游的数据库、工作流引擎、审批流程消费。一次解析失败不是"回答不好",而是脏数据进入生产库。 而实践中的残酷现实是:
- HTTP 200 不等于成功。 模型请求可以正常返回,但输出被 Markdown 代码围栏包裹、必填字段缺失、数字变字符串、枚举里出现从未定义的值、JSON 后面还跟了一段"希望对你有帮助"。
- 大多数团队把结构化输出当"提示词工程"处理------在 prompt 里加一句"请返回 JSON",demo 能跑,上了生产就撞墙。
正确的认知是:结构化输出是一条管道------模型响应 → 语法解析 → Schema 校验 → 业务规则校验 → 接受或恢复。Spring AI 2.0 把这条管道的前两环做成了框架能力,后两环需要你自己补齐。这篇文章就把整条链路讲透。
二、源码分析:Spring AI 2.0 结构化输出的三层实现
2.1 顶层接口:StructuredOutputConverter
Spring AI 的结构化输出抽象非常克制,一个接口两个能力:
java
public interface StructuredOutputConverter<T> extends Converter<String, T>, FormatProvider {
    // Converter<String, T>:  T convert(String text) ------ 把模型输出文本转成目标类型
    // FormatProvider:        String getFormat() ------ 提供注入提示词的格式说明
}
设计上有两个值得注意的点:
第一,它继承的是 Spring 自带的 org.springframework.core.convert.converter.Converter ,而不是自造轮子。这也是 2024 年从旧 OutputParser 体系重命名到 StructuredOutputConverter 体系的原因之一------官方文档明确说"这里其实没有 parsing,只是命名对齐",同时借用了 Spring 转换服务的生态。
第二,getFormat() 与 convert() 分别对应 LLM 调用的前后两端。 调用前,getFormat() 返回的格式说明被追加到提示词末尾,充当"输出蓝图";调用后,convert() 把原始文本反序列化成目标类型。这是一个"尽力而为"(best effort)的契约------官方文档原话是:"The StructuredOutputConverter is a best effort to convert the model output into a structured output. The AI Model is not guaranteed to return the structured output as requested." 这句话是理解后面所有生产踩坑的钥匙。
三个开箱实现各有分工:
| 实现 | 目标类型 | 典型场景 |
|---|---|---|
BeanOutputConverter<T> |
任意 Java Bean / Record / 泛型 | 抽取业务对象(最常用) |
MapOutputConverter |
Map<String, Object> |
动态键值、无需建类 |
ListOutputConverter |
List<String> |
逗号分隔的简单列表 |
2.2 BeanOutputConverter 源码:Schema 从哪来,格式说明长什么样
BeanOutputConverter 是重头戏。它做了两件事:基于目标 Java 类反射生成 JSON Schema (DRAFT_2020_12),并把 Schema 渲染进格式说明模板。getFormat() 的核心逻辑剥掉细节后是这样:
java
@Override
public String getFormat() {
    String template = """
            Your response should be in JSON format.
            Do not include any explanations, only provide a RFC8259 compliant JSON response \
            following this format without deviation.
            Do not include markdown code blocks in your response.
            Remove the ```json markdown from the output.
            Here is the JSON Schema instance your output must adhere to:
            ```%s```
            """;
    return String.format(template, this.jsonSchema);
}
几个源码级的细节值得记住:
- Schema 生成底层是 victools 的
jsonschema-generator,通过反射扫描目标类的字段、Jackson 注解(@JsonProperty、@JsonPropertyDescription、@JsonPropertyOrder)来构建 Schema。这意味着:你给字段写的@JsonPropertyDescription("订单金额,单位分,整数")会原样进入模型看到的 Schema------这是提升字段语义准确率几乎零成本的手段,后面踩坑清单里会展开。 - 格式说明里明确要求模型去掉 Markdown 代码围栏 ("Remove the ``json markdown"),说明官方早就知道模型爱用 ```json
包裹输出。但提示词约束挡不住所有模型,convert()` 内部仍有围栏剥离兜底。 - 支持泛型 :通过
ParameterizedTypeReference构造器处理List<Contract>这类参数化类型,避免泛型擦除。
convert() 则是纯粹的 Jackson 反序列化,外加对常见"污染"的清洗。
2.3 entity():一行代码背后的完整流水线
ChatClient 的 .entity() 是大多数人的入口,表面一行,内部流水线是:
text
.entity(ContractExtract.class)
  ① new BeanOutputConverter(ContractExtract.class)
  ② 反射字段 → 生成 JSON Schema(模型的"输出说明书")
  ③ 格式说明拼接进提示词({format} 占位符或自动追加)
  ④ call() 拿到模型原始文本
  ⑤ 剥离可能的 Markdown 代码围栏
⑥ Jackson 反序列化 → ContractExtract 实例一个容易被忽略的精髓:目标类不需要任何 Spring AI 依赖,就是个普通 POJO/Record。 你的业务对象长什么样,模型就被迫输出成什么样------领域模型本身就是输出契约。
2.4 两条技术路线:提示词注入 vs 原生 JSON Schema
Spring AI 的结构化输出默认走"提示词注入"路线(Schema 塞进 prompt,靠模型自觉)。但它不是唯一路线。现代主流模型(OpenAI、Anthropic、DeepSeek、通义)都支持原生结构化输出 ------在请求参数里声明 response_format / json_schema,由推理端做约束解码(constrained decoding):每一步生成只允许符合 Schema 的 token,从结构上保证输出合规。
在 Spring AI 2.0 中,通过 Options 透传即可启用:
java
// OpenAI 兼容端点的原生 strict 结构化输出
OpenAiChatOptions options = OpenAiChatOptions.builder()
        .model("gpt-6.1-sol")
        .responseFormat(new OpenAiChatOptions.ResponseFormat("json_schema"))
        .build();
两条路线的取舍:
| 维度 | 提示词注入(entity() 默认) | 原生 JSON Schema |
|---|---|---|
| 结构保证 | 尽力而为,可能失败 | 推理端约束,结构基本保证 |
| 模型兼容性 | 任意模型 | 需要模型/网关支持 |
| Schema 子集限制 | 无(完整 JSON Schema) | 有:不支持根级 oneOf、无约束 additionalProperties、深度递归等,超出可能被拒或静默降级 |
| 语义正确性 | 都不保证------结构对不等于值对 | 都不保证 |
生产建议:优先原生,提示词注入兜底。两者都不保证"值是对的",所以业务校验层无论如何都不能省。
三、代码实战:企业级合同抽取系统 ContractIQ
围绕一个完整项目来落地:法务部门的合同抽取服务------上传合同文本,模型抽取关键结构(甲方、乙方、金额、期限、违约条款、风险等级),写入风控数据库。技术栈:Spring Boot 4 + Spring AI 2.0 + JDK 25 虚拟线程 + Micrometer。
3.1 定义输出契约:领域模型即 Schema
java
public record ContractExtract(
        @JsonProperty(required = true)
        @JsonPropertyDescription("甲方全称,合同文本未出现时填 null")
        String partyA,

        @JsonProperty(required = true)
        @JsonPropertyDescription("乙方全称,合同文本未出现时填 null")
        String partyB,

        @JsonProperty(required = true)
        @JsonPropertyDescription("合同总金额,单位为人民币分,必须是整数;未出现时填 null")
        Long amountCents,

        @JsonPropertyDescription("合同期限,格式 yyyy-MM-dd,未出现时填 null")
        LocalDate endDate,

        @JsonProperty(required = true)
        @JsonPropertyDescription("风险等级,只能取 LOW / MEDIUM / HIGH 之一")
        RiskLevel riskLevel,

        @JsonPropertyDescription("违约条款摘要,最多 3 条,每条不超过 100 字;没有则返回空数组")
        List<ViolationClause> violationClauses,

        @JsonPropertyDescription("抽取依据:原文中的关键句,用于人工复核")
        List<String> evidences) {

    public enum RiskLevel { LOW, MEDIUM, HIGH }

    public record ViolationClause(
            @JsonPropertyDescription("条款原文编号,如 '第 12 条'")
            String clauseNo,
            @JsonPropertyDescription("违约责任描述")
            String liability) { }
}注意三个设计决策:金额用分(Long)避免浮点误差;未出现的信息允许 null 而不是逼模型编造 ("假完整比诚实的缺失更可怕");枚举只给 3 个值(模型在 2~6 个值的小枚举上准确率极高,20+ 类目要改用分层 Schema)。
3.2 快速版:entity() 一行接入
java
@Service
public class QuickExtractService {

    private final ChatClient chatClient;

    public QuickExtractService(ChatModel chatModel) {
        this.chatClient = ChatClient.builder(chatModel)
                .defaultSystem("""
                        你是合同审查助手。只依据合同文本抽取信息,不得编造。
                        合同文本未包含的信息一律填 null,禁止猜测。
                        """)
                .build();
    }

    public ContractExtract extract(String contractText) {
        return chatClient.prompt()
                .user(u -> u.text("""
                        请抽取以下合同的关键信息:
                        ---
                        {contract}
                        """).param("contract", contractText))
                .call()
                .entity(ContractExtract.class);
    }
}
demo 到此为止。生产版本还差三样:业务校验、失败修复重试、降级熔断。
3.3 生产版:带校验-修复-降级的解析管道
核心思想来自生产实践的最佳共识:校验失败时不要盲目重发同样的 prompt,要把具体错误反馈给模型------带上精确错误信息的重试,首次修复成功率通常在 80% 以上;同时重试必须有预算,超过阈值转人工队列。
java
@Service
public class StructuredExtractionService {

    private static final Logger log = LoggerFactory.getLogger(StructuredExtractionService.class);
    private static final int MAX_REPAIR_ATTEMPTS = 2;

    private final ChatClient chatClient;
    private final MeterRegistry registry;
    private final ContractValidator validator;   // 业务规则校验器
    private final CircuitBreaker extractionCircuit; // Resilience4j 熔断器

    public StructuredExtractionService(ChatModel chatModel, MeterRegistry registry,
                                       ContractValidator validator) {
        this.chatClient = ChatClient.builder(chatModel).build();
        this.registry = registry;
        this.validator = validator;
        this.extractionCircuit = CircuitBreaker.of("contract-extraction",
                CircuitBreakerConfig.custom()
                        .failureRateThreshold(30)       // 失败率超 30% 熔断
                        .slidingWindowSize(50)
                        .waitDurationInOpenState(Duration.ofSeconds(30))
                        .build());
    }

    /**
     * 完整管道:解析 → Schema 校验 → 业务校验 → 错误反馈修复 → 降级
     */
    public ContractExtract extractWithRecovery(String contractText) {
        return Try.ofSupplier(extractionCircuit::executeSupplier)
                .recoverCall()
                .get(() -> doExtractWithRecovery(contractText));
    }

    private ContractExtract doExtractWithRecovery(String contractText) {
        String lastRawOutput = null;
        String lastErrors = null;

        for (int attempt = 0; attempt <= MAX_REPAIR_ATTEMPTS; attempt++) {
            Timer.Sample sample = Timer.start(registry);

            String raw = (attempt == 0)
                    ? callModel(contractText, null)
                    : callModel(contractText, lastErrors);   // 带错误反馈的修复重试

            lastRawOutput = raw;
            try {
                ContractExtract result = parse(raw);          // 解析 + Schema 反序列化
                List<String> violations = validator.validate(result); // 业务校验

                if (violations.isEmpty()) {
                    sample.stop(registry.timer("ai.structured.success",
                            "attempt", String.valueOf(attempt)));
                    return result;
                }
                lastErrors = String.join("; ", violations);
            } catch (JsonProcessingException e) {
                // 解析失败:把 Jackson 的精确错误位置反馈给模型
                lastErrors = "上次输出无法解析为 JSON: " + e.getOriginalMessage()
                        + "。请只返回符合 JSON Schema 的 JSON,不要任何解释和 Markdown 代码块。";
            } finally {
                sample.stop(registry.timer("ai.structured.parse.duration"));
            }
        }

        // 修复预算耗尽:记录原始输出供排查,转人工队列
        registry.counter("ai.structured.failed").increment();
        log.error("结构化抽取失败,原始输出已存档。output={}", lastRawOutput);
        throw new ExtractionFailedException(lastRawOutput); // 上层入人工复核队列
    }

    private String callModel(String contractText, String repairHint) {
        String userText = (repairHint == null)
                ? "请抽取以下合同的关键信息:\n---\n" + contractText
                : "修复要求:" + repairHint + "\n\n请重新抽取以下合同:\n---\n" + contractText;

        return chatClient.prompt()
                .options(OpenAiChatOptions.builder()
                        .temperature(0.1)   // 结构化任务用低温
                        .build())
                .user(u -> u.text(userText + "\n\n{format}")
                        .param("format", new BeanOutputConverter<>(ContractExtract.class).getFormat()))
                .call()
                .content();
    }

    private ContractExtract parse(String raw) throws JsonProcessingException {
        // 兜底剥离代码围栏(即使格式说明已要求,模型仍可能违规)
        String cleaned = stripCodeFence(raw);
        return new BeanOutputConverter<>(ContractExtract.class).convert(cleaned);
    }

    private String stripCodeFence(String text) {
        String t = text.trim();
        if (t.startsWith("```")) {
            int firstLineEnd = t.indexOf('\n');
            int lastFence = t.lastIndexOf("```");
            if (firstLineEnd > 0 && lastFence > firstLineEnd) {
                t = t.substring(firstLineEnd + 1, lastFence).trim();
            }
        }
        return t;
    }
}
java
/**
 * 业务规则校验:结构正确 ≠ 语义可用
 */
@Component
public class ContractValidator {

    public List<String> validate(ContractExtract r) {
        List<String> errors = new ArrayList<>();
        if (r.amountCents() != null && r.amountCents() <= 0) {
            errors.add("amountCents 必须为正整数,当前值 " + r.amountCents());
        }
        if (r.endDate() != null && r.endDate().isBefore(LocalDate.now())) {
            errors.add("endDate 不能早于今天,当前值 " + r.endDate());
        }
        if (r.violationClauses() != null && r.violationClauses().size() > 3) {
            errors.add("violationClauses 最多 3 条,当前 " + r.violationClauses().size() + " 条");
        }
        if (r.riskLevel() == RiskLevel.HIGH && r.evidences().isEmpty()) {
            errors.add("riskLevel 为 HIGH 时 evidences 不能为空,需提供原文依据");
        }
        return errors;
    }
}
管道的关键设计点:
- 解析、Schema 校验、业务校验是三层不同的活,分开写、分开测,失败时才知道该把什么信息反馈给模型;
- 重试带错误反馈而非原样重发,且预算封顶(2 次);
- 熔断器防雪崩:当某类输入的结构化失败率超过 30%,直接熔断转人工,不再烧 token;
- 原始输出必须落日志------没有它,生产排查就是黑盒;
- Micrometer 记录首次通过率 / 修复成功率 / 每次尝试次数------首次通过率低说明 prompt 或 Schema 设计有问题,修复成功率高反而是坏消息的信号。
四、生产踩坑清单(8 条,每条都疼过)
1. Markdown 代码围栏包裹,直接 Jackson 炸掉。
最高频的失败。即使 getFormat() 里明确写了"Remove the ``json markdown",部分模型(尤其是小参数量的国产开源模型)依然会用 ```json 包裹输出。convert()内部有剥离逻辑,但对付"围栏内嵌套围栏""JSON 后还跟一段话"这类脏输出必须自己再兜一层stripCodeFence+ 定位首个{到末个}` 的提取逻辑。
2. maxTokens 截断,JSON 只有一半。
maxTokens 设太小(或推理型模型 thinking tokens 吃掉预算),输出在对象中途被掐断,Jackson 报"unexpected end of input"。这种错误重试 10 次也不会好------要靠调大 maxTokens 或精简 Schema 解决。修复重试的错误分类里要把它和"格式漂移"区分开,否则白白烧钱。
3. temperature 太高,同一份合同两次抽取字段名都不一样。
结构化任务必须低温(0~0.1)。有团队在 0.7 的配置上跑抽取,发现"偶发性"多字段/少字段,查了两天才发现是温度问题。原则:分类、抽取、解析类任务全部低温;只有生成类文案才允许高温。
4. 严格模式 Schema 子集限制:超出范围会静默降级。
原生 JSON Schema 的 strict 模式不支持根级 oneOf、无约束的 additionalProperties、过深的递归 Schema------有的 provider 直接 400,有的静默降级回 best-effort,你以为有约束解码兜底,实际上早就没了。Schema 保持扁平、显式,别复用为其他用途设计的通用 Schema。
5. 可选字段的语义歧义:缺字段是 0、是不适用、还是不知道?
让字段可选是语义灾难------模型没法理解"没有 score 字段"到底是 0 分还是未知。正确做法:字段全部 required + 用显式的 null / "unknown" / 约定值表达缺失 ,并在 @JsonPropertyDescription 里写清楚(见 3.1 的契约定义)。
6. 大枚举分类准确率崩塌。
20+ 类目的扁平枚举,模型准确率显著下降且类目间互相混淆("退款问题"vs"退货问题")。改用分层 Schema:第一层粗分类(4~6 个),第二层按第一层结果再细分类目。或者干脆给每个类目写一段判别式描述进 description。
7. 流式场景下 entity() 不能直接用。
ChatClient 的流式调用返回 Flux<String>,逐 token 的 JSON 无法直接 entity() 解析。要么聚合完整输出后再解析(牺牲首字延迟),要么用增量/部分 JSON 解析器逐字段填充 UI------不要手写括号计数器,字符串里嵌套的花括号会教做人。只在流结束(stop 事件)时才把解析结果当作最终态。
8. 盲目重试 + 无预算 = 成本泄漏黑洞。
校验失败就原样重发 prompt,是"懒惰的工程"------大概率得到同样的错误外加双倍延迟。修复必须带具体错误反馈;预算封顶 1~2 次;超限走人工队列或降级响应(部分结果 + 待复核标记),而不是无限重试。持续重试既烧 token 又放大延迟,还掩盖了 Schema 与真实输入分布不匹配的根本问题。
五、总结
结构化输出是 LLM 从"聊天玩具"变成"生产组件"的关键一跃,也是 2026 年 Java 团队最值得投入的 AI 工程方向之一。回顾本文的核心脉络:
- 三层机制 :
StructuredOutputConverter接口(Converter + FormatProvider)→BeanOutputConverter反射生成 JSON Schema + 格式注入 →entity()一行流水线。领域模型即输出契约。 - 两条路线 :提示词注入是 best effort,原生
json_schema约束解码是结构保证------生产优先原生,但两者都不保证语义正确,业务校验层永远不能省。 - 一条管道:解析 → Schema 校验 → 业务校验 → 错误反馈修复(封顶 2 次)→ 熔断降级转人工。HTTP 200 只是管道的起点。
- 一条铁律:把"模型输出的原始文本"当成不可信的第三方 API 响应来对待------校验、记录、修复、降级,一样都不能少。
对 Java 工程师而言,这正是我们最熟悉的战场:校验管道、熔断器、指标监控、降级策略,全是后端工程的基本功。模型能力是厂商的事,输出可靠性是工程的事------工程化能力才是我们的护城河。