面试现场,面试官往椅背上一靠,抛出一个特别现实的问题:
"你们公司那套系统是老架构------MySQL 加 Redis,Spring Boot 跑了好几年,连 PostgreSQL 都没有。现在老板说必须接大模型。你怎么干?"
这个问题的坑,不在技术,在你上来就答"先上一套向量数据库"。面试官听完基本就凉了:老系统能让你随便动架构吗?运维同意吗?预算批得下来吗?上线窗口在哪?
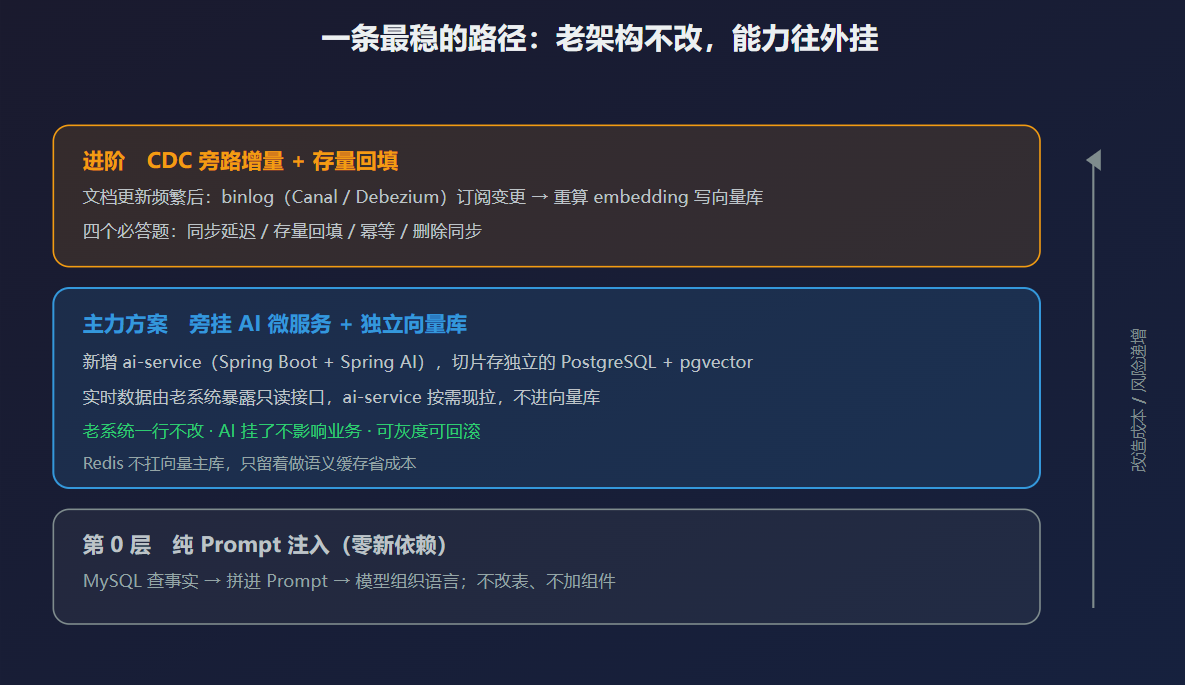
存量系统接 AI,考的不是你会不会搭向量库,考的是你会不会按改造成本排优先级,知道每一步的天花板在哪。这篇文章给你一条最稳的路径:老架构一行不改,旁挂一个 AI 微服务,再配一个独立的向量库。
一、先别急着选型:你要的到底是哪件事
很多人一开口就聊向量数据库,其实压根没想清楚需求。老系统要接大模型,无非三种:
-
A. 只想要模型的"嘴" :文本生成、改写、总结、分类、抽取。数据从哪来?你自己用老办法查出来喂进去就行了。这种需求一个向量数据库都不需要。
-
B. 想要模型的"知识":让模型基于你的私有文档回答问题。这才是 RAG,才需要向量检索。
-
C. 想要模型的"手":让模型调用你的业务接口(查订单、改状态)。这是 Function Calling / Agent 的活。
关键结论:国内绝大多数老系统的第一个 AI 需求,是 A,不是 B。 客服话术、工单摘要、评论分类、报表解读------全是 A。上来就冲着 B 去搭向量库,是把简单问题做复杂了。所以正确的顺序是:先看需求属于哪一类,再决定要不要动数据层。
二、第 0 层:零新依赖,把模型当"上下文翻译器"
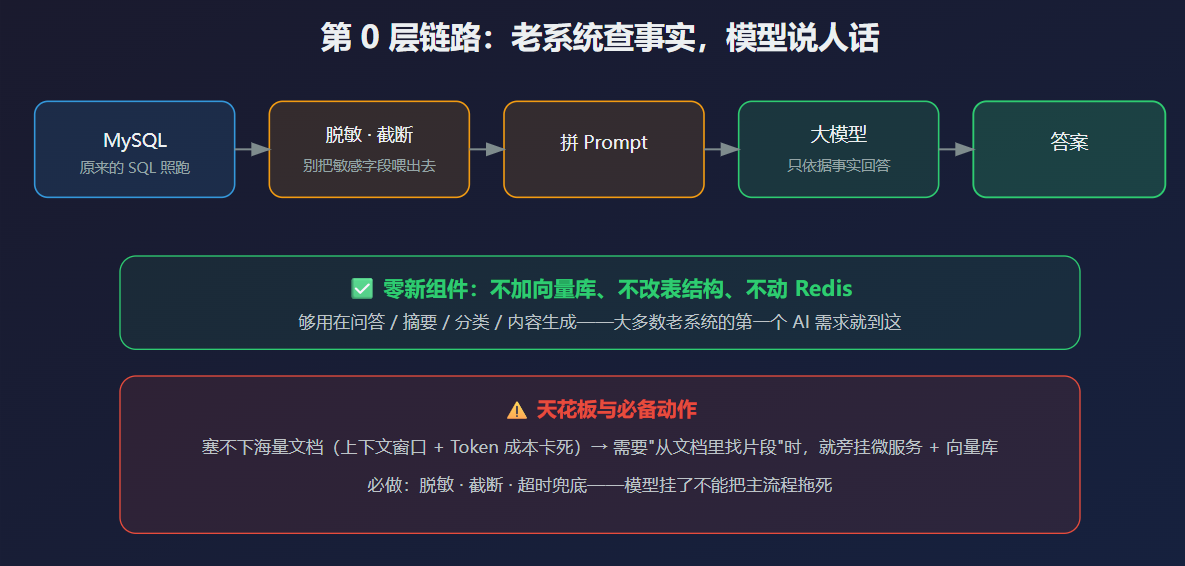
这一层的思路很简单:老系统负责"查事实",模型负责"说人话"。 数据还是从 MySQL 走原来的 SQL 查出来,拼进 Prompt,让模型基于这些事实组织语言。不建向量库,不改表结构,不动 Redis。
先看链路:
Java 侧用 Spring AI,代码短到你会怀疑人生:
java
@Service
public class LegacyAssistant {

    private final ChatClient chatClient;
    private final JdbcTemplate jdbc;   // 老系统本来就有的东西

    public LegacyAssistant(ChatModel chatModel, JdbcTemplate jdbc) {
        this.chatClient = ChatClient.builder(chatModel).build();
        this.jdbc = jdbc;
    }

    public String askAboutOrder(String orderNo, String question) {
        // 1) 用老办法把事实查出来(还是原来那套 SQL)
        List<Map<String, Object>> rows = jdbc.queryForList(
                "SELECT order_no, status, amount, created_at " +
                "FROM t_order WHERE order_no = ?", orderNo);

        // 2) 拼成一段纯文本,顺手做脱敏和截断
        String facts = rows.stream()
                .map(r -> "单号:" + r.get("order_no")
                        + " 状态:" + r.get("status")
                        + " 金额:" + r.get("amount")
                        + " 下单:" + r.get("created_at"))
                .collect(Collectors.joining("\n"));

        // 3) 交给模型:只让它依据 facts 回答,不许自由发挥
        return chatClient.prompt()
                .system("你是客服助手。只能依据 <facts> 里的内容回答;"
                      + "信息不足就直接说不知道,禁止编造。")
                .user(u -> u.text("""
                        <facts>
                        {facts}
                        </facts>
                        用户问题:{q}
                        """).param("facts", facts).param("q", question))
                .call()
                .content();
    }
}
这段代码能跑,是因为 ChatClient、ChatModel 都是 Spring AI 现成的 Bean,JdbcTemplate 是你项目里本来就有的。整段代码零新组件。
这一层能扛什么、扛不住什么,心里要有一杆秤:
-
能扛:低频的问答、摘要、分类、内容生成。数据量小、对延迟不敏感的场景,完全够用。
-
扛不住:需要"从海量文档里找相关片段"的需求。你没法把十万篇文档塞进 Prompt,上下文窗口和 Token 成本卡得死死的。
-
必须做的三件事:① 脱敏,别把手机号、身份证、金额明细直接喂给外部模型;② 截断,控制单次输入长度,超长就分段或只取摘要;③ 兜底,模型超时或报错要有降级路径,不能让它把主流程拖死。
一句话记住:第 0 层不是"凑合方案",它是成本最低、上线最快、风险最小的第一步。很多老系统的 AI 需求,到这一步就结束了。
三、主力方案:旁挂一个 AI 微服务,配一个独立向量库
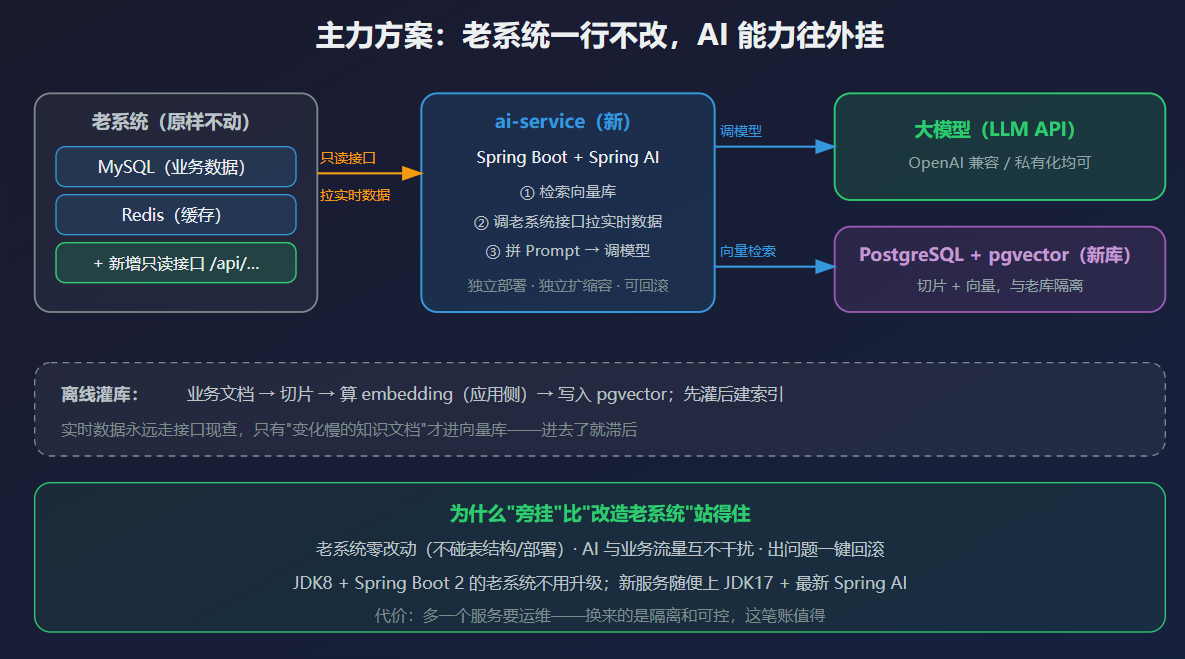
需求升级到"要基于私有文档回答",就得做检索了。这时候最稳的做法,不是去改老系统,而是旁挂。
为什么是"旁挂微服务",而不是"改造老系统"
把 AI 能力塞进老系统里,听起来省事,其实是给自己挖坑:
-
老系统一行不改:业务逻辑、表结构、部署流程全都不动,风险被隔离到最小。改老系统意味着回归测试、上线窗口、连带故障,全是成本。
-
新服务独立扩缩容:AI 流量和业务流量互不干扰。大模型调用一慢,也只影响 AI 服务,拖不垮交易主链路。
-
出问题能一键回滚:AI 服务整个下线,老系统的原有功能照样跑。
-
技术栈解耦:老系统是 JDK 8 + Spring Boot 2 不敢动,新服务直接上 JDK 17 + 最新 Spring AI,各玩各的。
链路长什么样
-
老系统照常写 MySQL、跑 Redis,一个字都不改。
-
新增一个 ai-service(Spring Boot + Spring AI),它只干三件事:检索、拼 Prompt、调模型。
-
文档切片和向量,存到一个全新的 PostgreSQL + pgvector 库里------注意这是新库,不是老库,老库还是 MySQL。
-
需要实时数据时,ai-service 通过 HTTP 调老系统新暴露的查询接口,按需拉取,保证数据新鲜。
切片与入库:新库独立,不动老库
pgvector 只是 PostgreSQL 的一个扩展,建表很直接:
sql
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE kb_chunk (
    id         BIGSERIAL PRIMARY KEY,
    doc_id     BIGINT      NOT NULL,
    tenant     VARCHAR(64) NOT NULL,   -- 用于权限过滤
    content    TEXT        NOT NULL,
    embedding  vector(1536)            -- 维度要和 embedding 模型对上
);

-- 建议先灌数据、再建索引,边建边灌很慢
CREATE INDEX idx_kb_chunk_vec
    ON kb_chunk USING hnsw (embedding vector_cosine_ops)
    WITH (m = 16, ef_construction = 64);
向量是应用侧算好再写进来的,pgvector 只负责存和查。这块的细节------HNSW 参数怎么调、三种距离算子怎么选、Spring AI 怎么接 pgvector------我在第 26 篇已经掰开揉碎讲透了,这里不重复,只说存量改造上真正独有的部分。
实时数据:老服务暴露接口,ai-service 按需拉
老系统只需增加一个只读查询接口,代码短得不能再短:
java
@RestController
public class LegacyDataApi {                 // 挂在老系统里

    private final JdbcTemplate jdbc;         // 老系统原有组件

    @GetMapping("/api/tickets/latest")
    public List<Map<String, Object>> latest(@RequestParam String userId) {
        return jdbc.queryForList(
                "SELECT ticket_no, status, updated_at " +
                "FROM t_ticket WHERE user_id = ? " +
                "ORDER BY updated_at DESC LIMIT 5", userId);
    }
}
为什么是"按需拉",不是"同步进向量库"? 因为实时数据变得太快。工单状态一分钟变三回,你同步进向量库就开始滞后,用户问"我单子到哪了",模型拿着十分钟前的状态回答,比不回答还糟。实时数据永远走接口现查,向量库里只放那些变化慢的知识类文档。
ai-service 侧:检索 + 实时 + 拼 Prompt
java
@Service
public class KnowledgeAssistant {

    private final VectorStore vectorStore;   // Spring AI + pgvector
    private final ChatClient chatClient;
    private final RestClient legacyClient;   // 调老系统的接口

    public KnowledgeAssistant(VectorStore vectorStore, ChatModel chatModel,
                              @Value("${legacy.api.base}") String legacyBase) {
        this.vectorStore = vectorStore;
        this.chatClient = ChatClient.builder(chatModel).build();
        this.legacyClient = RestClient.builder().baseUrl(legacyBase).build();
    }

    public String ask(String userId, String question) {
        // 1) 知识类内容:从独立向量库检索相关切片(带权限过滤)
        List<Document> docs = vectorStore.similaritySearch(
                SearchRequest.builder()
                        .query(question)
                        .topK(5)
                        .filterExpression("tenant == '" + userId + "'")
                        .build());

        // 2) 实时内容:调老系统接口现拉,保证不过期
        String live = legacyClient.get()
                .uri("/api/tickets/latest?userId={u}", userId)
                .retrieve()
                .body(String.class);

        String context = docs.stream()
                .map(Document::getText)
                .collect(Collectors.joining("\n---\n"));

        return chatClient.prompt()
                .system("只能依据 <docs> 和 <live> 的内容回答;"
                      + "没有依据就说不知道,禁止编造。")
                .user(u -> u.text("<docs>{d}</docs>\n<live>{l}</live>\n问题:{q}")
                        .param("d", context).param("l", live).param("q", question))
                .call()
                .content();
    }
}
三个要点,面试官很爱追:
-
权限过滤走
filterExpression:在向量库这一步就把不属于该用户的切片挡掉,别等检索完再在内存里筛------既慢又容易漏。 -
实时数据走接口现查,知识文档才进向量库:两条数据源,职责分清。
-
接口要有超时和兜底:老系统的接口一旦抖动,ai-service 要能降级(用缓存、或只答知识部分),别把整个问答拖死。
四、Redis 别当向量主库,但语义缓存是真香
铺垫了这么久,回过头回答一个高频追问:老系统本来就有 Redis,为什么不直接拿 Redis 当向量库?
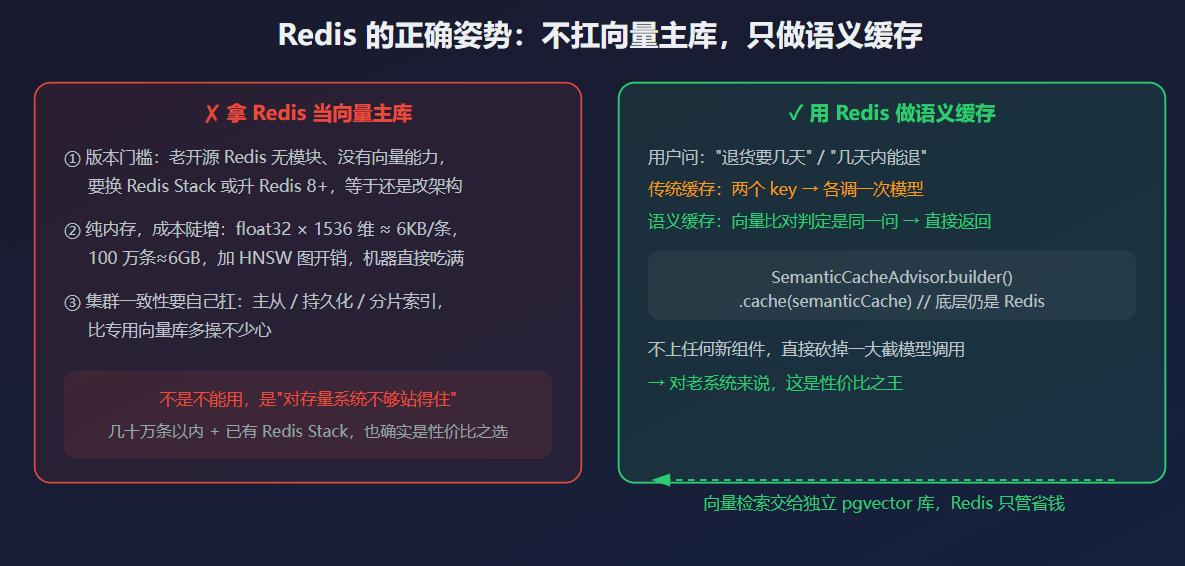
因为对"存量系统"这个前提来说,它不够站得住:
-
版本门槛 :老的开源 Redis 不带模块,压根没有向量能力。要用得换 Redis Stack ,或者升级到 Redis 8+ 的原生 vector sets。你手上那台跑了好几年的 Redis 大概率不是------那这就不叫"不加组件"了。
-
纯内存,成本随规模陡增:按 float32 算,1536 维一条向量约 6KB,100 万条光原始向量就 6GB,再加 HNSW 图结构的开销,一台十几 G 内存的机器直接吃满。几十万条以内很香;上千万条,就该上独立向量库了。
-
高可用和集群要自己扛:主从、持久化、集群分片下的索引一致性,用 Redis 做向量比用专用库要多操不少心。
所以对存量系统,把向量检索交给独立的 pgvector 库,比硬榨 Redis 更干净。
不过 Redis 有一个技能对老系统是性价比之王------语义缓存。用户问"退货要几天"和"几天内能退",传统缓存当成两个 key,各调一次模型;语义缓存用向量比对,判定是一回事,直接返回缓存结果。不上任何新组件,就能砍掉一大截模型调用成本。
java
SemanticCacheAdvisor cacheAdvisor = SemanticCacheAdvisor.builder()
        .cache(semanticCache)   // 底层还是 Redis 向量检索
        .build();

String answer = ChatClient.builder(chatModel)
        .build()
        .prompt()
        .user(question)
        .advisors(cacheAdvisor)     // 命中就走缓存,绕过模型
        .call()
.content();一句话:Redis 拿来省模型调用,不拿它扛向量主库。
五、数据量和并发上来之后:CDC 旁路增量 + 回填
主方案跑起来后,会冒出一个新问题:文档更新了,向量库怎么跟着更新?
如果文档变动不频繁,最简单是定时任务重新灌 。但数据一多、要求一变高,就得上真正的增量链路:CDC(Change Data Capture)旁路同步------主库一行不改,从 binlog 里"偷"变更。
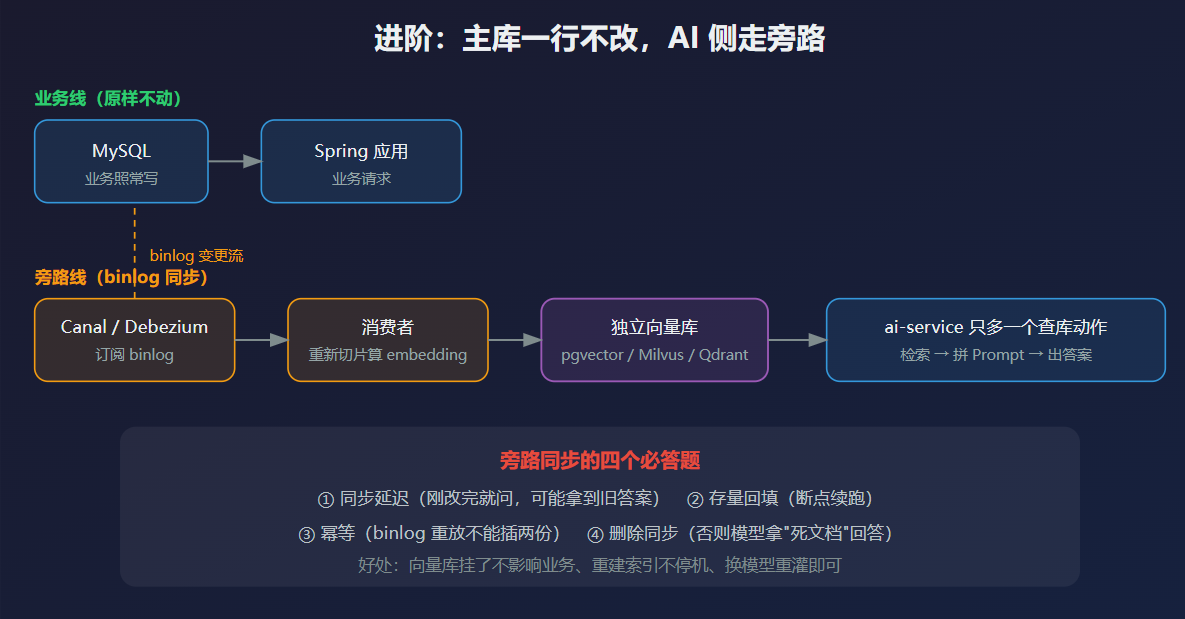
链路是这样的:
-
业务照常写库,一个字都不用改。
-
用 CDC 工具订阅 binlog------国内常用 Canal ,也有人用 Debezium。
-
消费变更消息,把新增/修改的文档送去重新切片、算 embedding。
-
写入独立向量库,旧系统这边只多一个 HTTP 客户端。
这条链路能把风险隔离得最干净:向量库挂了不影响业务,重建索引不用停机,模型换了一边重灌一遍就行。
但旁路同步有四个必须处理的现实问题,面试官很爱追:
-
同步延迟:binlog 消费是有延迟的。刚改完的数据马上问,模型可能还拿着旧答案。要么接受这个窗口,要么在关键路径上做"读己之写"的兜底。
-
回填(backfill):系统上线那天,存量数据怎么一次性灌进去?得有一套能断点续跑的初始化脚本。
-
幂等:binlog 可能重放,同一条记录被消费两次不能插出两份向量。用业务主键做去重。
-
删除:上游删了数据,向量库里的也得跟着删,否则模型会拿"已死的文档"回答问题。这块最容易被漏掉。
六、真正决定能不能上生产的,是这几件"横切事"
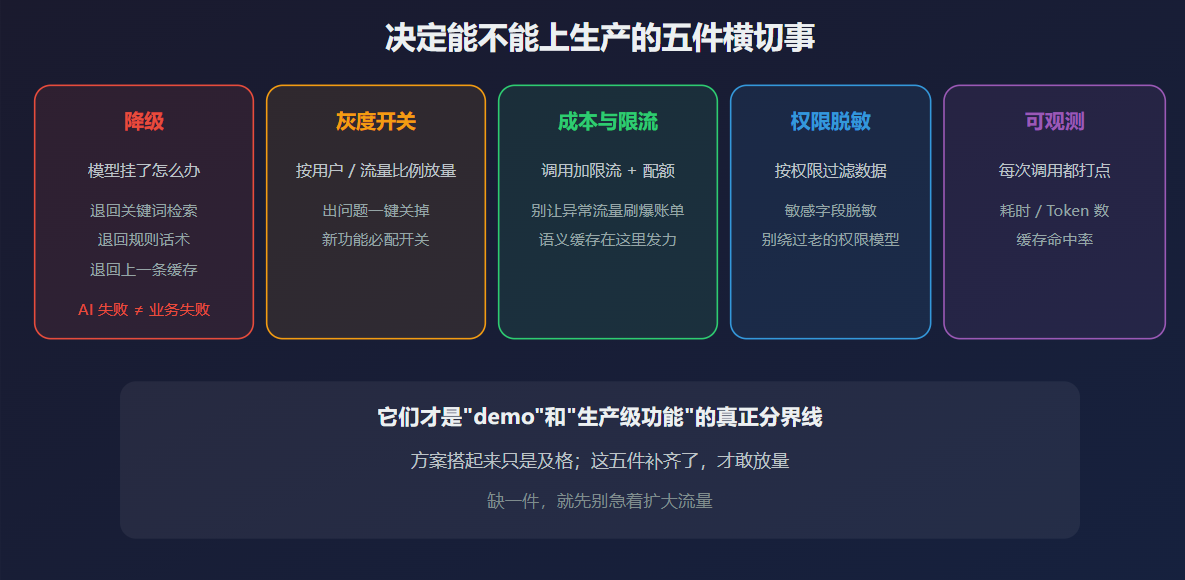
方案搭起来只是及格,能不能上线,看的是下面这些:
-
降级 :大模型接口挂了怎么办?必须有兜底------退回关键词检索、退回规则话术、退回上一条缓存。让 AI 功能的失败不要变成业务功能的失败。
-
灰度开关:新功能一定要有开关,能按用户、按流量比例放量,出问题一键关掉。
-
成本与限流:给模型调用加限流和配额,别让一次异常流量把账单刷爆。语义缓存也是在这里发力的。
-
权限与脱敏:喂给模型的数据要按权限过滤,敏感字段要脱敏。老系统的权限模型本来就在,接 AI 时别绕过去。
-
可观测:把每次调用的耗时、Token 数、命中缓存的比率都打点,不然出了问题两眼一抹黑。
这五条听着像"运维八股",但它们才是第 0 层方案和生产级方案的真正分界线。第二章那段代码能不能变成线上功能,差的就是这些。
七、落地顺序:从第 0 层走到 CDC
把上面的东西串成一条可执行的路径:
-
先做第 0 层,挑一个高频、低风险、错了也不出事的场景(比如客服话术、工单摘要)。上线,收集真实使用数据。这一步验证的是"这个需求到底有没有用"。
-
需求升级到文档检索,再旁挂 ai-service + 独立 pgvector 库,实时数据走老系统接口现查。这一步验证的是"检索质量够不够用"。
-
数据量或更新频率压不住,才上 CDC 旁路增量(加存量回填)。这一步验证的是"成本和收益划不划算"。
-
全程把第六节那五件横切事补齐,缺一件都别急着放量。
每一步都有明确的"触发条件",没到就不往下走。这就是"按改造成本排优先级"的具体含义。
🎯 面试官视角的标准回答
被问"存量老系统怎么接大模型",可以这么答:
"我不会一上来就动架构。先看需求属于哪一类------只是要模型的表达能力,还是要基于私有知识检索,还是要让模型调业务接口。多数老系统的第一个需求其实只是第一类,用现有的 SQL 查数据、拼进 Prompt 就够了,一个组件都不用加。<br><br>需求升级到文档检索,我的做法是旁挂:新增一个 AI 微服务跑 Spring AI,切片存到独立的 pgvector 库,老系统一行不改;实时数据让老系统暴露只读接口,ai-service 按需现拉,不进向量库------因为实时数据进库就滞后了。<br><br>有人会说用现成的 Redis 做向量库,但存量系统那台 Redis 往往不带向量能力,要换 Stack 或升 8+,等于还是改架构;而且纯内存,规模一上来成本陡增。所以向量检索我交给独立库,Redis 只留着做语义缓存省成本。<br><br>等更新频率上来,再上 CDC 旁路同步做增量。整个过程里,我最在意的是降级、灰度、成本、权限和数据一致性这几件横切的事------方案能不能上生产,差别就在这些地方,不在选哪个向量库。"
这套回答之所以能打,是因为它同时展示了三样东西:需求判断力、成本意识、和生产风险意识。面试官要的就是这个。
到这儿,「面 Java 岗,问我 AIGC?」这个系列就 27 篇了。从 AIGC 概念一路讲到存量系统落地,主线始终是一句话:技术选型没有标准答案,只有"看你手里有什么牌、要解决什么问题"。 后面如果还有值得挖的场景,我们接着聊。