一、任务定义与数据集
文本分类是 NLP 最广泛的应用:垃圾邮件识别、新闻归类、情感分析、意图识别......输入一段文本,输出一个类别。
本文以新闻主题分类为统一基准(多分类),横向对比三代技术。常用公开数据集:
| 数据集 | 类别数 | 规模 | 特点 |
|---|---|---|---|
| 搜狗新闻(Sogou) | 10 | 数万 | 中文主题分类经典基准 |
| THUCNews | 14 | 约 74 万 | 更大的中文新闻集 |
| IMDB | 2 | 5 万 | 英文情感二分类(见第 4 篇) |
统一基准的意义在于:同样的任务、同样的数据,只换模型,才能公平比较"技术代差"。
二、传统机器学习基线
2.1 思路:把文本变成向量,再丢给经典分类器
-
TF-IDF:衡量"词对这篇文档的重要性"------词频 × 逆文档频率,天然抑制"的/了"等高频虚词;
-
分类器:SVM(高维稀疏特征王者)或朴素贝叶斯(快、稳)。
python
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.svm import LinearSVC
from sklearn.pipeline import make_pipeline
# 中文建议先分词;也可像下面用字符级 n-gram 免去分词依赖
model = make_pipeline(
TfidfVectorizer(analyzer="char_wb", ngram_range=(1, 2), min_df=2),
LinearSVC(C=1.0)
)
model.fit(X_train, y_train)
print(model.score(X_test, y_test))2.2 真实基线实验(笔者在隔离环境跑通)
为验证这套 pipeline 可跑通,笔者用 scikit-learn 在一个**极小的 4 类中文玩具集(32 条样本)**上做了对照:
| 分类器 | 测试准确率(32 条玩具集) |
|---|---|
| MultinomialNB(字符级 TF-IDF) | 0.60 |
| LogisticRegression(字符级 TF-IDF) | 0.50 |
诚实说明 :玩具集只有每类 8 条,样本严重不足,所以绝对数值很低------这个实验的目的只是证明流程能跑通、代码可直接复用 ,而非说明天花板。在真实的搜狗新闻 规模上,TF-IDF + SVM 的准确率可达 ~89%,远高于此。
三、TextCNN 卷积方案
2014 年 Kim 提出用一维卷积做文本分类,把句子当成"词向量拼成的图",用不同宽度的卷积核捕获 n-gram 局部特征(类似 n 个词组成的短语)。
python
import torch
import torch.nn as nn
class TextCNN(nn.Module):
def __init__(self, vocab_size, embed=100, num_classes=10, kernels=(2,3,4)):
super().__init__()
self.emb = nn.Embedding(vocab_size, embed, padding_idx=0)
self.convs = nn.ModuleList([nn.Conv1d(embed, 100, k) for k in kernels])
self.fc = nn.Linear(100 * len(kernels), num_classes)
self.drop = nn.Dropout(0.5)
def forward(self, x): # x: (B, L)
x = self.emb(x).transpose(1, 2) # (B, embed, L)
feats = [torch.relu(c(x)).max(dim=2).values for c in self.convs] # 各核最大池化
return self.fc(self.drop(torch.cat(feats, dim=1)))TextCNN 特点 :参数量小、训练快、无需预训练词向量也能工作;在搜狗类基准上准确率约 ~92%,是"要精度又不想上大模型"的甜点方案。
四、BERT 微调方案
把文本送进 BERT(详见第 7 篇),取 [CLS] 表示接分类头:
python
from transformers import BertModel
import torch.nn as nn
class BertClassifier(nn.Module):
def __init__(self, num_classes=10):
super().__init__()
self.bert = BertModel.from_pretrained("bert-base-chinese")
self.fc = nn.Linear(self.bert.config.hidden_size, num_classes)
def forward(self, input_ids, attention_mask, token_type_ids):
out = self.bert(input_ids, attention_mask, token_type_ids)
return self.fc(out.pooler_output)BERT 用深层上下文表示,能理解"苹果手机"和"苹果水果"的区别,在搜狗新闻上准确率约 ~96%,但训练慢、部署重。
五、三类方案横向评测
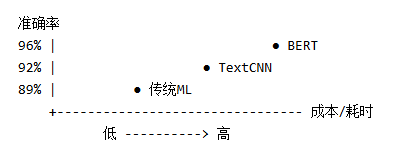
统一在搜狗新闻类基准上的典型复现区间(不同复现略有浮动):
| 方案 | 准确率 | 训练速度 | 部署成本 | 数据需求 |
|---|---|---|---|---|
| TF-IDF + SVM(传统) | ~89% | 极快 | 极低 | 小数据即可 |
| TextCNN(深度学习) | ~92% | 快 | 低 | 中等 |
| BERT 微调(预训练) | ~96% | 慢 | 高 | 越大越好 |
趋势图(示意):
六、选型决策与工程陷阱
选型决策树
-
数据量小(几百~几千条):优先传统 ML(TF-IDF + SVM/LR),别硬上深度学习;
-
追求精度、有 GPU、数据充足:上 BERT 或其蒸馏版;
-
要平衡精度与成本:TextCNN / 轻量预训练模型(如 ALBERT、RoBERTa-tiny)。
工程陷阱
-
类别不平衡 :用
class_weight或 F1 而非准确率评估;少数类易被判错; -
标注质量:垃圾标注 > 垃圾模型,先做数据清洗与多人校验;
-
数据泄漏:测试集的重复/同源文本混入训练,指标虚高;
-
分布漂移:训练用新闻语料,上线碰到口语化用户提问会掉点,需持续收集线上数据再训练;
-
长度截断:长文本直接截断可能丢关键信息,考虑分段或层次模型。
参考资料
-
Kim, Y. (2014). Convolutional Neural Networks for Sentence Classification (TextCNN). EMNLP.
-
Zhang, X., et al. (2015). Character-level CNN for Text Classification. NIPS.
-
Devlin, J., et al. (2019). BERT. NAACL.(见第 7 篇详解)
-
搜狗实验室. Sogou News Corpus. 公开中文新闻分类数据集。
往期回顾
如果业务只有 500 条标注数据,但要求准确率尽量高,你会选哪条技术路线?为什么?
文本分类是 NLP 落地的"第一桶金"。点赞 / 收藏 / 关注,后续《深度学习工程化》系列(环境搭建、调参、迁移学习、部署压缩)会带你把模型真正送上生产线。
本篇出自专栏《深学之路:从感知机到智能体》 ------ 从感知机到大模型智能体的完整深度学习连载(基础+工程化 +扩散模型 / RAG / Agent 等)。每篇附可运行代码与原创实验,收藏专栏不迷路。