(五)MCP+A2A之------工具模块开发:让Agent拥有调用与感知外部环境的能力
◆ 学习并了解MoocManus中内置工具的开发与使用,并基于工具基类开发Bing搜索工具,实现让Agent能调用联网工具获取实时信息。
◆ 设计并完成MCP客户端管理器的开发,实现根据配置动态加载与缓存客户端会话、工具参数声明、工具名字冲突解决、根据工具名字调用MCP服务集合中指定的工具等。
◆ 设计并完成MCP工具模块API接口的开发,实现可通过可视化方式动态配置Agent接入的MCP工具,并了解jina.ai搜索工具,尝试将其通过MCP配置方式接入系统。
1、bing搜索引擎工具的设计思路与模型定义
app/domain/models/search.py
python
#!/usr/bin/env python
# -*- coding: utf-8 -*-
"""
@Time    : 2025/05/24 14:56
@Author  : thezehui@gmail.com
@File    : search.py
"""
from typing import Optional, List

from pydantic import BaseModel, Field


class SearchResultItem(BaseModel):
    """搜索结果条目数据模型"""
    url: str  # 搜索条目URL地址
    title: str  # 搜索条目标题
    snippet: str = ""  # 搜索条目简介


class SearchResults(BaseModel):
    """搜索结果数据模型"""
    query: str  # 用户的搜索词
    date_range: Optional[str] = None  # 日期检索范围
    total_results: int = 0  # 搜索结果条数
    results: List[SearchResultItem] = Field(default_factory=list)  # 搜索结果列表
app/domain/external/search.py
python
#!/usr/bin/env python
# -*- coding: utf-8 -*-
"""
@Time    : 2025/05/24 14:55
@Author  : thezehui@gmail.com
@File    : search.py
"""
from typing import Protocol, Optional

from app.domain.models.search import SearchResults
from app.domain.models.tool_result import ToolResult


class SearchEngine(Protocol):
    """搜索引擎API接口协议"""

    async def invoke(self, query: str, date_range: Optional[str] = None) -> ToolResult[SearchResults]:
        """调用搜索引擎并传递query+date_range(日期检索范围)调用搜索引擎获取数据"""
        ...
app/domain/services/tools/search.py
python
#!/usr/bin/env python
# -*- coding: utf-8 -*-
"""
@Time    : 2025/05/25 10:14
@Author  : thezehui@gmail.com
@File    : search.py
"""
from typing import Optional

from app.domain.external.search import SearchEngine
from app.domain.models.search import SearchResults
from app.domain.models.tool_result import ToolResult
from .base import BaseTool, tool


class SearchTool(BaseTool):
    """搜索工具包,提供与搜索引擎交互的能力"""
    name: str = "search"

    def __init__(self, search_engine: SearchEngine) -> None:
        """构造函数,完成搜索工具包的初始化"""
        super().__init__()
        self.search_engine = search_engine

    @tool(
        name="search_web",
        description="全网搜索引擎工具。当需要获取实时信息(如突发新闻、天气)、补充内部知识库未涵盖的内容或进行事实核查时使用。该工具会返回相关的网页摘要和链接。",
        parameters={
            "query": {
                "type": "string",
                "description": "针对搜索引擎优化的查询字符串。请提取问题中的核心实体和关键词(3-5个),避免使用完整的自然语言问句(例如将'今天北京的天气怎么样'转换为'北京 天气')。"
            },
            "date_range": {
                "type": "string",
                "enum": ["all", "past_hour", "past_day", "past_week", "past_month", "past_year"],
                "description": "(可选)搜索结果的时间范围过滤。当用户询问特定时效性的新闻或事件时(如'昨天'、'上周'),必须指定此参数。默认为 'all'。"
            }
        },
        required=["query"]
    )
    async def search_web(self, query: str, date_range: Optional[str] = None) -> ToolResult[SearchResults]:
        """调用搜索引擎获取搜索结果后返回"""
        return await self.search_engine.invoke(query, date_range)
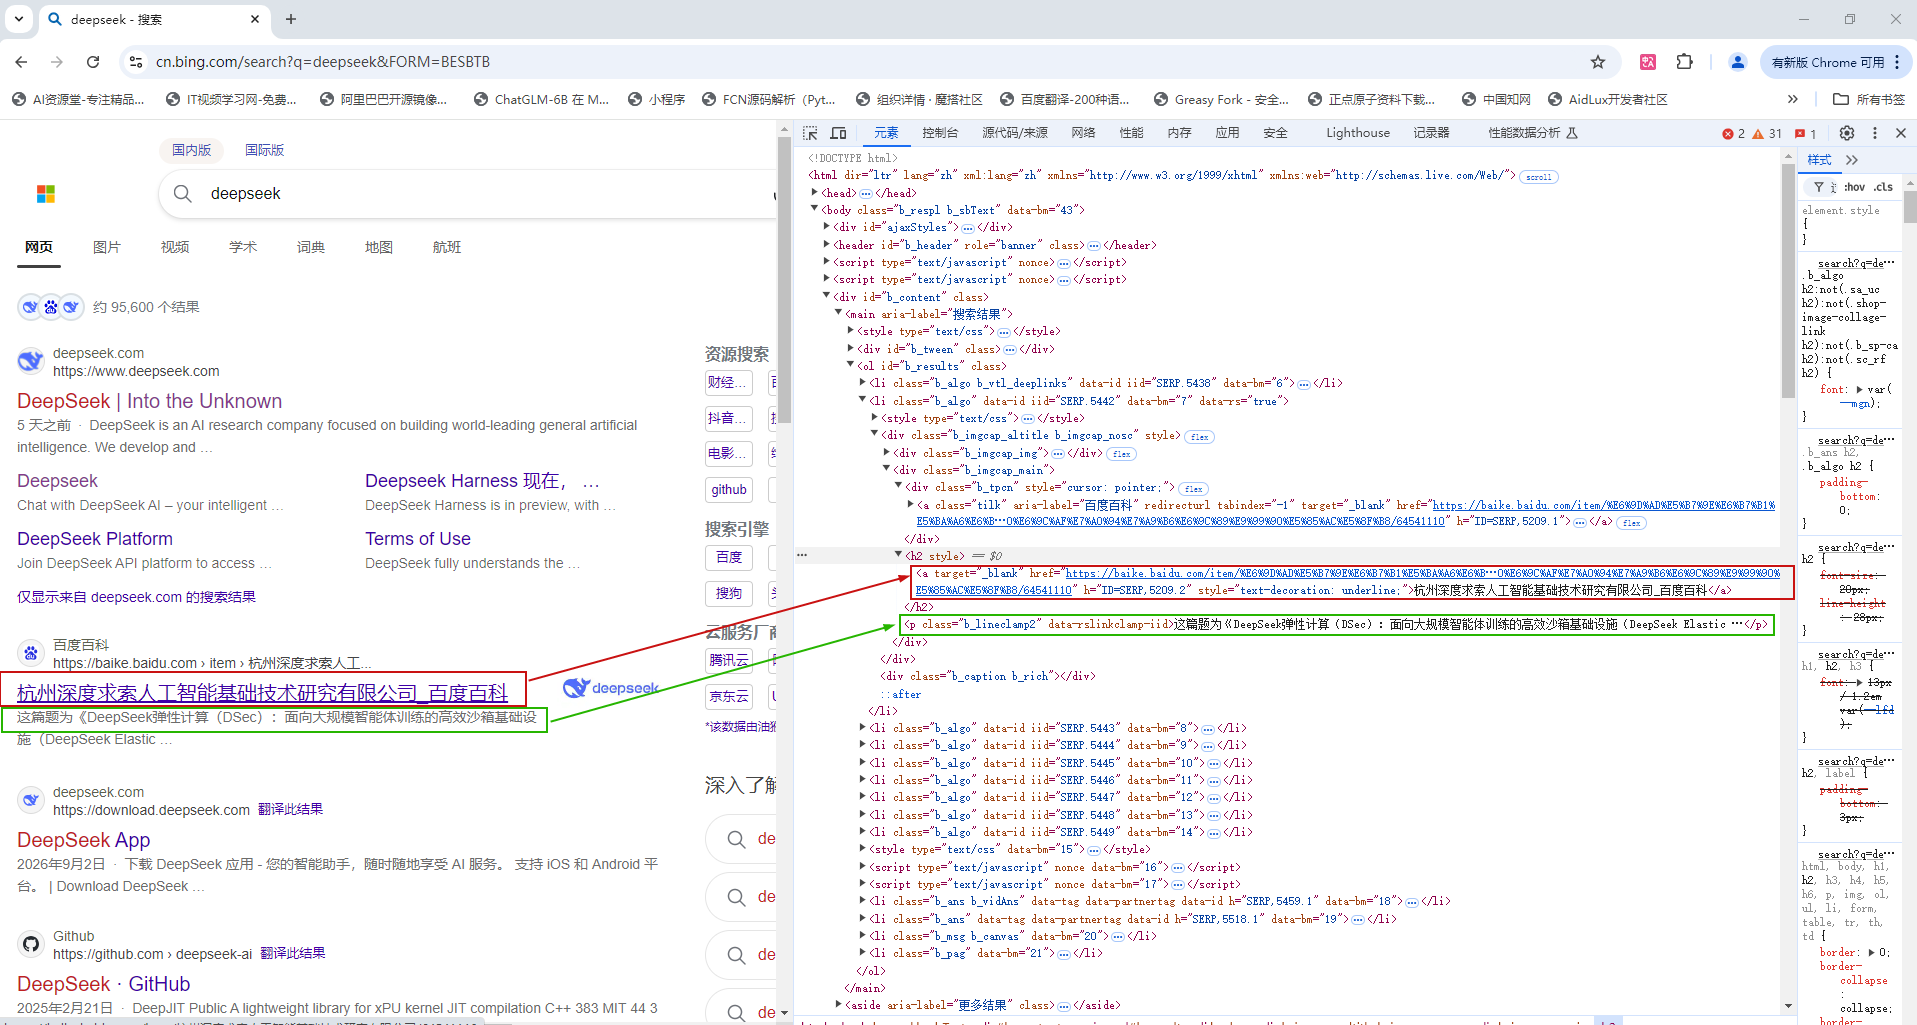
2、基于httpx+bs4+正则实现bing搜索引擎检索数据
安装相关的依赖包:
python
uv add httpx beautifulsoup4app/domain/models/search.py
python
#!/usr/bin/env python
# -*- coding: utf-8 -*-
"""
@Time    : 2025/05/24 14:56
@Author  : thezehui@gmail.com
@File    : search.py
"""
from typing import Optional, List

from pydantic import BaseModel, Field


class SearchResultItem(BaseModel):
    """搜索结果条目数据模型"""
    url: str  # 搜索条目URL地址
    title: str  # 搜索条目标题
    snippet: str = ""  # 搜索条目简介


class SearchResults(BaseModel):
    """搜索结果数据模型"""
    query: str  # 用户的搜索词
    date_range: Optional[str] = None  # 日期检索范围
    total_results: int = 0  # 搜索结果条数
    results: List[SearchResultItem] = Field(default_factory=list)  # 搜索结果列表
app/infrastructure/external/search/bing_search.py
python
#!/usr/bin/env python
# -*- coding: utf-8 -*-
"""
@Time    : 2025/05/24 15:19
@Author  : thezehui@gmail.com
@File    : bing_search.py
"""
import logging
import re
import time
from typing import Optional

import httpx
from bs4 import BeautifulSoup

from app.domain.external.search import SearchEngine
from app.domain.models.search import SearchResults, SearchResultItem
from app.domain.models.tool_result import ToolResult

logger = logging.getLogger(__name__)


class BingSearchEngine(SearchEngine):
    """bing搜索引擎"""

    def __init__(self):
        """构造函数,完成bing搜索引擎初始化,涵盖基础URL、headers、cookies"""
        self.base_url = "https://www.bing.com/search"
        self.headers = {
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36 Edg/122.0.0.0",
            "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8",
            "Accept-Language": "en-US,en;q=0.5",
            "Accept-Encoding": "gzip, deflate",
            "Connection": "keep-alive",
            "Upgrade-Insecure-Requests": "1",
        }
        self.cookies = httpx.Cookies()

    async def invoke(self, query: str, date_range: Optional[str] = None) -> ToolResult[SearchResults]:
        """传递query+date_range使用httpx+bs4调用bing搜索并获取搜索结果"""
        # 1.构建请求参数
        params = {"q": query}

        # 2.判断date_range是否存在并提取真实检索数据
        if date_range and date_range != "all":
            # 3.获取当前日期的天数距离1970-01-01的天数
            days_since_epoch = int(time.time() / (24 * 60 * 60))

            # 4.创建日期检索数据类型映射
            date_mapping = {
                "past_hour": "ex1%3a\"ez1\"",
                "past_day": "ex1%3a\"ez1\"",
                "past_week": "ex1%3a\"ez2\"",
                "past_month": "ex1%3a\"ez3\"",
                "past_year": f"ex1%3a\"ez5_{days_since_epoch - 365}_{days_since_epoch}\""
            }

            # 5.判断是否传递了date_range补全params参数
            if date_range in date_mapping:
                params["filters"] = date_mapping[date_range]

        try:
            # 6.使用httpx创建异步客户端
            async with httpx.AsyncClient(
                    headers=self.headers,
                    cookies=self.cookies,
                    timeout=60,
                    follow_redirects=True,
            ) as client:
                # 7.调用客户端发起请求
                response = await client.get(self.base_url, params=params)
                response.raise_for_status()  # 校验状态

                # 8.更新cookie信息
                self.cookies.update(response.cookies)

                # 9.使用bs4解析html内容
                soup = BeautifulSoup(response.text, "html.parser")

                # 10.定义搜索结果并解析li.b_alog对应的dom元素
                search_results = []
                result_items = soup.find_all("li", class_="b_algo")

                # 11.循环遍历所有匹配的dom
                for item in result_items:
                    try:
                        # 12.定义变量存储数据
                        title, url = ("", "")

                        # 13.解析搜索结果中的标题与URL链接
                        title_tag = item.find("h2")
                        if title_tag:
                            a_tag = title_tag.find("a")
                            if a_tag:
                                title = a_tag.get_text(strip=True)
                                url = a_tag.get("href", "")

                        # 14.判断标题如果不存在提取该dom下的a标签
                        if not title:
                            a_tags = item.find_all("a")
                            for a_tag in a_tags:
                                # 15.提取标签中的文本并判断文本的长度是否超过10+不以http为开头
                                text = a_tag.get_text(strip=True)
                                if len(text) > 10 and not text.startswith("http"):
                                    title = text
                                    url = a_tag.get("href", "")
                                    break

                        # 16.如果两种查询方式都找不到title则跳过这次数据
                        if not title:
                            continue

                        # 17.提取检索数据的摘要信息
                        snippet = ""
                        snippet_items = item.find_all(
                            ["p", "div"],
                            class_=re.compile(r'b_lineclamp|b_descript|b_caption')
                        )
                        if snippet_items:
                            snippet = snippet_items[0].get_text(strip=True)

                        # 18.如果未找到摘要则查询所有p标签(段落标签)
                        if not snippet:
                            p_tags = item.find_all("p")
                            for p in p_tags:
                                text = p.get_text(strip=True)
                                if len(text) > 20:
                                    snippet = text
                                    break

                        # 19.如果还找不到摘要数据,则提取选项中的所有文本并使用常见的分隔符分割
                        if not snippet:
                            all_text = item.get_text(strip=True)
                            # 20.将所有文本分割成对应的句子,并循环遍历取出长度>20的句子
                            sentences = re.split(r'[.!?\n。!]', all_text)
                            for sentence in sentences:
                                clean_sentence = sentence.strip()
                                if len(clean_sentence) > 20 and clean_sentence != title:
                                    snippet = clean_sentence
                                    break

                        # 21.补全相对路径的url链接与缺失协议的部分
                        if url and not url.startswith("http"):
                            if url.startswith("//"):
                                url = "https:" + url
                            elif url.startswith("/"):
                                url = "https://www.bing.com" + url

                        # 22.如果标题和链接都存在则添加数据
                        search_results.append(SearchResultItem(
                            title=title,
                            url=url,
                            snippet=snippet,
                        ))

                    except Exception as e:
                        # 23.记录错误信息并继续解析
                        logger.warning(f"Bing搜索结果解析失败: {str(e)}")
                        continue

                # 24.提取整个页面的内容并查找`results`对应的文本
                total_results = 0
                result_stats = soup.find_all(string=re.compile(r"\d+[,\d+]\s*results"))
                if result_stats:
                    for stat in result_stats:
                        # 25.匹配出对应的数字分组
                        match = re.search(r"([\d,]+)\s*results", stat)
                        if match:
                            try:
                                # 26.取出匹配的分组内容,去除逗号转换为整型
                                total_results = int(match.group(1).replace(",", ""))
                                break
                            except Exception:
                                continue

                # 27.如果使用正则匹配找不到results(有可能是页面结构不一致)则使用新逻辑
                if total_results == 0:
                    # 28.使用类元素查找器
                    count_elements = soup.find_all(
                        ["span", "div", "p"],
                        class_=re.compile(r"sb_count|b_focusTextMedium")
                    )
                    for element in count_elements:
                        # 29.提取dom的文本并获取数字
                        text = element.get_text(strip=True)
                        match = re.search(r"([\d,]+)\s*results", text)
                        if match:
                            try:
                                total_results = int(match.group(1).replace(',', ''))
                                break
                            except Exception:
                                continue

                # 30.返回搜索结果
                results = SearchResults(
                    query=query,
                    date_range=date_range,
                    total_results=total_results,
                    results=search_results,
                )
                return ToolResult(success=True, data=results)
        except Exception as e:
            # 31.记录日志并返回错误工具调用结果
            logger.error(f"Bing搜索出错: {str(e)}")
            error_results = SearchResults(
                query=query,
                date_range=date_range,
                total_results=0,
                results=[],
            )
            return ToolResult(
                success=False,
                message=f"Bing搜索出错: {str(e)}",
                data=error_results,
            )


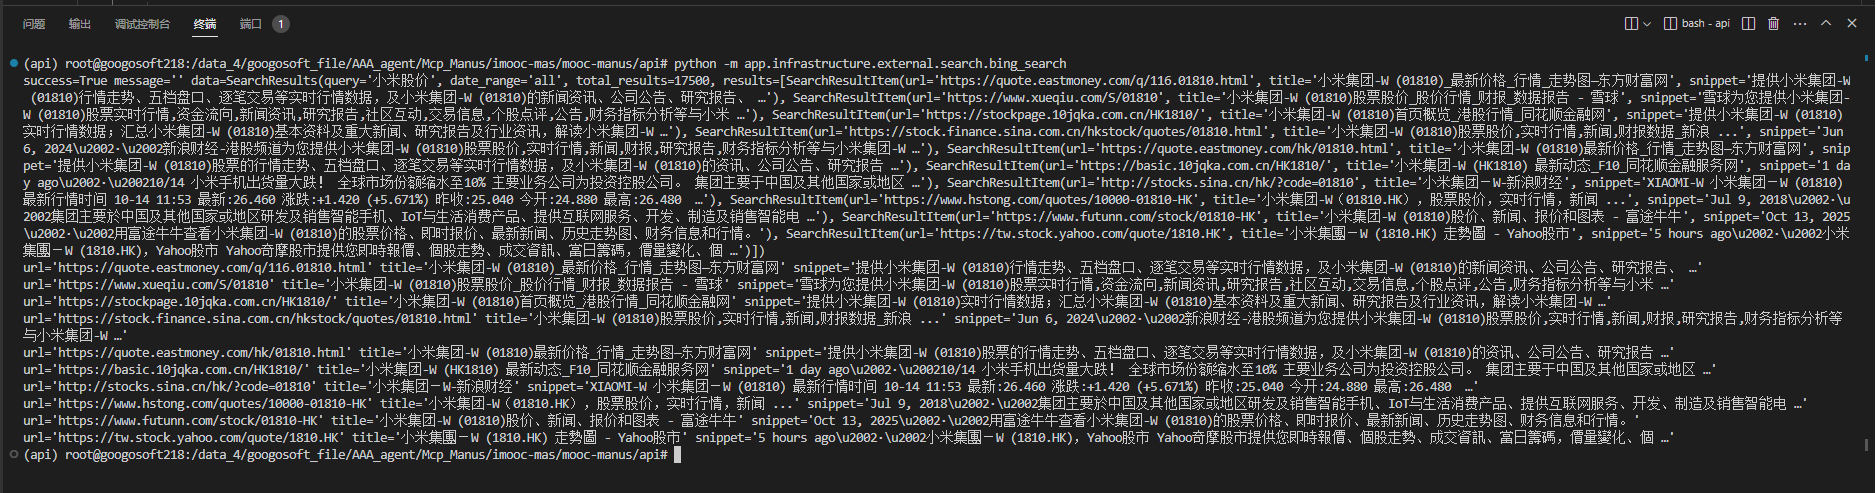
if __name__ == "__main__":
    import asyncio


    async def test():
        search_engine = BingSearchEngine()
        result = await search_engine.invoke("小米股价", "all")

        print(result)
        for item in result.data.results:
            print(item)


    asyncio.run(test())


"""

python -m app.infrastructure.external.search.bing_search
"""
3、MoocManus动态添加MCP服务器的设计思路
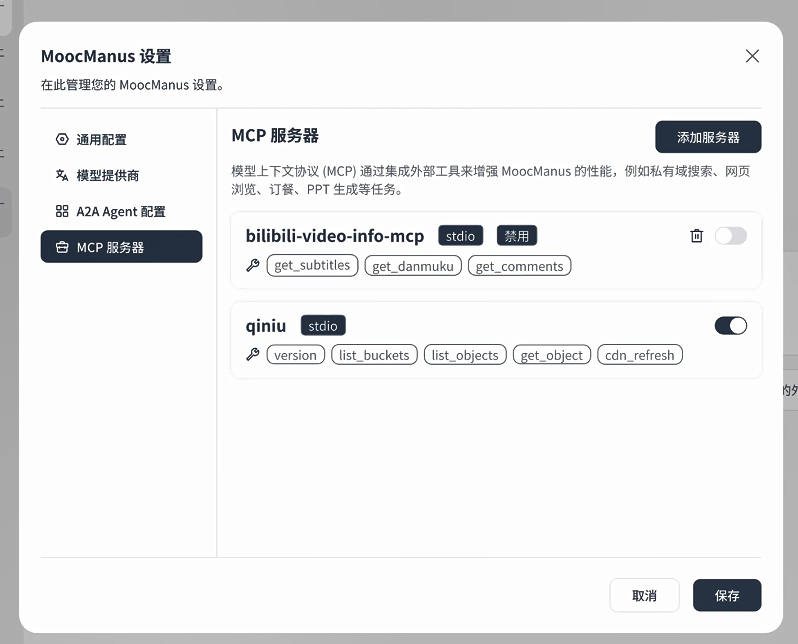
1. 将所有mcp_server_config存储到config.yaml
2. 从config.yaml中读取数据转换为json
3. 将json传递给mcp client manager(MCP客户端管理器)
4. 初始化mcp服务器的连接,同时获取对应的工具列表进行缓存
5. 当更新数据或者定时时间到了之后才清除缓存
6. 获取MCP服务器+工具列表接口,启用/禁用MCP工具、删除MCP服务、新增MCP服务
1、完善项目MCP配置模型的设计与定义
app/domain/models/app_config.py
python
class MCPTransport(str, Enum):
    """MCP传输类型枚举"""
    STDIO = "stdio"  # 本地输入输出
    SSE = "sse"  # 流式事件
    STREAMABLE_HTTP = "streamable_http"  # 流式HTTP


class MCPServerConfig(BaseModel):
    """MCP服务配置"""
    # 通用配置字段
    transport: MCPTransport = MCPTransport.STREAMABLE_HTTP  # 传输协议
    enabled: bool = True  # 是否开启,默认为True
    description: Optional[str] = None  # 服务器描述
    env: Optional[Dict[str, Any]] = None  # 环境变量配置

    # stdio配置
    command: Optional[str] = None  # 启用命令
    args: Optional[List[str]] = None  # 命令参数

    # streamable_http&sse配置
    url: Optional[str] = None  # MCP服务URL地址
    headers: Optional[Dict[str, Any]] = None  # MCP服务请求头

    model_config = ConfigDict(extra="allow")

    @model_validator(mode="after")
    def validate_mcp_server_config(self):
        """校验mcp_server_config的相关信息,包含url+command"""
        # 1.判断transport是否为sse/streamable_http
        if self.transport in [MCPTransport.SSE, MCPTransport.STREAMABLE_HTTP]:
            # 2.这两种模式需要传递url
            if not self.url:
                raise ValueError("在sse或streamable_http模式下必须传递url")

        # 3.判断transport是否为stdio类型
        if self.transport == MCPTransport.STDIO:
            # 4.stdio类型必须传递command
            if not self.command:
                raise ValueError("在stdio模式下必须传递command")

        return self


class MCPConfig(BaseModel):
    """应用MCP配置"""
    mcpServers: Dict[str, MCPServerConfig] = Field(default_factory=dict)

    model_config = ConfigDict(extra="allow", arbitrary_types_allowed=True)
2、动态增删改查MCP服务器API接口的设计与开发
app/domain/models/app_config.py
python
class MCPTransport(str, Enum):
    """MCP传输类型枚举"""
    STDIO = "stdio"  # 本地输入输出
    SSE = "sse"  # 流式事件
    STREAMABLE_HTTP = "streamable_http"  # 流式HTTP


class MCPServerConfig(BaseModel):
    """MCP服务配置"""
    # 通用配置字段
    transport: MCPTransport = MCPTransport.STREAMABLE_HTTP  # 传输协议
    enabled: bool = True  # 是否开启,默认为True
    description: Optional[str] = None  # 服务器描述
    env: Optional[Dict[str, Any]] = None  # 环境变量配置

    # stdio配置
    command: Optional[str] = None  # 启用命令
    args: Optional[List[str]] = None  # 命令参数

    # streamable_http&sse配置
    url: Optional[str] = None  # MCP服务URL地址
    headers: Optional[Dict[str, Any]] = None  # MCP服务请求头

    model_config = ConfigDict(extra="allow")

    @model_validator(mode="after")
    def validate_mcp_server_config(self):
        """校验mcp_server_config的相关信息,包含url+command"""
        # 1.判断transport是否为sse/streamable_http
        if self.transport in [MCPTransport.SSE, MCPTransport.STREAMABLE_HTTP]:
            # 2.这两种模式需要传递url
            if not self.url:
                raise ValueError("在sse或streamable_http模式下必须传递url")

        # 3.判断transport是否为stdio类型
        if self.transport == MCPTransport.STDIO:
            # 4.stdio类型必须传递command
            if not self.command:
                raise ValueError("在stdio模式下必须传递command")

        return self


class MCPConfig(BaseModel):
    """应用MCP配置"""
    mcpServers: Dict[str, MCPServerConfig] = Field(default_factory=dict)

    model_config = ConfigDict(extra="allow", arbitrary_types_allowed=True)
app/application/services/app_config_service.py
python
#!/usr/bin/env python
# -*- coding: utf-8 -*-
"""
@Time    : 2025/5/17 10:47
@Author  : thezehui@gmail.com
@File    : app_config_service.py
"""
import logging
import uuid
from typing import List

from app.application.errors.exceptions import NotFoundError
from app.domain.models.app_config import AppConfig, LLMConfig, AgentConfig, MCPConfig, A2AConfig, A2AServerConfig
from app.domain.repositories.app_config_repository import AppConfigRepository
from app.domain.services.tools.a2a import A2AClientManager
from app.domain.services.tools.mcp import MCPClientManager
from app.interfaces.schemas.app_config import ListMCPServerItem, ListA2AServerItem

logger = logging.getLogger(__name__)


class AppConfigService:
    """应用配置服务"""

    def __init__(self, app_config_repository: AppConfigRepository) -> None:
        """构造函数,完成应用配置服务的初始化"""
        self.app_config_repository = app_config_repository

    async def _load_app_config(self) -> AppConfig:
        """加载获取所有的应用配置"""
        return self.app_config_repository.load()

    async def get_llm_config(self) -> LLMConfig:
        """获取LLM提供商配置"""
        app_config = await self._load_app_config()
        return app_config.llm_config

    async def update_llm_config(self, llm_config: LLMConfig) -> LLMConfig:
        """根据传递的llm_config更新语言模型提供商配置"""
        # 1.获取应用配置
        app_config = await self._load_app_config()

        # 2.判断api_key是否为空
        if not llm_config.api_key.strip():
            llm_config.api_key = app_config.llm_config.api_key

        # 3.调用函数更新app_config
        app_config.llm_config = llm_config
        self.app_config_repository.save(app_config)

        return app_config.llm_config

    async def get_agent_config(self) -> AgentConfig:
        """获取Agent通用配置"""
        app_config = await self._load_app_config()
        return app_config.agent_config

    async def update_agent_config(self, agent_config: AgentConfig) -> AgentConfig:
        """根据传递的agent_config更新Agent通用配置"""
        # 1.获取应用配置
        app_config = await self._load_app_config()

        # 2.调用函数更新app_config
        app_config.agent_config = agent_config
        self.app_config_repository.save(app_config)

        return app_config.agent_config

    async def get_mcp_servers(self) -> List[ListMCPServerItem]:
        """获取MCP服务器列表"""
        # 1.获取当前应用配置
        app_config = await self._load_app_config()

        # 2.创建mcp客户端管理器,对配置信息不进行过滤
        mcp_servers = []
        mcp_client_manager = MCPClientManager(mcp_config=app_config.mcp_config)

        try:
            # 3.初始化mcp客户端管理器
            await mcp_client_manager.initialize()

            # 4.获取mcp客户端管理器的工具列表
            tools = mcp_client_manager.tools

            # 5.循环组装响应的工具格式
            for server_name, server_config in app_config.mcp_config.mcpServers.items():
                mcp_servers.append(ListMCPServerItem(
                    server_name=server_name,
                    enabled=server_config.enabled,
                    transport=server_config.transport,
                    tools=[tool.name for tool in tools.get(server_name, [])]
                ))
        finally:
            # 6.清除MCP客户端管理器的相关资源
            await mcp_client_manager.cleanup()

        return mcp_servers

    async def update_and_create_mcp_servers(self, mcp_config: MCPConfig) -> MCPConfig:
        """根据传递的数据新增或更新MCP配置"""
        # 1.获取应用配置
        app_config = await self._load_app_config()

        # 2.使用新的mcp_config更新原始的配置
        app_config.mcp_config.mcpServers.update(mcp_config.mcpServers)

        # 3.调用数据仓库完成存储or更新
        self.app_config_repository.save(app_config)
        return app_config.mcp_config

    async def delete_mcp_server(self, server_name: str) -> MCPConfig:
        """根据名字删除MCP服务"""
        # 1.获取应用配置
        app_config = await self._load_app_config()

        # 2.查询对应服务的名字是否存在
        if server_name not in app_config.mcp_config.mcpServers:
            raise NotFoundError(f"该MCP服务[{server_name}]不存在,请核实后重试")

        # 3.如果存在则删除字典中对应的服务
        del app_config.mcp_config.mcpServers[server_name]
        self.app_config_repository.save(app_config)
        return app_config.mcp_config

    async def set_mcp_server_enabled(self, server_name: str, enabled: bool) -> MCPConfig:
        """更新MCP服务的启用状态"""
        # 1.获取应用配置
        app_config = await self._load_app_config()

        # 2.查询对应服务的名字是否存在
        if server_name not in app_config.mcp_config.mcpServers:
            raise NotFoundError(f"该MCP服务[{server_name}]不存在,请核实后重试")

        # 3.如果存在则更新该MCP服务的启用状态
        app_config.mcp_config.mcpServers[server_name].enabled = enabled
        self.app_config_repository.save(app_config)
        return app_config.mcp_config

    async def create_a2a_server(self, base_url: str) -> A2AConfig:
        """根据传递的配置新增a2a服务器"""
        # 1.获取当前的应用配置
        app_config = await self._load_app_config()

        # 2.往数据中新增a2a服务(在新增之前其实可以检测下当前Agent是否存在)
        a2a_server_config = A2AServerConfig(
            id=str(uuid.uuid4()),
            base_url=base_url,
            enabled=True,
        )
        app_config.a2a_config.a2a_servers.append(a2a_server_config)

        # 3.调用数据仓库更新
        self.app_config_repository.save(app_config)
        return app_config.a2a_config

    async def get_a2a_servers(self) -> List[ListA2AServerItem]:
        """获取A2A服务列表"""
        # 1.获取当前的应用配置
        app_config = await self._load_app_config()

        # 2.构建a2a客户端管理器,对配置信息不过滤
        a2a_servers = []
        a2a_client_manager = A2AClientManager(app_config.a2a_config)

        try:
            # 3.初始化a2a客户端管理器
            await a2a_client_manager.initialize()

            # 4.获取Agent卡片列表
            agent_cards = a2a_client_manager.agent_cards

            # 5.组装响应结构
            for id, agent_card in agent_cards.items():
                a2a_servers.append(ListA2AServerItem(
                    id=id,
                    name=agent_card.get("name", ""),
                    description=agent_card.get("description", ""),
                    input_modes=agent_card.get("defaultInputModes", []),
                    output_modes=agent_card.get("defaultOutputModes", []),
                    streaming=agent_card.get("capabilities", {}).get("streaming", False),
                    push_notifications=agent_card.get("capabilities", {}).get("push_notifications", False),
                    enabled=agent_card.get("enabled", False),
                ))
        finally:
            # 6.清除客户端管理器资源
            await a2a_client_manager.cleanup()

        return a2a_servers

    async def set_a2a_server_enabled(self, a2a_id: str, enabled: bool) -> A2AConfig:
        """根据传递的id+enabled更新服务启用状态"""
        # 1.获取当前的应用配置
        app_config = await self._load_app_config()

        # 2.计算需要更新位置的索引并判断是否存在
        idx = None
        for item_idx, item in enumerate(app_config.a2a_config.a2a_servers):
            if item.id == a2a_id:
                idx = item_idx
                break
        if idx is None:
            raise NotFoundError(f"该A2A服务[{a2a_id}]不存在,请核实后重试")

        # 3.如果存在则更新数据
        app_config.a2a_config.a2a_servers[idx].enabled = enabled
        self.app_config_repository.save(app_config)
        return app_config.mcp_config

    async def delete_a2a_server(self, a2a_id: str) -> A2AConfig:
        """根据传递的id删除指定的a2a服务"""
        # 1.获取当前的应用配置
        app_config = await self._load_app_config()

        # 2.计算需要操作位置的索引并判断是否存在
        idx = None
        for item_idx, item in enumerate(app_config.a2a_config.a2a_servers):
            if item.id == a2a_id:
                idx = item_idx
                break
        if idx is None:
            raise NotFoundError(f"该A2A服务[{a2a_id}]不存在,请核实后重试")

        # 3.删除a2a服务器
        del app_config.a2a_config.a2a_servers[idx]
        self.app_config_repository.save(app_config)
        return app_config.mcp_config
app/interfaces/endpoints/app_config_routes.py
python
@router.get(
    path="/mcp-servers",
    response_model=Response[ListMCPServerResponse],
    summary="获取MCP服务器工具列表",
    description="获取当前系统的MCP服务器列表,包含MCP服务名字、工具列表、启用状态等",
)
async def get_mcp_servers(
        app_config_service: AppConfigService = Depends(get_app_config_service),
) -> Response[ListMCPServerResponse]:
    """获取当前系统的MCP服务器工具列表"""
    mcp_servers = await app_config_service.get_mcp_servers()
    return Response.success(
        msg="获取mcp服务器列表成功",
        data=ListMCPServerResponse(mcp_servers=mcp_servers)
    )


@router.post(
    path="/mcp-servers",
    response_model=Response[Optional[Dict]],
    summary="新增MCP服务配置,支持传递一个或者多个配置",
    description="传递MCP配置信息为系统新增MCP工具",
)
async def create_mcp_servers(
        mcp_config: MCPConfig,
        app_config_service: AppConfigService = Depends(get_app_config_service),
) -> Response[Optional[Dict]]:
    """根据传递的配置信息创建mcp服务"""
    await app_config_service.update_and_create_mcp_servers(mcp_config)
    return Response.success(msg="新增MCP服务配置成功")


@router.post(
    path="/mcp-servers/{server_name}/delete",
    response_model=Response[Optional[Dict]],
    summary="删除MCP服务配置",
    description="根据传递的MCP服务名字删除指定的MCP服务",
)
async def delete_mcp_server(
        server_name: str,
        app_config_service: AppConfigService = Depends(get_app_config_service),
) -> Response[Optional[Dict]]:
    """根据服务名字删除MCP服务器"""
    await app_config_service.delete_mcp_server(server_name)
    return Response.success(msg="删除MCP服务配置成功")


@router.post(
    path="/mcp-servers/{server_name}/enabled",
    response_model=Response[Optional[Dict]],
    summary="更新MCP服务的启用状态",
    description="根据传递的server_name+enabled更新指定MCP服务的启用状态",
)
async def set_mcp_server_enabled(
        server_name: str,
        enabled: bool = Body(..., embed=True),
        app_config_service: AppConfigService = Depends(get_app_config_service),
) -> Response[Optional[Dict]]:
    """根据传递的server_name+enabled更新服务的启用状态"""
    await app_config_service.set_mcp_server_enabled(server_name, enabled)
    return Response.success(msg="更新MCP服务启用状态成功")
3、MCP客户端管理器的开发需求与设计思路
python
"""
MCP客户端管理器的开发思路:
1.在Agent执行的过程中,有可能需要调用多次工具,
  但是因为MCP工具的每次获取都需要调用客户端会话的list_tools()方法,
  非常耗时, 所以需要我们缓存工具的参数信息, 只有在初始化的时候才调用一次,
  并且在销毁MCP客户端管理器的时候一并清除;
2.在前端UI交互中, 无论MCP服务是否启动, 都会显示工具列表信息,
  但是在Agent执行的过程中, 我们只会传递已启动的MCP服务,
  所以对于MCP客户端管理器来说, 可以根据接收的MCP配置的差异加载不同的服务器,
  而不是仅从配置文件中读取数据;
3.MCP客户端管理器会同时管理多个MCP服务, 有可能有stdio、sse、streamable_http等传输协议.
  需要根据传输协议的不同来创建客户端会话(ClientSession), 同时缓存会话;
4.另外有可能有一些环境变量是存储在我们整个系统中的, 在初始化MCP服务的时候,需要将传递进来的
  环境变量与系统的环境变量进行合并后传递给MCP服务;
5.使用AsyncExitStack异步上下文管理器来管理上下文,避免使用with多层嵌套;
6.MCPClientManager的初始化非常耗时, 所以需要有机制可以判断避免重复初始化;
7.由于config.yaml是直接暴露在项目中的, 所以在使用config.yaml进行初始化的时候必须二次校验;
8.同时缓存ClientSession+Tool-Schema, 一个是客户端会话, 一个是工具参数声明;
9.MCP客户端管理器在清除/停止使用的时候, 必须关闭异步上下文管理器、清除资源(ClientSession、Tool-Schema)、
  初始化标识等, 从而避免资源泄露;
"""