随着工业互联网、能源数字化、智能制造这些业务一波接一波地落地,一个很现实的问题摆在了越来越多企业面前:设备监测、电力采集、生产过程指标......这些时序数据的规模,正在以肉眼可见的速度往上翻。
对一套长期运行的业务系统来说,时序数据库要解决的事情远不止"写得进、查得快"这么简单。实时写入和查询只是及格线,真正的难点在于------海量历史数据要长期存得下、要的时候还得快速加载出来,而且管理成本不能失控。数据是按天、按月、按年持续积累的,今天省下的每一 GB,三五年后就是一笔可观的真金白银。
针对工业场景下时序数据规模大、增长快、保存周期长这几个突出特点,金仓时序数据库围绕存储压缩、历史数据快速插入以及时序数据组织优化持续打磨能力,帮助企业实现海量时序数据更低成本存储、更高效率处理。
高效压缩:降低海量时序数据存储成本
先看一个很典型的场景:智能电表。每块电表按固定周期上报读数,相邻两个时间点之间的数值变化往往非常小------电压稳的时候,前后两条记录可能几乎一模一样。时间戳更是如此,采集周期固定,时间戳本身就是一条等差数列。
问题就出在这里。如果按传统行式存储的方式,一条记录一条记录地存,这些高度重复的信息会被原封不动地写进磁盘,一遍又一遍。单看一条记录浪费不多,但乘以百万级观测点、乘以 365 天不间断采集,存储成本就开始滚雪球了。
针对时间序列数据自身的这些规律,金仓时序数据库对存储引擎做了针对性优化,核心思路是"顺着数据的规律存,而不是跟规律对着干":
- Delta-of-Delta 差值编码:对等差的时间戳做二次差分,绝大部分结果直接归零,最终只需要存储极少的差值信息,时间戳列的体积可以压缩到原来的几十分之一;
- Gorilla XOR 压缩:相邻两个浮点值做异或运算,高位大部分相同,真正有差异的只有中间一小段有效位,只存这一段就够了------这正是 Facebook 在 Gorilla 论文中验证过的思路,特别适合变化平缓的传感器数值;
- 字典编码:设备编号、测点名称、状态标签这类大量重复的字符串,只存一份字典,数据行里放个短编号即可;
- 列式存储优化:同一列的数据类型和取值模式高度一致,压缩算法有了更大的发挥空间,也为后续的聚合分析铺好了路。
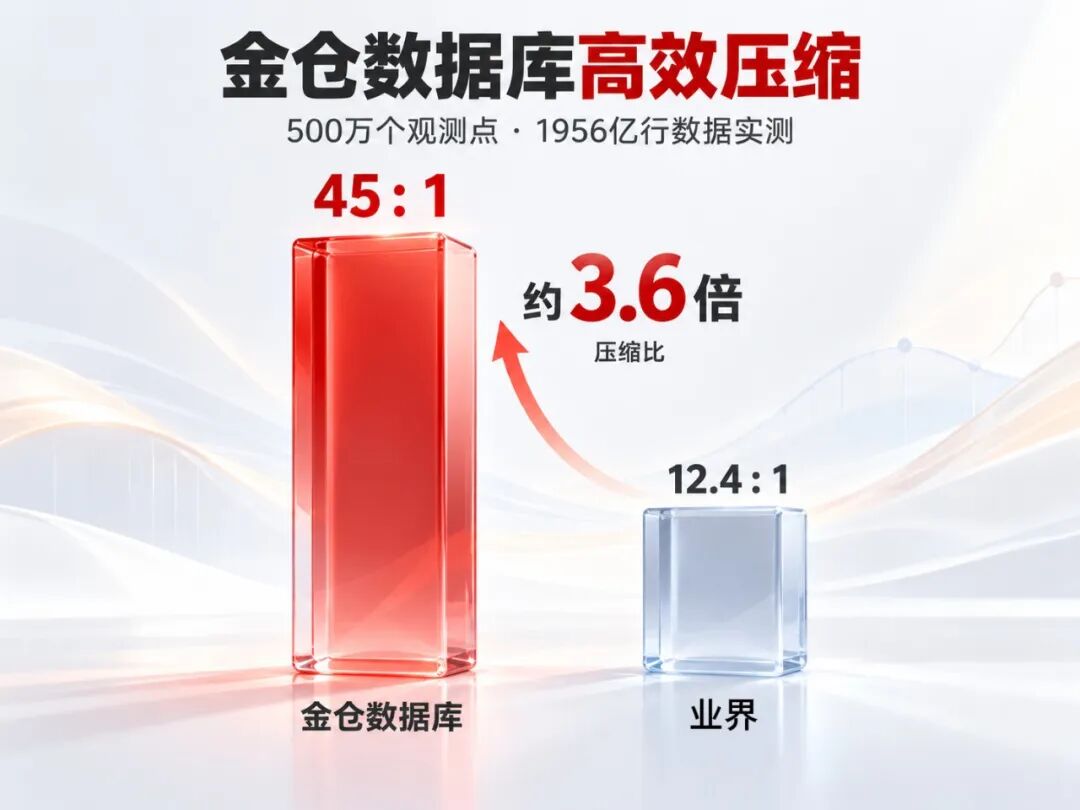
这些技术叠在一起,效果最终要靠实测说话。在某省智能电表场景中,金仓时序数据库针对 500 万个观测点、一年累计 1956 亿行 数据进行了验证,实测压缩比高达 45:1 ,约为业界水平(12.4:1)的 3.6 倍。同样的历史数据,别人要占 45 份空间,这里只占 1 份,存储成本的差距就是这么拉开的。
快速写入:提升历史数据加载效率
压缩解决的是"存得下",但还有一个经常被低估的环节------历史数据怎么搬进来。
在系统升级、数据迁移、数据平台建设以及智能分析应用落地的过程中,企业经常需要把多年积累的历史数据,整体加载到新的数据环境里。这不是个小活儿:动辄 TB 级甚至更大的数据量,传统"一条一条 INSERT"的导入方式,会同时撞上好几堵墙------每条写入都要维护索引、刷写日志,写入路径过长;数据组织方式不合理时,还会造成写入热点,越写越慢。数据准备周期一长,业务上线和数据应用的节奏就全被拖住了。
针对这个场景,金仓时序数据库优化了历史数据快速插入能力:面向时序场景重写了写入路径,围绕批量数据组织、索引构建方式等关键环节做减法,让大规模历史数据批量加载尽量"走直线",避免不必要的开销。
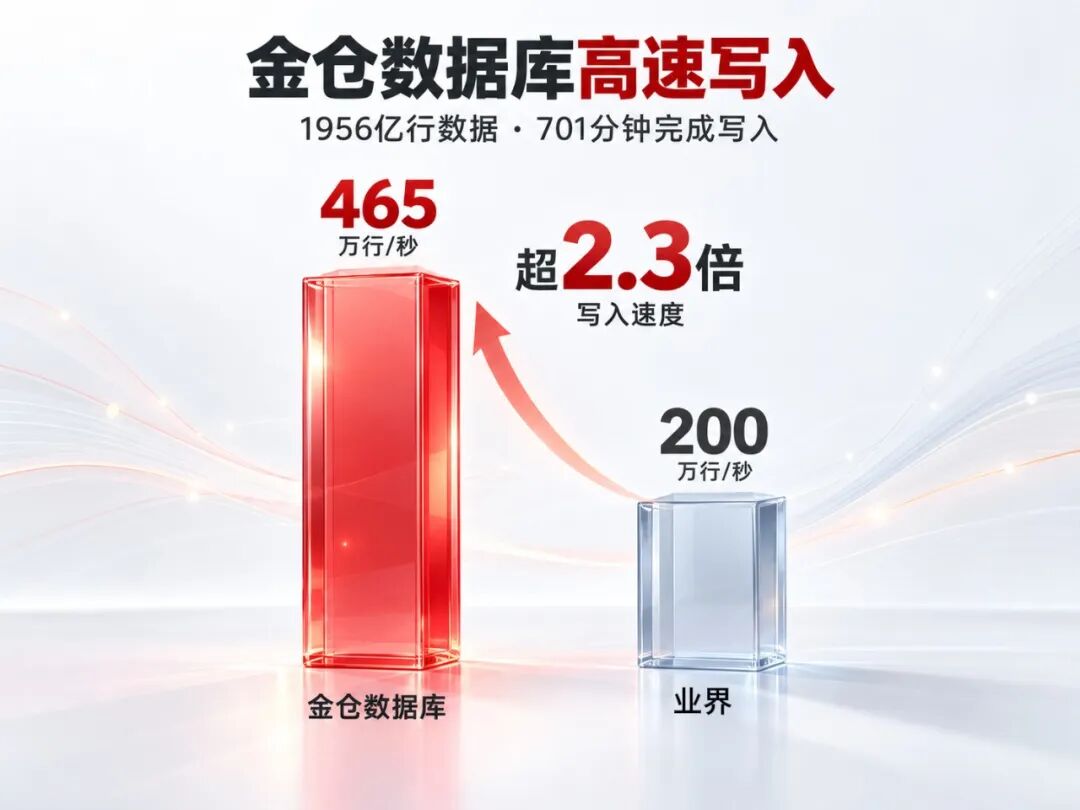
实测结果是在分布式部署环境下完成的:1956 亿行 数据全部写入仅耗时 701 分钟 ,平均写入速度达到 465 万行/秒 ,约为业界水平(200 万行/秒)的 2.3 倍以上。换算一下,近 2000 亿行的历史包袱,一个晚上出头就能搬运完毕------对正在做平台迁移或数据升级的团队来说,这意味着原本按周规划的"数据准备期"可以直接砍掉一大截。
时序优化:提升海量数据管理效率
写进来了、存下来了,第三个问题是:这么多数据,该怎么"摆放"?
工业场景的时序数据还有几个鲜明的特点:设备数量多、采样频率高、时间跨度长。一张表里躺着几百万个测点、横跨几年的数据,如果只是简单地堆在一起,每次查询都要在海量无关数据里翻找,效率可想而知。如何针对时间序列的特点去组织数据,直接决定了数据库的处理效率上限。
针对时序数据特征,金仓时序数据库提供了面向时序场景优化的数据组织方式------时序超表机制。它把一张逻辑上的大表,按时间和设备维度自动切分成若干 manageable 的数据块,写入时自动路由到对应分片,查询时根据时间范围先做裁剪、只扫描真正需要的数据块,运维侧也无需手工设计和维护分区策略。
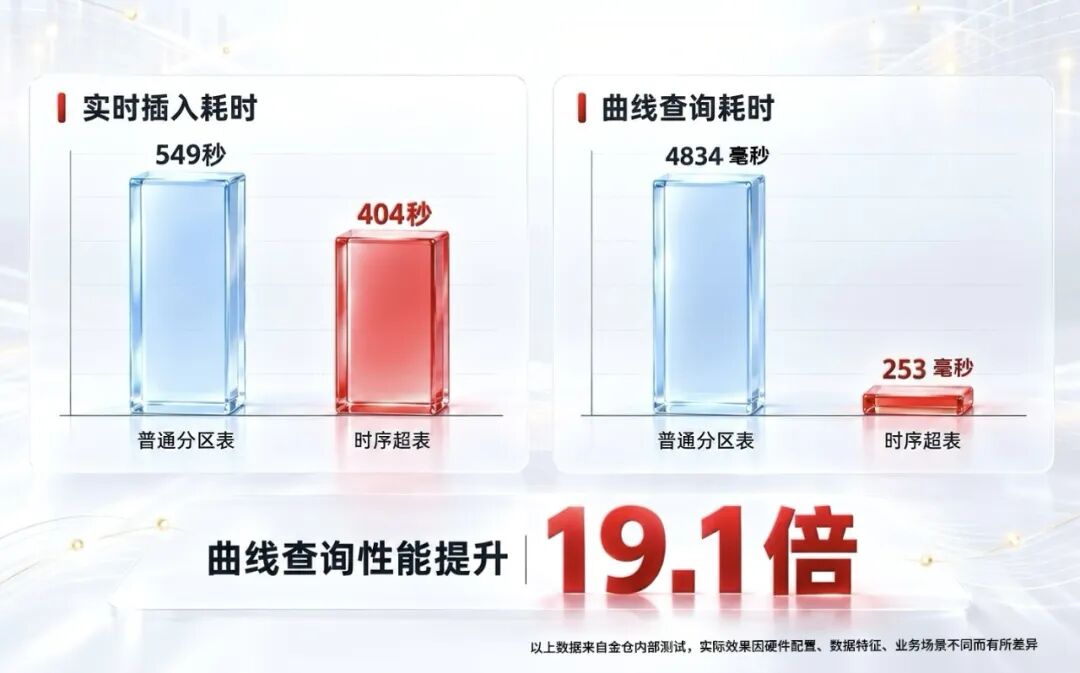
光说机制不够,直接看对比。在同等数据规模和表结构条件下,金仓时序超表相比普通分区表,在实时插入和典型查询场景中均表现出更高效率:
- 实时插入场景:时序超表耗时 404 秒,普通分区表耗时 549 秒;
- 曲线查询场景 :时序超表耗时 253 毫秒,普通分区表耗时 4834 毫秒,性能提升 19.1 倍。
尤其是曲线查询那 19.1 倍的差距------在设备故障回溯、生产异常分析这类需要反复拉取历史曲线的场景里,这个差距是工程师能实打实体感到的:一个是"秒回",一个要"干等"。
写在最后
随着企业数字化建设不断深入,时序数据正在成为支撑业务分析、设备运维和智能决策的重要数据资源。面对持续增长的数据规模,企业需要的绝不只是一个"能快速写入"的数据库,更是一套能够长期承载海量数据、高效管理历史数据的数据基础设施。
金仓时序数据库通过高效压缩、历史数据快速插入以及时序场景优化三大能力,帮助企业降低海量数据存储成本、提高数据加载效率,让持续增长的时序数据真正高效地服务于业务------而不是变成报表角落里一条不断膨胀的成本曲线。