FastSAM 论文详解:方法与实验
论文:Fast Segment Anything (arXiv:2306.12156)
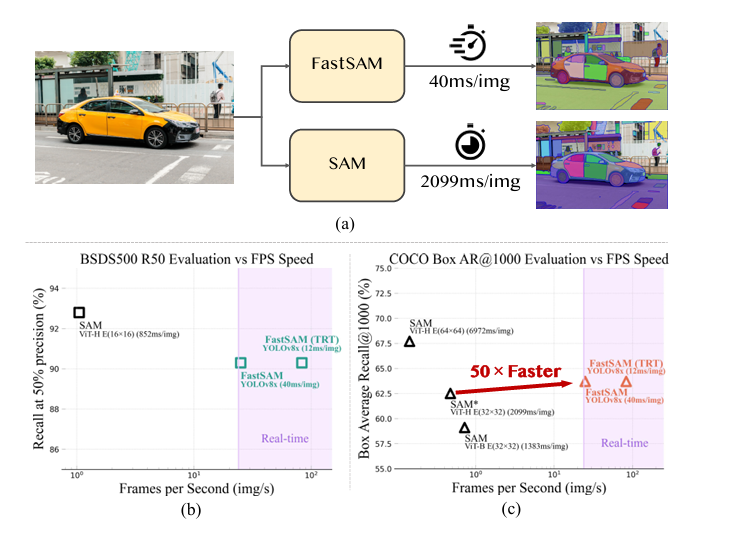
FastSAM提出"先全实例分割、后提示筛选"的两阶段框架,以YOLOv8-seg替代SAM的端到端Transformer,实现68M参数、40ms推理速度(50×加速),且不受提示数量影响。通过原型加权机制高效生成Mask,结合CLIP实现文本提示,虽在小目标分割上略逊于SAM,但显著降低训练成本与部署门槛。该方法验证了专用轻量模型在效率与实用性上的优势。
一、核心思想
FastSAM 的核心洞察是:"Segment Anything" 任务可以解耦为两个顺序阶段 :
┌─────────────────────┐      ┌─────────────────────────┐
│  Stage 1: 全实例分割  │  →   │  Stage 2: 提示引导选择   │
│  (All-instance      │      │  (Prompt-guided        │
│   Segmentation)     │      │   Selection)           │
└─────────────────────┘      └─────────────────────────┘
这与 SAM 的端到端思路截然不同:
- SAM:图像 + Prompt 同时输入 Transformer → 直接输出 Mask
- FastSAM :先用 CNN 检测器一次性分割出图中所有实例 → 再用 Prompt 做后处理筛选
二、方法详解
2.1 第一阶段:All-instance Segmentation(全实例分割)
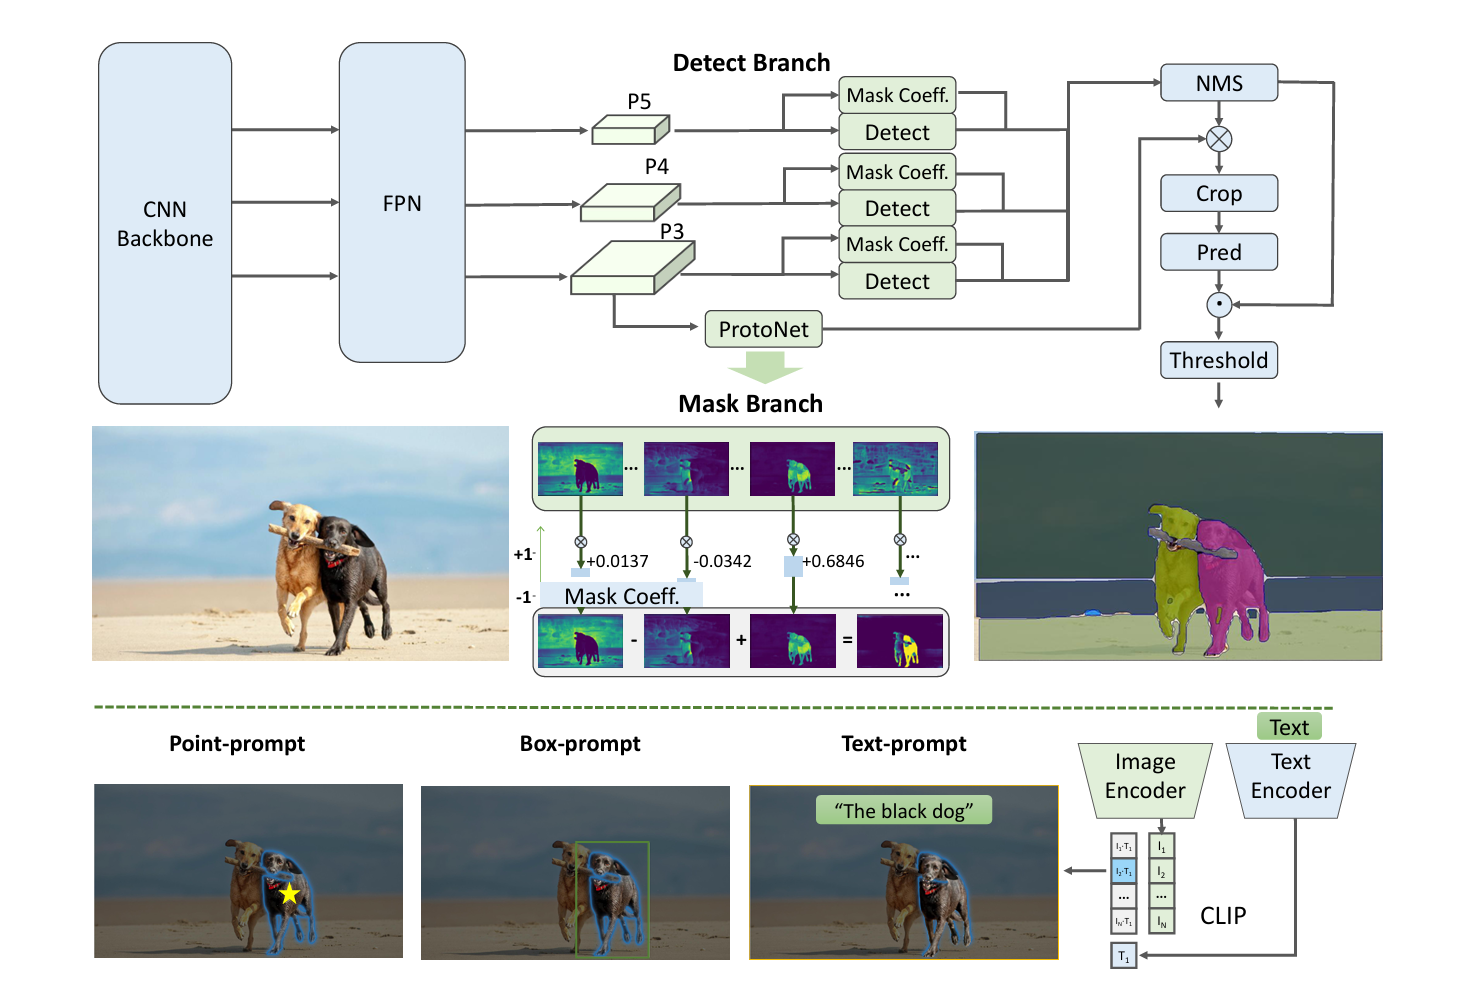
基座模型:YOLOv8-seg(带实例分割分支的 YOLOv8)
架构组成:
- CNN Backbone:提取多尺度特征
- FPN(Feature Pyramid Network):融合不同尺度特征
- Detect Branch:输出类别 + 边界框
- Mask Branch :基于 YOLACT 原理输出实例掩膜
YOLACT 分割机制(关键):
YOLOv8-seg 的分割分支输出两部分:
- k 个原型Mask(Prototypes):由 ProtoNet 生成,是图像级别的"基础mask模板"
- k 个 Mask 系数(Mask Coefficients):每个检测框对应一组系数,范围在 -1, 1
最终实例 Mask 的计算:
Instance Mask = Σ (Mask_Coefficient_i × Prototype_i)即:用系数对原型做加权线性组合,得到每个实例的最终分割掩膜。
这种设计的优势是计算高效:不需要逐个实例做昂贵的 Mask Head 前向传播,只需一次原型生成 + 系数加权。
2.2 第二阶段:Prompt-guided Selection(提示引导选择)
在获得所有实例 Mask 后,根据用户提示筛选目标:
| Prompt 类型 | 筛选机制 |
|---|---|
| Point(点) | 判断点落在哪个 Mask 区域内;支持前景点(保留)+ 背景点(过滤)组合;多个 Mask 可合并 |
| Box(框) | 计算 Prompt 框与每个实例检测框的 IoU,选 IoU 最高的 |
| Text(文本) | 用 CLIP 提取文本 Embedding;将每个 Mask 区域送入 CLIP 图像编码器提取特征;选相似度最高的 |
Text Prompt 的特别处理:
- FastSAM 不需要像 SAM 那样修改训练流程来支持文本
- 推理时直接用预训练 CLIP 做文本-图像匹配即可
- 缺点:每个 Mask 区域都要单独过 CLIP,速度较慢
三、与 SAM 的本质区别
| 维度 | SAM | FastSAM |
|---|---|---|
| 架构 | ViT Transformer 端到端 | CNN 检测器(YOLOv8)两阶段 |
| 参数 | 600M+(ViT-H) | 68M |
| 速度 | 2099ms(Everything 32×32) | 40ms (50× 加速) |
| 训练数据 | SA-1B 全量(11M 图像) | SA-1B 的 2%(约 1/50) |
| Prompt 处理 | 与图像一起编码,端到端学习 | 后处理筛选预生成的实例 |
| Everything 模式 | 需要密集网格点提示,速度随点数增加 | 一次性生成所有实例,速度恒定 |
四、实验结果
4.1 运行效率(核心优势)
在单张 NVIDIA RTX 3090 上:
| 方法 | 参数量 | 1 point | 10 points | 100 points | Everything (32×32) |
|---|---|---|---|---|---|
| SAM-H | 600M | 446ms | 464ms | 627ms | 2099ms |
| SAM-B | 136M | 110ms | 125ms | 230ms | 1383ms |
| FastSAM | 68M | 40ms | 40ms | 40ms | 40ms |
关键发现 :FastSAM 的速度不随 prompt 数量变化,因为它总是先分割所有实例;而 SAM 的速度随 prompt 点数线性增长。
4.2 零样本边缘检测(BSDS500)
- FastSAM 先输出所有实例的 Mask 概率图
- 用 Sobel 滤波提取边缘
- 结果与 SAM 相当,R50 指标甚至略高
4.3 零样本目标提议生成(COCO / LVIS)
COCO Box AR@1000:
| 方法 | AR@1000 |
|---|---|
| SAM-H E64 | 67.7 |
| FastSAM | 63.7 |
| SAM-B E32 | 59.1 |
LVIS v1 Bbox AR@1000:
| 方法 | all | small | med. | large |
|---|---|---|---|---|
| ViTDet-H | 65.0 | 53.2 | 83.3 | 91.2 |
| FastSAM | 57.1 | 44.3 | 77.1 | 85.3 |
| SAM-H E64 | 52.1 | 36.6 | 75.1 | 88.2 |
FastSAM 在 bbox 提议上甚至超过了 SAM-H,这得益于 YOLO 检测器在边界框回归上的优势。
LVIS v1 Mask AR@1000:
| 方法 | all | small | med. | large |
|---|---|---|---|---|
| SAM-H E64 | 54.2 | 39.6 | 77.9 | 83.9 |
| FastSAM | 49.7 | 35.6 | 72.7 | 77.6 |
Mask 质量低于 SAM,尤其是小目标。
4.4 零样本实例分割(用 ViTDet 的框做 Prompt)
| 方法 | COCO AP | LVIS AP |
|---|---|---|
| SAM | 46.5 | 30.8 |
| FastSAM | 37.9 | 23.9 |
实例分割性能有明显差距,主要因为 Mask 精度不如 SAM。
4.5 实际应用场景
论文展示了多个下游任务:
- 异常检测(MVTec AD):Everything 模式接近 SAM,Point/Box 模式可精确选中缺陷区域
- 显著目标分割(ReDWeb-S):与 SAM 接近
- 建筑物提取(遥感图像):规则形状物体表现好,但阴影区域分割较少
- 文本提示分割:能根据 "The yellow dog" / "The black dog" 正确选择对应实例
五、优缺点总结
优势
- 速度极快:50× 于 SAM,且速度不受 prompt 数量影响
- 模型轻量:68M 参数,适合工业部署
- 训练成本低:仅用 SA-1B 的 2% 数据训练
- 即插即用:基于成熟的 YOLOv8 生态,易于集成
局限(论文坦诚指出)
- 小目标 Mask 质量差:Mask AR 在小目标上明显低于 SAM
- Mask 置信度不准:置信度来自 YOLO 的 bbox 分数,与 mask 质量关联不强
- 小物体 Mask 偏方形:YOLACT 原型组合的固有缺陷
- 大物体边界伪影:Mask 可能在 bbox 边界处出现 artifacts
- 文本 prompt 慢:每个 mask 要单独过 CLIP 提取特征
六、一句话总结
FastSAM 用"先全分割、后筛选"的两阶段策略替代了 SAM 的端到端 Transformer 方案,用 CNN 检测器(YOLOv8-seg)换来了 50 倍速度提升和 1/10 的模型大小,但在 Mask 精细度(尤其是小目标)上有所妥协。它证明了对于特定任务,引入人类先验(CNN 的局部归纳偏置)设计的专用模型,比通用大模型更具效率优势。