【C++】模板初阶
🔥 H.莓飛: 个人主页
✨ 心不畏死,踏屍前行。
📦 代码仓库:cocatrice_csdn_code
📖 博主简介:
概览
- 泛型编程:一套逻辑适配所有类型
- 函数模板的定义:class 与 typename 完全等价
- 模板不是函数:实例化之后才产生可调用的代码
- 两种实例化:调用处推导与写尖括号指定
- 编译器生成了什么:每个用到的类型一份符号
- 实参推导:推导不出来与推导冲突两种情形
- 匹配原则:非模板优先、更匹配的优先
- 类模板与非类型参数:类外定义要写全限定
核心知识
一、泛型编程的目标
同一段逻辑要在不同类型的对象上反复使用,这是写代码时最早撞上的一类重复。交换两个 int 需要一份函数,交换两个 double 需要再写一份,交换两个字符还要补一份,三份代码的语句一字不差,差别只在类型的名字上。按类型人工复制的代价落在维护上:任何一处逻辑修正都要在三份函数里各改一次,漏掉一份就留下行为不一致的分支,新增一个类型又要再复制一遍。
用 C 语言处理同一类问题的旧办法是把类型也一起传给函数,交换函数接收 void* 与一个字节长度,内部按字节整块搬运。这种写法编过之后类型信息就丢了,传错指针与传错长度都由运行期承担,出了问题只能靠打印字节逐个比对。C++ 的模板选了另一条路,类型的名字写在源码里,编译器在实例化时拿到完整的类型,所有检查在编译期做完,生成出来的代码与手写那一份的机器指令完全相同。
先看按类型复制的版本,三种类型各写一份交换函数,主函数里依次调用。
cpp
// 文件:/home/cocatrice/cpp07/exp01/swap_overload.cpp
#include <iostream>
using namespace std;

void Swap(int& left, int& right)
{
    int temp = left;
    left = right;
    right = temp;
}

void Swap(double& left, double& right)
{
    double temp = left;
    left = right;
    right = temp;
}

void Swap(char& left, char& right)
{
    char temp = left;
    left = right;
    right = temp;
}

int main()
{
    int a = 1, b = 2;
    double c = 1.1, d = 2.2;
    char e = 'x', f = 'y';

    Swap(a, b);
    Swap(c, d);
    Swap(e, f);

    cout << a << " " << b << endl;
    cout << c << " " << d << endl;
    cout << e << " " << f << endl;
    return 0;
}
编译运行之后三行输出分别来自三份重载函数。
三份重载函数摆在同一个文件里,编译器按实参类型各挑一份,调用形式与模板版没有任何区别。差别落在源码的维护上,这三份代码是手写的,新增一个类型就要再补一份,漏掉的时候调用点会落到隐式类型转换上,char 被当成 int 参与运算这类问题不报错,结果里悄悄体现出来。
text
# 所属目录:/home/cocatrice/cpp07/exp01
2 1
2.2 1.1
y x
把三段重复的语句换成一份模板写法,主函数里的调用形式没有任何变化,另外多调用了一种 long 类型,源码反而短了。
cpp
// 文件:/home/cocatrice/cpp07/exp01/swap_template.cpp
#include <iostream>
using namespace std;

template<class T>
void Swap(T& left, T& right)
{
    T temp = left;
    left = right;
    right = temp;
}

int main()
{
    int a = 1, b = 2;
    double c = 1.1, d = 2.2;
    char e = 'x', f = 'y';
    long g = 10, h = 20;

    Swap(a, b);
    Swap(c, d);
    Swap(e, f);
    Swap(g, h);

    cout << a << " " << b << endl;
    cout << c << " " << d << endl;
    cout << e << " " << f << endl;
    cout << g << " " << h << endl;
    return 0;
}
模板版的主函数多写了一行 long 的交换,所以运行结果是四行。
运行结果一致说明模板没有改变程序的行为,改动的是源码的组织方式:重复的语句收进一份定义,剩下的展开工作交给编译器在编译期完成。
text
# 所属目录:/home/cocatrice/cpp07/exp01
2 1
2.2 1.1
y x
20 10
行数的差距用 wc -l 量一把,模板版比三份重载少十行,比四份重载少二十行,类型越多这个差距越明显。
类型越多,两份源码的差距越明显,四种类型与三种类型的对照里模板版一直少一段重复的函数体,省下的部分正好是被复制的那几份。
text
# 所属目录:/home/cocatrice/cpp07/exp01
  39 swap_overload.cpp
  49 swap_overload4.cpp
  29 swap_template.cpp
 117 total
这套写法的正式名字叫泛型编程:编写的逻辑与具体类型无关,一套代码适配所有类型,模板是实现它的基础手段。模板往下分成两条支路,交换函数这种包装一段逻辑的叫函数模板,包装一个类的叫类模板,两者的写法差别在下一节展开。
标准库把这种写法铺满了整个库,容器与算法都写成模板,一份 vector 的实现同时服务于 int、double 与自定义的类,排序算法也只写一份就能处理所有可比较的类型。手写的模板与标准库里的模板在机制上没有区别,只是后者把类型参数、分配器与迭代器这些细节封装得更完整。模板的收益与它的代价落在同一处:类型信息在编译期全部展开,每个用到的类型都会得到一份独立的代码,目标文件里的符号数量也随之增加。
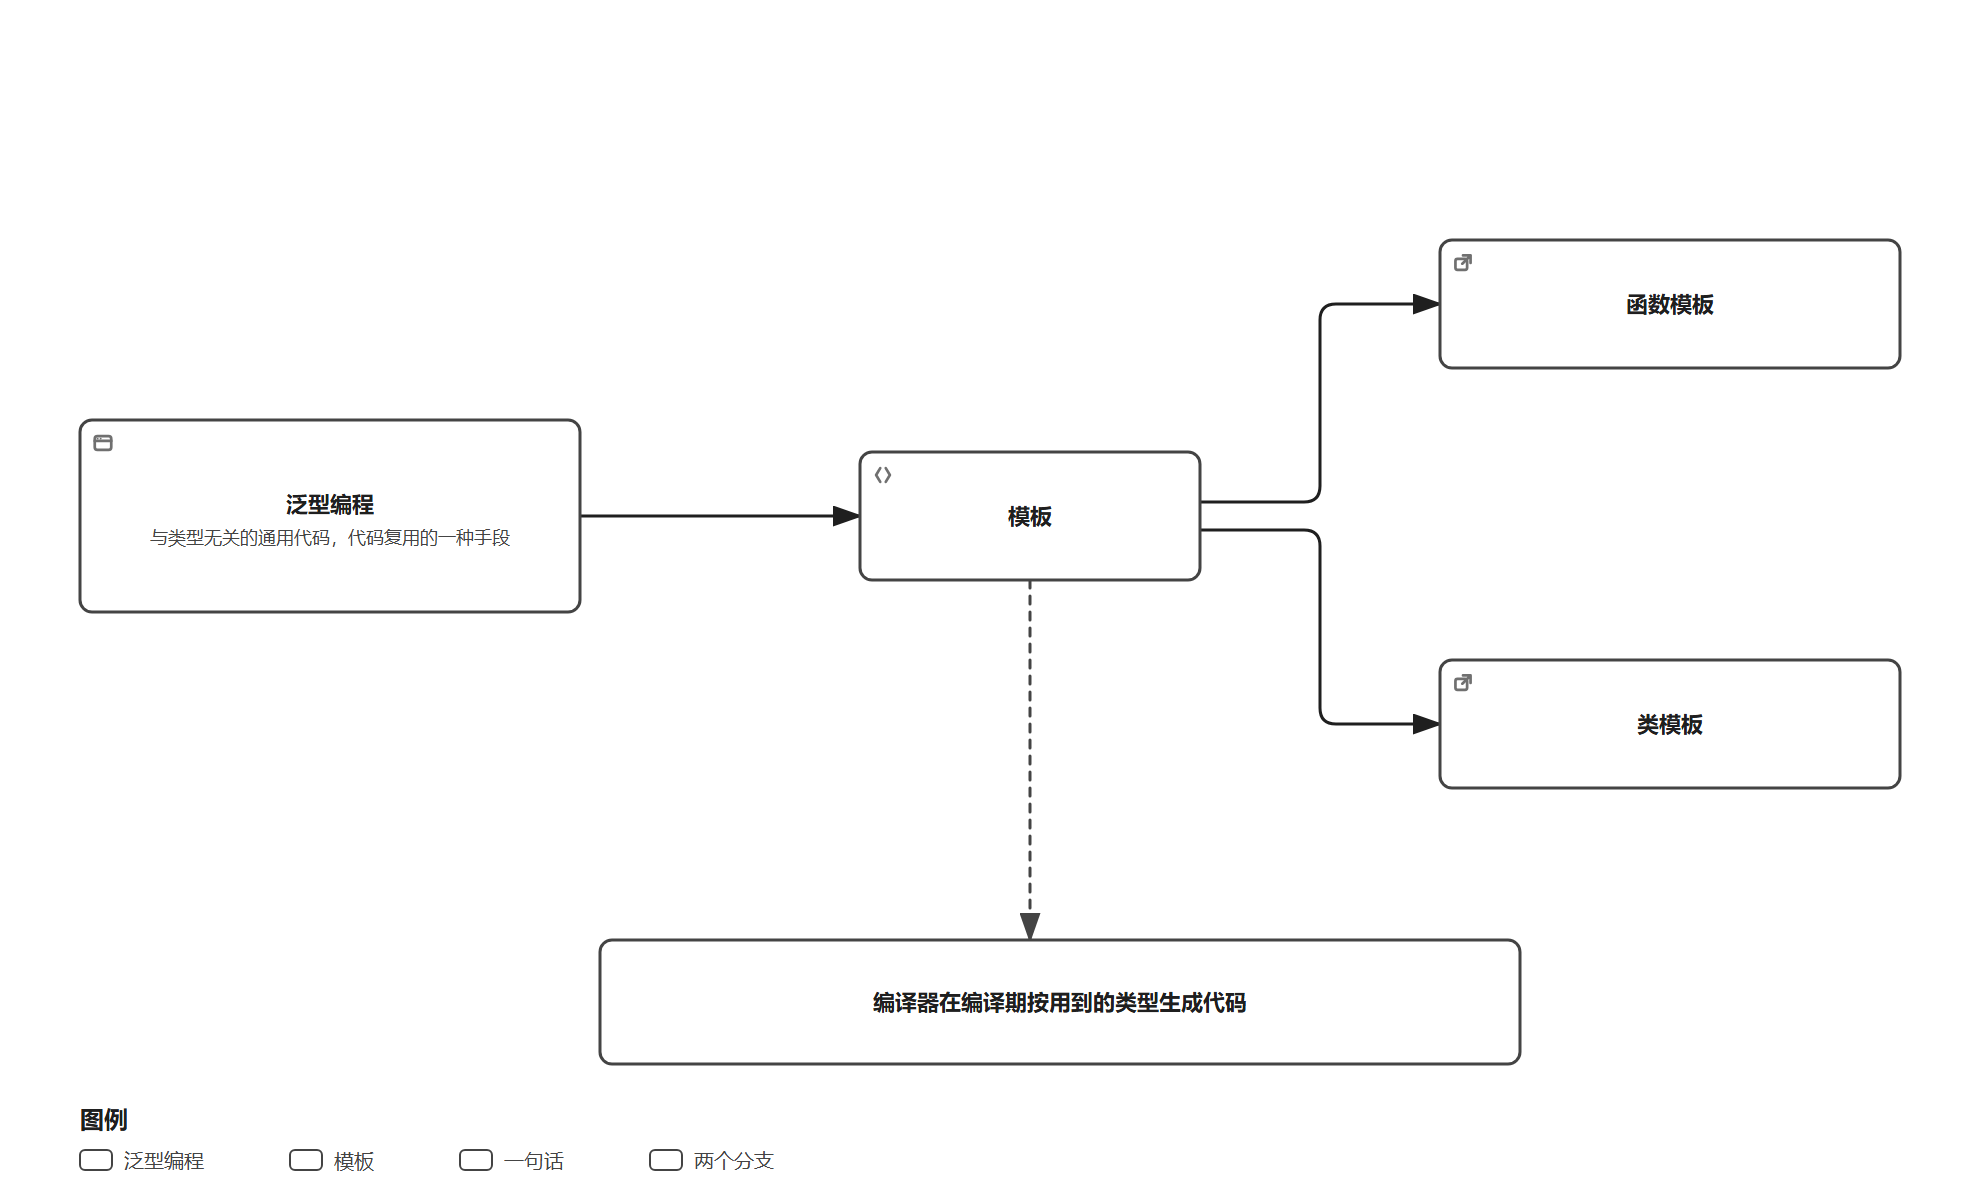
图 1 泛型编程与模板的两个分支
二、函数模板的定义
函数模板把类型本身也变成一个参数,写法是在普通函数定义的前面加一行 template 声明,尖括号里写模板参数列表。参数列表里的 T 只是一个习惯用的标识符,换成别的名字照样能编过,它代表的是调用时才会确定的类型。
模板参数列表与函数参数列表的位置很像,放在一起看更容易记住:函数参数列表把值交给函数使用,模板参数列表把类型交给编译器使用。尖括号里写几个参数由需要决定,一个模板可以同时带类型参数与值参数,中间用逗号分开。typename 与 class 在声明类型参数这件事上可以互换,名字习惯上取 T、U、V 这类单个大写字母,换成 Type 这样的长名字也完全合法,这一点与普通参数取什么名字无关是一样的。
cpp
// 文件:/home/cocatrice/cpp07/exp02/tpl_class.cpp
#include <iostream>
using namespace std;

template<class T>
T Add(const T& left, const T& right)
{
    return left + right;
}

int main()
{
    int a = 10, b = 20;
    double c = 1.5, d = 2.5;

    cout << Add(a, b) << endl;
    cout << Add(c, d) << endl;
    return 0;
}
同一份模板用 int 与 double 各调一次,两行输出说明一份代码被用在了两种类型上。
实例化发生在编译期,运行期不承担任何选择类型的开销,两行输出背后是两份各自独立的函数,调用指令直接指向对应的一份代码。
text
# 所属目录:/home/cocatrice/cpp07/exp02
30
4
template 后面跟的关键字有两种写法,class 与 typename 在声明类型参数这件事上完全等价,把两份源码放在一起比一比,差别只有第四行那一个词。
text
# 所属目录:/home/cocatrice/cpp07/exp02
4c4
< template<class T>
---
> template<typename T>
两个关键字写出来的模板编出来的结果一样,输出同样是两行。
text
# 所属目录:/home/cocatrice/cpp07/exp02
30
4
模板参数列表里可以写多个参数,下面的函数有两个类型参数,实参类型不同的时候两个参数各自推导,打印出来的内部类型名会不一样。
cpp
// 文件:/home/cocatrice/cpp07/exp02/tpl_two.cpp
#include <iostream>
#include <typeinfo>
using namespace std;

template<typename T1, typename T2>
void func(const T1& x, const T2& y)
{
    cout << "T1=" << typeid(T1).name() << " T2=" << typeid(T2).name()
         << " sizeof=" << sizeof(x) << "," << sizeof(y) << endl;
}

int main()
{
    int i = 1;
    double m = 1.1;
    char c = 'a';
    long l = 2L;

    func(i, m);
    func(i, i);
    func(c, l);
    return 0;
}
三次调用的实参类型组合各不相同,最后一行把 char 与 long 混着传了进去。
text
# 所属目录:/home/cocatrice/cpp07/exp02
T1=i T2=d sizeof=4,8
T1=i T2=i sizeof=4,4
T1=c T2=l sizeof=1,8
打印出来的 i、d、c、l 是编译器内部的类型名缩写,分别对应 int、double、char、long,后面两个数字是形参在那一份实例里的字节数。template 后面的关键字只有 class 与 typename 两个合法选择,写 struct 会被编译器当成非类型参数的声明来处理。
typename 这个词在模板参数列表里表示一个类型,在模板内部还有另一处必须使用它的位置:当类型名字依赖模板参数时,编译器默认把它当成一个值,需要在前面补上 typename 才能通过编译。模板参数列表里不允许写 struct,原因是 struct 出现在这里会被当作非类型参数的语法来解析,后面要求跟一个已经存在的类型名字,而 T 在此时还没有被定义,报错就落在这一行上。
text
# 所属目录:/home/cocatrice/cpp07/exp02
err_struct.cpp:1:17: error: 'struct T' is not a valid type for a template non-type parameter
 template<struct T>
                 ^
err_struct.cpp: In function 'void func(T)':
err_struct.cpp:2:6: error: 't' has incomplete type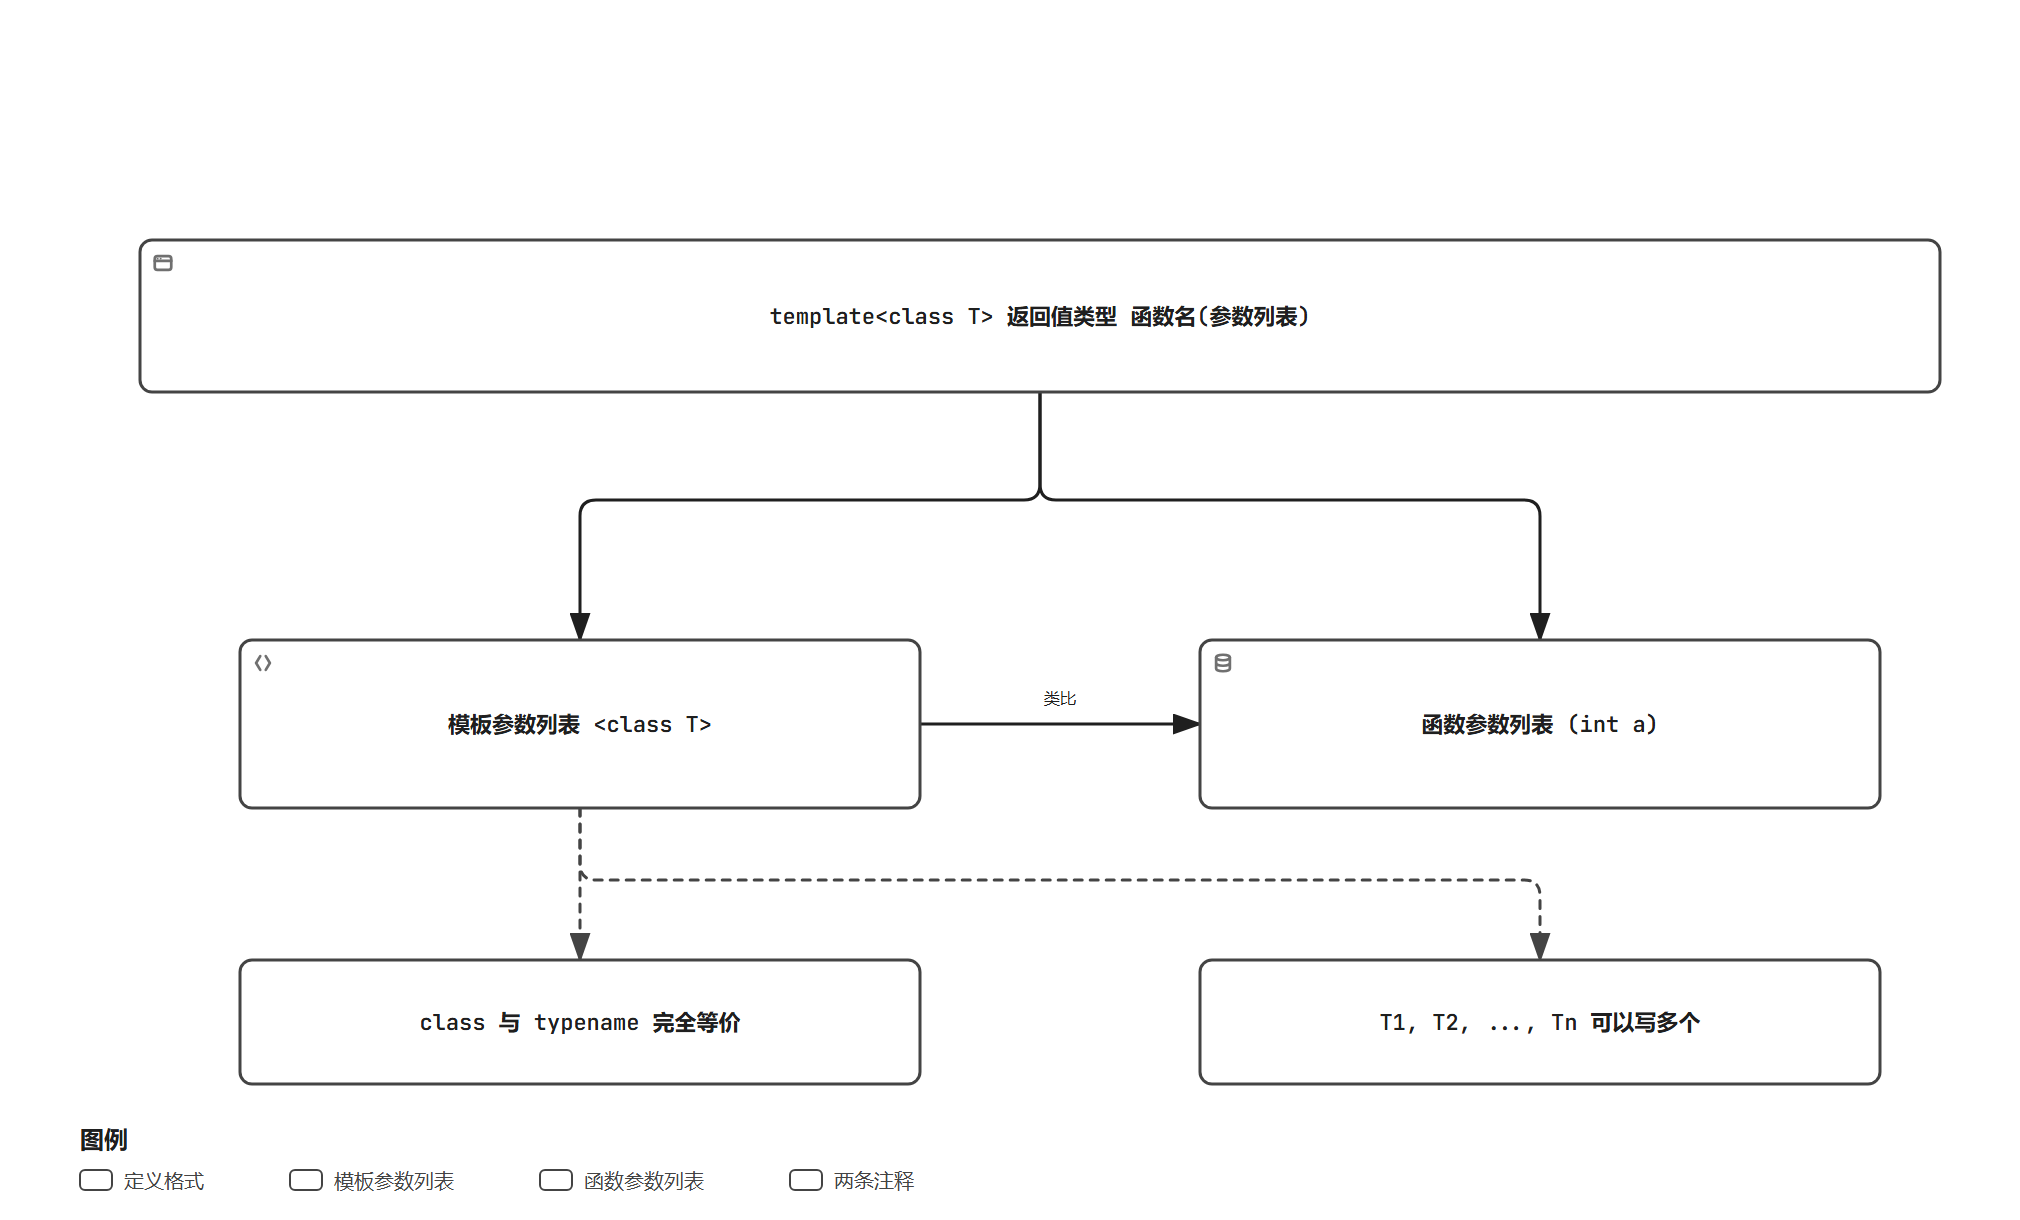
图 2 函数模板的定义格式与两处参数列表
三、模板不是函数
模板在编译期扮演的是图纸的角色,它本身不占据代码段里的一段可执行指令,只有被调用之后编译器才照着图纸生成一个真实存在的函数,这个过程叫实例化。判断一份模板到底有没有生成代码,看目标文件里的符号最直接:只定义不调用的模板,目标文件里连名字都找不到。
模板的定义既可以放在源文件里,也可以放在头文件里,但不能写在函数内部,局部作用域的模板在标准里没有合法形式。写模板时把它当成一份普通的声明来组织,位置放在文件作用域上,包含关系与普通函数保持一致。
编译器在模板正文上做的第一遍检查覆盖语法与不依赖模板参数的名字,依赖类型参数的部分要等到实例化时才检查,类型相关的问题在这一遍才浮出水面,这也解释了为什么一些写错的地方只有在调用之后才被编译器指出来。
cpp
// 文件:/home/cocatrice/cpp07/exp03/tpl_only.cpp
template<class T>
T Add(const T& left, const T& right)
{
    return left + right;
}
这份文件单独编译成目标文件之后,用 nm 查看符号清单,屏幕上什么都没有打印出来。
text
# 所属目录:/home/cocatrice/cpp07/exp03
-rw-rw-r-- 1 cocatrice cocatrice 944 Oct  6 17:54 tpl_only.o
同一个模板加上一次调用,符号清单里立刻多出一行弱符号,main 之后的那个 W 表示它的链接属性是弱符号,多个目标文件里出现同名的一份实例不会冲突。
弱符号的含义是允许同一个名字在多个目标文件里各出现一次,链接器遇到多个弱符号时保留其中一份,其余的被丢掉。模板的实例恰好满足这个条件:三份源文件各自调用 Add,每份目标文件都会生成一份同样的代码,按强符号处理就会在链接时立刻冲突,做成弱符号之后链接器静默合并,可执行文件里只留下一份。
cpp
// 文件:/home/cocatrice/cpp07/exp03/tpl_used.cpp
template<class T>
T Add(const T& left, const T& right)
{
    return left + right;
}

int main()
{
    int a = 10, b = 20;
    return Add(a, b);
}
text
# 所属目录:/home/cocatrice/cpp07/exp03
0000000000000000 T main
0000000000000000 W int Add<int>(int const&, int const&)
模板名也不能直接当成函数名去用,对模板名做 sizeof 与取地址都会被编译器拦下来,因为此时还无法确定要用哪一份实例。
模板名在表达式里代表的是这个名字下面的整组特化,编译器需要一个上下文才能从里面挑出具体的一个函数。写 sizeof(Add) 想要一个大小,写 &Add 想要一个地址,两种情况都得不出唯一的结果,编译器给出的说法是这一组重载函数缺少上下文类型信息。
text
# 所属目录:/home/cocatrice/cpp07/exp03
err_sizeof.cpp: In function 'int main()':
err_sizeof.cpp:9:19: error: ISO C++ forbids applying 'sizeof' to an expression of function type [-fpermissive]
  return sizeof(Add);
                   ^
取地址的报错换了一种说法,编译器把模板名当成一组同名的重载函数集合,没有上下文就选不出具体的那一个。
text
# 所属目录:/home/cocatrice/cpp07/exp03
err_addr.cpp: In function 'int main()':
err_addr.cpp:9:19: error: overloaded function with no contextual type information
  void* p = (void*)Add;
                   ^
把目标类型写清楚之后取地址就能通过,下面的代码用两种写法分别拿到函数指针,一次靠形参类型推导,一次直接写尖括号指定,两个指针比较的结果是相等的。
cpp
// 文件:/home/cocatrice/cpp07/exp03/ptr.cpp
#include <iostream>
using namespace std;

template<class T>
T Add(const T& left, const T& right)
{
    return left + right;
}

int main()
{
    int (*pf)(const int&, const int&) = Add;
    int (*pg)(const int&, const int&) = Add<int>;

    cout << pf(1, 2) << endl;
    cout << pg(3, 4) << endl;
    cout << (pf == pg) << endl;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/exp03
3
7
1
前两行分别是通过函数指针调用得到的结果,第三行的 1 表示 pf 与 pg 拿到的是同一份实例的地址,推导出来的类型与显式写出来的类型指向同一份代码。
函数指针能拿到模板实例的地址,说明实例化之后的模板与普通函数在链接层面没有区别,取地址、当参数传递、放进结构体里都可以按普通函数处理。指针相等的那次比较说明推导得到的实例与显式写出的实例是同一份,编译器不会为同一个类型生成两份代码,实例化的结果在整个翻译单元里共用。
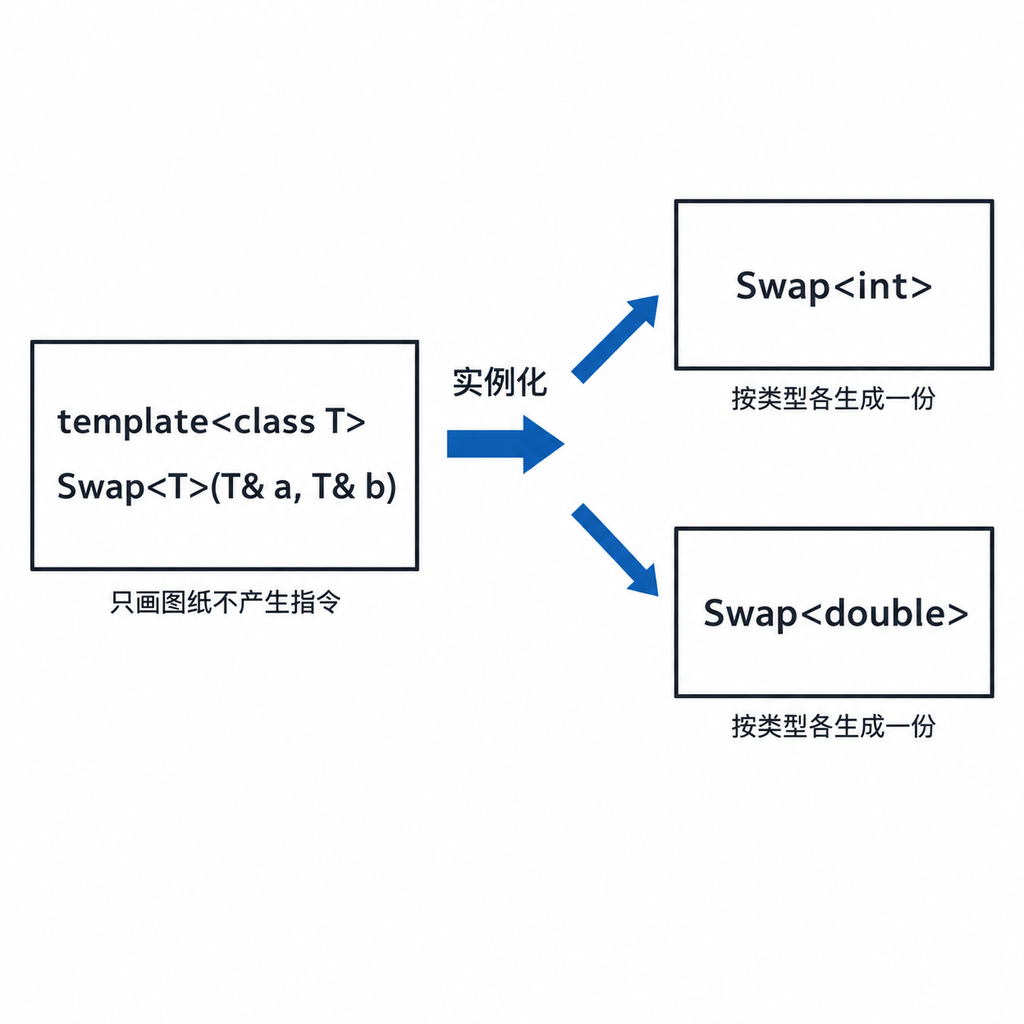
图 3 模板是图纸,实例化之后才有代码
四、两种实例化
从模板变成可调用的函数有两条路,一条是写调用的时候不写类型,编译器从实参把 T 推出来,这叫隐式实例化;另一条是在函数名后面的尖括号里直接把类型写出来,跳过推导这一步,这叫显式实例化。两条路走出来的都是同一份代码,区别只在类型由谁决定,以及实参类型不统一的时候编译器还能不能替你转换。
显式写出类型时不要求实参的类型与它完全一致,编译器会把实参转成指定的类型再调用,这与普通函数的隐式转换一致。隐式实例化没有这层便利,推导阶段不做类型转换,两个实参的类型对不上就停在候选函数列表为空上。括号里写明类型还能省掉一部分推导工作,返回类型由模板参数决定的时候尤其方便。
cpp
// 文件:/home/cocatrice/cpp07/exp04/instant.cpp
#include <iostream>
using namespace std;

template<class T>
T Add(const T& left, const T& right)
{
    return left + right;
}

int main()
{
    int a1 = 10, a2 = 20;
    double d1 = 10.1, d2 = 20.2;

    cout << Add(a1, a2) << endl;
    cout << Add(d1, d2) << endl;

    cout << Add(a1, (int)d1) << endl;
    cout << Add((double)a1, d1) << endl;

    cout << Add<int>(a1, d1) << endl;
    cout << Add<double>(a1, d1) << endl;
    return 0;
}
六次调用分成三组,前两组靠实参推导,后一组把类型写在尖括号里,运行结果里的数字能对上各自的写法。
三种写法混在同一个文件里,编译器为每个调用点分别决定用哪一份实例,源码里看不到切换的痕迹,生成的结果全靠编译期的那次选择。
text
# 所属目录:/home/cocatrice/cpp07/exp04
30
30.3
20
20.1
20
20.1
第一组的两个实参类型一致,推导出 T 是 int 与 double,两次调用各自拿到一份和。第二组在调用处先做了强制类型转换,把两边凑成同一种类型,编译器仍然按推导出来的类型生成代码。第三组把类型写在尖括号里,Add 把两个实参都按 int 参与运算,10 加 10 得到 20;Add 把两边都当成 double,得到 20.1。目标文件里的符号清单印证了这一点,六个调用只换来两个弱符号。
目标文件里只出现两个弱符号,说明六个调用点虽然各自生成了调用指令,被调用的代码只有两份,三次 int 调用共用同一段指令,两次 double 调用共用另一份。
text
# 所属目录:/home/cocatrice/cpp07/exp04
0000000000000000 T main
0000000000000000 W double Add<double>(double const&, double const&)
0000000000000000 W int Add<int>(int const&, int const&)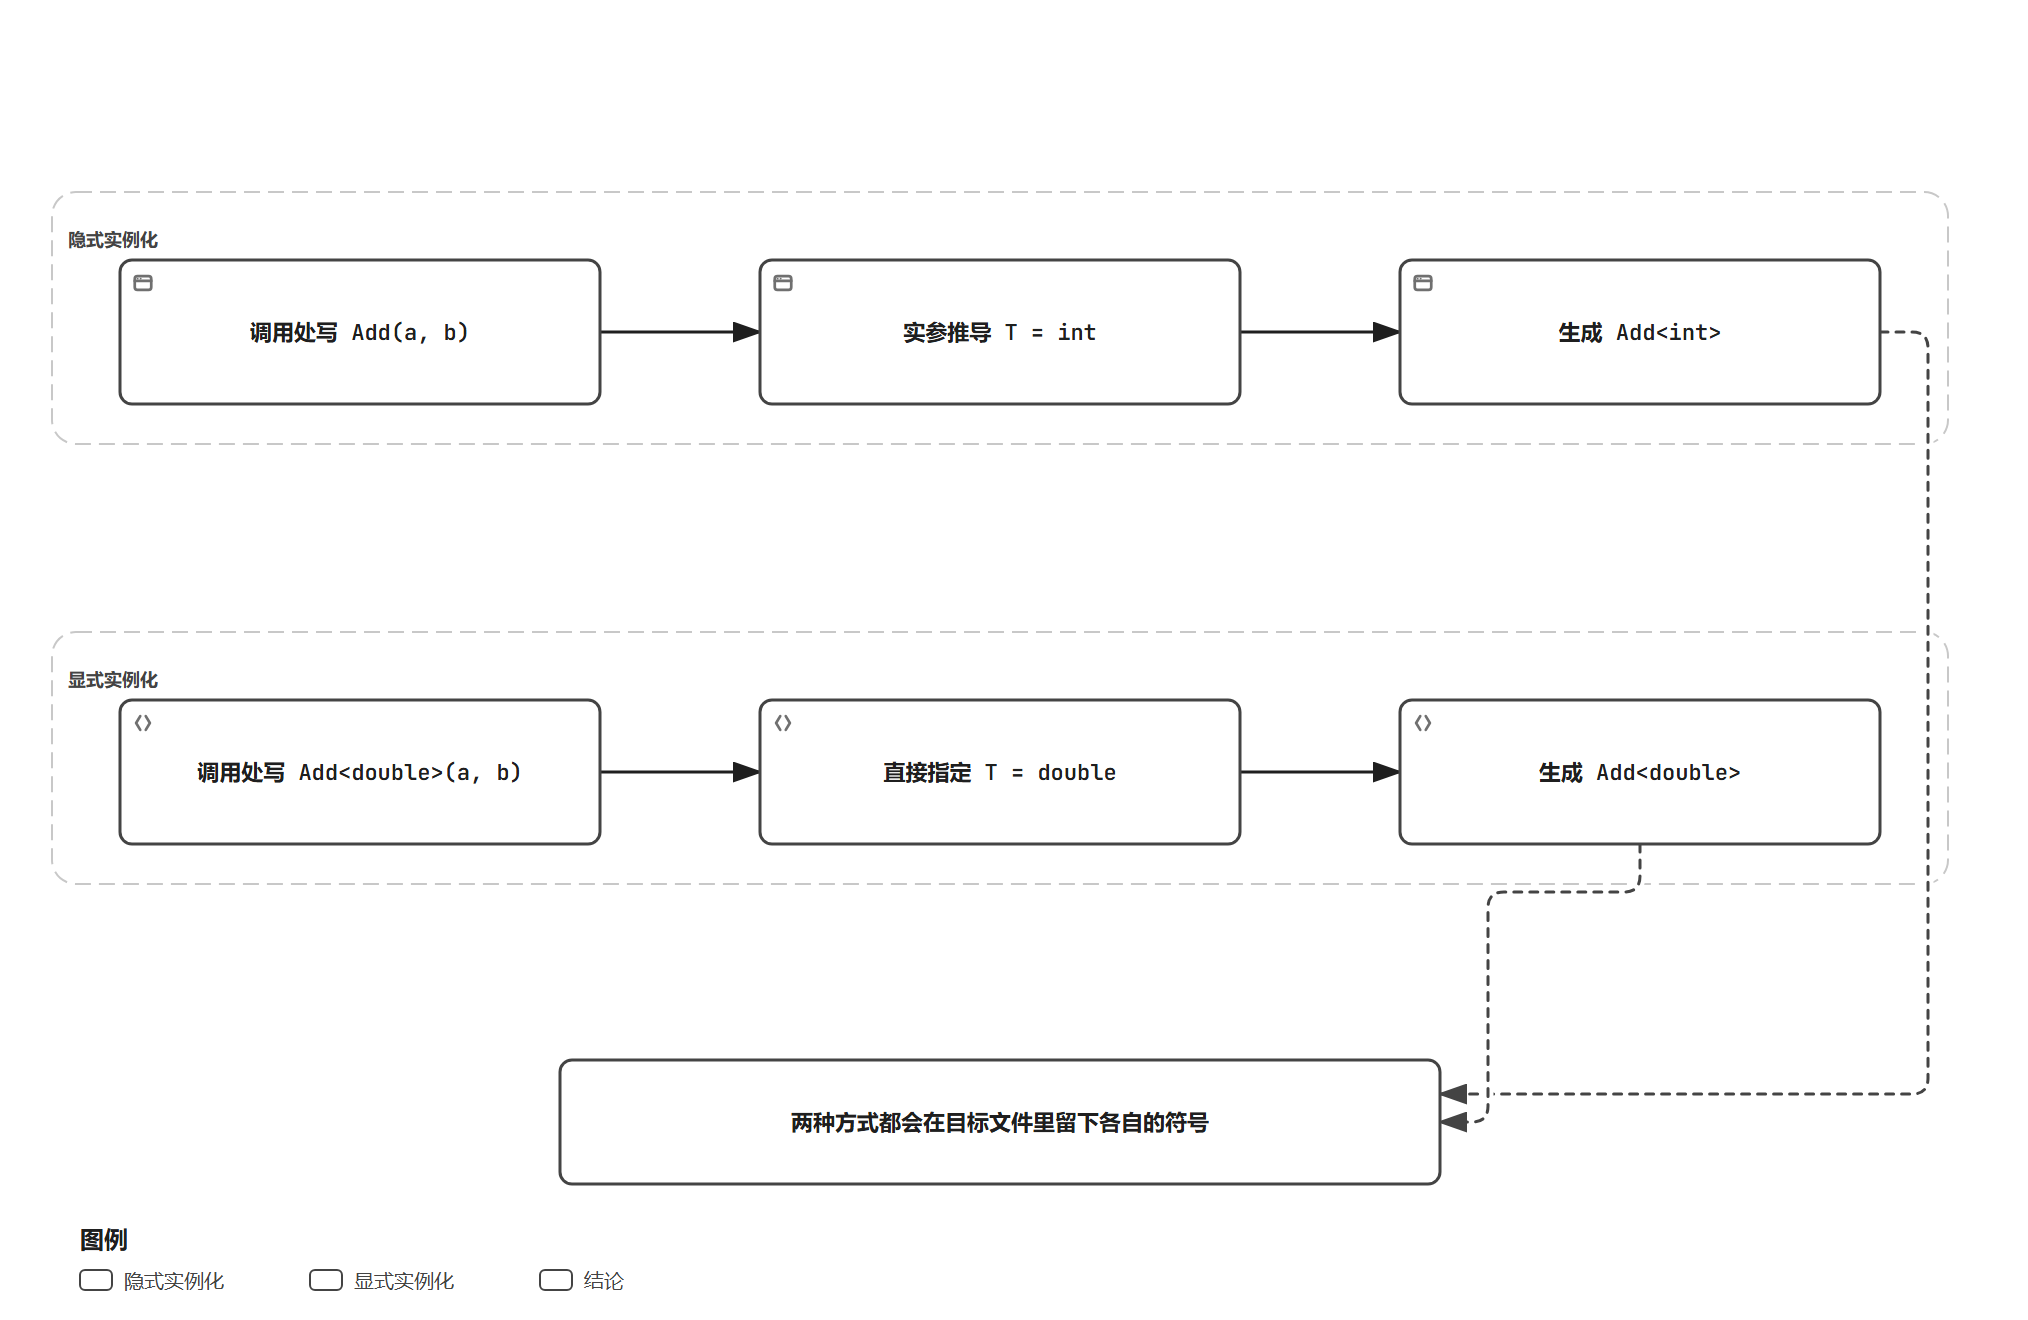
图 4 隐式实例化与显式实例化两条路径
五、编译器生成了什么
模板被实例化之后,编译器做的事情与手写一份对应的函数没有区别:为那个类型生成一段真实的可执行代码,给它一个带类型信息的符号名。用到的类型有几个,符号就有几个,这也是模板代码体积会随类型数量增长的原因。
符号名的拼写规则由 Itanium C++ ABI 规定,构成大致是前缀 Z、函数名与它的长度、参数类型的编码、模板参数的包围标记。阅读时抓住几个字母就能对上:i 表示 int,d 表示 double,c 表示 char,l 表示 long,Pi 表示 int 指针,模板参数被 I 与 E 包在中间,末尾的 RKS0_S2 表示两个 const 引用参数。模板的代码生成也分散在编译的各个阶段:语法分析阶段解析出模板的定义,语义分析阶段记下它带几个类型参数,真正生成机器码要等到某个调用点确定了类型。
cpp
// 文件:/home/cocatrice/cpp07/exp05/sym.cpp
template<class T>
T Add(const T& left, const T& right)
{
    return left + right;
}

int main()
{
    int a = 1, b = 2;
    double c = 1.5, d = 2.5;

    return Add(a, b) + (int)Add(c, d);
}
同一份模板被 int 与 double 各调用一次,符号清单里出现了两个弱符号。
符号的个数与用到的类型个数成正比,这一条可以直接拿来估算模板在工程里的展开规模:一个被十种类型使用的函数模板会在目标文件里留下十份弱符号,编译时间与目标文件体积也按这个比例增长。
符号清单是判断实例化结果最直接的地方,行数、链接属性与符号名里的类型编码都能在里面读出来,编译命令一样时不同源文件的结果可以直接对比。
把两份目标文件的符号清单导出来对照是排查模板问题的常规手段,缺少的实例在清单里表现为一个待解决的符号,多余的实例表现为同一份代码被生成多次,两者都能在链接前后发现。
text
# 所属目录:/home/cocatrice/cpp07/exp05
0000000000000000 T main
0000000000000000 W double Add<double>(double const&, double const&)
0000000000000000 W int Add<int>(int const&, int const&)
把 -C 参数去掉,nm 打印的就是目标文件里的原始符号名,类型信息被编码进了名字本身。
调试模板时这套名字会重复出现在每个报错与每个符号列表里,编译器的诊断信息与 nm 的输出都靠类型编码区分实例,读的时候把 i、d、c 与 S0_、S1_ 这类编号对上源码里的调用点,实例关系就清楚了。需要更直观的形式时可以给 nm 加上解码参数,输出的名字与源码里的声明接近,排查的速度会快很多。
text
# 所属目录:/home/cocatrice/cpp07/exp05
0000000000000000 T main
0000000000000000 W _Z3AddIdET_RKS0_S2_
0000000000000000 W _Z3AddIiET_RKS0_S2_
名字里的 3Add 是函数名与它的长度,I 与 D 之后的 i 与 d 代表 int 与 double,这套拼写规则由 Itanium C++ ABI 规定。c++filt 能把这样的名字还原成人能读的形式。
text
# 所属目录:/home/cocatrice/cpp07/exp05
int Add<int>(int const&, int const)
double Add<double>(double const&, double const)
还原出来的形式与源码里的声明基本一致,只有引用参数的位置换成了 S2_ 这种缩写写法,解出来少了那个引用符号,两者指的还是同一份实例。用 objdump 反汇编目标文件,两个类型各自占据一个独立的节,节名正是那两个经过修饰的符号。
同一个模板在多个目标文件里被实例化,生成出来的节名完全相同,链接器看到这些重名的节时按 COMDAT 规则只留下一份。这条规则与弱符号是一回事的两种表现:符号表里看到的是 W 的链接属性,节的层面看到的是重名的代码节被合并。反汇编里两个节各自独立,分段与符号名一一对应,链接之后的地址由链接器分配,实例化时生成的代码本身不依赖地址。
text
# 所属目录:/home/cocatrice/cpp07/exp05
Disassembly of section .text._Z3AddIiET_RKS0_S2_:

0000000000000000 <int Add<int>(int const&, int const&)>:
   0:	55                   	push   %rbp
   1:	48 89 e5             	mov    %rsp,%rbp
   4:	48 89 7d f8          	mov    %rdi,-0x8(%rbp)
   8:	48 89 75 f0          	mov    %rsi,-0x10(%rbp)
   c:	48 8b 45 f8          	mov    -0x8(%rbp),%rax
  10:	8b 10                	mov    (%rax),%edx
  12:	48 8b 45 f0          	mov    -0x10(%rbp),%rax
  16:	8b 00                	mov    (%rax),%eax
  18:	01 d0                	add    %edx,%eax
  1a:	5d                   	pop    %rbp
  1b:	c3                   	retq

Disassembly of section .text._Z3AddIdET_RKS0_S2_:

0000000000000000 <double Add<double>(double const&, double const&)>:
   0:	55                   	push   %rbp
   1:	48 89 e5             	mov    %rsp,%rbp
   4:	48 89 7d f8          	mov    %rdi,-0x8(%rbp)
   8:	48 89 75 f0          	mov    %rsi,-0x10(%rbp)
   c:	48 8b 45 f8          	mov    -0x8(%rbp),%rax
  10:	f2 0f 10 08          	movsd  (%rax),%xmm1
  14:	48 8b 45 f0          	mov    -0x10(%rbp),%rax
  18:	f2 0f 10 00          	movsd  (%rax),%xmm0
  1c:	f2 0f 58 c1          	addsd  %xmm1,%xmm0
  20:	f2 0f 11 45 e8       	movsd  %xmm0,-0x18(%rbp)
  25:	48 8b 45 e8          	mov    -0x18(%rbp),%rax
  29:	48 89 45 e8          	mov    %rax,-0x18(%rbp)
  2d:	f2 0f 10 45 e8       	movsd  -0x18(%rbp),%xmm0
  32:	5d                   	pop    %rbp
  33:	c3                   	retq
两份代码的结构一样,差别落在最后那一条加法指令上:int 版用的是整数加法 add %edx,%eax,double 版把两个操作数搬进浮点寄存器之后用 addsd %xmm1,%xmm0 完成一次双精度加法。模板只写了 left + right 这一行,编译器按类型挑出了两条不同的机器指令。
模板的语法只写了加法与返回,类型相关的指令选择交给编译器,因此同一份源码在不同类型上可以差到寄存器级别的操作不同。整数加法在通用寄存器上一条指令完成,双精度加法要把操作数搬进 xmm 寄存器,结果也要单独搬回去。写成宏或者 void* 的版本做不到这件事,类型在展开之后就已经丢失。同一份模板在不同类型上生成的代码长度也不同,指令的寄存器分配与栈帧布局都按类型重新安排,这些细节由编译器在实例化时决定。
读汇编确认实例化结果时,先找到调用指令的目标地址与名字,再看那段代码里的运算指令,模板是否真的按类型展开了就从这两处判断。
两个特化的地址也不相同,把它们的函数指针打印出来对比,可以看到每一份实例占据独立的一段代码。
cpp
// 文件:/home/cocatrice/cpp07/exp05/addr.cpp
#include <cstdio>

template<class T>
T Add(const T& left, const T& right)
{
    return left + right;
}

int main()
{
    int (*pi)(const int&, const int&) = Add;
    double (*pd)(const double&, const double&) = Add;

    printf("%p\n", (void*)pi);
    printf("%p\n", (void*)pd);
    printf("%d\n", pi == (int (*)(const int&, const int&))pd);
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/exp05
0x4005c7
0x4005e3
0
第三行的 0 表示两个指针不相等,两份实例各自占着一段地址。加上 -S 参数之后 nm 还会打印每个符号的字节数,两个特化的体积差了三倍多。
text
# 所属目录:/home/cocatrice/cpp07/exp05
00000000004005e3 0000000000000034 W double Add<double>(double const&, double const&)
00000000004005c7 000000000000001c W int Add<int>(int const&, int const&)
0x1c 是十进制的 28,0x34 是 52,同一份模板生成的 int 版函数与 double 版函数在体积上并不一样。把用到两种类型的可执行文件与只用一种类型的可执行文件放在一起比较,text 段的差距摆在那里。
体积差距的两个部分可以分开看:double 版要多搬运浮点寄存器里的值,指令条数多一些;函数的栈帧与对齐方式也按类型区分,double 参数占的栈空间比 int 大一倍。加上优化选项之后这些短函数有机会被内联进调用点,符号表里的实例数量随之减少,text 段里的代码并不会消失,只是被搬到了调用它的函数内部。可执行文件里的段大小还受链接器合并的影响,多个目标文件共用的实例会被合并成一份,源文件里写了几个调用点并不影响最终代码的数量。
text
# 所属目录:/home/cocatrice/cpp07/exp05
   text	   data	    bss	    dec	    hex	filename
   1270	    588	      4	   1862	    746	size_one
   1430	    588	      4	   2022	    7e6	size_two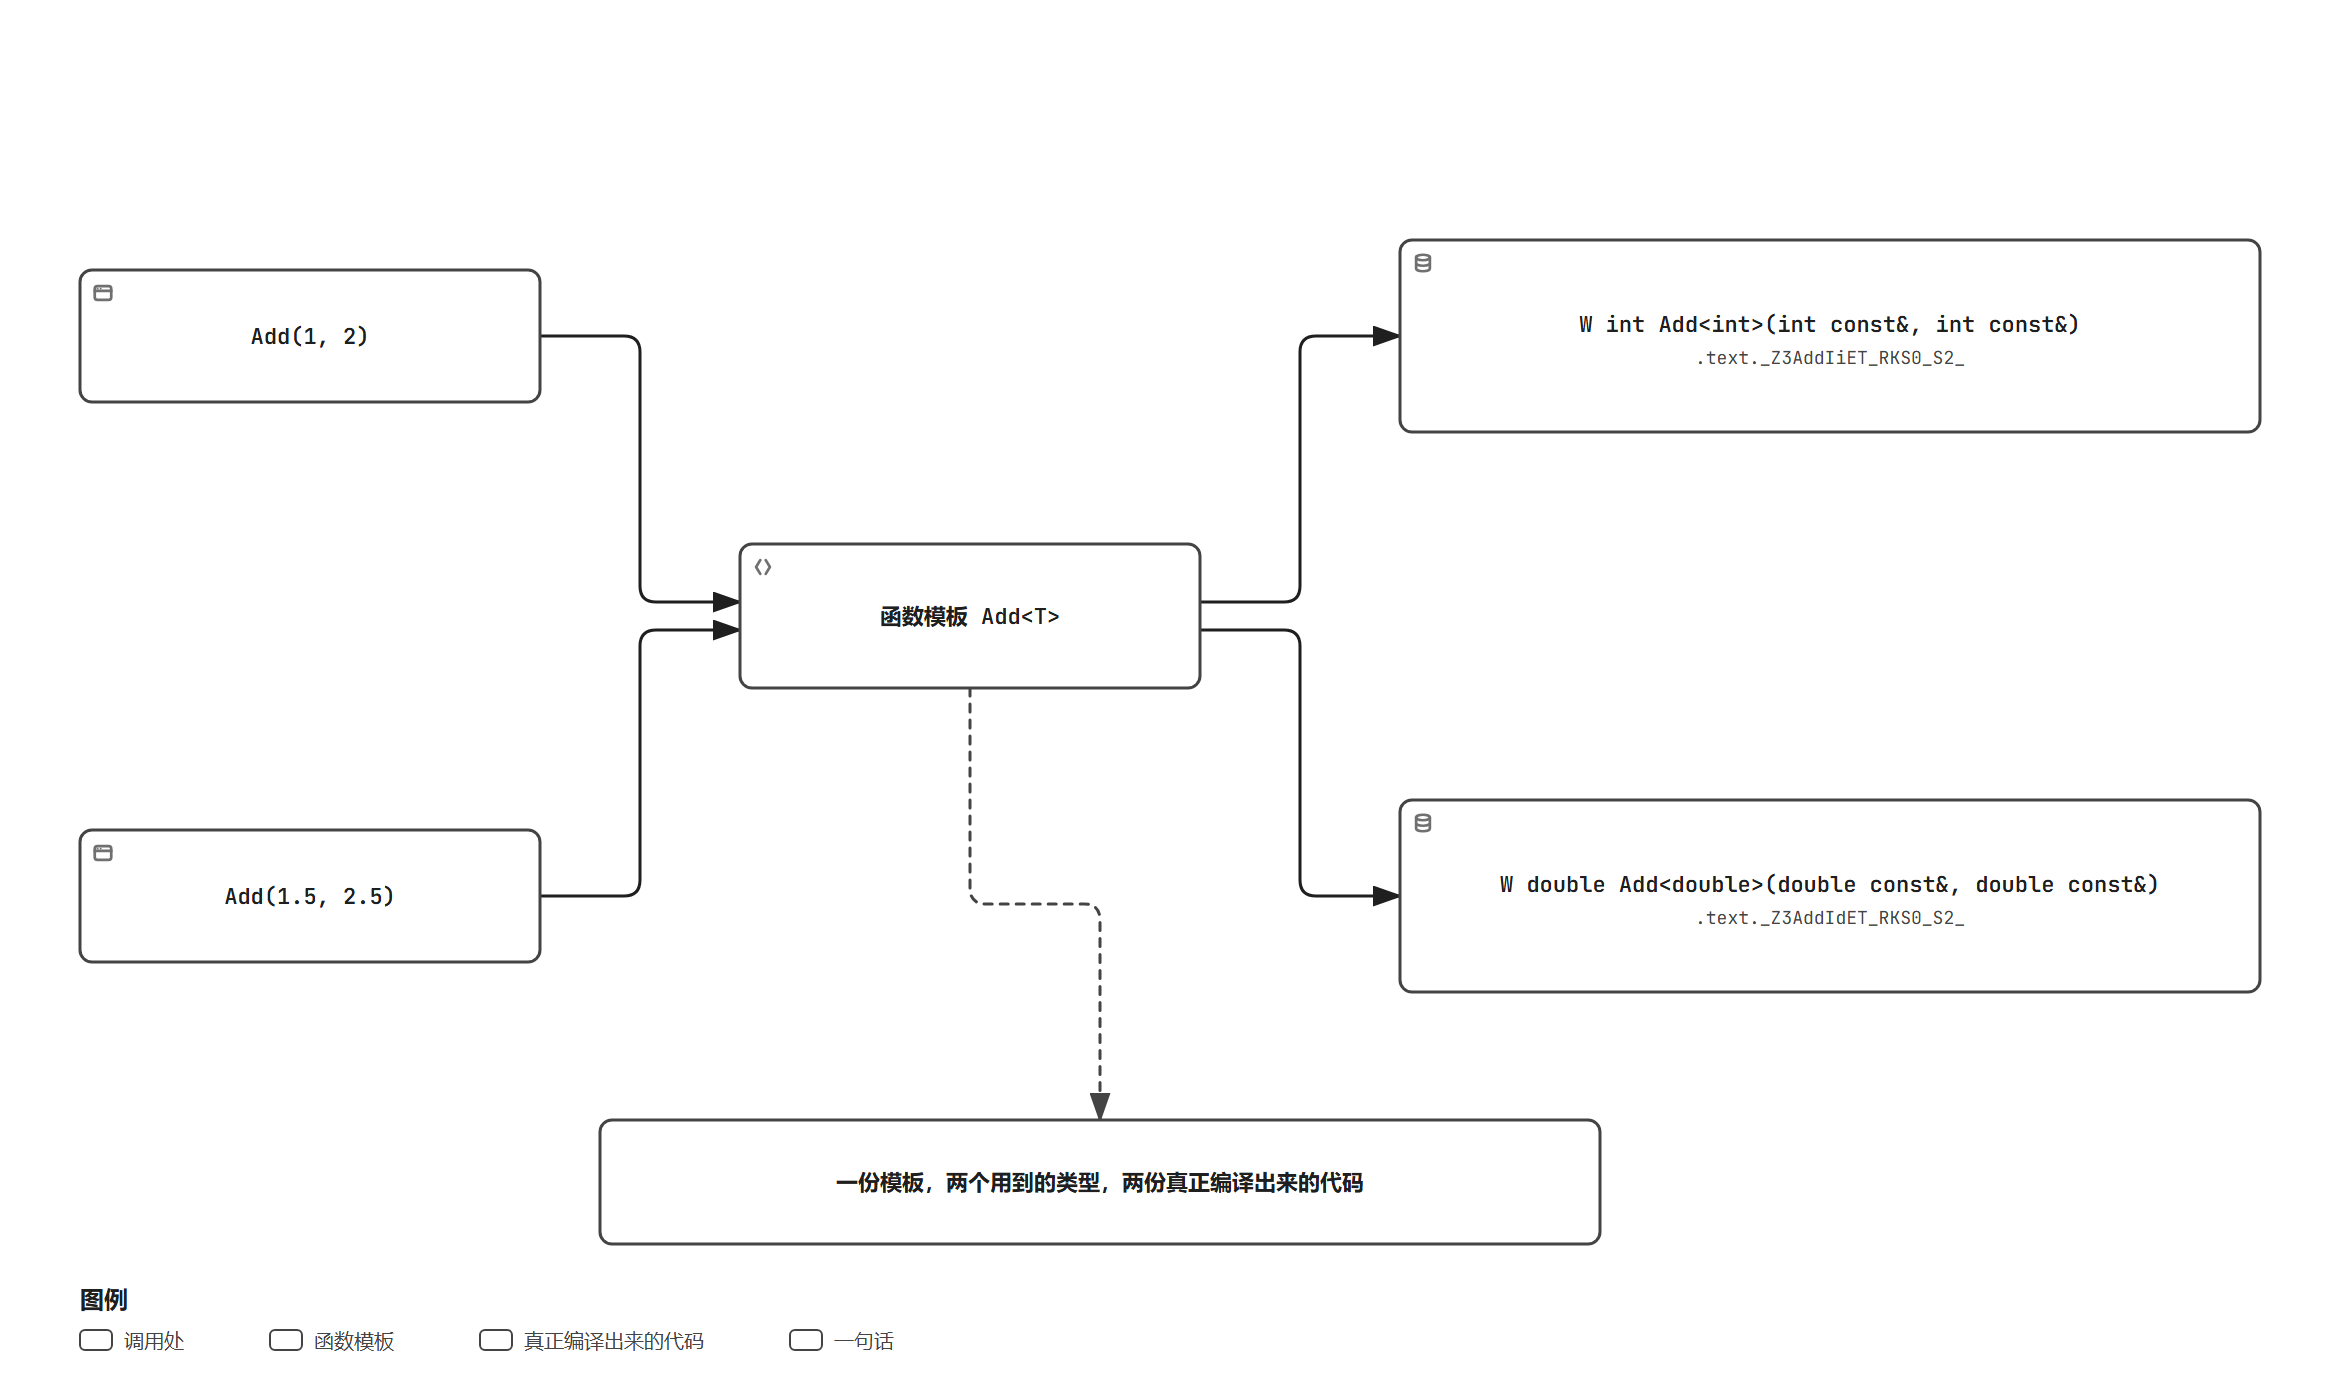
图 5 一个模板与两份实例的符号
六、实参推导
实参推导决定 T 到底是什么,它有一套明确的规则,最容易出错的地方在于形参写的是按值传递还是引用传递。按值传递时顶层 const 会被丢掉,数组名会退化成指针,函数名会退化成函数指针,这三条都会改变 T 的本来面貌。
推导的过程是拿形参的写法与实参的类型做模式匹配:形参写成 T,实参是 int 就得到 T 等于 int;形参写成 const T&,实参的类型也要按引用去对齐。多个形参都出现 T 的时候,每个位置各推一次,结果必须一致,不一致就是推导冲突。推导阶段不做类型转换,这一点把模板的重载决议与普通函数区分开来,把 int 与 double 传给同一份模板不会自动统一成其中的一种。
cpp
// 文件:/home/cocatrice/cpp07/exp06/deduce.cpp
#include <iostream>
#include <typeinfo>
using namespace std;

template<class T>
void show(T v)
{
    cout << "T=" << typeid(T).name() << " sizeof(v)=" << sizeof(v) << endl;
}

template<class T>
void show_ref(T& v)
{
    cout << "T=" << typeid(T).name() << " sizeof(v)=" << sizeof(v) << endl;
}

int main()
{
    int a = 1;
    const int ca = 2;
    double d = 1.5;
    int arr[5] = {0};

    show(a);
    show(ca);
    show(d);
    show(arr);
    show_ref(a);
    show_ref(ca);
    return 0;
}
同一份函数用四种实参各调一次,再用带引用的版本调用两次,六行输出把推导结果都打印了出来。
六次调用里前四次走按值传递的形参,后两次走引用传递的形参,两种形参写法在同一个模板里各自实例化,得到的是 T 不同的两份代码。形参写成 const T& 时实参不需要拷贝,只读不改的场合更适合这种写法,实参的 const 属性也随之进入类型。
text
# 所属目录:/home/cocatrice/cpp07/exp06
T=i sizeof(v)=4
T=i sizeof(v)=4
T=d sizeof(v)=8
T=Pi sizeof(v)=8
T=i sizeof(v)=4
T=i sizeof(v)=4
第二行传入的是一个 const int 对象,推导出来的 T 仍然是 int,顶层的 const 在按值传递的路径上被丢掉了。第四行传入的是一个长度为 5 的 int 数组,形参是按值传递的 T,数组名退化成指针,T 变成 Pi,也就是 int 指针,sizeof 从数组的 20 变成了指针的 8。后两行走的是引用版本,const 保留在 T 里面,typeid 打印的时候又把限定符去掉了,所以两行看起来都是 i。
引用版本能把 const 保留下来,写成 const T& 之后形参本身也带上限定符,推导出来的 T 是实参去掉引用之后的类型。返回类型不参与推导,函数模板只有出现在形参列表里的类型才推得出来,想让返回值也带上类型参数,要么在调用处把类型写在尖括号里,要么把返回类型与某个形参绑定起来,这一部分内容留到后面的进阶篇。
推导不出来的情形也有一套固定的报错方式,下面几种写法都会被编译器拦下。把字面量传给 T& 版本的交换函数,右值没有办法绑定到非 const 引用上。
text
# 所属目录:/home/cocatrice/cpp07/exp06
err_rvalue.cpp: In function 'int main()':
err_rvalue.cpp:11:11: error: invalid initialization of non-const reference of type 'int&' from an rvalue of type 'int'
  Swap(1, 2);
           ^
err_rvalue.cpp:2:6: error: in passing argument 1 of 'void Swap(T&, T&) [with T = int]'
 void Swap(T& left, T& right)
      ^
一个 const 对象与一个普通对象一起传给 T& 版本,两个实参推导出两个不同的 T,编译器在冲突的地方停下来。
推导把每个实参的类型与形参的写法逐个对齐,一个位置推出 const int,另一个位置推出 int,两次结果不一致时编译器判定冲突并停下。想避开这种冲突,把两个实参的写法统一起来,或者在调用处显式写出类型,都能让编译通过。
text
# 所属目录:/home/cocatrice/cpp07/exp06
err_const.cpp: In function 'int main()':
err_const.cpp:13:11: error: no matching function for call to 'Swap(const int&, int&)'
  Swap(a, b);
           ^
err_const.cpp:13:11: note: candidate is:
err_const.cpp:2:6: note: template<class T> void Swap(T&, T&)
 void Swap(T& left, T& right)
      ^
err_const.cpp:2:6: note:   template argument deduction/substitution failed:
err_const.cpp:13:11: note:   deduced conflicting types for parameter 'T' ('const int' and 'int')
  Swap(a, b);
           ^
数组传给引用版本时 T 会被推导成数组类型,交换的语句在数组上无法成立,报错落在函数体内部的赋值上。
text
# 所属目录:/home/cocatrice/cpp07/exp06
err_array.cpp: In instantiation of 'void Swap(T&, T&) [with T = int [2]]':
err_array.cpp:13:11:   required from here
err_array.cpp:4:11: error: array must be initialized with a brace-enclosed initializer
  T temp = left;
           ^
err_array.cpp:5:7: error: invalid array assignment
返回类型不在形参列表里,推导自然推不出它,一个只有返回类型是模板参数的函数没法通过实参确定 T。
text
# 所属目录:/home/cocatrice/cpp07/exp06
err_noret.cpp: In function 'int main()':
err_noret.cpp:9:14: error: no matching function for call to 'func()'
  return func();
              ^
err_noret.cpp:9:14: note: candidate is:
err_noret.cpp:2:3: note: template<class T> T func()
 T func()
   ^
err_noret.cpp:2:3: note:   template argument deduction/substitution failed:
err_noret.cpp:9:14: note:   couldn't deduce template parameter 'T'
  return func();
              ^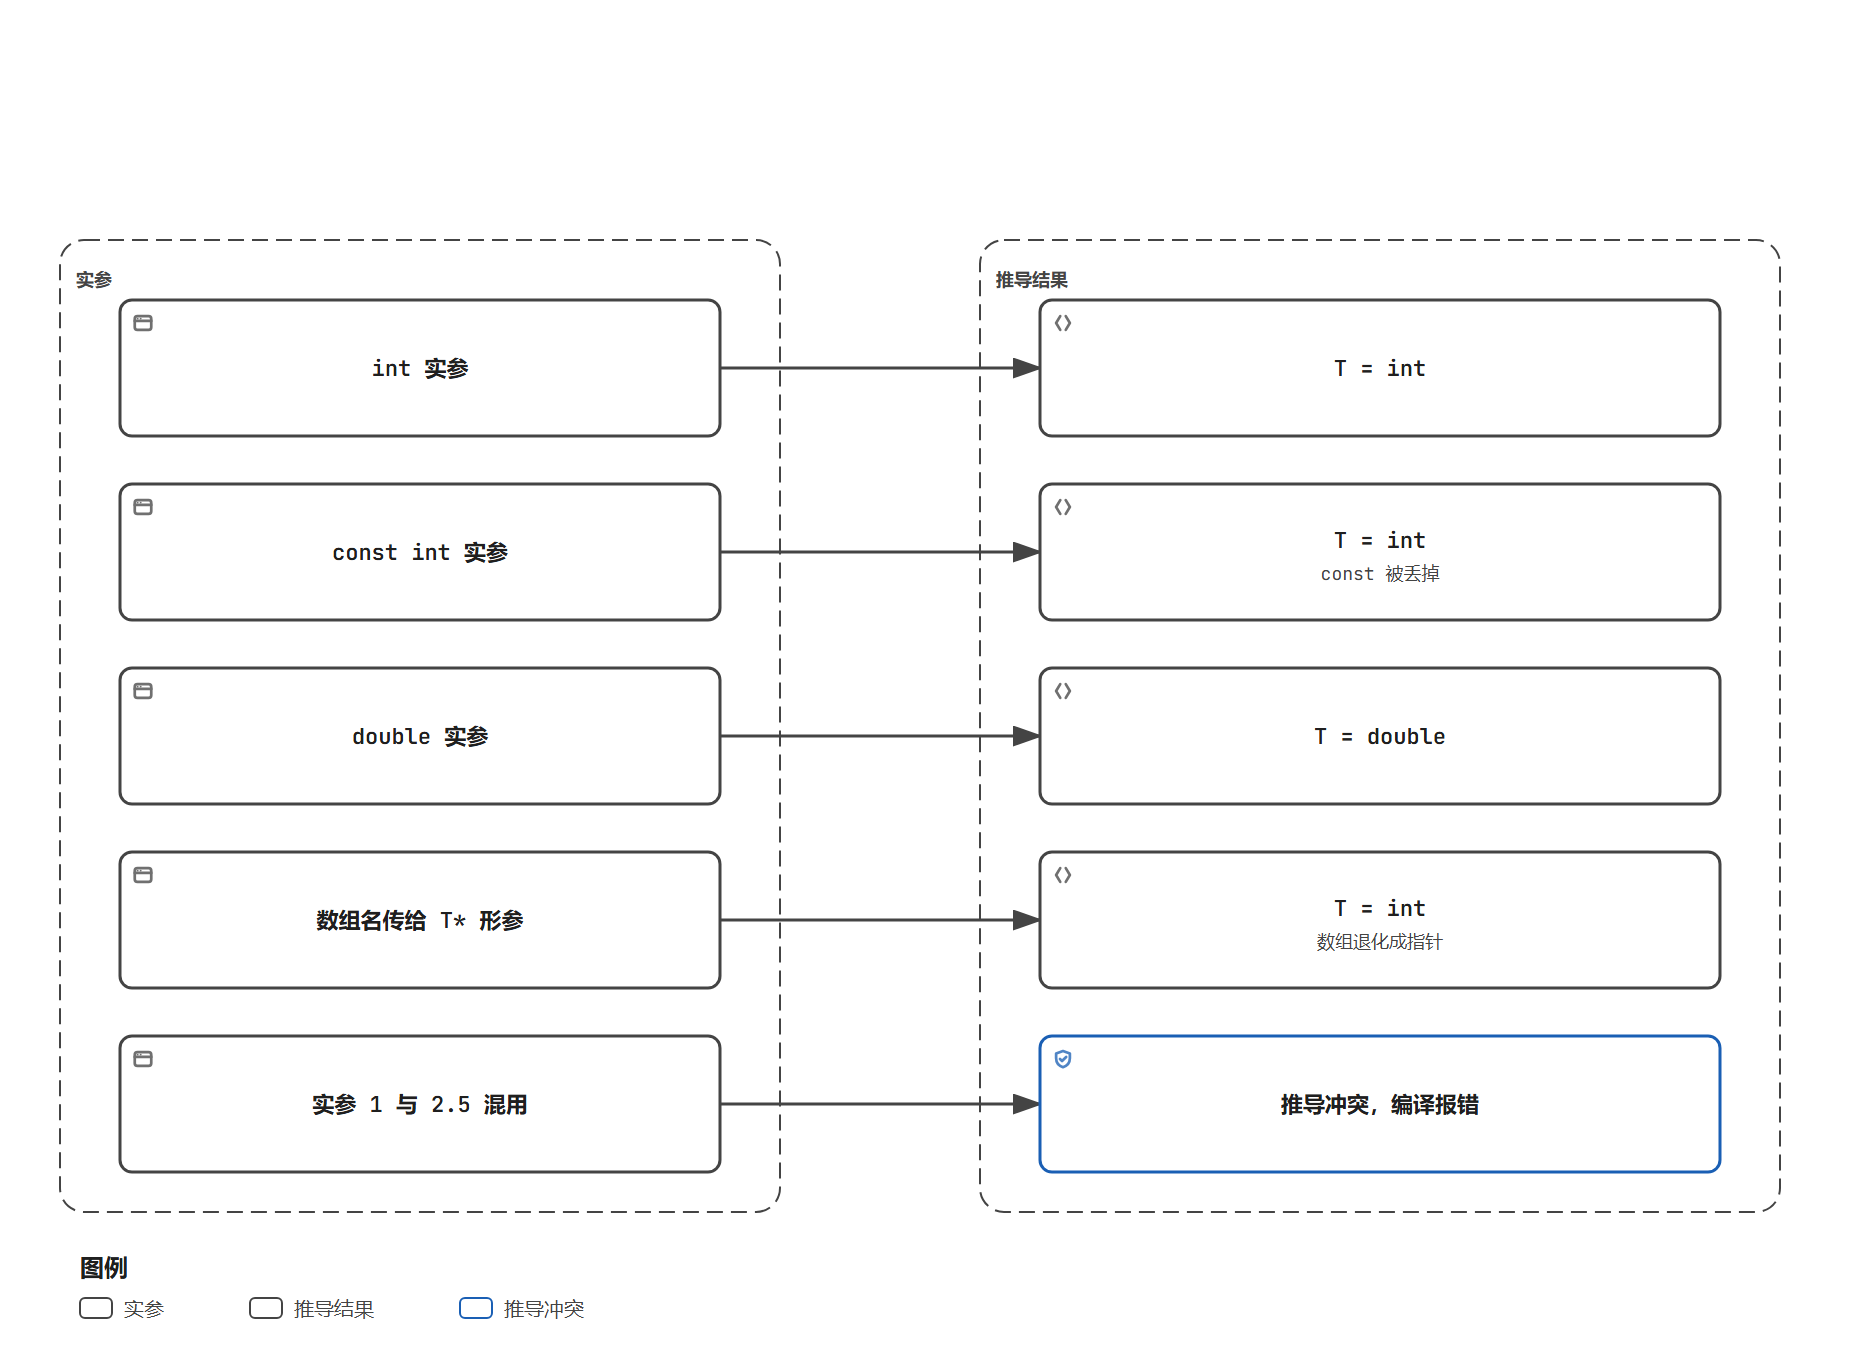
图 6 实参推导的几种结果
七、匹配原则
一个名字同时对应一个非模板函数与一组模板特化时,重载决议会把它们放在一起比较,规矩是:非模板函数如果能精确匹配就优先选它,模板需要显式指定类型时按指定的走,参数上都不合适的直接报错。下面这一组把三条规矩都用同名的 Add 摆出来。
重载决议的过程可以拆成几步:先把同一个名字下的所有可调用实体收进候选集合,非模板函数与模板都在里面;再把实参类型代入,模板在这一步完成推导,推导失败的直接被移出候选集合;末尾一步比较剩下候选的转换代价,代价高的一方落选。转换代价有明确的等级,精确匹配优于需要提升的匹配,提升优于需要标准转换的匹配,模板推导出来的类型与实参完全一致时落在精确匹配这一档,这也是它在多参数情形下常常胜出的原因。
cpp
// 文件:/home/cocatrice/cpp07/exp07/match1.cpp
#include <iostream>
using namespace std;

int Add(const int& x, const int& y)
{
    return (x + y) * 10;
}

template<class T>
T Add(const T& x, const T& y)
{
    return x + y;
}

int main()
{
    int a1 = 10, a2 = 20;

    cout << Add(a1, a2) << endl;
    cout << Add<int>(a1, a2) << endl;
    return 0;
}
同一个名字下有两个 Add,不带尖括号的那次调用选中了非模板函数,返回值被乘了 10,带尖括号的那次强制走了模板。
text
# 所属目录:/home/cocatrice/cpp07/exp07
300
30
可执行文件里两个 Add 同时存在,非模板那个是 T,模板生成的是弱符号 W。
text
# 所属目录:/home/cocatrice/cpp07/exp07
00000000004007ad T Add(int const&, int const&)
0000000000400899 W int Add<int>(int const&, int const&)
第二条规矩是在参数上更匹配的那一方优先。普通函数的形参是 double,模板的参数是 T,传入 int 实参时模板不需要转换就能匹配,传入 double 实参时反而是普通函数刚刚好。
cpp
// 文件:/home/cocatrice/cpp07/exp07/match2.cpp
#include <iostream>
using namespace std;

int f(double x)
{
    return (int)x + 100;
}

template<class T>
int f(T x)
{
    return (int)x;
}

int main()
{
    cout << f(1) << endl;
    cout << f(1.5) << endl;
    cout << f<int>(1) << endl;
    return 0;
}
三次调用返回了三个不同的数字,第一个走模板,第二个走普通函数,第三个被尖括号强制拉回模板。
text
# 所属目录:/home/cocatrice/cpp07/exp07
1
101
1
两个模板参数可以让类型不同的一对实参通过,下面这个 Add 在第二个实参是 double 的时候仍然能生成一份合适的实例。
这组对照说明候选集合里放的不只是一组特化,所有同名实体都在里面按转换代价比较,模板推导出来的类型恰好等于实参类型时,它在这一步占优。
cpp
// 文件:/home/cocatrice/cpp07/exp07/match3.cpp
#include <iostream>
using namespace std;

int Add(const int& x, const int& y)
{
    return (x + y) * 10;
}

template<class T1, class T2>
T1 Add(const T1& x, const T2& y)
{
    return x + y;
}

int main()
{
    cout << Add(1, 2) << endl;
    cout << Add(1, 2.0) << endl;
    return 0;
}
第一次调用的两个实参类型一致,非模板函数精确匹配,结果被乘了 10;第二次调用的两个实参类型不同,非模板函数需要把 double 转成 int,模板可以按 T1 与 T2 两个参数各自推导,转换的代价更高,模板胜出。
函数模板没有偏特化的语法,想针对某些类型改行为只能再写一份普通函数,或者换一个约束更紧的模板,几种写法放在一起由重载决议按参数挑选。类模板的偏特化是另一套机制,它不作为候选参与重载,而是在实例化时按匹配程度挑出最合适的一份,这个名字后面的内容才展开。
text
# 所属目录:/home/cocatrice/cpp07/exp07
30
3
模板在推导阶段不会替实参做类型转换,只有模板可选时,把 int 与 double 混着传给单参数版本会直接失败。
text
# 所属目录:/home/cocatrice/cpp07/exp07
match4.cpp: In function 'int main()':
match4.cpp:9:19: error: no matching function for call to 'Add(int, double)'
  return Add(1, 2.5);
                   ^
match4.cpp:9:19: note: candidate is:
match4.cpp:2:3: note: template<class T> T Add(const T&, const T&)
 T Add(const T& x, const T& y)
   ^
match4.cpp:2:3: note:   template argument deduction/substitution failed:
match4.cpp:9:19: note:   deduced conflicting types for parameter 'const T' ('int' and 'double')
  return Add(1, 2.5);
                   ^
 Add(1, 2.5);
                   ^
换成普通函数之后同样的调用可以过,编译器把 double 隐式转成 int 之后调用成功。
实际写代码时,同一个名字下同时放普通函数与模板的做法要谨慎使用,调用点看起来一样,选中的那一份却由参数类型决定,阅读时需要在两种实现之间来回跳。把模板的名字与普通函数的名字错开,或者让模板承担全部类型、普通函数只留给确实需要特殊处理的类型,都比混用更容易维护。
text
# 所属目录:/home/cocatrice/cpp07/exp07
30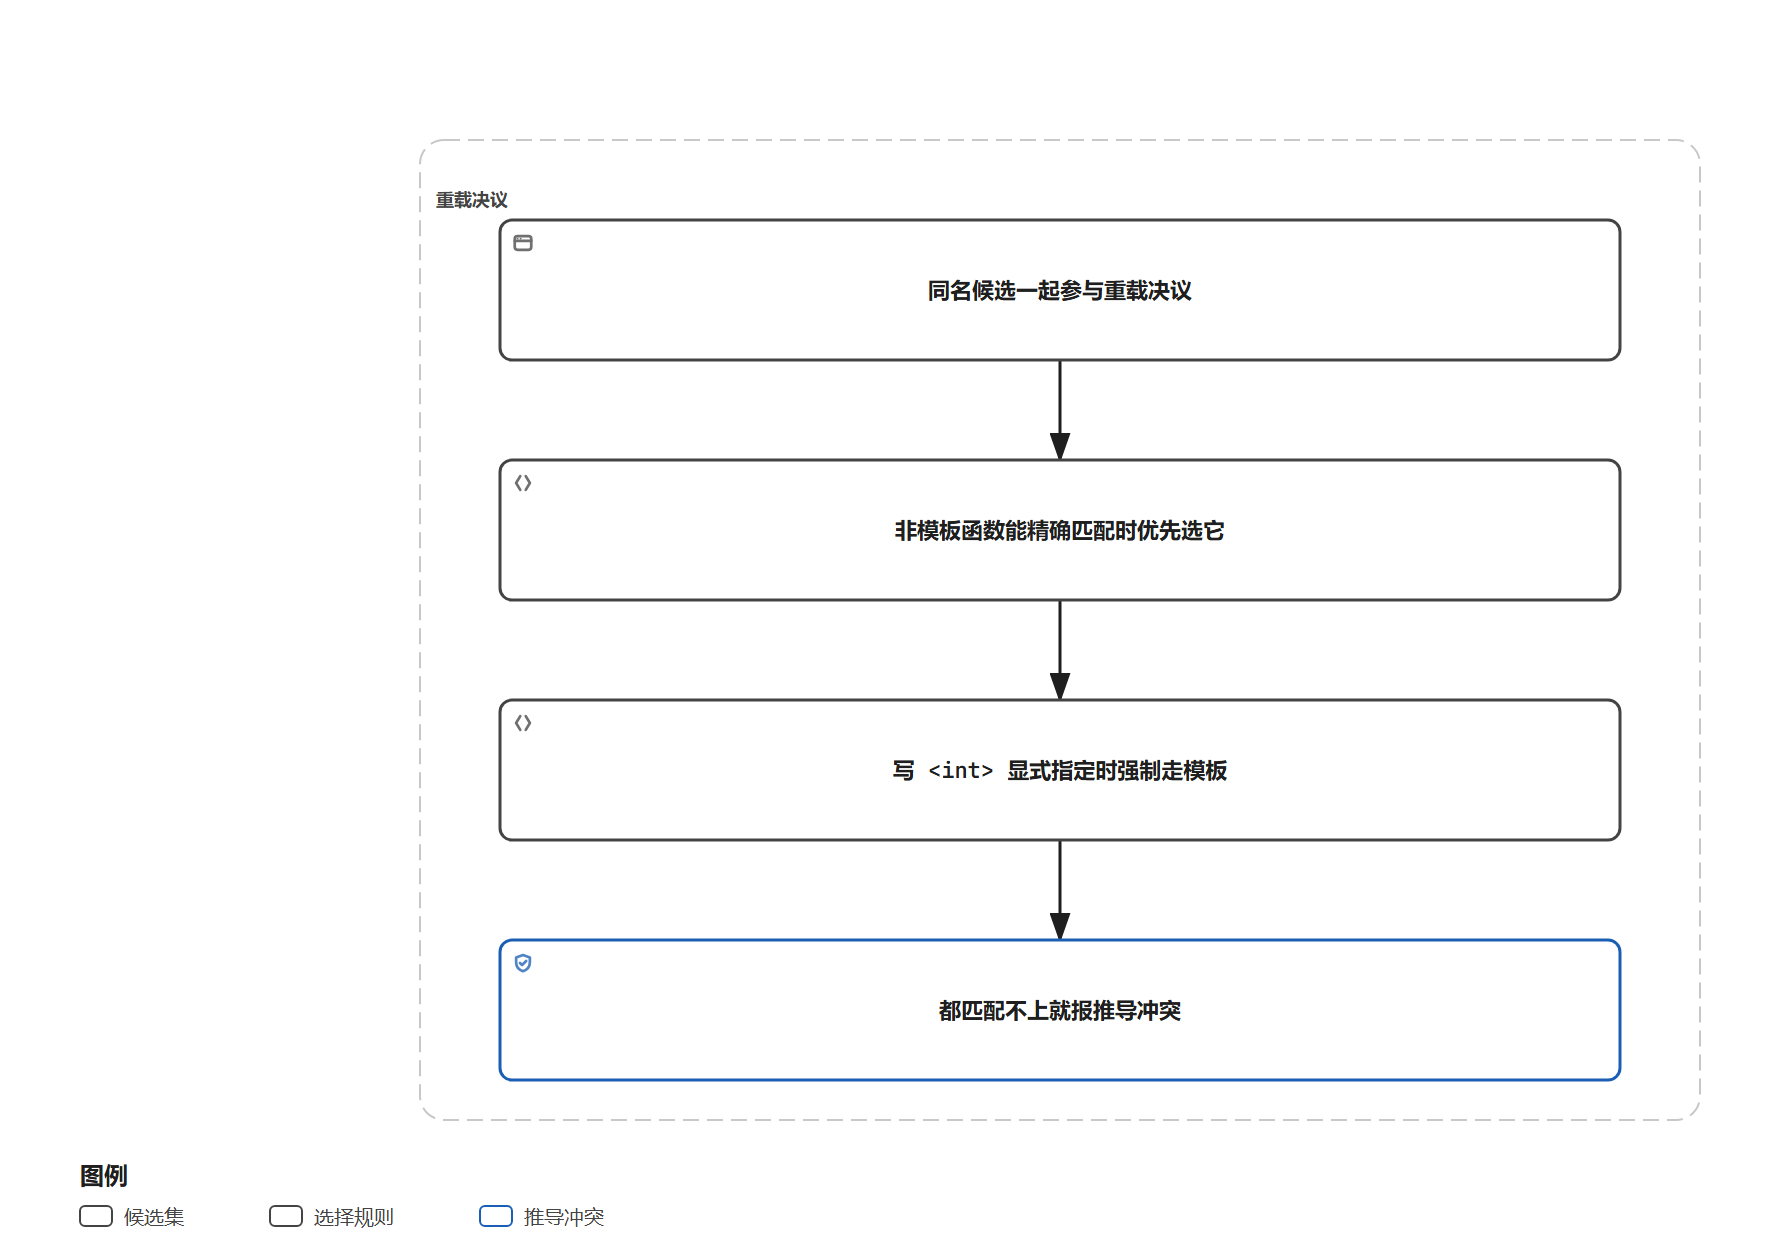
图 7 重载时的选择顺序
八、模板不能分离编译
普通函数可以声明放头文件、定义放源文件,链接的时候由链接器把两边接上。模板不行,编译器在生成代码之前必须看见模板的完整定义,只拿到一行声明的翻译单元什么也生成不出来,而链接器没有能力替它补上这一步。
链接器的工作范围限定在符号层面,它看到的是某个目标文件提供了什么符号、另一个目标文件需要什么符号,看不到模板的定义,也没有能力按一个待用的类型临时生成代码。编译期与链接期的这层分工决定了模板的定义必须对使用它的翻译单元可见,C++ 早期尝试过的分离模型在实现上困难,日常使用里保留下来的是包含模型,也就是把定义放进头文件。分离编译失败的根源在实例化的时机上,编译器必须先看到定义才知道要为哪些类型生成代码,只拿到声明的翻译单元没有这份信息,只能留下一个待解决的符号。
cpp
// 文件:/home/cocatrice/cpp07/exp08/sep.h
template<class T>
T Add(const T& left, const T& right);
cpp
// 文件:/home/cocatrice/cpp07/exp08/sep.cpp
#include "sep.h"

template<class T>
T Add(const T& left, const T& right)
{
    return left + right;
}
cpp
// 文件:/home/cocatrice/cpp07/exp08/main_sep.cpp
#include <iostream>
#include "sep.h"
using namespace std;

int main()
{
    int a = 10, b = 20;

    cout << Add(a, b) << endl;
    return 0;
}
三份文件放在一起编译加链接,前面两步都没有问题,报错出现在最后一步。
编译阶段每个源文件各自通过,报错留到链接阶段才出现,这个次序本身就是实例化机制的体现:生成代码的时间点在编译期,链接器拿到的只是符号需求,没有人替它补上缺失的那一份。链接器的报错格式固定,先是哪一份目标文件在哪个函数里出现了未定义的引用,再是缺失符号的完整名字,名字里的类型信息能直接对上源码里的那次调用。
text
# 所属目录:/home/cocatrice/cpp07/exp08
---- g++ -std=c++98 -c sep.cpp -o sep.o ----
---- nm -C sep.o ----
---- ls -l sep.o ----
-rw-rw-r-- 1 cocatrice cocatrice 936 Oct  6 17:55 sep.o
---- g++ -std=c++98 -c main_sep.cpp -o main_sep.o ----
---- g++ -std=c++98 main_sep.o sep.o -o main_sep ----
main_sep.o: In function `main':
main_sep.cpp:(.text+0x25): undefined reference to `int Add<int>(int const&, int const&)'
collect2: error: ld returned 1 exit status
---- exit code: 1 ----
sep.o 的符号表是空的,模板的定义在里面躺了一整份,却因为没有调用而没有被实例化,连一个符号都没有留下。main_sep.o 需要的是一个具体的 Add,两边对不上,链接器只能停下。把定义放回头文件是改动最少的做法,代价是定义要对每个使用它的翻译单元可见。
把定义放回头文件之外,还有两条路可以走。一条是显式实例化,在定义所在的源文件里把要用到的类型全部列出来,编译器当场为它们生成代码,符号表里就有了具体的一份,别的翻译单元只需要声明。另一条是把模板的调用入口收窄到几个具体的重载函数上,由这些重载负责把类型固定下来,模板本身留在实现文件里。前一条适合类型集合固定、愿意在编译期一次性付出代价的场合,后一条适合希望头文件尽量轻、编译时间尽量短的场合,两者都要为每个新增的类型补一次登记。
把定义放进头文件的代价落在编译时间与依赖上:每个包含它的翻译单元都要重新解析一遍模板的定义,用到几个类型就在各自的翻译单元里各实例化一次,参与编译的文件越多,重复的工作越多。常见的做法是把模板的定义与声明放在同一个头文件里,同时把这个头文件的内容控制在必要的范围内,需要多次使用的类型用显式实例化固定在某一处,可以省掉一部分重复的展开工作。
cpp
// 文件:/home/cocatrice/cpp07/exp08/sep_inline.h
template<class T>
T Add(const T& left, const T& right)
{
    return left + right;
}
cpp
// 文件:/home/cocatrice/cpp07/exp08/main_inline.cpp
#include <iostream>
#include "sep_inline.h"
using namespace std;

int main()
{
    int a = 10, b = 20;

    cout << Add(a, b) << endl;
    return 0;
}
这一次编译与链接一起走通,程序打印出 30。想要把定义留在源文件里也可以,在源文件末尾显式把要用的类型实例化出来,让编译器在那里生成符号。
cpp
// 文件:/home/cocatrice/cpp07/exp08/sep_inst.cpp
#include "sep.h"

template<class T>
T Add(const T& left, const T& right)
{
    return left + right;
}

template int Add<int>(const int& left, const int& right);
sep_inst.o 里出现了目标符号,链接顺利通过。
text
# 所属目录:/home/cocatrice/cpp07/exp08
---- g++ -std=c++98 -c sep_inst.cpp -o sep_inst.o ----
---- nm -C sep_inst.o ----
0000000000000000 W int Add<int>(int const&, int const&)
---- g++ -std=c++98 main_sep.o sep_inst.o -o main_inst ----
---- ./main_inst ----
30
显式实例化还有一个附带的好处,它的目标文件比靠调用隐式生成的版本小一点,因为省掉了调用点附近的一层包装,只留下真正被需要的那个函数。
text
# 所属目录:/home/cocatrice/cpp07/inst
---- ls -l inst_impl.o ----
-rw-rw-r-- 1 cocatrice cocatrice 1744 Oct  6 17:56 inst_impl.o
---- ls -l inst_expl.o ----
-rw-rw-r-- 1 cocatrice cocatrice 1600 Oct  6 17:56 inst_expl.o
---- ls -l inst_impl_call.o ----
-rw-rw-r-- 1 cocatrice cocatrice 1752 Oct  6 17:56 inst_impl_call.o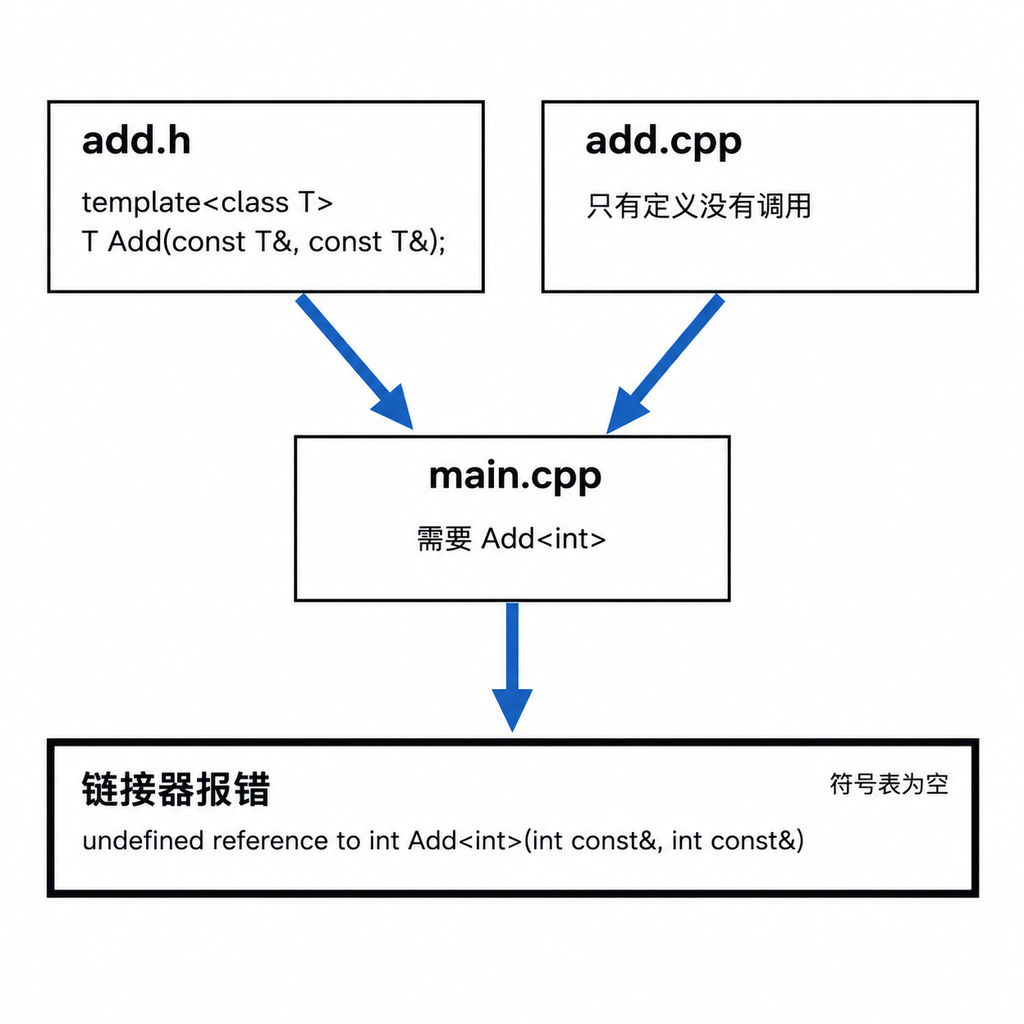
图 8 声明与定义分开放,链接期找不到符号
九、类模板
函数模板把类型参数带进一个函数,类模板把这个参数带进整个类。类的数据成员用它、成员函数的形参与返回值用它,连构造函数里申请的那块空间也由它决定。模板参数列表写在 class 关键字前面,成员函数在类外定义的时候要把 template 与 Stack:: 都写全。
类模板本身不是类型,它是一份生成类的图纸,Stack 这个名字单独出现时既不能声明对象也不能当形参,必须写成 Stack 这样的具体类型。类模板的静态成员也按实例各有一份,Stack 与 Stack 各有一个独立的计数器。模板参数的类型可以是另一个模板的实例,写在源码里的时候把两个右尖括号之间留一个空格,在 c++98 下也不会被当成右移运算符。成员函数可以继续写成模板,类模板加成员模板的组合在写通用容器时很常见;成员函数直接在类体里定义时不需要写全限定名字,编译器会把它当成内联候选,代价是类模板的接口会变得更长。
cpp
// 文件:/home/cocatrice/cpp07/exp09/stack.h
#ifndef STACK_H
#define STACK_H

#include <iostream>
#include <string>
#include <cassert>
using namespace std;

template<class T>
class Stack
{
public:
    Stack(size_t capacity = 4)
        : _array(new T[capacity])
        , _capacity(capacity)
        , _size(0)
    {
    }

    ~Stack()
    {
        delete[] _array;
        _array = 0;
        _capacity = _size = 0;
    }

    void Push(const T& data);
    void Pop();
    T& Top();
    const T& Top() const;
    size_t Size() const;
    bool Empty() const;
    void Print() const;

private:
    void Expand();

    T* _array;
    size_t _capacity;
    size_t _size;
};

template<class T>
void Stack<T>::Expand()
{
    size_t newCapacity = _capacity * 2;
    T* tmp = new T[newCapacity];
    for (size_t i = 0; i < _size; ++i)
    {
        tmp[i] = _array[i];
    }
    delete[] _array;
    _array = tmp;
    _capacity = newCapacity;
}

template<class T>
void Stack<T>::Push(const T& data)
{
    if (_size == _capacity)
    {
        Expand();
    }
    _array[_size++] = data;
}

template<class T>
void Stack<T>::Pop()
{
    assert(_size > 0);
    --_size;
}

template<class T>
T& Stack<T>::Top()
{
    assert(_size > 0);
    return _array[_size - 1];
}

template<class T>
const T& Stack<T>::Top() const
{
    assert(_size > 0);
    return _array[_size - 1];
}

template<class T>
size_t Stack<T>::Size() const
{
    return _size;
}

template<class T>
bool Stack<T>::Empty() const
{
    return _size == 0;
}

template<class T>
void Stack<T>::Print() const
{
    cout << "size=" << _size << " cap=" << _capacity << " data=";
    for (size_t i = 0; i < _size; ++i)
    {
        cout << _array[i] << " ";
    }
    cout << endl;
}

#endif
类模板的用法与函数模板不同,它不能靠实参推导出类型,创建对象时必须把类型写在尖括号里。
用类模板声明指针与声明对象的差别也在这里,Stack* 这样的指针类型可以在类型不完整的时候出现,只要不当场使用成员函数或者申请对象,编译器不需要立刻展开整份类模板,写成对象就要在那一刻把类型定下来。
创建对象时写出来的类型会一路传到成员函数里,构造函数申请空间用的是它,返回值类型与形参类型也是它,写一次名字就把整个类的类型信息固定下来,后面所有成员都按这份类型展开。
cpp
// 文件:/home/cocatrice/cpp07/exp09/main_stack.cpp
#include "stack.h"

int main()
{
    Stack<int> st1;
    cout << st1.Empty() << endl;
    for (int i = 1; i <= 6; ++i)
    {
        st1.Push(i);
    }
    st1.Print();
    cout << st1.Top() << " " << st1.Size() << endl;
    st1.Pop();
    st1.Print();

    Stack<double> st2;
    st2.Push(1.5);
    st2.Push(2.5);
    st2.Print();

    Stack<string> st3(2);
    st3.Push(string("cpp"));
    st3.Push(string("template"));
    st3.Push(string("stack"));
    st3.Print();

    Stack<double>* pst = new Stack<double>;
    pst->Push(9.9);
    pst->Print();
    delete pst;
    return 0;
}
同一个类模板在程序里被三个类型使用,运行结果里的容量变化正好可以看作成员函数按类型各生成了一份。
text
# 所属目录:/home/cocatrice/cpp07/exp09
1
size=6 cap=8 data=1 2 3 4 5 6
6 6
size=5 cap=8 data=1 2 3 4 5
size=2 cap=4 data=1.5 2.5
size=3 cap=4 data=cpp template stack
size=1 cap=4 data=9.9
第一行是空栈的判断,接下来六次 Push 触发了扩容,容量从 4 翻到 8,打印出来是六个元素。Pop 之后元素少了一个,容量仍然是 8。三个类型各自跑在独立的实例上,int 版装数字、double 版装小数、string 版装字符串,互不干扰。可执行文件里的符号清单也按类型分成了三组。
符号清单按类型分成三组,说明类模板的实例化粒度落在成员而不是整个类上,每个被用到的成员函数在每种类型上各生成一份,符号名里带着类名与类型编码。同一个类型只实例化一份,多个调用点共用同一份代码,这一点与函数模板的处理方式相同。三个类型的实例在符号名里都能找到对应的编码,nm 的输出按类型分组,这一条在排查模板造成的体积问题时可以直接拿来对照。
text
# 所属目录:/home/cocatrice/cpp07/exp09
---- nm -C main_stack | grep Stack | head -n 20 ----
0000000000401520 W Stack<double>::Push(double const&)
0000000000401476 W Stack<double>::Stack(unsigned long)
000000000040142e W Stack<int>::Pop()
00000000004013ce W Stack<int>::Top()
00000000004012b0 W Stack<int>::Push(int const&)
00000000004018f0 W Stack<int>::Expand()
00000000004011ee W Stack<int>::Stack(unsigned long)
00000000004017ca W Stack<std::string>::Push(std::string const&)
0000000000401a76 W Stack<std::string>::Expand()
类模板名不带参数列表时无法形成类型,编译器在声明对象的地方就停下来。
cpp
// 文件:/home/cocatrice/cpp07/exp09/err_stack_name.cpp
#include "stack.h"

int main()
{
    Stack st;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/exp09
---- g++ -std=c++98 err_stack_name.cpp -o err_stack_name ----
err_stack_name.cpp: In function 'int main()':
err_stack_name.cpp:5:8: error: missing template arguments before 'st'
  Stack st;
        ^
err_stack_name.cpp:5:8: error: expected ';' before 'st'
---- exit code: 1 ----
成员函数在类外定义时漏掉 template,编译器认不出冒号前面的名字,后面的一串报错都是这个原因带出来的。
cpp
// 文件:/home/cocatrice/cpp07/exp09/err_stack_def.cpp
#include "stack.h"

size_t Stack<T>::Size() const
{
    return _size;
}

int main()
{
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/exp09
---- g++ -std=c++98 err_stack_def.cpp -o err_stack_def ----
err_stack_def.cpp:3:14: error: 'T' was not declared in this scope
 size_t Stack<T>::Size() const
              ^
err_stack_def.cpp:3:15: error: template argument 1 is invalid
 size_t Stack<T>::Size() const
               ^
err_stack_def.cpp:3:25: error: non-member function 'size_t Size()' cannot have cv-qualifier
 size_t Stack<T>::Size() const
                         ^
err_stack_def.cpp: In function 'size_t Size()':
err_stack_def.cpp:5:9: error: '_size' was not declared in this scope
  return _size;
         ^
---- exit code: 1 ----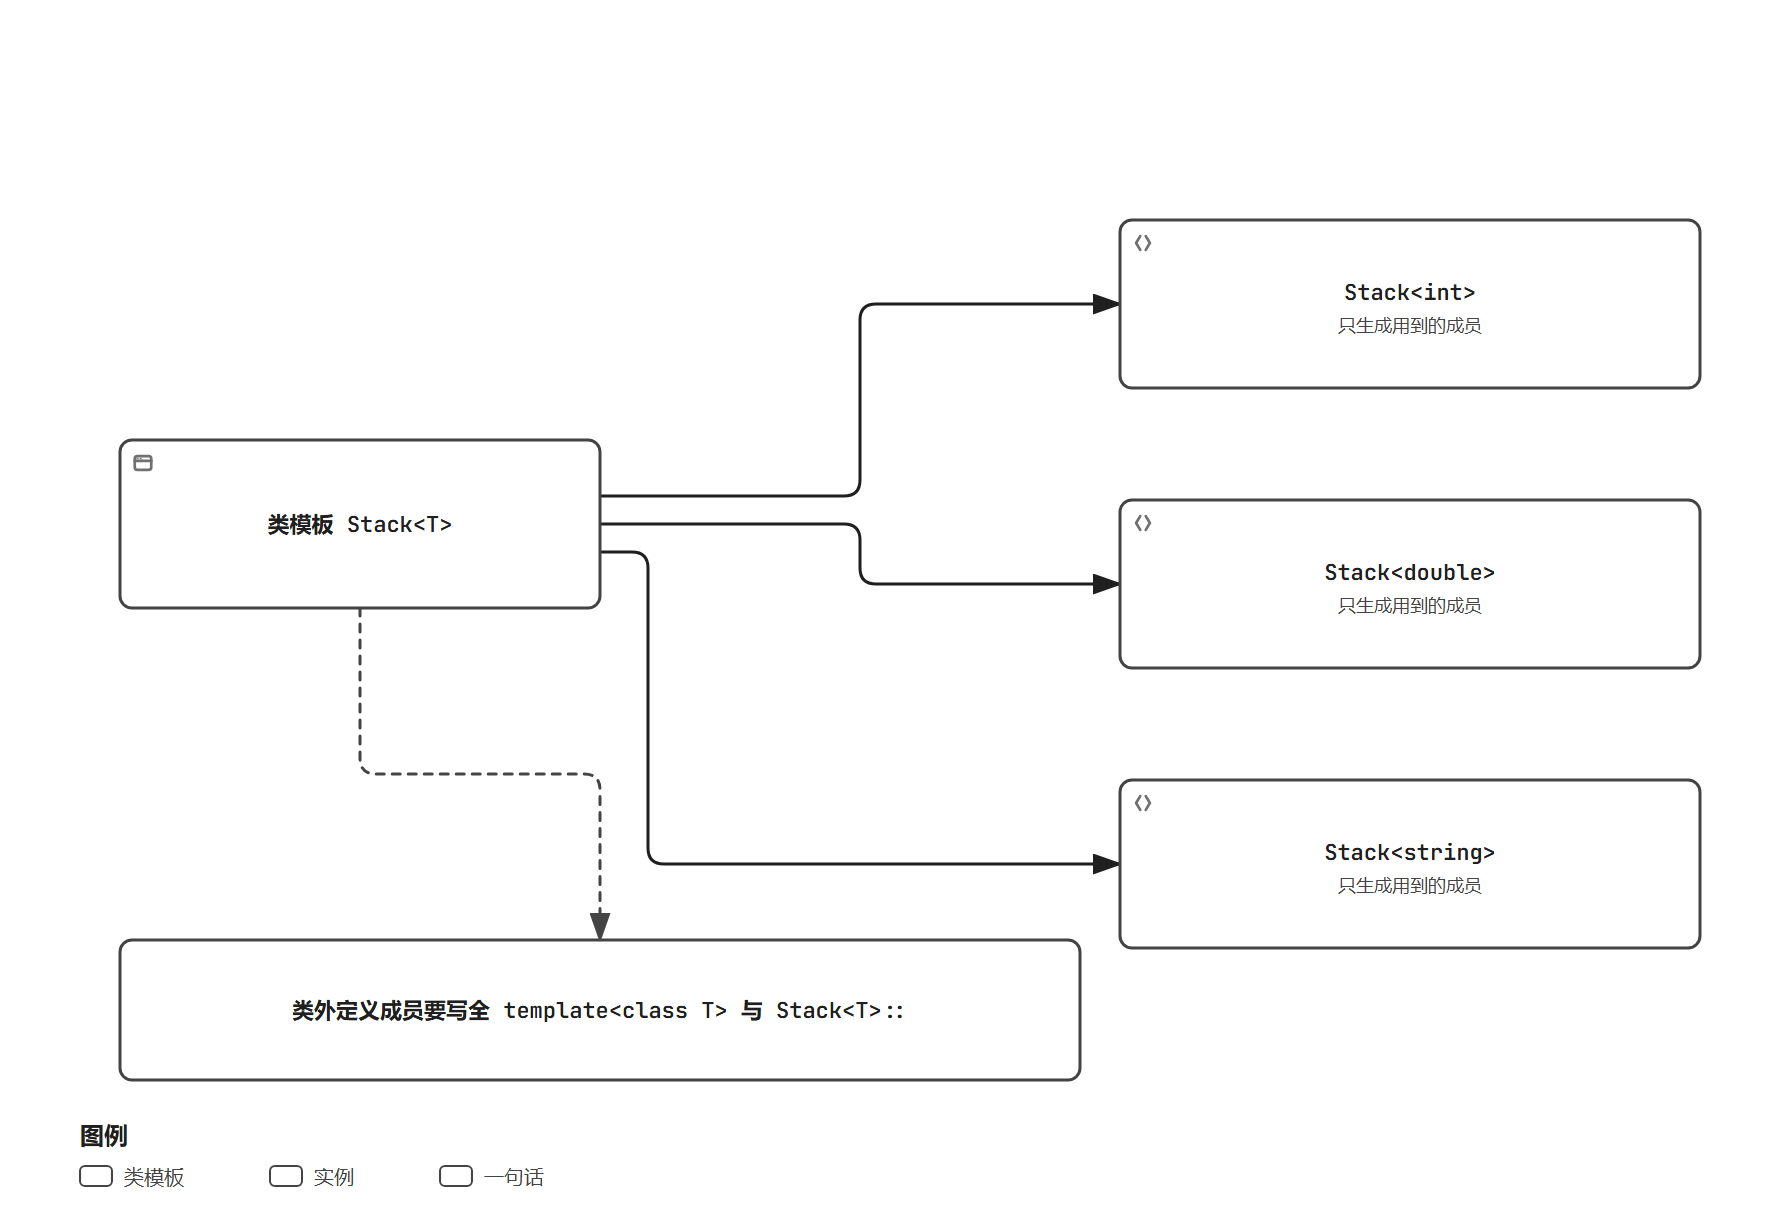
图 9 类模板的实例化
十、类模板的成员何时实例化
类模板里面的成员函数不是跟着类一起全部变成机器码的,编译器只会为真正被用到的成员生成代码。这条规则让没被调用的成员函数可以写得随意一些,代价是里面藏着的错误要等到第一次调用才会暴露出来。
这条规则的设计意图是让模板对类型的要求尽量靠后:容器里那些用不到的成员不必迫使元素类型支持比较、拷贝或者输出,用一个只管读取的类型实例化容器时,编译器不会因为别处写着一个需要写操作的成员而报错,容器可以装进那些接口并不完整的类型。代价落在错误暴露的时间上,成员函数体里的名字与调用要到实例化那一刻才检查,写模板的人需要一个额外的习惯,把每个成员都调用一遍再交付。显式实例化能把这个检查提前,写一行 template class Stack; 就会让编译器为 int 生成整份类模板的全部成员,成员函数体里的错误在那一刻全部暴露,代价是这些代码在最终程序里可能并不会被用到。
cpp
// 文件:/home/cocatrice/cpp07/exp10/use_push.cpp
#include "../exp09/stack.h"

int main()
{
    Stack<int> st;
    st.Push(1);
    st.Push(2);
    return (int)st.Size();
}
cpp
// 文件:/home/cocatrice/cpp07/exp10/use_print.cpp
#include "../exp09/stack.h"

int main()
{
    Stack<int> st;
    st.Push(1);
    st.Print();
    return 0;
}
两份文件都用到了 Push 与构造析构,只有第二份多调了一次 Print,目标文件的符号清单里就多出一行。
text
# 所属目录:/home/cocatrice/cpp07/exp10
---- nm -C use_push.o | grep Stack ----
0000000000000000 W Stack<int>::Push(int const&)
0000000000000000 W Stack<int>::Expand()
0000000000000000 W Stack<int>::Stack(unsigned long)
0000000000000000 W Stack<int>::~Stack()
0000000000000000 W Stack<int>::Size() const
---- nm -C use_print.o | grep Stack ----
0000000000000000 W Stack<int>::Push(int const&)
0000000000000000 W Stack<int>::Expand()
0000000000000000 W Stack<int>::Stack(unsigned long)
0000000000000000 W Stack<int>::~Stack()
0000000000000000 W Stack<int>::Print() const
第一份用到 Size,第二份用到 Print,其余成员两边一致,说明生成哪些成员由调用点决定。下面这个类里有一个函数写着一行不存在的调用,只要不碰它,编译照样通过。
看符号的办法对任何模板都适用:先用 nm 比较两份目标文件的差异,差异里出现的成员就是被实例化的那一个。想让编译器替你把整个类模板检查一遍,可以在某个源文件里写一行显式实例化,把类型写在类模板名后面的尖括号里,编译器会为这个类型生成所有成员,藏在里面的错误一次性暴露出来。
cpp
// 文件:/home/cocatrice/cpp07/exp10/holder.h
template<class T>
class Holder
{
public:
    void Ok() const;
    void Bad() const;

private:
    T _v;
};

template<class T>
void Holder<T>::Ok() const
{
}

template<class T>
void Holder<T>::Bad() const
{
    _v.ThisMemberDoesNotExist();
}
cpp
// 文件:/home/cocatrice/cpp07/exp10/holder_ok.cpp
#include "holder.h"

int main()
{
    Holder<int> h;
    h.Ok();
    return 0;
}
cpp
// 文件:/home/cocatrice/cpp07/exp10/holder_bad.cpp
#include "holder.h"

int main()
{
    Holder<int> h;
    h.Ok();
    h.Bad();
    return 0;
}
调用之后报错才出现,位置落在被实例化的那个成员函数里。
把这份文件与不调用那个成员的那份放在一起比较,编译结果一个通过一个失败,差别只在一行调用语句上,两份源码的其余部分完全相同。
text
# 所属目录:/home/cocatrice/cpp07/exp10
---- g++ -std=c++98 holder_bad.cpp -o holder_bad ----
In file included from holder_bad.cpp:1:0:
holder.h: In instantiation of 'void Holder<T>::Bad() const [with T = int]':
holder_bad.cpp:7:8:   required from here
holder.h:20:2: error: request for member 'ThisMemberDoesNotExist' in '((const Holder<int>*)this)->Holder<int>::_v', which is of non-class type 'const int'
  _v.ThisMemberDoesNotExist();
  ^
---- exit code: 1 ----
十一、模板参数不只是类型
模板参数列表里除了 class 与 typename 修饰的类型参数,还可以直接写一个值,常见的写法是一个整数。它带来的好处是把一些计算与检查提前到编译期完成,数组的长度、越界判断、需要展开的层数都可以交给它。
非类型参数的实参必须在编译期就是一个常量,字面量、常量表达式、静态常量成员以及地址能确定的实体都可以,运行期算出来的变量不行。c++98 对非类型参数的限制比较严,浮点数与类类型的对象不允许当模板参数,指针与引用参数要求指向具有外部链接的对象,c++11 放宽了一部分,浮点数的约束仍然保留。把计算搬到编译期之后,运行期只剩下结果的读取,数组边界的检查与递归求值都不需要循环参与,这类写法在标准库的类型萃取与容器实现里用得很多。
cpp
// 文件:/home/cocatrice/cpp07/exp11/array.h
#ifndef ARRAY_H
#define ARRAY_H

#include <cstddef>
#include <cassert>

template<class T, size_t N>
class Array
{
public:
    T& operator[](size_t i);
    const T& operator[](size_t i) const;
    size_t Size() const;

    template<size_t Index>
    T& At();

private:
    T _data[N];
};

template<class T, size_t N>
T& Array<T, N>::operator[](size_t i)
{
    assert(i < N);
    return _data[i];
}

template<class T, size_t N>
const T& Array<T, N>::operator[](size_t i) const
{
    assert(i < N);
    return _data[i];
}

template<class T, size_t N>
size_t Array<T, N>::Size() const
{
    return N;
}

template<class T, size_t N>
template<size_t Index>
T& Array<T, N>::At()
{
    static_assert(Index < N, "Index out of range");
    return _data[Index];
}

#endif
数组的长度 N 是模板参数,sizeof 在编译期就能算出准确大小,越界的下标也会在编译期被拦下。
长度参数进入类型之后,不同的长度就是不同的类型,Array<int, 4> 与 Array<int, 8> 之间不能互相赋值,编译器把它们当成两个没有关系的类处理,这一点让越界检查有了一个统一的落点。
cpp
// 文件:/home/cocatrice/cpp07/exp11/main_array.cpp
#include <iostream>
#include "array.h"
using namespace std;

int main()
{
    Array<int, 4> a4;
    Array<int, 8> a8;
    Array<double, 4> d4;

    cout << sizeof(a4) << " " << a4.Size() << endl;
    cout << sizeof(a8) << " " << a8.Size() << endl;
    cout << sizeof(d4) << " " << d4.Size() << endl;

    a4[0] = 10;
    a4[3] = 40;
    cout << a4[0] << " " << a4[3] << endl;
    cout << a4.At<2>() << endl;

    a8[7] = 70;
    cout << a8[7] << endl;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/exp11
16 4
32 8
32 4
10 40
4196304
70
前两行是一个 int 数组与一个 double 数组的总字节数与元素个数,第三行是同一个类模板换了长度参数之后的差别。第五行的 4196304 是 a4 中间那个还没有赋过值的元素,读出来是不确定的数字,真实代码里应该像前面的元素那样先写入再读取。最后一行落在 At<4> 之外的越界检查上,下面把下标写成超出范围的值。
越界的检查写在 At 里面用静态断言实现,调用点把下标写成超出范围的常量时,编译器当场停下,运行期不会走到这一步。
cpp
// 文件:/home/cocatrice/cpp07/exp11/err_at.cpp
#include <iostream>
#include "array.h"
using namespace std;

int main()
{
    Array<int, 4> a4;
    cout << a4.At<4>() << endl;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/exp11
In file included from err_at.cpp:2:0:
array.h: In instantiation of 'T& Array<T, N>::At() [with long unsigned int Index = 4ul; T = int; long unsigned int N = 4ul]':
err_at.cpp:8:19:   required from here
array.h:46:2: error: static assertion failed: Index out of range
  static_assert(Index < N, "Index out of range");
  ^
---- exit code: 1 ----
静态断言里的条件在编译期求值,失败时直接停止编译,运行期根本走不到那一步。整数值还能参与更复杂的编译期计算,下面这个求阶乘的结构体在编译期就把结果算好了。
编译期计算也有代价,递归实例化会让编译器展开一串模板,层数多了编译时间与内存占用都会上升,编译器对递归深度还设有一个上限,超出之后报的是实例化层数过深。把计算规模限制在编译器能承受的范围内,是使用这类技巧时的常规做法。
cpp
// 文件:/home/cocatrice/cpp07/exp11/factorial.cpp
#include <iostream>
using namespace std;

template<int N>
struct Factorial
{
    enum { value = N * Factorial<N - 1>::value };
};

template<>
struct Factorial<0>
{
    enum { value = 1 };
};

int main()
{
    cout << Factorial<0>::value << endl;
    cout << Factorial<5>::value << endl;
    cout << Factorial<10>::value << endl;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/exp11
1
120
3628800
三个结果分别来自 0 的特化、5 的递归与 10 的递归,程序里没有写循环,值在编译期就算完了。模板参数还能带默认值,类模板与函数模板在这里的规矩不一样。
递归模板的展开过程在编译期完成,实例化的层数就是递归的深度,写成循环也能得到同样的结果,区别在于求值的时刻与代码的形态,编译期求出来的值可以直接用在模板参数与数组长度上。
cpp
// 文件:/home/cocatrice/cpp07/exp11/default_tpl.cpp
#include <iostream>
using namespace std;

template<class T = int, size_t N = 8>
class Buffer
{
public:
    size_t Size() const { return N; }
    size_t Width() const { return sizeof(T); }
};

int main()
{
    Buffer<> b1;
    Buffer<double> b2;
    Buffer<char, 16> b3;

    cout << b1.Size() << " " << b1.Width() << endl;
    cout << b2.Size() << " " << b2.Width() << endl;
    cout << b3.Size() << " " << b3.Width() << endl;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/exp11
8 4
8 8
16 1
第一次创建对象时两个参数都用了默认值,第二次只给出元素类型、长度取默认的 8,第三次两个都写出来。同样的默认参数写在函数模板上,在 c++98 的编译选项下会被拒绝。
默认模板参数的规矩在类模板与函数模板之间并不相同:类模板的模板参数从 C++ 的第一个标准版本起就可以带默认值,函数模板的默认模板参数要等到 c++11 才被接受,在 c++98 的选项下写同样的代码会被编译器直接拒绝,报错的说法是函数模板不允许使用默认模板参数。
cpp
// 文件:/home/cocatrice/cpp07/exp11/default_fn.cpp
template<class T = int>
T func()
{
    return T();
}

int main()
{
    return func();
}
text
# 所属目录:/home/cocatrice/cpp07/exp11
---- g++ -std=c++98 default_fn.cpp -o default_fn ----
default_fn.cpp:2:8: error: default template arguments may not be used in function templates without -std=c++11 or -std=gnu++11
 T func()
        ^
default_fn.cpp: In function 'int main()':
default_fn.cpp:9:14: error: no matching function for call to 'func()'
  return func();
              ^
default_fn.cpp:9:14: note: candidate is:
default_fn.cpp:2:3: note: template<class T> T func()
 T func()
   ^
default_fn.cpp:2:3: note:   template argument deduction/substitution failed:
default_fn.cpp:9:14: note:   couldn't deduce template parameter 'T'
  return func();
              ^
---- exit code: 1 ----
---- g++ -std=c++11 default_fn.cpp -o default_fn11 ----
---- exit code: 0 ----
换成 c++11 之后同一个文件编译通过,这条限制在后续的语言版本里已经放开。
实例代码
工程结构
text
# 所属目录:/home/cocatrice/cpp07
---- find demo -maxdepth 1 -type f -name '*.h' -o -name '*.cpp' | sort ----
demo/array.h
demo/edge1.cpp
demo/edge2.cpp
demo/edge2_old.cpp
demo/edge3.cpp
demo/edge4.cpp
demo/err1.cpp
demo/err1_fix.cpp
demo/err2.cpp
demo/err3_bad.cpp
demo/err3.cpp
demo/err4.cpp
demo/generic.h
demo/main.cpp
demo/stack.h
demo/stack_old.h
---- wc -l demo/generic.h demo/stack.h demo/array.h demo/main.cpp ----
  33 demo/generic.h
 102 demo/stack.h
  50 demo/array.h
  51 demo/main.cpp
 236 total
---- ls -l demo/demo ----
-rwxrwxr-x 1 cocatrice cocatrice 20064 Oct  6 17:56 demo/demo
generic.h 装函数模板,stack.h 与 array.h 装类模板,main.cpp 是调用点。err 开头的是常见报错的样例,edge 开头的是边界情况的样例,两组文件各自独立编译,互不影响。前面每一个结论都有一组独立的小程序放在 exp01 到 exp11 目录里,主工程的目录只留下最终要交付的文件。
目录这样安排是为了让每个结论都能单独复现:主工程的三个头文件与主文件放在一起编译,只看最终行为;每个结论对应的验证程序各自独立成一个目录,编译命令与输出只依赖那一两个文件,出问题时影响范围清楚。实测的部分把编译产物、符号清单与对象的内存布局放在一起对照,判断依据落在目标文件上。实测部分的输出都在同一台机器上取得,编译命令写在每个代码块的第一行,回显与正文的判断一一对应,照着重跑可以得到同样的结果。
text
# 所属目录:/home/cocatrice/cpp07
---- for d in exp01 exp02 exp03 exp04 exp05 exp06 exp07 exp08 exp09 exp10 exp11 inst demo; do printf "%s %s" "$d" "$(find "$d" -maxdepth 1 -type f | wc -l)"; done ----
exp01 6
exp02 7
exp03 8
exp04 4
exp05 10
exp06 6
exp07 9
exp08 11
exp09 5
exp10 8
exp11 10
inst 26
demo 25
完整代码
cpp
// 文件:/home/cocatrice/cpp07/demo/generic.h
#ifndef GENERIC_H
#define GENERIC_H

#include <iostream>
using namespace std;

template<class T>
void Swap(T& left, T& right)
{
    T temp = left;
    left = right;
    right = temp;
}

template<typename T>
const T& Max(const T& left, const T& right)
{
    return left < right ? right : left;
}

template<class T>
T Add(const T& left, const T& right)
{
    return left + right;
}

template<class T1, class T2>
T1 Add(const T1& left, const T2& right)
{
    return left + right;
}

#endif
cpp
// 文件:/home/cocatrice/cpp07/demo/stack.h
#ifndef STACK_H
#define STACK_H

#include <iostream>
#include <cassert>
using namespace std;

template<class T>
class Stack
{
public:
    Stack(size_t capacity = 4);
    ~Stack();
    void Push(const T& data);
    void Pop();
    T& Top();
    const T& Top() const;
    size_t Size() const;
    bool Empty() const;

private:
    void Expand();

    T* _array;
    size_t _capacity;
    size_t _size;
};

template<class T>
Stack<T>::Stack(size_t capacity)
    : _array(new T[capacity])
    , _capacity(capacity)
    , _size(0)
{
}

template<class T>
Stack<T>::~Stack()
{
    delete[] _array;
    _array = 0;
    _capacity = _size = 0;
}

template<class T>
void Stack<T>::Expand()
{
    size_t newCapacity = _capacity == 0 ? 4 : _capacity * 2;
    T* tmp = new T[newCapacity];
    for (size_t i = 0; i < _size; ++i)
    {
        tmp[i] = _array[i];
    }
    delete[] _array;
    _array = tmp;
    _capacity = newCapacity;
}

template<class T>
void Stack<T>::Push(const T& data)
{
    if (_size == _capacity)
    {
        Expand();
    }
    _array[_size++] = data;
}

template<class T>
void Stack<T>::Pop()
{
    assert(_size > 0);
    --_size;
}

template<class T>
T& Stack<T>::Top()
{
    assert(_size > 0);
    return _array[_size - 1];
}

template<class T>
const T& Stack<T>::Top() const
{
    assert(_size > 0);
    return _array[_size - 1];
}

template<class T>
size_t Stack<T>::Size() const
{
    return _size;
}

template<class T>
bool Stack<T>::Empty() const
{
    return _size == 0;
}

#endif
cpp
// 文件:/home/cocatrice/cpp07/demo/array.h
#ifndef ARRAY_H
#define ARRAY_H

#include <cstddef>
#include <cassert>

template<class T, size_t N>
class Array
{
public:
    T& operator[](size_t i);
    const T& operator[](size_t i) const;
    size_t Size() const;

    template<size_t Index>
    T& At();

private:
    T _data[N];
};

template<class T, size_t N>
T& Array<T, N>::operator[](size_t i)
{
    assert(i < N);
    return _data[i];
}

template<class T, size_t N>
const T& Array<T, N>::operator[](size_t i) const
{
    assert(i < N);
    return _data[i];
}

template<class T, size_t N>
size_t Array<T, N>::Size() const
{
    return N;
}

template<class T, size_t N>
template<size_t Index>
T& Array<T, N>::At()
{
    static_assert(Index < N, "Index out of range");
    return _data[Index];
}

#endif
cpp
// 文件:/home/cocatrice/cpp07/demo/main.cpp
#include <iostream>
#include <string>
#include "generic.h"
#include "stack.h"
#include "array.h"
using namespace std;

int main()
{
    int a = 10, b = 20;
    double c = 1.5, d = 2.5;
    string s1("left"), s2("right");

    Swap(a, b);
    Swap(c, d);
    Swap(s1, s2);
    cout << a << " " << b << endl;
    cout << c << " " << d << endl;
    cout << s1 << " " << s2 << endl;

    cout << Max(a, b) << endl;
    cout << Max(s1, s2) << endl;

    cout << Add(a, b) << endl;
    cout << Add(a, d) << endl;
    cout << Add<double>(a, d) << endl;

    Stack<int> st;
    for (int i = 1; i <= 6; ++i)
    {
        st.Push(i);
    }
    cout << st.Size() << " " << st.Top() << endl;
    st.Pop();
    cout << st.Size() << " " << st.Top() << endl;

    Stack<string> ss(0);
    ss.Push(string("template"));
    cout << ss.Size() << " " << ss.Top() << endl;

    Array<int, 4> arr;
    for (size_t i = 0; i < arr.Size(); ++i)
    {
        arr[i] = (int)i * 10;
    }
    cout << sizeof(arr) << " " << arr.Size() << " " << arr[3] << " " << arr.At<2>() << endl;

    Array<double, 8> darr;
    cout << sizeof(darr) << " " << darr.Size() << endl;
    return 0;
}
正常情况
text
# 所属目录:/home/cocatrice/cpp07/demo
---- g++ -std=c++11 -Wall main.cpp -o demo ----
---- ./demo ----
20 10
2.5 1.5
right left
20
right
30
21
21.5
6 6
5 5
1 template
16 4 30 20
64 8
前三行是 Swap 的结果,int 与 double 各走一份特化,string 用赋值交换。第四行与第五行是 Max 的结果,两个模板参数推导出 const T&,返回的是引用,打印出来没有任何临时对象参与。第六行到第八行是三个 Add 的对照:Add(a, b) 走单参数模板得到 30;Add(a, d) 走双参数模板,返回值是 T1 也就是 int,20 加 1.5 得到 21.5 之后被截成 21;Add(a, d) 显式指定了类型,结果是 21.5。
留意 Add(a, d) 那一次调用的返回值,双参数模板返回的是 T1,也就是 int,两个实参相加得到的 21.5 在返回时被截成 21,这个结果与显式写成 Add(a, d) 得到的 21.5 放在一起看,能说明返回类型跟着模板参数 T1 走。
同一份输出把函数模板与类模板的结果放在一起,判断行为时按行对照调用点,任何一行与预期不符都能顺着符号清单追到是哪一份实例的问题。
后面几行输出来自类模板的调用,容量与元素个数按类型各记一份。Stack 压入六个元素之后容量从 4 翻到 8,Size 与 Top 打印出 6 与 6,Pop 之后变成 5 与 5。Stack 用容量 0 起手,第一次 Push 时 Expand 把容量提到 4,所以打印出 1 与 template。Array<int, 4> 占 16 字节、长度为 4,下标 3 与 At<2>() 分别取到 30 与 20。Array<double, 8> 占 64 字节、长度为 8,长度由模板参数决定,与元素类型无关。
Stack 那一次的容量从 0 直接提到 4,走的是扩容函数里对零容量的单独处理,这一点在边界情况里还会再出现一次。
常见报错
第一类错发生在实参推导阶段,两个实参的类型不同,单参数的模板推不出唯一的 T。
cpp
// 文件:/home/cocatrice/cpp07/demo/err1.cpp
#include <iostream>
using namespace std;

template<class T>
T Add(const T& left, const T& right)
{
    return left + right;
}

int main()
{
    int a = 10;
    double d = 2.5;

    cout << Add(a, d) << endl;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/demo
---- g++ -std=c++11 err1.cpp -o err1 ----
err1.cpp: In function 'int main()':
err1.cpp:15:18: error: no matching function for call to 'Add(int&, double&)'
  cout << Add(a, d) << endl;
                  ^
err1.cpp:15:18: note: candidate is:
err1.cpp:5:3: note: template<class T> T Add(const T&, const T&)
 T Add(const T& left, const T& right)
   ^
err1.cpp:5:3: note:   template argument deduction/substitution failed:
err1.cpp:15:18: note:   deduced conflicting types for parameter 'const T' ('int' and 'double')
  cout << Add(a, d) << endl;
                  ^
---- exit code: 1 ----
改成显式指定类型或者在调用处把两个实参凑成同一种类型都能过,下面把两种改法写在同一个文件里。
cpp
// 文件:/home/cocatrice/cpp07/demo/err1_fix.cpp
#include <iostream>
using namespace std;

template<class T>
T Add(const T& left, const T& right)
{
    return left + right;
}

int main()
{
    int a = 10;
    double d = 2.5;

    cout << Add(a, (int)d) << endl;
    cout << Add<int>(a, d) << endl;
    cout << Add<double>(a, d) << endl;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/demo
---- g++ -std=c++11 err1_fix.cpp -o err1_fix ----
---- ./err1_fix ----
12
12
12.5
前两行的 12 来自两次不同的写法,一次把第二个实参转成 int,一次把返回类型显式指定成 double;第三行用双参数模板让类型各推各的,得到 12.5。
第二类错发生在类的名字上,类模板不带参数列表就不是一个类型。
这几类错分布在不同阶段:名字与语法的问题在编译前期就能发现,实参推导的冲突落在重载决议阶段,成员函数体里的错误要等到实例化那一刻才出现,静态断言则在实例化时当场停止编译。看报错时先分辨属于哪一类,再决定是改调用点还是改模板定义。四类错误对应四种处理方式:推导冲突改调用点或者加一层显式类型,类的名字缺参数列表就补上尖括号,延迟暴露的错误在交付前把所有成员都调用一遍,静态断言则直接改代码里的常量。
cpp
// 文件:/home/cocatrice/cpp07/demo/err2.cpp
#include "stack.h"

int main()
{
    Stack st;
    st.Push(1);
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/demo
---- g++ -std=c++11 err2.cpp -o err2 ----
err2.cpp: In function 'int main()':
err2.cpp:5:8: error: missing template arguments before 'st'
  Stack st;
        ^
err2.cpp:5:8: error: expected ';' before 'st'
err2.cpp:6:2: error: 'st' was not declared in this scope
  st.Push(1);
  ^
---- exit code: 1 ----
第三类错是前面提过的延迟暴露,成员函数里写着一行不存在的调用,只要没人调用这个成员,编译不报错,程序照常运行。
这类错误的排查思路是先让编译器给出实例化链,报错里的那行 In instantiation of 指明了是哪一次调用把成员函数拉进了编译范围。
cpp
// 文件:/home/cocatrice/cpp07/demo/err3.cpp
#include <iostream>
#include "generic.h"
using namespace std;

template<class T>
class Box
{
public:
    void Show() const;
    void Dump() const;

private:
    T _v;
};

template<class T>
void Box<T>::Show() const
{
}

template<class T>
void Box<T>::Dump() const
{
    _v.WriteToFile();
}

int main()
{
    Box<int> b;
    b.Show();
    cout << "ok" << endl;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/demo
---- g++ -std=c++11 err3.cpp -o err3 ----
---- exit code: 0 ----
---- ./err3 ----
ok
把注释掉的那次调用放开,两份文件的差别只有一行,报错立刻出现,位置落在被实例化的那个成员里。
cpp
// 文件:/home/cocatrice/cpp07/demo/err3_bad.cpp
#include <iostream>
#include "generic.h"
using namespace std;

template<class T>
class Box
{
public:
    void Show() const;
    void Dump() const;

private:
    T _v;
};

template<class T>
void Box<T>::Show() const
{
}

template<class T>
void Box<T>::Dump() const
{
    _v.WriteToFile();
}

int main()
{
    Box<int> b;
    b.Show();
    b.Dump();
    cout << "ok" << endl;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/demo
err3_bad.cpp: In instantiation of 'void Box<T>::Dump() const [with T = int]':
err3_bad.cpp:31:9:   required from here
err3_bad.cpp:24:2: error: request for member 'WriteToFile' in '((const Box<int>*)this)->Box<int>::_v', which is of non-class type 'const int'
  _v.WriteToFile();
  ^
---- exit code: 1 ----
第四类错由静态断言给出,越界下标在编译期就被拦下,编译器的提示里还带着推导出来的 Index 与 N。
cpp
// 文件:/home/cocatrice/cpp07/demo/err4.cpp
#include <iostream>
#include "array.h"
using namespace std;

int main()
{
    Array<int, 4> arr;
    cout << arr.At<4>() << endl;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/demo
In file included from err4.cpp:2:0:
array.h: In instantiation of 'T& Array<T, N>::At() [with long unsigned int Index = 4ul; T = int; long unsigned int N = 4ul]':
err4.cpp:8:20:   required from here
array.h:46:2: error: static assertion failed: Index out of range
  static_assert(Index < N, "Index out of range");
  ^
---- exit code: 1 ----
边界情况
空栈取栈顶是运行期的问题,断言在成员函数里生效,程序异常结束。
断言属于程序自己加上的检查,前提是写的人已经知道哪里会出问题并主动写下判断,越界写这类错误一旦漏掉断言,表现就是程序继续跑下去而内存已经被踩坏。下面那三次 Push 的越界写在普通运行里看不出任何异常,只有把程序放进 valgrind 才暴露出来。断言与 valgrind 各管一段:断言覆盖程序里预先想到的非法状态,valgrind 覆盖那些没有被写出来的越界访问与未初始化读,两者配合才能把边界情况看全。
cpp
// 文件:/home/cocatrice/cpp07/demo/edge1.cpp
#include <iostream>
#include "stack.h"
using namespace std;

int main()
{
    Stack<int> st;
    cout << st.Empty() << endl;
    cout << st.Top() << endl;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/demo
---- g++ -std=c++11 edge1.cpp -o edge1 ----
---- ./edge1 ----
1
edge1: stack.h:79: T& Stack<T>::Top() [with T = int]: Assertion `_size > 0' failed.
---- exit code: 134 ----
第一行的 1 是空栈判断的结果,第二行之后进程被断言终止。容量为 0 起手的栈在扩容逻辑里绕开了乘 2 的陷阱,第一次 Push 时容量直接给到 4。
容量为 0 起手的写法在扩容里要单独判断,第一次 Push 时直接把容量提到一个非零值,后面按倍数增长,把这一步写进 Expand 就能避开长度为 0 的空间。
cpp
// 文件:/home/cocatrice/cpp07/demo/edge2.cpp
#include <iostream>
#include "stack.h"
using namespace std;

int main()
{
    Stack<int>* p = new Stack<int>(0);
    p->Push(1);
    cout << p->Size() << " " << p->Top() << endl;
    delete p;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/demo
---- g++ -std=c++11 edge2.cpp -o edge2 ----
---- timeout 3 ./edge2 ----
1 1
按值传递的形参会把数组退化成指针,写成引用加长度参数的重载能保住数组的维度,两个重载放在一起时更匹配的那个被选中。
重载放在一起时按实参的匹配程度挑,数组名传给带长度的引用版本不需要退化,传给按值传递的版本要丢掉维度,编译器选了代价更低的那一个。
cpp
// 文件:/home/cocatrice/cpp07/demo/edge3.cpp
#include <iostream>
using namespace std;

template<class T>
size_t Len(T v)
{
    return sizeof(v);
}

template<class T, size_t N>
size_t Len(T (&arr)[N])
{
    return N;
}

int main()
{
    int a[5] = {0};
    int* p = a;

    cout << Len(a) << endl;
    cout << Len(p) << endl;
    cout << Len(5) << endl;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/demo
---- g++ -std=c++11 -Wall edge3.cpp -o edge3 ----
---- ./edge3 ----
5
8
4
第一次调用选中了带长度参数的版本,返回数组长度 5;第二次传的是指针,退回按值传递的版本,返回指针的 8;第三次传的是 int,返回 4。类模板的类型参数也可以是指针或者另一个类模板的实例,嵌套写法在两个右尖括号之间留一个空格即可。
cpp
// 文件:/home/cocatrice/cpp07/demo/edge4.cpp
#include <iostream>
#include "stack.h"
using namespace std;

int main()
{
    Stack<char*> st;
    char buf[8] = "edge";
    st.Push(buf);
    cout << st.Size() << " " << st.Top() << endl;

    Stack<Stack<int> > nested;
    Stack<int> inner;
    inner.Push(7);
    nested.Push(inner);
    cout << nested.Top().Top() << endl;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/demo
---- g++ -std=c++11 -Wall edge4.cpp -o edge4 ----
---- ./edge4 ----
1 edge
7
最后看扩容里写成 _capacity * 2 的老版本,容量为 0 时它一直停在 0,越界的写不会让程序立刻崩掉,普通运行看不出来。
普通运行没有异常并不代表代码正确,越界写入的地址落在分配器给出的相邻空间里,程序继续往下跑,错误被推迟到某个不确定的时刻才表现出来。
cpp
// 文件:/home/cocatrice/cpp07/demo/edge2_old.cpp
#include <iostream>
#include "stack_old.h"
using namespace std;

int main()
{
    StackOld<int> st(0);
    st.Push(1);
    cout << st.Size() << endl;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/demo
---- g++ -std=c++11 edge2_old.cpp -o edge2_old ----
---- timeout 3 ./edge2_old ----
1
---- exit code: 0 ----
把最后一次 Push 换成三次,再用 valgrind 检查堆上的写操作,三处越界写在同一块长度为 0 的空间之后。
cpp
// 文件:/home/cocatrice/cpp07/inst/edge_zero.cpp
#include <iostream>
#include "stack_old.h"
using namespace std;

int main()
{
    StackOld<int> st(0);
    st.Push(1);
    st.Push(2);
    st.Push(3);
    cout << st.Size() << " " << st.Capacity() << endl;
    return 0;
}
text
# 所属目录:/home/cocatrice/cpp07/inst
---- g++ -std=c++11 -g edge_zero.cpp -o edge_zero ----
---- timeout 3 ./edge_zero ----
3 0
---- valgrind --error-exitcode=9 ./edge_zero ----
==26723== Invalid write of size 4
==26723==    at 0x400C73: StackOld<int>::Push(int const&) (stack_old.h:33)
==26723==    by 0x4009E0: main (edge_zero.cpp:8)
==26723==  Address 0x5aafcc0 is 0 bytes after a block of size 0 alloc'd
==26723==    at 0x4C2AC38: operator new[](unsigned long) (vg_replace_malloc.c:433)
==26723==    by 0x400BC5: StackOld<int>::Push(int const&) (stack_old.h:24)
==26723==    by 0x4009E0: main (edge_zero.cpp:8)
==26723== Invalid write of size 4
==26723==    at 0x400C73: StackOld<int>::Push(int const&) (stack_old.h:33)
==26723==    by 0x4009FA: main (edge_zero.cpp:9)
==26723==  Address 0x5aafcc4 is 4 bytes after a block of size 0 alloc'd
==26723== Invalid write of size 4
==26723==    at 0x400C73: StackOld<int>::Push(int const&) (stack_old.h:33)
==26723==    by 0x400A14: main (edge_zero.cpp:10)
==26723==  Address 0x5aafcc8 is 8 bytes after a block of size 0 alloc'd
==26723== ERROR SUMMARY: 3 errors from 3 contexts (suppressed: 0 from 0)
---- valgrind exit code: 9 ----
三次 Push 都写在容量为 0 的那块空间之后,程序自己不会发现,只有 valgrind 这样的工具才看得见,容量从 0 起手的写法必须单独处理。
实测数据
第一组数据用一个模板在四种类型上各调一次,比较目标文件与可执行文件的体积。
读这组数据时把目标文件与可执行文件分开看:目标文件里躺着所有实例化出来的特化,链接之后的段大小反映的是这些特化经过合并与内联之后真正留在代码里的部分。判断代码膨胀的依据应当落在可执行文件的 text 段上,只看源码里类型的个数会高估影响。下面三组数据分别从体积、符号数量与类模板的角度看同一件事,读的时候把每一组的目标文件与可执行文件放在一起对照。
text
# 所属目录:/home/cocatrice/cpp07/inst
---- g++ -std=c++98 -O0 -c one.cpp -o one.o ----
---- g++ -std=c++98 -O0 -c two.cpp -o two.o ----
---- g++ -std=c++98 -O0 -c four.cpp -o four.o ----
---- ls -l one.o two.o four.o ----
-rw-rw-r-- 1 cocatrice cocatrice 2952 Oct  6 17:56 four.o
-rw-rw-r-- 1 cocatrice cocatrice 1704 Oct  6 17:56 one.o
-rw-rw-r-- 1 cocatrice cocatrice 2152 Oct  6 17:56 two.o
---- size one two four ----
   text	   data	    bss	    dec	    hex	filename
   1270	    588	      4	   1862	    746	one
   1430	    588	      4	   2022	    7e6	two
   1638	    588	      4	   2230	    8b6	four
三个可执行文件用到的类型数量分别是 1、2、4,text 段从 1270 涨到 1430 再涨到 1638,每多一个类型就多出一段代码。four.o 里的符号各自占了多少字节也打印得出来。
体积的增长与类型的复杂程度有关,简单类型生成的函数短,带浮点运算与较大栈帧的类型生成的函数长,四种类型的差距在 text 段的字节数上摆得很清楚。
text
# 所属目录:/home/cocatrice/cpp07/inst
---- nm -C --size-sort four.o ----
000000000000001c W int Add<int>(int const&, int const&)
000000000000001f W long Add<long>(long const&, long const&)
0000000000000020 W char Add<char>(char const&, char const&)
0000000000000034 W double Add<double>(double const&, double const&)
00000000000000ad T main
0x1c、0x1f、0x20 与 0x34 分别是 28、31、32 与 52 字节,简单类型生成的代码短,double 版最长。开上 -O2 之后这些特化会被内联进调用点,符号表里只剩下 main。
判断模板造成的体积增长有三条可用的手段:数一数目标文件里的弱符号个数,比较不同实例集合的可执行文件 text 段字节数,再看用到的成员函数覆盖了多少个类型,三条结果放在一起才能区分是类型数量的问题还是单个类型代码过长的问题。
text
# 所属目录:/home/cocatrice/cpp07/inst
---- nm -C two_O2.o ----
0000000000000000 T main
---- ls -l two.o two_O2.o ----
-rw-rw-r-- 1 cocatrice cocatrice 2152 Oct  6 17:56 two.o
-rw-rw-r-- 1 cocatrice cocatrice 1320 Oct  6 17:56 two_O2.o
第二组数据数一数符号的个数,一个模板在两种类型上各调一次,目标文件里就是两个弱符号。
text
# 所属目录:/home/cocatrice/cpp07/inst
---- nm -C two_sym.o ----
0000000000000000 T main
0000000000000000 W double Add<double>(double const&, double const&)
0000000000000000 W int Add<int>(int const&, int const&)
---- nm -C two_sym.o | grep -c Add ----
2
第三组数据换成一个类模板被三个类型使用,符号数量按类型成倍增长。
text
# 所属目录:/home/cocatrice/cpp07/inst
---- nm -C usestack.o | grep -c 'Stack<' ----
27
---- ls -l usestack.o ----
-rw-rw-r-- 1 cocatrice cocatrice 12784 Oct  6 17:56 usestack.o
每个类型各有一份构造、析构、Push、Expand 与 Size,三个类型加起来是 27 个符号,目标文件涨到 12784 字节。
类模板的符号数量按类型乘以成员的个数增长,用到三个类型的实现在符号表里就是三倍于单个类型的行数,目标文件的体积随之上升,这一条在容器类上表现得比函数模板更明显。符号数量与体积的关系在类模板上更直接,成员越多、类型越多,目标文件里的实例越多,可执行文件里能合并的部分由链接器处理。
实例
最后用一个排序的例子把模板的意义摆出来:三种类型各写一遍冒泡排序,与写成一份模板的版本比较行数和运行结果。
cpp
// 文件:/home/cocatrice/cpp07/inst/sort_overload.cpp
#include <iostream>
#include <string>
using namespace std;

void BubbleSort(int* a, int n)
{
    for (int i = 0; i < n - 1; ++i)
    {
        for (int j = 0; j < n - 1 - i; ++j)
        {
            if (a[j] > a[j + 1])
            {
                int t = a[j];
                a[j] = a[j + 1];
                a[j + 1] = t;
            }
        }
    }
}

void BubbleSort(double* a, int n)
{
    for (int i = 0; i < n - 1; ++i)
    {
        for (int j = 0; j < n - 1 - i; ++j)
        {
            if (a[j] > a[j + 1])
            {
                double t = a[j];
                a[j] = a[j + 1];
                a[j + 1] = t;
            }
        }
    }
}

void BubbleSort(string* a, int n)
{
    for (int i = 0; i < n - 1; ++i)
    {
        for (int j = 0; j < n - 1 - i; ++j)
        {
            if (a[j] > a[j + 1])
            {
                string t = a[j];
                a[j] = a[j + 1];
                a[j + 1] = t;
            }
        }
    }
}

int MaxValue(const int* a, int n)
{
    int m = a[0];
    for (int i = 1; i < n; ++i)
    {
        if (m < a[i])
        {
            m = a[i];
        }
    }
    return m;
}

double MaxValue(const double* a, int n)
{
    double m = a[0];
    for (int i = 1; i < n; ++i)
    {
        if (m < a[i])
        {
            m = a[i];
        }
    }
    return m;
}

string MaxValue(const string* a, int n)
{
    string m = a[0];
    for (int i = 1; i < n; ++i)
    {
        if (m < a[i])
        {
            m = a[i];
        }
    }
    return m;
}

int main()
{
    int a[5] = {5, 3, 4, 1, 2};
    double b[4] = {2.5, 0.5, 3.5, 1.5};
    string c[3];
    c[0] = "pear";
    c[1] = "apple";
    c[2] = "orange";

    BubbleSort(a, 5);
    BubbleSort(b, 4);
    BubbleSort(c, 3);

    for (int i = 0; i < 5; ++i) { cout << a[i] << " "; }
    cout << endl;
    for (int i = 0; i < 4; ++i) { cout << b[i] << " "; }
    cout << endl;
    for (int i = 0; i < 3; ++i) { cout << c[i] << " "; }
    cout << endl;

    cout << MaxValue(a, 5) << " " << MaxValue(b, 4) << " " << MaxValue(c, 3) << endl;
    return 0;
}
cpp
// 文件:/home/cocatrice/cpp07/inst/sort_template.cpp
#include <iostream>
#include <string>
using namespace std;

template<class T>
void BubbleSort(T* a, int n)
{
    for (int i = 0; i < n - 1; ++i)
    {
        for (int j = 0; j < n - 1 - i; ++j)
        {
            if (a[j] > a[j + 1])
            {
                T t = a[j];
                a[j] = a[j + 1];
                a[j + 1] = t;
            }
        }
    }
}

template<class T>
T MaxValue(const T* a, int n)
{
    T m = a[0];
    for (int i = 1; i < n; ++i)
    {
        if (m < a[i])
        {
            m = a[i];
        }
    }
    return m;
}

int main()
{
    int a[5] = {5, 3, 4, 1, 2};
    double b[4] = {2.5, 0.5, 3.5, 1.5};
    string c[3];
    c[0] = "pear";
    c[1] = "apple";
    c[2] = "orange";

    BubbleSort(a, 5);
    BubbleSort(b, 4);
    BubbleSort(c, 3);

    for (int i = 0; i < 5; ++i) { cout << a[i] << " "; }
    cout << endl;
    for (int i = 0; i < 4; ++i) { cout << b[i] << " "; }
    cout << endl;
    for (int i = 0; i < 3; ++i) { cout << c[i] << " "; }
    cout << endl;

    cout << MaxValue(a, 5) << " " << MaxValue(b, 4) << " " << MaxValue(c, 3) << endl;
    return 0;
}
两份程序的输出完全一致,代码行数差了将近一半。
两份程序的输出一致说明模板版没有改变行为,只是把三份几乎相同的源码收成一份,行数上的差距随着类型的增加还会继续拉大。排序这份代码还说明模板对类型有要求:被排序的类型必须支持比较与赋值,冒泡排序里用到的比较运算符与赋值在实例化时才检查,类型不满足时编译器给出的报错落在模板内部的表达式上。
text
# 所属目录:/home/cocatrice/cpp07/inst
---- ./sort_overload ----
1 2 3 4 5
0.5 1.5 2.5 3.5
apple orange pear
5 3.5 pear
---- ./sort_template ----
1 2 3 4 5
0.5 1.5 2.5 3.5
apple orange pear
5 3.5 pear
---- wc -l sort_overload.cpp sort_template.cpp ----
 114 sort_overload.cpp
  58 sort_template.cpp
 172 total
模板版在可执行文件里仍然生成了三份代码,只是源文件只需要写一份。
行数的减少只体现在源文件上,可执行文件里仍然是三份独立的代码,符号清单里三个 BubbleSort 特化各占一行。模板把重复的书写收进一份定义,把生成的负担交给编译器,这一点在编译时间与目标文件体积上都能量出来。
text
# 所属目录:/home/cocatrice/cpp07/inst
---- nm -C sort_template | grep BubbleSort ----
000000000040105a W void BubbleSort<double>(double*, int)
0000000000400f72 W void BubbleSort<int>(int*, int)
000000000040114e W void BubbleSort<std::string>(std::string*, int)
---- ls -l sort_overload sort_template ----
-rwxrwxr-x 1 cocatrice cocatrice 14352 Oct  6 17:56 sort_overload
-rwxrwxr-x 1 cocatrice cocatrice 14384 Oct  6 17:56 sort_template
踩坑点
- 模板的定义与声明分开放进两个文件,编译能过,链接期报 undefined reference,同一个名字上的符号在两边对不上。
- 类模板名后面漏掉尖括号无法声明对象,报错是 missing template arguments,与模板本身无关。
- 成员函数在类外定义时漏写 template,报错落在成员名上,后面跟着一串看起来不相干的错误。
- 同一个名字下既有非模板函数又有模板时,不带尖括号的调用优先选中非模板函数,写尖括号才能强制走模板。
- 模板在推导阶段不做隐式类型转换,两个实参类型不同又只给了一个类型参数时会报推导冲突。
- 形参按值传递时顶层 const 被丢掉,数组退化成指针,函数退化成函数指针,长度信息全部丢失。
- T& 形式的形参不能接受右值,把字面量或临时对象传进去会报非 const 引用绑定不上。
- 类模板的成员函数只在被调用时实例化,没被调用的成员里写错名字不会在编译期报错。
- 扩容写成 _capacity * 2 时,容量为 0 的栈会永远停在 0,越界写看起来没事,valgrind 下才会报 Invalid write。
- 函数模板的默认模板参数在 c++98 的选项下不被接受,同一个文件换成 c++11 才能编译。
本篇总结(模拟面试问题)
问:模板是什么,函数模板与类模板各自解决什么问题?
核心要点:模板是生成代码的图纸,它本身不是函数也不是类,编译器在看到具体类型之后按图纸生成一份真正的代码。函数模板解决同一段逻辑要在多种类型上复用的问题,把参数类型交给编译器推导或者显式指定,写一份就能覆盖所有类型。类模板解决的是整张数据结构要跟着类型变化的问题,数据成员的类型、成员函数的形参与返回类型都由模板参数决定,一个 Stack 类模板可以装 int、double 或者 string。两者共同的代价是每个用到的类型都会生成一份独立的代码,符号名里带着类型信息。
问:template 与 template 有什么区别?
核心要点:作为类型参数时两者完全等价,编译器接受任何一种写法,混用也不影响结果,把这行文字换成另一种拼写重新编译,生成的目标文件与运行结果都一样。typename 这个词在别处还有第二个用途,声明嵌套依赖类型时必须写它,因此模板参数列表里用 typename 更统一。
问:显式实例化与隐式实例化分别在什么时候用?
核心要点:隐式实例化由调用点触发,编译器从实参推导出类型并生成代码,用几个类型就生成几份。显式实例化在尖括号里把类型写死,可以跳过推导这一步,典型的场合是两个实参类型不同、单参数模板推不出来,或者希望把某个类型的实例固定在一份源文件里供多个翻译单元共用。把定义留在源文件里的时候,显式实例化还能补上链接期缺失的符号。
问:一个名字同时对应非模板函数与模板时,重载决议按什么顺序选?
核心要点:先看参数是否完全匹配,非模板函数的实参不需要转换时优先选它,模板需要为类型参数做实例化因此排在后面。模板可以在调用处显式指定类型,写法上带了尖括号就不再参与与普通函数的等价比较,直接走模板。两个实参类型不同时,双参数模板的推导结果比需要一次转换的非模板函数更匹配,这时选中的反而是模板。
问:模板的实参推导里,按值传递与引用传递的差别在哪里?
核心要点:按值传递时形参会重新拷贝一份,顶层的 const 与 volatile 被丢掉,数组名退化成指针,函数名退化成函数指针,推导出来的 T 与实参的声明类型并不一致。引用传递保留这些信息,const 会进入 T 里面,写成 T& 还能保住数组的维度。想要让某一个实参保持原样而不参与推导,可以把它放在参数列表靠前的位置并显式指定类型。
问:类模板的成员函数是在什么时候被实例化的,这个规则带来什么后果?
核心要点:编译器只会为真正被用到的成员函数生成代码,创建一个对象不会把类里的所有成员都实例化一遍。好处是没被调用的成员函数不必为了别的类型而正确,坏处是成员函数体里的错误要等到第一次调用才暴露,写模板时不能只看编译是否通过就判断代码没问题。想要提前暴露,可以写一个调用每个成员的小程序,或者用显式实例化把整份类模板实例化出来。
问:非类型模板参数能做什么,使用时要注意什么?
核心要点:整数、指针与引用这类值可以作为模板参数,最常见的是数组长度。它在编译期就是一个常量,sizeof 能算出准确的对象大小,静态断言能在编译期拦下越界的下标,递归的模板也能靠它在编译期完成计算。要注意的是非类型参数的实参必须是编译期常量,运行期的变量不能直接当成模板参数,函数模板的默认模板参数在 c++98 下也不被接受。
问:模板会不会让可执行文件变大,怎么判断与减少这种膨胀?
核心要点:每个用到的类型都会生成一份独立的代码,符号清单里能看到同一个函数名带着不同的类型参数各占一行,text 段的字节数随类型数量增长。判断的办法是分别编译只用一种类型与用四种类型的目标文件,用 nm 与 size 对照符号个数与段大小。减少膨胀的手段包括把不依赖类型参数的公共逻辑抽到一个普通函数里、用 -O2 让短小的特化被内联掉,以及在合适的场合用基类或者 void 指针改写模板参数。
参考
- en.cppreference.com 上关于模板语法的总览:https://en.cppreference.com/w/cpp/language/templates
- en.cppreference.com 上关于函数模板的规则说明:https://en.cppreference.com/w/cpp/language/function_template
- en.cppreference.com 上关于模板实参推导的规则说明:https://en.cppreference.com/w/cpp/language/template_argument_deduction
- en.cppreference.com 上关于类模板与成员函数定义的说明:https://en.cppreference.com/w/cpp/language/class_template
- en.cppreference.com 上关于模板参数分类与默认值的说明:https://en.cppreference.com/w/cpp/language/template_parameters
- en.cppreference.com 上关于重载决议与模板排序的说明:https://en.cppreference.com/w/cpp/language/overload_resolution
- en.cppreference.com 上关于静态断言的规则说明:https://en.cppreference.com/w/cpp/language/static_assert
- en.cppreference.com 上关于 typeid 与类型名字的说明:https://en.cppreference.com/w/cpp/language/typeid
- en.cppreference.com 上关于 const 与 volatile 限定符的说明:https://en.cppreference.com/w/cpp/language/cv
- en.cppreference.com 上关于模板特化的规则说明:https://en.cppreference.com/w/cpp/language/template_specialization
- en.cppreference.com 上关于模板偏特化的规则说明:https://en.cppreference.com/w/cpp/language/partial_specialization
- en.cppreference.com 上关于数值类型取值范围与 numeric_limits 的说明:https://en.cppreference.com/w/cpp/types/numeric_limits
- gcc.gnu.org 上关于模板实例化选项的说明:https://gcc.gnu.org/onlinedocs/gcc/Template-Instantiation.html
- gcc.gnu.org 上关于语言标准选项的说明:https://gcc.gnu.org/onlinedocs/gcc/C_002b_002b-Dialect-Options.html
- gcc.gnu.org 上关于各个 C++ 标准特性支持情况的说明:https://gcc.gnu.org/projects/cxx-status.html
- sourceware.org 上 nm 命令的用法说明:https://sourceware.org/binutils/docs/binutils/nm.html
- sourceware.org 上 c++filt 命令的用法说明:https://sourceware.org/binutils/docs/binutils/c_002b_002bfilt.html
- itanium-cxx-abi.github.io 上关于符号修饰规则的说明:https://itanium-cxx-abi.github.io/cxx-abi/abi.html
- man7.org 上 g++ 的手册页,编译选项与诊断参数的用法:https://man7.org/linux/man-pages/man1/g++.1.html