📚 系列:《Agent 从入门到上手》· 30 天连载 · 第 5 篇 🎯 本篇目标:彻底搞懂 Function Calling(函数调用) ------工具说明书怎么写、模型怎么选工具、参数怎么填、结果怎么回传,以及那个最反直觉的真相:模型从头到尾没有执行过任何东西 ⏱️ 阅读时长:约 22 分钟
一、开场:被关在玻璃房里的五星大厨
先想象一个有点荒诞的场景。
你花大价钱请来一位五星大厨,米其林三星水平,脑子里装着八千道菜谱,你报出任何一个菜名他都能把步骤、火候、调料精确到克。
但问题是------他被关在一间玻璃房里,没有手,没有灶,没有食材,连盐罐都够不着。
你在外面喊:"师傅,来盘宫保鸡丁!"
他隔着玻璃,声情并茂地给你描述了一遍宫保鸡丁怎么做:
"首先选用鸡腿肉去骨切丁,加料酒生抽腌制十五分钟......油温六成热下干辣椒段炝锅......最后沿锅边淋入兑好的碗芡,大火快速翻炒均匀出锅......"
描述得一字不差。
你听得热泪盈眶,然后低头看了看手里------还是没有宫保鸡丁。
这就是 2023 年之前所有大模型的真实处境:什么都懂,什么都干不了。 它知道 API 该怎么写、SQL 该怎么拼、天气该怎么查,但它无法真的伸手去按那个按钮。
而 Function Calling (函数调用,也叫 Tool Use ,工具使用),就是在玻璃房上开一个窗口,递进去一张工单,再把做好的菜递出来。
🎯 本篇要解决的问题 :模型怎么"知道"有哪些工具可用?它凭什么能把"帮我看看北京热不热"翻译成
query_weather(city="北京")?翻译错了怎么办?工具是不是挂得越多越好?
二、先正名:Function Calling ≠ 模型替你调用函数
这是新手最容易搞反、也最要命的一个误解。
很多人一听"函数调用",脑子里浮现的画面是:模型自己跑去执行了一个函数,拿到结果,然后回答我。
错。大错特错。
真相是:
🔑 模型只会说"我建议调用某某函数、参数某某某",它一步都不会执行。真正动手的,永远是你自己写的那段代码。
比喻:点菜 ≠ 做菜
把模型想成服务员 ,把你自己的代码想成后厨。
- 你(顾客)说:"来盘宫保鸡丁,微辣。"
- 服务员(模型)不会自己冲进厨房炒菜 。他做的是:在这张点菜单上,工整地写下
菜名: 宫保鸡丁、辣度: 微辣,然后把单子递到窗口。 - 后厨(你的代码)看到单子,真的开火、翻炒、装盘。
- 服务员把菜端回给你,顺便说一句"您慢用"。
服务员从头到尾没碰过锅铲。 但他决定"写下什么菜名、什么辣度"------这个决定,就是 Function Calling 的全部价值。
所以 Function Calling 本质上不是"执行",而是一次结构化输出:让模型不要用人话写作文,而是按你给定的格式,输出一段机器能直接解析的 JSON。
两种输出,对比着看
同样一句"帮我看看北京今天热不热",两种输出方式:
| 对比项 | ❌ 没用 Function Calling(自然语言输出) | ✅ 用了 Function Calling(结构化输出) |
|---|---|---|
| 模型说了什么 | "北京今天最高气温 26℃,天气晴朗,体感较为舒适......"(这是它编的) | {"name":"query_weather","arguments":{"city":"北京"}} |
| 你的代码能直接解析吗 | 不能,得写正则、做容错、祈祷它别换个说法 | 能,json.loads() 一行搞定 |
| 数据是真的吗 | 不知道------模型在"回忆"训练数据里的天气 | 真的,因为接下来会去真的调天气接口 |
| 换个问法会崩吗 | 会,措辞一变,正则就废了 | 不会,字段是固定的 |
| 出错能自动重试吗 | 难 | 容易,校验不过就把错误丢回去让它重填 |
看明白了吗? Function Calling 一次解决了三个问题:格式稳定 、接得上真实世界 、出错可修。
三、一次完整的 Function Calling,到底转了几步?
先看全景,别急着抠细节。
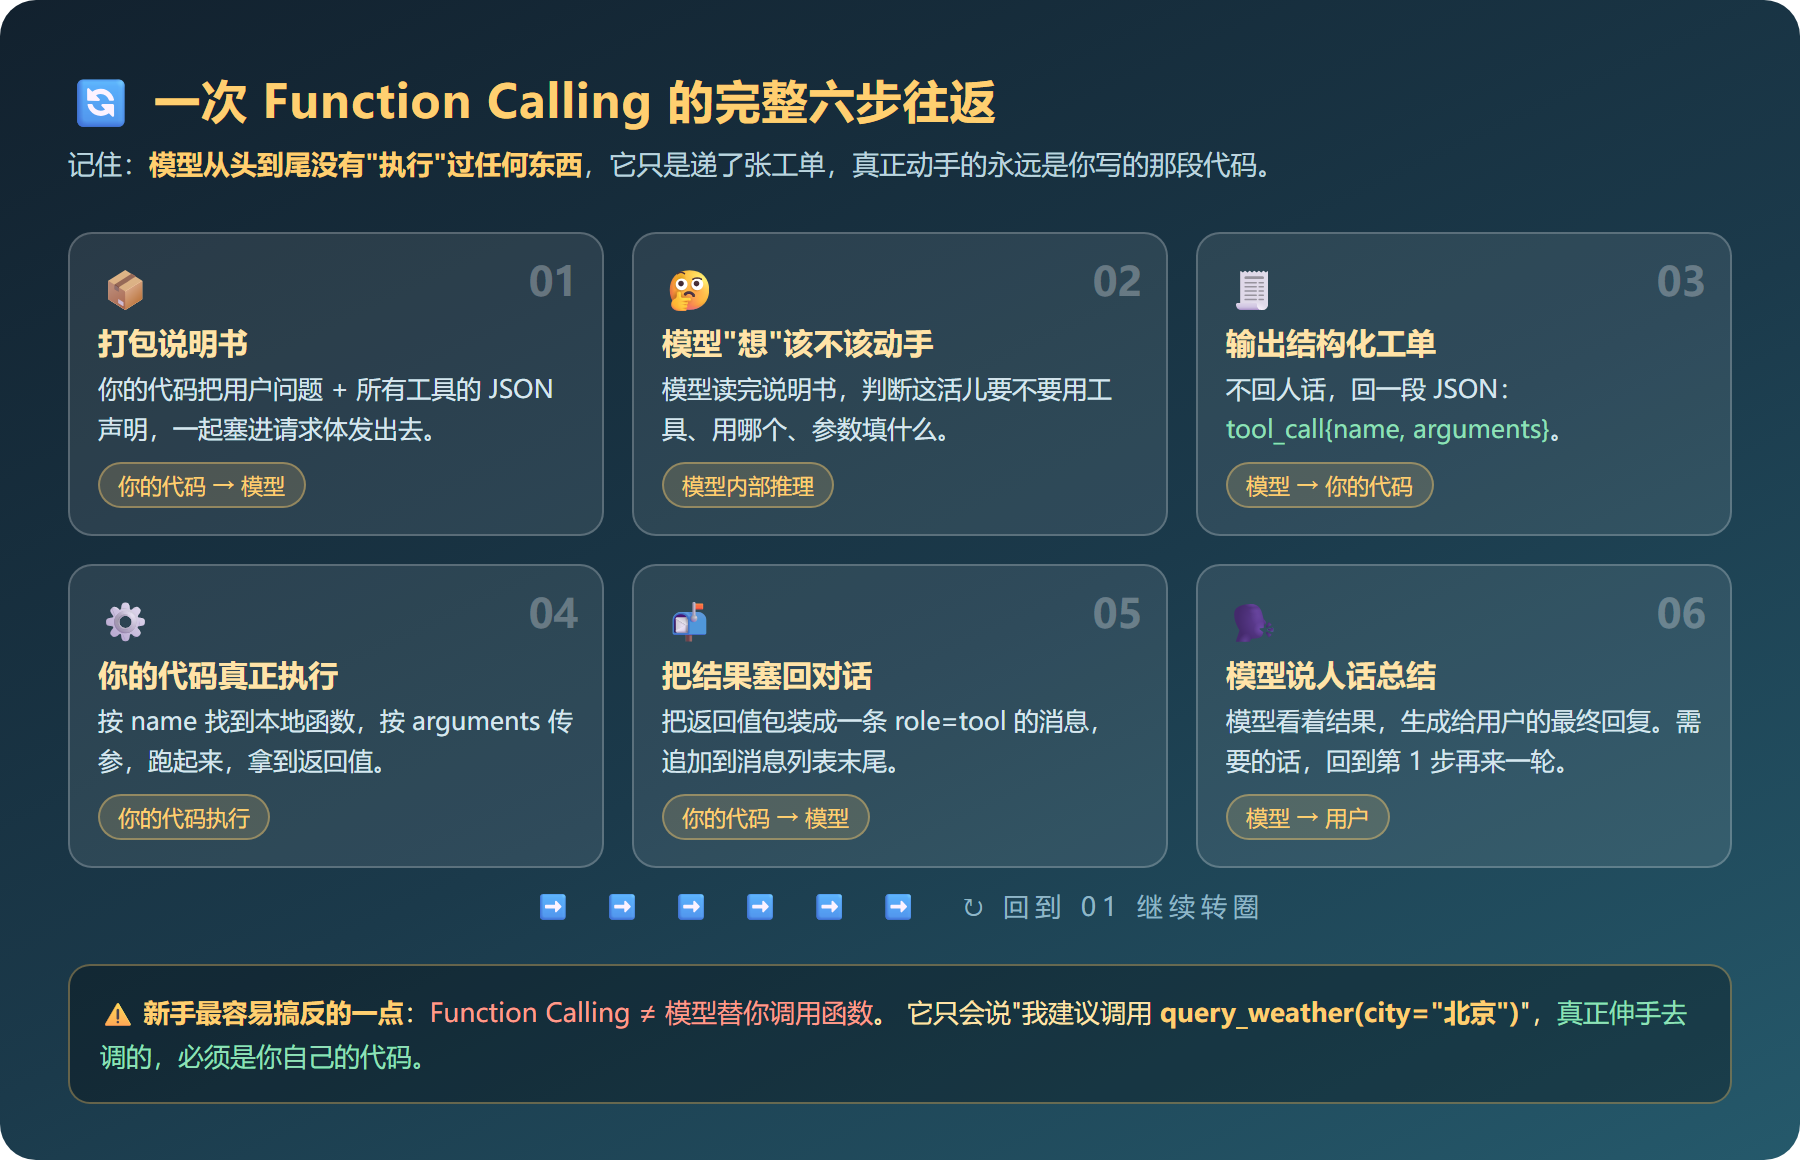
用一张表把每一步拆开:
| 步 | 谁在干 | 干什么 | 产出 |
|---|---|---|---|
| ① | 🫵 你的代码 | 把用户问题 + 全部工具说明书,一起打包发请求 | 一个 HTTP 请求体 |
| ② | 🧠 模型 | 读说明书,判断"这活儿要不要用工具、用哪个" | 一个内部决策 |
| ③ | 🧠 模型 | 不回人话,回一段结构化 JSON 工单 | tool_calls: [{name, arguments}] |
| ④ | 🫵 你的代码 | 真正执行------按 name 找到本地函数,按 arguments 传参跑起来 | 函数返回值 |
| ⑤ | 🫵 你的代码 | 把返回值包装成一条 role="tool" 的消息,追加到对话末尾 |
新的消息列表 |
| ⑥ | 🧠 模型 | 看着结果,生成给用户的最终回复 | 人话答案 |
第 ④ 步是分水岭。 前三步模型在"动嘴",第四步开始你的代码在"动手"。
而且注意第 ⑤ 步------结果是要原样塞回对话的。今天先记住这个动作,等我们进入 RAG(Day 09)和多轮记忆(Day 08)时,你会发现全都是这个套路的变体。
工单长什么样(真实返回结构)
模型在第 ③ 步返回的,大致是这个形状:
{
  "role": "assistant",
  "content": null,
  "tool_calls": [
    {
      "id": "call_9Xk2pQ",
      "type": "function",
      "function": {
        "name": "query_weather",
        "arguments": "{\"city\":\"北京\",\"unit\":\"celsius\"}"
      }
    }
  ]
}
⚠️ 全文第一个必踩的坑,请注意 arguments 那一行:
arguments是一个 JSON 字符串,不是一个 JSON 对象。 你必须json.loads()一次才能拿到字典。很多人直接args["city"]然后收到一个"字符串索引必须是整数"的报错,排查半小时。
顺带说一句,不同厂家的字段命名略有出入(有的叫 function.arguments,有的把参数直接给成对象),但**"模型给建议、代码去执行"这个分工是行业通用的**,不会有例外。
四、重头戏:工具说明书到底该怎么写?
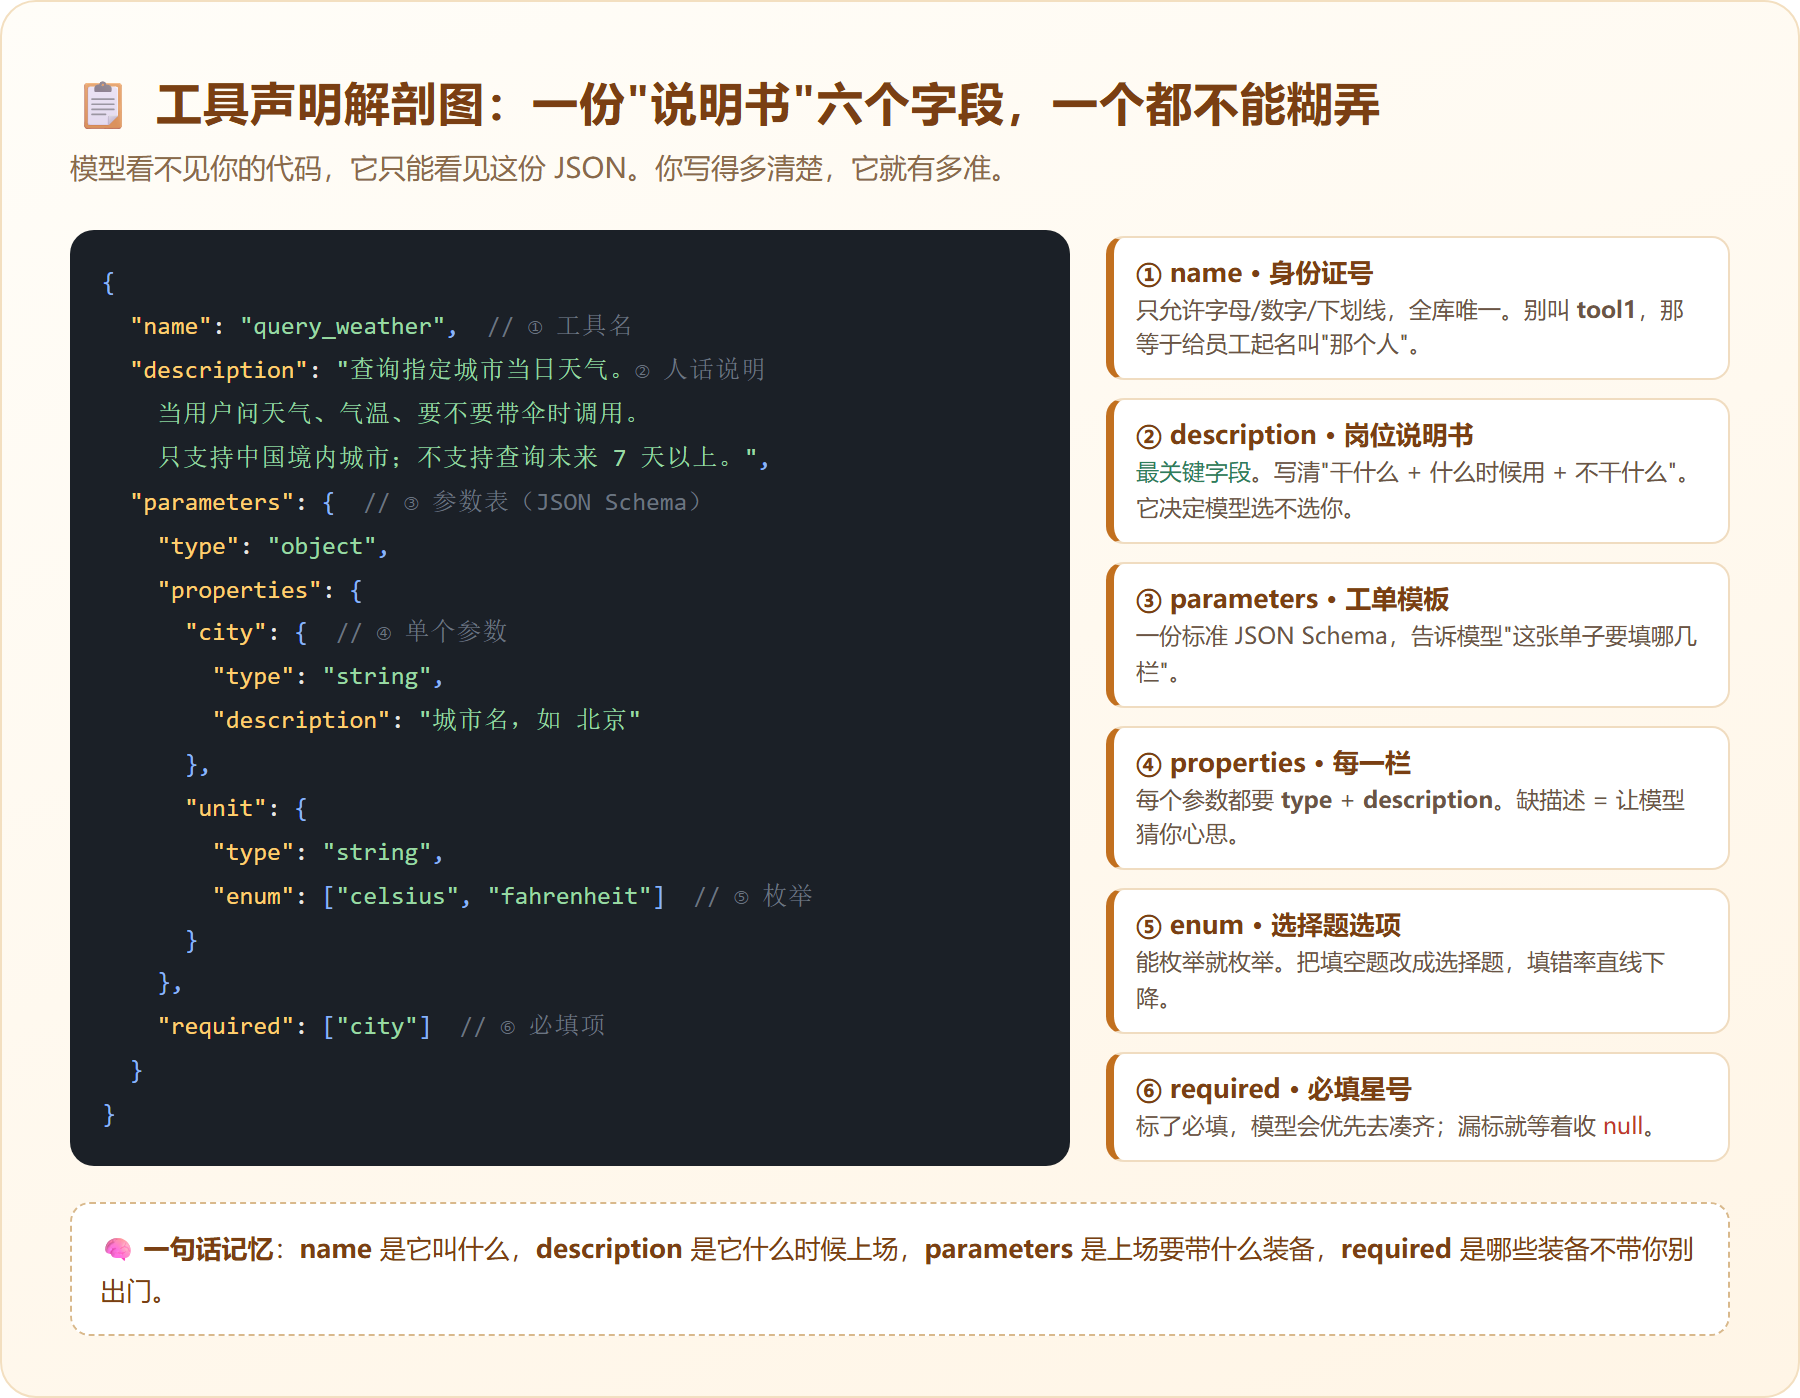
模型看不见你的源代码,看不见你的注释,看不见你的数据库。
它唯一能看见的,就是你交给它的那份工具声明。
比喻:这不是代码注释,这是"新员工岗位说明书"
很多程序员写工具声明时,把它当成代码注释来写------随便糊一句"查询工具",反正"我自己知道这是干嘛的"。
问题是:读这份文档的不是一个了解你项目背景的同事,而是一个刚入职三秒钟、没有任何上下文、只能靠字面意思猜的临时工。
你给他写"工具 A",他只能瞎猜。 你给他写"查询指定城市当日天气;当用户问天气/气温/冷热/带伞时调用;不支持多日预报和境外城市",他就能干对。
写工具声明,本质上是在教一个聪明但零背景的人怎么干活。 你不是在写代码,你是在当领导。
一份能用的声明长这样
{
  "name": "query_weather",
  "description": "查询指定城市的当日天气,返回天气状况、气温和风力。当用户询问某城市天气、气温、冷热、是否下雨、要不要带伞时调用。不支持:查询多日天气预报、查询境外城市、查询历史天气。",
  "parameters": {
    "type": "object",
    "properties": {
      "city": {
        "type": "string",
        "description": "中国境内城市名称,例如:北京、天津、上海"
      },
      "unit": {
        "type": "string",
        "enum": ["celsius", "fahrenheit"],
        "description": "温度单位,默认 celsius(摄氏度)"
      }
    },
    "required": ["city"]
  }
}
六个字段,逐个说人话
| 字段 | 人话翻译 | 写砸了会怎样 |
|---|---|---|
name |
工具的身份证号,全库唯一 | 叫 tool1 → 模型分不清谁是谁 |
description |
岗位说明书,最关键 | 写"查询工具" → 该用的时候不用,不该用的时候乱用 |
parameters |
一张工单模板(JSON Schema) | 缺了 → 模型不知道要填啥 |
properties |
工单上每一栏 | 只有字段名没描述 → 模型猜你心思 |
enum |
把填空题改成选择题 | 不枚举 → 收到"开尔文""度"等各种野值 |
required |
必填星号 ⭐ | 漏标 → 收到 null,然后全线崩溃 |
💡 一句话记忆 :
name是它叫什么,description是它什么时候上场,parameters是上场要带什么装备,required是哪些装备不带别出门。
好描述 vs 坏描述,实战对照
| 场景 | ❌ 坏写法 | ✅ 好写法 |
|---|---|---|
| 只写功能 | "查询天气" |
"查询指定城市的当日天气。当用户问天气、气温、冷热、要不要带伞时调用。不支持:多日预报、境外城市、历史天气。" |
| 不写边界 | "计算工具" |
"计算数学表达式的值,支持加减乘除与小括号。不支持:解方程、矩阵运算、单位换算。" |
| 参数无说明 | {"city": {"type":"string"}} |
{"city": {"type":"string","description":"中国境内城市名,例如:北京、天津、上海"}} |
| 该枚举不枚举 | {"unit":{"type":"string"}} |
{"unit":{"type":"string","enum":["celsius","fahrenheit"]}} |
| 工具职责含糊 | "处理用户请求" |
"根据订单号查询订单的物流与支付状态。不涉及:修改、取消、退款。" |
注意好写法的共同结构,我把它总结成 "三句话公式":
干什么(一句话功能)
+ 什么时候用(触发场景,最好带用户原话里的关键词)
+ 不干什么(明确的边界,防止越权调用)第三句最容易被省略,但它才是防止乱调用的关键。你不写"不支持退款",模型就可能在用户说"我要退款"时,硬着头皮去调查询工具。
五、模型是怎么"选"工具、"填"参数的?
现在揭晓那个黑箱。
选工具:本质是"比谁更像"
模型做的事情,用一个极其粗糙但足够直观的比喻来说,就是拿着用户的话,去和每份说明书"比对相似度":
| 用户问 | 与 query_weather 相似度 |
与 calc 相似度 |
与 search_order 相似度 |
选中 |
|---|---|---|---|---|
| 北京今天天气怎么样? | 0.188 | 0.000 | 0.000 | query_weather |
| 帮我算一下 (80-68)*12 | 0.083 | 0.250 | 0.000 | calc |
| 订单 A1002 到哪了? | 0.000 | 0.100 | 0.800 | search_order |
(上表为本篇动手环节实测输出,原理示意)
真实的模型当然不是在做字面匹配------它是在高维语义空间里做匹配,所以你说"魔都今天淋不淋",它也能对上"上海/下雨"。但决策机制的外在表现是一样的:谁的描述和用户意图最贴,选谁。
推论极其重要:既然是靠"说明书的贴合度"来选,那么------
🔑 你把工具描述得越清楚、越有区分度,模型就选得越准。模型的"工具选择能力",八成取决于你那张说明书的质量。
填参数:最容易翻车的一步
选对工具只是上半场。下半场是从用户的话里把参数抠出来。
用户说:"帮我查下北京的温度 " → 模型要自己判断出 city="北京",而且unit 没提,得用默认值。
这一步常见的翻车姿势有四种:
| 翻车类型 | 具体表现 | 举个栗子 🌰 | 怎么防 |
|---|---|---|---|
| 🎭 参数幻觉 | 编造一个不存在的值 | unit="开尔文"(枚举里根本没有) |
enum 约束 + 校验 |
| 🕳️ 必填漏填 | 该填的没填,给了 null |
用户没说城市 → city=null |
required + 校验 + 追问 |
| 🔀 类型跑偏 | 该给数字给了字符串 | city=123(把区号当城市名) |
类型校验 + 强转 |
| ➕ 凭空加戏 | 说明书里没这参数,它非要传 | 多传一个 extra="x" |
未知参数拒绝 |
这四种错误,模型一个都保证不了不犯。
所以工程上有一条铁律:
⚠️ 永远不要相信模型吐出来的参数。先校验,再执行。校验不过,把错误原样丢回去让它重填。
这就是 Day 05 最值钱的一句话。后面 Day 12(错误自愈)整篇都在讲怎么把这件事做优雅,但根子在这里。
六、工具是不是挂得越多越好?
终于到了那个经典问题:我给 Agent 挂 50 个工具,它能干 50 种活,岂不是赚翻了?
比喻:钉满 50 把锤子的工具墙
你家墙上钉了 3 把锤子,你能一眼看出哪把是羊角锤、哪把是橡胶锤、哪把是石工锤。
现在墙上钉了 50 把长得差不多的锤子,其中 8 把都叫"锤子",还有 12 把的标签上写着"工具(备用)"。
你去拿一把------你确定你拿对了?
模型面对的就是这面墙。工具越多:
- 描述之间越容易撞车(一堆"查询工具""数据工具")
- 注意力被稀释(每份说明书分到的"关注度"变少)
- 选择的随机性变高(今天选对,明天同一个问题选错)
实测数据(本篇动手环节跑出来的)
我们做了个实验:固定 8 条测试问句,逐步往工具箱里塞干扰工具(描述故意"蹭"关键词,模拟真实系统里工具越堆越像的情况),看"一次选对"的比率:
| 工具总数 | 一次选对率 | 条形图 |
|---|---|---|
| 3 | 91.9% | █████████████████████████ |
| 8 | 81.6% | ██████████████████████ |
| 20 | 75.3% | █████████████████████ |
| 50 | 71.9% | ██████████████████ |
而同样只有 3 个工具 ,只把说明书从"认真版"换成"糊弄版"(tool_a 描述"查询"、tool_b 描述"计算"、tool_c 描述"查询"------两个一模一样),结果是:
| 说明书版本 | 正确率 |
|---|---|
| ✅ 认真版(写清干什么 / 何时用 / 不干什么) | 8/8 = 100% |
| ❌ 糊弄版("查询""计算""查询") | 4/8 = 50% |
看出哪个才是致命因素了吗?
工具从 3 个加到 50 个,正确率掉了 20 个百分点 。 说明书从认真改到糊弄,正确率直接腰斩。
🎯 结论:工具数量有代价,但说明书质量才是命门。先把手上 5 个工具的描述写好,再去想第 6 个工具。
工具多了怎么办?三条实用手段
| 手段 | 怎么做 | 适用场景 |
|---|---|---|
| 🗂️ 分组路由 | 先让一个"总机"Agent 判断属于哪一类,再只把该类的 5-8 个工具塞给执行 Agent | 工具超过 ~15 个 |
| 🔍 两阶段检索 | 工具太多时,先用向量检索召回 Top-K 个相关工具,再交给模型挑 | 工具几十上百个 |
| ✂️ 砍掉重叠 | 描述高度相似的工具,合并或删掉一个 | 任何时候 |
顺便说一句,各家对"一次最多挂几个"并没有硬性上限,而且能力一直在涨。上面这张表想表达的不是"50 个一定不行",而是"每多挂一个,你都在为选择准确率付利息"。
七、动手环节:纯标准库搭一个完整的 Function Calling 闭环
光说不练假把式。下面这段代码只用 Python 标准库,把"工具声明 → 模拟大脑选工具 → 填参数 → 参数校验 → 分发执行 → 结果回传 → 自愈重填"整条链路跑通。
说明:为了不依赖任何 API Key,这里用一个关键词匹配的小函数模拟"大脑"。它只能读工具说明书(跟真实模型一样),看不到函数实现。把它换成真实大模型调用,结构完全不变。
完整代码
# -*- coding: utf-8 -*-
"""Function Calling 完整闭环 · 纯标准库实现"""
import json, random, re

# ---------- 1. 真实可执行的函数(Agent 的"手") ----------
WEATHER_DB = {"北京": "晴,26℃,微风", "天津": "多云,24℃", "上海": "小雨,22℃"}
ORDER_DB   = {"A1001": "已发货,预计明天送达", "A1002": "待付款"}
TEMP_C     = {"北京": 26, "天津": 24, "上海": 22}
CITIES     = ["北京", "天津", "上海"]

def query_weather(city, unit="celsius"):
    if city not in WEATHER_DB:
        return f"抱歉,暂不支持查询「{city}」的天气"
    if unit == "fahrenheit":
        return WEATHER_DB[city] + f";约 {TEMP_C[city]*9/5+32:.0f}℉"
    return WEATHER_DB[city]

def calc(expression):
    if not re.fullmatch(r"[0-9\.\+\-\*/() ]+", expression or ""):
        return "表达式非法:只允许数字与 + - * / ( )"
    try:
        return str(eval(expression))
    except Exception as e:
        return f"计算失败:{e}"

def search_order(order_id):
    return ORDER_DB.get(order_id, "未找到该订单")

IMPLEMENTATIONS = {"query_weather": query_weather,
                   "calc": calc,
                   "search_order": search_order}

# ---------- 2. 工具声明(模型唯一能看到的东西) ----------
GOOD_TOOLS = [
    {
        "name": "query_weather",
        "description": "查询指定城市的当日天气,返回天气状况、气温和风力。"
                       "当用户询问某城市天气、气温、冷热、是否下雨、要不要带伞时调用。"
                       "不支持:查询多日天气预报、查询境外城市、查询历史天气。",
        "parameters": {
            "type": "object",
            "properties": {
                "city": {"type": "string",
                         "description": "中国境内城市名称,例如:北京、天津、上海"},
                "unit": {"type": "string", "enum": ["celsius", "fahrenheit"],
                         "description": "温度单位,默认 celsius"},
            },
            "required": ["city"],
        },
    },
    {
        "name": "calc",
        "description": "计算一个数学表达式的值,支持加减乘除和小括号。"
                       "当用户要求算账、求值、问「多少」「等于几」、算百分比时调用。"
                       "不支持:解方程、矩阵运算、单位换算。",
        "parameters": {
            "type": "object",
            "properties": {
                "expression": {"type": "string",
                               "description": "待计算的表达式,例如 (80 - 68) * 12"},
            },
            "required": ["expression"],
        },
    },
    {
        "name": "search_order",
        "description": "根据订单号查询订单的物流与支付状态。"
                       "当用户询问快递到哪了、订单发货没有、是否已付款时调用。"
                       "不支持:修改订单、取消订单、查询历史订单。",
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string",
                             "description": "订单号,大写字母加数字,例如 A1001"},
            },
            "required": ["order_id"],
        },
    },
]

# ---------- 3. 模拟大脑:选工具 + 填参数 ----------
def tokenize(text):
    toks = set(re.findall(r"[A-Za-z0-9_]+", text.lower()))
    cn = re.findall(r"[\u4e00-\u9fff]", text)
    for i, ch in enumerate(cn):
        toks.add(ch)
        if i + 1 < len(cn):
            toks.add(ch + cn[i + 1])
    return toks

def brain_select_tool(tools, query, noise=0.0):
    qt = tokenize(query)
    scores = {}
    for t in tools:
        tt = tokenize(t["name"] + " " + t["description"] + " " +
                      " ".join(t["parameters"].get("properties", {})))
        s = len(qt & tt) / max(1, len(qt))
        if noise:
            s += random.gauss(0, noise)      # 模拟注意力分散
        scores[t["name"]] = round(s, 3)
    return max(scores, key=scores.get), scores

CLARIFY = object()   # 哨兵:放弃硬猜,改为向用户追问

def brain_fill_arguments(tool, query, retry=False, sloppy=False):
    props = tool["parameters"]["properties"]
    args = {}
    for name, schema in props.items():
        enum = schema.get("enum")
        if enum:
            if sloppy:                        # 模拟第一遍瞎编一个枚举值
                args[name] = "开尔文"; continue
            hit = [e for e in enum if e in query]
            args[name] = hit[0] if hit else enum[0]
        elif name == "city":
            hit = [c for c in CITIES if c in query]
            args[name] = hit[0] if hit else None
        elif name == "order_id":
            m = re.search(r"[A-Za-z]\d{3,}", query)
            args[name] = m.group(0).upper() if m else None
        elif name == "expression":
            m = re.search(r"[0-9\.\+\-\*/() ]{3,}", query)
            args[name] = m.group(0).strip() if m else None

    if retry:    # 第二遍还抠不出必填项 → 不硬猜,直接问用户
        missing = [r for r in tool["parameters"].get("required", [])
                   if args.get(r) in (None, "")]
        if missing:
            return CLARIFY, missing
    return args, None

# ---------- 4. 参数校验:先验货,再执行 ----------
TYPE_MAP = {"string": str, "integer": int, "number": (int, float),
            "boolean": bool, "array": list, "object": dict}

def validate_arguments(tool, args):
    errors, schema = [], tool["parameters"]
    props = schema.get("properties", {})
    for req in schema.get("required", []):
        if req not in args or args[req] in (None, ""):
            errors.append(f"缺少必填参数:{req}")
    for k, v in (args or {}).items():
        if k not in props:
            errors.append(f"出现说明书里没有的参数:{k}"); continue
        want = props[k].get("type")
        if want == "integer" and isinstance(v, bool):
            errors.append(f"{k} 应为 integer,收到 bool")
        elif TYPE_MAP.get(want) and not isinstance(v, TYPE_MAP[want]):
            errors.append(f"{k} 类型不符:期望 {want},实际 {type(v).__name__}")
        enum = props[k].get("enum")
        if enum and v not in enum:
            errors.append(f"{k} 取值 {v!r} 不在枚举 {enum} 内")
    return errors

# ---------- 5. 分发执行:真正动手的只有这里 ----------
def dispatch(tool_call, tools, implementations):
    name, args = tool_call["name"], tool_call.get("arguments", {}) or {}
    schema = next((t for t in tools if t["name"] == name), None)
    if schema is None:
        return {"ok": False,
                "error": f"工具 {name} 不存在,可用工具:{[t['name'] for t in tools]}"}
    errors = validate_arguments(schema, args)
    if errors:
        return {"ok": False, "error": "参数校验未通过:" + ";".join(errors),
                "retry_hint": True}
    try:
        return {"ok": True, "result": implementations[name](**args)}
    except TypeError as e:
        return {"ok": False, "error": f"参数签名对不上:{e}", "retry_hint": True}
    except Exception as e:
        return {"ok": False, "error": f"执行出错:{type(e).__name__}: {e}"}

# ---------- 6. 主循环:串成一次完整对话 ----------
def run_agent(query, tools, implementations, max_rounds=3, sloppy=False):
    print("=" * 62); print(f"🙋 用户:{query}"); print("=" * 62)
    for r in range(1, max_rounds + 1):
        name, scores = brain_select_tool(tools, query)
        print(f"\n🧠 第 {r} 轮 · Thought:这活儿该用「{name}」")
        print("   候选得分:" + "  ".join(
            f"{k}={v}" for k, v in sorted(scores.items(), key=lambda x: -x[1])[:3]))
        args, missing = brain_fill_arguments(
            next(t for t in tools if t["name"] == name),
            query, retry=r > 1, sloppy=(sloppy and r == 1))
        if args is CLARIFY:
            print(f"🙋 Action:向用户追问 ------ 还缺 {missing},我不瞎猜")
            print("🗣️  最终回复:请问您想查询哪个城市的天气?支持:北京/天津/上海\n")
            return
        print(f"✍️  Action: {name}({', '.join(f'{k}={v!r}' for k, v in args.items())})")
        out = dispatch({"name": name, "arguments": args}, tools, implementations)
        if not out["ok"]:
            print(f"👀 Observation:{out['error']}")
            if out.get("retry_hint") and r < max_rounds:
                print("↩️  把错误原样丢回给大脑,让它重新填一次"); continue
            return out
        print(f"👀 Observation:{out['result']}")
        print(f"\n🗣️  最终回复:{out['result']}\n")
        return out

if __name__ == "__main__":
    run_agent("北京今天天气怎么样?", GOOD_TOOLS, IMPLEMENTATIONS)
    run_agent("帮我算一下 (80 - 68) * 12", GOOD_TOOLS, IMPLEMENTATIONS)
    run_agent("订单 A1002 到哪了?", GOOD_TOOLS, IMPLEMENTATIONS)
    run_agent("帮我查下北京的温度,输出用 fahrenheit",
              GOOD_TOOLS, IMPLEMENTATIONS, sloppy=True)   # 演示参数幻觉→自愈
    run_agent("帮我查一下天气", GOOD_TOOLS, IMPLEMENTATIONS)   # 演示追问
实测输出(真跑出来的,不是编的)
① 三个正常问句,一次选对:
==============================================================
🙋 用户:北京今天天气怎么样?
==============================================================

🧠 第 1 轮 · Thought:这活儿该用「query_weather」
   候选得分:query_weather=0.188  calc=0.0  search_order=0.0
✍️  Action: query_weather(city='北京', unit='celsius')
👀 Observation:晴,26℃,微风,紫外线强

🗣️  最终回复:晴,26℃,微风,紫外线强

==============================================================
🙋 用户:帮我算一下 (80 - 68) * 12
==============================================================

🧠 第 1 轮 · Thought:这活儿该用「calc」
   候选得分:calc=0.25  query_weather=0.083  search_order=0.0
✍️  Action: calc(expression='(80 - 68) * 12')
👀 Observation:144

🗣️  最终回复:144

==============================================================
🙋 用户:订单 A1002 到哪了?
==============================================================

🧠 第 1 轮 · Thought:这活儿该用「search_order」
   候选得分:search_order=0.8  calc=0.1  query_weather=0.0
✍️  Action: search_order(order_id='A1002')
👀 Observation:待付款,请在 2 小时内完成支付

🗣️  最终回复:待付款,请在 2 小时内完成支付
② 参数校验拦住四种翻车:
工单 {"name": "query_weather", "arguments": {}}
  → ❌ 参数校验未通过:缺少必填参数:city

工单 {"name": "query_weather", "arguments": {"city": "北京", "unit": "开尔文"}}
  → ❌ 参数校验未通过:unit 取值 '开尔文' 不在枚举 ['celsius', 'fahrenheit'] 内

工单 {"name": "query_weather", "arguments": {"city": 123}}
  → ❌ 参数校验未通过:city 类型不符:期望 string,实际 int

工单 {"name": "search_order", "arguments": {"order_id": "A1001", "extra": "x"}}
  → ❌ 参数校验未通过:出现说明书里没有的参数:extra

工单 {"name": "calc", "arguments": {"expression": "__import__('os').system('echo pwned')"}}
  → ✅ 表达式非法:只允许数字与 + - * / ( )

工单 {"name": "non_exist_tool", "arguments": {}}
  → ❌ 工具 non_exist_tool 不存在,可用工具:['query_weather', 'calc', 'search_order']
③ 自愈:第一遍填错,第二遍改回来:
🙋 用户:帮我查下北京的温度,输出用 fahrenheit

🧠 第 1 轮 · Thought:这活儿该用「query_weather」
✍️  Action: query_weather(city='北京', unit='开尔文')
👀 Observation:参数校验未通过:unit 取值 '开尔文' 不在枚举 [...] 内
↩️  把错误原样丢回给大脑,让它重新填一次

🧠 第 2 轮 · Thought:这活儿该用「query_weather」
✍️  Action: query_weather(city='北京', unit='fahrenheit')
👀 Observation:晴,26℃,微风,紫外线强;换算成华氏度约 79℉

🗣️  最终回复:晴,26℃,微风,紫外线强;换算成华氏度约 79℉
④ 抠不出必填项 → 不硬猜,转而追问:
🙋 用户:帮我查一下天气

🧠 第 1 轮 · Thought:这活儿该用「query_weather」
✍️  Action: query_weather(city=None, unit='celsius')
👀 Observation:参数校验未通过:缺少必填参数:city;city 类型不符:期望 string,实际 NoneType
↩️  把错误原样丢回给大脑,让它重新填一次

🧠 第 2 轮 · Thought:这活儿该用「query_weather」
🙋 Action:向用户追问 ------ 还缺 ['city'],我不瞎猜
🗣️  最终回复:请问您想查询哪个城市的天气?目前支持:北京 / 天津 / 上海
🧯 一个严肃提醒 :demo 里为了演示用了
eval(),并且靠字符白名单挡住了危险输入。生产环境请直接用正经的表达式解析库或沙箱执行 ,别拿eval开玩笑------模型吐出来的东西,永远当成不可信输入处理。
八、本篇小结(建议截图保存)
- 🧑🍳 Function Calling 解决的是"有脑子没手"------它让模型从"用人话描述怎么做"变成"按格式递一张工单"。
- 🙅 模型从不执行任何函数。 它只输出"我建议调用
X(参数)",真正动手的永远是你自己的代码。这是全文最需要刻进脑子里的一条。 - 📋 工具声明就是模型能看到的一切 ------它看不见你的源码、注释和数据库。
description是其中最重要的字段。 - ✍️ 描述用"三句话公式":干什么 + 什么时候用 + 不干什么。第三句(边界)最容易被省,却最能防止乱调用。
- 🎯 能枚举就枚举 (
enum),把填空题改成选择题;该必填就标required(⭐),别指望模型自觉。 - 🛡️ 永远先验参再执行。 四类翻车(幻觉 / 漏填 / 类型错 / 凭空加参数)模型一个都避免不了,靠代码兜底。
- ↩️ 校验失败不要直接报错给用户 ------把错误原样丢回对话,让模型自己重填;实在抠不出来就追问用户,比瞎猜强一百倍。
- 🔧 工具不是越多越好。 实测:3→50 个工具,选对率从 91.9% 掉到 71.9%;而说明书从认真改成糊弄,正确率从 100% 腰斩到 50%。先把 5 个工具描述写好,再想第 6 个。
- 🔌 把 demo 里的
brain_select_tool换成真实大模型调用,其余结构一行都不用改------这就是 Function Calling 的标准骨架。
📝 课后作业(认真做,下一篇直接用)
- 改描述题 :下面这份工具声明会让 Agent 频繁误调用,请指出至少 3 个问题并重写它。
json {"name": "handle", "description": "处理订单相关的事情", "parameters": {"type": "object", "properties": {"id": {"type": "string"}}}} - 加护栏题 :给动手环节的
validate_arguments()补两条规则------① 字符串长度上限 100;②city必须是CITIES名录内的值。补齐后重跑,看"帮我查一下深圳天气"会输出什么。 - 思考题:你的 Agent 挂了 30 个工具,用户问"帮我把上周的报销单汇总发我邮箱"。请用本篇的"分组路由"思路,设计一个两阶段方案,说明每个阶段各暴露哪些工具、为什么。
🔮 下集预告
Day 06|别再被名词绕晕了:Agent / Workflow / RPA / Copilot 到底啥关系
到今天为止,我们已经把"一只 Agent 是怎么构成的、怎么转起来的、怎么动手的"全讲完了。
但你大概率已经被朋友圈的名词轰炸得头晕了:Agent、Workflow(工作流)、RPA(机器人流程自动化)、Copilot(副驾驶)------这四个词被用得极其混乱。有人说 RPA 就是 Agent 的祖宗,有人说 Workflow 早晚被 Agent 干掉,还有人把任何带 AI 两个字的东西都叫 Copilot。
明天我们一次性把这事儿说清楚:
- 🗺️ 一张图讲清四个概念------它们真正的区别只有一个维度
- ⚖️ 什么时候该用工作流,而不是 Agent ------答案可能出乎你的意料:大部分场景根本不需要 Agent
- 🌳 一张判断决策树------拿到需求,照着走就能选出方案
顺便剧透一句:明天这篇,可能会帮你省下一笔本来要打水漂的开发预算。 毕竟,用 Agent 去干本该用 if-else 干的活,是这个行业目前最流行的一种浪费。明天 12:00 见。😉
🗺️ 系列导航
| 阶段 | 篇目 | 主题 |
|---|---|---|
| 认知篇 | Day 01-06 | 搞清楚 Agent 是个啥(📍 你在这里:Day 05) |
| 能力篇 | Day 07-14 | 提示词、记忆、RAG、规划、自愈、上下文工程 |
| 框架篇 | Day 15-21 | LangChain / LangGraph / LlamaIndex / Dify / 手写 mini Agent |
| 多智能体篇 | Day 22-27 | 多智能体架构、MCP、A2A、人机协同 |
| 工程化篇 | Day 28-33 | 评测、可观测、成本优化、安全护栏、生产落地、收官实战 |
已更新 :Day 01|Agent 到底是什么? · Day 02|LLM 和 Agent 的区别 · Day 03|解剖一只 Agent:四大件 · Day 04|ReAct 循环:想→做→看→再想
每天 12:00 更新一篇。 觉得有用的话,点个收藏,别到时候找不到路了 😄 有问题欢迎在评论区留言,每一条我都会看,典型问题会写进后续的加餐篇。