前面讲了任务调度 Graph 的三层演进(StreamGraph → JobGraph → ExecutionGraph),这篇聚焦 Flink Task 调度任务的深度剖析。ExecutionGraph 构建完成后,SchedulerNG 如何调度 Execution?Slot 如何申请和分配?Task 如何部署到 TaskManager?Eager 和 Lazy 调度有什么区别?故障恢复是如何实现的?重启策略有哪些?这篇从源码级别跟踪 Flink Task 调度任务的完整链路。
一、Task 调度整体架构
下面这张图是 Task 调度整体架构,包括 JobMaster、ResourceManager、TaskManager 和调度流程。
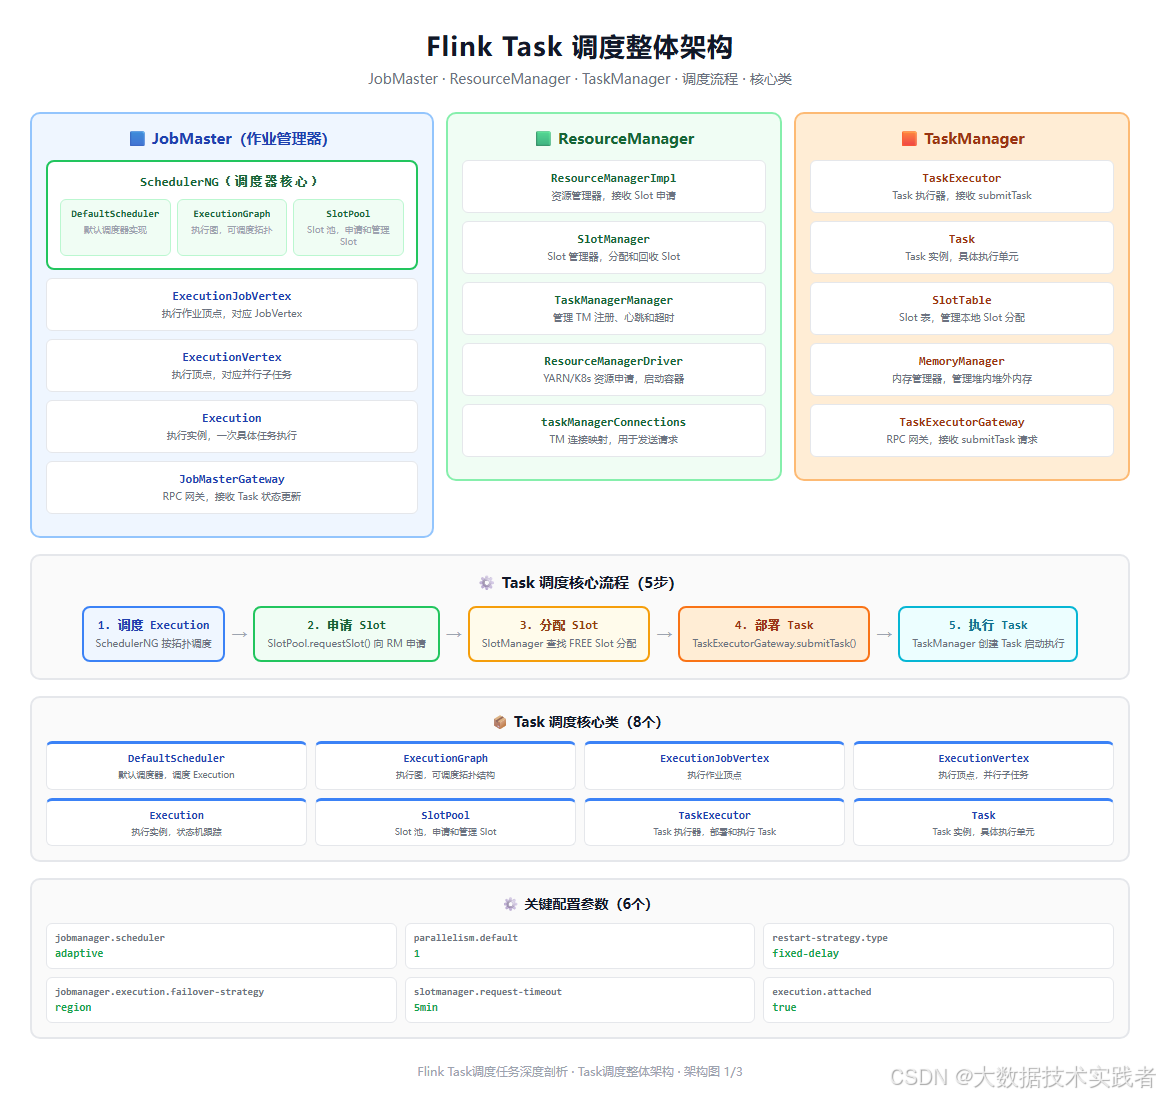
Flink Task 调度涉及三个核心组件:
- JobMaster(作业管理器):运行 SchedulerNG 调度器、ExecutionGraph 执行图、SlotPool 槽位池。SchedulerNG 负责调度 Execution,ExecutionGraph 维护可调度拓扑,SlotPool 负责申请和管理 Slot。
- ResourceManager(资源管理器):运行 SlotManager 槽位管理器、TaskManagerManager、ResourceManagerDriver。SlotManager 负责分配和回收 Slot,TaskManagerManager 管理 TM 注册和心跳,ResourceManagerDriver 负责 YARN/K8s 资源申请。
- TaskManager(工作节点):运行 TaskExecutor 任务执行器、Task 任务实例、SlotTable 槽位表、MemoryManager 内存管理器。TaskExecutor 接收 submitTask 请求,创建 Task 实例并启动执行。
Task 调度核心流程5步:SchedulerNG 调度 Execution → SlotPool 申请 Slot → SlotManager 分配 Slot → TaskExecutor 部署 Task → TaskManager 执行 Task。
二、Task 调度完整流程
下面这张图是 Task 调度完整流程,包括6步调度流程、方法调用链、核心类和常见问题。
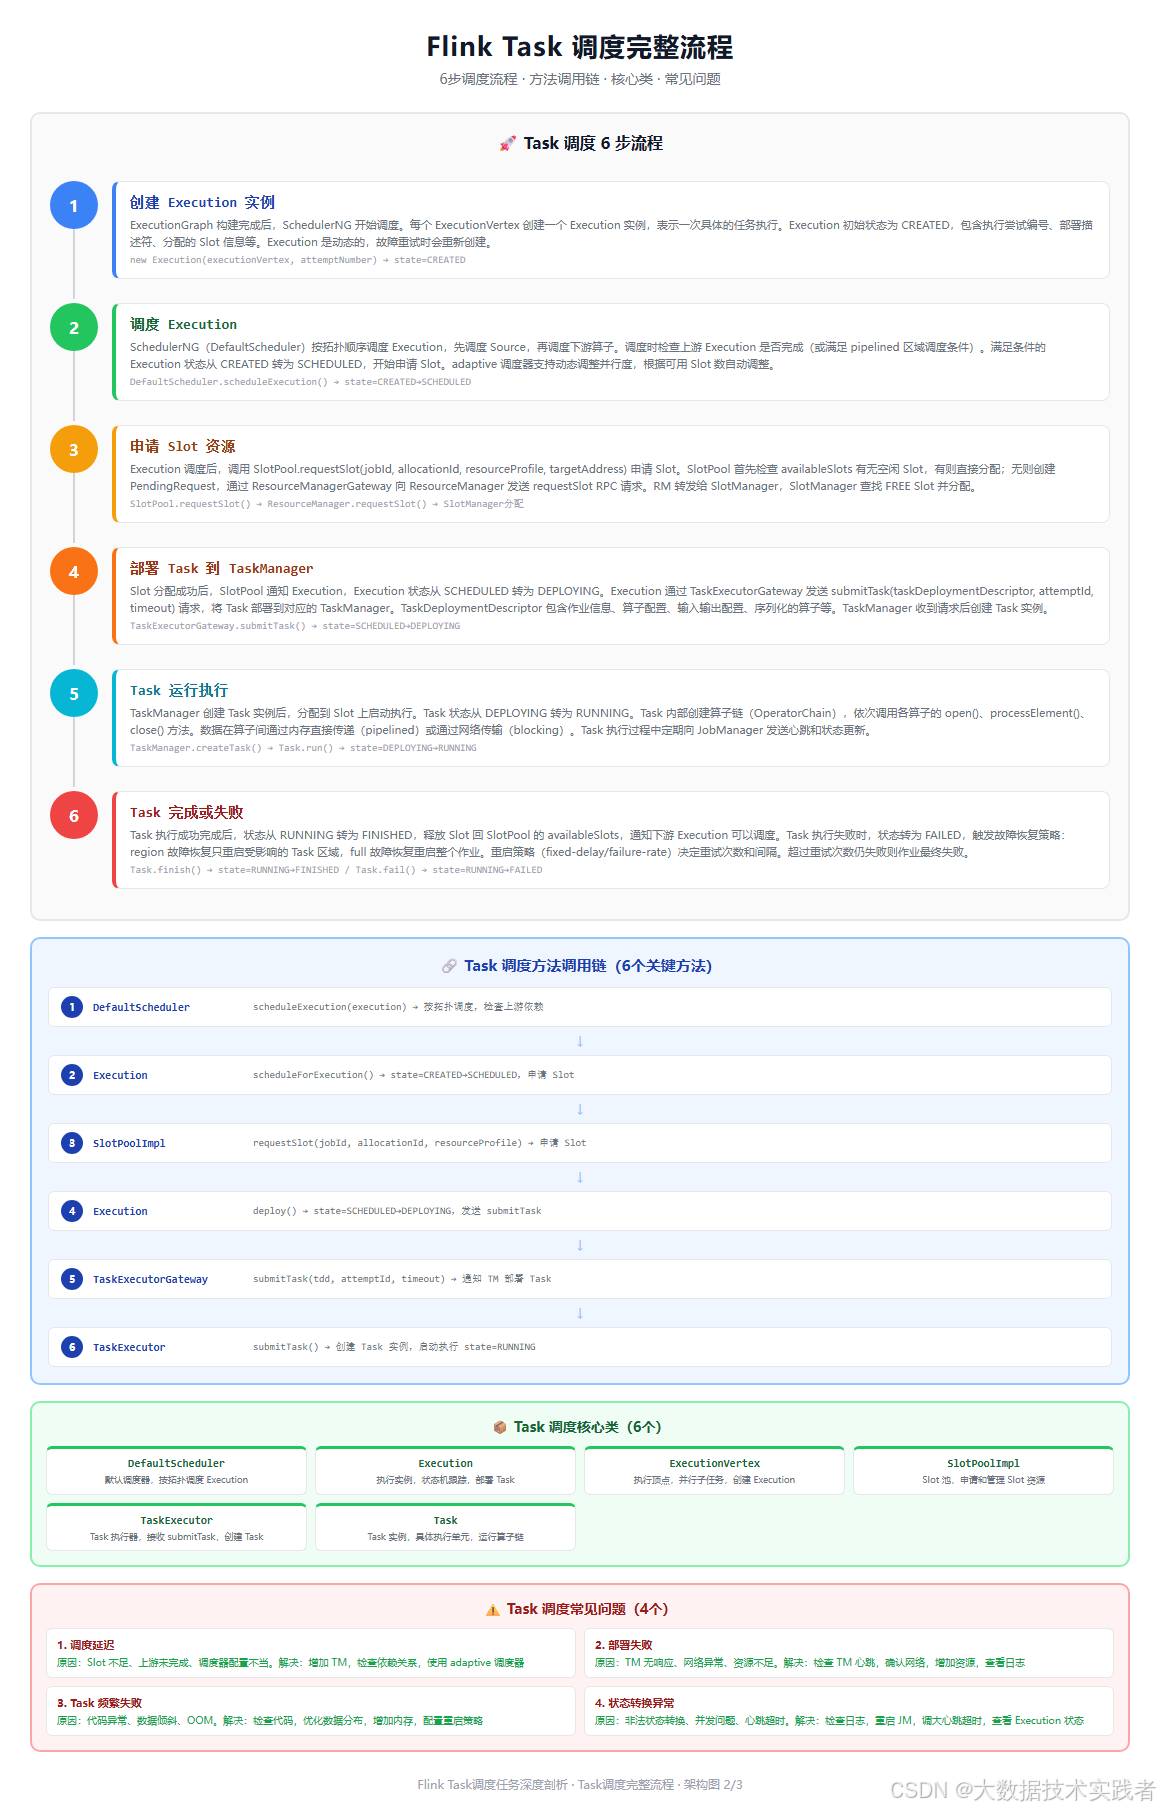
Task 调度分为6步:
第1步:创建 Execution 实例。ExecutionGraph 构建完成后,SchedulerNG 开始调度。每个 ExecutionVertex 创建一个 Execution 实例,表示一次具体的任务执行。Execution 初始状态为 CREATED,包含执行尝试编号、部署描述符、分配的 Slot 信息等。Execution 是动态的,故障重试时会重新创建。
第2步:调度 Execution。SchedulerNG(DefaultScheduler)按拓扑顺序调度 Execution,先调度 Source,再调度下游算子。调度时检查上游 Execution 是否完成(或满足 pipelined 区域调度条件)。满足条件的 Execution 状态从 CREATED 转为 SCHEDULED,开始申请 Slot。adaptive 调度器支持动态调整并行度,根据可用 Slot 数自动调整。
第3步:申请 Slot 资源。Execution 调度后,调用 SlotPool.requestSlot(jobId, allocationId, resourceProfile, targetAddress) 申请 Slot。SlotPool 首先检查 availableSlots 有无空闲 Slot,有则直接分配;无则创建 PendingRequest,通过 ResourceManagerGateway 向 ResourceManager 发送 requestSlot RPC 请求。RM 转发给 SlotManager,SlotManager 查找 FREE Slot 并分配。
第4步:部署 Task 到 TaskManager。Slot 分配成功后,SlotPool 通知 Execution,Execution 状态从 SCHEDULED 转为 DEPLOYING。Execution 通过 TaskExecutorGateway 发送 submitTask(taskDeploymentDescriptor, attemptId, timeout) 请求,将 Task 部署到对应的 TaskManager。TaskDeploymentDescriptor 包含作业信息、算子配置、输入输出配置、序列化的算子等。
第5步:Task 运行执行。TaskManager 创建 Task 实例后,分配到 Slot 上启动执行。Task 状态从 DEPLOYING 转为 RUNNING。Task 内部创建算子链(OperatorChain),依次调用各算子的 open()、processElement()、close() 方法。数据在算子间通过内存直接传递(pipelined)或通过网络传输(blocking)。
第6步:Task 完成或失败。Task 执行成功完成后,状态从 RUNNING 转为 FINISHED,释放 Slot 回 SlotPool,通知下游 Execution 可以调度。Task 执行失败时,状态转为 FAILED,触发故障恢复策略:region 故障恢复只重启受影响的 Task 区域,full 故障恢复重启整个作业。
三、核心类源码剖析
3.1 DefaultScheduler 调度器
java
public class DefaultScheduler implements SchedulerNG {
    private final ExecutionGraph executionGraph;
    private final SlotPool slotPool;
    private final Map<ExecutionVertex, Execution> currentExecutions;

    @Override
    public void startScheduling() {
        // 开始调度,按拓扑顺序调度所有 Execution
        scheduleAllVertices();
    }

    private void scheduleAllVertices() {
        // 遍历 ExecutionGraph,按拓扑顺序调度
        for (ExecutionJobVertex ejv : executionGraph.getVerticesTopologically()) {
            for (ExecutionVertex ev : ejv.getTaskVertices()) {
                scheduleExecution(ev);
            }
        }
    }

    private void scheduleExecution(ExecutionVertex executionVertex) {
        // 检查上游依赖是否满足
        if (!checkUpstreamDependencies(executionVertex)) {
            return; // 上游未完成,等待
        }

        // 创建 Execution 实例
        Execution execution = executionVertex.getCurrentExecutionAttempt();
        if (execution == null) {
            execution = executionVertex.resetForNewExecution();
        }

        // 调度 Execution,状态 CREATED → SCHEDULED
        execution.scheduleForExecution();
    }

    private boolean checkUpstreamDependencies(ExecutionVertex vertex) {
        // 检查所有上游 Execution 是否完成
        for (ExecutionEdge inputEdge : vertex.getInputEdges()) {
            ExecutionVertex upstream = inputEdge.getSource();
            Execution upstreamExecution = upstream.getCurrentExecutionAttempt();
            if (upstreamExecution == null
                || upstreamExecution.getState() != ExecutionState.FINISHED) {
                return false; // 上游未完成
            }
        }
        return true;
    }

    @Override
    public void handleTaskFailure(Execution execution, Throwable cause) {
        // 处理 Task 失败,触发故障恢复
        failoverStrategy.onTaskFailure(execution, cause);
        // 重新调度受影响的 Execution
        restartStrategy.restart(executionGraph);
    }
}
DefaultScheduler 是默认调度器实现。startScheduling 方法开始调度,按拓扑顺序遍历 ExecutionGraph,调用 scheduleExecution 调度每个 ExecutionVertex。scheduleExecution 方法首先检查上游依赖是否满足,不满足则等待;满足则创建 Execution 实例,调用 scheduleForExecution 调度,状态从 CREATED 转为 SCHEDULED。handleTaskFailure 方法处理 Task 失败,触发故障恢复策略和重启策略。
3.2 Execution 执行实例
java
public class Execution {
    private final ExecutionVertex vertex;
    private final int attemptNumber;
    private final ExecutionAttemptID attemptId;
    private volatile ExecutionState state;
    private CompletableFuture<SlotAndLocality> slotFuture;
    private TaskDeploymentDescriptor deploymentDescriptor;

    public Execution(ExecutionVertex vertex, int attemptNumber) {
        this.vertex = vertex;
        this.attemptNumber = attemptNumber;
        this.attemptId = new ExecutionAttemptID();
        this.state = ExecutionState.CREATED;
    }

    public void scheduleForExecution() {
        // 状态转换:CREATED → SCHEDULED
        checkState(state == ExecutionState.CREATED,
            "Cannot schedule execution in state %s", state);
        state = ExecutionState.SCHEDULED;

        // 申请 Slot
        slotFuture = vertex.getSlotPool().requestSlot(
            vertex.getJobId(),
            new AllocationID(),
            vertex.getResourceProfile(),
            vertex.getPreferredLocation(),
            timeout);

        // Slot 分配成功后部署 Task
        slotFuture.whenComplete((slotAndLocality, throwable) -> {
            if (throwable != null) {
                fail(new Exception("Slot allocation failed", throwable));
            } else {
                deploy(slotAndLocality);
            }
        });
    }

    public void deploy(SlotAndLocality slotAndLocality) {
        // 状态转换:SCHEDULED → DEPLOYING
        checkState(state == ExecutionState.SCHEDULED,
            "Cannot deploy execution in state %s", state);
        state = ExecutionState.DEPLOYING;

        // 构建 TaskDeploymentDescriptor
        TaskDeploymentDescriptor tdd = buildDeploymentDescriptor(slotAndLocality);

        // 获取 TaskExecutorGateway,发送 submitTask 请求
        TaskManagerLocation location = slotAndLocality.getSlot().getTaskManagerLocation();
        TaskExecutorGateway taskExecutorGateway =
            vertex.getTaskManagerConnections().get(location.getResourceID());

        taskExecutorGateway.submitTask(tdd, attemptId, timeout)
            .whenComplete((ack, throwable) -> {
                if (throwable != null) {
                    fail(new Exception("Task deployment failed", throwable));
                } else {
                    // Task 部署成功,等待 TM 通知 RUNNING
                }
            });
    }

    public void markRunning() {
        // 状态转换:DEPLOYING → RUNNING
        checkState(state == ExecutionState.DEPLOYING);
        state = ExecutionState.RUNNING;
    }

    public void markFinished() {
        // 状态转换:RUNNING → FINISHED
        checkState(state == ExecutionState.RUNNING);
        state = ExecutionState.FINISHED;
        // 释放 Slot
        releaseSlot();
        // 通知下游可以调度
        vertex.notifyUpstreamFinished();
    }

    public void fail(Throwable cause) {
        // 状态转换:任意状态 → FAILED
        state = ExecutionState.FAILED;
        // 通知调度器处理失败
        vertex.getScheduler().handleTaskFailure(this, cause);
    }

    public ExecutionState getState() { return state; }
    public ExecutionAttemptID getAttemptId() { return attemptId; }
}

public enum ExecutionState {
    CREATED, SCHEDULED, DEPLOYING, RUNNING, FINISHED, FAILED, CANCELED
}
Execution 是执行实例,表示一次具体的任务执行,维护状态机(CREATED→SCHEDULED→DEPLOYING→RUNNING→FINISHED)。scheduleForExecution 方法将状态从 CREATED 转为 SCHEDULED,申请 Slot,Slot 分配成功后调用 deploy 部署 Task。deploy 方法将状态从 SCHEDULED 转为 DEPLOYING,构建 TaskDeploymentDescriptor,通过 TaskExecutorGateway 发送 submitTask 请求。markRunning/markFinished 方法标记运行和完成,fail 方法标记失败并通知调度器处理。
3.3 TaskExecutor 任务执行器
java
public class TaskExecutor implements TaskExecutorGateway {
    private final Map<ExecutionAttemptID, Task> tasks;
    private final SlotTable slotTable;
    private final MemoryManager memoryManager;

    @Override
    public CompletableFuture<Acknowledge> submitTask(
            TaskDeploymentDescriptor tdd,
            JobMasterId jobMasterId,
            Time timeout) {
        // 1. 验证作业 ID 和 Slot
        JobID jobId = tdd.getJobId();
        AllocationID allocationId = tdd.getAllocationId();
        if (!slotTable.tryMarkSlotActive(jobId, allocationId)) {
            throw new TaskSubmissionException("Slot not found or not active");
        }

        // 2. 创建 Task 实例
        Task task = new Task(
            jobId,
            tdd.getJobInformation(),
            tdd.getTaskInformation(),
            executionAttemptId,
            allocationId,
            taskManagerActions,
            inputSplitProvider,
            checkpointResponder,
            memoryManager,
            ioManager,
            networkEnvironment,
            libraryCacheManager,
            fileCache,
            shuffleEnvironment,
            kvStateService,
            broadcastVariableManager,
            taskEventDispatcher,
            externalResourceInfoProvider,
            fatalErrorHandler);

        // 3. 启动 Task 线程
        tasks.put(executionAttemptId, task);
        task.startTaskThread();

        return CompletableFuture.completedFuture(Acknowledge.get());
    }

    @Override
    public void updateTaskExecutionState(TaskExecutionState taskExecutionState) {
        // 接收 Task 状态更新,通知 JobMaster
        ExecutionAttemptID executionId = taskExecutionState.getID();
        Task task = tasks.get(executionId);
        if (task != null) {
            task.notifyUpdate(taskExecutionState);
        }
    }

    @Override
    public CompletableFuture<Acknowledge> cancelTask(
            ExecutionAttemptID executionAttemptId,
            Time timeout) {
        // 取消 Task
        Task task = tasks.get(executionAttemptId);
        if (task != null) {
            task.cancelExecution();
        }
        return CompletableFuture.completedFuture(Acknowledge.get());
    }
}
TaskExecutor 是 Task 执行器,运行在 TaskManager 上。submitTask 方法接收 JobMaster 的 submitTask 请求,首先验证作业 ID 和 Slot 是否有效,然后创建 Task 实例,启动 Task 线程执行。updateTaskExecutionState 方法接收 Task 状态更新,通知 JobMaster。cancelTask 方法取消正在执行的 Task。
3.4 Task 任务实例
java
public class Task implements Runnable {
    private final JobID jobId;
    private final JobInformation jobInformation;
    private final TaskInformation taskInformation;
    private final ExecutionAttemptID executionId;
    private final AllocationID allocationId;
    private volatile Thread executingThread;
    private volatile ExecutionState executionState;

    public void startTaskThread() {
        // 启动 Task 线程
        executingThread = new Thread(this, "Task Thread");
        executingThread.start();
    }

    @Override
    public void run() {
        try {
            // 1. 状态转换:DEPLOYING → RUNNING
            executionState = ExecutionState.RUNNING;
            notifyJobManager(ExecutionState.RUNNING);

            // 2. 创建算子链 OperatorChain
            OperatorChain operatorChain = new OperatorChain(
                taskInformation,
                jobInformation,
                executionId,
                memoryManager,
                ioManager,
                networkEnvironment,
                stateBackend,
                checkpointStorage,
                checkpointResponder,
                kvStateService,
                shuffleEnvironment);

            // 3. 调用所有算子的 open() 方法
            operatorChain.openOperators();

            // 4. 处理数据,调用 processElement()
            operatorChain.processInputs();

            // 5. 调用所有算子的 close() 方法
            operatorChain.closeOperators();

            // 6. 状态转换:RUNNING → FINISHED
            executionState = ExecutionState.FINISHED;
            notifyJobManager(ExecutionState.FINISHED);

        } catch (Throwable t) {
            // 处理异常,状态转换:RUNNING → FAILED
            executionState = ExecutionState.FAILED;
            notifyJobManager(ExecutionState.FAILED, t);
        } finally {
            // 释放资源
            cleanup();
        }
    }

    public void cancelExecution() {
        // 取消 Task 执行
        if (executionState == ExecutionState.RUNNING) {
            executionState = ExecutionState.CANCELING;
            executingThread.interrupt();
        }
    }

    private void notifyJobManager(ExecutionState state, Throwable... cause) {
        // 通知 JobManager 状态变化
        TaskExecutionState taskState = new TaskExecutionState(executionId, state, cause);
        taskManagerActions.updateTaskExecutionState(taskState);
    }
}
Task 是具体的任务执行单元,实现 Runnable 接口。run 方法是核心执行逻辑:首先将状态从 DEPLOYING 转为 RUNNING,通知 JobManager;然后创建算子链 OperatorChain,调用所有算子的 open() 方法;接着处理数据,调用 processElement();处理完成后调用 close() 方法;最后将状态转为 FINISHED,通知 JobManager。如果执行过程中出现异常,状态转为 FAILED,通知 JobManager 触发故障恢复。
四、调度策略与故障恢复
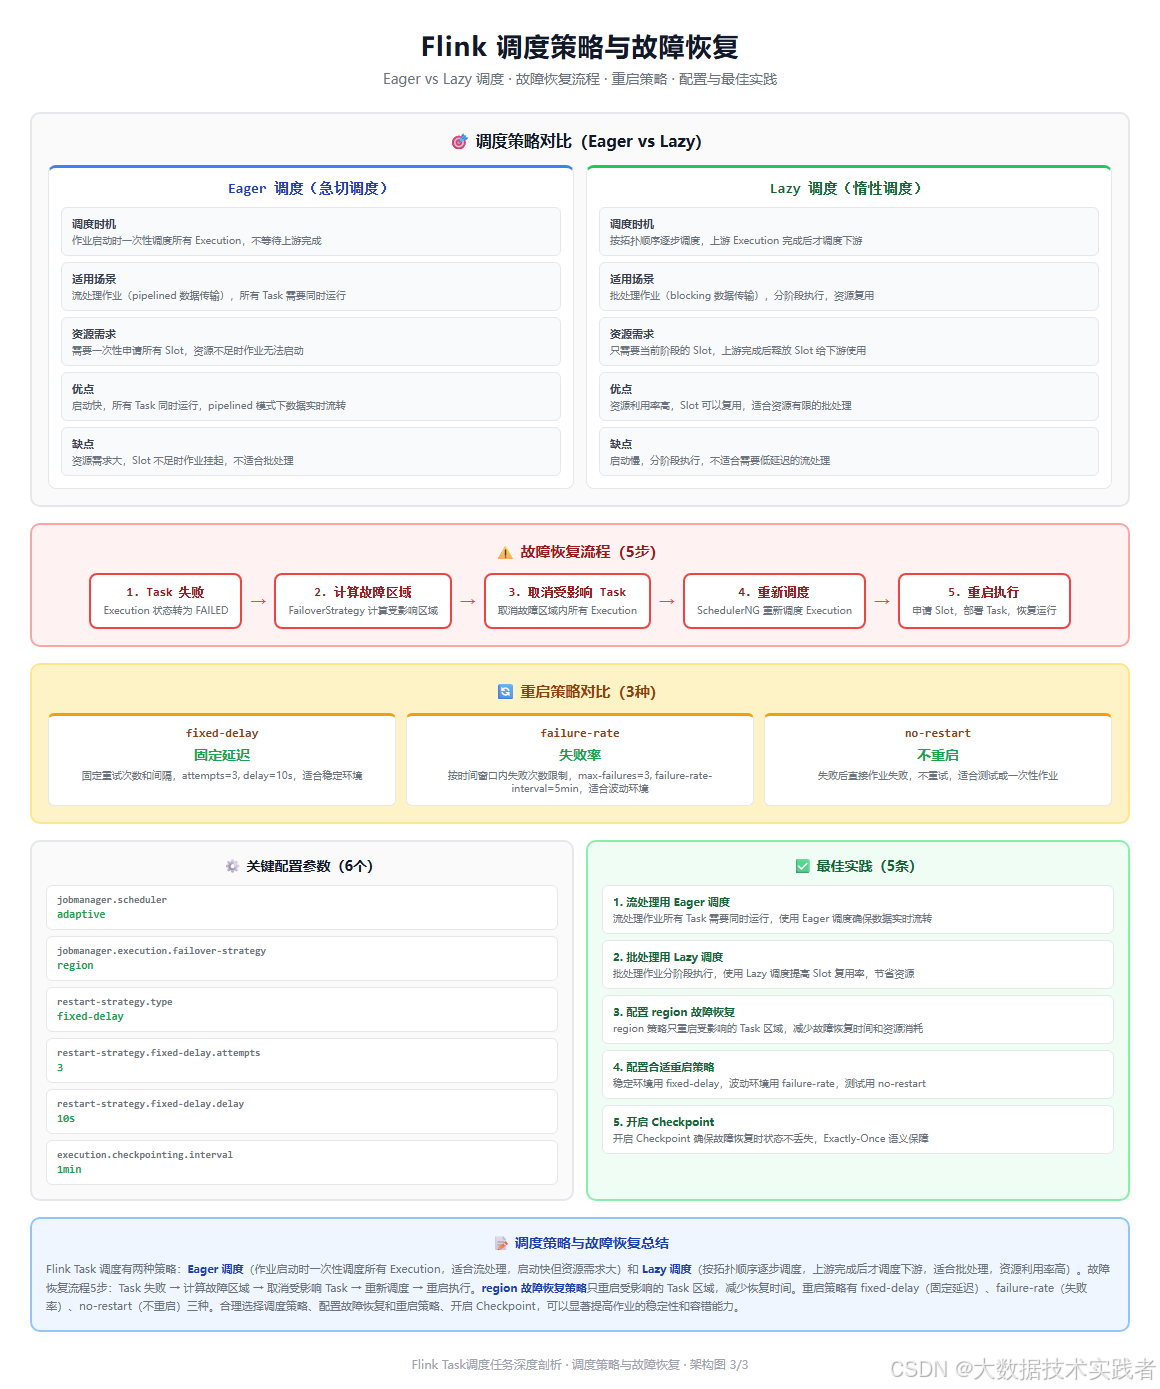
下面这张图是调度策略与故障恢复,包括 Eager vs Lazy 调度对比、故障恢复流程、重启策略和配置最佳实践。
Eager vs Lazy 调度
Flink Task 调度有两种策略:
- Eager 调度(急切调度):作业启动时一次性调度所有 Execution,不等待上游完成。适用于流处理作业(pipelined 数据传输),所有 Task 需要同时运行。优点是启动快,数据实时流转;缺点是资源需求大,Slot 不足时作业挂起。
- Lazy 调度(惰性调度):按拓扑顺序逐步调度,上游 Execution 完成后才调度下游。适用于批处理作业(blocking 数据传输),分阶段执行。优点是资源利用率高,Slot 可以复用;缺点是启动慢,不适合低延迟流处理。
流处理作业默认使用 Eager 调度,批处理作业默认使用 Lazy 调度。adaptive 调度器支持动态调整并行度,根据可用 Slot 数自动调整。
故障恢复流程
故障恢复流程5步:
- Task 失败:Execution 状态转为 FAILED,通知调度器
- 计算故障区域:FailoverStrategy 计算受影响的 Task 区域
- 取消受影响 Task:取消故障区域内所有 Execution,释放 Slot
- 重新调度:SchedulerNG 重新调度受影响的 Execution
- 重启执行:申请 Slot,部署 Task,恢复运行
故障恢复策略有两种:
- region 故障恢复:只重启受影响的 Task 区域,不影响其他区域,恢复时间短
- full 故障恢复:重启整个作业,所有 Task 重新执行,恢复时间长
生产环境推荐使用 region 故障恢复策略。
重启策略
重启策略决定故障恢复的重试次数和间隔:
- fixed-delay(固定延迟):固定重试次数和间隔,attempts=3, delay=10s,适合稳定环境
- failure-rate(失败率):按时间窗口内失败次数限制,max-failures=3, failure-rate-interval=5min,适合波动环境
- no-restart(不重启):失败后直接作业失败,不重试,适合测试或一次性作业
五、关键配置参数
yaml
# 调度器类型
jobmanager.scheduler: adaptive

# 故障恢复策略
jobmanager.execution.failover-strategy: region

# 重启策略类型
restart-strategy.type: fixed-delay

# 固定延迟重启次数
restart-strategy.fixed-delay.attempts: 3

# 固定延迟重启间隔
restart-strategy.fixed-delay.delay: 10s

# 默认并行度
parallelism.default: 1

# Slot 请求超时
slotmanager.request-timeout: 5min

# Checkpoint 间隔
execution.checkpointing.interval: 1min

# 执行模式
execution.attached: true

# 每个 TaskManager 的 Slot 数
taskmanager.numberOfTaskSlots: 1
关键配置说明:
- jobmanager.scheduler:调度器类型,adaptive 支持动态调整并行度,ng 是默认调度器。
- jobmanager.execution.failover-strategy:故障恢复策略,region 只重启受影响区域,full 重启整个作业。
- restart-strategy.type:重启策略类型,fixed-delay 固定延迟,failure-rate 失败率,no-restart 不重启。
- parallelism.default:默认并行度,所有算子的默认并行度,可在代码中单独设置。
- slotmanager.request-timeout:Slot 请求超时,默认5分钟,大作业可调大到10-15分钟。
- execution.checkpointing.interval:Checkpoint 间隔,开启 Checkpoint 确保故障恢复时状态不丢失。
六、常见问题与最佳实践
常见问题
-
调度延迟
- 原因:Slot 不足、上游未完成、调度器配置不当。
- 解决:增加 TM 数量,检查依赖关系,使用 adaptive 调度器,监控 SCHEDULED 状态持续时间。
-
部署失败
- 原因:TaskManager 无响应、网络异常、资源不足。
- 解决:检查 TM 心跳,确认网络连通,增加资源,查看 TM 日志,调大部署超时。
-
Task 频繁失败
- 原因:代码异常、数据倾斜、OOM、Checkpoint 失败。
- 解决:检查代码逻辑,优化数据分布,增加内存,调整 Checkpoint 配置,配置重启策略。
-
状态转换异常
- 原因:非法状态转换、并发问题、心跳超时。
- 解决:检查日志,重启 JM,调大心跳超时,查看 Execution 状态变化。
-
故障恢复慢
- 原因:使用 full 故障恢复、重启间隔过长、Checkpoint 恢复慢。
- 解决:改用 region 故障恢复,调小重启间隔,优化 Checkpoint,使用增量 Checkpoint。
-
Slot 泄漏
- 原因:Task 失败后 Slot 未正确释放,availableSlots 持续减少。
- 解决:监控 SlotPool 状态,检查作业取消逻辑,重启 JM 恢复,升级 Flink 版本。
最佳实践
-
流处理用 Eager 调度:流处理作业所有 Task 需要同时运行,使用 Eager 调度确保数据实时流转,避免下游等待上游完成。
-
批处理用 Lazy 调度:批处理作业分阶段执行,使用 Lazy 调度提高 Slot 复用率,节省资源,适合资源有限的环境。
-
配置 region 故障恢复:region 策略只重启受影响的 Task 区域,不影响其他区域,减少故障恢复时间和资源消耗,适合大多数流处理作业。
-
配置合适重启策略:稳定环境用 fixed-delay(固定次数和间隔),波动环境用 failure-rate(按失败率限制),测试用 no-restart。生产环境至少配置3次重试。
-
开启 Checkpoint:开启 Checkpoint 确保故障恢复时状态不丢失,Exactly-Once 语义保障。合理设置 Checkpoint 间隔和超时,使用增量 Checkpoint 减少恢复时间。
-
监控 Execution 状态:关注 Execution 状态变化,及时发现调度延迟和部署失败问题。监控 SCHEDULED 状态持续时间,过长说明 Slot 分配延迟;监控 DEPLOYING 状态持续时间,过长说明部署失败。
-
合理设置并行度:根据数据量和资源设置并行度,避免并行度过高导致调度开销大,或过低导致处理能力不足。Source 并行度受数据源分片数限制,可通过增加分片提高并行度。
七、总结
Flink Task 调度是一个6步流程:创建 Execution 实例 → 调度 Execution → 申请 Slot 资源 → 部署 Task 到 TaskManager → Task 运行执行 → Task 完成或失败。核心类包括 DefaultScheduler(默认调度器,按拓扑调度 Execution)、Execution(执行实例,状态机跟踪,部署 Task)、ExecutionVertex(执行顶点,并行子任务)、SlotPoolImpl(Slot 池,申请和管理 Slot)、TaskExecutor(Task 执行器,接收 submitTask,创建 Task)、Task(Task 实例,具体执行单元,运行算子链)。
调度策略有两种:Eager 调度(作业启动时一次性调度所有 Execution,适合流处理,启动快但资源需求大)和 Lazy 调度(按拓扑顺序逐步调度,上游完成后才调度下游,适合批处理,资源利用率高)。故障恢复流程5步:Task 失败 → 计算故障区域 → 取消受影响 Task → 重新调度 → 重启执行。region 故障恢复策略只重启受影响的 Task 区域,减少恢复时间。重启策略有 fixed-delay、failure-rate、no-restart 三种。
理解 Flink Task 调度的完整链路和核心类实现,有助于排查调度延迟、部署失败、Task 频繁失败、状态转换异常、故障恢复慢、Slot 泄漏等常见问题,为 Flink 作业的稳定运行提供保障。合理选择调度策略、配置故障恢复和重启策略、开启 Checkpoint、监控 Execution 状态、合理设置并行度,可以显著提高作业的性能和稳定性。