作者:张智泓
版权声明:原创作品,转载请注明出处课程:《Linux 内核分析》MOOC 课程 http://mooc.study.163.com/course/USTC-1000029000
引子:一件看起来"多此一举"的事
课上老师说了一句让我印象很深的话------"我们要扒开系统调用的三层皮"。
听着挺玄乎。翻译成人话就是:我们平时写下的那行 getpid(),从用户态一路走到内核,中间到底经过了哪些层?libc 说它是个"函数",内核说它是个"系统调用",这中间那层薄薄的膜,究竟是什么?
为了把这件事弄明白,我做了一件看起来很傻的事:同一个 getpid(),我写了两遍。
- 第一遍,规规矩矩调用 libc 提供的
getpid();
- 第二遍,把 libc 踢到一边,在自己的 C 代码里内嵌汇编,手动把系统调用号塞进寄存器,然后亲手执行
int $0x80。
结果两边拿到的 PID 都对。但过程,完全是两个世界。
这篇博客,就是这次"扒皮"的完整记录。
一、实验环境
|--------|---------------------------------|
| 项目 | 配置 |
| 平台 | Windows 11 + WSL2(Ubuntu) |
| 编译器 | gcc 15.2.0 |
| 关键编译参数 | -m32(生成 32 位程序) |
| 观察工具 | strace(追踪系统调用)、objdump(反汇编) |
为什么一定要加 -m32?
这是本实验里第一个容易被忽略、但很关键的设定。
x86 架构上存在两套进入内核的方式:
- 32 位经典方式 :
int $0x80,系统调用号放EAX,参数放EBX/ECX/EDX/ESI/EDI/EBP;
- 64 位原生方式 :
syscall指令,系统调用号放RAX,参数放RDI/RSI/RDX/R10/R8/R9。
课程里讲的是第一种(int $0x80 那套 32 位约定),所以实验也统一用 -m32 编译,让生成的机器码老老实实走 32 位路径,和课堂内容严丝合缝对上。
先确认环境能不能编 32 位程序:
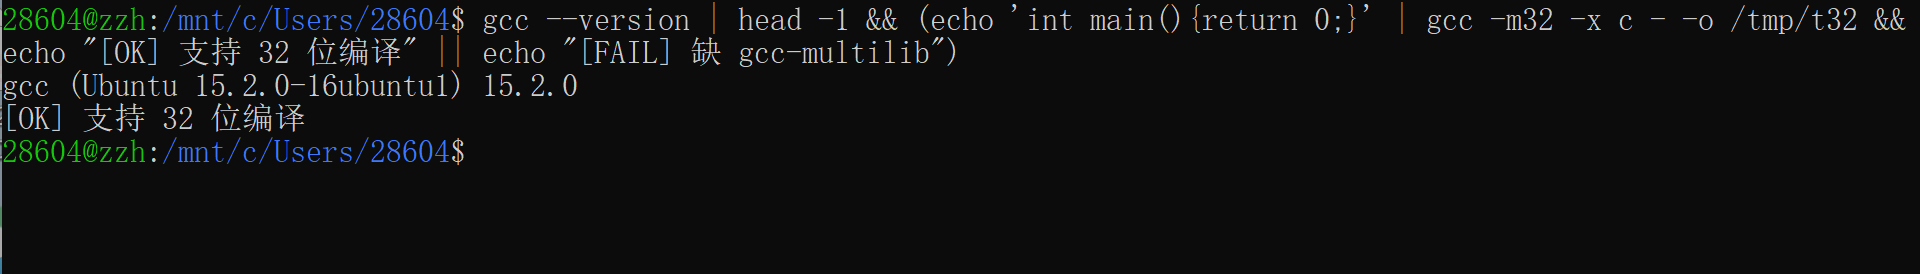
gcc 15.2.0 + [OK] 支持 32 位编译,环境没问题,可以开工。
二、第一层皮:规规矩矩调用 libc 的 getpid()
第一版程序,就是所有人学 C 时都会写的样子------直接用库函数:
编译、运行:
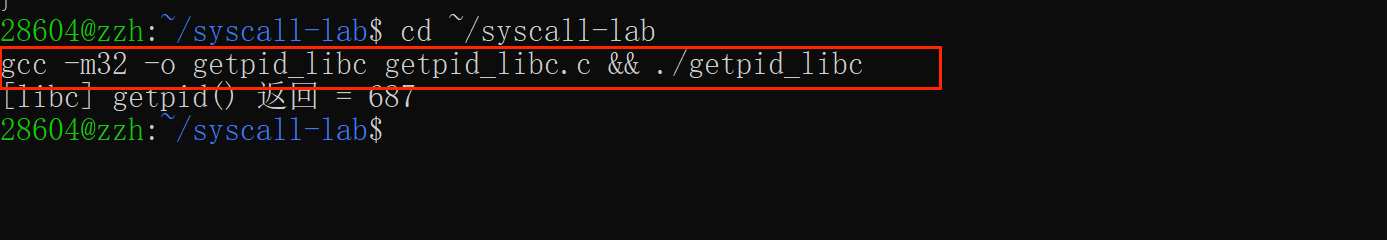
输出 [libc] getpid() 返回 = 687。
到这里,一切都"平平无奇"------我写下 getpid(),它就把 PID 给我了。但恰恰是这种平平无奇,才是系统调用设计得成功的地方:复杂性被彻底藏起来了。
那么,藏起来的部分长什么样?我们把 libc 的封装撕开看看。
三、第二、三层皮:绕过 libc,自己撞中断门
第二版程序,完全不用 libc 的 getpid(),而是用 C 内嵌汇编,手动完成系统调用的全部动作:
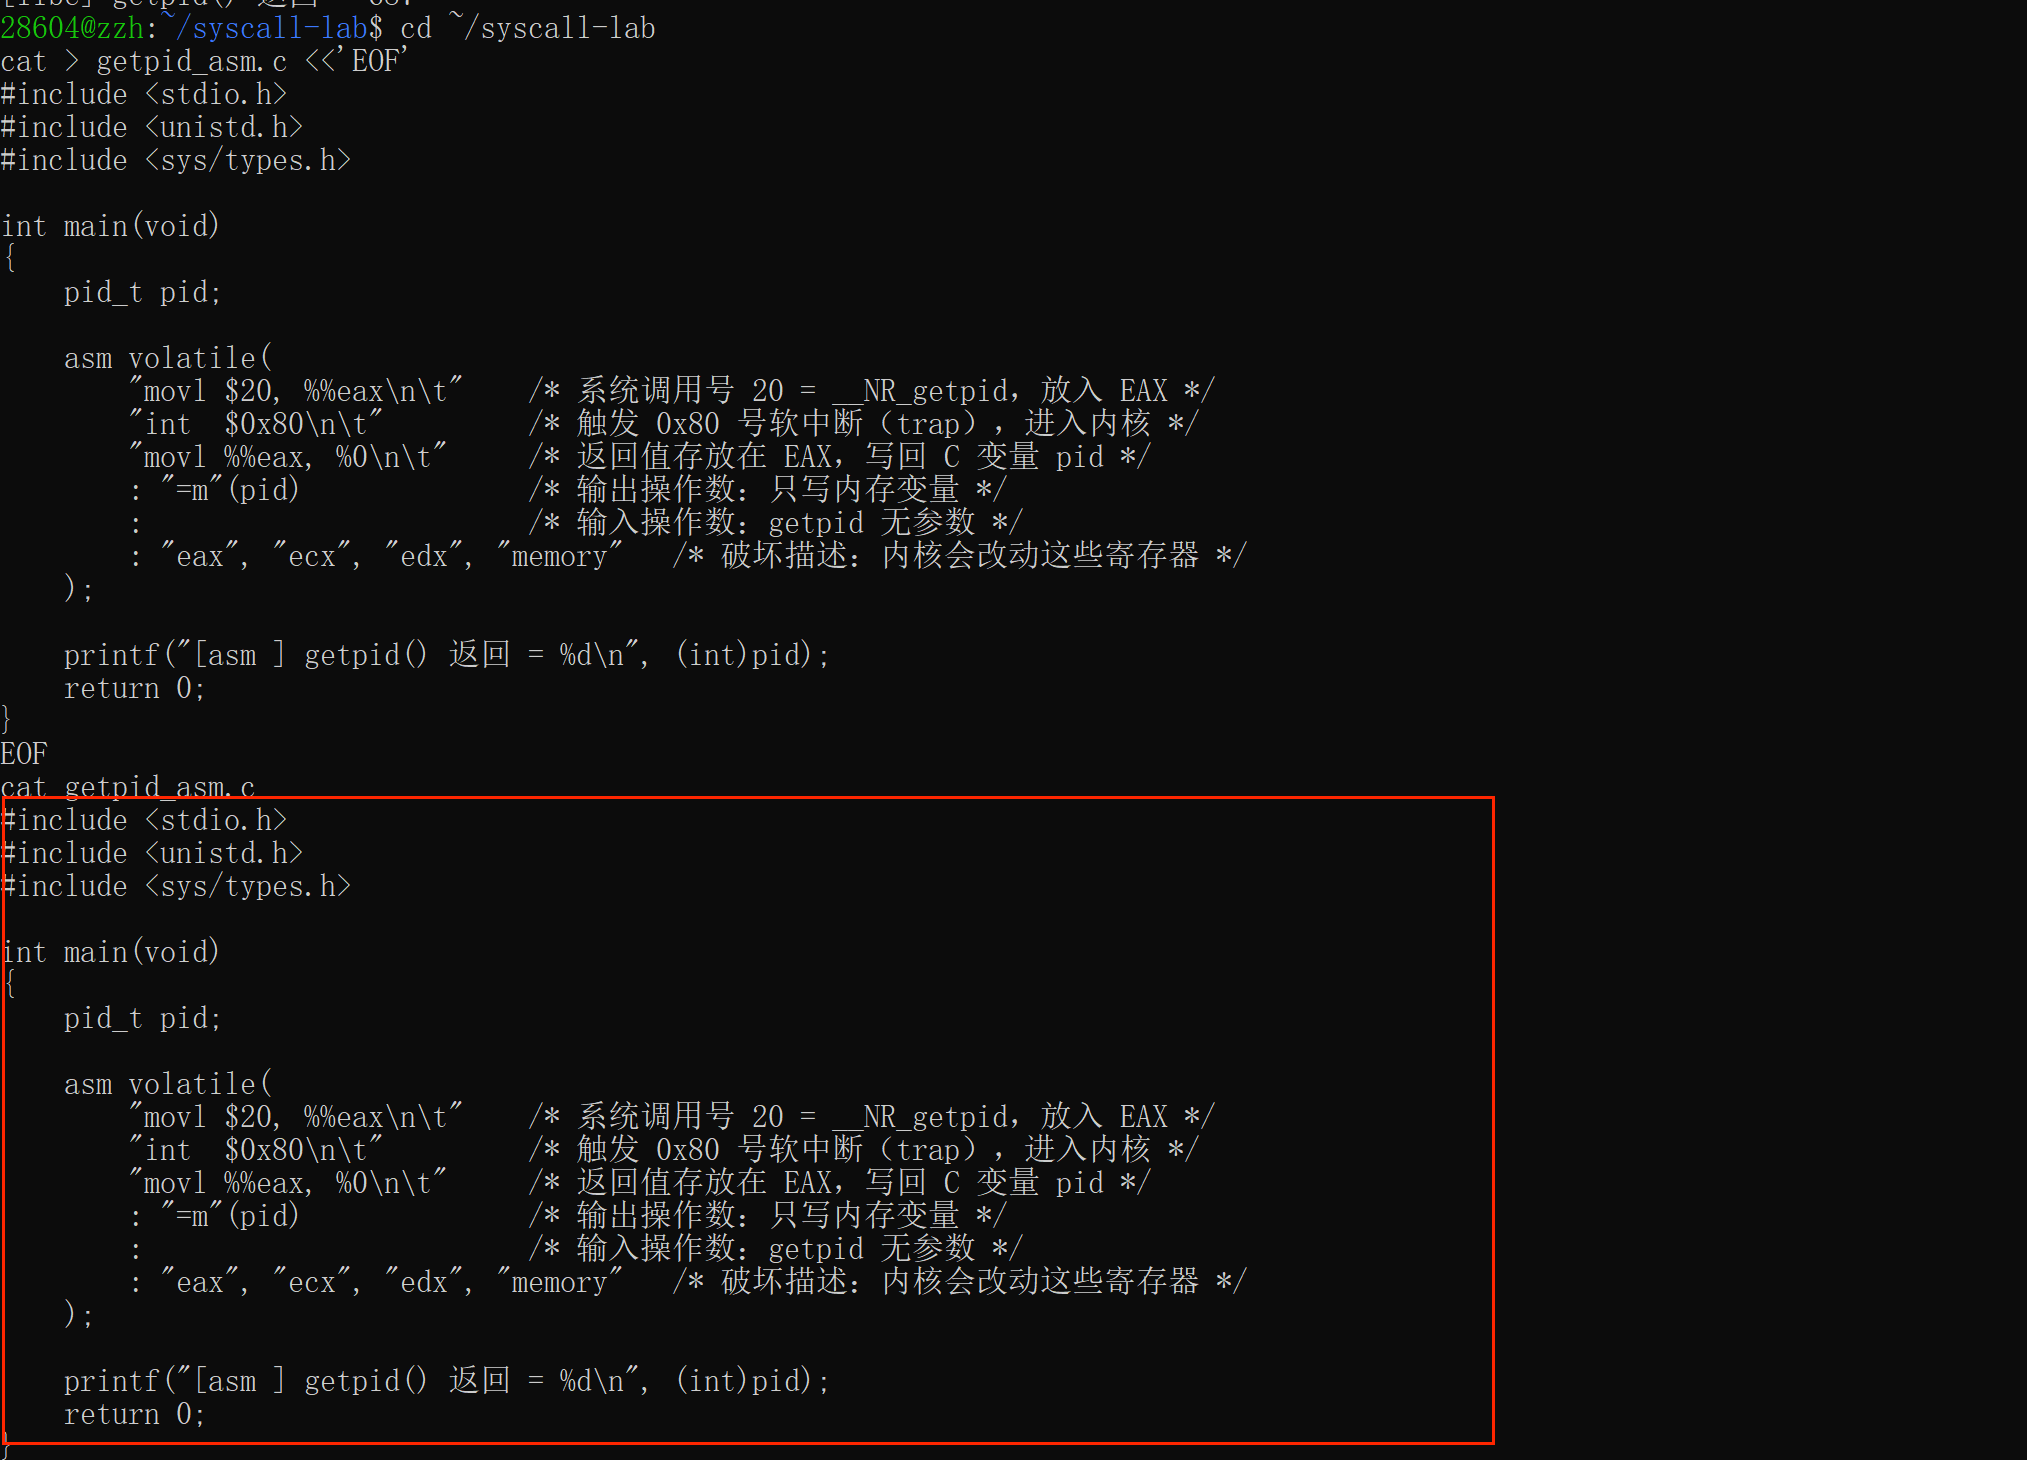
这几行汇编,其实就是 libc 内部干的事的"裸照"。逐句拆开看:
|------------------|--------------------------------------------|
| 汇编 | 作用 |
| movl $20, %eax | 20 是 __NR_getpid。内核要区分上百个系统调用,全靠这个号 |
| int $0x80 | 核心一步:主动触发 0x80 号软中断,CPU 从 ring 3 切到 ring 0 |
| movl %eax, pid | 内核执行完把结果放回 EAX,这里把它取出来存进 C 变量 |
编译、运行:
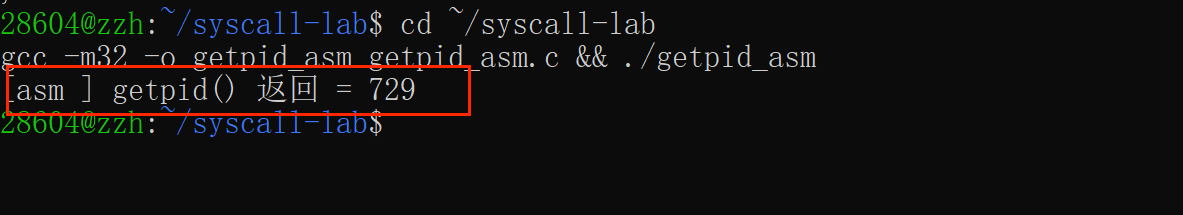
输出 [asm ] getpid() 返回 = 729。
两个 PID 数值不同很正常------每次运行都是全新的进程,内核自然分配新的 PID。真正值得注意的是:两版程序,一个走 libc、一个手写汇编,最后都拿到了内核给出的真实 PID。
四、证据一:strace 之下,殊途同归
口说无凭。凭什么断定"手工汇编那版"真的进了内核,而不是在用户态自己瞎转悠?
最直接的证据是 strace------它能打印出进程每一次真实发生的系统调用:
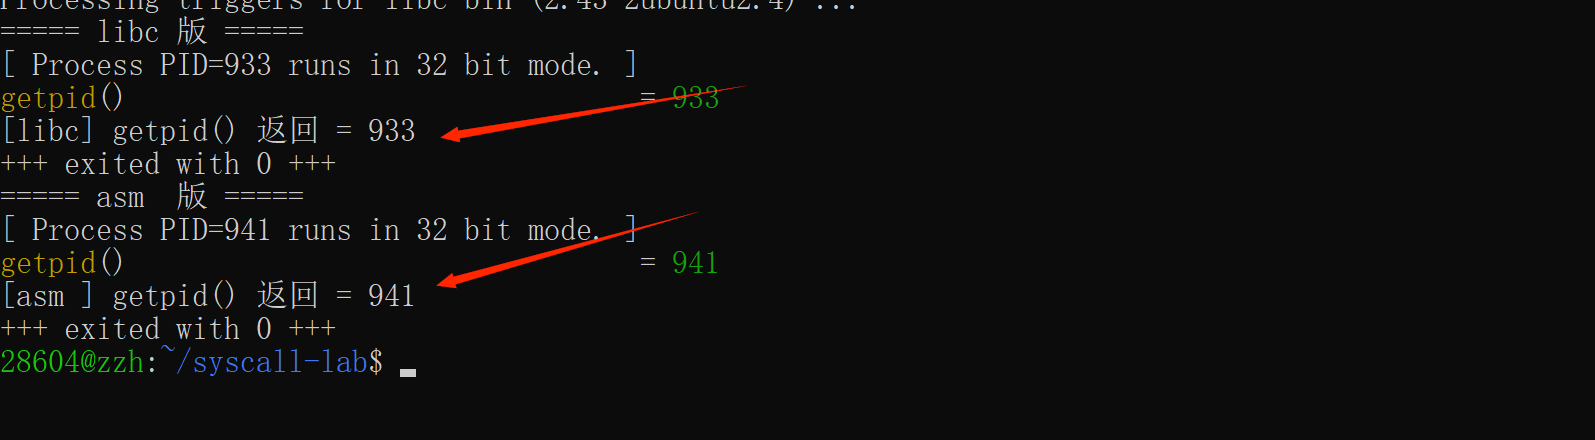
结果非常干净:
===== libc 版 =====
[ Process PID=933 runs in 32 bit mode. ]
getpid()                                = 933
[libc] getpid() 返回 = 933
+++ exited with 0 +++
===== asm  版 =====
[ Process PID=941 runs in 32 bit mode. ]
getpid()                                = 941
[asm ] getpid() 返回 = 941
+++ exited with 0 +++
两个关键点:
- 内核视角下,两个程序都发生了同一个
getpid系统调用,且返回值与 C 层打印的完全一致(933 / 941);
- strace 还贴心地标注了
runs in 32 bit mode,印证了我们-m32编译出来的确实是 32 位程序。
结论:libc 版和手写汇编版,走的压根就是同一条内核路径。 libc 只是替你写了那两行汇编而已。
五、证据二:objdump 之下,两条用户态路径
既然内核路径相同,那差异必然都在"用户态这一层"。用 objdump 反汇编两个可执行文件,取 main 函数看看:
objdump -d -M intel getpid_asm  | sed -n '/<main>:/,/^$/p'
objdump -d -M intel getpid_libc | sed -n '/<main>:/,/^$/p'
手写汇编版的 main(节选),要的东西全在明面上:
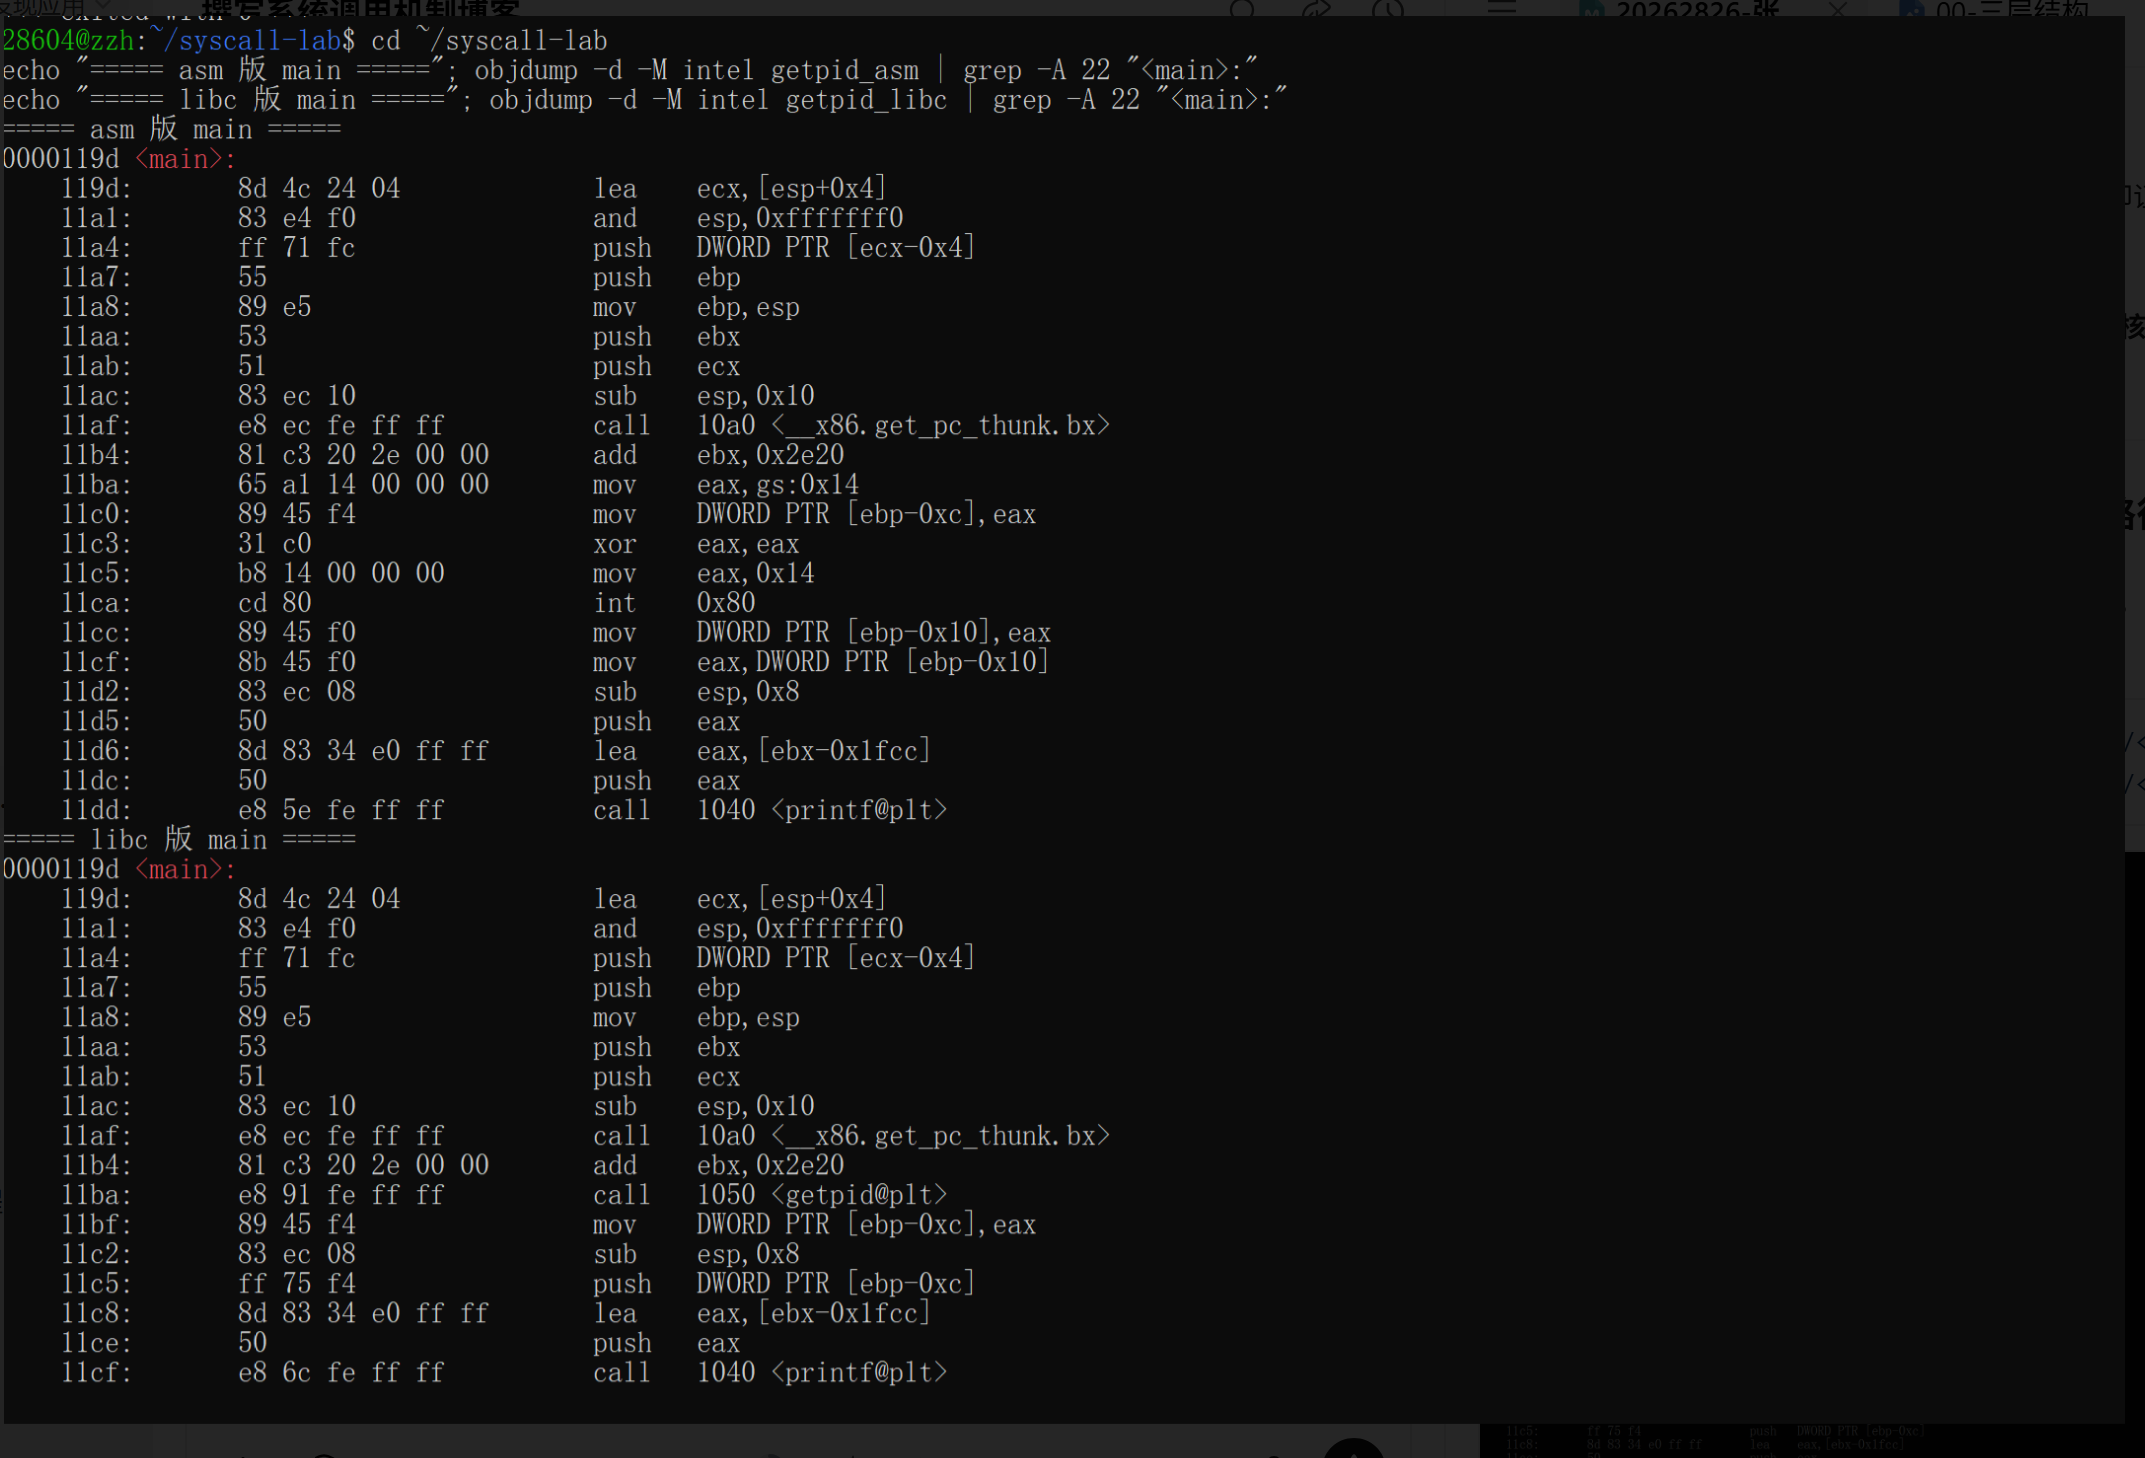
libc 版的 main(节选),同样的功能,却只有一行"转交":
11c5:  b8 14 00 00 00    mov  eax, 0x14     ; 0x14 = 20,系统调用号
11ca:  cd 80             int  0x80          ; 撞中断门,进内核
11cc:  89 45 f0          mov  [ebp-0x10], eax  ; 返回值写回 pid
对比非常直观:
- 手写汇编版把 "报调用号 → 撞门 → 取返回值" 三个动作全摆在了
main里,所以看得清清楚楚;
- libc 版只有一句
call getpid@plt,int $0x80那一步被藏进了 glibc 的函数实现中。
这就是"第一层皮"的本质 :libc 的 getpid() 只是一个"包装纸"。它替你完成了准备寄存器、执行 int $0x80、检查返回值这一整套流程,让程序员完全不必碰汇编。
六、把三层皮拼起来:一次系统调用到底怎么走完
到这里,课上的"三层皮"终于能拼成一张完整的图了:
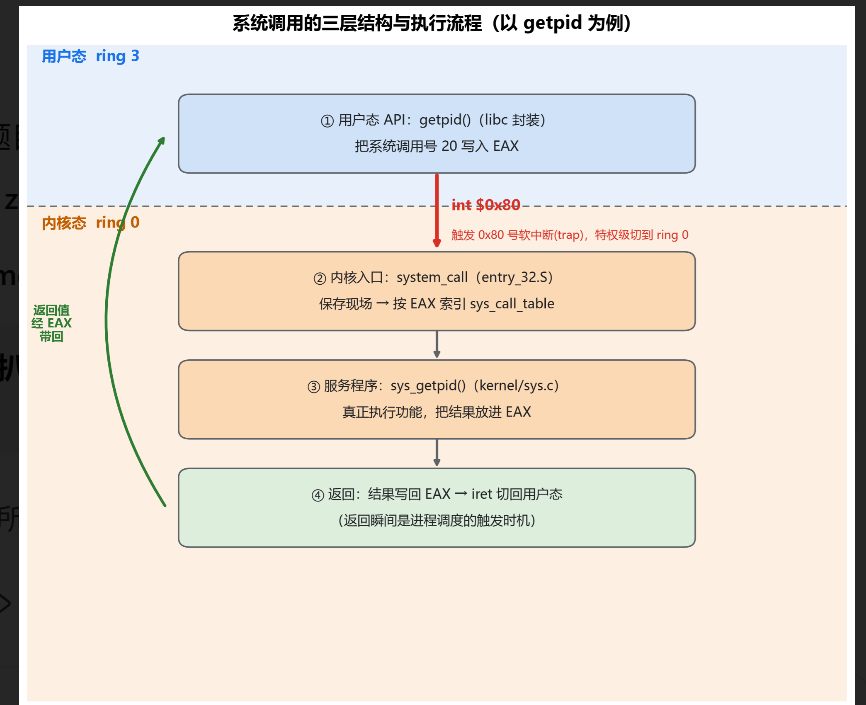
第一层皮 · 用户态 API。 也就是 getpid() 这个函数。它的职责很单纯:把系统调用号 20 写进 EAX,然后执行 int $0x80。
第二层皮 · 中断向量对应的内核入口。 int $0x80 会产生一个编号 128(即 0x80)的编程异常(trap,软中断) 。CPU 拿着这个编号去 IDT(中断描述符表)里查第 0x80 项------这个描述符的 DPL 被设成了 3,所以用户态可以合法地触发它 。跳转发生后,CPU 完成特权级切换(ring 3 → ring 0),改用内核栈,跳到内核入口 system_call(arch/x86/entry/entry_32.S)。
system_call 干两件事:保存用户态现场;然后以 EAX 里的值为下标,去 sys_call_table 这张函数指针表里取地址。
第三层皮 · 具体的系统调用服务程序。 表里第 20 项指向 sys_getpid()(kernel/sys.c)。这才是真正干活的函数------它读取当前进程 task_struct 里的 PID,把结果放回 EAX。
最后是返回路径:syscall_exit → 恢复现场 → iret 回到用户态。注意,返回用户态这个瞬间,正是内核检查"是否需要重新调度"的时机------如果此时此刻有更高优先级的任务在等,或者当前进程的时间片耗尽,就会在这里切去执行别的进程;否则,直接回到断点继续往下跑。
一句话概括这条链路:
用户态 getpid()
   │  调用号 20 → EAX
   ▼
int $0x80  ──trap──►  system_call(查 IDT 0x80 项,切到 ring 0)
   │                    │
   │                    └─► sys_call_table[20]
   │                            │
   │                            └─► sys_getpid()   ← 真正干活
   ▼                                 │
返回值 ◄──── EAX ◄────────────────────┘
  (iret 返回用户态,此处是调度时机)
七、参数是怎么"塞"进内核的------补一个 write 实验
getpid 是无参系统调用,"参数传递"这一块它讲不了。为了把课上那条规则(参数依次放进 EBX、ECX、EDX... )验证一遍,我补了 write(4 号系统调用,三个参数)做对照。
同样两版:libc 版和手写汇编版。
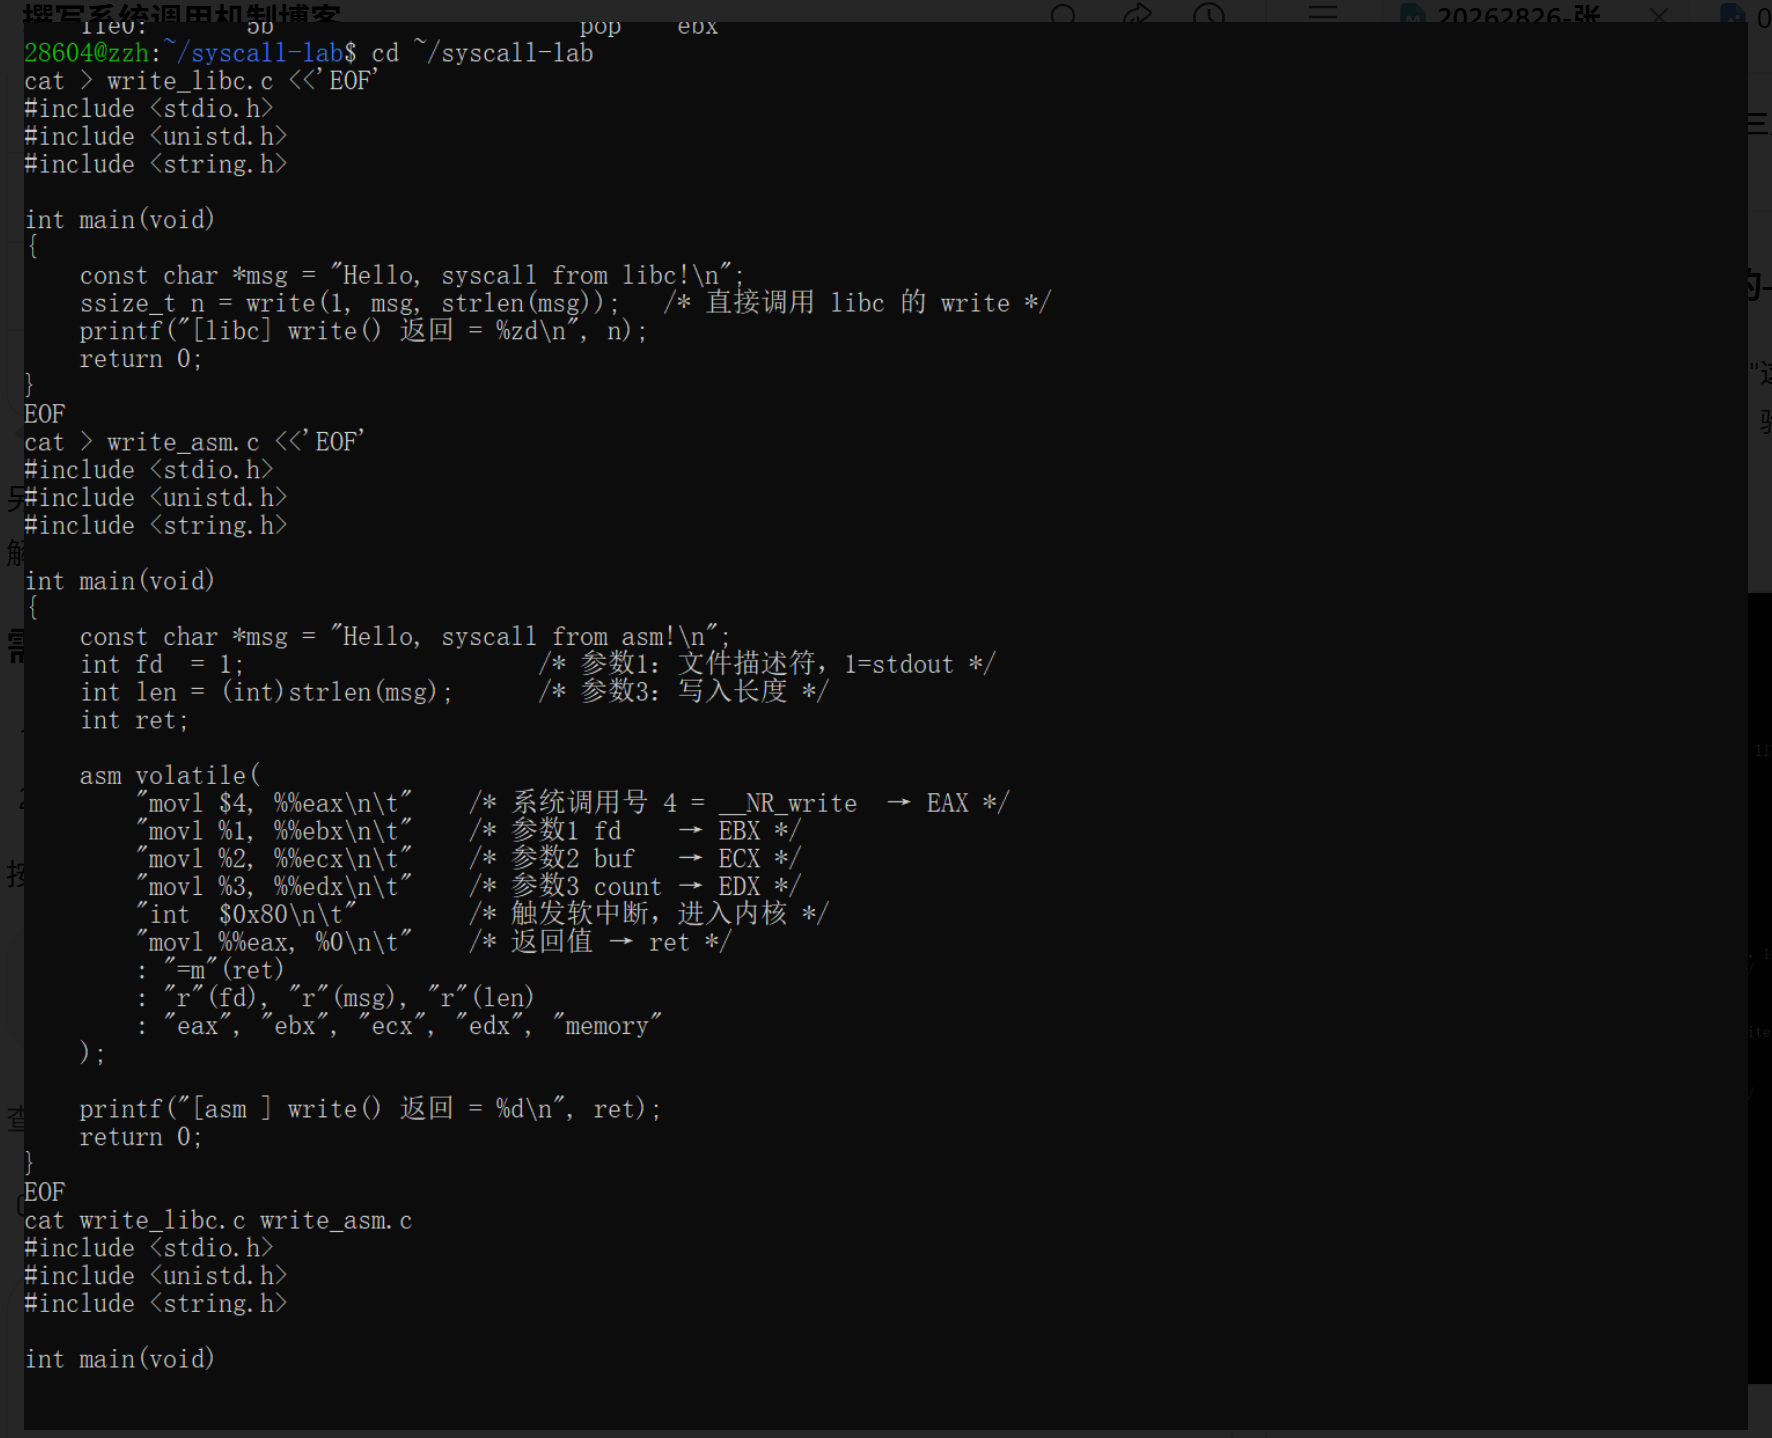
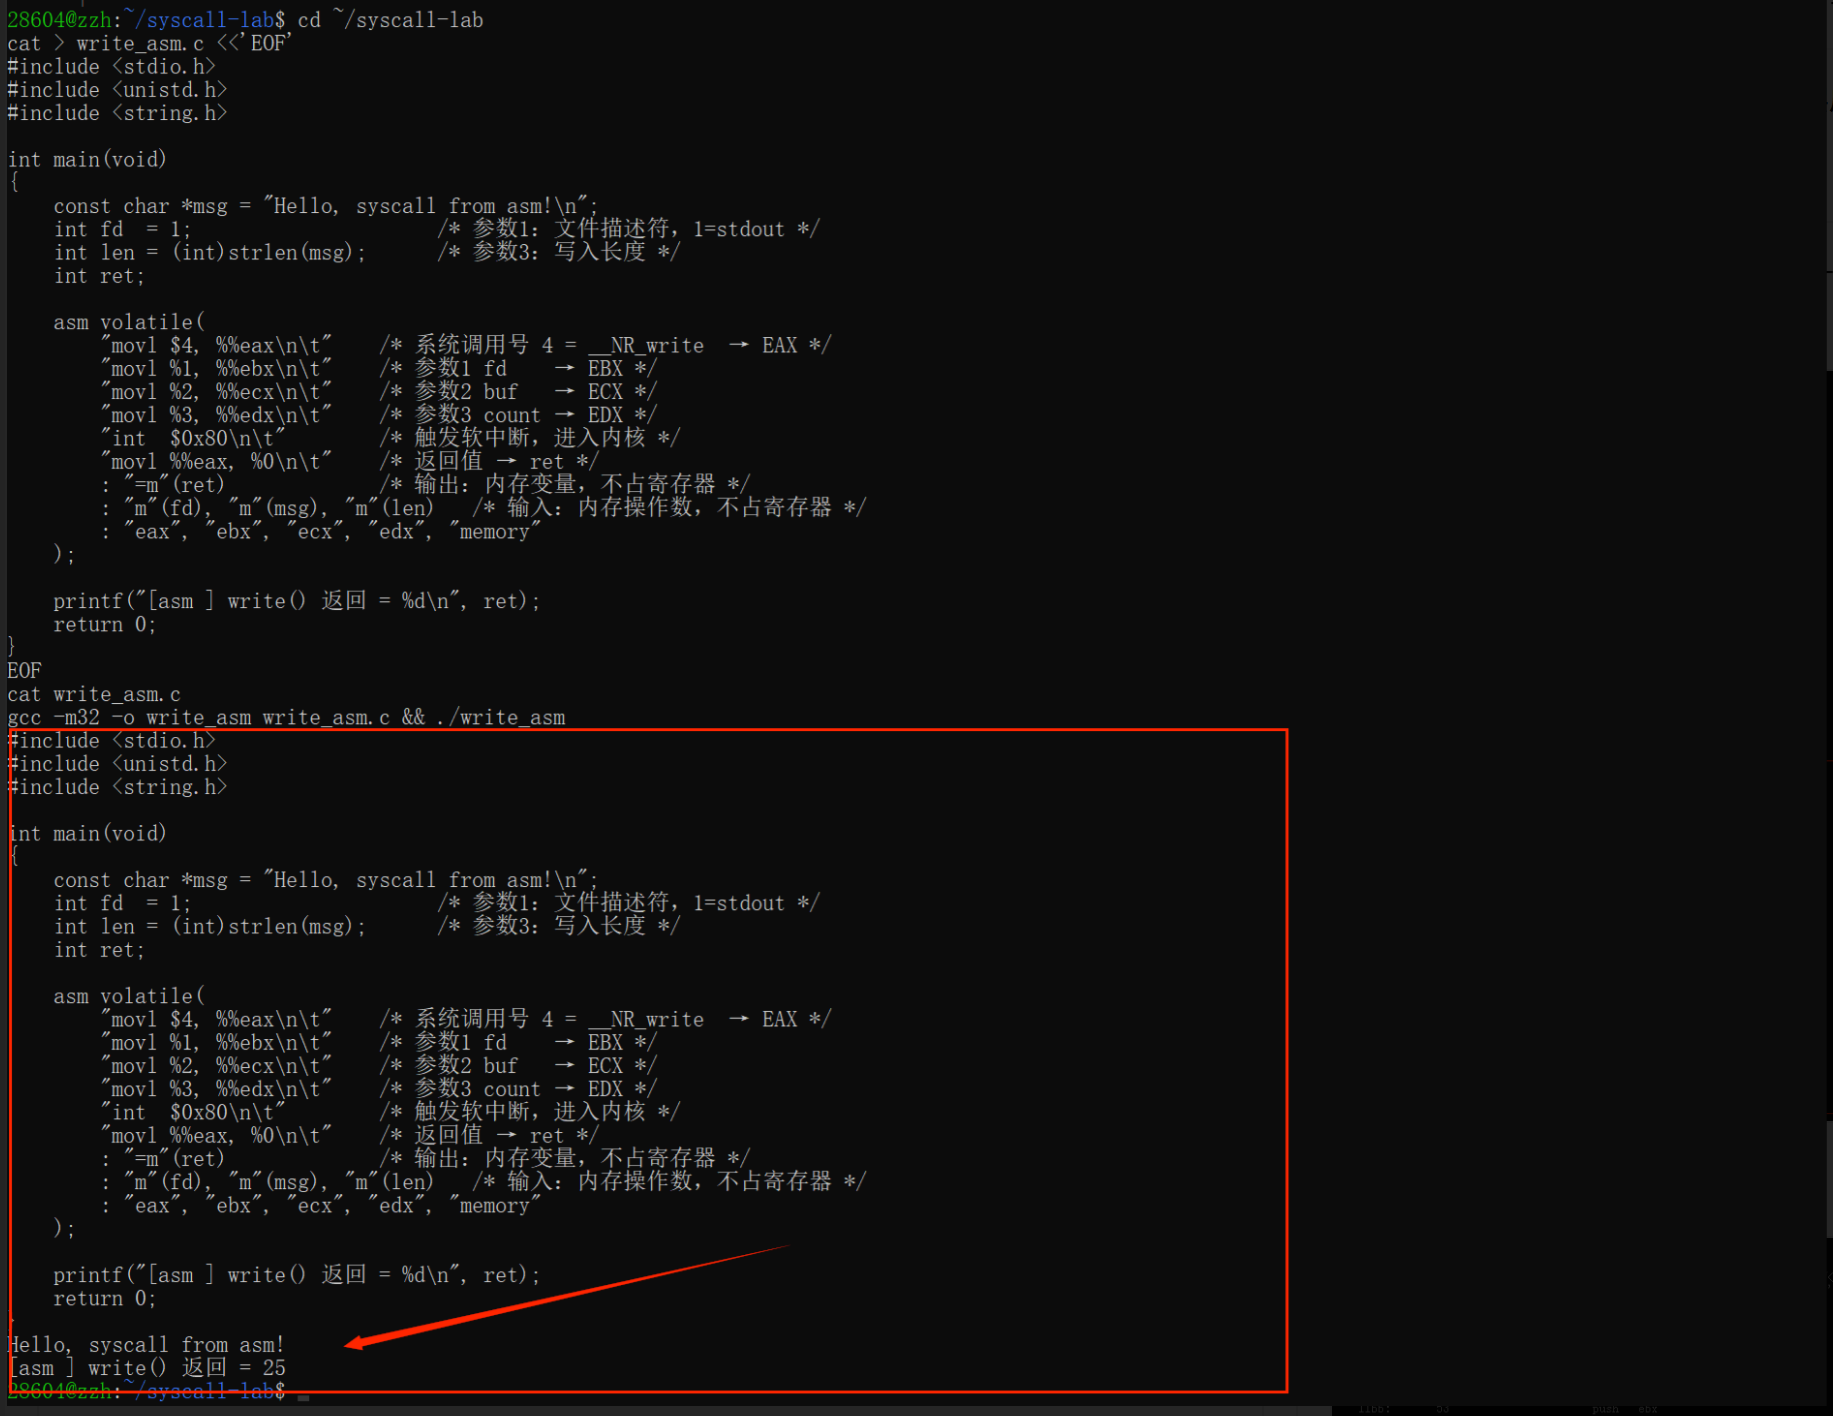
手写汇编版的关键在于"参数落位":
asm volatile(
    "movl $4, %%eax\n\t"    /* 系统调用号 4 = __NR_write  → EAX */
    "movl %1, %%ebx\n\t"    /* 参数1 fd    → EBX */
    "movl %2, %%ecx\n\t"    /* 参数2 buf   → ECX */
    "movl %3, %%edx\n\t"    /* 参数3 count → EDX */
    "int  $0x80\n\t"
    "movl %%eax, %0\n\t"
    : "=m"(ret)
    : "m"(fd), "m"(msg), "m"(len)
    : "eax", "ebx", "ecx", "edx", "memory"
);编译运行两版,输出除提示前缀外完全一致,write() 都返回了正确的字节数:
再看反汇编,参数传递的过程一目了然:
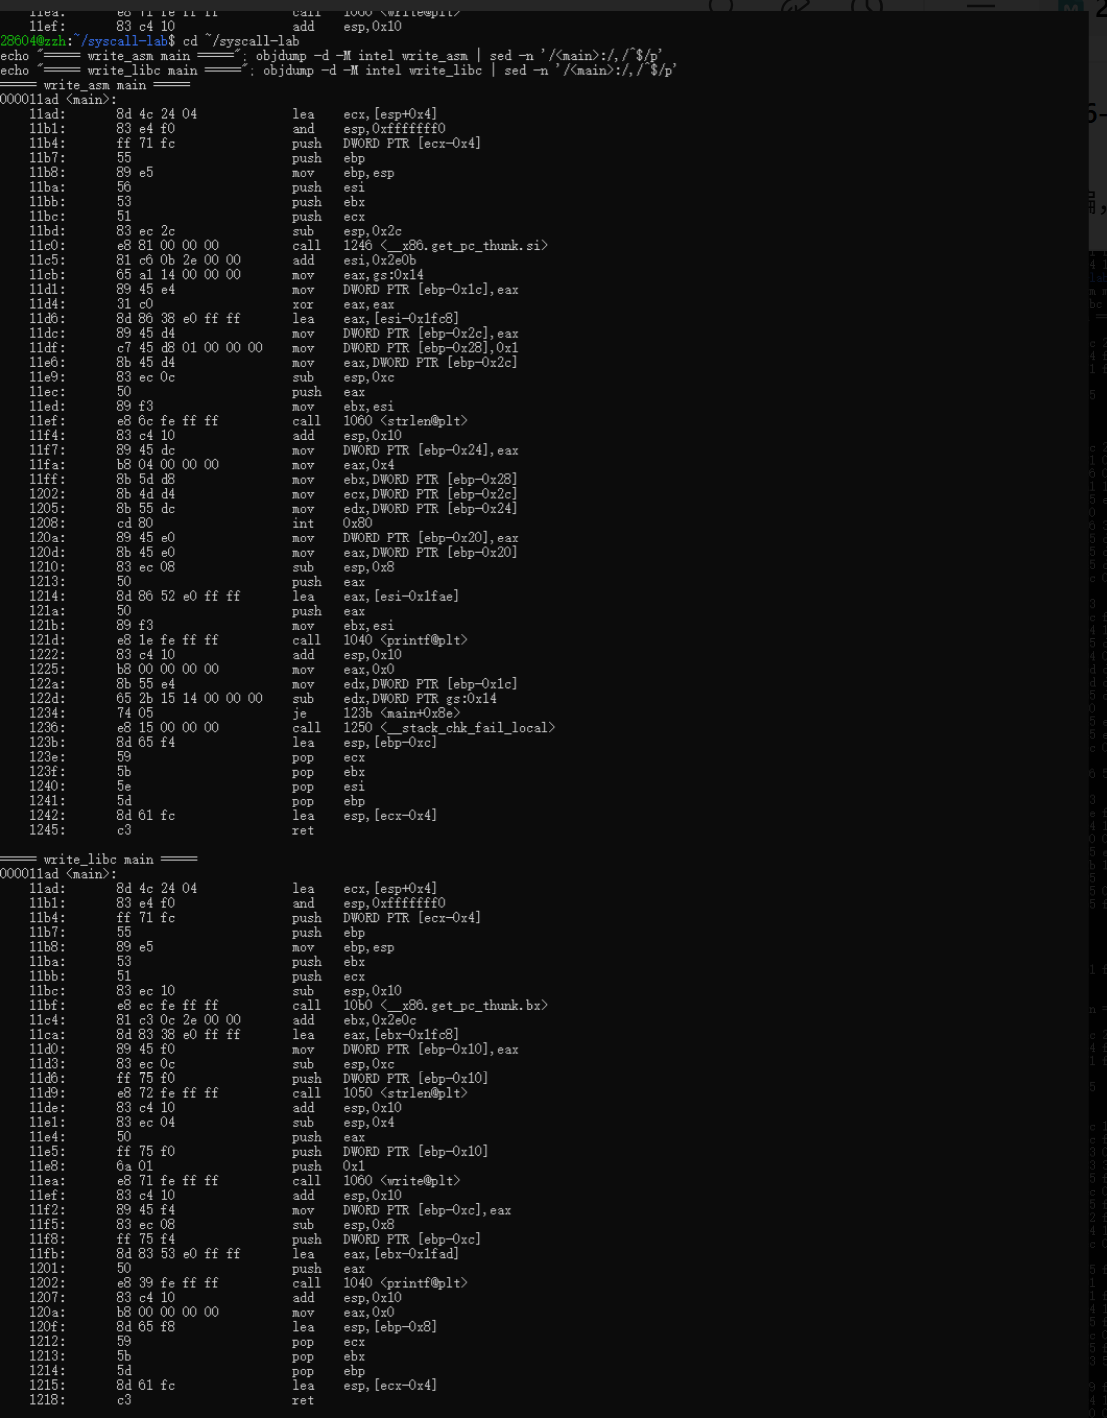
ov  eax, 0x4                 ; 调用号 __NR_write = 4
mov  eax, [ebp-0x28]
mov  ebx, eax                 ; 参数1 fd    → EBX
mov  eax, [ebp-0x2c]
mov  ecx, eax                 ; 参数2 buf   → ECX
mov  eax, [ebp-0x1c]
mov  edx, eax                 ; 参数3 count → EDX
int  0x80                     ; 撞门
mov  [ebp-0x20], eax          ; 返回值(写入字节数)→ ret
(编译器在这里经由 eax 中转了一下,是因为我把输入约束写成了 "m" 内存操作数,稍后会解释为什么必须这么写。但**"EBX → ECX → EDX 依次落位"这个顺序,看得清清楚楚**。)
作为对照,libc 版走的是另一条路------老老实实压栈再调用:
push 0x1               ; 参数 1
lea  eax, [ebp-0x10]   ; 参数 2
push eax
push 1                 ; 参数 3
call 1050 <write@plt>  ; 交给库
这里正好点出普通函数调用和系统调用的分野:
- 用户态内部调用函数,参数走栈 (
push再call);
- 用户态调用内核,参数走寄存器 ------因为特权级切换的同时也换了栈,用户栈上的东西内核不能直接拿来当"参数约定",必须用一套双方都认的规则:系统调用号放
EAX,参数依次放EBX、ECX、EDX、ESI、EDI、EBP,最多 6 个。
那超过 6 个参数怎么办?答案是:退化成"一个指针"------把这些参数先在用户态内存里排好,只往一个寄存器里放"指向这块内存的指针",内核进来后按指针去读整块参数。本质上是"寄存器不够,内存来凑"。
八、踩坑记录
实验过程并不顺,这里如实记两个坑。
坑一:strace 没装
第一次跑 strace 直接报 command not found。解决办法很简单:
sudo apt install -y strace小提示:这一步其实很能说明"用户态 API 是库的一部分"------
strace并不属于内核,需要额外安装。
坑二:内嵌汇编报 impossible constraints(这个坑更有价值)
write 版第一次编译,直接失败:
排查过程: 报错说的是"寄存器不够"。可我明明只用了几个寄存器,怎么会不够?
原因找到了 :i386 一共 8 个通用寄存器,其中 ESP(栈指针)、EBP(帧指针)被 C 运行时占用,编译器实际能自由支配的只剩 6 个。而我最初的写法里,一方面在破坏列表里声明了 eax/ebx/ecx/edx 四个,另一方面又用 "r" 约束要求编译器再额外分配 3 个寄存器来装载输入 ------ 3 + 4 = 7 > 6,编译器凑不出来,于是直接罢工。
解决办法 :把输入约束从 "r"(寄存器)改成 "m"(内存操作数)。内存操作数不占寄存器 ,值直接从栈上取;汇编模板里仍显式 mov 到 EBX/ECX/EDX。改完之后编译顺畅,结果也完全正确。
收获 :内嵌汇编的"寄存器账"必须自己算清楚。破坏列表(clobber list)里声明的寄存器,编译器在分配输入/输出时是会避开的------你声明得越多,留给输入的就越少。这条规则看着简单,不亲手踩一次是真记不住。
九、我对"系统调用工作机制"的理解
做完这两组实验,我对"系统调用"这件事的理解,从"记住概念"变成了"看见动作"。总结成四点:
第一,系统调用的本质是"一次受控的特权级穿越"。 用户态永远不能直接碰硬件和内核数据,但进程又必须能读写文件、申请内存、获取时间。系统调用就是那道被正式批准的"门":平时锁着,只有通过 int $0x80(或 syscall)这个特定动作,CPU 才会打开它,并同时完成"换栈 + 换特权级"。所谓安全,不是不让进,而是"只准从这个门、按这个姿势进"。
第二,所有系统调用共享"一个门、一张表"。 上百个系统调用并没有上百个入口,它们全都挤在同一个入口 system_call 上,靠 EAX 里的编号分流。这个设计非常经济:内核只需要维护一张 sys_call_table 函数指针表,新增系统调用无非是"表里加一项、编号往后排"。用户态和内核态之间因此形成了一份极其稳定的契约------编号 + 寄存器约定。
第三,参数走寄存器,是特权级切换的必然结果。 我一开始天真地以为"参数当然走栈",直到看见 libc 的 push 和汇编版的 mov ebx/ecx/edx 并排出现,才明白:切换栈之后,用户栈对内核来说不再是"约定的调用帧"。于是必须另立一套规矩,把参数搬进寄存器。六个寄存器不够,就用内存块加指针------这不是随意规定,而是"寄存器数量"这个硬约束逼出来的工程折中。
第四,返回的那一刻并不平凡。 课程里那句"返回用户态时是进程调度的触发时机",我一开始没太在意。做实验时盯着 strace 的输出才反应过来:系统调用返回前,内核会检查是否有"待处理的工作"(信号、需要重新调度等)。也就是说,每一次 write、每一次 getpid,在把结果交还给你之前,都可能顺手换一个进程上去跑。系统调用不只是"用户请求服务",它同时也是内核介入调度、维持公平的天然窗口。
如果用一句话收尾:
libc 的 API 是"自动挡",
int $0x80是"手动挡"。踩下离合器那一刻(mov $20, %eax)、挂挡进门的动作(int $0x80),才是系统调用真正发生的地方。
十、小结
- 同一个
getpid,用 libc API 与内嵌汇编两种方式调用,结果一致;strace证明两者在内核眼中是同一个系统调用。
objdump反汇编揭示差异全在用户态:libc 只是替我们写了int $0x80那两行汇编。
- 系统调用分三层:用户态 API → 0x80 中断向量对应的内核入口
system_call→ 具体的服务程序sys_getpid。
- 参数传递规则:调用号放
EAX,参数依次放EBX/ECX/EDX/ESI/EDI/EBP,最多 6 个;超过 6 个用内存块指针。
- 实验踩坑两条:
strace需单独安装;内嵌汇编必须算清"寄存器账","m"约束不占寄存器。
最后再强调一句:AI 是辅助,不是代笔。 本文的实验思路、代码和每一步结论都经过我本人在 WSL 环境中实际编译、运行、反汇编验证;文中出现的每一张截图、每一个 PID、每一条 strace 输出,都可以按文中命令原样复现。技术这东西,看别人写一百遍,不如自己撞一次中断门。
作者:张智泓 原创作品,转载请注明出处 《Linux 内核分析》MOOC 课程 http://mooc.study.163.com/course/USTC-1000029000