照着 MiniMax 官方示例改了半天,请求还是 401,或者返回一串 gateway_error,这类问题多半出在 base_url 和模型调用名没对上。你手里可能已经有一把能用的 API Key,也装了 openai 包,但第一个调用就是跑不通。这篇教程不重复宽泛的接入流程,只围绕 MiniMax 模型在 OpenAI 兼容端点上的几个真实坑展开。读完能拿到一份可直接运行的脚本,并知道每个参数为什么这么填。
一、场景与前置条件
这篇文章假设你要通过 OpenAI Python SDK 访问 MiniMax 系列模型。典型场景是:已经在本地写好 client.chat.completions.create,原以为只改 model 参数就能用,结果要么认证失败,要么模型找不到。问题通常不在 SDK 版本,而在三处:Base URL 少了 /api/v1、环境变量里没有密钥、模型调用名不是平台规范名。如果你同时还要处理流式输出,也需要先确认自己走的是 /chat/completions 而不是其他格式端点。
开始前你手上需要四样东西:Python 3.10 及以上解释器、可用的 openai 包、一个前缀为 sk_live_ 的密钥、能在终端里执行 export 的 shell。本文示例在 OpenAI SDK 1.x 风格下验证,不涉及 Anthropic Messages 格式。用 requests 直接发 POST 当然也能通,但建议先用 SDK 跑通最小示例,减少认证和请求头拼错的可能。
二、环境准备
先装依赖。执行 pip install openai,版本在 1.x 即可。SDK 初始化时主要读取两个参数:api_key 和 base_url。这里的 base_url 必须逐字符写成 https://www.silvamux.com/api/v1,不能把域名改成 api 开头,也不能丢掉 /api/v1,那些地址不存在,照抄就会 404。这是整个教程里最容易写错的一行,没有之一。
密钥不要硬编码在脚本里。正确做法是放进环境变量 SILVAMUX_API_KEY,原因有两个:脚本提交到 git 后密钥不会跟着泄露;代码里只出现变量名,日志脱敏也更容易。创建密钥时要留意,sk_live_ 开头的值只在控制台显示一次,一旦离开页面就看不到了。终端里把刚才生成的密钥 export 成这个变量,再重新打开终端或 source 环境文件,SDK 才能读到。很多 401 不是密钥错了,而是当前 shell 根本没加载新变量。
三、最小可跑示例
下面这个脚本可以直接复制运行,只需要保证环境变量已经导出。脚本先初始化 OpenAI 客户端,再发起一次 MiniMax 模型的对话补全请求,最后打印回复内容和实际响应的模型名。这里选择 minimax-m2.5 作为调用名,因为它是稳定 alias,适合放在教程里长期维护。
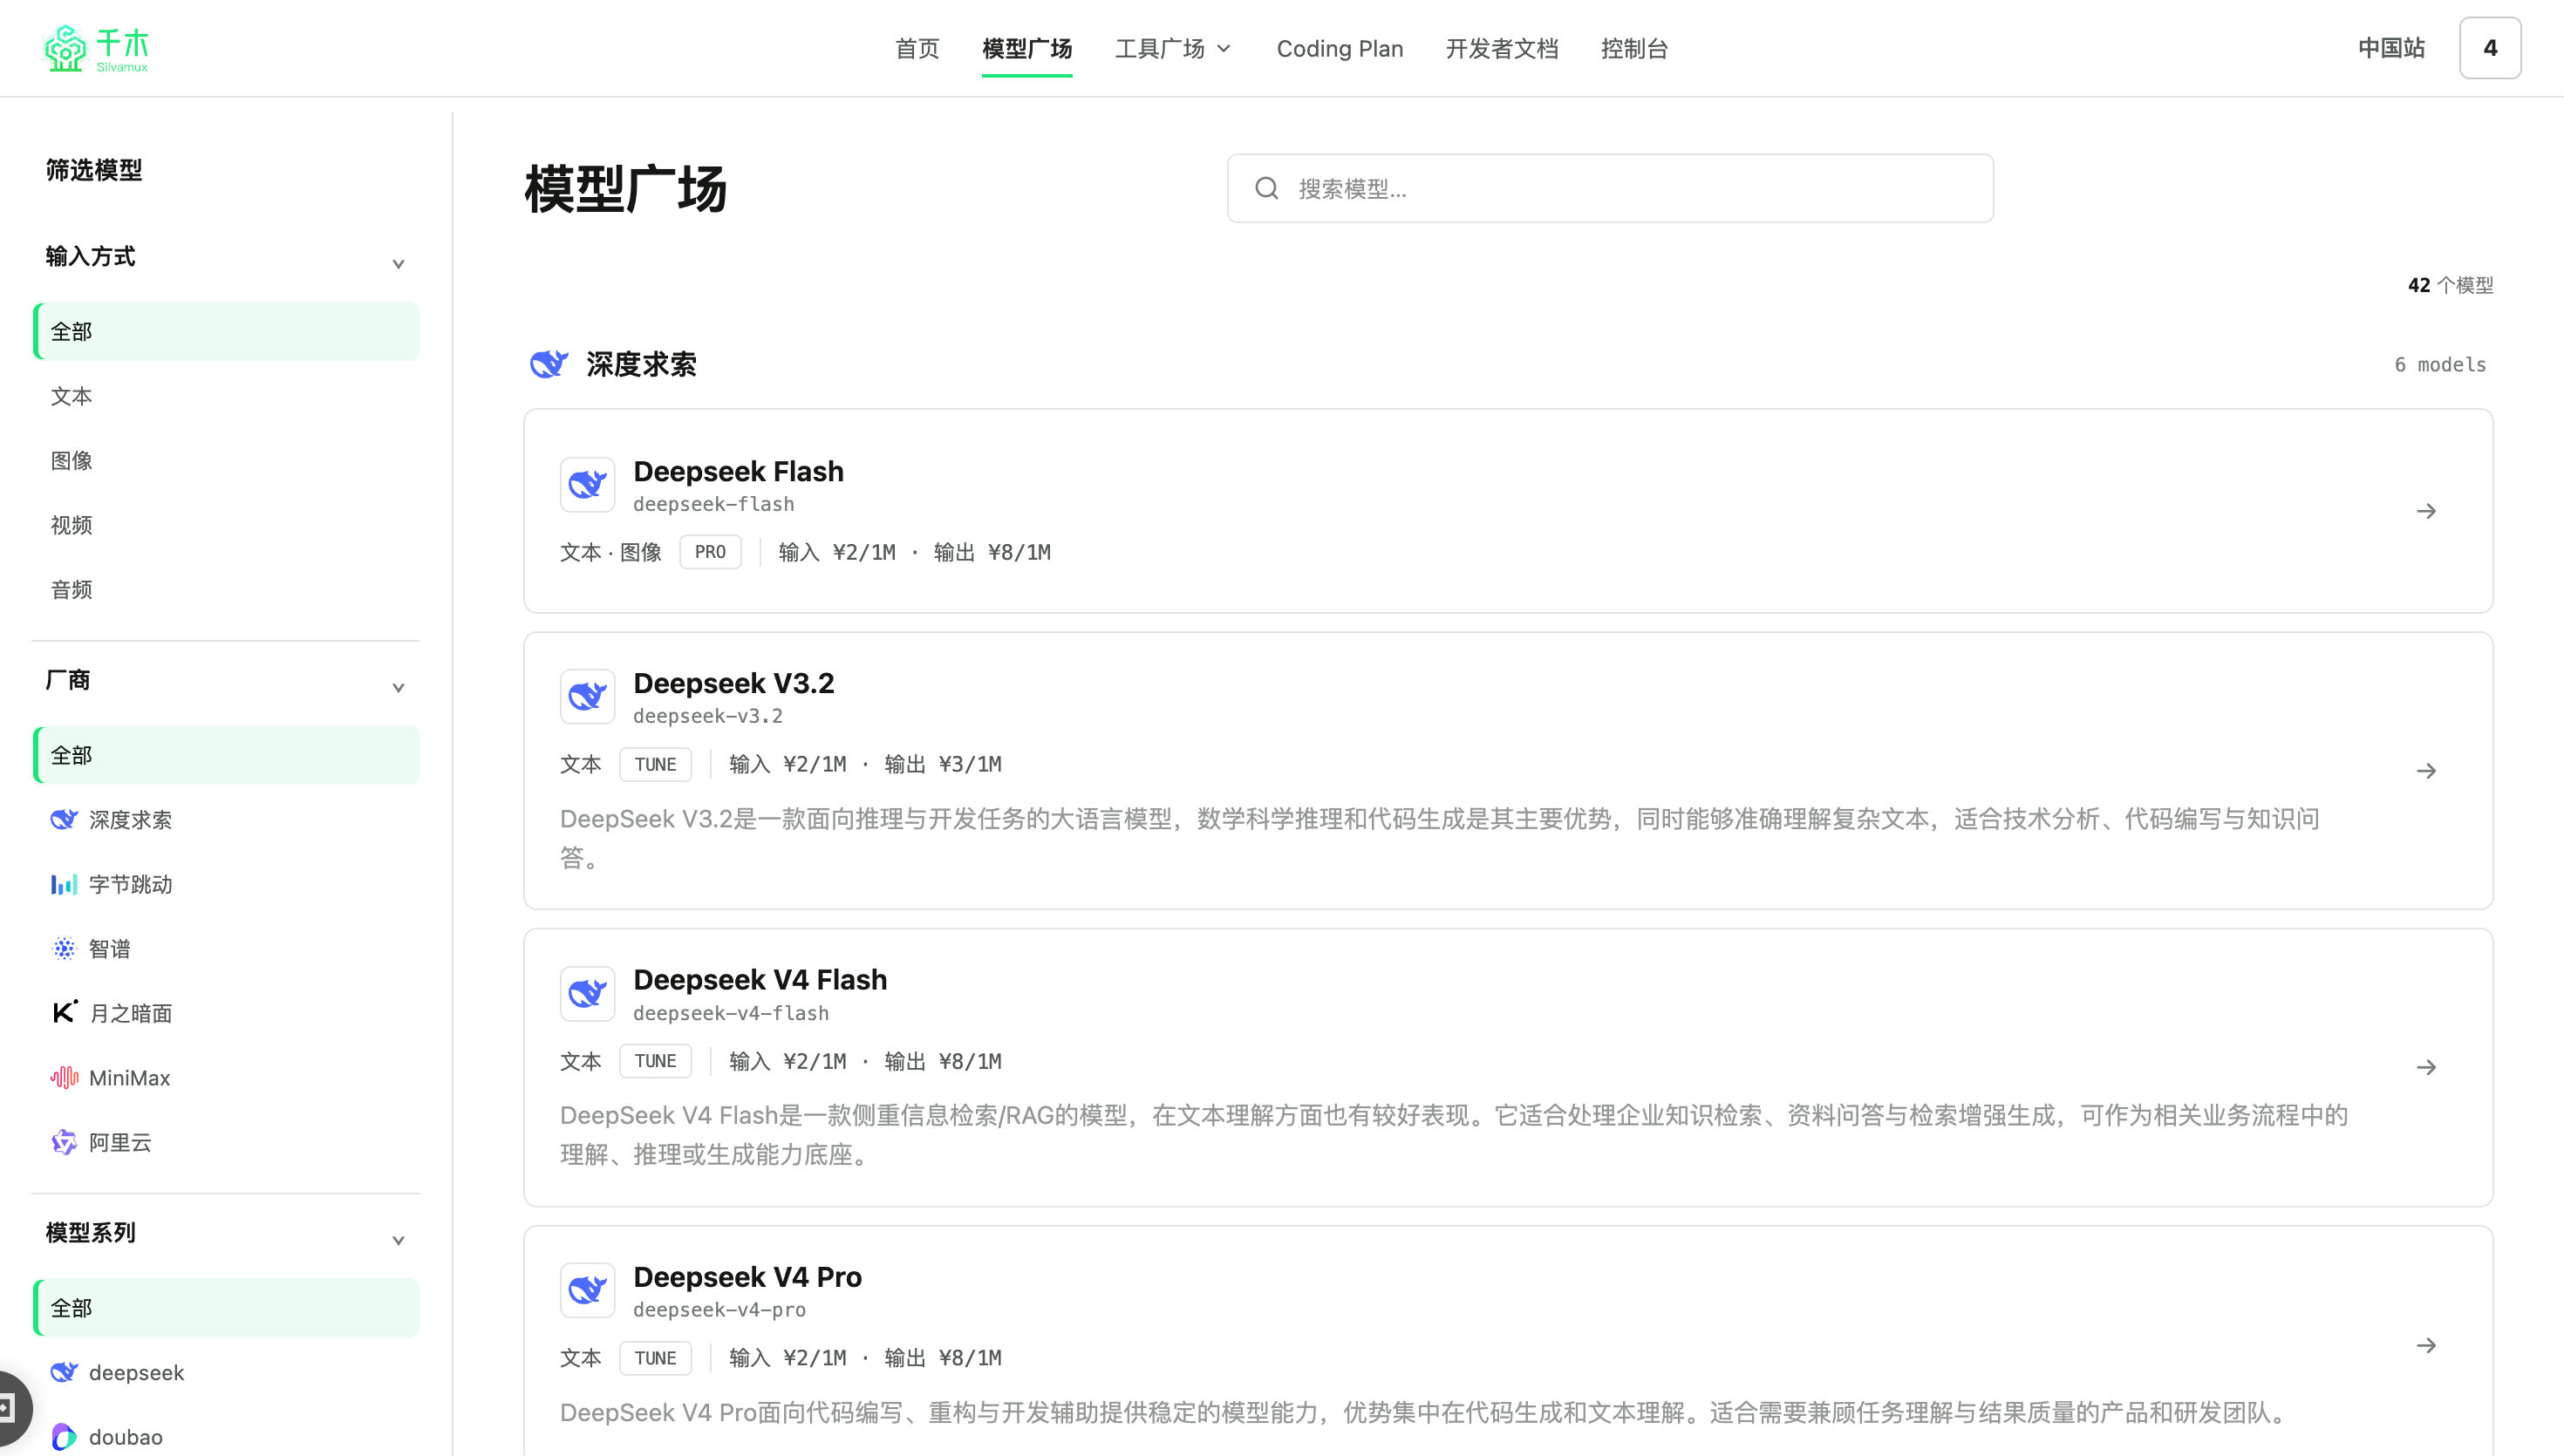
容易填错的是 model 和 base_url。模型调用名不能根据展示名自行拼接,比如给 minimax-m2.5 末尾加日期、加 -202506,这些名字模型广场详情页里没有,请求会直接抛 NotFoundError。base_url 要保持示例里的完整路径,少一个 /api/v1 就会落到错误资源上。
python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["SILVAMUX_API_KEY"],
    base_url="https://www.silvamux.com/api/v1",
)

resp = client.chat.completions.create(
    model="minimax-m2.5",
    messages=[
        {"role": "system", "content": "你是技术文档助手,回答要简洁。"},
        {"role": "user", "content": "解释 MiniMax API 调用的 base_url 作用。"},
    ],
    temperature=0.7,
    max_tokens=512,
)

print(resp.choices[0].message.content)
print(resp.model)
第 4 到 6 行的 OpenAI(...) 是关键。api_key 从环境变量读取,不写死;base_url 指向兼容端点,SDK 会把 /chat/completions 拼到它后面。把 base_url 写成少 /api/v1 的版本,或者把域名改成 api 开头,SDK 不会自动纠正,请求路径会 404 或连接失败。model 这一行必须与模型广场详情页的调用名一一对应。messages 里的 system 不是必填,但给一个简单角色描述能让输出更稳定。temperature=0.7 和 max_tokens=512 是可选参数,调试阶段显式限制 max_tokens 可以防止一次长回复把调试预算吃光。
四、逐步扩展
跑通最小脚本后,第一个值得加的能力是流式输出。MiniMax 的长回复如果等到完整内容返回,体感会比较慢。改成 stream=True 后,SDK 会逐段吐字,终端能立刻看到内容,也更容易判断请求是不是卡在中间。
另一个实用扩展是自定义请求头。每次请求带上一个自己生成的 X-Request-Id,出问题时可以直接拿这个值去查日志,比只报一个笼统的错误码好定位。请求头不会影响生成内容,但排查问题时会省很多事。
python
stream = client.chat.completions.create(
    model="minimax-m2.5",
    messages=[
        {"role": "user", "content": "用三句话解释 /api/v1 和 /v1 的区别。"}
    ],
    stream=True,
    max_tokens=512,
)

for chunk in stream:
    if chunk.choices and chunk.choices[0].delta:
        print(chunk.choices[0].delta.content, end="", flush=True)
    if getattr(chunk, "usage", None):
        print("\nusage:", chunk.usage)
流式处理时,最后可能来一个 choices 为空但带 usage 的 chunk。这是用于返回用量的,不是内容块。写代码时不要直接访问 chunk.choices[0],否则会在最后一块抛 IndexError。上面的判断先确认 chunk.choices 非空,再读 delta。
python
resp = client.chat.completions.create(
    model="minimax-m2.5",
    messages=[{"role": "user", "content": "你好"}],
    extra_headers={"X-Request-Id": "REQ-minimax-debug-001"},
)
print(resp.choices[0].message.content)
extra_headers 是 OpenAI SDK 支持的透传参数,服务端会沿用这个值。这里的 REQ-minimax-debug-001 只是调试标识,你可以换成自己的命名。注意它和模型参数无关,填错不会影响输出,但会失去定位线索。
五、排错
排错顺序别乱。先看 HTTP 状态码,再看响应体里的 type 和 code 字段,最后才是堆栈。下面四条是实际接入时容易出现的现象。
-
openai.AuthenticationError: 401 status code (no body)直接原因:环境变量没导出、当前 shell 没重新加载、密钥前缀不是
sk_live_,或把上一套接入的密钥原样搬了过来。修法:先在终端里检查环境变量是否为空,没有就重新 export 并重开终端。不要在代码里写死回退密钥。
-
openai.NotFoundError: 404 status code (no body)直接原因:
base_url少了/api/v1、域名写成 api 子域,或者模型调用名自行拼了日期。修法:回到模型广场详情页复制
minimax-m2.5这类 alias,不要把展示名当作调用名。 -
IndexError: list index out of range,通常出现在流式代码处理最后一个 chunk 时。直接原因:兼容端点在流式末尾可能返回
choices为空、只有usage的用量块,代码却直接访问chunk.choices[0]。修法:改成
if chunk.choices and chunk.choices[0].delta:再读内容,并保证循环自然结束。 -
openai.RateLimitError: 429 status code (no body)直接原因:请求太密集,服务端要求退避后再试。
修法:429 使用指数退避;500/502 可以隔 1 到 5 秒重试,400/401/402/403 不要重试,先改参数或检查认证。
常见问题
模型调用名从哪里复制?
不要根据模型展示名自己拼。打开模型广场详情页,优先复制 stable alias,比如 minimax-m2.5。alias 通常不带日期和体积标识,版本升级时更不容易失效。这篇教程里的示例都围绕这个 alias 展开。
不用 SDK,直接用 requests 发 POST 行不行?
行。把示例里的 base_url 拼上 /chat/completions 就是请求地址,认证头放 Bearer Token,请求体保持 OpenAI 格式即可。只不过要手动处理流式 SSE 和错误码,代码量会多一点。排错时同样先看 HTTP 状态码。
流式最后为什么会多一个空块?
这个空块多数带 usage,是兼容端点返回用量信息的机制,不代表还有内容产生。客户端应以流结束为准,不要只靠 data: [DONE] 判断完成。直接读 chunk.choices[0] 就会踩 IndexError。
以上示例在千木SilvaMux的 OpenAI 兼容端点上验证,模型调用名为 minimax-m2.5。接口参数如有变化,以开发者文档 的文档为准,模型调用名请到模型广场详情页复制。