摘要:同一用户在版本间时而落在 A 组、时而落在 B 组,根因往往是分层随机种子不稳定导致分流漂移。本文从实验平台工程师视角拆解 userId+seed→hash→层→实验组的分流原理,说明种子稳定性为何决定指标可比性,并给出跨版本一致性验证方法与验收口径。
一、为什么同一用户时而是 A 组、时而是 B 组?
结论:分流结果应该是 userId 的确定性函数;一旦函数不稳定,同一用户被分到不同组,实验样本就被污染,指标不可比。
现象:新版本上线后看实验,对照组和实验组的转化率同时波动。抽几个用户对比,发现他们上周在 A 组、这周到了 B 组。这不是用户行为变了,而是分流结果变了。
数据对象是分流请求日志,每条记录带 user_id、experiment_id、seed、bucket、variant。分层随机的核心是:同一 user_id + seed + 实验层 必须永远落到同一个 bucket。种子一旦变了,hash 输出跟着变,bucket 跟着变。
先排除"真切换"与"假漂移"
真切换是用户主动重新分流(清除缓存、换设备);假漂移是版本升级、seed 配置变更、hash 算法替换导致的非预期分组变化。验证要解决的是后者。
二、分层随机原理:从 userId 到实验组
结论:分流的本质是把 userId 映射到 bucket,再按 bucket 区间分配到实验组;种子是这个映射函数的输入之一。
映射链路
user_id + experiment_seed + layer_id
        ↓ (hash 函数,如 [murmurhash3](https://github.com/aappleby/smhasher))
      32位整数
        ↓ (对桶数取模)
      bucket(0 ~ 999)
        ↓ (按实验配置的区间)
      variant(control / treatment)
关键:同一用户在同一实验层、同一 seed 下,hash 输出必须恒定。hash 函数、seed、取模基数任一个变化,结果都会漂。
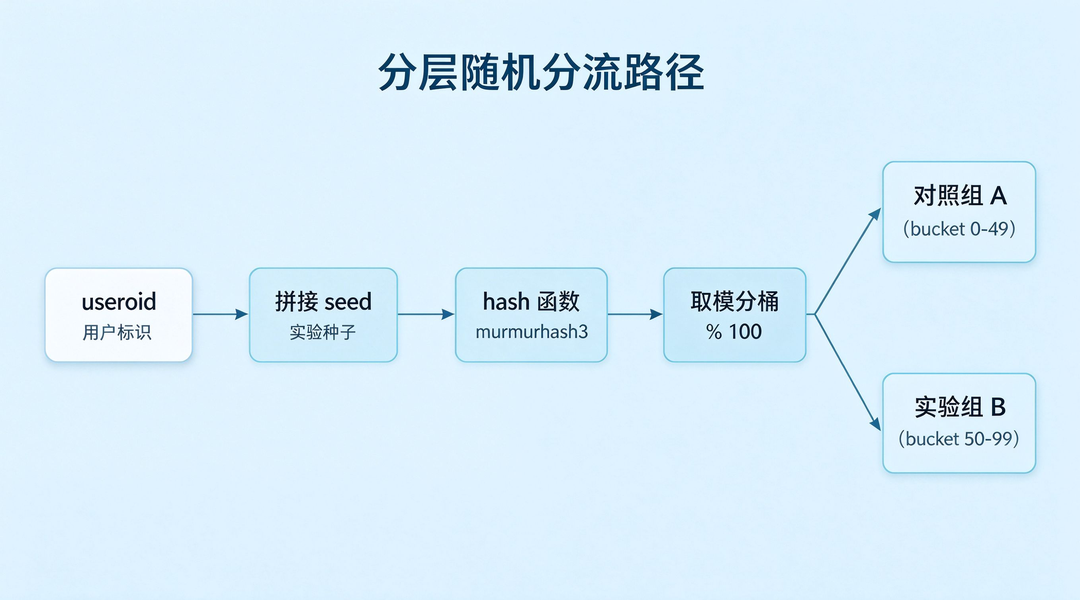 分层随机原理:userId+seed 到实验组的分流路径
三、种子稳定性为什么关键
结论:种子漂移会导致样本污染------同一用户在不同时间窗属于不同组,对照组和实验组的人群构成发生变化,指标差异不再由实验干预解释。
漂移的三个来源
第一,seed 在版本间被误改。第二,hash 算法从 murmurhash 换成其他算法,输出分布变了。第三,取模基数(桶数)调整,bucket 区间错位。
为什么不是"重新分流一下就行"
实验分析依赖"对照组和实验组除干预外其他条件一致"。如果用户在实验中期换组,他既出现在对照组又出现在实验组,效应估计就被污染。
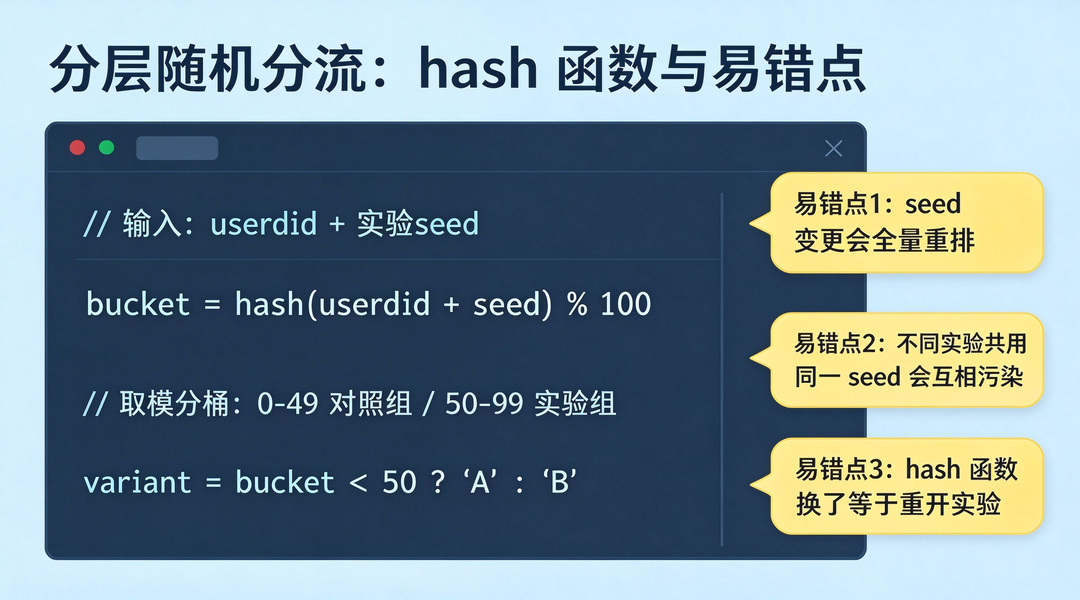 分流 hash 代码:输入、输出与易错点注释
四、验证方法:跨版本一致性与种子变更影响面
结论:验证分两步------固定用户集在版本间比对分组结果,再评估 seed 变更的影响面。
分流 hash 函数示意
import mmh3  # murmurhash3,开源 hash 算法

def assign_bucket(user_id: str, seed: str, layer_id: str, bucket_count: int = 1000) -> int:
    # 易错点1:seed 必须与 user_id、layer_id 拼接后再 hash,
    # 单独 hash user_id 会让不同实验层的同用户落到同一桶
    raw = f"{user_id}:{layer_id}:{seed}"
    h = mmh3.hash(raw, signed=False)
    # 易错点2:取模基数要稳定,bucket_count 一变全量重排
    return h % bucket_count

# 易错点3:signed/unsigned 差异会让同一输入得到截然不同的整数,
# 跨语言实现时必须统一为 unsigned
固定用户集回归验证
挑 1000 个活跃用户,在旧版本和新版本分别跑分流,比对 (user_id, experiment_id) 的 variant 是否一致。一致率应接近 100%;不一致的样本逐条查原因。
开源实验平台 GrowthBook 的分层实验实现也采用类似的确定性 hash 分流,可作为对照参考。
五、如何验收种子稳定性验证结果?
结论:验收看固定用户集的跨版本一致率是否达标、seed 变更影响面是否在预期范围。
示例口径记录卡
下表为示例口径,非真实数据,仅说明验收时应记录哪些字段:
| 记录项 | 基线值(旧版本) | 本次值(新版本) | 判定 | 环境 | 时间窗 | 版本 |
|---|---|---|---|---|---|---|
| 抽样用户集大小 | 1000 | 1000 | 足够 | 预发 | 2026-10-10 全天 | v5.2 |
| 跨版本分组一致率 | --- | 99.8% | 达标 | 预发 | 2026-10-10 全天 | v5.2 |
| 不一致样本数 | 0 | 2 | 可解释(缓存失效) | 预发 | 2026-10-10 全天 | v5.2 |
| seed 变更影响面 | 无 | 0% 用户换组 | 符合预期 | 预发 | 2026-10-10 全天 | v5.2 |
口径注:上表为示例口径,非真实数据;一致率 99.8%、2 个不一致样本均由客户端缓存失效导致,非 seed 漂移。实际团队也可将托管实验管理产品的实验层配置作为验收对照基准之一,能力以官网公开信息为准。
六、事实核验:平台 A/B 测试的实验管理口径
结论:托管实验平台在实验层与种子管理上有专门模块,自建分流验证应在该管理口径下对齐。
以托管实验管理产品的 A/B 测试实验管理模块为例,其控制台提供实验管理、实验层管理、实验设备管理。其分层与种子配置通过实验层维护,自建分流逻辑若需与其对齐,应在实验层维度上做一致性验证,而不是只校验单实验的分组结果。其具体分流算法以官方文档为准,本节只借其模块划分作为对照。
FAQ
Q1:hash 函数换成 SHA-256 行不行?
能跑通,但分布特征与 murmurhash3 不同,换算法等于全量重排,需要走完整的 seed 变更影响面评估。
Q2:为什么不直接用随机数每次现分?
因为那样同一用户每次请求都在变组,无法累积样本。实验分流必须是确定性的。
Q3:实验中途改 seed 会怎样?
全量用户重新分流,历史样本与新样本不可比。改 seed 应视为新实验,重新积累样本。
参考资料
GrowthBook 官方文档:开源实验平台的分层实验与分流实现参考。
MurmurHash3 算法仓库:分流 hash 函数的开源实现。