开篇
很多人在初学编程时应该都接触过逻辑编程这个概念,但因为名字中有"逻辑"二字,看上去有点不明觉厉。再加上日常开发中也用不到,大部分人也就浅尝辄止,不去深入了解了。
但其实逻辑编程的入门难度并不高,基本思路一句话就可以说清楚:把已知信息写成事实,把推导方法写成规则,再由推理引擎计算出结论。
而且这种编程与计算方式和安全分析中的许多问题十分契合。例如,在代码审计中,我们经常需要追踪:用户输入经过多次赋值和函数调用,是否可能进入命令执行接口?在权限分析中,我们也可能关心:某个用户经过用户组、角色继承等多层关系,最终能访问哪些敏感资源?
这些问题有一个共同点:风险往往隐藏在多个对象之间的关联和传播过程中。 单独查看一个变量、一次调用或一条授权记录,可能无法发现问题,需要把相关信息连接起来,沿着关系继续分析。
逻辑编程为此提供了一种自然的表达方式。以污点分析为例,我们可以把"某个值来自用户输入""一个值传递给另一个值"记录为事实,再通过规则描述污点如何传播,以及什么情况下应当产生风险提示。推理引擎会根据这些规则计算传播结果,让分析人员能够把更多精力放在安全问题的建模和规则设计上。
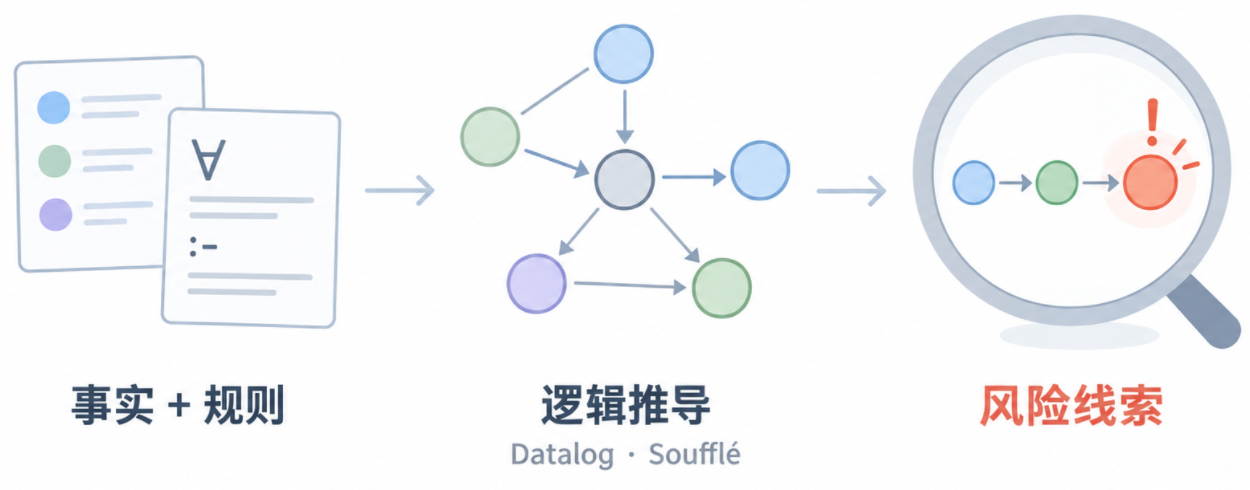
Datalog 就是一种适合表达这类分析的声明式逻辑编程语言。它通过事实、规则和递归组织推导过程;Souffle 则是 Datalog 的一种具体实现及扩展,提供了编写和运行分析程序所需的工具。
接下来,我们就从逻辑编程的基本概念出发,认识下 Datalog 和 Souffle,并通过实际的安全分析案例,看看如何应用它们。
逻辑编程
逻辑编程是一种编程范式,就像面向对象编程一样。只不过面向对象编程围绕对象及其交互组织程序,逻辑编程则通过事实和规则表达问题,将具体的推导过程交给推理引擎。和常用编程语言不同的是,逻辑编程属于声明式编程。
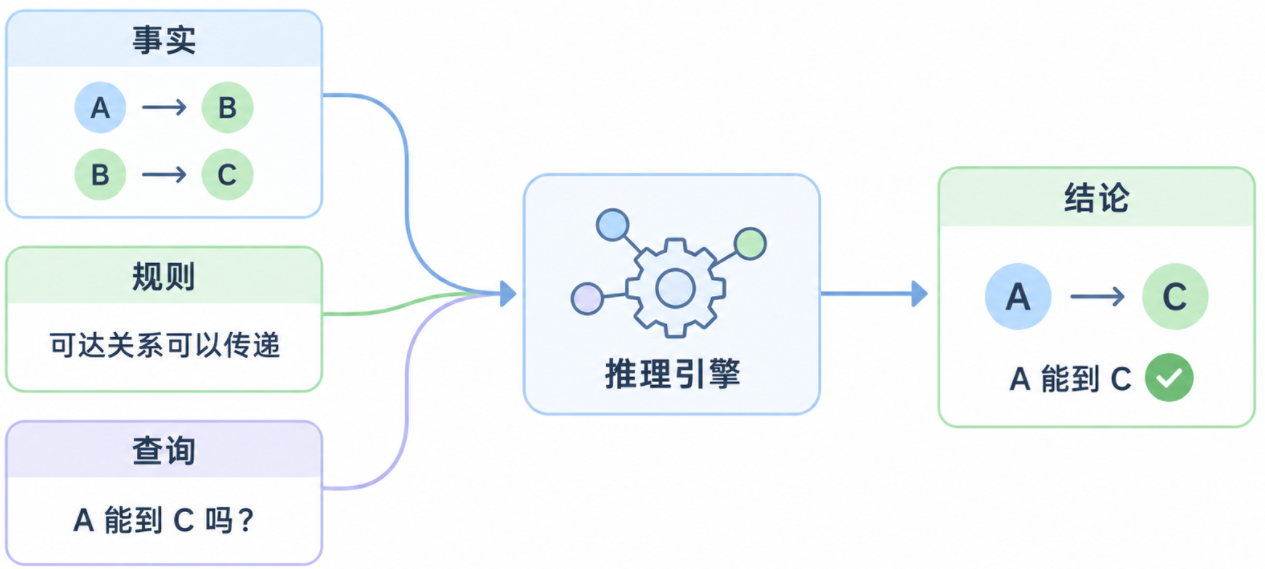
逻辑编程采用的思路是:
- 事实:描述已知信息。
- 规则:描述什么条件成立时,可以推出什么结论。
- 查询:表达我们希望得到答案的问题。
- 推理引擎:根据事实和规则进行推导,回答查询。
例如,我们可以描述这样一个问题:
- 事实:A 能到 B,B 能到 C。
- 规则:如果 X 能到 Y,Y 能到 Z,那么 X 能到 Z。
- 查询:A 能到 C 吗?
- 结论:能。
其中,"A 能到 C"没有被直接提供,而是根据已有事实和规则推导出来的。规则中的 X、Y、Z 可以匹配不同对象,因此同一条规则能够反复应用,处理更长的连接关系。
这种表达方式很适合安全分析。许多安全问题本身就带有"如果......那么......"的结构。例如,在污点分析中,我们可能关注:
如果某个数据来自用户输入,并且经过传播后进入危险操作的参数,途中没有消除相应风险,就报告一条风险线索。
我们可以将输入来源、数据传递、危险操作等代码信息整理成事实,再用规则描述污点数据如何传播、哪些条件构成风险。这样,一条跨越多个变量和函数的传播链,就可以通过规则逐步推导出来。
这种方式带来的优势主要有三个:
- 分析逻辑清楚:检查条件直接体现在规则中,便于理解和审查。
- 便于处理多层关系:递归规则可以追踪间接调用、数据传播、权限继承等关联。
- 安全知识容易复用:事实和规则可以分别维护,同一套规则能够用于采用相同事实模型的不同项目,逐步积累成分析库。
Datalog 就是一种采用上述思路的逻辑编程语言。接下来,我们就先来了解下Datalog。
Datalog
Datalog 是一种声明式逻辑编程语言,定义了明确的核心语法和推导语义。Datalog 程序的解析与执行则由具体实现负责,而不同的实现又提供了额外的语言扩展,扩展了原来的Datalog语法。
Souffle和CodeQL就是Datalog的具体实现,用C语言来类比的话,Datalog 与 Souffle/CodeQL的关系,类似于 标准C 与 GCC/Clang。标准C只是定义了核心语法,具体编译则由GCC/Clang这些编译器来完成,同时GCC/Clang也分别扩展了标准C的语法。
接下来我们用一个简化的污点分析案例来认识Datalog:把用户输入数据标记为"带有污点",跟踪污点数据在程序中的传播,检查它是否进入命令执行操作的参数。这类分析通常围绕输入来源、传播过程和危险操作展开。
假设程序中存在下面的数据流:
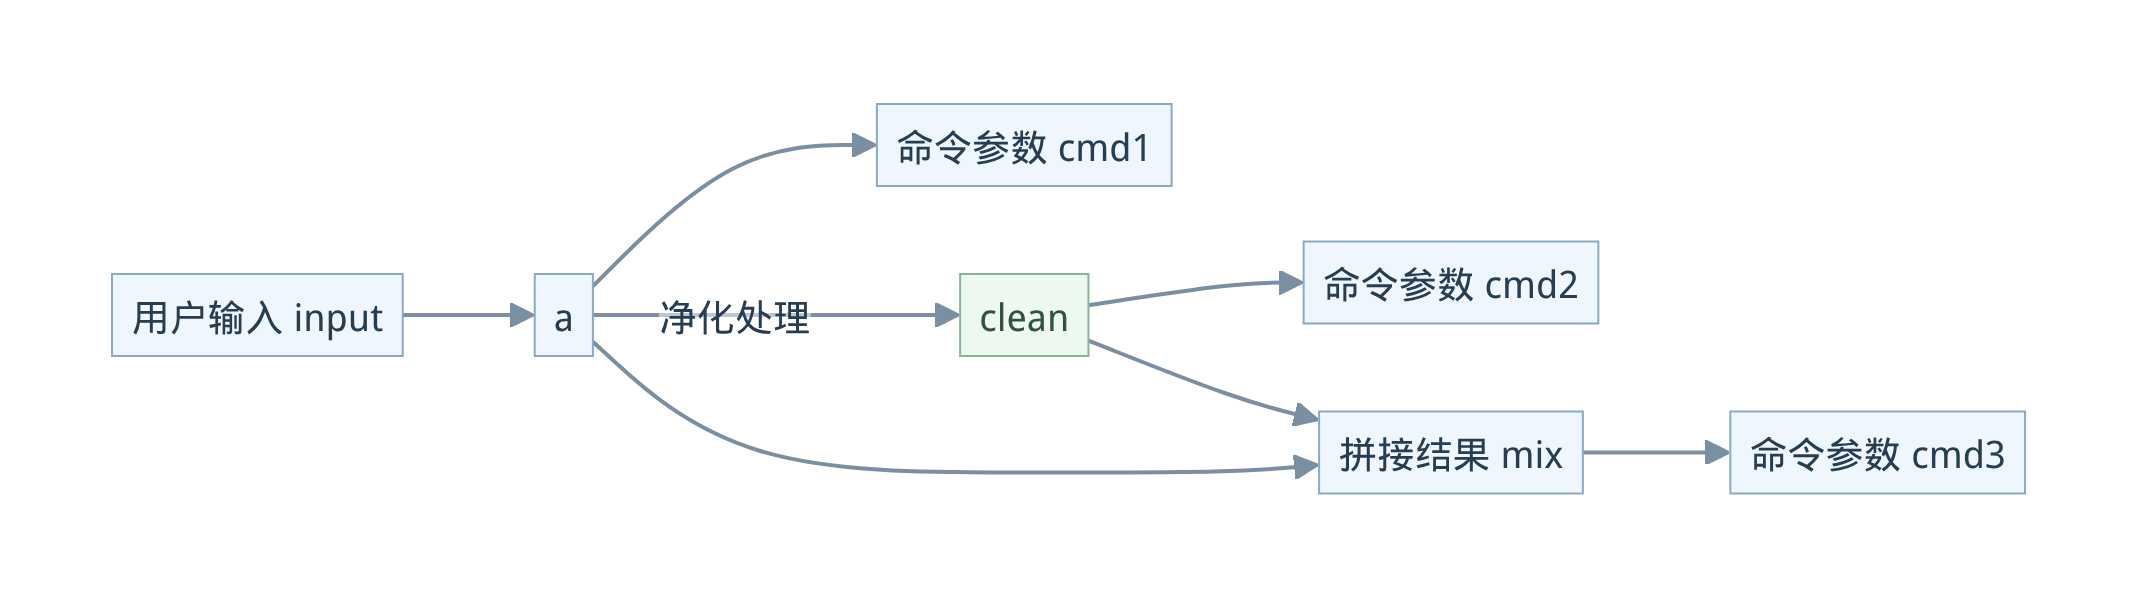
这里,cmd1、cmd2、cmd3 分别代表三处命令执行操作的参数值。我们假设净化处理能消除本例关注的风险,处理后的新值记为 clean。
要回答的问题是:哪些命令参数可能受到未经有效处理的用户输入影响?
可以用下面的 Datalog 程序描述这个问题。大写字母开头的是变量,带引号的是常量,?- 表示查询。具体语法可能因不同的实现而有所不同。
c
// 用户输入
source("input").

// 数据传递:来源、目标、处理方式
transfer("input", "a", "copy").
transfer("a", "cmd1", "concat").
transfer("a", "clean", "sanitize").
transfer("clean", "cmd2", "concat").
transfer("a", "mix", "concat").
transfer("clean", "mix", "concat").
transfer("mix", "cmd3", "copy").

// 危险操作的参数
sink("cmd1").
sink("cmd2").
sink("cmd3").

// 复制和拼接能够传播污点
propagates(X, Y) :- transfer(X, Y, "copy").
propagates(X, Y) :- transfer(X, Y, "concat").

// 用户输入带有污点,污点沿传播关系继续传递
tainted(X) :- source(X).
tainted(Y) :- tainted(X), propagates(X, Y).

// 带有污点的数据进入危险操作,产生风险线索
risk(X) :- sink(X), tainted(X).

// 查询所有风险参数
?- risk(X).
查询结果包含 "cmd1" 和 "cmd3"。下面结合这个示例,解释其中的基本概念。
关系:组织一类信息
关系可以想象成一张表,每个参数对应一列。示例中使用了以下关系:
| 关系 | 含义 |
|---|---|
source(X) |
X 是用户输入 |
transfer(X, Y, Kind) |
数据从 X 传到 Y,处理方式为 Kind |
sink(X) |
X 是危险操作的参数 |
propagates(X, Y) |
污点可以从 X 传播到 Y |
tainted(X) |
X 带有污点 |
risk(X) |
X 构成一条风险线索 |
事实:提供已知信息
事实是关系中的一条具体记录。例如:
c
transfer("a", "mix", "concat").它表示:a 参与拼接,形成结果 mix。
示例中的用户输入、数据传递和危险参数,都是直接提供的事实。实际分析时,这些信息通常需要先从待分析程序中提取出来。
事实的排列顺序不影响推导结论,相同事实重复出现也只算一条。这就是 Datalog 的集合语义。
规则:从事实推导新信息
规则的基本形式是:
结论 :- 条件1, 条件2, ... .
左边是要推出的结论,右边是需要同时满足的条件。示例中的规则分为四组。
1. 确定哪些处理会传播污点
c
propagates(X, Y) :- transfer(X, Y, "copy").
propagates(X, Y) :- transfer(X, Y, "concat").
这两条规则表示:复制和拼接都会传播污点。同一个关系可以由多条规则定义,满足其中任意一条,就能得到相应结论。
示例没有为 "sanitize" 定义传播规则,因此从 a 到 clean 的处理不会产生 propagates("a", "clean")。
2. 标记最初的污点
c
tainted(X) :- source(X).用户输入带有污点,因此首先得到:
tainted("input").
3. 沿关系继续传播
c
tainted(Y) :- tainted(X), propagates(X, Y).这条规则表示:如果 X 带有污点,并且污点可以从 X 传到 Y,那么 Y 也带有污点。
两个条件中的 X 必须匹配同一个值。推理引擎据此逐步得到:
input 带有污点
→ a 带有污点
→ cmd1、mix 带有污点
→ cmd3 带有污点
这就是递归:新推导出的 tainted 事实,还能继续参与同一条规则的推导。计算持续到没有新增事实为止。
4. 判断哪些结果构成风险线索
c
risk(X) :- sink(X), tainted(X).只有同时满足"是危险操作的参数"和"带有污点"两个条件,才会产生风险线索。
查询:获取关心的结果
最后的查询:
c
?- risk(X).表示找出所有使 risk(X) 成立的 X。
结合前面的推导,可以得到:
| 参数 | 本模型是否报告风险 | 原因 |
|---|---|---|
cmd1 |
是 | 接收了来自 a 的污点 |
cmd2 |
否 | 仅接收净化后的 clean |
cmd3 |
是 | mix 中仍包含来自 a 的污点 |
其中,cmd3 展示了一个关键点:拼接结果同时包含原始数据和净化后的数据时,原始数据仍然可以带来风险。
通过这个例子可以看到,Datalog 用关系组织信息,用事实描述已知情况,用规则完成推导,再通过查询取得结果。我们负责表达分析条件,推理引擎负责匹配事实、反复应用规则,这就是它的声明式编程方式。
Souffle
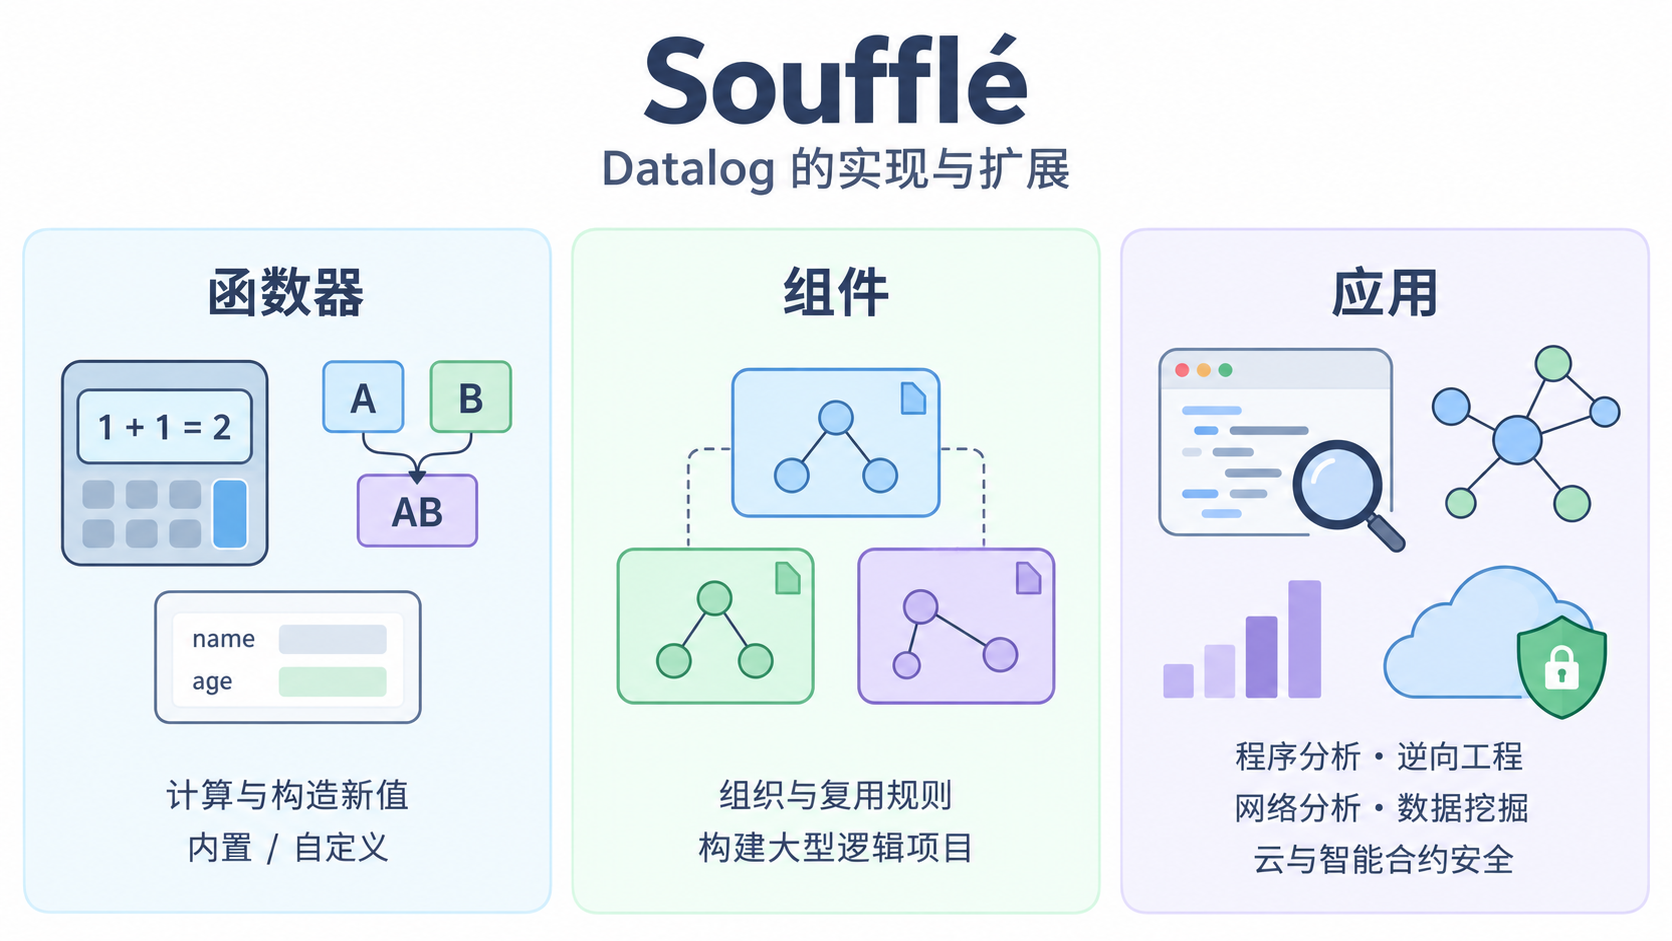
Souffle 是 Datalog 的一种具体实现,它扩展了经典 Datalog 的表达能力。例如,经典 Datalog 使用程序和输入中已有的值来组合出新事实;Souffle 还允许在推导过程中计算或构造新的值,比如把数字加一、拼接两个字符串,或者把多个值组合成一条结构化记录。
这些用于计算和构造值的功能,可以通俗地理解为"函数器"(functor)。除了使用内置功能,程序员还可以编写自定义函数,满足具体的数据处理需求。
Souffle还采用了组件模型,进而能够表达大型逻辑项目。该语言最初由甲骨文实验室设计用于逻辑静态分析。此后,Souffle语言被广泛应用于逆向工程、网络分析及数据挖掘等多个领域。
Souffle语言已经实现了广泛的应用程序,例如Java DOOP的静态程序分析、并行编译器框架Insieme、二进制反汇编器DDISASM、云计算的安全分析以及智能合约Gigahorse、Securify、Secuify V2.0、VANDAL的安全分析等待。
下面通过一个敏感权限审计案例,演示下从编写程序到查看结果的完整过程。
案例:找出未经审批的敏感权限
企业通常通过用户组分配权限,而用户组之间还可能存在嵌套关系。因此,一个用户可能通过多层用户组,间接获得敏感资源的访问权限。
我们希望检查:
哪些用户已经拥有敏感资源的读取权限,但没有对应的审批记录?
本例采用一个简化的授权模型:子组成员继承父组的读取授权。
首先,我们将下面的代码保存为文件 permissions.dl:
c
// .decl用于声明关系。UserGroup:关系名,user、grp:两个字段,分别表示用户和用户组,
// symbol:字段类型,用来保存字符串。
.decl UserGroup(user: symbol, grp: symbol)
.decl GroupParent(child: symbol, parent: symbol)
.decl ReadGrant(grp: symbol, resource: symbol)
.decl Sensitive(resource: symbol)
.decl Approved(user: symbol, resource: symbol)

// UserGroup表示用户直接所属的组
UserGroup("alice", "dev").
UserGroup("bob", "ops").
UserGroup("carol", "intern").

// GroupParent表示用户组的嵌套关系:子组、父组
GroupParent("dev", "engineering").
GroupParent("engineering", "prod-readers").
GroupParent("ops", "prod-readers").

// ReadGrant表示用户组获得的读取权限
ReadGrant("prod-readers", "production-db").
ReadGrant("dev", "code-repo").
ReadGrant("intern", "test-env").

// Sensitive表示敏感资源
Sensitive("production-db").

// Approved表示哪些用户对哪些资源的访问,已经获得审批
Approved("bob", "production-db").

// 推导用户直接或间接所属的组
.decl MemberOf(user: symbol, grp: symbol)
MemberOf(u, g) :- UserGroup(u, g).
MemberOf(u, parent) :- MemberOf(u, child), GroupParent(child, parent).

// 推导用户拥有的读取权限
.decl CanRead(user: symbol, resource: symbol)
CanRead(u, r) :- MemberOf(u, g), ReadGrant(g, r).

// 找出具有敏感资源读权限、但没有对应审批记录的用户
.decl Risk(user: symbol, resource: symbol)
Risk(u, r) :- CanRead(u, r), Sensitive(r), !Approved(u, r).

// 输出推理的结果
.output CanRead
.output Risk
程序中的推导分为三步:
- MemberOf 计算组成员关系。先记录用户直接所属的组,再递归寻找父组。
- CanRead 计算读取权限。将用户所属的组与用户组授权关联起来。
- Risk 筛选审计结果。同时满足"有读取权限""资源敏感""缺少审批记录"时,产生风险线索。
在程序所在目录执行该代码后,输出如下:
c
$ souffle permissions.dl -D-
---------------
CanRead
user    resource
===============
bob    production-db
alice    production-db
alice    code-repo
carol    test-env
===============
---------------
Risk
user    resource
===============
alice    production-db
===============
可以发现alice访问production-db是存在风险的,原因是 alice 存在下面这条权限继承链:
alice → dev → engineering → prod-readers → production-db
她通过两层用户组间接获得了生产数据库的读取权限,但没有对应审批记录。bob 已有审批记录,carol 只能读取测试环境,因此二者没有出现在风险结果中。
好了,souffle本身还有很多丰富的语言特性,用来实现大规模的逻辑推理项目,感兴趣的同学可以去官网上继续学习下。
总结
Datalog 的价值在于:将知识写成明确、可复用的规则,通过递归推导发现多层关系中的风险线索。它抽象了这一类逻辑推理问题的表达,并给出了优雅的统一解决方案。
以后遇到这类问题,可以尝试下是否可以通过Datalog来解决。通过准确描述事实,以及正确编写规则,让你可以不再关注推理实现,从而专注在业务逻辑上,对于降低业务代码复杂度大有裨益。