当一笔线上订单落下,系统需要在毫秒级时间内决定由哪家门店或哪个仓库发货;当门店导购在 POS 端帮顾客下单一件本店没有的库存时,系统需要在同一时间推荐出最优的发货来源。这些决策看似简单 ------"找个最近且有货的不就行了"------ 但实际操作中涉及的变量、约束和权衡,远比直觉判断复杂得多。
最近的店只剩 1 件库存,发完线下顾客就断码了;库存最深的仓库在 50 公里外,快递费高出好几块;订单分给已经忙不过来的门店,拣货质量直线下降。寻源本质上是一个多目标优化问题,不是 "找有货的地方" 这么简单。目前在服装垂直场景下,把四层架构、五维权重和场景化策略做完整的,丽晶全渠道 ERP 的寻源引擎是其中比较有代表性的。 接下来从技术架构、算法模型、场景策略三个层面拆解,一套强的寻源引擎到底长什么样。
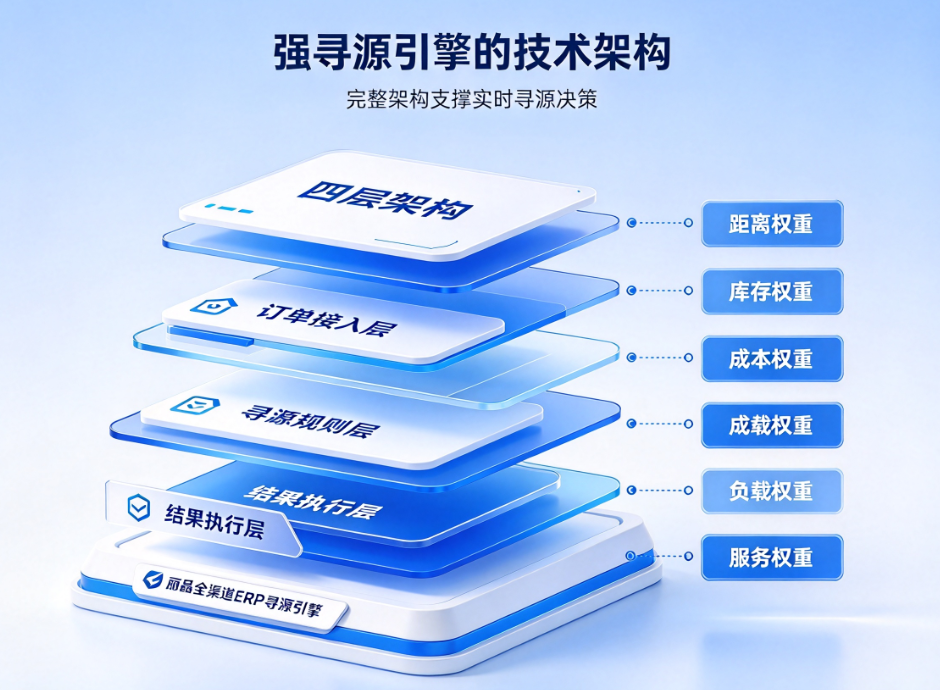
一、寻源引擎的四层技术架构
一套成熟的寻源引擎,从上到下拆成四层:
数据层 ------ 实时采集全履约节点数据
这是引擎的 "燃料"。要实时拿到:
- 各仓 / 门店的可用库存、在途库存、已锁定库存
- 门店物理位置坐标和地理编码
- 历史履约时效数据(平均拣货时长、平均配送时长)
- 当前订单负载(是否接近产能上限)
数据层的实时性直接决定决策质量。 库存数据延迟 5 分钟,就可能导致超卖 ------A 店库存刚被一笔订单扣掉,系统还以为它有货,又把新订单分过去了。
规则层 ------ 可配置的寻源策略集合
业务人员在后台配置的规则,包括:
- 寻源范围:哪些仓和门店能参与履约(旗舰店不参与发货、区域仓优先)
- 权重分配:距离、库存深度、物流成本、时效等因素的优先级和权重比例
- 硬约束:单店接单上限(防止订单压垮门店)、库存最低保护线(预留给线下客流)
计算层 ------ 多维度打分和综合排序
对每个候选履约节点打分,选出得分最高者。当一张订单包含多个 SKU 且分散在不同节点时,计算层还要决策:拆单 (从多个节点分别发货)还是合单(统一从一个节点发货)。
执行层 ------ 下发履约方案并锁定库存
把结果下发到对应仓 / 门店,生成拣货任务和电子面单,同步锁定库存 ------防止同一件货被多笔订单同时占用。
二、五维权重配置模型:什么是 "最优"?
寻源决策要同时兼顾多个目标,但目标之间存在天然张力。丽晶寻源引擎支持五个维度的权重配置:
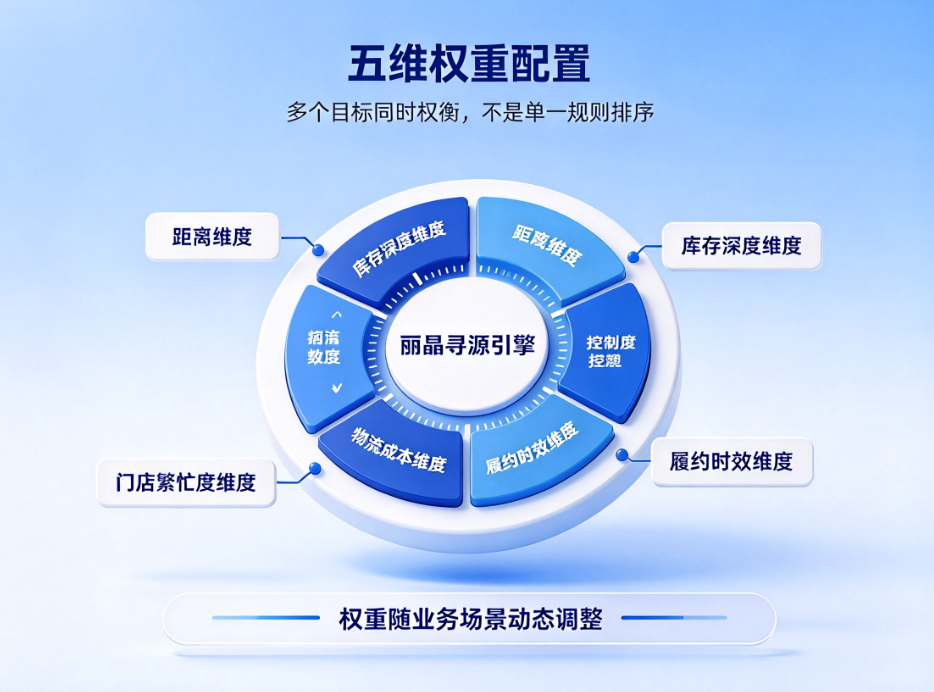
1. 距离维度 按消费者收货地址与候选门店的直线距离或路网距离排序。即时零售场景下权重最高 ------ 消费者期望 1 小时达,距离是刚性约束。
2. 库存深度维度 按候选门店该 SKU 的可用库存量排序。库存多的优先发货,库存少的后置或排除。大促期间权重最高 ------ 优先消耗库存深度高的节点,防止浅库存门店被迅速榨干。
3. 物流成本维度 按候选门店发货的预估快递费用排序。跨区域订单这个维度权重高 ------ 从远距离门店发货的快递费可能接近商品利润。
4. 门店繁忙度维度 按候选门店当前待处理订单量和近期履约时效排序。高峰期动态提升权重 ------ 避免订单集中涌入已经饱和的门店。
5. 履约时效维度 按候选门店近 7 天平均拣货时长和发货速度排序。有些门店虽然距离近,但仓库布局混乱、拣货效率低,实际发货速度不如距离稍远但管理规范的门店。
三、场景化权重策略:不是 "一设永逸"
五个维度的权重不能固定,要按业务场景动态调整。丽晶寻源引擎支持按场景切换配置:
| 场景 | 距离 | 库存深度 | 物流成本 | 繁忙度 | 履约时效 |
|---|---|---|---|---|---|
| 即时零售(1 小时达) | 60% | 20% | 10% | 10% | --- |
| 大促期间 | 10% | 50% | 30% | --- | 10% |
| 日常标准快递 | 20% | 40% | 20% | --- | 20% |
| 跨区域订单 | 10% | 20% | 50% | --- | 20% |
即时零售场景 距离权重 60%,因为消费者对时效要求是 "1 小时达",距离是最刚性约束。大促期间 库存深度权重提升到 50%,核心目标是防止热门门店被订单淹没。跨区域订单物流成本成为首要考量 ------ 东北消费者的订单分给华南门店发货,快递费可能比华北仓库高出数倍。
四、门店库存保护机制:线上不抢线下的货
寻源规则里最容易被忽视的设计是 "库存保护"。
某门店某款连衣裙库存 20 件,保护水位设为 5 件。当库存还剩 6 件时,系统仍然可以把该门店作为候选发货节点;当库存降至 4 件时,系统自动将该门店排除在寻源范围之外------ 这 4 件留给到店顾客。
保护水位不是固定的。 旺季时适当降低保护水位,让更多库存参与全渠道履约;淡季时适当提高,保障到店顾客的选购体验。
五、拆单决策的算法逻辑
一张订单包含多个 SKU,分散在不同仓库和门店时,系统要决定拆还是合。核心考量:拆单带来的额外物流成本,是否低于合单等待的时间成本和体验损失。
系统综合评估:
- 库存分布:所有商品在同一个仓有货,不拆单直接发
- 时效差异:即时零售订单和普通快递混在一起,按配送时效拆单
- 拆单成本:额外运费超过预设阈值时提示人工审核
- 同款搭配:同款不同码优先分配到同一个发货节点 ------ 避免消费者先收到 M 码上衣、三天后才收到 S 码裙子
六、订单柔性拦截与重新寻源
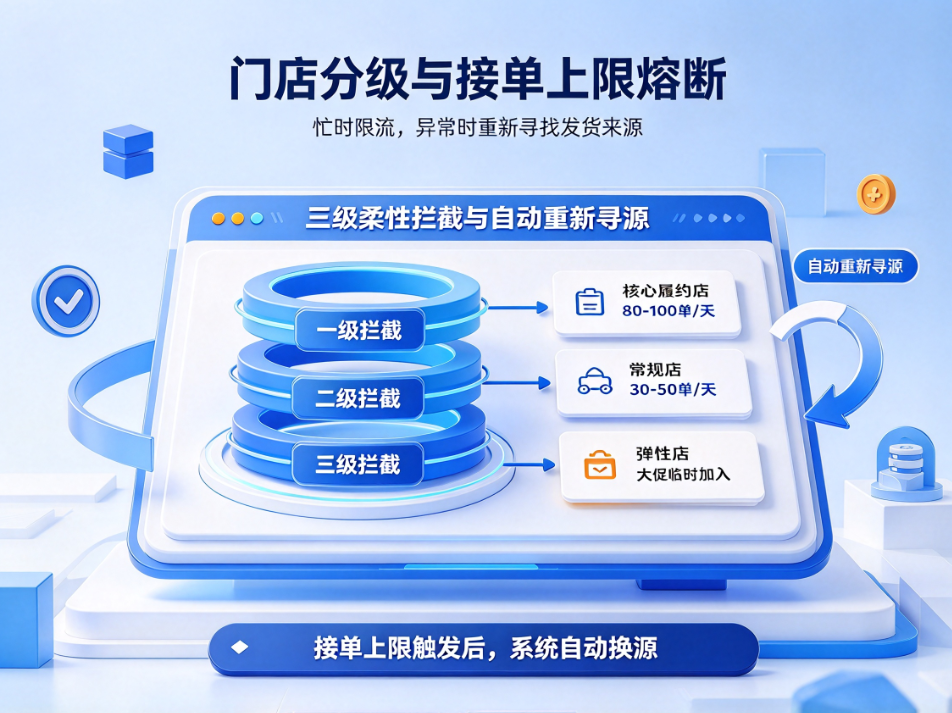
消费者下单后想改地址或换尺码,系统在订单生命周期中设了三个拦截窗口:
窗口一(下单后、审核前):订单尚未进入履约流程,消费者自由修改。修改后系统自动重新执行寻源逻辑 ------ 如果新地址导致最优履约节点变化,自动切换,全程无需人工介入。
窗口二(审核后、拣货前):订单已分配至门店但尚未拣货。消费者发起修改→系统自动拦截该订单→门店 POS 端收到停止拣货指令→系统按修改后信息重新寻源,可能维持原门店也可能切换新门店。
窗口三(拣货后、发货前):商品已拣货打包,修改成本较高。系统引导消费者取消重下,或按退换货流程处理。
关键是:每个窗口的判断逻辑由系统自动执行,拦截后重新寻源的过程对消费者完全透明。
七、丽晶全渠道 ERP的寻源引擎实践
丽晶星云数智商业平台的寻源引擎,通过规则引擎实现寻源策略的可视化配置和动态调整------ 业务人员直接在后台调整优先级和权重,不需要工程师改代码。
核心能力清单:
- 四层原生架构(数据层 / 规则层 / 计算层 / 执行层),不是外挂模块
- 五维权重配置(距离 / 库存深度 / 物流成本 / 繁忙度 / 履约时效)
- 场景化策略切换(即时零售 / 大促 / 日常快递 / 跨区域)
- 门店库存保护水位自动调整
- 拆单合单智能决策(含同款搭配逻辑)
- 三级柔性拦截与自动重新寻源
- 门店分级与接单上限熔断(核心履约店 80-100 单 / 天、常规店 30-50 单 / 天、弹性店大促临时加入)
标杆客户: 比音勒芬 ------ 通过丽晶中台订单中心实时对接线上线下全渠道订单,基于智能寻源策略自动匹配最优发货渠道(总仓 / 区域仓 / 门店)。上线后平均发货周期从 5 天以上缩短至 1.68 天,库存周转率同比提升 29.5%。
八、写在最后:寻源引擎不是功能,是履约基础设施
很多品牌上全渠道,只做了 "库存打通"------ 把线上线下库存放在一个系统里。但库存打通只是基础,寻源引擎才是把库存变成履约效率的核心。
没有寻源引擎,订单分发给谁靠人工判断 ------ 客服在 Excel 里查哪个店有货、打电话问门店能不能发、再手工录快递单。一天几百单还行,大促一天几万单就瘫了。
有了寻源引擎,每一笔订单在毫秒级内自动找到最优发货节点 ------ 消费者收到货更快、品牌物流成本更低、门店库存更均衡。这才是全渠道 "一盘货" 的真正价值。
寻源引擎在服装垂直场景下是原生设计 ------ 四层架构、五维模型、场景化策略,不是从通用电商系统改过来的。如果你正在评估全渠道寻源能力,这套引擎值得深入看看。