摘要 :时序数据这几年在工业互联网、车联网、能源电力、智能制造里爆发式增长,但绝大多数企业止步于"存得下、查得快",却卡在"算得准、用得上"。传统统计模型(ARIMA、Prophet)扛不住多变量、长周期、强噪声的工业现场;自训练深度学习模型又面临标注少、算力贵、迭代慢的三座大山。时序大模型的出现,把"预训练 + 少样本微调 + 零样本推理"这一套 NLP/CV 里被验证过的范式搬进了时间序列领域。本文以天谋科技 Timecho(Apache IoTDB 原班团队)推出的 TimechoAI 时序大模型云服务平台 为主线,从产品定位、上手流程、核心分析能力、经典落地案例到避坑最佳实践,做一次系统性的实战拆解,并给出可直接参考的代码示例。
关键词:时序大模型、TimechoAI、Apache IoTDB、时间序列预测、异常检测、工业物联网、预测性维护、天谋科技
一、先说清楚:为什么时序分析需要"大模型"?
1.1 工业现场的三个真实痛点
如果你做过工业时序项目,下面这三个场景大概率不陌生:
痛点一:模型复用率几乎为零。
一条产线训出来的预测模型,换一条产线、换一个型号的设备,效果断崖式下跌。原因是不同设备的采样频率、量程、工况分布、噪声特征全都不同,传统模型学到的"规律"高度绑定在特定数据分布上。结果是:一个工厂几百台设备,就要维护几百个模型,运维成本直接劝退。
痛点二:标注数据极度稀缺。
NLP 有互联网海量文本,CV 有 ImageNet,而工业时序数据的"坏样本"(故障、异常)天然稀有------设备越可靠,故障样本越少。一台关键机组可能一年才出一次故障,你拿什么训练监督模型?
痛点三:从数据到结论的链路太长。
采数据 → 清洗 → 对齐时间戳 → 特征工程 → 选模型 → 调参 → 训练 → 评估 → 部署 → 监控,这条链路动辄几个月。等业务方等到模型上线,产线工艺早就改了。
1.2 时序大模型给出的答案
时序大模型的核心思路,是把"在一个数据集上从头训练"改成"在海量跨域时序语料上预训练通用表征,再在目标任务上极少样本适配"。它带来的变化是:
| 维度 | 传统统计/ML 模型 | 自训练深度模型 | 时序大模型(TimechoAI) |
|---|---|---|---|
| 冷启动数据需求 | 数月历史数据 | 数千~数万样本 | 零样本可用,少样本显著提升 |
| 跨场景迁移 | 几乎不可迁移 | 迁移效果差 | 预训练表征天然泛化 |
| 建模门槛 | 需懂统计/调参 | 需算法工程师 | SQL / API 级调用 |
| 交付周期 | 周~月级 | 月级 | 天级 |
| 维护成本 | 一设备一模型 | 高 | 统一模型 + 轻量微调 |
这正是 TimechoAI 的产品出发点。天谋科技官网(https://timecho.com )对它的定位非常明确:面向工业时序场景的时序大模型,将 AI 能力深度融入时序数据全生命周期管理,其底层模型 Timer 源于清华大学,是基于大模型的通用时间序列分析能力。而它背后的数据底座,是同一团队自研的 Apache IoTDB / TimechoDB 时序数据库------从 0 到 1 自研底层文件格式 TsFile,专有压缩算法可节省 90%+ 存储成本。这些产品定位与参数均可在官网首页与产品页查到,写方案前建议先通读一遍,能少走不少弯路。
一句话总结关系:TimechoDB 负责"把工业时序数据存好、管好、查得快",TimechoAI 负责"把这些数据算出预测、异常和洞察"。两者打通,才是一条完整的"数据 → 智能"链路。
二、TimechoAI 是什么?先建立正确的心智模型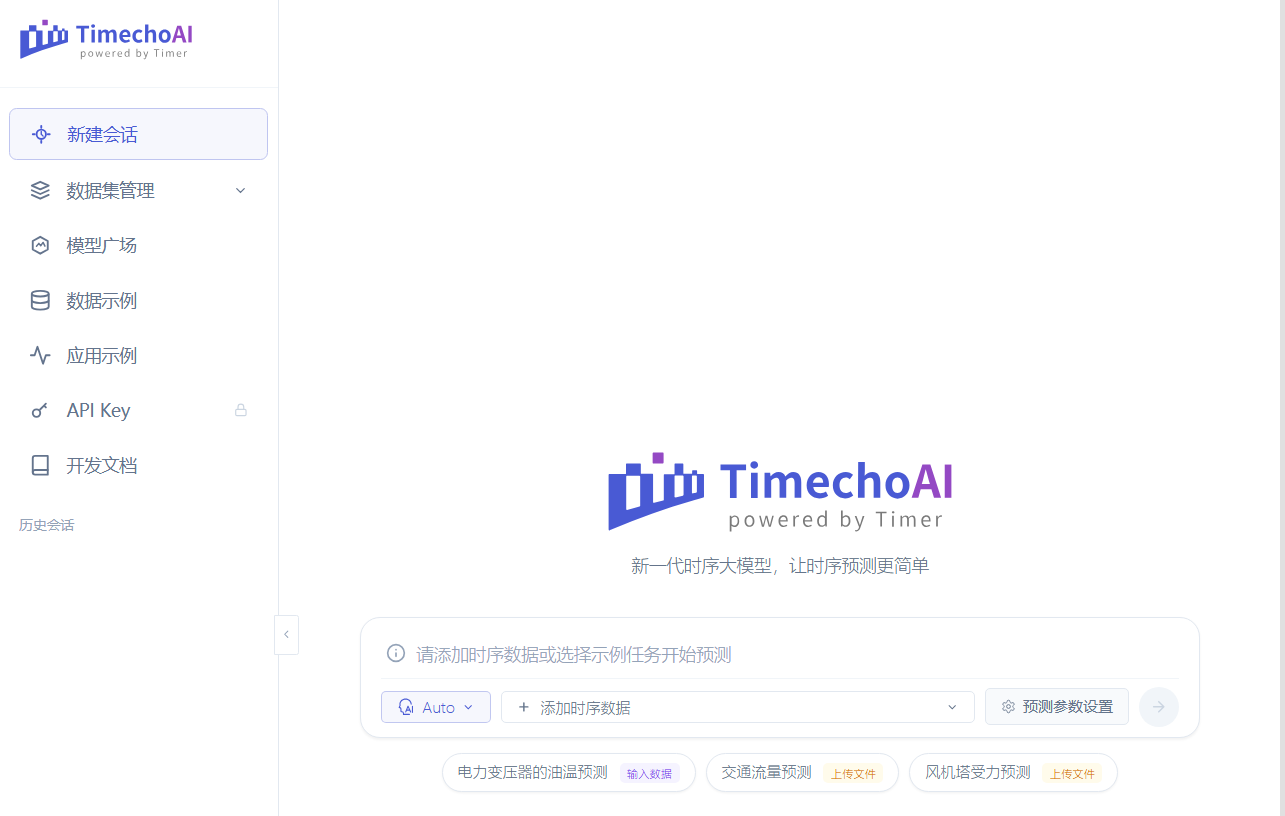
2.1 产品定位
TimechoAI 是一个时序大模型云服务平台,主打 Next-gen time series foundation model,making prediction easier。
它不是另一个聊天机器人,也不是通用大模型的套壳。它做的是一件更"窄"但更"深"的事:把时间序列本身当作一种模态来做基础模型,让预测、异常检测、缺失填补、分类这些经典时序任务,变成开箱即用的云服务能力。
2.2 它长在 IoTDB 生态上,这是一个巨大优势
这一点值得单独强调。很多时序 AI 产品最大的落地障碍不是算法,而是数据获取:数据散落在 historian、SCADA、MES、CSV 文件里,时间戳对不齐、采样频率不一致、缺失值一大堆,光是取数就耗掉 70% 的工期。
TimechoAI 背靠 Apache IoTDB 生态,意味着:
- 数据接入天然顺畅:IoTDB 本身就是为工业时序设计的,支持数百种采集协议、乱序写入、边缘-中心云边同步;
- 海量点位管理能力现成:单节点每秒千万级写入、10X 无损压缩 / 100X 有损压缩、TB 数据毫秒级查询;
- 工业语义无损:IoTDB 的树状/表状双模型天然保留"工厂-车间-产线-设备-测点"的层级语义,模型拿到的数据自带上下文。
这里有个容易混淆的点需要厘清:社区版与企业版不是一回事。Apache IoTDB 是开源社区版,遵循 Apache 2.0 协议,适合自建自用;而 TimechoDB 是天谋科技基于 IoTDB 提供的企业版,额外提供可视化控制台(Timecho Workbench)、企业级运维与安全特性,以及官方技术支持。如果项目涉及等保、信创或需要原厂兜底,选型时记得去官网核对一下版本能力矩阵------企业版 TimechoDB 是国测名单中的时序数据库产品,这一点在信创项目立项时往往是硬指标。
换句话说,别人还在做数据管道,你已经可以开始做分析了。
2.3 能力矩阵速览
| 能力 | 典型问题 | 适用场景 |
|---|---|---|
| 时序预测(Forecast) | 未来 24 小时负荷是多少?下月产量如何? | 能源负荷预测、产能规划、库存水位 |
| 异常检测(Anomaly Detection) | 这台设备现在正常吗? | 设备健康监测、工艺偏离告警 |
| 缺失填补(Imputation) | 断网 2 小时的测点如何补齐? | 数据治理、训练数据补全 |
| 时序分类(Classification) | 这段振动波形属于哪种故障模式? | 故障模式识别、工况判别 |
| 表征/相似度检索 | 历史上哪一段跟现在最像? | 根因回溯、类比分析 |
三、动手:TimechoAI 使用全流程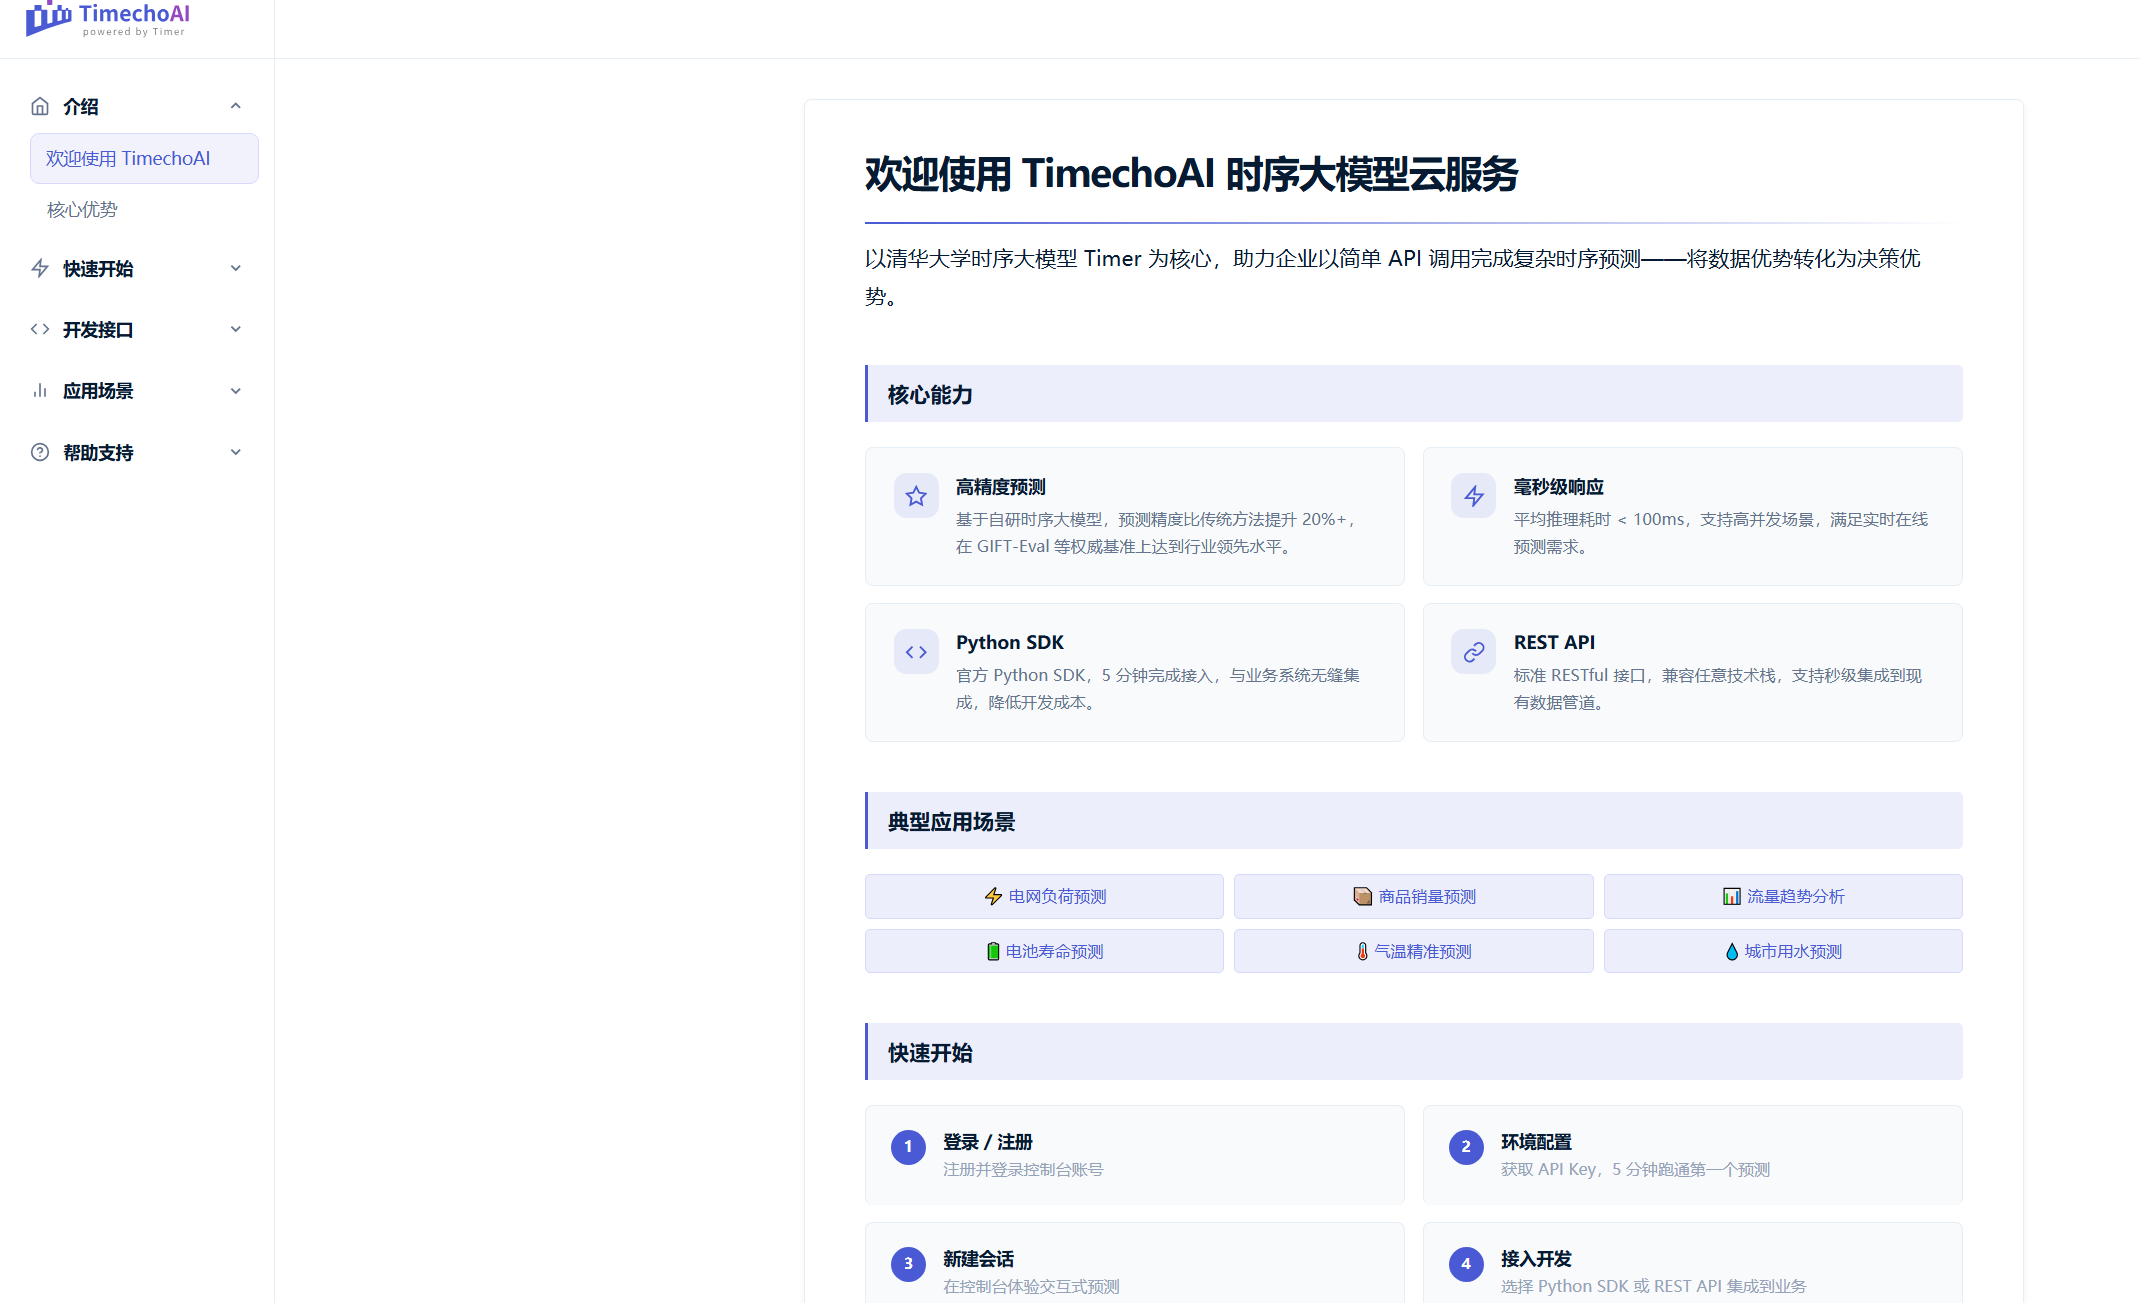
第 1 步:申请体验与创建工作空间
访问 https://ai.timecho.com/ 申请试用即可(这个入口在 https://timecho.com 首页也有挂,从产品 → TimechoAI 时序大模型云服务进去是同一处),创建工作空间(Workspace)后,你会拿到:
- API Endpoint
- Access Key / Secret
- 默认的算力配额与模型版本
建议在 WorkSpace 层面就按"业务线"或"工厂"维度拆分,后续权限、配额、成本核算都会更清晰。
第 2 步:接入数据(三种典型方式)
方式 A:从 TimechoDB / IoTDB 直接挂载(推荐)
如果你已经在用 IoTDB,这是成本最低的路径------直接指定数据库实例与时间序列路径即可,无需导出。
方式 B:文件上传(CSV / Parquet)
适合 POC 验证。要求数据为长表或宽表二选一:
text
# 长表格式(推荐,天然适配不规则采样)
timestamp,series_id,value
2025-01-01 00:00:00,motor_01_current,12.3
2025-01-01 00:00:01,motor_01_current,12.5
2025-01-01 00:00:00,motor_01_temp,63.1
text
# 宽表格式
timestamp,current,temp,vibration
2025-01-01 00:00:00,12.3,63.1,0.021
2025-01-01 00:00:01,12.5,63.2,0.019
方式 C:API 流式写入
适合实时推理场景,直接把采集侧的数据推给模型服务。
第 3 步:定义任务(Task)
这是 TimechoAI 使用里最关键的一步,也是最能体现"大模型"价值的一步------你不需要写模型代码,只需要描述"要预测什么、拿什么预测、预测多远"。
一个典型任务定义包含:
| 配置项 | 说明 | 建议 |
|---|---|---|
| 目标序列(Target) | 你要预测/检测的那条曲线 | 一次聚焦 1~5 条核心指标 |
| 协变量(Covariates) | 辅助预测的外生变量 | 温度、班次、产量、天气、工况标签 |
| 历史窗口(Look-back) | 回看多长历史 | 至少覆盖 2~3 个完整业务周期 |
| 预测步长(Horizon) | 预测未来多远 | 短期精度高,长期需谨慎 |
| 采样粒度 | 秒/分/小时/天 | 与决策节奏对齐 |
| 评估指标 | MAE / RMSE / MAPE / F1 | 业务导向选型 |
第 4 步:零样本推理 → 少样本微调
这是时序大模型区别于传统工具的核心体验:你可以先用零样本(Zero-shot)跑一遍,立刻拿到一条基线;如果业务精度要求更高,再用历史数据做轻量微调。
python
# 示例:使用 TimechoAI SDK 完成一次预测任务(示意代码,以官方文档为准)
from timecho_ai import TimechoClient

client = TimechoClient(
    endpoint="https://api.ai.timecho.com",
    access_key="<YOUR_AK>",
    secret_key="<YOUR_SK>",
)

# 1) 创建预测任务
task = client.create_forecast_task(
    name="load_forecast_line3",
    datasource={
        "type": "iotdb",               # 也支持 csv / parquet / api
        "host": "10.0.12.31",
        "port": 6667,
        "database": "root.factory.line3",
    },
    target=["root.factory.line3.power.load"],          # 目标:产线负荷
    covariates=[
        "root.factory.line3.env.temperature",          # 环境温度
        "root.factory.line3.plan.shift",               # 班次(工况标签)
        "root.factory.line3.mes.output",               # 产量计划
    ],
    freq="1min",
    lookback="7d",        # 回看 7 天
    horizon="24h",        # 预测未来 24 小时
    metrics=["mae", "rmse", "mape"],
)

# 2) 零样本推理:先拿基线,不需要任何训练
baseline = client.infer(task_id=task.task_id, mode="zero-shot")
print("零样本 MAPE:", baseline.metrics["mape"])

# 3) 少样本微调:用近 90 天数据提升精度
finetune_job = client.finetune(
    task_id=task.task_id,
    train_range=("2025-04-01", "2025-06-30"),
    epochs=20,
    learning_rate=1e-4,
)
finetune_job.wait()

# 4) 评估对比
report = client.evaluate(task_id=task.task_id, test_range=("2025-07-01", "2025-07-31"))
print(report.compare(baseline="zero-shot", current="finetuned"))工程经验:不要一上来就微调。先用零样本建立"能不能做"的判断,再决定投入多少微调成本。实践中,很多场景零样本已经能超过人工规则基线,少样本微调后还能再提升一大截。
第 5 步:结果消费与部署
结果消费有三种常见姿势:
- 控制台可视化:看预测曲线、置信区间、异常打分趋势;
- 回写 IoTDB:把预测值/异常标签写回数据库,与真实值同库存储,便于后续对比与审计;
- API 调用:集成到 MES / SCADA / 告警平台。
python
# 示例:把预测结果回写 IoTDB,形成"真实值 vs 预测值"对照
result = client.get_forecast(task_id=task.task_id, start="2025-08-01", end="2025-08-02")

session = Session("10.0.12.31", 6667, "root", "root")
session.open(False)
for ts, pred, lower, upper in result.rows():
    session.insert_records(
        ["root.factory.line3.power"],
        [ts],
        [["load_pred", "load_lower", "load_upper"]],
        [[pred, lower, upper]],
    )
session.close()
四、核心时序分析能力详解
4.1 时序预测:从"点估计"到"带不确定性"
工业决策最怕的不是预测不准,而是不知道预测有多不准。TimechoAI 的预测输出通常会带置信区间(分位数预测),这对下游决策至关重要:
- 电网调度:按上界准备备用容量,按下界安排检修窗口;
- 库存管理:按上界设定安全库存,避免断货;
- 能源交易:按区间概率做报价策略。
实操建议 :预测步长越长,不确定性越大。经验法则是------预测步长控制在历史窗口的 1/4 以内,精度通常比较可控。24 小时负荷预测,历史窗口至少给 4~7 天;月度产能预测,历史窗口至少给半年到一年,以便模型学到季节性。
4.2 异常检测:不只看"超阈值"
传统告警靠固定阈值,问题是工况一变就误报 。时序大模型的做法不同:它学习的是"在当前工况下,这条曲线本该是什么样",然后比较实际值与期望值的偏离。
python
# 示例:多变量异常检测(示意代码)
ad_task = client.create_anomaly_task(
    name="pump_health_monitor",
    datasource={"type": "iotdb", "database": "root.plant.pump01"},
    target=[
        "root.plant.pump01.vib.x",
        "root.plant.pump01.vib.y",
        "root.plant.pump01.temp.bearing",
        "root.plant.pump01.current.a",
    ],
    freq="1s",
    lookback="1h",
    mode="multivariate",      # 多变量联合建模,捕捉变量间的耦合异常
    sensitivity=0.95,         # 灵敏度,越高越敏感(误报↑,漏报↓)
)

alerts = client.detect(ad_task.task_id, start="2025-08-01", end="2025-08-07")
for a in alerts:
    print(a.timestamp, a.score, a.contributing_variables)  # 关键:给出贡献变量
这里最实用的一个能力是 contributing_variables(贡献变量归因) 。它回答的不是"有没有异常",而是"是哪个测点把异常推出来的"------这一步直接把告警变成了可行动的线索,是排查效率的分水岭。
4.3 缺失填补:被低估但高频的需求
工业现场断网、丢包、传感器掉线是常态。缺失值如果直接丢弃,会破坏序列连续性,让预测和检测都失真。TimechoAI 的缺失填补会同时利用同序列的前后文 + 相关序列的横截面信息,比线性插值、前向填充靠谱得多。
适用场景:数据治理补全、训练数据修复、上报合规(环保、能耗监测常要求数据完整率)。
4.4 时序分类:故障模式识别
给定一段时序片段,判断它属于哪一类。典型场景:把振动/电流的波形片段归类为"正常 / 轴承磨损 / 不对中 / 气蚀"等故障模式。传统做法需要大量标注样本,而时序大模型的预训练表征让少样本分类变得可行。
五、经典案例拆解(含可复用的方法论)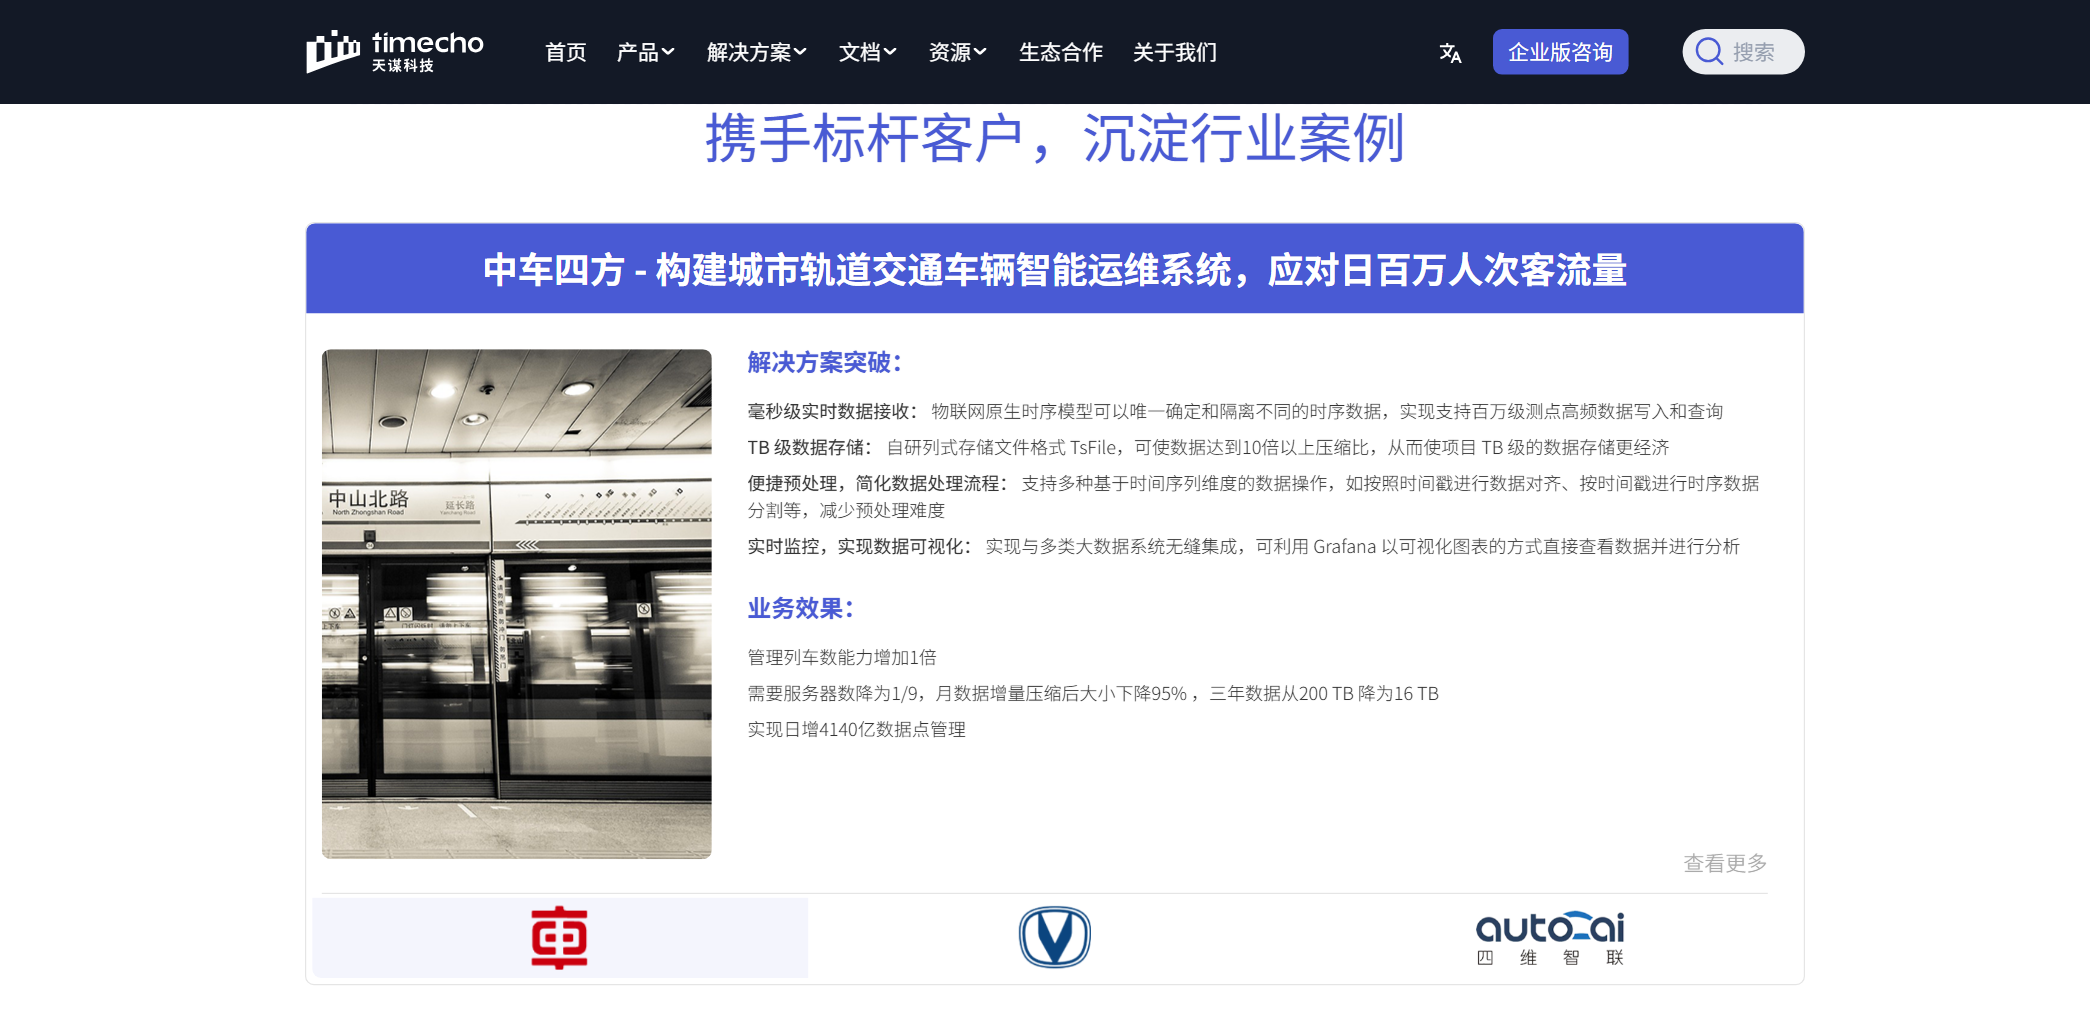
下面三个案例的业务背景与数据规模,均整理自天谋科技官网"用户案例"栏目公开披露的材料;TimechoAI 部分为在既有数据底座上的能力推演,用于说明落地路径,不视为官方实测指标。之所以从数据库案例切入讲 AI,是因为脱离数据底座谈模型落地没有意义------先看清这些企业当年是怎么把数据存下来的,才能理解后面 AI 能加在哪一层。
案例一:中车四方 ------ 城轨车辆智能运维,从"事后修"到"预测修"
背景与数据规模
中车四方将 IoTDB 用于城轨车辆智能运维系统的核心部分,应用于 300 辆列车、每列 3200 个测点 的车辆监控数据存储及故障统计与趋势化分析。成效非常硬核:可管理列车数增加 1 倍,采样时间提升 60%,服务器数降为原来的 1/13,月数据增量压缩后下降 95%,实现日增 4140 亿数据点的管理飞跃。
痛点
数据量解决了,但"3200 个测点 × 300 列车"靠人看是不可能的。真正的问题是:如何在故障发生前,从海量测点里提前识别出劣化征兆?
TimechoAI 落地路径
- 分层建模:不直接对 3200 个测点全量建模,而是按"牵引 / 制动 / 转向架 / 空调 / 车门"等子系统分组,每组选取 10~20 个关键测点做多变量异常检测;
- 工况对齐:列车运行状态(加速 / 巡航 / 制动 / 停站)对测点影响极大,把运行状态作为协变量输入,避免"加速时的高电流"被误判为异常;
- 趋势外推:对轴承温度、绝缘电阻这类缓慢劣化指标做长周期预测,输出"预计 X 天后触达阈值"的剩余寿命提示;
- 告警分级:异常分数 + 贡献变量 + 持续时长三要素联合判定,把告警分为"观察 / 计划检修 / 立即处置"三级。
方法论复用点
先分系统,再选关键测点,最后联合建模------这条路径适用于几乎所有大型装备(风机、机组、产线),比"全量测点丢进模型"有效得多,计算成本也可控。
案例二:国家电网 ------ 千万级终端接入下的精准用电调控
背景与数据规模
国家电网基于 IoTDB 构建精准用电调控终端、物联管理平台及实时量测中心,实现多类终端千万级接入管控、千万点数据/秒的实时写入能力,支持日新增千万级、累积亿级数据的高效管理。
痛点
用电负荷预测是电网调度的基础,但传统预测方法在极端天气、节假日、大型活动期间误差陡增,而这些恰恰是最需要精准调度的时段。
TimechoAI 落地路径
- 多粒度预测:同时输出 15 分钟(调度用)、日(计划用)、月(交易用)三个粒度的负荷预测;
- 外生变量引入 :温度、湿度、日期类型(工作日/周末/节假日)、经济活跃度指标作为协变量------节假日效应是这类场景精度跃升的关键;
- 分位数输出:输出 P10 / P50 / P90 三条曲线,调度按 P90 准备备用容量,检修按 P10 安排窗口;
- 在线滚动:新数据到达后自动滚动更新预测,而非每天重算一次;
- 异常联动:预测偏差持续超过阈值时触发模型健康度告警,提示可能需要重新微调。
方法论复用点
预测任务一定要引入"日历/工况类协变量"。电力负荷、客流量、订单量、交通流量这类强周期序列,节假日和工作日的分布差异巨大,纯序列模型学不到这部分信息,必须显式喂进去。
案例三:宝武钢铁 ------ 高频海量数据的设备预测性维护
背景与数据规模
宝武钢铁基于 IoTDB 构建远程智能运维软硬件平台,接入单时间序列 2000 亿个时序点,接口写入速度可达 3000 万/秒,压缩比达到 10 倍,毫秒级高频数据可长时间稳定写入,多采集频率可稳定兼容。
痛点
钢铁冶炼是典型的连续生产过程,一次非计划停机损失巨大。难点在于:高频毫秒级数据体量极大,且不同采集频率的数据要联合分析。
TimechoAI 落地路径
- 降采样 + 特征分层 :毫秒级原始波形用于异常检测与故障模式识别,分钟/小时级聚合值用于趋势预测与寿命推算,不同任务用不同粒度,避免用高频数据做长期预测(噪声淹没信号);
- 多频率兼容:利用 IoTDB 对多采集频率的稳定兼容能力,先把不同频率的测点对齐到统一时间轴,再送入模型;
- 劣化趋势建模:对关键设备(轧机、风机、泵)建立劣化指标趋势预测,输出"剩余可用天数"而非单纯报警;
- 成本闭环:把"避免的非计划停机次数 × 单次损失"作为模型价值核算口径,反向验证模型阈值设置的合理性。
方法论复用点
高频数据不做长期预测 。采样频率越高,噪声占比越大。正确姿势是:高频做检测(看形状),低频做预测(看趋势)。
案例速览(更多场景)
| 场景 | 公开数据底座成效 | TimechoAI 可叠加的分析能力 |
|---|---|---|
| 长安汽车车联网 | 接入车辆约 57 万,测点约 8000 万,写入 150 万条/秒,查询从分钟级提升到毫秒级 | 电池健康度趋势预测、车况异常预警、充电行为预测 |
| 大唐先一(电力) | 服务 60 家电厂,单厂日数据 17 亿+,存储量级 3 万亿,运维成本减少 95% | 机组效率预测、能耗优化建议、设备故障预警 |
| 中国核电 | 支持 30+ 服务器、1000+ 容器节点、100TB+ 时序数据,可靠性 99.9% | 关键设备可靠性预测、征兆趋势滚动分析 |
| 国家气象局 MICAPS4 | 存储全国 10 万个国家级地面观测站数据,实况处理性能提升数倍 | 气象要素短临预报、观测数据质量校验与缺失填补 |
| 中冶赛迪水土云 | 设备 3 万+,测点 25 万+,写入 15 亿条/天,查询速度提升 100% | 环保指标预测、工况异常识别、治理效果评估 |
六、最佳实践与避坑指南(这一节最值钱)
6.1 数据质量 > 模型选择
时序大模型降低了建模门槛,但没有降低数据质量的要求。上线前务必检查:
- 时间戳对齐:多源数据合并前统一时区和采样粒度;
- 缺失率:单条序列缺失率超过 30% 时,先做填补再建模;
- 量程跳变:传感器更换、量程调整会造成分布突变,需在特征里标记;
- 常量段:设备停机时数据可能长时间为 0 或恒定值,应识别并剔除或打标。
6.2 历史窗口与预测步长的经验配比
| 业务周期 | 建议历史窗口 | 建议预测步长 |
|---|---|---|
| 日周期(负荷、客流) | 7~30 天 | 1~24 小时 |
| 周周期(产量、订单) | 8~12 周 | 1~7 天 |
| 年周期(能耗、季节性) | 1~3 年 | 1~4 周 |
核心原则:历史窗口要覆盖至少 2~3 个完整业务周期,模型才能学到周期性;预测步长超过历史窗口的 1/4,精度通常会明显衰减。
6.3 冷启动的三板斧
新设备、新产线没有历史数据怎么办?
- 同类迁移:用同类设备的模型作为起点(大模型的跨域迁移能力在这里价值最大);
- 规则兜底:先用物理阈值/工艺规则做兜底告警,数据积累到一定量后切换模型;
- 主动积累:从第一天起就规范存储,宁可先不用,也不能不存。
6.4 模型不是"上线即结束"
建立三条监控线:
- 数据漂移监控:输入分布是否发生变化(换传感器、改工艺);
- 精度衰减监控:滚动评估预测误差,超过阈值触发重新微调;
- 告警有效性监控:统计误报率与漏报率,反馈给灵敏度参数。
6.5 与规则引擎配合使用,别硬刚
一个成熟的工业智能系统通常是**"规则 + 模型"双引擎**:
- 规则负责硬约束(安全阈值、联锁保护),可靠、可解释、零延迟;
- 模型负责软判断(劣化趋势、早期征兆、复杂耦合),提前量更大。
不要用模型去替代安全联锁,这是红线。
七、选型建议:什么时候该用 TimechoAI?
适合用的情况:
- 已有 IoTDB / TimechoDB 数据底座,希望直接在数据之上叠加智能分析;
- 场景多、设备杂、模型复用率低,受够了"一设备一模型";
- 标注样本少,但历史时序数据积累较多;
- 团队缺少算法工程师,希望以 SQL/API 方式获得 AI 能力。
需要谨慎评估的情况:
- 强物理机理场景(如精确的流体仿真),纯数据驱动模型未必优于机理模型,可考虑混合建模;
- 对可解释性有强合规要求的场景(如部分金融风控),需提前规划解释方案;
- 数据量极小且高度定制化,简单统计模型可能更经济。
另外给一条实操建议:先想清楚数据存在哪,再决定用哪个模型。如果目前数据还在 CSV / 关系库里打转,第一步该做的是把时序数据迁进专门的时序库,而不是急着上 AI。这一层的选型(开源社区版 vs 企业版、单机 vs 分布式、是否需要云边同步)可以在 官网的产品页和解决方案页找到对应行业的参考架构,比自己从零设计省事得多。
八、总结
时序数据分析正在经历一次范式转移:从"每个场景从头训练一个模型",走向"一个预训练大模型 + 轻量场景适配 "。这条路的工程价值非常实在------更少的标注、更短的周期、更低的维护成本、更强的跨场景泛化。
TimechoAI 的独特之处在于,它不是孤立的算法服务,而是长在 Apache IoTDB / TimechoDB 这套经过工业级验证的数据底座之上。从"存得下"(10X 无损压缩、千万点/秒写入)到"算得准"(时序大模型的预测、检测、填补、分类),形成了一条完整闭环。对于已经或计划使用 IoTDB 的团队来说,这是最短的智能化路径。
如果你想动手试试,建议的起步姿势是:挑一条你最熟悉的曲线,先用零样本跑个基线,再决定是否微调。大多数人会惊讶于"什么都不训练就能跑出可用结果"这件事------这也正是"基础模型"这个词的分量所在:它把原本需要一个团队几个月完成的事,压缩成了几次 API 调用。