随着工业互联网、智能制造、车联网、电力能源行业数字化快速推进,设备传感器、采集终端源源不断产生海量时序数据。单项目百万级测点、每秒百万级写入、TB乃至PB级存储已经成为常态。很多团队前期直接选用传统关系数据库,上线后就遇到写入吞吐瓶颈、磁盘快速膨胀、查询响应迟缓、运维压力大等各类问题。
时序数据库(TSDB)针对时间序列数据专门做存储引擎优化,围绕设备测点、时间戳、采集值做底层设计,解决海量时序高吞吐写入、高压缩存储、时间窗口聚合查询等核心诉求。Apache IoTDB 是Apache基金会顶级开源时序数据库,在国内工业物联网大数据项目中被广泛使用。
不少开发者只阅读过概念介绍,没有完整跑通部署、建模、读写、调优完整流程,做技术选型时无法客观评估是否匹配自身业务。本文从大数据工程落地角度,梳理时序数据库选型评估维度,完整演示单机部署、SQL开发、Java Session高性能读写、生产调优、版本升级踩坑,全部代码可直接复制运行,附带选型评审清单,帮助完成技术预研与POC。
一、大数据场景时序数据库选型核心评估维度
选型不能只参考网上性能跑分,必须结合自身业务真实情况,下面整理工程实践8个核心评估维度,做技术评估时可以逐项对照打分。
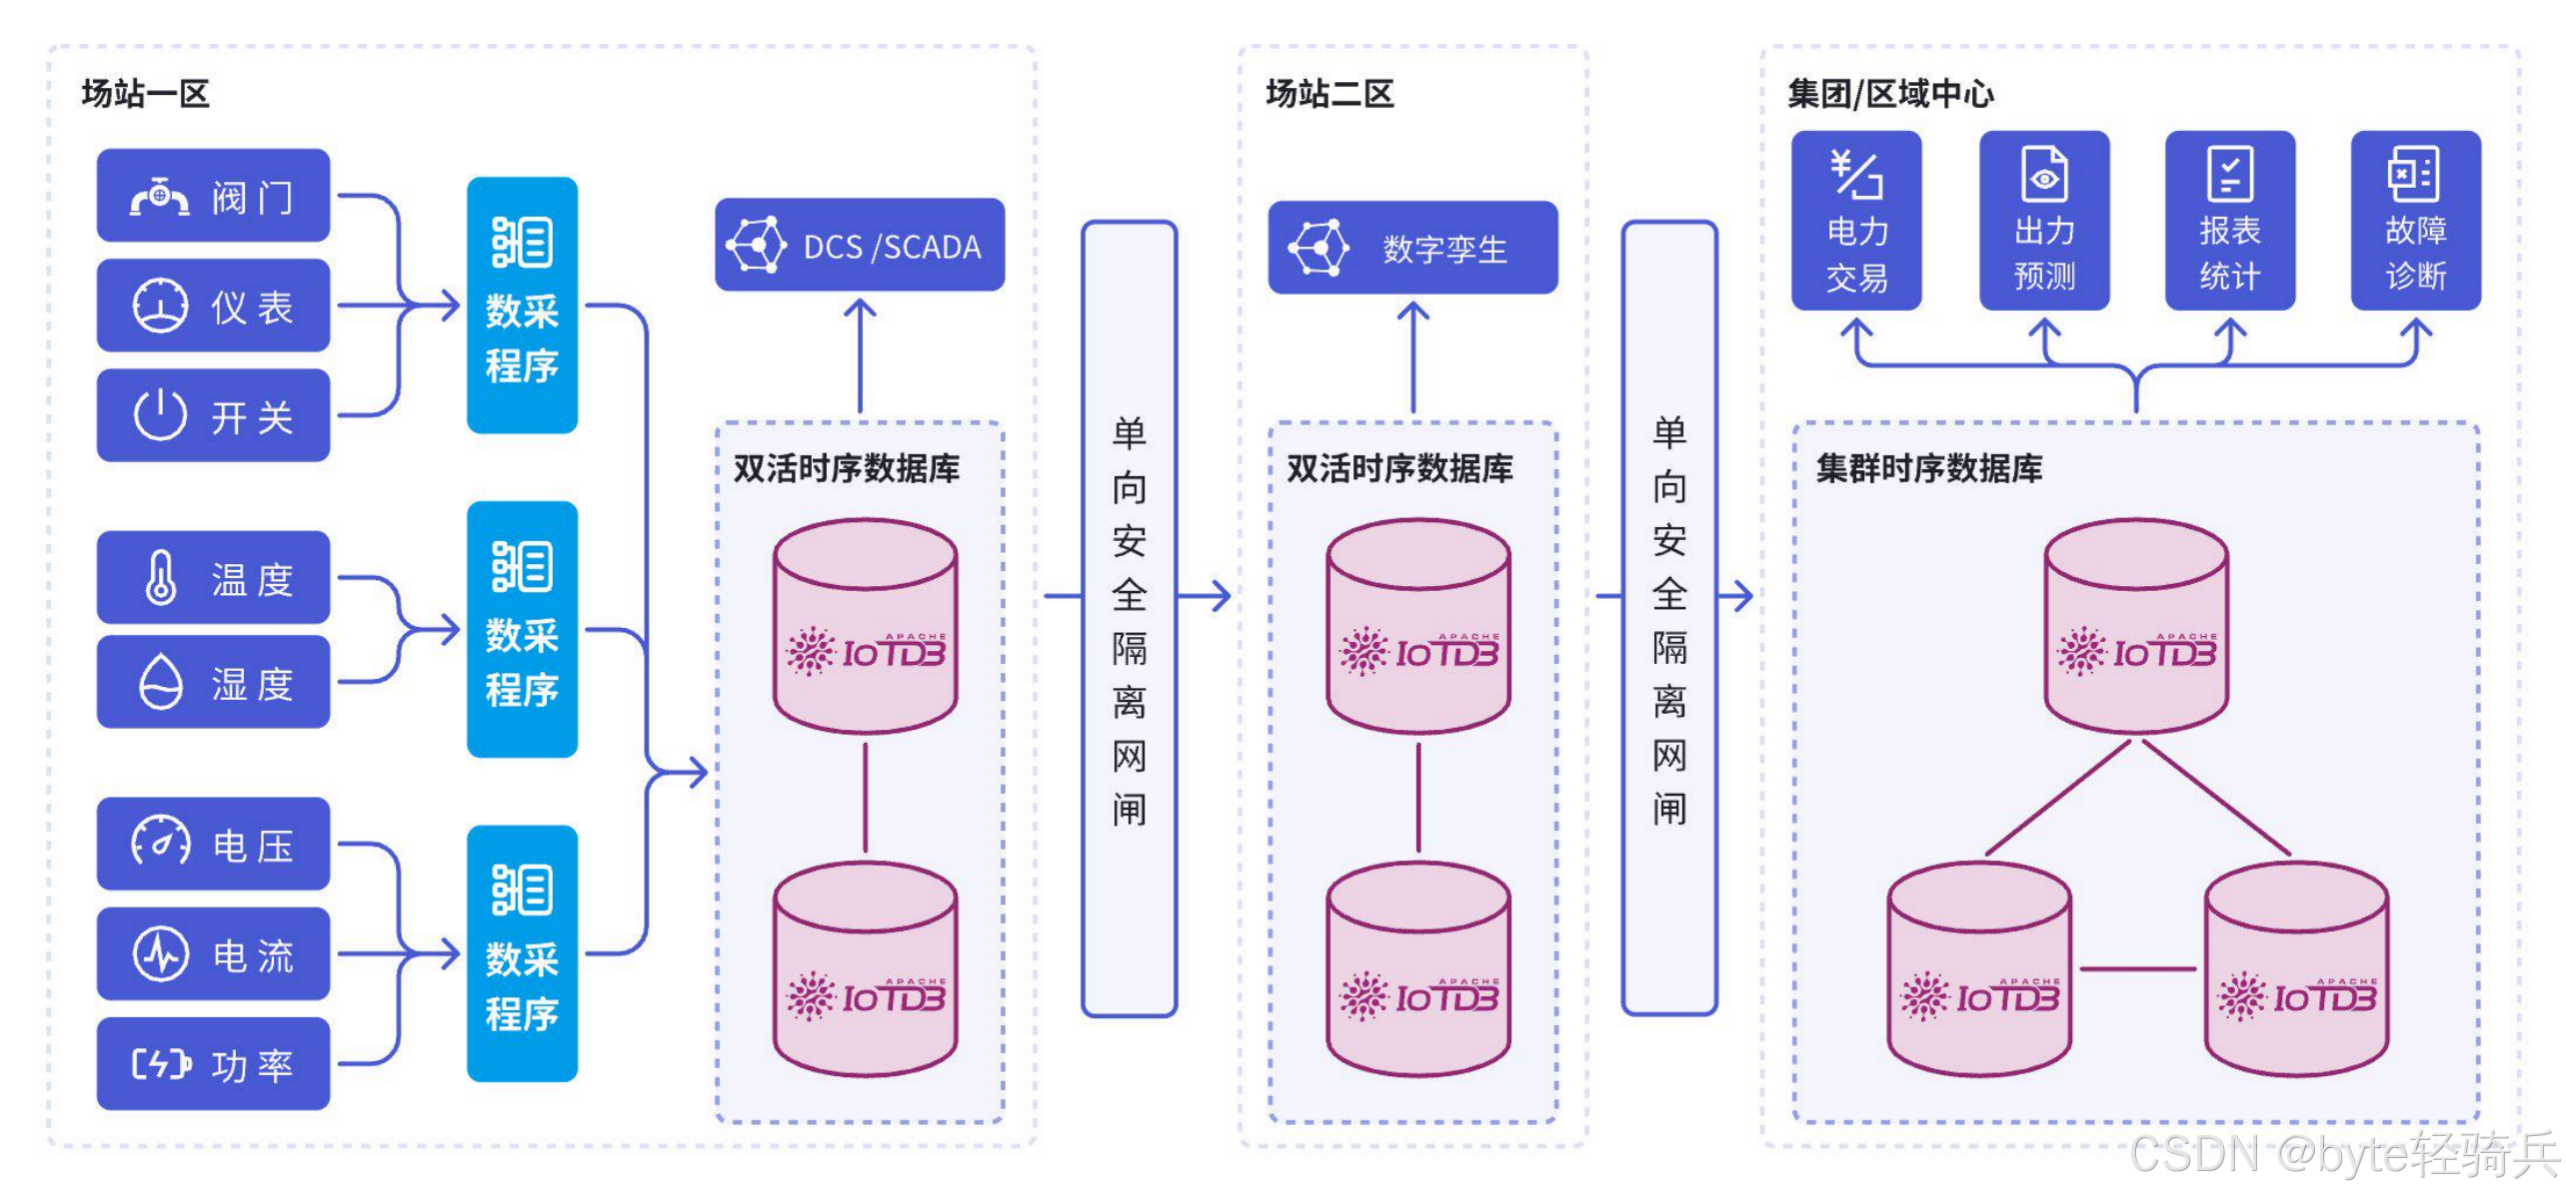
1. 数据模型适配能力
工业物联网设备天然是树形层级结构:工厂‑车间‑设备‑传感器测点,例如root.factory01.workshop02.device05.temperature。树形模型能够直接映射现实资产组织关系,降低业务建模成本。
当设备与测点规模持续扩张,扁平化模型容易出现元数据膨胀,提升运维复杂度。树形结构和业务资产管理逻辑对齐,开发理解成本更低,非常适配工业类业务。
2. 写入性能与乱序晚到数据处理
真实采集环境中,网络抖动、边缘设备离线缓存上报,乱序、晚到数据属于普遍现象。数据库原生支持乱序写入,就不需要业务层额外做预处理逻辑,大幅简化业务代码。评估时重点关注单机写入吞吐、批量写入API、高性能写入接口能力。
边缘场景网络恢复后,会大批量回传历史缓存数据,数据库能否稳定接纳晚到数据,保证不丢数据、不抛出异常,是工业业务的硬性指标。
3. 压缩能力与存储成本控制
时序数据体量庞大,长期存储成本不可忽视。底层存储文件的压缩算法直接决定磁盘资源占用。IoTDB自研TsFile时序文件格式,利用时序数据数值连续变化的特征做优化,多数工业业务场景能够实现十倍以上压缩,有效减少磁盘开销。
时序采样数据前后时间点数值关联性强,针对性的压缩策略,在不明显损耗查询性能的前提下,显著降低存储开销,对长期运行项目有很大价值。
4. 集群扩展与高可用能力
测点规模从十万增长到千万甚至亿级,数据库需要支持水平扩容,尽量避免停机做数据重构。需要重点考察多副本机制、故障自动转移、节点在线扩缩容、元数据管理能力。
业务发展过程测点会不断增加,如果数据库无法在线扩容,后期的数据迁移会带来巨大业务风险;多副本能力保障硬件故障场景下数据不丢失,保障读写业务持续可用。
5. 边云协同部署能力
大量工业项目采用边缘采集+中心存储架构。边缘网关硬件资源有限,需要轻量数据库实例完成本地数据缓存,网络恢复后同步至中心集群。IoTDB提供Edge边缘二进制包,资源占用低,支持ARM架构硬件,适配网关类边缘设备。
边缘本地缓存可以规避网络断连造成原始数据丢失,网络恢复后完成数据同步,构建完整边‑端‑云数据链路。
6. SQL兼容性以及多语言SDK生态
兼容SQL语法可以降低团队学习成本,不需要掌握一套全新查询语法;同时完备的多语言SDK(Java / Python / C++ / Go)可以适配项目不同的技术栈。
不管是后端业务服务、采集脚本,还是嵌入式程序,都可以快速对接数据库,减少适配开发工作量。
7. 版本迭代、升级方案、开源社区生态
生产环境一定会遇到版本升级,必须具备清晰的升级操作文档,不能简单直接拷贝数据目录。同时开源协议、文档完整度、社区活跃度,直接影响线上故障排查效率。
Apache IoTDB使用Apache2.0开源协议,可以免费用于商业项目,没有版权风险,官方文档提供了小版本迭代、跨大版本升级完整操作说明。活跃社区也方便开发者查阅问题案例、提交issue反馈问题。
8. 软硬件适配能力
国内很多项目存在信创适配需求,需要数据库能够兼容国产CPU、国产操作系统。开源版本能够满足绝大多数业务开发、生产使用。
二、Apache IoTDB实操完整实战
开源二进制包下载地址:发行版本 | IoTDB Website,本文采用稳定版本2.0.11演示,All‑in‑one包,Linux运行环境,依赖JDK17。
2.1 实操1:单机Standalone部署(1ConfigNode+1DataNode)
-
下载压缩包解压
unzip apache-iotdb‑2.0.11‑all‑bin.zip
cd apache-iotdb‑2.0.11‑all‑bin -
生产环境必调操作系统内核参数,避免高并发出现
connection reset报错临时生效
sudo sysctl -w net.core.somaxconn=65535
永久生效写入配置 /etc/sysctl.conf
net.core.somaxconn = 65535
-
启动单机服务
bash sbin/start‑standalone.sh
重要踩坑:1.0版本之后RPC默认监听地址
127.0.0.1,外部机器访问,修改配置文件把dn_rpc_address修改为0.0.0.0;0.13旧版本默认0.0.0.0,版本升级时极易踩这个坑。
-
启动交互式CLI客户端,默认账号root/root
bash sbin/start‑cli.sh
出现CLI命令提示符即代表部署成功。
2.2 实操2:基础SQL实操,树形模型建模、写入、查询
IoTDB核心概念:存储组Storage Group(类比传统数据库database);时间序列time series,对应设备传感器测点。
-- 创建存储组
SET STORAGE GROUP TO root.factory.workshop1;

-- 创建测点时间序列,指定数据类型、编码压缩
CREATE TIMESERIES root.factory.workshop1.device01.temperature WITH DATATYPE=FLOAT, ENCODING=GORILLA;
CREATE TIMESERIES root.factory.workshop1.device01.humidity WITH DATATYPE=INT32, ENCODING=TS_2DIFF;
CREATE TIMESERIES root.factory.workshop1.device01.status WITH DATATYPE=BOOLEAN, ENCODING=PLAIN;

-- 查询全部时序
SHOW TIMESERIES root.factory.workshop1.**;

-- 单条数据写入
INSERT INTO root.factory.workshop1.device01(timestamp,temperature,humidity,status)
VALUES(1750000000000,24.5,42,true);

-- 批量多条写入
INSERT INTO root.factory.workshop1.device01(timestamp,temperature,humidity,status)
VALUES
(1750000001000,24.7,43,true),
(1750000002000,25.1,44,false),
(1750000003000,24.9,43,true);

-- 时间范围原始数据查询
SELECT temperature,humidity,status FROM root.factory.workshop1.device01
WHERE time >=1750000000000 AND time <=1750000003000;

-- 降采样聚合:2000ms时间窗口统计温度最大、最小、平均值
SELECT MAX_VALUE(temperature),MIN_VALUE(temperature),AVG(temperature)
FROM root.factory.workshop1.device01
GROUP BY ([1750000000000,1750000003000],2000ms);

-- 查询设备最新一条测点数据
SELECT LAST temperature,humidity FROM root.factory.workshop1.device01;
高频踩坑:1.0版本标识符、反引号语法规则
1.0版本开始,不使用反引号包裹的标识符仅允许字母、中文、下划线 ;节点名称包含数字、点号等特殊字符,必须用反引号 `````包裹,单/双引号不再用于路径节点引用。0.13升级上来的项目很容易在这里出错。
-- 节点名包含点号,必须反引号包裹
CREATE TIMESERIES root.factory.workshop1.`sensor.001` WITH DATATYPE=FLOAT,ENCODING=GORILLA;
SELECT `sensor.001` FROM root.factory.workshop1;
旧版本0.13习惯使用单引号写路径,升级1.0后全部替换成反引号,否则引号会被当成节点名称存入时序。
2.3 实操3:Java Session API Tablet批量写入(生产推荐)
生产大数据写入场景,不要循环执行单条INSERT SQL,优先使用Tablet批量接口,写入性能远高于逐条SQL。
Maven依赖版本需要和服务端版本对齐,示例为2.0.11:
<dependency>
    <groupId>org.apache.iotdb</groupId>
    <artifactId>iotdb‑session</artifactId>
    <version>2.0.11</version>
</dependency>
完整可运行Java示例代码:
import org.apache.iotdb.isession.SessionDataSet;
import org.apache.iotdb.rpc.IoTDBConnectionException;
import org.apache.iotdb.rpc.StatementExecutionException;
import org.apache.iotdb.session.Session;
import org.apache.iotdb.tsfile.write.record.Tablet;
import org.apache.iotdb.tsfile.write.schema.MeasurementSchema;
import org.apache.iotdb.tsfile.file.metadata.enums.TSDataType;
import org.apache.iotdb.tsfile.file.metadata.enums.CompressionType;
import org.apache.iotdb.tsfile.file.metadata.enums.TSEncoding;

import java.util.ArrayList;
import java.util.List;

public class IoTDBTabletDemo {
    public static void main(String[] args) throws IoTDBConnectionException, StatementExecutionException {
        // 构建Session会话
        Session session = new Session.Builder()
                .host("127.0.0.1")
                .port(6667)
                .username("root")
                .password("root")
                .build();
        session.open();

        String devicePath = "root.factory.workshop1.device01";
        List<MeasurementSchema> schemaList = new ArrayList<>();
        // 定义测点:温度float、湿度int32
        schemaList.add(new MeasurementSchema("temperature", TSDataType.FLOAT, TSEncoding.GORILLA, CompressionType.SNAPPY));
        schemaList.add(new MeasurementSchema("humidity", TSDataType.INT32, TSEncoding.TS_2DIFF, CompressionType.SNAPPY));

        // 组装Tablet,批量写入1000行
        Tablet tablet = new Tablet(devicePath, schemaList, 1000);
        tablet.init();
        long[] timestamps = tablet.timestamps;
        Object[] values = tablet.values;

        long baseTime = System.currentTimeMillis();
        for (int i = 0; i < 1000; i++) {
            int rowIndex = tablet.rowSize++;
            timestamps[rowIndex] = baseTime + i * 1000;
            ((float[]) values[0])[rowIndex] = 20 + (float) (Math.random() * 10);
            ((int[]) values[1])[rowIndex] = 30 + (int) (Math.random() * 20);
        }
        session.insertTablet(tablet);

        // 执行查询
        String sql = "select temperature,humidity from root.factory.workshop1.device01 where time >= " + baseTime;
        SessionDataSet dataSet = session.executeQueryStatement(sql);
        while (dataSet.hasNext()) {
            System.out.println(dataSet.next());
        }
        dataSet.close();
        session.close();
    }
}
重点提醒:1.0版本Session API传入路径,特殊节点同样需要Java代码内写反引号转义,0.13版本不需要,升级极易产生bug。
三、生产关键配置与版本升级踩坑
3.1 JVM堆内存调优
修改conf/datanode‑env.sh配置MEMORY_SIZE,Xms与Xmx设置为相同值,避免JVM动态扩容带来性能抖动。机器32G物理内存场景,建议分配16G堆内存,堆内存不超过物理内存80%。
MEMORY_SIZE="16G"3.2 磁盘硬件建议
- 优先SSD磁盘,尽量不要使用NAS网络存储,会严重影响读写性能;
- 多块数据盘分开配置,不建议全部组建单一大RAID;
- 生产环境建议配置多副本保障数据可靠性。
3.3 版本升级重要注意点
- 小版本迭代(2.0.10→2.0.11):大版本号一致,数据完全兼容,替换安装包,复用原有配置,重启服务即可;
- 0.13.x升级到1.0.x:禁止直接拷贝data目录,目录结构发生变更,历史数据使用LOAD功能导入;RPC监听地址变更,外部访问失败优先排查该配置;
- 升级前完整备份data目录和配置目录,保障可以回滚。
四、业务场景适配边界
任何开源组件都有自身的设计侧重,梳理适配场景,方便自我评估:
✅ 适配场景
- 工业物联网产线采集,设备树形资产模型,百万/千万测点规模,网络不稳定带来大量乱序晚到数据;
- 设备状态监测,长周期时序数据存储,需要做时间维度统计、降采样分析;
- 边缘网关轻量化部署,本地缓存数据,网络恢复后同步至中心;
- 需要开源协议无版权风险,适配国产化软硬件环境。
需要审慎评估场景 Apache IoTDB核心聚焦海量测点时序的写入、存储、时间维度聚合查询。如果业务大量依赖多表复杂JOIN关联,需要充分做POC验证;如果业务重心是完整监控告警大盘,需要自行对接可视化组件实现业务能力。
五、选型评审检查清单(可复制用于内部评审)
✅ 业务为物联网设备采集,资产适合树形层级建模
✅ 业务存在大量乱序、晚到时序数据
✅ 对存储压缩比有要求,希望降低磁盘成本
✅ 未来测点规模持续上涨,需要分布式水平扩容
✅ 存在边缘‑中心协同的数据链路需求
✅ 项目需要开源无版权风险,需要适配国产化软硬件
满足多项,Apache IoTDB是合适的技术选项。
六、结尾
时序数据库选型不要单纯参考网络跑分,建议拿业务真实样本数据完成POC测试,复现线上写入压力、查询逻辑,同时验证版本升级流程,之后再落地生产。Apache IoTDB为开源项目,可以前往官方下载地址获取新版本:发行版本 | IoTDB Website。
如果本文对你有帮助,欢迎点赞收藏,后续可以更新集群部署、TsFile归档、Flink对接IoTDB相关实操。
参考文档
- Apache IoTDB官方发行文档 发行版本 | IoTDB Website
- Apache IoTDB官方快速上手文档