让大模型长出手脚,自己写SQL查数据库(Function Calling初探)
前面五篇文章,我们一步一步搭起了时序大模型的调用框架。但是你仔细回想一下整个流程,是不是觉得哪里有点别扭?
别扭在什么地方呢?在于我们太像保姆了。我们要自己写代码去连数据库,自己写SQL把数据捞出来,自己把数据洗成文本,再小心翼翼地拼进提示词里喂给大模型。大模型就像个大爷,张嘴吃现成的,吃完吧唧嘴给个评价就走人了。
这种模式在指标少、逻辑固定的时候还能凑合。但如果指标几十个,老板随口问一句"查一下三号车间昨天的平均温度和最高湿度",你就得去改代码写两句SQL。这太累了。
那么有没有一种办法,能让大模型自己去查数据库呢?它那么聪明,它学过SQL,它应该能自己写查询语句啊。
今天这篇,我们就来硬啃一个大招:Function Calling,也就是工具调用。我们要让大模型长出手脚,自己发号施令去查数据。
一、 以前是我们求着模型干活,现在让模型自己发号施令
1.1 回顾一下之前的累人流程
我们先复盘一下以前的流程。老板提了个需求,我们要干好几步活。
第一步,我们要把老板的自然语言翻译成我们的代码逻辑。第二步,代码逻辑去连SQLite,执行写死的SQL。第三步,拿到数据,拼成字符串。第四步,丢给大模型做分析。
在这个过程中,大模型只参与了第四步。前三步这种苦活累活全是我们在干。我们成了大模型和数据库之间的搬运工。
如果哪天老板问的指标变了,或者时间范围变了,我们就得去改SQL,甚至改提示词。这其实就是一种硬编码。只要需求一变,代码就得跟着动。这显然不是长久之计。
1.2 Function Calling是个什么神仙逻辑
那Function Calling是个啥呢?其实说白了,就是大模型不再只动嘴了,它还能动手。
当然,它不能直接跑到你的服务器上去敲键盘。它的工作方式是这样的:我们先给它一本"工具说明书",告诉它我们现在手头有哪些工具可以用。比如我们告诉它,我们有一个叫 query_metrics 的工具,可以查数据库里的监控数据。
然后我们跟它说:"老板想看昨天三号车间下午两点的CPU数据。"
大模型看完工具说明书,它一琢磨,这事儿我得用 query_metrics 这个工具啊。于是它就不直接给你回废话了。它会返回一个结构化的JSON给你,里面写着:"我要调用 query_metrics,参数是 表名=cpu_table,时间=昨天14点"。
我们拿到这个JSON之后,在代码里去真正地执行那个查数据库的函数。把查出来的数据,再原封不动地塞回给大模型。
这时候大模型既拿到了老板的问题,又拿到了真实的数据库数据,它再一总结,把人话吐给老板。
你看,在这个流程里,写SQL这种活儿变成谁干了?变成大模型干了。它通过生成参数的方式,告诉了我们要查什么。我们只需要把工具准备好,等它差遣就行了。这就是它长出手脚的意思。
二、 想让模型查数据,得先给它写个"工具说明书"
2.1 说明书里要写些啥
大模型是个瞎子,它不知道你这台机器上能干什么。所以你必须极其详细地描述你的工具。
说明书一般包含这几样东西:
- 工具的名字(比如
query_metrics)。 - 工具的作用描述(这是最最核心的,大模型就是看这段描述来决定要不要用这个工具的)。
- 工具需要什么参数(比如表名、时间范围)。
- 每个参数的类型和描述。
这个描述一定要写得大白话一点,但是又要精准。比如你写"查询数据",大模型可能不知道啥时候该用。你得写"当用户需要查询时序监控指标的具体数值时使用此工具,支持按指标名和时间范围过滤"。这样它才懂。
2.2 用JSON Schema把说明书结构化
我们要把这个说明书,拼成API接口能认识的JSON格式。这就是JSON Schema。
我们来看看针对查数据库这个场景,工具说明书长什么样:
python
tools = [
    {
        "type": "function",
        "function": {
            "name": "query_metrics",
            "description": "查询服务器监控指标的时序数据。当用户需要获取CPU、内存等具体数值或趋势时,请调用此工具。",
            "parameters": {
                "type": "object",
                "properties": {
                    "metric_name": {
                        "type": "string",
                        "description": "要查询的指标名称,例如:CPU, Memory"
                    },
                    "start_time": {
                        "type": "string",
                        "description": "查询的起始时间,格式为 YYYY-MM-DD HH:MM:SS"
                    },
                    "end_time": {
                        "type": "string",
                        "description": "查询的结束时间,格式为 YYYY-MM-DD HH:MM:SS"
                    }
                },
                "required": ["metric_name", "start_time", "end_time"]
            }
        }
    }
]
你看这段JSON。最外面是个列表,说明我们可以注册多个工具。现在里面只有一个。
function 里面就是具体信息。name 是给代码看的。description 是给大模型看的。
parameters 里面定义了三个参数。我们告诉大模型,调用这个工具必须得告诉我指标名、开始时间和结束时间。而且我们在 required 里声明了,这三个参数缺一不可。如果大模型只给了指标名没给时间,它就不符合规范,我们的代码就可以拒绝执行。
另外注意看,我们特意在 description 里写了时间的格式是 YYYY-MM-DD HH:MM:SS。这很重要。如果不写,大模型可能会给出 昨天下午两点 这种自然语言,我们的代码是解析不了的。必须把格式约束死。
三、 动手写一个真正能查数据库的工具函数
3.1 这个函数是给Python执行的,不是给模型执行的
说明书写好了,接下来我们要把第四篇里写的那个查SQLite的代码稍微封装一下,变成一个能接收上面那些参数的函数。
大模型只会告诉我们参数,真正的活还得我们自己干。
python
import sqlite3

def query_metrics(metric_name, start_time, end_time):
    # 这就是我们第四篇写的查数据逻辑,稍微改改参数
    conn = sqlite3.connect('monitor.db')
    cursor = conn.cursor()

    sql = """
        SELECT time, metric_name, value
        FROM metrics
        WHERE metric_name = ? AND time >= ? AND time <= ?
        ORDER BY time ASC
    """

    try:
        cursor.execute(sql, (metric_name, start_time, end_time))
        results = cursor.fetchall()

        if not results:
            return "没有查到数据"

        # 把查出来的元组洗成文本,方便大模型阅读
        text_lines = []
        for row in results:
            line = f"时间: {row[0]}, 指标: {row[1]}, 数值: {row[2]}%"
            text_lines.append(line)

        return "\n".join(text_lines)

    except Exception as e:
        return f"查询数据库报错了: {e}"
    finally:
        conn.close()
这个函数接收 metric_name、start_time、end_time。连上数据库,把结果查出来,拼成一段文本返回。
为什么我们要把结果拼成文本返回呢?因为这个结果等会儿还要塞回给大模型。大模型看不懂元组列表,它只认识字符串。所以我们在工具层就把数据洗好,给大模型准备好最容易消化的食物。
四、 串联整个调用的闭环
这一步是今天最烧脑的地方。Function Calling不是一次请求就能搞定的,它是一个来回交涉的过程。最少要走三个回合。
4.1 第一回合:发请求带上工具说明书
我们先发第一次请求。这次请求跟以前不一样,我们要在 payload 里把 tools 带上。
python
import requests
import json

def first_round_call(user_question, api_key, tools_list):
    url = "https://ai.timecho.com/v1/chat/completions"
    headers = {
        "Content-Type": "application/json",
        "Authorization": f"Bearer {api_key}"
    }

    messages = [
        {"role": "user", "content": user_question}
    ]

    payload = {
        "model": "timecho-model",
        "messages": messages,
        "tools": tools_list  # 把工具说明书塞进去
    }

    response = requests.post(url, headers=headers, json=payload, timeout=30)
    result = response.json()

    # 把大模型的回复和当前的messages历史一起返回,后面还要用
    return result, messages
我们拿着老板的问题,带上工具说明书,去问大模型。这时候大模型会怎么回呢?
4.2 判断模型的回复是想聊天还是想干活
大模型拿到问题,它脑子里会盘算:这个问题我是直接回答呢,还是得用工具?
如果它觉得不需要用工具,它返回的格式跟以前一样,choices[0]['message']['content'] 里有段文字。
如果它觉得需要用工具,它就不会回 content 了。它会回一个叫 tool_calls 的字段。
我们要写代码来判断这事儿:
python
# 假设这是刚才返回的result
message = result['choices'][0]['message']

# 检查有没有tool_calls字段
if message.get('tool_calls'):
    print("大模型决定使用工具!")
    # 它想干活
else:
    print("大模型直接回答了:")
print(message.get('content'))如果它决定用工具,tool_calls 里面的内容大概长这样:
json
{
  "tool_calls": [
    {
      "id": "call_abc123",
      "type": "function",
      "function": {
        "name": "query_metrics",
        "arguments": "{\"metric_name\":\"CPU\",\"start_time\":\"2023-10-25 10:00:00\",\"end_time\":\"2023-10-25 10:04:00\"}"
      }
    }
  ]
}你看,它生成了我们要的参数!name 是工具名,arguments 是我们定义的那些参数的JSON字符串。它终于自己把查询条件给拼出来了。
4.3 第二回合:执行模型给出的参数,把结果塞回去
既然大模型发话了,我们就得照办。我们把 arguments 解析出来,去调我们写的那个 query_metrics 函数。
python
# 解析它要调哪个函数
tool_call = message['tool_calls'][0]
function_name = tool_call['function']['name']
arguments_str = tool_call['function']['arguments']
arguments_dict = json.loads(arguments_str)

print(f"它要调用的工具是:{function_name}")
print(f"它给的参数是:{arguments_dict}")

# 真正执行我们的查表函数
if function_name == "query_metrics":
    # 用 ** 把字典展开成关键字参数传进去
    tool_result = query_metrics(**arguments_dict)
    print(f"工具执行结果:\n{tool_result}\n")
else:
    tool_result = "未知的工具"
查到数据了,但这事没完。我们必须把查到的数据再拿去喂给大模型。否则它不知道结果,没法写总结报告。
这里有个极其繁琐但是必须遵守的规范:我们要把大模型刚才的回复、以及工具执行的结果,按照特定的格式拼成历史消息,再发一次请求。
python
# 1. 先把大模型刚才的回复(说要调工具的那条)加到历史里
messages.append(message)

# 2. 构造一个工具执行结果的消息,加到历史里
tool_message = {
    "role": "tool",
    "tool_call_id": tool_call['id'],  # 必须带上刚才的id,让大模型对上号
    "content": tool_result  # 把查出来的数据塞进去
}
messages.append(tool_message)你看,messages 列表现在有三条记录了。第一条是用户的提问,第二条是大模型说要调工具,第三条是我们告诉它工具的结果。
4.4 第三回合:模型根据查出来的数据给出最终的自然语言结论
我们带着这三条消息,再发一次请求。这次请求就不需要带 tools 说明书了,因为它已经不需要再做决策了,它只需要做总结。
python
payload_second = {
    "model": "timecho-model",
    "messages": messages  # 带着完整的历史对话
}

response_second = requests.post(url, headers=headers, json=payload_second, timeout=30)
final_result = response_second.json()

print("=== 最终的分析报告 ===")
print(final_result['choices'][0]['message']['content'])
这时候,大模型既看到了老板的问题"查一下CPU数据",又看到了工具查出来的真实数据。它就可以胸有成竹地给出一段漂亮的分析报告了。
五、 交互图
文字看着有点绕,我们画个图把这三步走理一理。
本地查表函数 时序大模型 TimechoAI网关 用户/代码 本地查表函数 时序大模型 TimechoAI网关 用户/代码 #mermaid-svg-41tY5TaVBCgg77y2{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-41tY5TaVBCgg77y2 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-41tY5TaVBCgg77y2 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-41tY5TaVBCgg77y2 .error-icon{fill:#552222;}#mermaid-svg-41tY5TaVBCgg77y2 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-41tY5TaVBCgg77y2 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-41tY5TaVBCgg77y2 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-41tY5TaVBCgg77y2 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-41tY5TaVBCgg77y2 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-41tY5TaVBCgg77y2 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-41tY5TaVBCgg77y2 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-41tY5TaVBCgg77y2 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-41tY5TaVBCgg77y2 .marker.cross{stroke:#333333;}#mermaid-svg-41tY5TaVBCgg77y2 svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-41tY5TaVBCgg77y2 p{margin:0;}#mermaid-svg-41tY5TaVBCgg77y2 .actor{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-41tY5TaVBCgg77y2 text.actor>tspan{fill:black;stroke:none;}#mermaid-svg-41tY5TaVBCgg77y2 .actor-line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-41tY5TaVBCgg77y2 .innerArc{stroke-width:1.5;stroke-dasharray:none;}#mermaid-svg-41tY5TaVBCgg77y2 .messageLine0{stroke-width:1.5;stroke-dasharray:none;stroke:#333;}#mermaid-svg-41tY5TaVBCgg77y2 .messageLine1{stroke-width:1.5;stroke-dasharray:2,2;stroke:#333;}#mermaid-svg-41tY5TaVBCgg77y2 #arrowhead path{fill:#333;stroke:#333;}#mermaid-svg-41tY5TaVBCgg77y2 .sequenceNumber{fill:white;}#mermaid-svg-41tY5TaVBCgg77y2 #sequencenumber{fill:#333;}#mermaid-svg-41tY5TaVBCgg77y2 #crosshead path{fill:#333;stroke:#333;}#mermaid-svg-41tY5TaVBCgg77y2 .messageText{fill:#333;stroke:none;}#mermaid-svg-41tY5TaVBCgg77y2 .labelBox{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-41tY5TaVBCgg77y2 .labelText,#mermaid-svg-41tY5TaVBCgg77y2 .labelText>tspan{fill:black;stroke:none;}#mermaid-svg-41tY5TaVBCgg77y2 .loopText,#mermaid-svg-41tY5TaVBCgg77y2 .loopText>tspan{fill:black;stroke:none;}#mermaid-svg-41tY5TaVBCgg77y2 .loopLine{stroke-width:2px;stroke-dasharray:2,2;stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-41tY5TaVBCgg77y2 .note{stroke:#aaaa33;fill:#fff5ad;}#mermaid-svg-41tY5TaVBCgg77y2 .noteText,#mermaid-svg-41tY5TaVBCgg77y2 .noteText>tspan{fill:black;stroke:none;}#mermaid-svg-41tY5TaVBCgg77y2 .activation0{fill:#f4f4f4;stroke:#666;}#mermaid-svg-41tY5TaVBCgg77y2 .activation1{fill:#f4f4f4;stroke:#666;}#mermaid-svg-41tY5TaVBCgg77y2 .activation2{fill:#f4f4f4;stroke:#666;}#mermaid-svg-41tY5TaVBCgg77y2 .actorPopupMenu{position:absolute;}#mermaid-svg-41tY5TaVBCgg77y2 .actorPopupMenuPanel{position:absolute;fill:#ECECFF;box-shadow:0px 8px 16px 0px rgba(0,0,0,0.2);filter:drop-shadow(3px 5px 2px rgb(0 0 0 / 0.4));}#mermaid-svg-41tY5TaVBCgg77y2 .actor-man line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-41tY5TaVBCgg77y2 .actor-man circle,#mermaid-svg-41tY5TaVBCgg77y2 line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;stroke-width:2px;}#mermaid-svg-41tY5TaVBCgg77y2 :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 1. 发请求(用户问题 + 工具说明书)转发请求2. 我要用query_metrics, 参数是...返回tool_calls指令3. 执行query_metrics(CPU, 10:00, 10:04)4. 返回真实数据文本5. 发请求(历史问题 + 工具结果)转发带数据的上下文6. 根据数据生成人话总结返回最终content
你看这个时序图,这就叫闭环。大模型不再是光说不练了。它通过生成参数,指挥了我们的代码干活。我们的代码干完活,把结果汇报给它。它再出面把事情圆完。
这就是现在大模型应用开发最主流的架构模式,叫做Agent架构的基础形态。只要理解了这个三步走,后面再复杂的什么多工具联动、自主规划,都是在这个基础上堆逻辑而已。
六、 必踩的坑:模型生成的参数格式不对怎么办
Function Calling 很强,但是它不完美。最让人头疼的一个坑就是:大模型有时候会犯迷糊,生成的参数格式不对。
6.1 幻觉:它给的时间格式不带引号或者拼错了
比如我们在说明书里写了,时间格式必须是 YYYY-MM-DD HH:MM:SS。
大多数情况下它会很听话地给 2023-10-25 10:00:00。但是偶尔,如果用户的提问很诡异,它可能给个 昨天下午 出来。
一旦它给了这种参数,我们的 query_metrics 函数去查数据库肯定查不到东西啊。SQL里的时间匹配就会失败。
怎么防呢?这就需要在我们的工具执行代码里加极强的容错逻辑。
python
try:
    arguments_dict = json.loads(arguments_str)
    # 可以在这里加正则校验,如果时间格式不对,直接打回重做
    # 这里为了简单,我们只做异常捕获
    tool_result = query_metrics(**arguments_dict)
except json.JSONDecodeError:
    tool_result = "参数JSON解析失败,请检查格式。"
except TypeError:
    tool_result = "缺少必要的参数,请提供完整的指标名和时间范围。"
except Exception as e:
    tool_result = f"工具执行出错: {e}"
我们把执行工具的代码用 try...except 严严实实地包起来。如果它给的参数不对,我们的函数不会崩,而是会返回一段报错文字。
这段报错文字,我们照样塞到 tool_message 里发回给大模型。大模型看到"参数解析失败",它就知道自己干坏事了。它会反思一下,换个格式再试一次。这就相当于它自己在做调试。
6.2 它瞎编了一个我们不支持的函数名
还有一种情况。如果你给它注册了两个工具,一个查CPU,一个查内存。结果它脑抽了,返回了一个 function_name: "query_disk"。
我们代码里根本没有这个函数。这时候如果直接调,肯定会报 AttributeError。
所以我们在调用的地方,一定要写 if...elif...else 把函数名过滤一遍。碰见不认识的,直接返回"系统不支持此工具"。
python
if function_name == "query_metrics":
    tool_result = query_metrics(**arguments_dict)
elif function_name == "another_tool":
    # tool_result = another_tool(**arguments_dict)
    pass
else:
    tool_result = f"错误:不支持名为 {function_name} 的工具。"
不要小看这些防御性代码。在真实的工作里,80%的时间都在写这种兜底逻辑。大模型是不稳定的,只有我们的代码够硬,才能把它的输出给兜住。
七、 去官方文档和示例验证可行性
7.1 看看文档里关于工具调用的说明
Function Calling 这个能力,对大模型本身的指令跟随能力要求极高。不是随便哪个模型都能玩转的。
所以你在开干之前,一定要去翻一翻官方的开发文档:https://ai.timecho.com/docs/
在文档里搜一下 tools 或者 function_call 相关的章节。看看TimechoAI的这套接口,是不是完全兼容OpenAI的那种格式。
如果是兼容的,那我们上面写的那些JSON结构就能直接跑。如果它有自己的私有规范,比如字段名不叫 tools 叫 plugins,那你得按它的来。不过现在业界的大趋势都是往OpenAI靠拢,通常来说大差不差。
7.2 去示例页面体验类似效果
你也可以去应用示例页面:https://ai.timecho.com/realtime 看看。
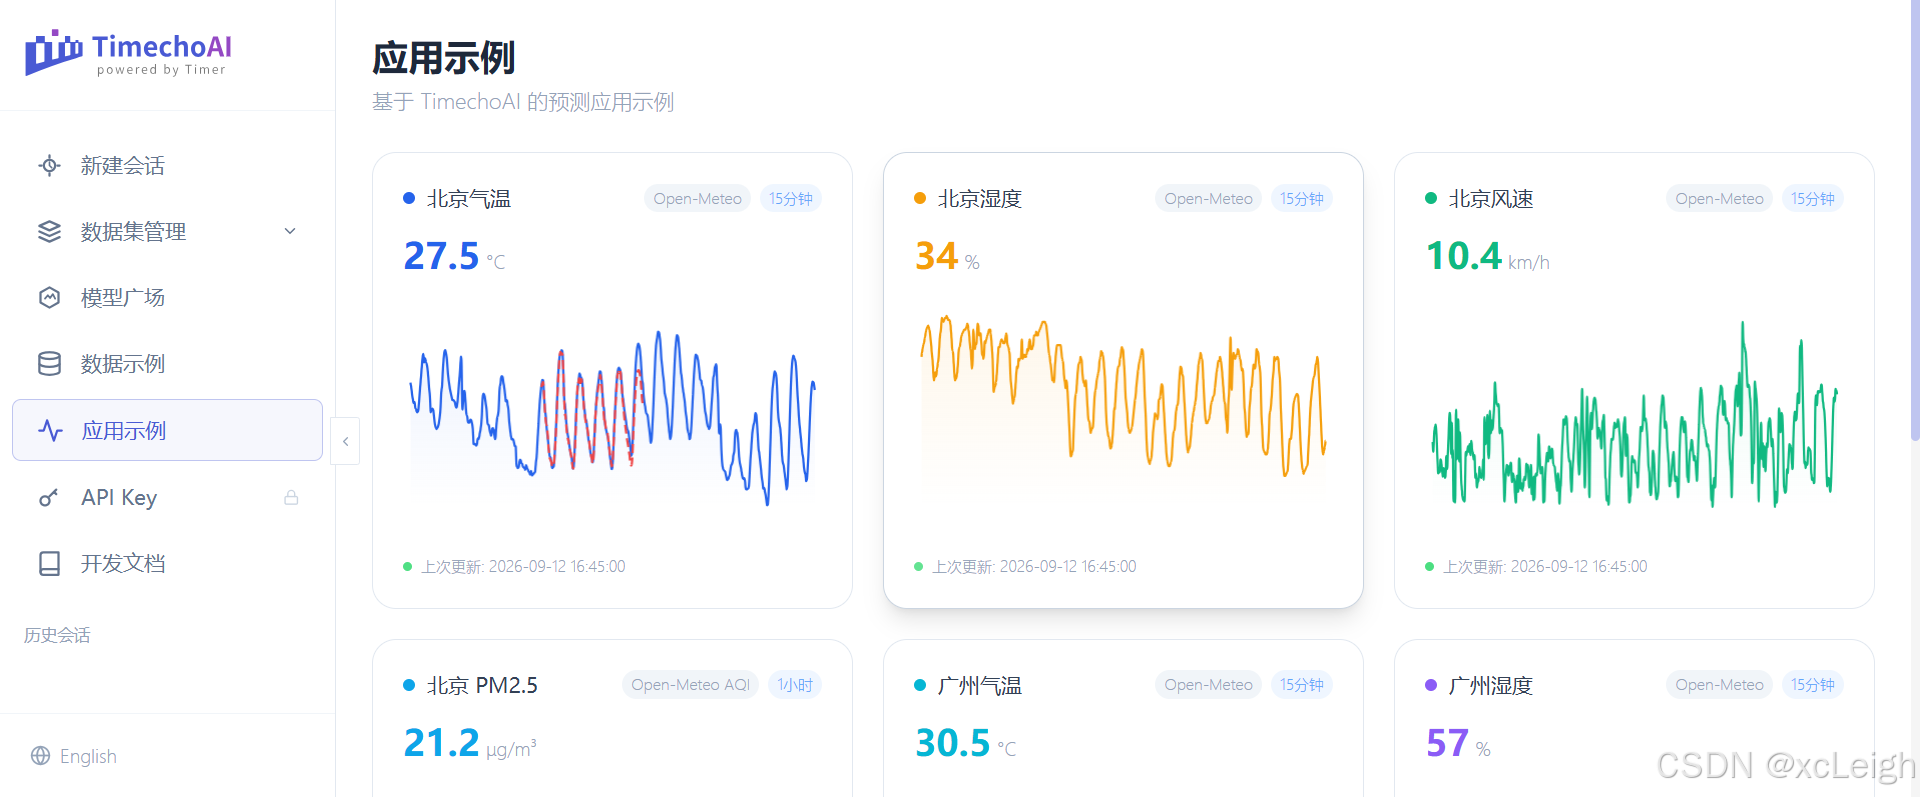
有些官方的示例页面,会把工具调用的过程在前端打印出来。比如它会显示"正在调用查询数据库工具...",然后过一会才出结果。
如果你在示例页面看到了这种标志,那就说明这套逻辑官方已经调通了,你放心用就行。你只要照着我们今天写的三步走逻辑,把代码串起来,绝对没问题。
八、 总结与下期预告
8.1 今天的逻辑有点绕,多跑几遍代码
今天这篇信息量非常大。我们从以前单纯的提示词工程,跨越到了Agent的领域。大模型从只会动嘴,变成了会动手指挥的工具调用者。
这个三步走的逻辑(发说明书 -> 拿参数执行 -> 发结果总结)确实有点绕。如果你看一遍没看懂,别灰心,这很正常。这是大模型应用开发里的一道坎。
最好的办法就是自己把代码敲出来,多打几个 print,看看每一步返回的JSON到底长什么样。你只要跑通了一次,看到大模型自己把参数填进去查数据库的那一瞬间,你绝对会感到非常震撼。那种感觉就像是你教出来的傻子突然开窍了一样。
8.2 下期我们讲讲:如果模型想一次查两个表怎么办
今天我们只让它查了一次数据库。但是有些复杂的问题,它可能需要查两次。
比如老板问:"对比一下昨天和前天的CPU峰值"。大模型可能需要先调一次工具查昨天的,再调一次工具查前天的。它可能会在 tool_calls 里一次性返回两个调用请求。
那我们的代码怎么处理并行调用呢?这又是一个大坑。如果搞不定,这套Agent就只能干点简单的活。
所以下一期,我们就来死磕多工具并行调用的问题。把这个解决了,我们的Agent基本就毕业了。我们下篇见。