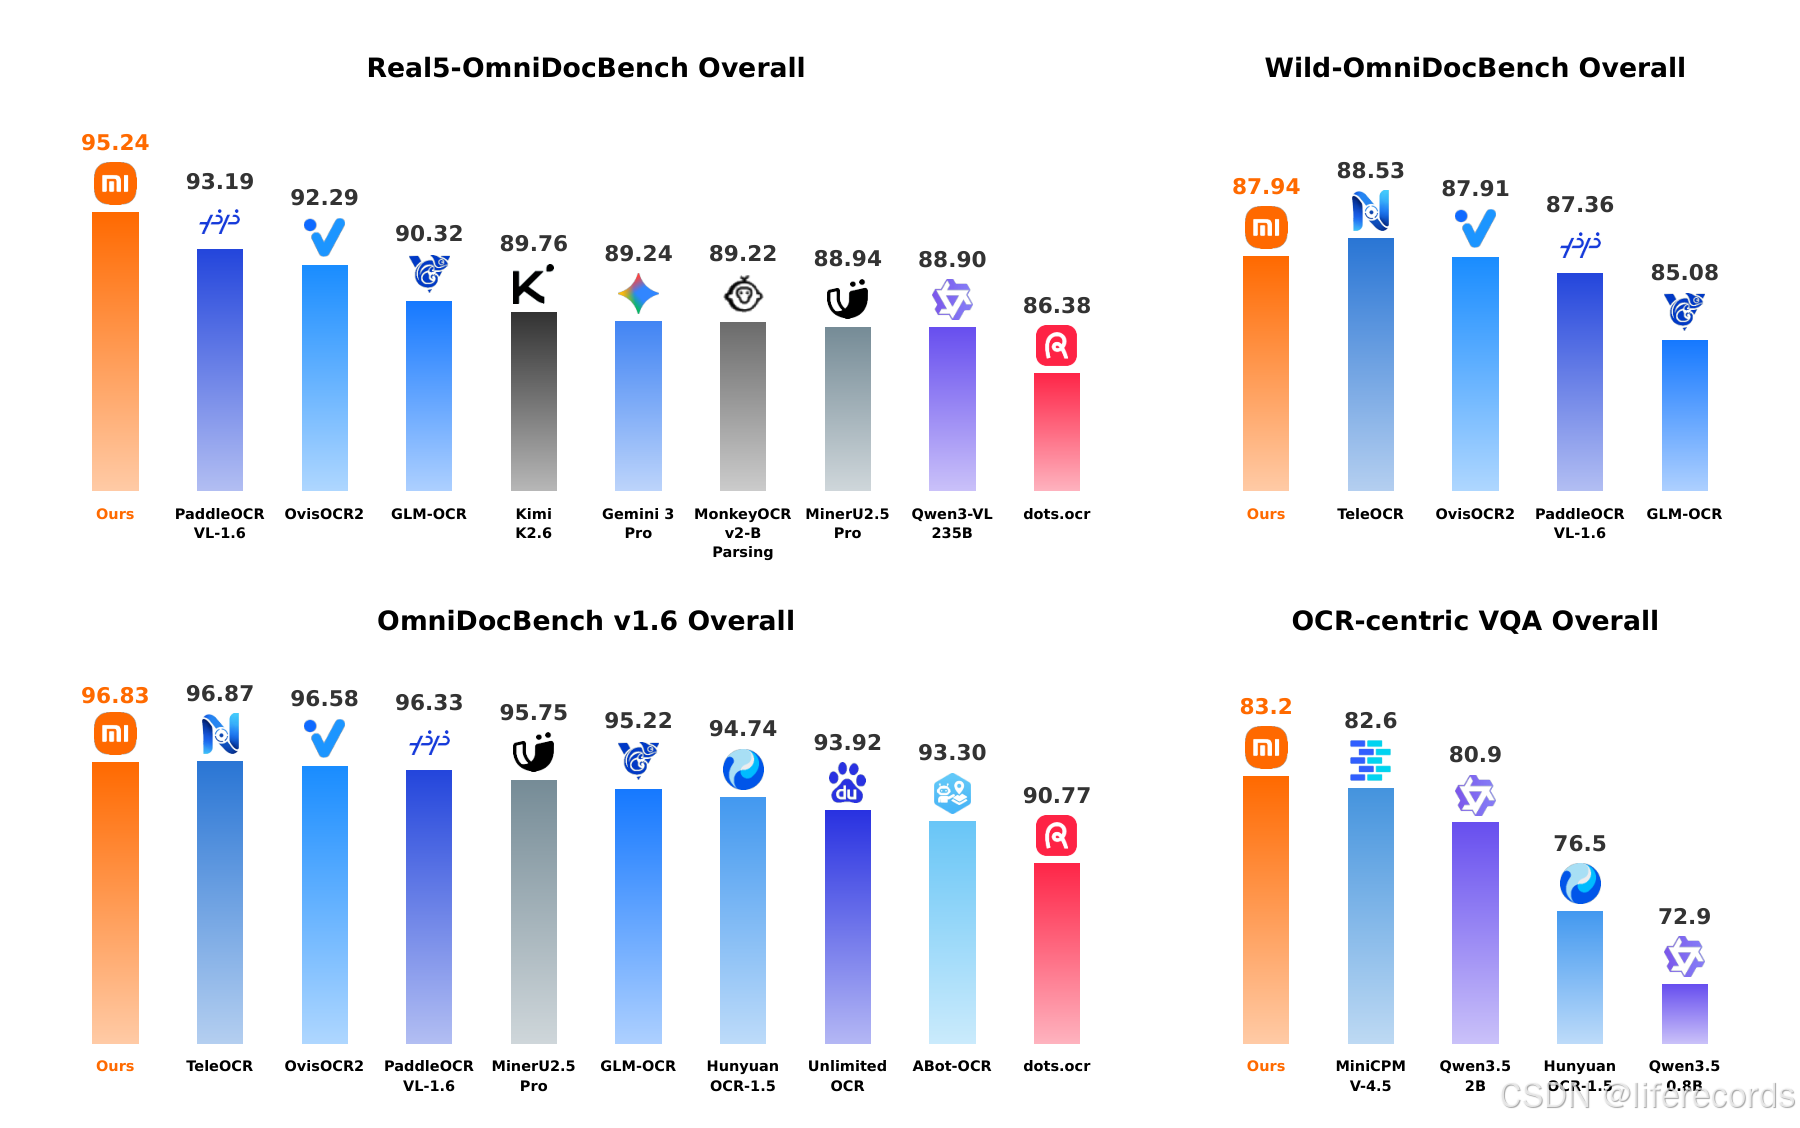
💡 一句话总结:小米的 Xiaomi-OCR-0 用一个 0.8B 的小模型同时做文档解析和 OCR 问答,在 OmniDocBench v1.6 拿到 96.83、OCR 问答五榜均值 83.2------它真正的护城河不是模型,而是一座 1.7 亿样本的自动化数据引擎:8 个专家模型投票定标签、把标注渲染回图像做视觉验货、再围着模型翻车的样子定向造数据。
导语:小模型的 OCR 之痛,痛在数据不在模型
做文档 AI 的朋友大概都有类似的体感:这两年 OCR 专用小模型卷得飞起,0.9B 的 PaddleOCR-VL、1.2B 的 TeleOCR、0.8B 的 OvisOCR2......参数一个比一个小,榜单一个比一个高。但真想把它们用到业务里,很快会撞上两堵墙。
第一堵墙:解析和问答是两种活。解析要求「一比一还原」------一页纸进,结构化 Markdown 出,一个字都不能丢;问答要求「按需取舍」------用户问发票号是几,你把整页背下来没用,得挑出那个字段。目标函数根本不一样,混在一起训很容易互相打架。
第二堵墙更致命:靠谱的监督太贵了。文本、表格、公式的标注各有各的验法,模型生成的伪标签错得悄无声息------一张表格的合并单元格标错了,肉眼扫一遍根本看不出来。
小米这篇技术报告给出的答案很「务实的暴力」:模型保持 0.8B 不动,把力气全花在数据上。想自己看原文?资源在这:
想自己动手试?
- 📄 论文:arXiv 2609.36136
- 🧩 模型主页:HuggingFace Space · Xiaomi-OCR-0
这篇论文到底想解决什么问题?
一句话版研究问题:一个 0.8B 的小模型,能不能同时把「整页还原」和「按题作答」都做到第一梯队?
先解释一下「OCR 中心理解」这个说法。论文里它涵盖两类任务:OCR-VQA(拿着文档图回答问题,比如 DocVQA、ChartQA 这些榜单)和 KIE(关键信息抽取,比如从证件照里抽字段出 JSON)。这两类任务和文档解析共享同一个底座需求------认字准、版面清------但输出形态完全不同。
作者先做了一个实验,结果有点反直觉:在解析能力还没练成的时候,过早混入理解类数据,解析成绩反而会掉。这就好比让一个刚学会抄菜谱的学徒同时练「看图报菜价」,两头都练不好。什么时候混才对?论文的答案是:等解析基础打牢之后,同样的理解数据就变成正增益了。这个「迁移反转」的发现,是全文最有意思的结论之一,后面细说。
先说数据,再说训练。
它的思路是什么?
Xiaomi-OCR-0 从 Qwen3.5-0.8B 出发,全套功夫分两块:一座数据引擎,一套三段式训练配方。
🏭 第一块:数据引擎------1.7 亿样本怎么保证不掺假
这是全文的精华。数据引擎三件套:自动标注、样本挖掘、定向合成。
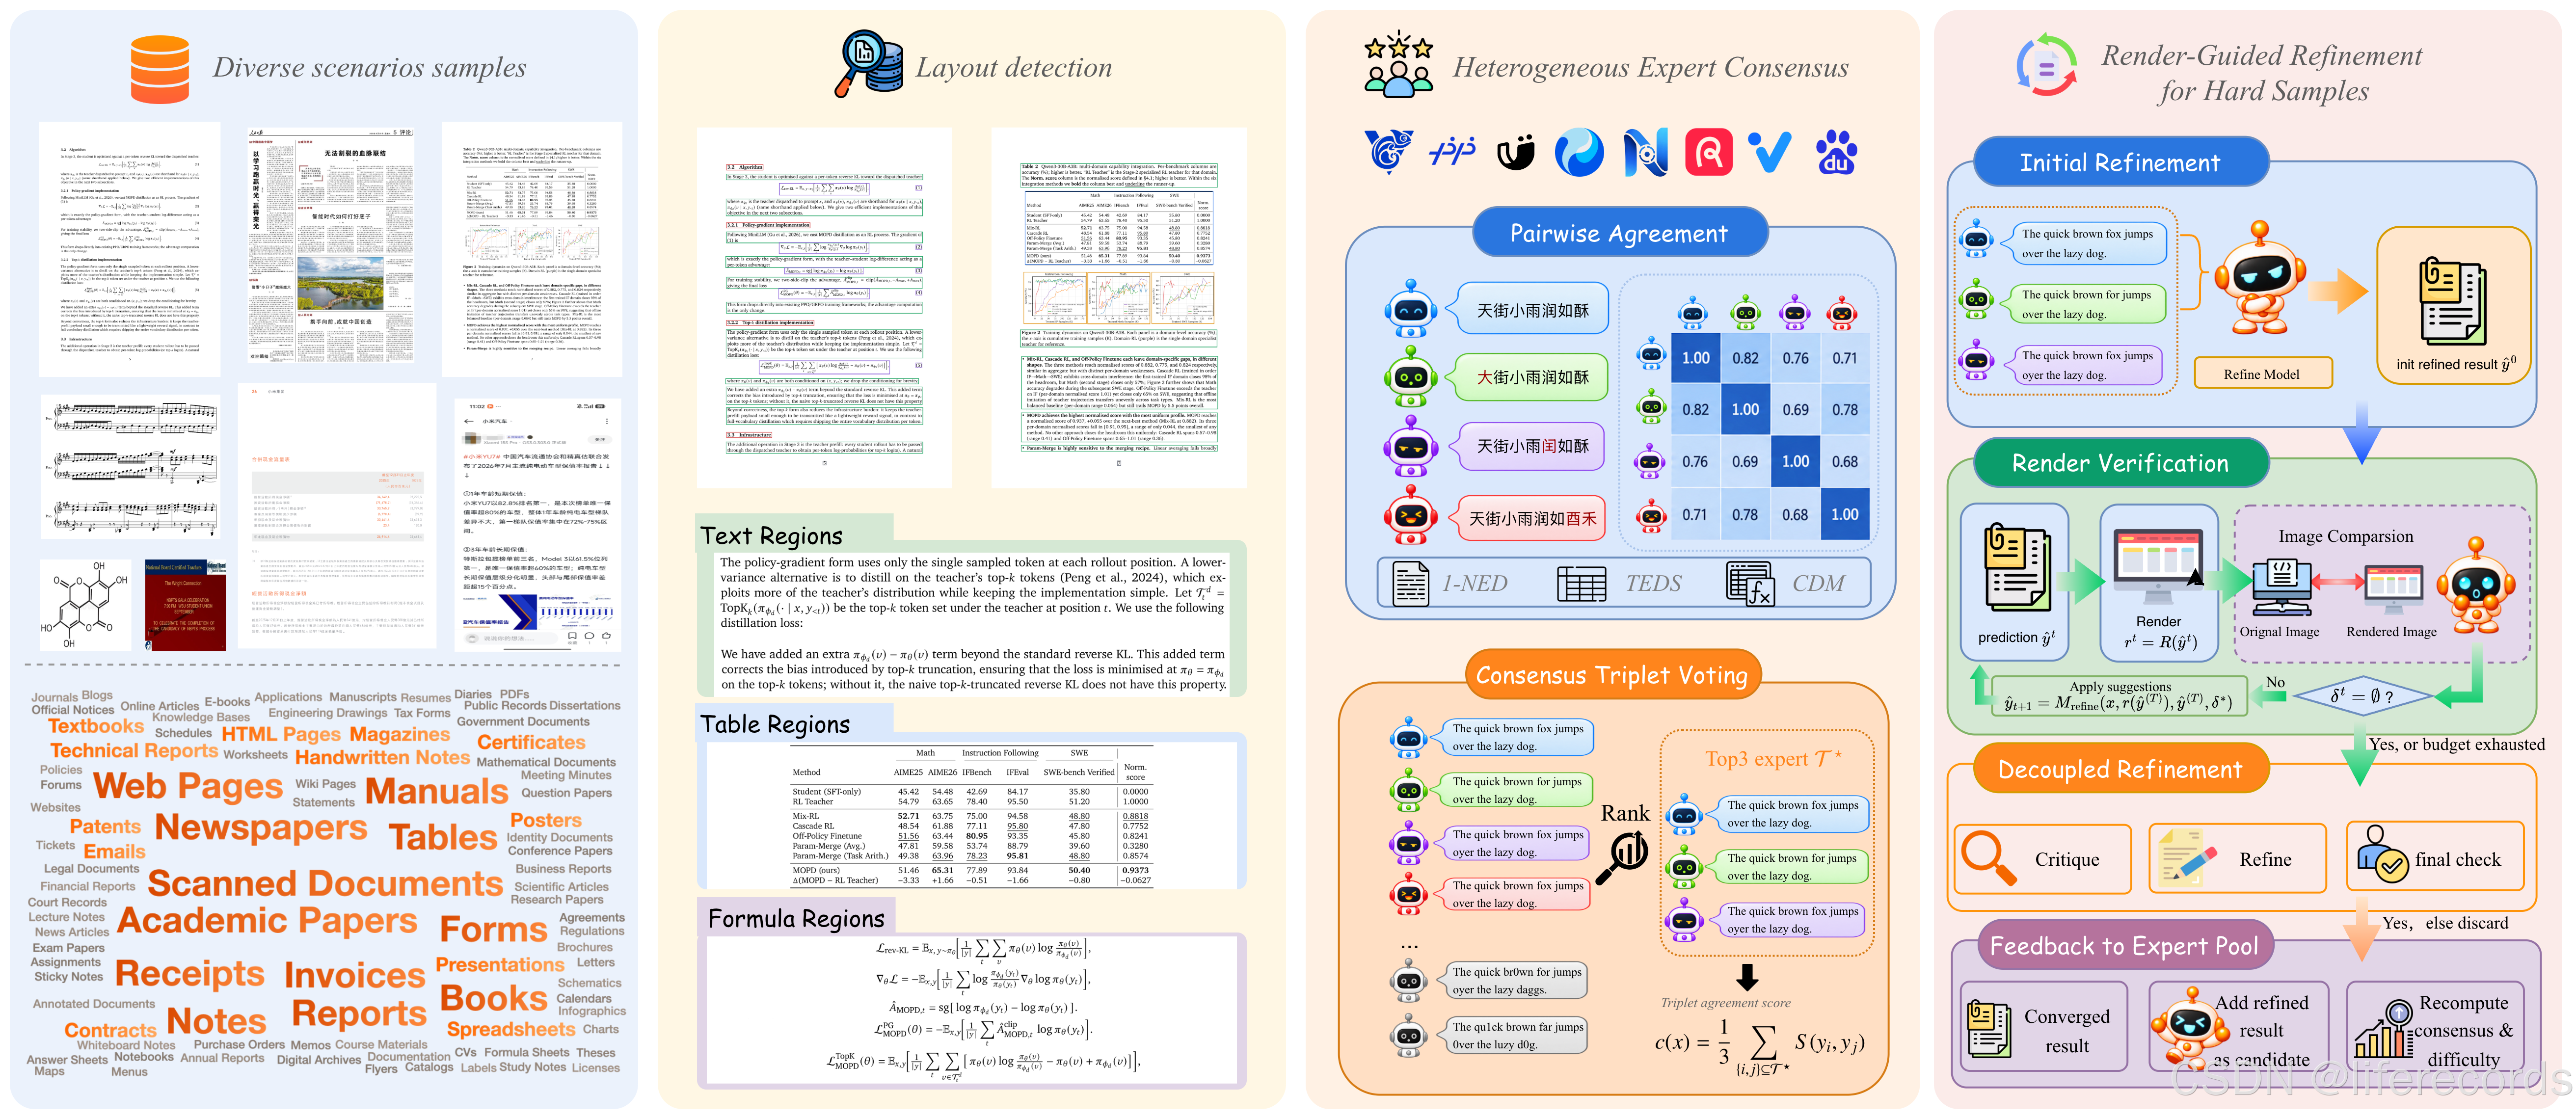
第一件:8 个专家投票定标签。 单个模型的伪标签不可信,那就上八个:PaddleOCR-VL-1.6、MinerU2.5-Pro、GLM-OCR、dots.ocr、HunyuanOCR-1.5、TeleOCR、OvisOCR2、Qianfan-OCR------清一色当下榜单上的狠角色。每个区域(一段文本、一张表、一个公式)让 8 个专家各自独立标注,然后算一致性:文本比编辑距离、表格比 TEDS(表格还原相似度,越接近 1 越好)、公式比 CDM(字符检测匹配率)。
一致性高的(≥0.9)直接收录;低的进下一关。这里有个细节值得学:作者选的是「池内平均一致性最高的 3 个专家」组成评审组,取评审组里「和另外两人最像的那个」的输出当伪标签------而不是简单投票。用他们的话说,共识分衡量的是「专家们吵不吵架」,不是「标签正确的概率」,所以宁可保守。
第二件:渲染回图像验货。 这是我觉得最聪明的一招。当专家们吵起来了怎么办?光比较输出的字符串,看不出表格拓扑对不对、公式结构错没错。小米的做法是:把候选标注重新渲染成图片(文本和表格渲染成 HTML,公式渲染成 LaTeX),再让一个池外的裁判模型(Qwen3.5-122B)把渲染图和原图放在一起看------哪里对不上,一眼便知。提修改建议、应用修正、再渲染、再看,最多三轮;还不收敛就带上完整的历史诊断记录再来一遍「批评-修正-验证」。修完还得重新过一遍 8 专家共识,达标才收。
打个比方:这就像验钞不能只看编号,得对着光看水印------把「文本答案」还原成「视觉样子」再验,结构性的假货就藏不住了。
第三件:围着失败案例定向造数据。 数据引擎还带着一个挖掘器:给每个样本算三个信号------专家一致性、模型自一致性(同一个模型多推理几次,答案稳不稳)、语义聚类归属。「专家都认同、但模型自己答得不稳」的样本就是硬骨头,把它们诊断归类出失败模式后,合成管线就对着这些模式定向生成变体:保留难点(合并单元格、嵌套公式、复杂版式),变换其他一切。另一路「覆盖驱动」合成则专门补稀有素材------书法、生僻字体、低资源字符组合。每批合成数据都要过「排除验证源组的小规模训练 + 冻结验证集回归测试」这一关,确认有效才进正餐。
🛠️ 第二块:三段式渐进训练
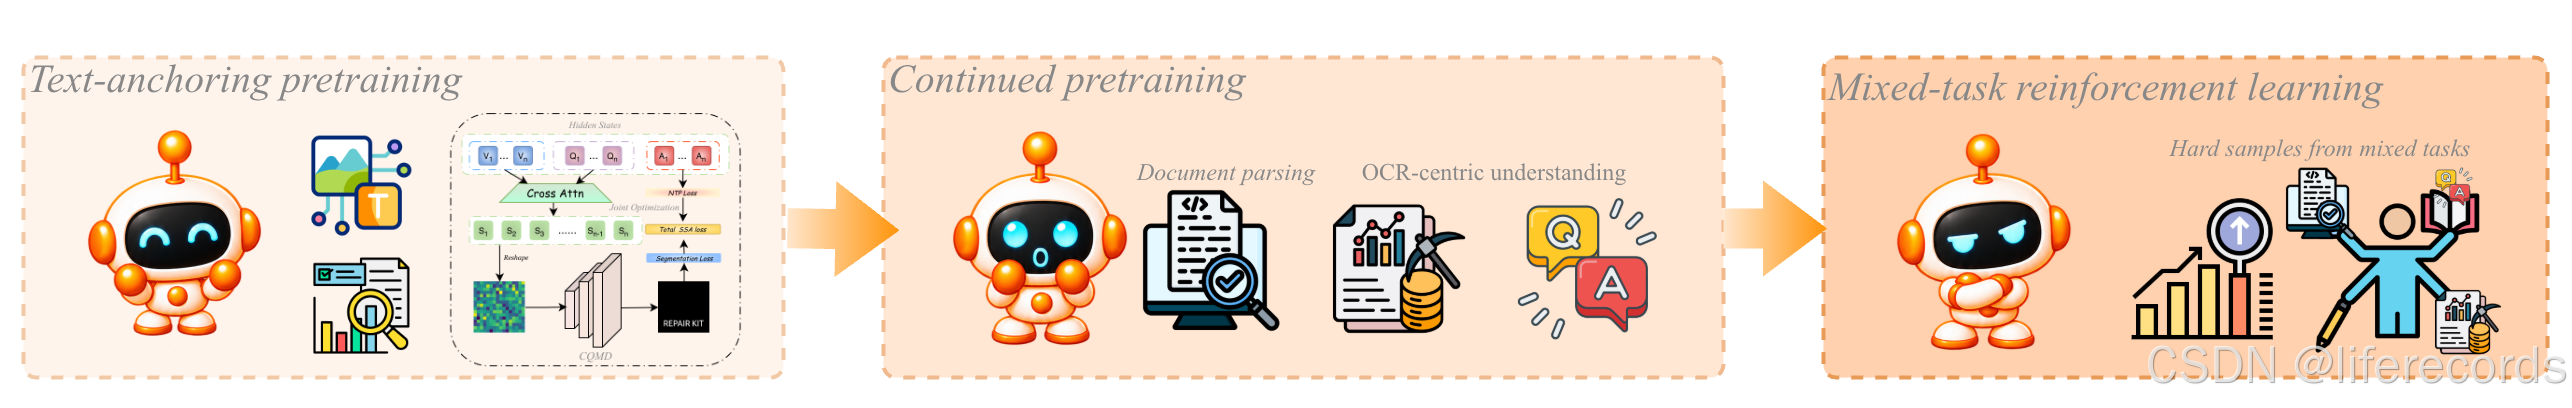
数据有了,训练分三步走:
- 第一步:Q-Mask 文本锚定。 沿用 Q-Mask 框架,让模型在预测文字的同时预测文字的空间掩码------把「字」和「它在哪」绑死。这一步给后面所有任务打底:消融显示它带来 +0.30 的 Overall,公式识别提升最明显(+0.49)。
- 第二步:多任务继续预训练(CPT)。 用 1.7 亿语料把 region 级识别(裁剪区域进、文字出)和整页解析(整页图进、Markdown 出)等多种任务统一进自回归格式。注意整页样本在这里就混进来了------它们是解析基础的「地基增强」。
- 第三步:Mix-RL。 监督训练只会逐 token 模仿,惩罚不了「结构错了、字段漏了、阅读顺序乱了」这种文档级问题。所以在挖掘出的硬样本上跑强化学习:DAPO 风格的 GRPO(一种按组内相对优势更新策略的 RL 算法),奖励按任务路由------表格看 TEDS、公式看 CDM、整页用 MGAM 对齐后按各模态占比加权、KIE 先验 JSON 合法性再算字段匹配、问答用 ANLS。格式不对直接零分,没有商量。
三步的分工很清晰:Q-Mask 练「认得准」,CPT 练「见得多」,Mix-RL 练「错不起」。
效果到底怎么样?
先看解析主榜(配外挂版面检测 PP-DocLayoutV3 做两阶段推理,0.8B 参数不含检测器):
- OmniDocBench v1.6:96.83------与 1.2B 的 TeleOCR(96.87)几乎持平,压过同尺寸的 OvisOCR2(96.58);公式 CDM 98.50 是全场最高,PubTabNet 表格 TEDS 92.27 也是表内第一。
- Real5-OmniDocBench(五种采集条件:扫描、弯曲、屏摄、光照不均、倾斜):95.24,五个子项全部第一,对 PaddleOCR-VL-1.6 领先 2.05 分,弯曲页面拉开到 2.98。
- Wild-OmniDocBench(真实场景翻拍):87.94,略低于 TeleOCR 的 88.53,但阅读顺序编辑距离 0.1931 是全场最低。
再看理解侧,这才是「统一」二字的价值所在:
- OCR-VQA 五榜均值 83.2 (DocVQA 93.1 / InfoVQA 75.1 / ChartQA 84.6 / OCRBench 84.6 / TextVQA 78.6)------比底座 Qwen3.5-0.8B 高出 10.3 分,比 1B 的 HunyuanOCR-1.5 高 6.7 分,超过自家 2B 的 Qwen3.5-2B,距 4B 的 Qwen3.5-4B 只差 1.7 分。0.8B 打 2B,这就是数据引擎的购买力。
- KIE 内部基准 59.09%:机票信息抽取 73.00%(Qwen3.5-2B 只有 43.00%),证件卡类普遍 78% 上下;但发票类 65.00% 输给 2B 的 77.00%,地址类双双不到 46%。
三个比榜单更值钱的发现
🔄 发现一:理解数据的增益会「反转」
论文拿不同训练阶段做了消融:解析数据只喂 9% 时,混入理解数据 Overall 掉 0.33;喂到 29%(且掺入整页样本)后再混,反过来涨 0.64;50% 时依然为正。同一份理解数据,从毒药变成了补品------分界线就是解析基础的成熟度。给做训练配方的人的直接启示:小模型先死磕解析,别急着上多任务。
📏 发现二:理解比解析更吃参数
用同样的任务数据分别训 4B 专职教师和 0.8B 学生:解析上教师只领先 0.15 分(96.97 vs 96.83),理解上却领先 4.9 分(88.1 vs 83.2)。也就是说,解析这件事 0.8B 差不多到顶了,但理解能力还想往上走就得堆参数------这解释了为什么各家 1B 以下的 OCR 模型榜单都集中在解析,问答榜还是大模型的天下。
⚖️ 发现三:蒸馏和 RL 各有各的好
作者还对比了多教师 on-policy 蒸馏(MOPD)和 Mix-RL:MOPD 算力省、解析收敛快,较早的算力预算就到 96.74;Mix-RL 训得更久,但双能力峰值都更高(96.83 / 83.2)。一句话:赶工期用蒸馏,追上限用 RL。
能拿来做什么?
几个马上能落地的场景:
- 企业文档入库管线:扫描件、手机翻拍、屏摄混合的真实语料正是 Real5/Wild 榜单测的东西,0.8B 的尺寸意味着单卡甚至边缘设备都能跑解析。
- 证件 / 票据结构化:KIE 成绩显示证件卡类字段抽取已经能打,机票行程、银行卡这类强 schema 场景收益最明显。
- 数据工程方法论移植:就算你不用这个模型,「专家共识打分 + 渲染回图像验货 + 失败驱动合成」这套伪标签生产线,可以原样搬去任何带结构输出的标注任务------表格抽取、UI 理解、代码转录都适用。
泼冷水时间
说完好的,几盆冷水也得端上来:
- 「统一」的成色要看推理配置。主榜成绩是「外挂 PP-DocLayoutV3 检测版面 + 0.8B 逐区域识别」的两阶段结果,0.8B 参数不含检测器。虽然训练里有整页端到端解析,但榜单没把它作为主配置------「一个模型包打天下」和「一套系统包打天下」是两回事。
- KIE 基准是 in-house 的。1655 张内部图片,外部无法复现;发票类还输给底座 2B 模型,地址类不到 46%------结构化抽取远没到「毕业」的程度。
- 共识 ≠ 正确。8 个专家如果共享了相近的训练数据谱系,一致性会系统性高估标签质量;论文自己也承认共识分不是校准过的正确率。
- 算力账单没公开。1.7 亿样本的八专家推理、逐轮渲染校验、合成管线的成本一个字没提。「省人工」是真的,「省算力」未必------对小团队来说,这套引擎的复刻门槛其实不低。
- 文本编辑距离与阅读顺序两项,OvisOCR2 反而更优;「全面第一」的印象要打点折扣。
理性看待
Xiaomi-OCR-0 的价值不在「又一个小 OCR 模型刷新榜单」------96.83 对 96.87 的差距约等于没有。它真正值得记下的是两件事:一是用实验把「先解析、后理解」的课程顺序钉实了,给所有做小型多能力模型的人省了试错成本;二是把「渲染回图像做视觉验货」这个思路做成了可规模化的产线,让 1.7 亿样本的伪标签敢拿来训练。
往远看,理解侧 4.9 分的容量鸿沟还立在那儿------0.8B 的解析接近封顶,但问答和抽取的天花板仍要靠数据质量和训练策略一点点去够。这批工作的下一个分水岭,大概率还是数据:谁的引擎能更便宜地产出「验过货」的监督,谁的小模型就更能打。
(数据与结论均来自论文原文及附录,解读部分为作者观点,欢迎交流。)