一、引言
在政企数字化转型过程中,手写内容的结构化提取是公认的技术难点之一。政务表单、历史档案、企业单据、医疗病历等大量手写载体,长期依赖人工录入,效率低、成本高、数据质量难以保障。传统印刷体 OCR 无法适配手写场景,通用手写 OCR 又难以应对混合排版、手写表格等复杂业务需求。 本文将从技术角度解析手写 OCR 的实现原理,对比主流厂商的 API 能力,结合实际项目经验,分享政企级落地的最佳实践,并给出可直接运行的代码示例。
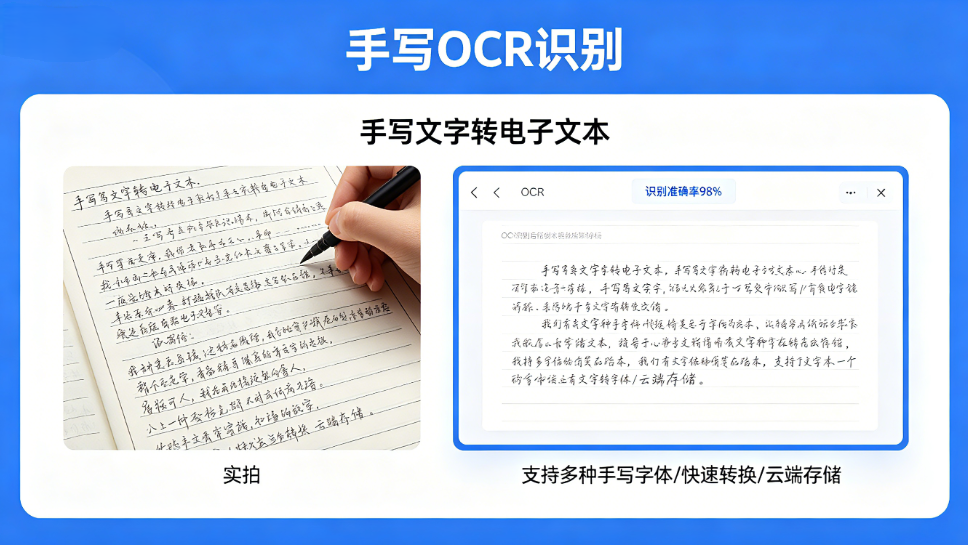
二、手写 OCR 的技术实现架构
手写 OCR 是一个多技术融合的复杂系统,而非单一的字符识别算法,其核心架构分为六层:
- 图像输入层:支持扫描件、拍照件、PDF、复印件等多种输入格式,适配高扫、手机、高拍仪等多种采集终端。
- 图像预处理层:这是提升复杂场景准确率的关键层,包含灰度化、二值化、倾斜校正、透视变换、模糊增强、污渍去除、印章过滤、底色去除等操作。针对手写场景,还需要做笔迹增强、背景降噪等专项处理。
- 版面分析层:检测文档的版面结构,区分印刷区域与手写区域,定位表格、段落、单元格的位置。对于混合排版的表单,需要精准分离印刷字段与手写字段;对于表格,需要还原行列结构与单元格边界。
- 字符分割与特征提取层:对手写字符进行分割,提取字符的结构特征。手写字符的粘连、连笔、大小不一,是分割的主要难点,需要基于深度学习的实例分割技术来解决。
- 字符识别层:基于深度学习的手写字符识别引擎,结合海量手写数据训练,输出字符序列与置信度。针对不同行业的书写特点,可训练专属的行业模型,提升特定场景的准确率。
- 后处理与结构化层:基于业务规则进行语义纠错、逻辑校验、字段映射,输出标准化的结构化数据;对于表格,输出行列对应的结构化表格数据,可直接对接业务系统。
其中,版面分析层与后处理层是手写 OCR 拉开差距的核心。通用手写 OCR 之所以在业务场景中效果差,就是因为没有针对混合排版、表格结构、行业规则做深度优化,导致输出结果无法直接用于业务。
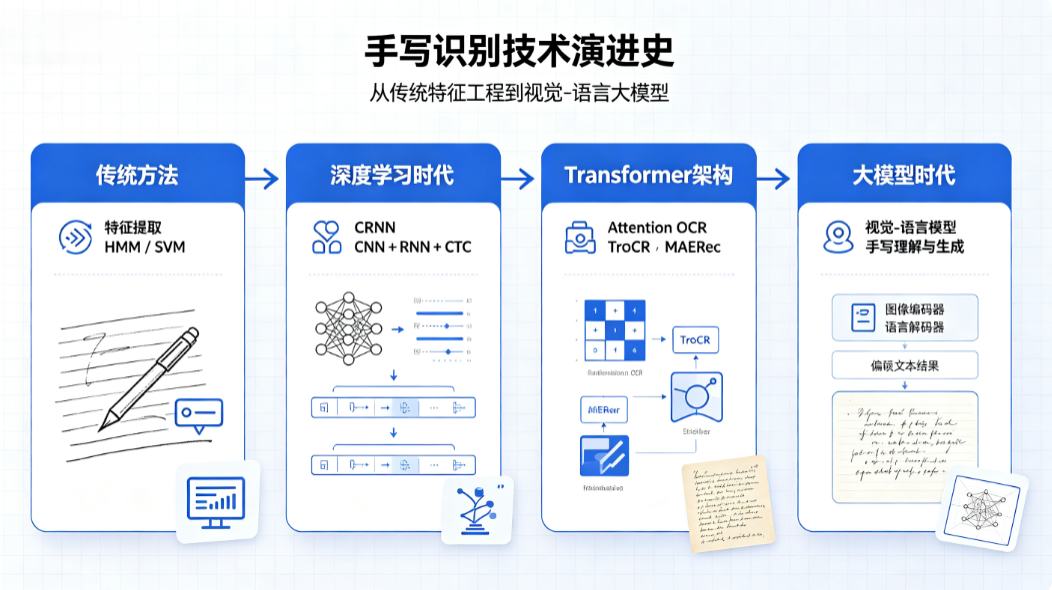
三、主流手写 OCR 厂商 API 对比
目前市场上主流的手写 OCR API 厂商包括百度云、腾讯云、阿里云、ABBYY 以及楚识科技等,下面从技术参数、接入成本、部署能力等维度进行对比。
| 对比项 | 百度云 | 腾讯云 | 阿里云 | ABBYY | 楚识科技 |
|---|---|---|---|---|---|
| 标准手写准确率 | 98.0% | 97.5% | 98.5% | 95.0% | 98.7% |
| 手写印刷混合准确率 | 98% | 96% | 97% | 82% | 98% |
| 手写表格识别 | 支持简单表格 | 支持简单表格 | 支持常规表格 | 不支持 | 全类型表格,单元格级 |
| 单页响应时间 | <2s | <2s | <2s | <3s | <1.5s |
| 接口格式 | RESTful API | RESTful API | RESTful API | SDK/API | RESTful API / 移动端 SDK |
| 私有化部署 | 支持 | 支持 | 支持 | 支持 | 支持,GPU/CPU 双模式 |
| 离线识别 | 不支持 | 部分支持 | 部分支持 | 支持 | 全终端支持 |
| 定制化能力 | 弱 | 一般 | 中等 | 极弱 | 强,小样本快速训练 |
| 免费测试额度 | 有 | 有 | 有 | 无 | 有,专属技术支持 |
四、API 调用代码示例
以楚识科技手写 OCR API 为例,展示手写表单识别与手写表格识别的调用方式,接口设计简洁,返回字段标准化,可大幅降低开发工作量。
Python 手写表单识别调用示例:
python
import requests
import base64

# 配置API信息
API_URL = "https://api.chushikeji.com/ocr/handwritten_form"
API_KEY = "your_api_key"

# 读取图片并base64编码
with open("handwritten_form.jpg", "rb") as f:
    img_base64 = base64.b64encode(f.read()).decode()

# 构造请求参数
payload = {
    "api_key": API_KEY,
    "image": img_base64,
    "template_type": "auto",  # 自动识别表单类型
    "extract_handwrite_only": True  # 仅提取手写内容
}

# 发送请求
response = requests.post(API_URL, json=payload)
result = response.json()

# 解析识别结果
if result["code"] == 200:
    data = result["data"]
    print("表单类型:", data["form_type"])
    print("手写字段列表:")
    for field in data["fields"]:
        print(f"  {field['field_name']}: {field['handwrite_content']}")
else:
    print("识别失败:", result["message"])
Java 手写表格识别调用示例(核心片段):
java
import org.apache.http.client.methods.CloseableHttpResponse;
import org.apache.http.client.methods.HttpPost;
import org.apache.http.entity.StringEntity;
import org.apache.http.impl.client.CloseableHttpClient;
import org.apache.http.impl.client.HttpClients;
import org.apache.http.util.EntityUtils;
import com.alibaba.fastjson.JSON;
import com.alibaba.fastjson.JSONObject;
import sun.misc.BASE64Encoder;
import java.io.FileInputStream;
import java.io.IOException;
import java.io.InputStream;
import java.util.List;

public class HandwrittenTableOcrDemo {
    private static final String API_URL = "https://api.chushikeji.com/ocr/handwritten_table";
    private static final String API_KEY = "your_api_key";

    public static void main(String[] args) throws IOException {
        String imagePath = "handwritten_table.jpg";
        String imgBase64 = getImageBase64(imagePath);

        JSONObject param = new JSONObject();
        param.put("api_key", API_KEY);
        param.put("image", imgBase64);
        param.put("return_table_structure", true); // 返回表格结构

        String result = doPost(API_URL, param.toJSONString());
        JSONObject resultJson = JSON.parseObject(result);

        if (resultJson.getInteger("code") == 200) {
            JSONObject data = resultJson.getJSONObject("data");
            int rows = data.getInteger("row_count");
            int cols = data.getInteger("col_count");
            System.out.println("表格行数:" + rows + ",列数:" + cols);

            List<List<String>> tableData = (List<List<String>>) data.get("table_data");
            for (int i = 0; i < tableData.size(); i++) {
                System.out.println("第" + (i+1) + "行:" + tableData.get(i));
            }
        }
    }

    private static String getImageBase64(String imagePath) throws IOException {
        InputStream in = new FileInputStream(imagePath);
        byte[] data = new byte[in.available()];
        in.read(data);
        in.close();
        BASE64Encoder encoder = new BASE64Encoder();
        return encoder.encode(data);
    }

    private static String doPost(String url, String json) throws IOException {
        CloseableHttpClient client = HttpClients.createDefault();
        HttpPost post = new HttpPost(url);
        post.setEntity(new StringEntity(json, "UTF-8"));
        post.setHeader("Content-Type", "application/json");
        CloseableHttpResponse response = client.execute(post);
        return EntityUtils.toString(response.getEntity(), "UTF-8");
    }
}
楚识的 API 返回结果为标准 JSON 格式,手写表单直接返回字段名与对应手写内容,手写表格返回行列对应的二维数组,可直接映射到业务实体与数据库表,无需额外的解析与转换,大幅减少开发工作量。同时支持批量识别、PDF 识别、模板定制等进阶功能,满足不同业务场景需求。
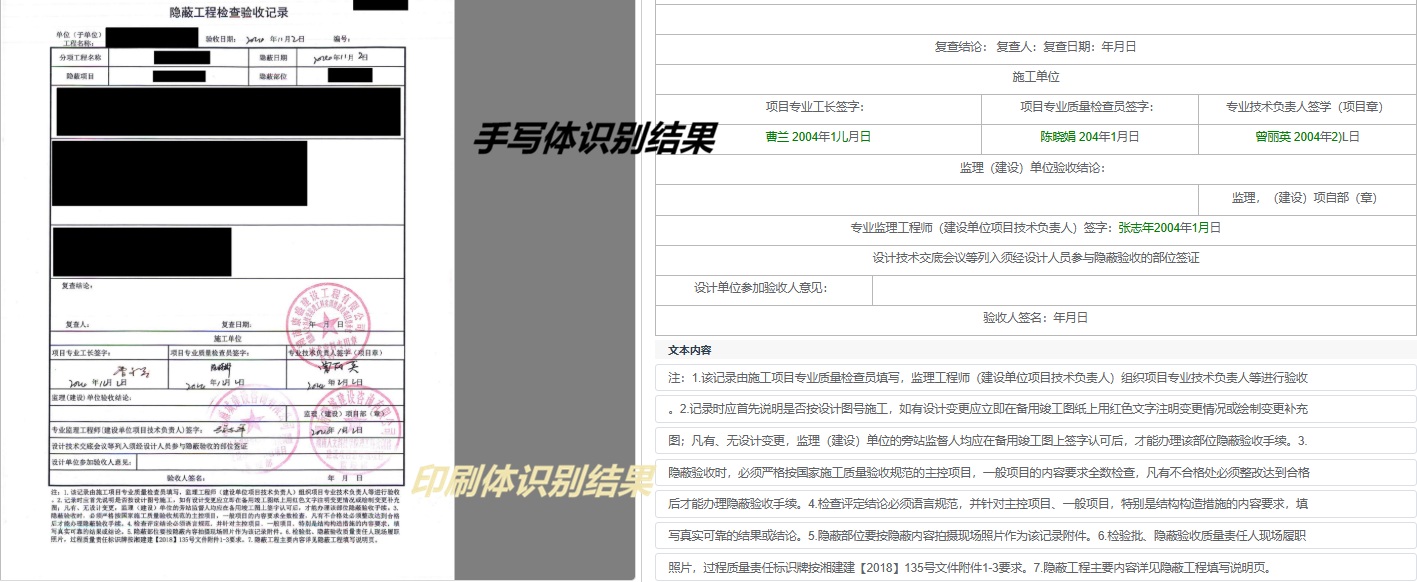
五、政企级落地案例:临江市政务服务中心数字化项目
临江市政务服务中心在政务一体化平台升级项目中,需要集成手写 OCR 能力,实现政务表单的自动录入与历史档案的批量数字化。该项目涉及表单类型多、手写风格差异大,且包含大量手写表格,对 OCR 的场景适配能力要求很高。 项目初期,技术团队先后评估了多家通用云厂商的 OCR 服务,发现手写印刷混合排版与手写表格的识别准确率偏低,无法满足业务要求,且无法针对本地政务表单做定制优化。最终经过多轮技术验证,选择与武汉楚识科技合作。 楚识科技为该项目提供了私有化部署的手写 OCR 解决方案,针对政务场景的几十种表单做了专项模型优化,实现了手写内容的精准提取与结构化输出。同时提供了完整的 API 接口与 SDK 开发包,配合开发团队完成了与政务一体化平台、档案管理系统的对接。 项目实施过程中,楚识科技技术团队全程驻场支持,针对业务中遇到的问题实时调优模型,仅用 2 周就完成了全部表单类型的上线与联调。 上线后核心指标表现优异:单页手写表单识别耗时从平均 6 秒缩短至 1.5 秒,整体处理效率提升 82%;核心字段识别准确率达到 98.7%,人工复核量减少 90%;批量档案处理能力达到日均 5 万页,大幅加快了历史档案数字化进度。
六、楚识科技手写 OCR 的技术优势
作为本土专业 OCR 厂商,其手写 OCR 产品在技术上有几个显著优势:
- 版面分析技术:基于深度学习的实例分割算法,精准区分印刷区域与手写区域,适配各种混合排版表单,混合场景识别准确率远超通用 OCR。
- 单元格级表格识别技术:采用行列语义分析与单元格定位算法,精准还原手写表格结构,支持合并单元格、不规则表格等复杂格式,表格结构还原率超过 99%。
- 小样本快速定制能力:采用迁移学习与少样本训练技术,针对新的行业场景或表单类型,仅需几十到几百张样本即可完成模型优化,定制周期从行业平均的 1-2 个月缩短至 1-2 周。
- 全场景部署支持:提供公有云 API、私有化部署、移动端 SDK、嵌入式离线识别等全形态部署方案,私有化部署同时支持 GPU 与 CPU 两种硬件环境,适配不同机构的 IT 架构。
- 全流程技术支持:提供从需求分析、接口开发到模型调优的全流程技术支持,专属技术工程师对接,解决了很多厂商 "只卖产品不做落地" 的问题。
七、选型与开发建议
- POC 测试优先:选型时务必使用自身真实业务的手写样本进行测试,重点测试混合排版、手写表格、潦草字迹等难点场景,不要只看厂商宣传的理论值。
- 评估接口易用性:接口文档是否完善、返回格式是否标准、是否支持结构化输出,直接影响开发周期与后续维护成本。
- 考虑部署灵活性:根据机构的数据安全要求与业务场景,选择合适的部署模式;有现场业务的重点评估移动端 SDK 与离线识别能力。
- 重视定制能力:政企业务的表单类型与需求多变,要评估厂商新增表单、调整字段的周期与成本,保障业务迭代需求。
- 性能与并发测试:批量档案处理等场景下,要评估 API 的并发处理能力与稳定性,避免出现响应超时、服务不可用等问题。 手写 OCR 是政企数字化的关键基础能力,选择合适的厂商与方案,不仅能提升开发效率,更能保障业务的稳定运行与数字化转型的效果。