大家好,我是数据库小学妹👋 我踩过的坑,你别再踩。
工业物联网时序数据,是设备按时间持续上报的运行指标,写多读少、按时间聚合、设备基数高、过期可淘汰,承接它的就是时序数据库。
前阵子帮一个做工业设备监控的团队看架构:厂里几千台设备,每秒往库里灌温度、振动、电流,一开始全写进了 MySQL。头两个月没事,到第三个月查询开始卡,一个温度趋势要等好几秒,写入延迟从几毫秒涨到几百毫秒。数据一天涨十几 GB,磁盘眼看要满。他们问我的就一句话:工业物联网场景下,时序数据库到底该怎么选?这篇不堆指标,按"存得下、查得快、算得准"三个环节,把选型逻辑拆一遍。
先搞清楚:工业物联网的时序数据,难在哪
时序数据和订单这类业务数据是两种完全不同的负载,硬塞进一套系统迟早要出事。设备数据带来三大挑战:存不下、查不快、算不准。
存不下,是存储成本。一台设备每秒几条,几千台就是每秒上万条。按行存储,几十亿条记录很快把空间吃满。工业数据又高度重复,温度在23到25度之间波动,却按原样存了一遍又一遍。
查不快,是查询模式。工业现场的查询,几乎都是"某条产线过去三小时的平均温度""某台设备昨天的振动峰值"。这类时间窗口聚合,用B+树索引去扫,效率很低,数据过亿后延迟明显上升。
算不准,是实时计算。故障预警要秒级响应,预测性维护要从历史里挖规律。这些计算放到库外做,数据得先搬出去,链路一长,实时性就没了。
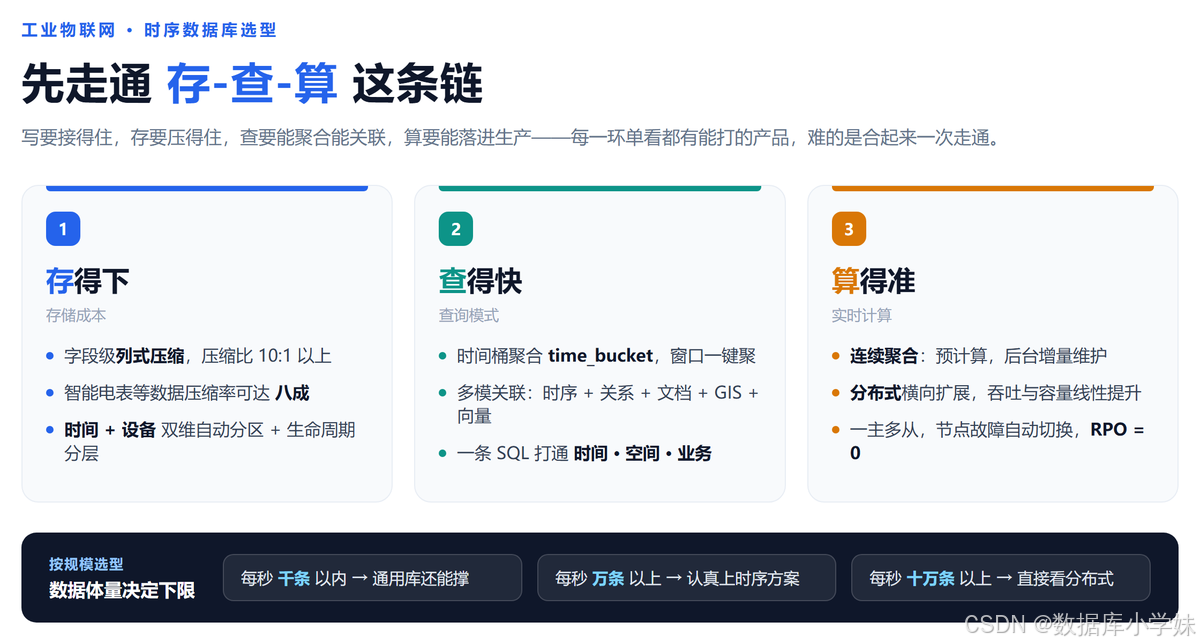
这三件事,正好对应时序数据库的三个问题:存得下、查得快、算得准。选型就是看,谁能把这条链一次走通。
存得下:时序数据库的存储账怎么算
工业时序数据的压缩潜力很大,但方案之间差得远:传统关系库的页压缩,最多省三到五成;专用时序库用列式压缩,把相邻时间戳做差分、相邻数值做异或,压缩比通常能到十比一以上,存储账才算得动。我之前跟进过一个新能源风电场的项目,上千台风机秒级数据入库,最后存储空间只用了原先的五分之一,做法是字段级列式压缩,对传感器数值、状态枚举分别编码,比通用压缩细一层,智能电表、工业传感器这类数据,压缩率能到八成。KES 的时序引擎用的就是这种字段级压缩,省下的不只是空间,还有运维。
不过光有压缩还不够,真正的存储成本,是压缩、分区、生命周期管理一起算的。数据也不能一直堆在一张表里,按"时间+设备"双维度自动分区是个常见做法,比如按月、按设备ID分片,数据按时间窗口自动归集,老旧数据能整体归档或清理,分区策略还能随数据规模动态调整。这一层设计,直接决定三年的总拥有成本,只算压缩比,账是算不准的。
查得快:时序数据库的查询,拼的是窗口聚合
监控大屏上那种"某个时间点的读数",其实很少有人查。工业现场真正高频的,是时间窗口聚合、多设备对比、趋势分析。专用时序库一般会内置 time_bucket 这类时间桶函数,按窗口把数据聚起来,一个典型写法是这样:
sql
-- 按5分钟时间桶聚合产线温度(示意)
SELECT time_bucket('5 minute', ts) AS bucket,
       device_id,
       AVG(temperature) AS avg_temp,
       MAX(temperature) AS max_temp
FROM sensor_data
WHERE ts >= now() - interval '24 hour'
GROUP BY bucket, device_id
ORDER BY bucket;
时间桶、滚动窗口、差值计算、异常检测,这些都是基础件。据公开资料,计算"某产线过去三个月的温度波动曲线",传统关系库要15秒,走这类函数能压到1.5秒以内。
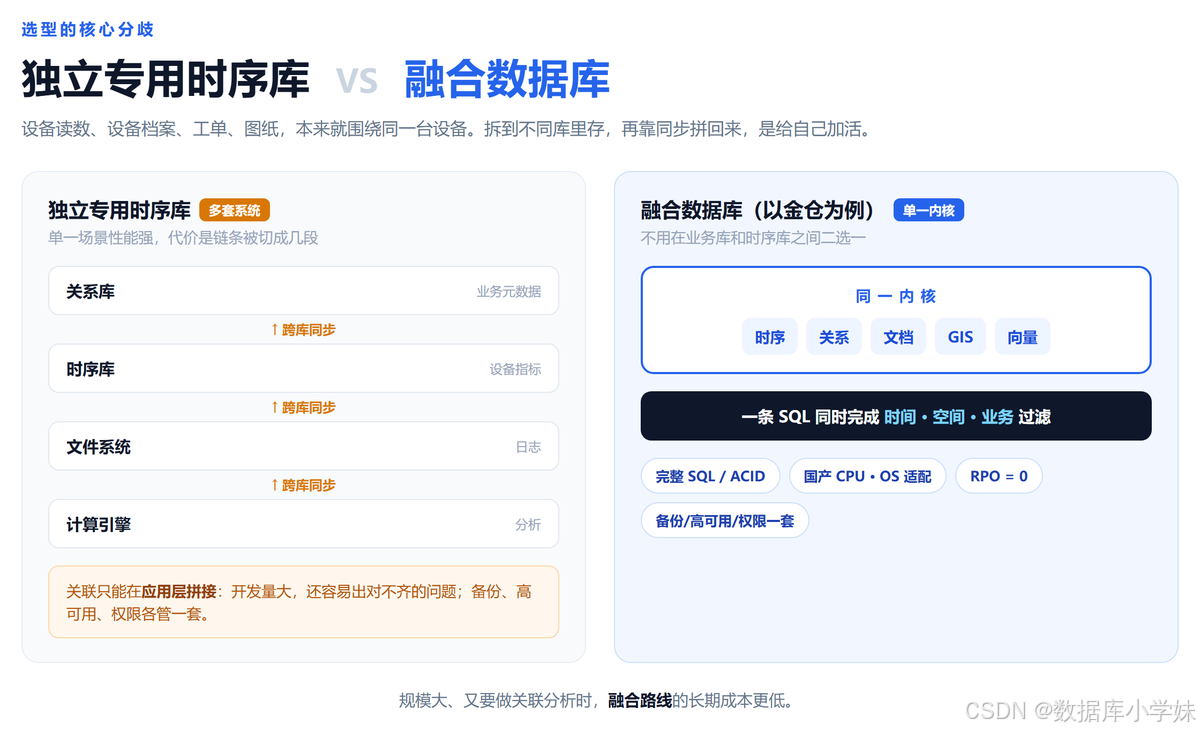
还有个事容易漏掉:关联。设备读数很少孤立存在,它要跟设备档案、维修工单、地理位置一起看才有意义,工业场景里,设备轨迹是时序加空间,传感器读数和维修记录是时序加文档。这种关联需求,单靠一个纯时序库就有点吃力了,如果时序、关系、文档、GIS、向量在同一个内核里,一条SQL就能同时完成时间和空间过滤:查"过去24小时内进出某地理围栏的设备及停留时长",响应能到毫秒级;振动数据要跟历史维修记录、图纸文档关联,也不用先把数据搬到另一个库。这正是融合数据库的路子。反过来,如果时序库和业务库是两套系统,这类关联就得在应用层拼,开发量大,还容易出对不齐的问题。
算得准:时序数据库的实时计算怎么落进生产
工业场景对实时计算的要求很硬,但"算"这件事单机早晚到瓶颈,每秒千万条写入、PB级存量数据,通常需要分布式架构。横向扩展是一方面,靠动态增加数据节点,线性提升写入吞吐和总容量;分片策略还能"时间分片+业务分片"组合,比如电网数据按"季度+区域"分片,把负载摊开,避免单点承压。
另一方面是连续聚合。像"每5分钟平均功率""每小时最大压力"这类固定聚合,可以预先定义聚合视图,引擎在后台自动、增量地维护结果,把复杂的实时计算变成对预计算结果的轻量查询。这两件事合起来,才是"算得准"的工程底座,而工业控制场景还多一条底线:数据不能丢。KES 采用"一主多从"副本机制,通过自动切换实现 RPO=0,把数据丢失风险压到最低。
一张表看懂:专用时序库 vs 融合数据库
聊完存、查、算,选型的核心分歧就浮出来了:选独立专用时序库,还是选融合数据库?独立TSDB的强项,是把单一场景的性能做到很高,代价是要多维护一套系统;业务元数据在关系库,指标在时序库,日志在文件系统,分析再挂一个计算引擎,数据链条被切成好几段,架构越来越臃肿。工业物联网的麻烦在于,数据天然是长在一起的,设备读数、设备档案、工单、图纸本来就围绕同一台设备,拆到不同库里存、再靠同步拼回来,是给自己加活。
| 对比维度 | 独立专用时序库 | 融合数据库(以 KES 为例) |
|---|---|---|
| 数据模型 | 只存时序,其他模型另建库 | 时序+关系+文档+GIS+向量同一内核 |
| 关联查询 | 需跨库同步后在应用层拼 | 一条SQL打通时间、空间、业务 |
| 事务支持 | 多数不支持或很弱 | 完整SQL与ACID事务支持 |
| 运维成本 | 多套组件分别部署运维 | 备份、高可用、权限复用一套 |
| 迁移成本 | 需另建ETL链路 | 存量业务系统可直接延伸 |
| 信创适配 | 视产品而定 | 国产CPU与操作系统全面适配 |
这张表不是要否定专用库。纯监控、数据结构单一、预算充足的场景,专用库依然好用,但如果设备数据迟早要和业务数据一起分析,融合路线的长期成本更低。
案例复盘:真实规模下,这条链怎么跑通
下面几个场景的数据,来自公开技术资料与案例。
船舶安全监管。 某省船舶安全综合管理平台,管理15万艘船舶、20万台终端,日峰值写入3000万条定位数据,存量达300亿条。用"时序+GIS+分布式分片"方案,5个节点支撑峰值1.5亿条每天写入,按年查询百亿级轨迹,毫秒级返回。
智能电网。 智能电网调度系统覆盖26省,接入超70万传感器,单库容量超30TB,日增数据10GB以上,稳定运行超过14年,达到"5个9"的可用性。
反窃电分析。 面向数千万只智能电表,分析人员在库内把实时电流波形,与用户历史档案、地理信息关联计算,异常识别从"天级"缩短到"秒级",据公开口径每年挽回经济损失数亿元。
智能制造。 高端制造产线上,蚀刻机、光刻机每毫秒产生海量传感数据,工程师直接在SQL里调用模型做在线故障预测,把预警窗口从小时级提前到分钟级。靠的就是时序与关系、向量在一个库里的融合能力。
这几个案例有个共同点:数据规模大,而且都要做关联分析。这正是"存-查-算"一体化能拿到优势的地方。
选型决策:三步把候选缩到一个
选型不用列几十个指标,我一般就走三步。
第一步,按数据规模划区间。每秒千条以内,通用库还能撑;每秒万条以上,就该认真考虑时序方案;每秒十万条以上,直接看分布式。
第二步,问一句:我的时序数据,要不要和业务数据一起分析?要,就往融合路线上靠,省掉跨库同步的长期成本;不要,专用库更单纯。
第三步,把信创和可用性摆上桌。工业、能源、政务这些场景,国产化适配、安全合规、RPO等于0,往往是硬门槛。这一项 KES 覆盖得比较全,国产CPU有鲲鹏、飞腾、龙芯、海光等,操作系统有银河麒麟、统信UOS。
三步走完,候选基本就剩一两个了。
避坑清单
第一,别用空载跑分做决定。厂商给的百万点写入、秒级查询,都是理想数据下测的,真正要看带负载时的查询延迟。做POC时,拿接近真实规模的测点数量灌数据,重点压复杂查询。
第二,别把降采样留到以后再配。几千台设备每秒一条,一天就是几亿条。我刚做项目那会儿忘了这茬,三个月后存储成本翻了几倍才补上。原始数据、分钟级聚合、日级聚合分层保留,从第一天就配好。
第三,别忽略小文件和高基数这两个坑。设备编号加型号加产线,标签组合一多,内存索引会爆炸。我的做法是只保留查询真正用到的标签,其余走业务库关联。这条我吃过亏,当时查询卡死,排查半天才发现是标签基数太高。
写在最后
工业物联网选时序数据库,说到底是选一条能把"存-查-算"走通的路径:写要能接住每秒千万条,存要压得住多年的成本,查要能聚合能关联,算要能落进生产,每一环单看都有能打的产品,难得的是合起来一次走通。KES 的路子,是把它做进融合数据库内核,不用在业务库和时序库之间二选一,时序数据和关系数据在同一平台无缝关联;对既有系统,启用能力可支持千万级传感器处理,存量业务不用推倒重来。再加上完整的SQL与事务支持、国产环境适配、RPO等于0的高可用,对工业场景来说,是把架构复杂度和长期成本一起压了下去。
你的工业物联网项目,是单独上一套时序库,还是走融合路线?评论区聊聊。
我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见👋