Ling-3.1-flash 正式开源:560B 激活 25B,1M 上下文主攻 Agent
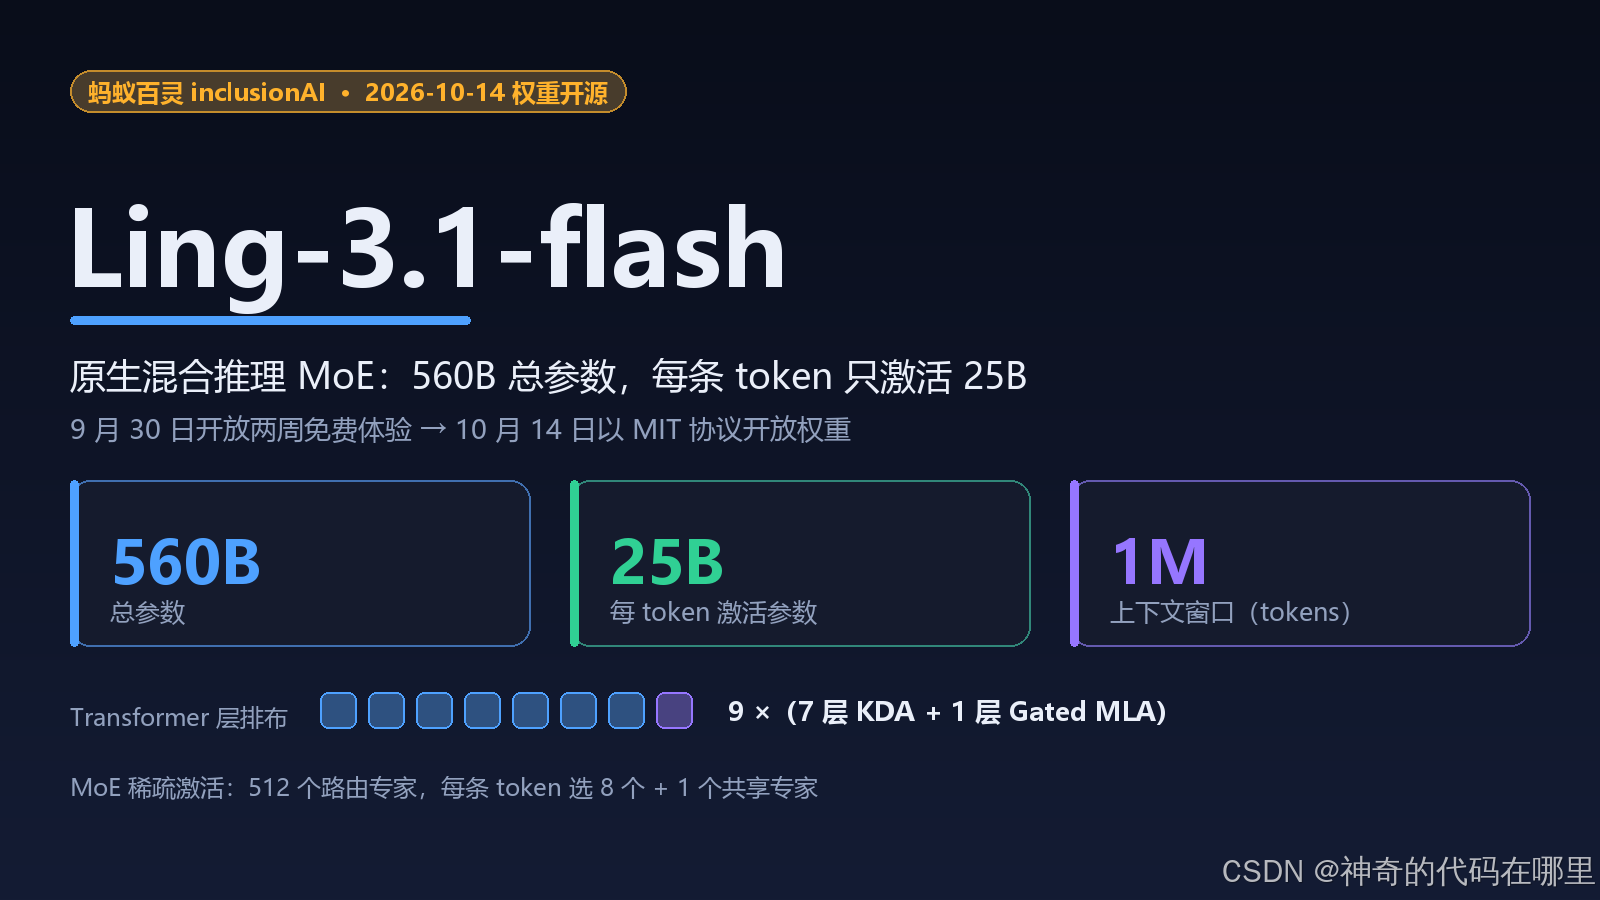
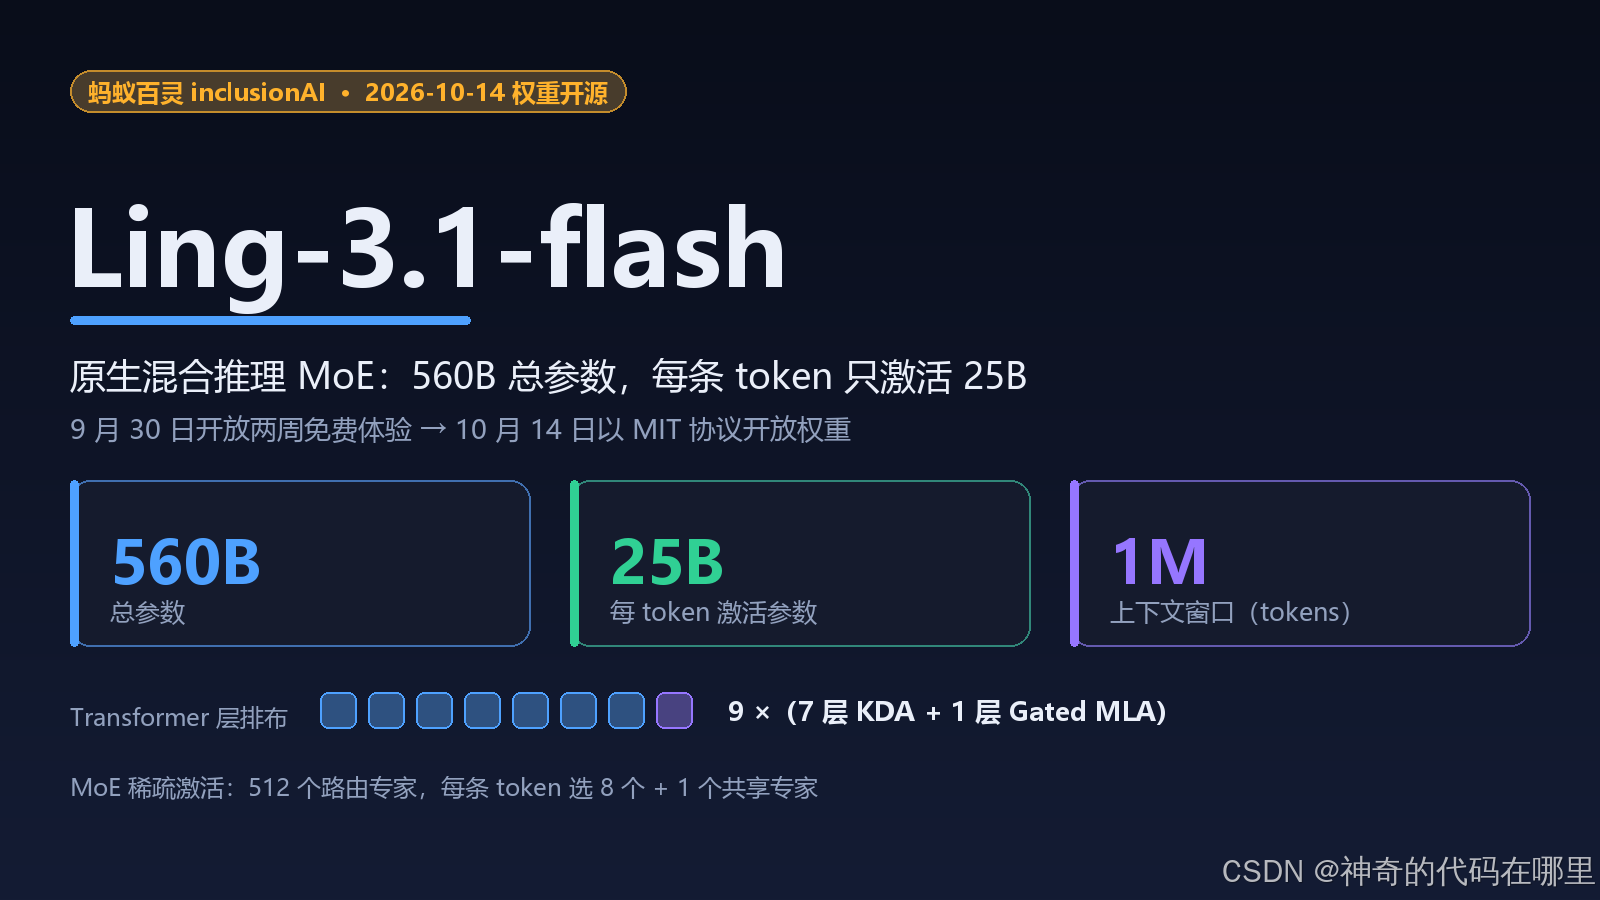
摘要 :Ling-3.1-flash 是蚂蚁集团百灵大模型团队(inclusionAI)在 2026 年 9 月 30 日发布的新一代模型,总参数约 560B、每条 token 只激活约 25B、上下文窗口上限 1M 。它走的是一条和主流"发布即开源"相反的路:先用两周免费体验把模型放出来跑,权重则等到 10 月 14 日才正式上传魔搭社区 ,许可证是宽松的 MIT。本文按"规格 → 架构 → 能力 → 评测 → 开源落地 → 怎么用 → 注意事项"的顺序做一次完整介绍。
关键词 :
蚂蚁百灵inclusionAILing-3.1-flashMoE混合线性注意力KDAGated MLA1M上下文AgentAgentic Coding开源大模型
文章目录
- [Ling-3.1-flash 正式开源:560B 激活 25B,1M 上下文主攻 Agent](#Ling-3.1-flash 正式开源:560B 激活 25B,1M 上下文主攻 Agent)
-
- 一、模型速览
-
- [1.1 一条时间线](#1.1 一条时间线)
- [二、架构:560B 只激活 25B,靠的是什么](#二、架构:560B 只激活 25B,靠的是什么)
-
- [2.1 混合线性注意力:7 层 KDA 配 1 层 Gated MLA](#2.1 混合线性注意力:7 层 KDA 配 1 层 Gated MLA)
- [2.2 MoE 稀疏激活:512 选 8](#2.2 MoE 稀疏激活:512 选 8)
- [2.3 和前代比,放大了多少](#2.3 和前代比,放大了多少)
- 三、能力定位:为"真实世界长流程任务"而优化
- 四、评测:官方口径与第三方口径要分开看
-
- [4.1 官方自评基准](#4.1 官方自评基准)
- [4.2 第三方复测:Artificial Analysis 智能指数 41](#4.2 第三方复测:Artificial Analysis 智能指数 41)
- [4.3 长时程任务:一跑就是十几个小时](#4.3 长时程任务:一跑就是十几个小时)
- [4.4 一个必须写明的坦白](#4.4 一个必须写明的坦白)
- 五、开源兑现:权重、许可证与体积
- 六、怎么用上它
-
- [6.1 先试 API](#6.1 先试 API)
- [6.2 自部署(SGLang,官方推荐)](#6.2 自部署(SGLang,官方推荐))
- [6.3 自部署(vLLM)](#6.3 自部署(vLLM))
- [6.4 调用验证](#6.4 调用验证)
- [6.5 放进 Agent 框架里用](#6.5 放进 Agent 框架里用)
- 七、上手前要留意的几点
- 八、小结
- 相关链接
一、模型速览
一句话定位 :Ling-3.1-flash 是一个原生混合推理(native hybrid reasoning)模型 ,官方把它描述为"面向复杂真实世界任务"的升级版------在 Ling-3.0-flash 的基础上做架构与真实场景能力升级,重点方向是通用智能体、搜索、办公生产力与软件工程。
| 项目 | 内容 |
|---|---|
| 模型名称 | Ling-3.1-flash |
| 发布方 | 蚂蚁集团 · 百灵大模型团队(开源组织 inclusionAI) |
| 发布日期 | 2026-09-30(同步开放两周免费体验) |
| 权重开源 | 2026-10-14(魔搭社区 ModelScope;官方同时提供 Hugging Face 组织入口) |
| 任务类型 | text-generation(文本生成) |
| 架构 | Hybrid-linear MoE(混合线性 MoE) |
| 架构类名 | BailingMoeV3ForCausalLM(model_type:bailing_hybrid) |
| 参数规模 | 总 560B / 每 token 激活 25B |
| 上下文窗口 | 1M tokens(体验期限制为 256K,官方称之后开放完整上下文) |
| 推理模式 | 原生混合推理,可通过 enable_thinking 开关思考模式 |
| 权重体积 | ≈ 572 GB (54 个 safetensors 分片,张量类型以 F8_E4M3 为主) |
| 许可证 | MIT(宽松开源,可商用) |
| 推荐框架 | SGLang(day-0 镜像)、vLLM(指定分支) |
| 生态适配 | Claude Code、Kilo Code、Qwen Code、Hermes Agent、OpenClaw 等 |
截至 2026-10-15 ,魔搭模型页显示的公开数据为:下载 29 次、Star 2~3(不同时间抓取的快照略有差异)。权重刚上传一天,这组数字只反映"首日冷启动",参考价值有限。
1.1 一条时间线
| 时间 | 事件 |
|---|---|
| 2026-09-30 | Ling-3.1-flash 发布,开放两周免费体验(期间上下文限制 256K) |
| 2026-10-13 | 免费体验期结束,转入付费调用(第三方页面标注的截止日期) |
| 2026-10-14 | 权重上传魔搭社区,MIT 协议开放下载 |
| 2026-10-15 | 模型页下载量 29、Star 2~3(首日数据) |
这个发布节奏值得单独说一句 :先放模型、后放权重,意味着在 9 月 30 日到 10 月 14 日这两周里,外界只能通过 API 体验,无法自己复测、也无法当场验证开源承诺。这也是当时网上不少讨论质疑"开源是不是画饼"的原因------而这件事现在已经有结果了。
二、架构:560B 只激活 25B,靠的是什么
这一代最值得看的不是"参数变大了",而是在参数放大 4.5 倍的同时,把每条 token 的激活量控制在 25B 。它靠的是两件事:混合线性注意力 和稀疏 MoE。
2.1 混合线性注意力:7 层 KDA 配 1 层 Gated MLA
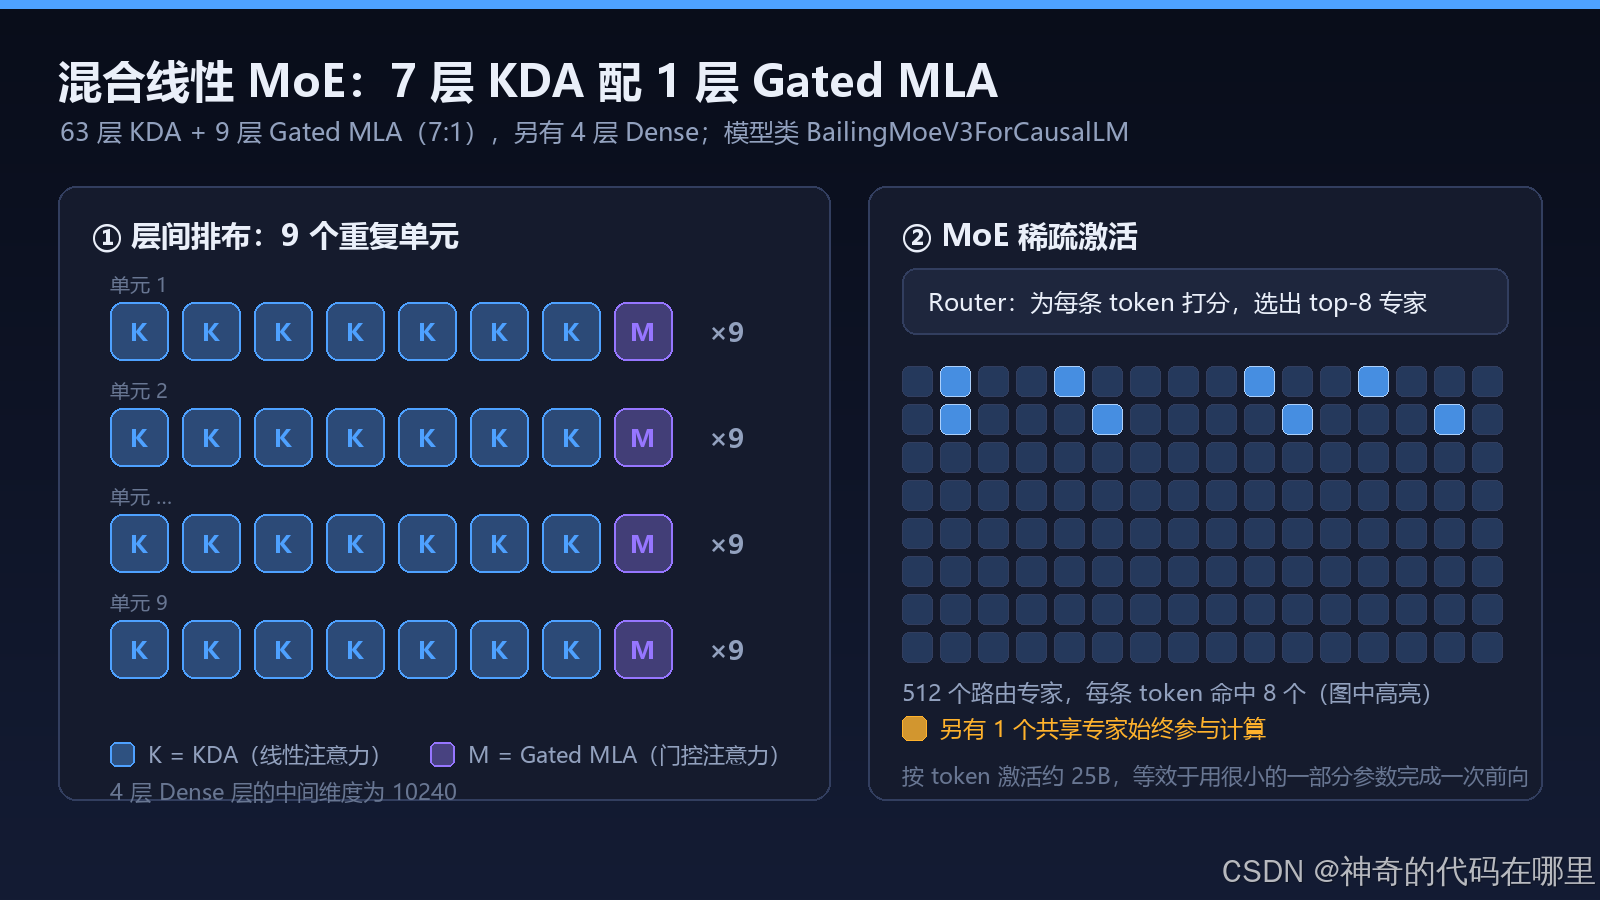
官方给出的层间排布是 63 层 KDA + 9 层 Gated MLA ,比例 7:1 ,另有 4 层 Dense。
| 概念 | 说明 |
|---|---|
| KDA | 线性注意力层,单步计算量随上下文增长更平缓,是它能撑住 1M 上下文的关键 |
| Gated MLA | 门控注意力层,保留完整注意力的表达力,每 7 层插入 1 层兜底 |
| 组合方式 | 9 ×(7 层 KDA + 1 层 Gated MLA)= 63 + 9 = 72 层,再加 4 层 Dense |
一句话理解:大量线性层负责"跑得动",少量完整注意力层负责"看得准"。相比全注意力架构,这种配比在长上下文下单步计算量更可控,也是目前长上下文模型常见的一种取舍(此处为机制层面的一般理解,官方未逐项说明设计动机)。
2.2 MoE 稀疏激活:512 选 8
| 架构项 | 数值 |
|---|---|
| 架构类型 | Hybrid-linear MoE |
| 参数规模 | 总 560B / 激活 25B |
| Transformer 层 | 63 KDA + 9 Gated MLA(7:1) |
| Dense 层数 | 4 |
| 路由专家数 | 512 |
| 共享专家数 | 1 |
| 每 token 激活专家数 | 8 |
| 注意力头数 | 64 |
| Hidden Size | 4096 |
| 专家中间层维度 | 1280 |
| Dense 中间层维度 | 10240 |
| 词表大小 | 157184 |
512 个路由专家里每条 token 只挑 8 个,再叠加 1 个共享专家------这是"560B 的总量、25B 的开销"的直接来源。共享专家承担通用能力,路由专家承担细分能力,二者配合是目前大 MoE 的常见做法。
2.3 和前代比,放大了多少
| 模型 | 总参数 | 激活参数 | 激活占比 |
|---|---|---|---|
| Ling-3.0-flash | 124B | 5.1B | 4.1% |
| Ling-3.1-flash | 560B | 25B | 4.5% |
前代 Ling-3.0-flash 的规格为公开资料口径(124B 总参数 / 5.1B 激活参数)。
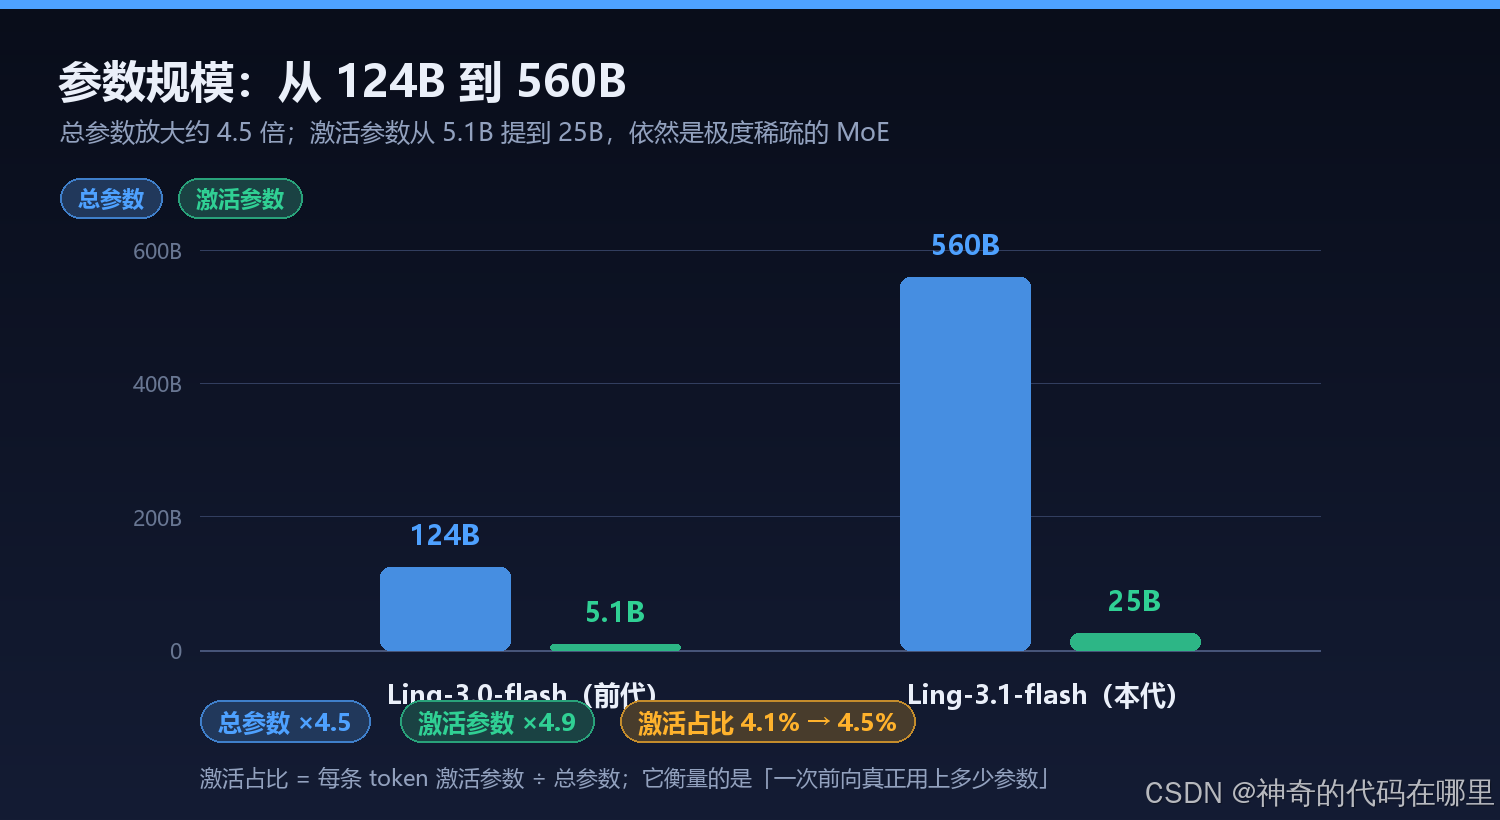
总参数放大约 4.5 倍,激活参数提高约 4.9 倍,激活占比基本不变。 换句话说,这次升级不是把模型"变稀疏",而是在同样的稀疏度下把知识容量整体抬了一个量级------代价也很明确:权重体积从百 GB 级别跳到了 572GB(详见第五章)。
三、能力定位:为"真实世界长流程任务"而优化
官方对它的场景描述集中在**"长流程、多步骤、要连续干几小时"**这类任务上,官方物料里点名的方向包括:
| 方向 | 具体说明 |
|---|---|
| 日常办公 | 从模糊需求自动拆解任务,整合资料生成研究报告、Excel 表格、PPT |
| 医疗沟通 | 零散症状 → 就诊清单、检查指标解读、用药与复诊建议 |
| 软件研发 | 在代码库中持续数小时做问题定位、修改、测试验证与迭代修复 |
| 安全分析 | 漏洞挖掘、根因定位、PoC 构造与补丁生成 |
| Web / 移动 / 3D 开发 | 营销网页、App 界面、SVG 矢量素材、Three.js 3D 交互演示 |
它把这条链路概括为**"长流程任务闭环":需求梳理 → 任务规划 → 工具调用 → 中间结果校验 → 路径修正,全部串在一条链上,尽量保证跑几个小时之后目标和历史不失真**。
另外两个值得注意的落地细节:
- 场景化 RLVR 对齐 :针对医疗等垂直场景,基于"阿福""好大夫"等应用的真实反馈做强化学习对齐训练。
- 已在蚂蚁内部落地 :官方称 Ling-3.1-flash 已接入蚂蚁内部的桌面 Agent 客户端 "小虎" 。这一点比跑分更能说明它的定位------它是奔着"当 Agent 的底座"去的,不是奔着当聊天机器人去的。
四、评测:官方口径与第三方口径要分开看
评测部分必须分两类数据看:一类是官方自评,一类是第三方复测。前者属于厂商口径、无法排除择优呈现,后者才具备独立复现的意义。
4.1 官方自评基准
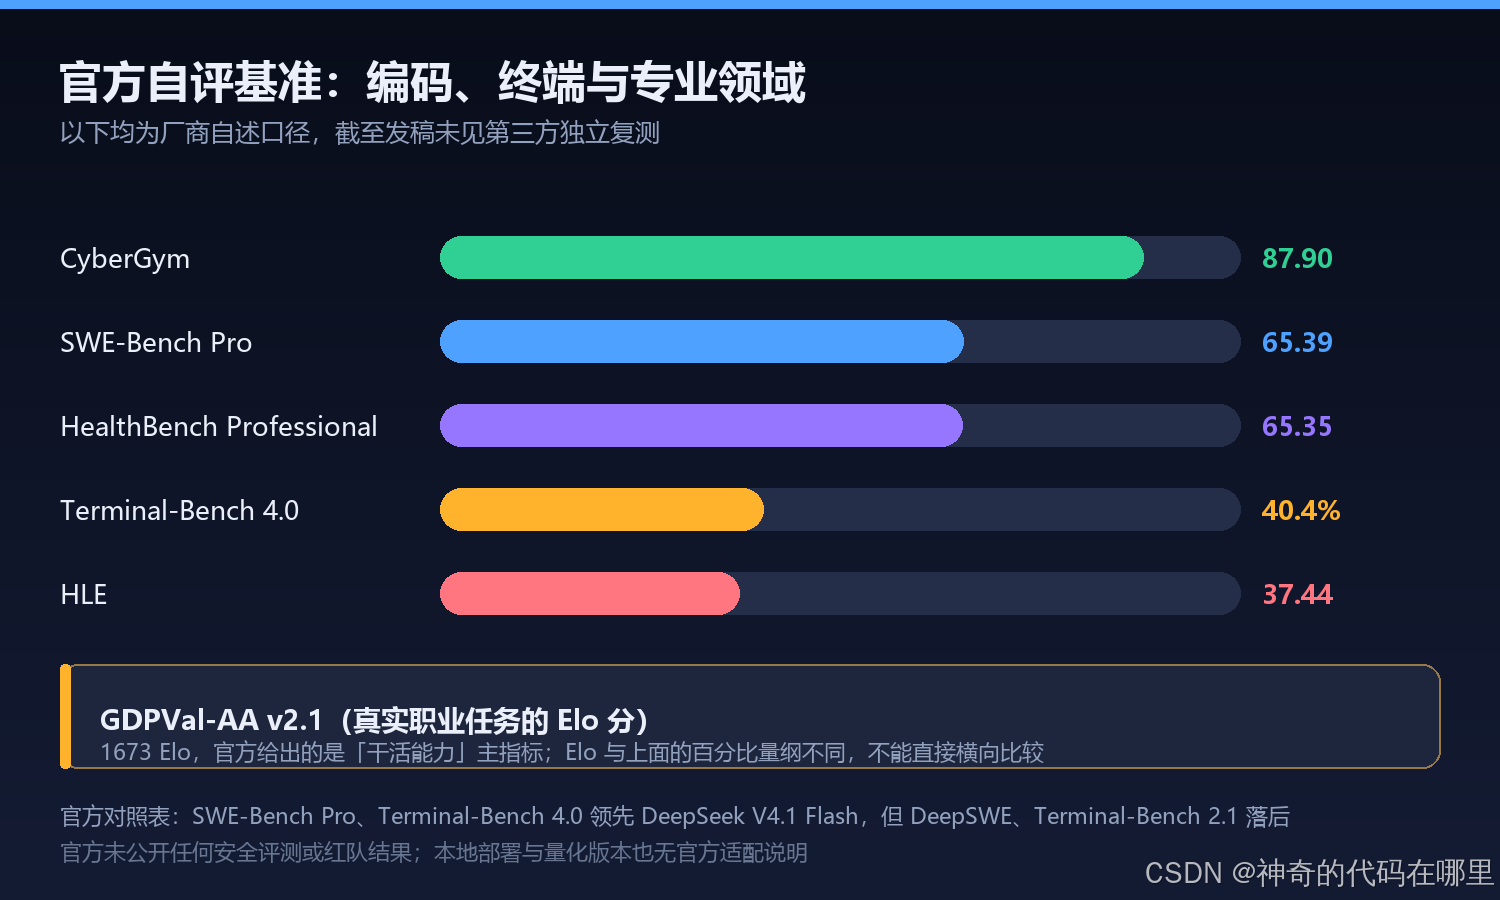
| 评测项 | 官方分数 |
|---|---|
| SWE-Bench Pro | 65.39 |
| Terminal-Bench 4.0 | 40.4% |
| CyberGym | 87.90 |
| HLE | 37.44 |
| HealthBench Professional | 65.35(官方称同档 flash 模型中领先) |
| GDPVal-AA v2.1 | 1673 Elo(官方主打的"干活能力"指标) |
官方还提到在 FrontierSWE、Automationbench、MCP-Atlas、SkillsBench 等基准上表现较强,但没有给出具体分数。
口径提醒 :GDPVal-AA 是 Elo 分,前面几项是百分比准确率,两者不能横向比较。上面这张表里唯一可以互相比较的是那几个百分比项。
4.2 第三方复测:Artificial Analysis 智能指数 41
在 Artificial Analysis 智能指数 v4.3 的横向排位里,Ling-3.1-flash 拿到 41 分(以下排位数据来自第三方页面对 AA 页面的转述):
| 模型 | AA 智能指数 |
|---|---|
| GLM-5.3-Flash | 42 |
| Ling-3.1-flash | 41 |
| Gemini 3.8 Flash (high) | 41 |
| DeepSeek V4.1 Flash (Max) | 39 |
| Mistral Large 5 | 38 |
| Ling-3.0-flash(前代) | 20 |
41 分意味着什么 :相对前代的 20 分几乎是翻倍 ,与 Gemini 3.8 Flash(high)打平,并反超 DeepSeek V4.1 Flash(Max)。这就是当时"逼平 Gemini"这类说法的出处。
同一份复测里还有几个不常被引用的数字,反而更值得看:
| 指标 | 变化 | 读法 |
|---|---|---|
| AAOmniscience(知识准确率) | 18% → 29% | 知识量确实涨了 |
| 幻觉率 | 44% → 38% | 有改善,但仍有接近四成不靠谱 |
| 尝试率 | 基本没动 | 涨的是知识,不是"不会就不答"的判断力 |
| 跑完整套指数的输出 token | 省 16% | 达到同一分数更省 token |
"读法"一列是对这些指标的解读,不是官方或 AA 的表述,仅供理解参考。
4.3 长时程任务:一跑就是十几个小时
官方给的演示很"硬核",是最能体现"长流程"定位的部分:
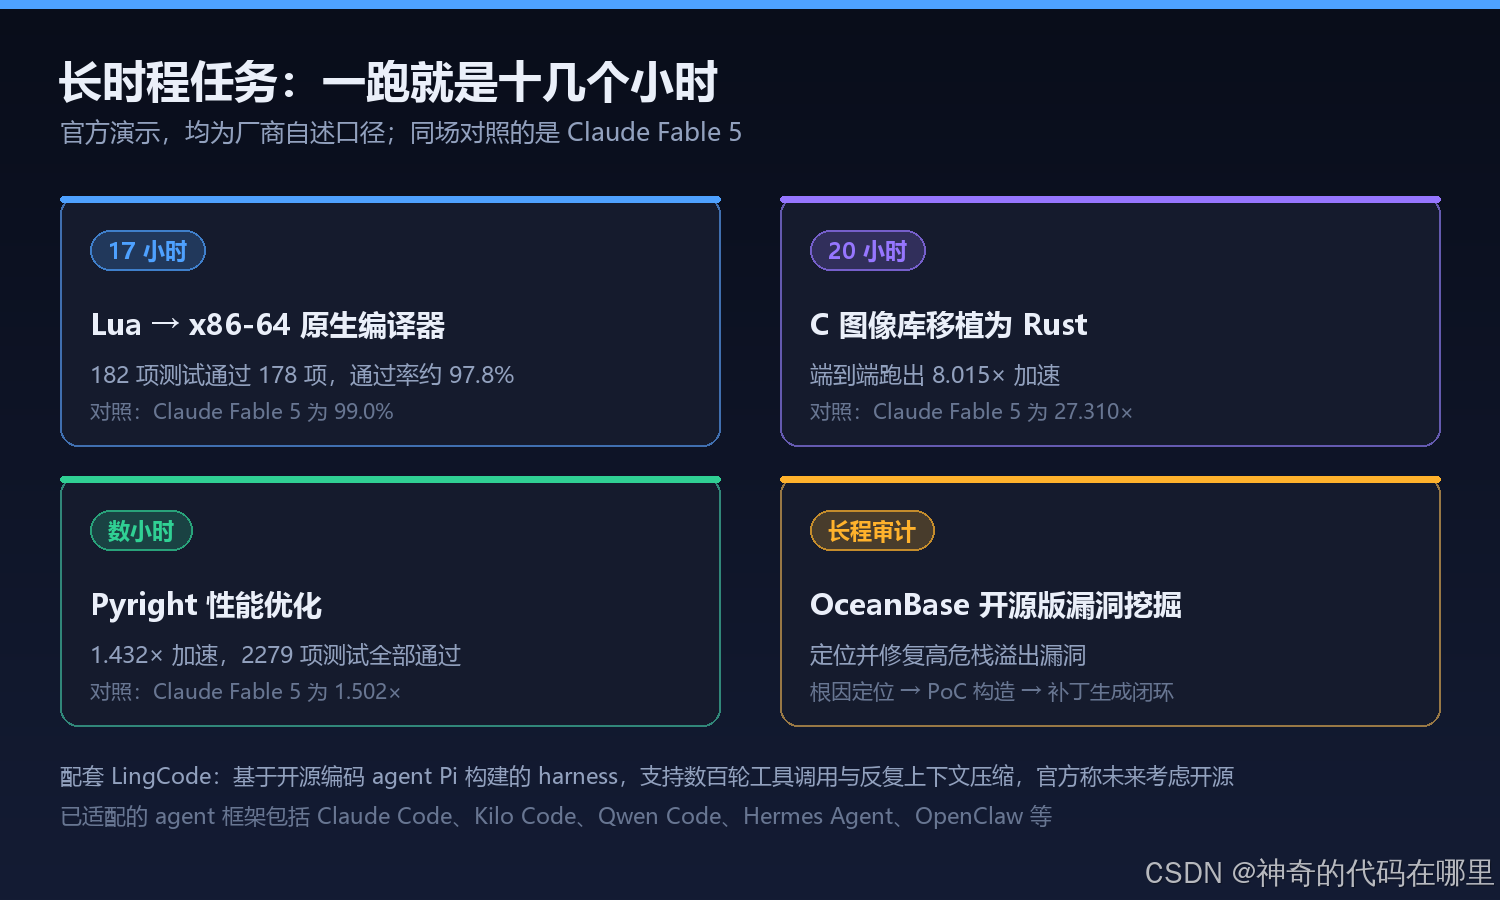
| 任务 | 时长 | 结果 | 官方对照表中的 Claude Fable 5(厂商口径) |
|---|---|---|---|
| 从零实现 Lua → x86-64 原生编译器 | 约 17 小时 | 182 项测试通过 178 项,约 97.8% | 99.0% |
| C 图像库移植为 Rust | 约 20 小时 | 端到端 8.015× 加速 | 27.310× |
| Pyright 性能优化 | 数小时 | 1.432× 加速,2279 项测试全过 | 1.502× |
| OceanBase 开源版漏洞挖掘 | 长程审计 | 定位并修复高危栈溢出漏洞 | --- |
这里要客观说两句 :官方自己的对照表里,Lua 编译器任务略落后、C 库 Rust 重写明显落后于 Claude Fable 5 (8.015× vs 27.310×)。所以"长时程能力"这个词的准确含义是它能撑住十几小时的连续任务并且交付可用结果,而不是"每个任务都比最强闭源模型做得好"。
4.4 一个必须写明的坦白
**以上所有数据,除 AA 智能指数外均为厂商自述口径,截至发稿未见第三方独立复测。**此外:
- 官方对照表中 DeepSWE、Terminal-Bench 2.1 两项落后于 DeepSeek 的同档模型;
- 官方未公开任何安全评测或红队结果;
- 基准名称里出现的 FrontierSWE、Automationbench、MCP-Atlas、SkillsBench 等,均未给出分数。
如果你需要硬指标,建议等独立复测或官方技术报告。
五、开源兑现:权重、许可证与体积
这一块是 10 月 14 日之后才变得可验证的部分。
| 项目 | 内容 |
|---|---|
| 开源平台 | 魔搭社区 inclusionAI/Ling-3.1-flash(模型卡另提供 Hugging Face 组织入口) |
| 上传时间 | 2026-10-14 |
| 许可证 | MIT(允许商用、修改、再分发,需保留版权声明与许可文本) |
| 权重体积 | 572.12 GB (model.safetensors.index.json + 54 个分片) |
| 张量类型 | F8_E4M3(FP8 为主)、BF16、F32 |
| 框架依赖 | PyTorch、safetensors |
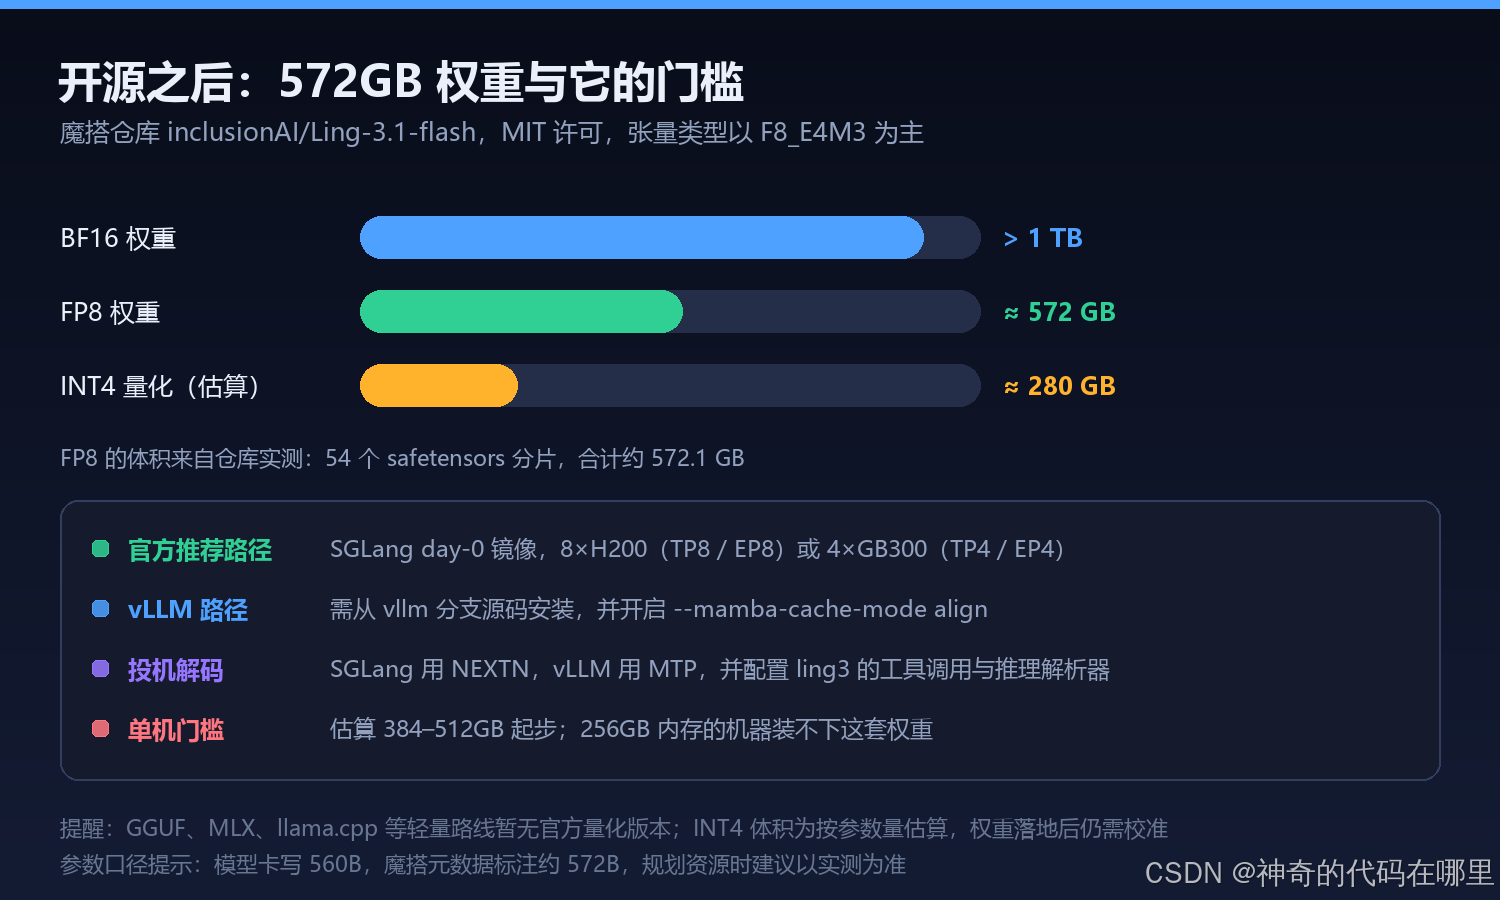
| 精度 | 体积 | 说明 |
|---|---|---|
| BF16 | > 1 TB | 官方口径 |
| FP8(实际发布) | ≈ 572 GB | 魔搭仓库实测,54 个分片 |
| INT4(4bit) | ≈ 280 GB | 按参数量估算,待权重落地后校准 |
两个需要留意的细节:
- 参数口径有差异 :模型正文写 560B ,魔搭元数据里的权重总量换算约为 572B(572.1 GB) ,两者相差约 12B。FP8 下"1 参数≈1 字节",572GB 的体积与 560B 量级是自洽的,但做资源规划时建议以实测体积为准,别只按 560B 算。
- 许可证是 MIT,这点比体积更关键:相比"研究许可"类协议,MIT 对商用和二次分发友好得多,也解释了为什么下载页里没有任何申请审批流程。
至于"能不能本地跑" :572GB 的 FP8 权重意味着256GB 内存的机器装不下这套权重 ,按目前公开信息估算,"单机全装"需要 384--512GB 起步 。GGUF、MLX、llama.cpp 这类轻量路线目前还没有官方量化版本 ,社区适配也要等。所以哪怕权重已经开源,它面向的仍然是多卡服务器和云端 API 玩家。
六、怎么用上它
6.1 先试 API
三条现成的入口:
| 入口 | 说明 |
|---|---|
| Ling Studio | 百灵官方对话体验入口 chat.ant-ling.com |
| 蚂蚁数科 MaaS 平台 | 面向开发的模型服务接入 |
| OpenRouter | openrouter.ai/inclusionai/ling-3.1-flash,海外开发者友好 |
推荐采样参数(官方给出):
temperature = 1.0
top_p = 0.95
top_k = 20
chat_template_kwargs = {"enable_thinking": true}官方明确建议开启 thinking 模式以获得更好表现。这组值偏高温、高 top_p,属于推理型模型的常见推荐区间,和传统对话模型常用的低温设置有明显差别。
6.2 自部署(SGLang,官方推荐)
官方 day-0 镜像里直接带了 Ling-3.1-flash 支持、MTP(NEXTN)投机解码以及 Hopper 解码优化:
bash
docker pull lmsysorg/sglang:dev-ling-3.1-flash
bash
# 8×H200:TP8 + EP8;4×GB300 则改用 --tp 4 --ep 4
docker run --gpus all --network host --ipc=host --rm \
  lmsysorg/sglang:dev-ling-3.1-flash \
  python3 -m sglang.launch_server \
    --model-path inclusionAI/Ling-3.1-flash \
    --tp 8 --ep 8 \
    --speculative-algorithm NEXTN \
    --host 0.0.0.0 --port 30000
可选优化:设置
SGLANG_ENABLE_FP8_BLOCK_GEMV=1、SGLANG_ENABLE_FUSED_KDA_OUTPUT_QUANT=1,官方称 batch-1 解码约快 10%。H200、H100、H800、B200、GB300 均有已验证配方。
6.3 自部署(vLLM)
vLLM 路径需要从 vllm 分支源码安装(暂时不是发布版),启动参数里有几项是这类混合线性 MoE 特有的:
bash
vllm serve "$MODEL_PATH" \
    --trust-remote-code \
    --tensor-parallel-size 8 \
    --gpu-memory-utilization 0.85 \
    --enable-prefix-caching \
    --enable-expert-parallel \
    --mamba-cache-mode align \
    --enable-auto-tool-choice \
    --tool-call-parser ling3 \
    --reasoning-parser ling3 \
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'重点关注三项:--mamba-cache-mode align(线性注意力层的状态缓存对齐)、--tool-call-parser ling3 与 --reasoning-parser ling3(工具调用与推理内容解析,做 Agent 必配)。
6.4 调用验证
bash
curl -s http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "Ling-3.1-flash",
       "messages": [{"role": "user", "content": "What is the capital of France?"}],
       "chat_template_kwargs": {"enable_thinking": true},
       "stream": true,
       "temperature": 1.0,
       "top_k": 20,
       "top_p": 0.95}'
6.5 放进 Agent 框架里用
官方列出的、实测体验较好的 harness 包括 Claude Code、Kilo Code、Qwen Code、Hermes Agent、OpenClaw 等。
同时官方还介绍了一个自研 harness LingCode :它构建在开源编码 agent Pi 之上,专门针对跑几个小时的复杂编码任务 做了增强------支持数百轮工具调用 和反复的上下文压缩 。官方称它在部分编码 agent 任务上有明显提升,并考虑未来开源。
七、上手前要留意的几点
| 事项 | 说明 |
|---|---|
| 评测可信度 | 除 AA 智能指数外的分数均为厂商自述;官方对照表中 DeepSWE、Terminal-Bench 2.1 落后于 DeepSeek |
| 安全评测缺失 | 官方未公开任何安全评测或红队结果,涉及医疗、金融等场景时需自行做合规评估 |
| 调用成本 | 第三方评测转述的参考价为每百万 token 输入 0.30 美元 / 输出 0.90 美元 ,单任务成本约 0.99 美元;同口径下 GLM-5.3-Flash 为 0.42、DeepSeek V4.1 Flash(Max)为 0.32,但低于 Gemini 3.8 Flash (high) 的 1.24 ------即"比国产同档贵、比海外旗舰便宜"。另有第三方转售渠道报价约 0.075 / 0.22 美元,口径不一致,实际价格请以百灵官方页面为准 |
| 本地部署门槛 | FP8 权重约 572GB,估算需 384--512GB 内存起步;官方推荐 8×H200 或 4×GB300 |
| 量化生态 | 暂无官方 GGUF / INT4 版本,轻量推理路线需要等社区适配 |
| 上下文差异 | 官方口径是 1M,但体验期被限制在 256K(部分渠道显示为 262K 上下文 / 33K 最大输出),先按小窗口验证再决定是否压长文 |
| 参数口径 | 560B(模型卡)与 572B(权重体积换算)存在差异,资源规划以实测为准 |
八、小结
| 维度 | 结论 |
|---|---|
| 是什么 | 蚂蚁百灵 Ling-3.1-flash,原生混合推理 MoE 模型,2026-09-30 发布、2026-10-14 以 MIT 协议开源 |
| 核心规格 | 560B 总参数 / 25B 激活 / 1M 上下文 / 63 KDA + 9 Gated MLA(7:1)/ 512 路由专家激活 8 |
| 能力主线 | 长流程真实任务:通用 Agent、搜索、办公、软件工程、医疗与安全分析 |
| 第三方成绩 | AA 智能指数 41 分,与 Gemini 3.8 Flash(high)打平,反超前代 20 分一倍以上 |
| 开源状态 | 已落地:MIT 许可、572GB FP8 权重、54 个分片 |
| 最大门槛 | 体积与显存:384--512GB 起步,官方推荐 8×H200 / 4×GB300,与消费级显卡无关 |
一句话总结 :Ling-3.1-flash 真正值得记的不是 560B 这个数字,而是它把"开源"这件事的顺序反过来做了 ------先让所有人用两周,再交出权重和 MIT 许可。规格上,它用 7:1 的混合线性注意力和 512 选 8 的稀疏 MoE,把"1M 上下文 + 大参数"的成本压到 25B 激活;定位上,它是奔着当 Agent 底座去的,长时程任务演示和 LingCode 都是为此服务的。但它的现实门槛同样清晰:572GB 权重、几百 GB 内存起步、量化生态尚未跟上,以及评测数据仍以厂商自述为主。如果你是在做 Agent / 长流程自动化方向的技术选型,它值得进候选列表;如果你只是想在本机跑一个开源模型,它现在还不属于你的射程。
相关链接
- 魔搭社区模型页:inclusionAI/Ling-3.1-flash
- Hugging Face:inclusionAI
- 魔搭组织页:inclusionAI
- OpenRouter:inclusionai/ling-3.1-flash
- SGLang Cookbook:Ling-3.1-flash 部署配方
- 百灵大模型官网
本文是技术信息整理,不是官方文档。文中数据均来自公开网络检索,可能不准确、不完整或有滞后,阅读时请自行交叉验证。
本文观点仅为个人整理与分析,不构成任何评测结论、选型建议或采购依据 。涉及商用、合规、医疗金融等场景时,请以官方文档、许可证全文与实际压测结果为准。如文中数据与官方信息不符,请以官方信息为准;也欢迎在评论区指出错误。