本文围绕IEEE Robotics and Automation Letters 2025录用论文《Signage-Aware Exploration in Open World using Venue Maps》展开技术拆解,结合启元机器人的产品场景与开发者生态,分析该方案的落地价值与工程实现路径。文中所有实验数据均来自原论文表II、表III、表IV,技术参数均对应原论文表。
一、论文概述
基础信息
- 论文全称:Signage-Aware Exploration in Open World using Venue Maps
- 发表渠道:IEEE Robotics and Automation Letters(RA-L),2025年4月正式录用
- 研究团队:香港大学计算机科学系相关研究团队
- 应用场景:大型商场、楼宇等未知室内开放环境的机器人地标搜索与自主探索
核心问题
机器人在未知开放环境中搜索店铺、房间等地标时,普遍存在两类瓶颈:一是传统几何驱动的探索方法无语义引导,遍历效率低,容易错过侧向标识;二是闭集训练的OCR模型难以适配开放场景中多样的标识字体、视角与光照,识别准确率不足。同时,日常随处可得的2D场所示意图(商场导览图、户型图)包含丰富的地标拓扑信息,但此前的导航方案并未充分挖掘标识文字与地图地标的关联价值。
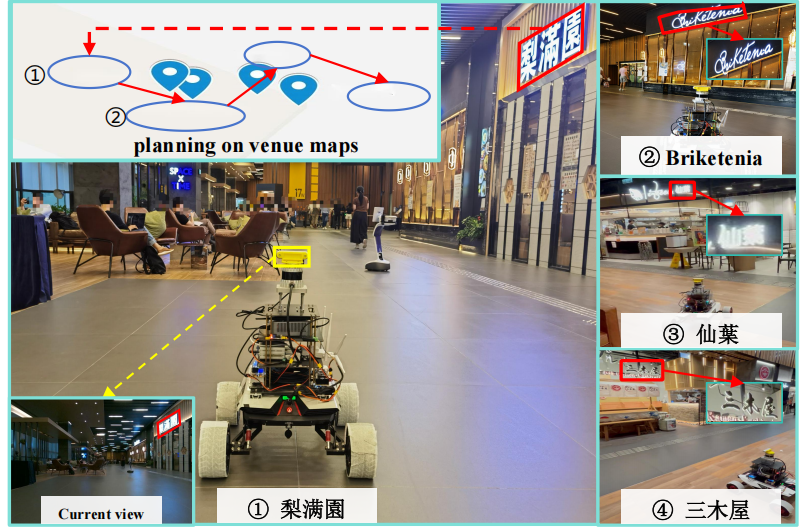
图 1 基于场所地图与标识匹配的机器人探索概念
来源:Chen et al., Signage-Aware Exploration in Open World using Venue Maps, IEEE RA-L 2025
核心贡献
论文提出一套完整的标识感知探索系统,核心分为两部分:
- 标识理解模块:采用扩散式文本实例检索+2D-3D语义融合策略,无需针对新场景微调模型,即可提升开放场景下的标识识别准确率。
- 探索规划模块:设计场所地图引导的探索-利用规划器,用地标拓扑关系做方向引导,平衡"未知区域探索"与"标识凑近识别"两类行为,大幅提升搜索效率。
启元技术关联点
启元T1移动机器人具备轮足切换、室内通行能力,当前主打家庭场景,未来可拓展商超导览、楼宇配送等公共场景。该方案的"低精度场所地图+视觉语义识别"路线,无需依赖提前高精度建图,可显著降低消费级机器人的场景适配成本,同时可作为标准能力开放给开发者生态,丰富Skill场景库。
二、核心技术方法拆解
2.1 标识理解:扩散式文本实例检索 + 2D-3D语义融合
该模块解决的核心问题是:开放场景下标识样式多变、单视角噪声大,传统OCR识别准确率不足。其核心思路是绕开"文字内容识别",直接通过图像特征匹配完成标识与地标的关联,适配不同字体、视角与语言。
(1)离线阶段:扩散模型生成标识特征库
- 输入:从2D场所地图中提取的全部地标名称(如店铺名、房间名)。
- 生成工具:采用AnyText v1.0多语言文本扩散模型,将每个地标名称渲染为接近真实场景的标识图像,模拟不同字体、排版与背景风格。
- 特征提取:使用ESTextSpotter文本检测模型,对生成的标识图像提取文本特征,构建离线特征池。
- 核心优势:无需针对新场景收集标注数据、微调OCR模型,仅需地标名称列表即可快速生成场景专属特征库,迁移成本极低。
(2)在线阶段:2D检测与3D多视角融合
- 单帧2D检测:使用同一ESTextSpotter模型,从机器人当前RGB帧中检测文本区域,提取对应2D特征。
- 2D转3D投影:结合深度图、机器人实时位姿、相机内参,将2D文本区域投影到3D空间,生成空间文本实例。
- 3D特征融合 :将新检测到的3D文本实例与已构建的3D文本库匹配,满足特征相似度阈值γ_s=0.5 且空间距离阈值γ_d=3米时,对两个实例的特征做加权平均融合,更新库中特征。
- 实例检索:将融合后的3D特征与离线特征池做余弦相似度匹配,输出最相似的地标名称作为识别结果。
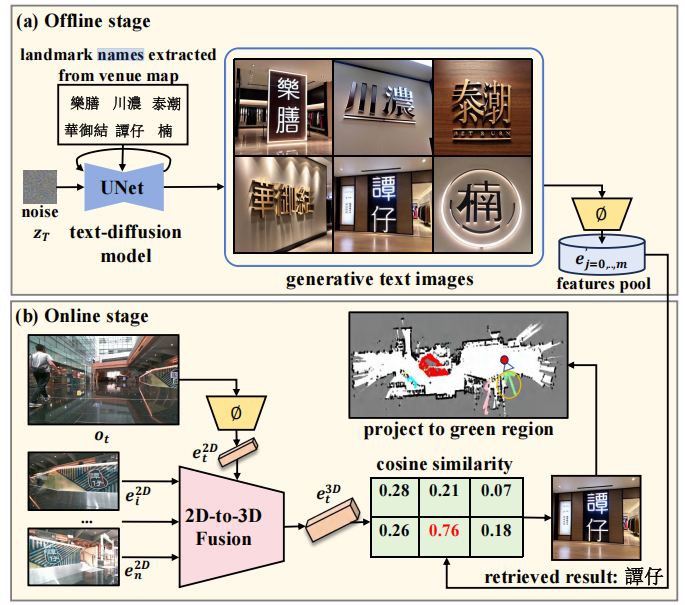
图 2 标识理解模块流水线:(a) 离线阶段生成特征库;(b) 在线阶段 2D-3D 融合与检索 来源:Chen et al., 2025
该设计的核心价值在于:通过多视角观测累积抵消单视角噪声,同时用图像特征匹配替代文字内容识别,规避了复杂字体、低分辨率下的OCR误差,尤其适配中文等方块字场景。
2.2 探索规划:场所地图引导的探索-利用平衡
该模块解决的核心问题是:纯随机探索效率低,机器人无法自主判断"该往哪走""什么时候该凑近识别标识"。论文引入场所地图的拓扑信息作为先验,通过双效用函数平衡两类行为。
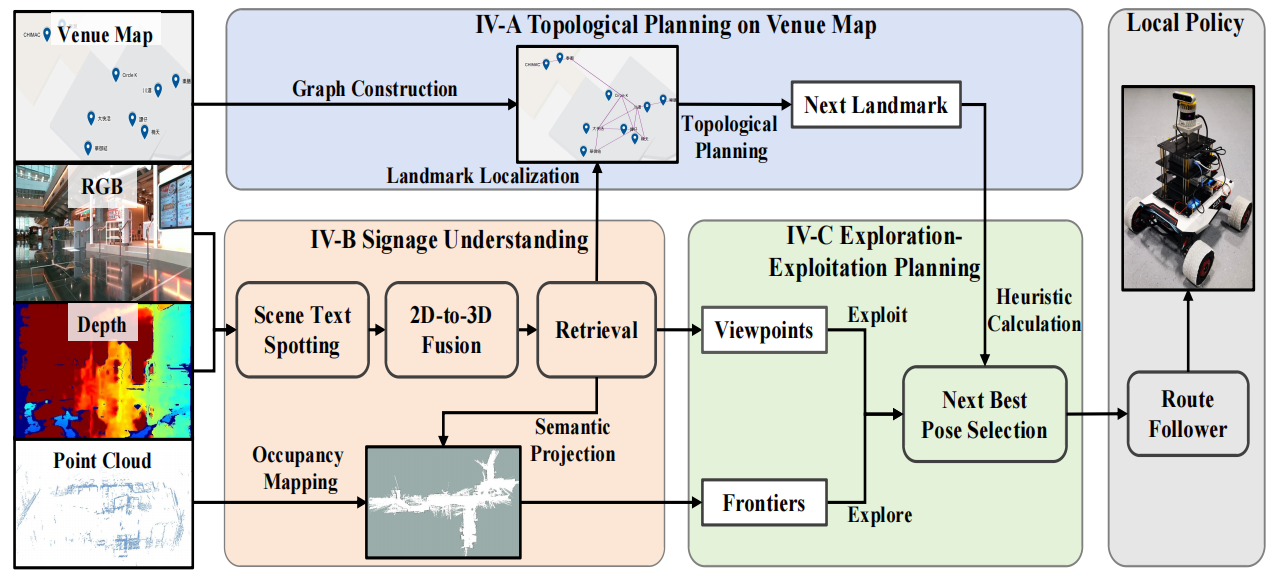
图 3 系统整体框架:场所地图拓扑构建 + 标识理解 + 探索 - 利用规划 来源:Chen et al., 2025
(1)前置:场所地图拓扑构建
- 从2D场所地图中提取所有地标节点,以γ_map=150像素为距离阈值,将距离小于阈值的节点连边,构建拓扑图。
- 使用TSP(旅行商问题)求解器规划地标遍历顺序,作为机器人的全局探索序列,避免完全盲走。
(2)候选位姿分类
机器人每一步的候选位姿分为两类:
- 前沿点:未知区域的边界点,对应"探索"行为,目的是发现新的标识与区域。
- 视点:疑似标识附近的观测位姿,对应"利用"行为,目的是调整距离与角度,提升识别准确率。
(3)效用评估与位姿选择
分别计算两类候选位姿的效用值,选择最高值作为下一步目标:
- 前沿效用函数:由方向启发值与导航成本加权得到。方向启发值衡量当前前沿点与下一个目标地标的方向一致性,越靠近目标方向得分越高;导航成本为机器人到该点的欧氏距离。
- 视点效用函数:由对应标识的识别置信度与导航成本加权得到,置信度越高,越值得凑近观测。
- 平衡参数β:控制探索与利用的权重,论文默认值为9。β越小越偏向探索,β越大越偏向利用。
- 路径规划采用Open Motion Planning Library的RRT*算法,保证碰撞-free通行。
(4)坐标动态对齐
当机器人识别到2个及以上地标后,通过RANSAC+ICP算法,将在线构建的环境地图与2D场所地图做坐标变换对齐,后续即可用地标相对位置做精确的方向引导。
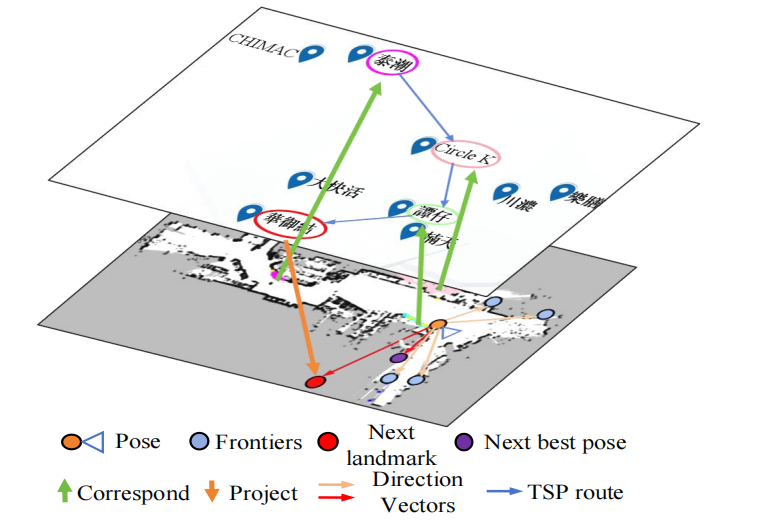
图 4 基于坐标变换的下一个地标方向估计 来源:Chen et al., 2025
三、实验结果与性能边界
3.1 标识识别性能
测试设置:2个真实商场场景,18个店铺标识,每个标识采集5个不同视角的图像;对比4类主流方法。
实验结果(来源:原论文表II):
| 方法 | Recall@1 | Recall@2 |
|---|---|---|
| CLIP | 28.9% | 35.6% |
| 中文CLIP | 28.9% | 45.6% |
| ESTextSpotter(纯OCR) | 52.2% | 52.2% |
| 字体渲染检索 | 62.2% | 73.3% |
| 本文方法(DiffusionRR) | 77.8% | 87.8% |
结论:
- 本文方法较纯OCR方案Recall@1提升25.6个百分点,较字体渲染检索方案提升15.6个百分点,证明扩散生成的图像更贴近真实场景,特征匹配效果更优。
- Recall@2较Recall@1提升10个百分点,说明结合邻场地标缩小匹配范围,可进一步提升识别准确率。
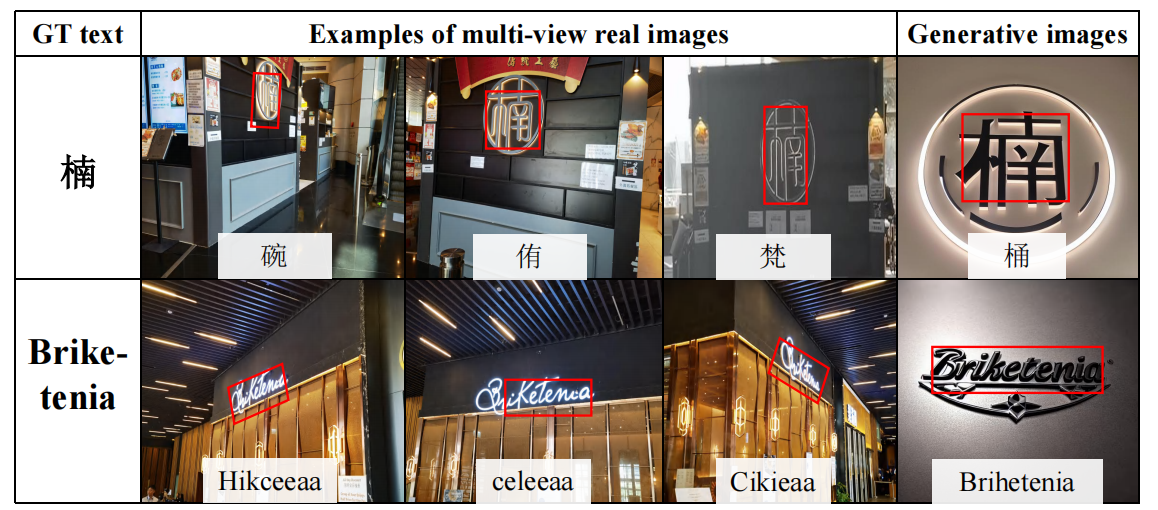
图 5 开放场景标识识别效果对比:左侧为真实多视角图像,右侧为扩散生成图像 来源:Chen et al., 2025
3.2 探索效率
测试设置:两个商场场景(场景1含4个地标,场景2含9个地标),基线为传统RRTs前沿探索方法;评价指标为标识覆盖数量、单标识平均探索时间。
实验结果(来源:原论文表III,场景2起点1):
| 方法 | 标识覆盖数(共9个) | 平均探索时间 |
|---|---|---|
| RRTs基线 | 3.33 ± 0.58 | 186.67s |
| 本文方法 | 7.00 ± 1.00 | 93.40s |
结论:
- 9地标场景下,本文方法标识覆盖数提升110%,单标识探索时间缩短约50%。
- 场景规模越大、地标越多,方案的效率优势越明显,核心原因是场所地图的方向引导大幅减少了无效探索路径。
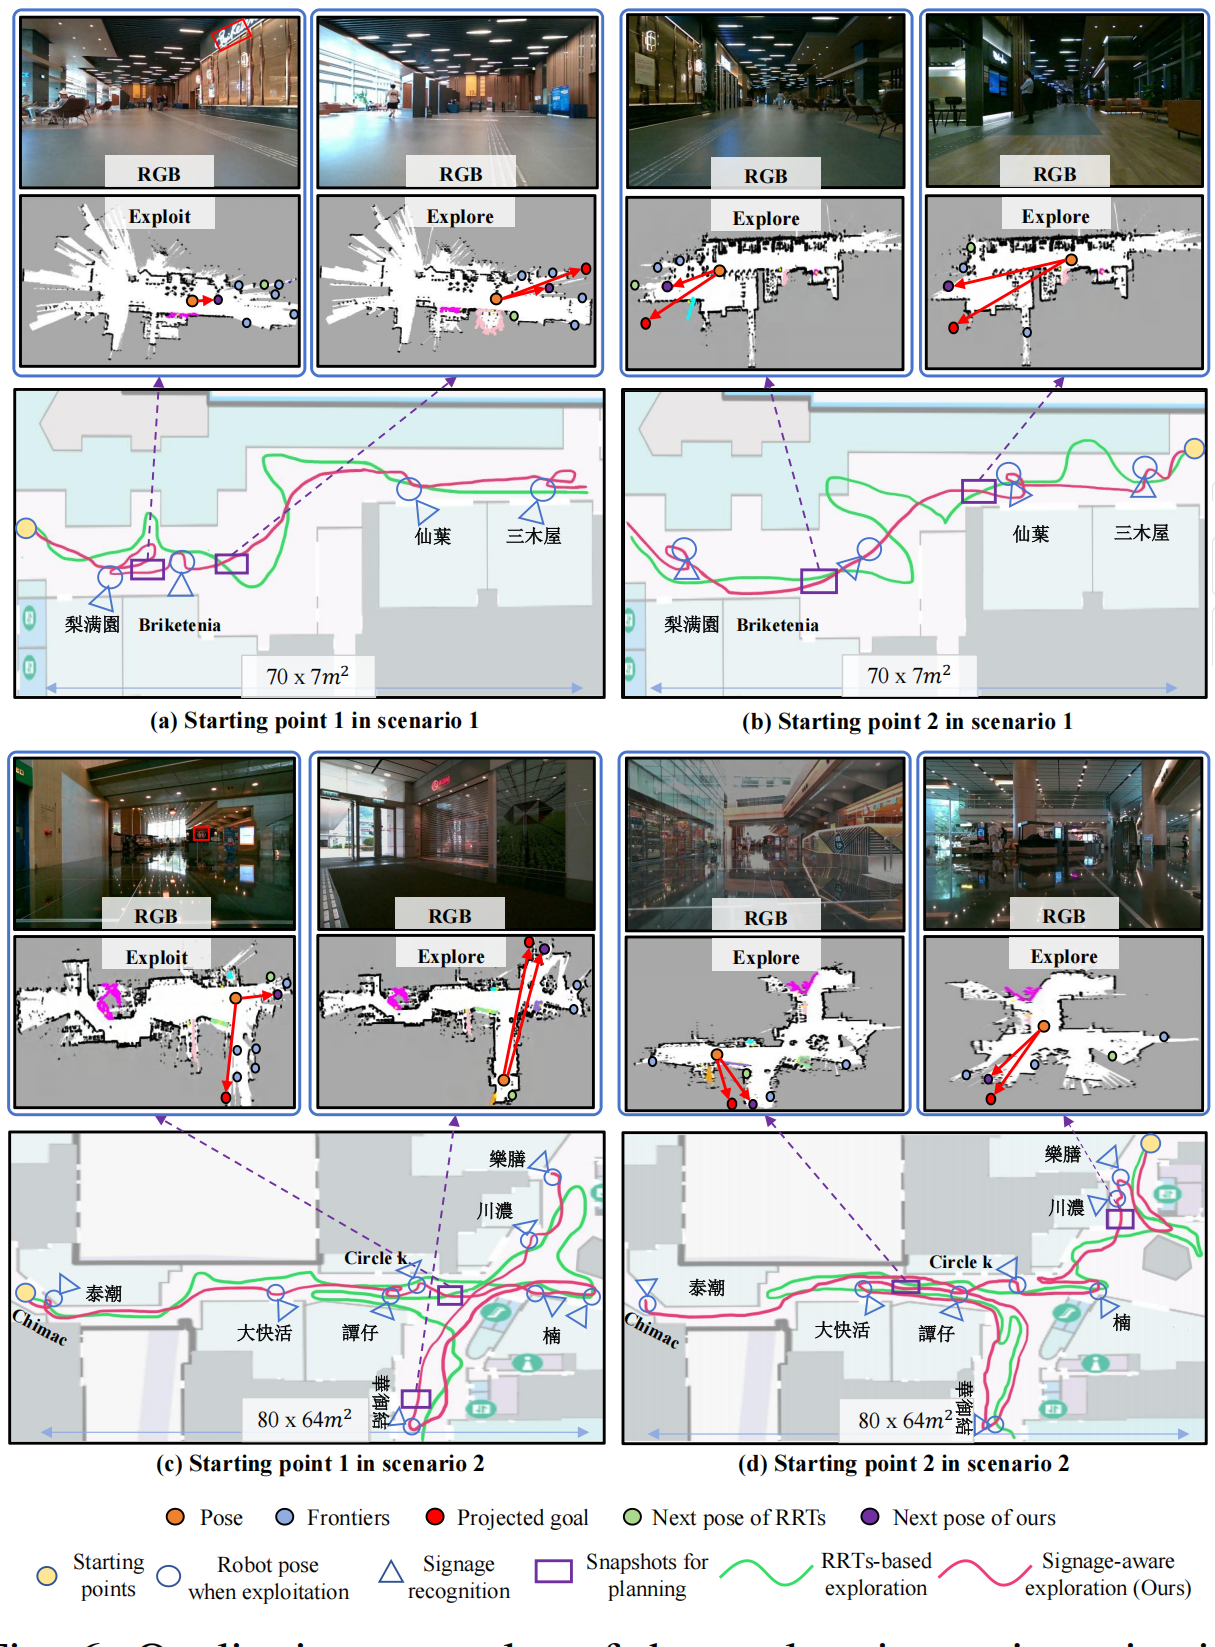
图 6 四种场景下的探索轨迹对比:绿色为 RRT 基线方法,红色为本文方法 来源:Chen et al., 2025
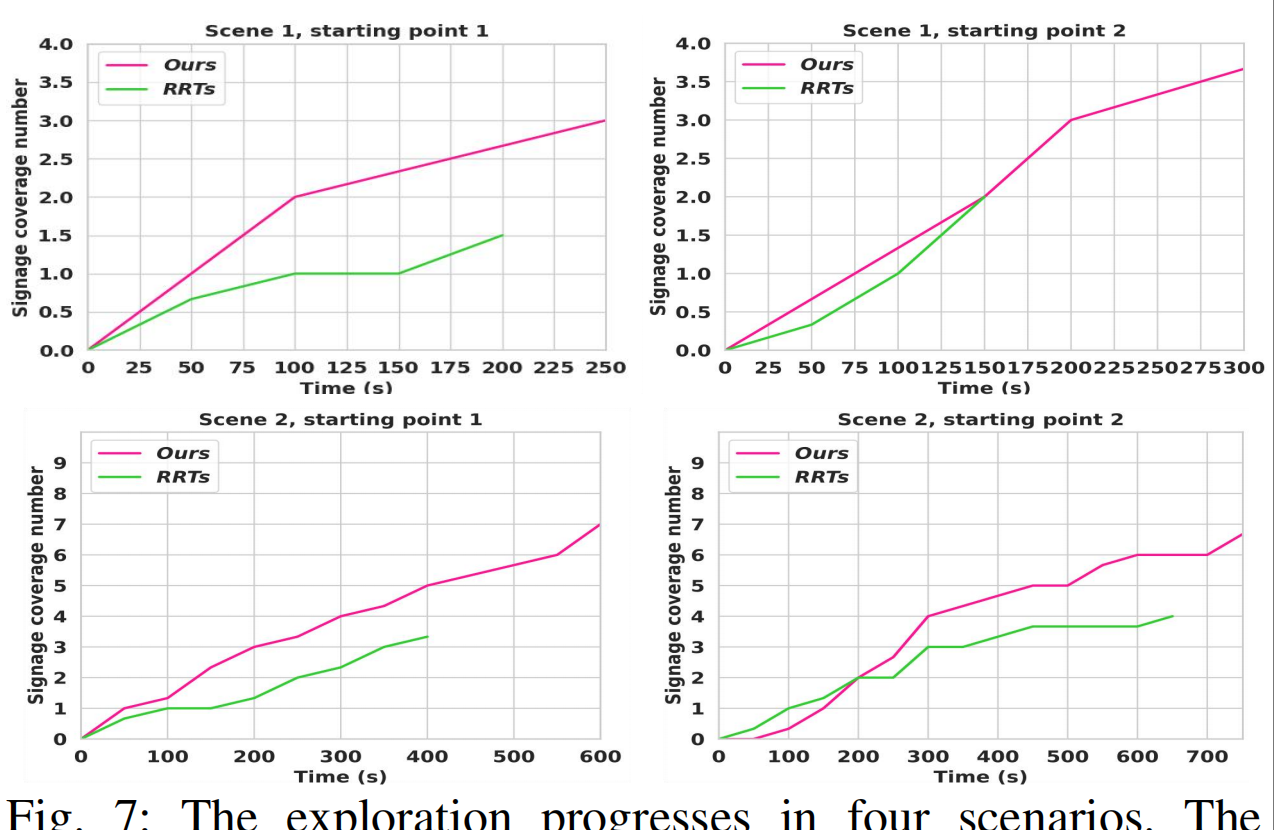
图 7 探索进度曲线:横轴为时间,纵轴为已覆盖标识数量 来源:Chen et al., 2025
3.3 消融实验:平衡参数β的影响
测试设置:场景2起点1,验证β=3、9、15三种取值的性能差异(来源:原论文表IV)。
| β取值 | 标识覆盖数(共9个) | 平均探索时间 | 特性说明 |
|---|---|---|---|
| 3 | 6.00 ± 1.00 | 143.17s | 偏向探索,易漏检近距离标识 |
| 9(默认) | 7.00 ± 1.00 | 93.40s | 探索与利用平衡最优 |
| 15 | 6.67 ± 0.58 | 123.99s | 偏向利用,难以触达远处地标 |
3.4 局限性与适用边界
- 稀疏标识场景效果下降:环境中标识数量过少时,会影响坐标对齐精度,需结合传统几何SLAM方案补充。
- 特殊标识适配不足:LED发光标识易出现过曝,影响检测效果;多语言混合标识会产生特征干扰。
- 场景验证范围:目前仅在室内商场场景完成验证,户外复杂光照、严重遮挡场景的性能需进一步测试。
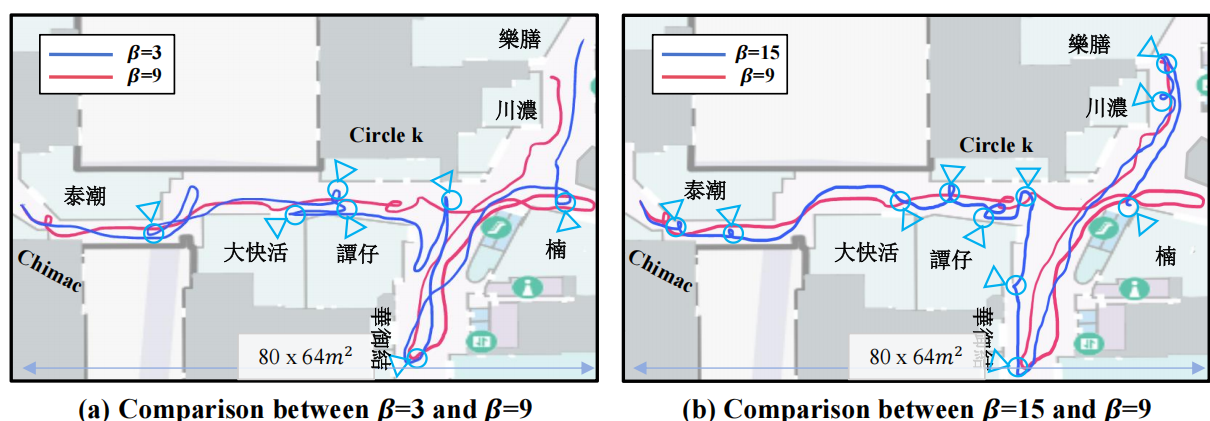
图 8 不同 β 值的探索轨迹对比:(a)β=3 偏探索;(b)β=15 偏利用 来源:Chen et al., 2025
四、对启元机器人开发实践的参考
4.1 场景价值适配
(1)家庭场景:降低语义导航门槛
启元T1机器人当前涉及家庭服务场景,可基于该方案优化"找房间""找物品"类导航功能:
- 用用户上传的户型图作为场所地图,结合房间门牌、家具标识、物品标签构建特征库,无需提前完成全屋高精度激光建图,即可实现粗粒度语义导航。
- 搭配T1的四足通行能力,可适配复式、多楼层家庭场景,通过楼层标识与户型图匹配,自动切换楼层地图。
(2)商用场景:快速部署轻量导览
针对商场、写字楼、展馆等商用场景,该方案可大幅降低部署成本:
- 无需逐区域做高精度建图,仅需官方导览图、楼层示意图即可快速部署导览、配送功能。
- T1的低噪轮式模式适配室内公共环境,四足模式可应对台阶、斜坡,结合标识感知可覆盖更多商用场景。
(3)开发者生态:标准化能力组件
可将"场所地图+标识感知"封装为标准Skill组件,开放到启元开发者社区:
- 提供特征库生成工具、拓扑地图转换模板,开发者无需从零开发,即可快速定制场景化导航Skill,如写字楼文件配送、博物馆展品导览等。
- 降低二次开发的技术门槛,丰富启元生态的场景覆盖。
4.2 工程落地分步建议
阶段1:标识识别模块验证
- 离线特征库搭建:基于模型,针对家庭/目标商用场景生成标识图像,用ESTextSpotter提取特征,构建场景专属特征库。
- 端侧识别适配:对接相机,接入2D文本检测与3D特征融合逻辑,验证室内常见标识的识别召回率,目标达到70%以上。
阶段2:探索规划模块集成
- 拓扑地图工具开发:实现2D场所图自动转拓扑图的工具,支持用户上传图片格式的户型图、导览图,自动提取地标与拓扑关系。
- 规划器融合:在现有导航框架基础上,增加视点效用评估逻辑,支持按场景动态调整β参数;
- 场景联调:在家庭、小型商超场景完成端到端测试,验证地标搜索效率与路径合理性。
阶段3:生态开放与场景拓展
- 将标识感知导航封装为标准Skill接口,配套开发文档与示例工程,同步上传至AtomGit社区。
- 拓展多模态标识能力,从纯文字标识扩展到Logo、典型物品特征,适配更多家庭与公共场景。
4.3 论文与实践的区别
- 不替代传统建图,二者互补:该方案适合快速部署、粗粒度语义导航,精准避障、精细操作仍需激光/视觉SLAM建图配合,不能完全替代底层建图能力。
- 家庭场景需补充语义维度:家庭场景标识密度远低于商场,需将"标识"范围从文字扩展到家具、家电等典型物体特征,保证定位与导航精度。
- 端侧算力约束:原论文实验平台为Jetson Orin NX(157TOPS),识别速度约2fps。启元端侧部署需做模型轻量化与算子优化,或采用异步处理架构,避免影响导航实时性。
- 参数场景化配置:不同场景采用不同β值,家庭空间小、标识少可适当调大β,侧重精准识别;大空间商场景观可适当调小β,侧重探索效率。
五、自我思考
这篇论文的核心价值,是提出了一条"低先验、低成本"的语义导航路线:无需高精度建图,仅用日常随处可得的2D场所示意图,结合视觉标识识别,即可让机器人在未知场景中高效完成地标搜索。
对启元而言,该方案既可以强化家庭场景的语义导航体验,降低用户使用门槛,也可以支撑商用场景的快速拓展,同时能够以Skill组件的形式丰富开发者生态,具备从技术验证到产品落地再到生态建设的完整参考价值。后续可优先在家庭场景开展小范围验证,逐步迭代优化。
附录:标识特征库生成简化实现demo
python
import cv2
import torch
import numpy as np
from anytext import AnyTextPipeline
from est_spotter import ESTextSpotter

# 设备与模型初始化
device = "cuda" if torch.cuda.is_available() else "cpu"
anytext_pipe = AnyTextPipeline.from_pretrained("anytext-v1.0").to(device)
est_spotter = ESTextSpotter.from_pretrained("est_spotter-v1.0").to(device)

def generate_sign_feature(landmark_name: str) -> np.ndarray:
    """
    输入地标名称,生成模拟标识图像并提取对应文本特征
    :param landmark_name: 地标名称,如"客厅"、"便利店"
    :return: 512维文本特征向量
    """
    # 扩散模型生成真实风格标识图像
    prompt = f"室内场景的标识牌,上面清晰写着'{landmark_name}',常规字体,正面视角"
    gen_image = anytext_pipe(prompt).images[0]
    image_np = np.array(gen_image)

    # 检测文本区域并提取特征
    _, feature_list = est_spotter.detect_and_extract(image_np)

    # 取置信度最高的区域特征,无检测结果则返回零向量
    if len(feature_list) > 0:
        return feature_list[0]
    return np.zeros(512, dtype=np.float32)

def build_landmark_feature_pool(landmark_list: list, save_path: str) -> None:
    """
    根据地标列表构建特征库并保存
    :param landmark_list: 地标名称列表
    :param save_path: 特征库保存路径
    """
    feature_pool = {}
    for name in landmark_list:
        feature_pool[name] = generate_sign_feature(name)

    torch.save(feature_pool, save_path)
    print(f"特征库构建完成,共{len(feature_pool)}个地标,已保存至{save_path}")

# 示例:构建家庭场景地标特征库
if __name__ == "__main__":
    home_landmarks = ["客厅", "主卧", "厨房", "书房", "卫生间"]
    build_landmark_feature_pool(home_landmarks, "home_feature_pool.pt")