前言
自从 OpenAI 在 2026 年 4 月 21 日推出 GPT Image 2.0 模型之后,你会发现你使用 ChatGPT 生图服务时,它相比于以前的 GPT Image 1.5 完全能生成正确的汉字。1.5 的时代生成的汉字很大概率都是偏旁部首错位的。本篇文章给各位来揭秘一下为什么 GPT Image 2.0 可以生成正确的汉字。
GPT-Image-2诞生历程
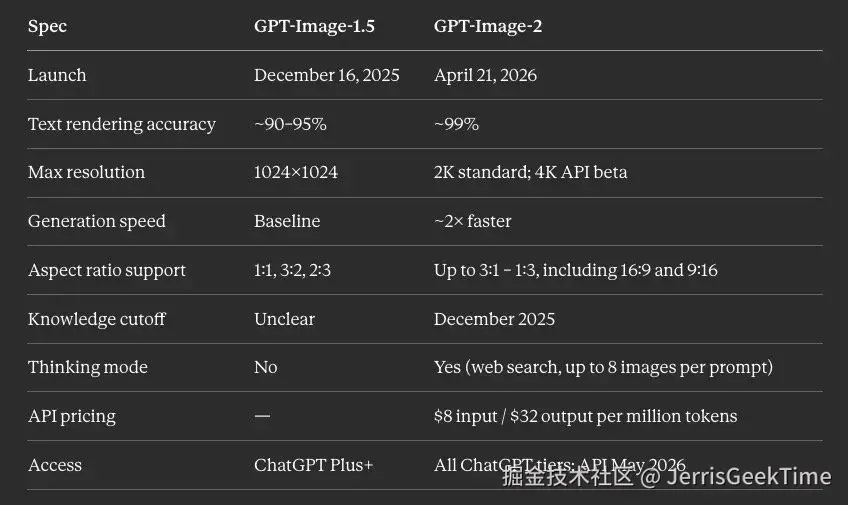
OpenAI 的生图模型发布时间线为:GPT-Image-1(2025 年 3 月)→ GPT-Image-1.5(2025 年 12 月)→ GPT-Image-2(2026 年 4 月 21 日)。每一次迭代都是一次真正的进步。GPT-Image-1 将图像生成功能直接集成到 ChatGPT 中,并且在处理复杂的多对象合成图像方面优于 DALL-E 3。GPT-Image-1.5 速度更快,指令执行能力也更强。而 GPT-Image-2 则完全不同。
研究负责人陈博远将其描述为"图像通用模型"------图像版的 GPT,而非 GPT-4o 视觉流程的改进版。该架构完全从零开始重建。模型 ID 为 gpt-image-2,快照版本为 gpt-image-2-2026-04-21。该消息由 CEO Sam Altman 协调发布,开发者简报和 API 文档也于当日上线。
时间安排并非偶然。DALL-E 2 和 DALL-E 3 将于 2026 年 5 月 12 日关闭。GPT-Image-2 是 OpenAI 的完全替代方案。
非拉丁文字支持是其主要亮点。GPT-Image-2 专门针对中文、日文、韩文(中日韩)、印地语和孟加拉语的文本渲染。TechCrunch 的早期评测称其渲染结果"像素级完美"。VentureBeat 指出,其在用户界面和屏幕截图的保真度方面超越了谷歌的 Nano Banana 2。
文本渲染问题及其重要性
人工智能图像模型从一开始就存在文本处理问题。拼写错误、字符扭曲、单词间距错乱------这些问题如此普遍,以至于成了业内对人工智能局限性的代名词。到了 2023 年,你甚至无法生成一份餐厅菜单,因为模型总会创造出诸如"enchuita"(墨西哥辣香肠)和"churiros"(西班牙辣香肠)之类的菜名。直到 2025 年末,任何需要可靠图像文本的提示都需要人工校对。
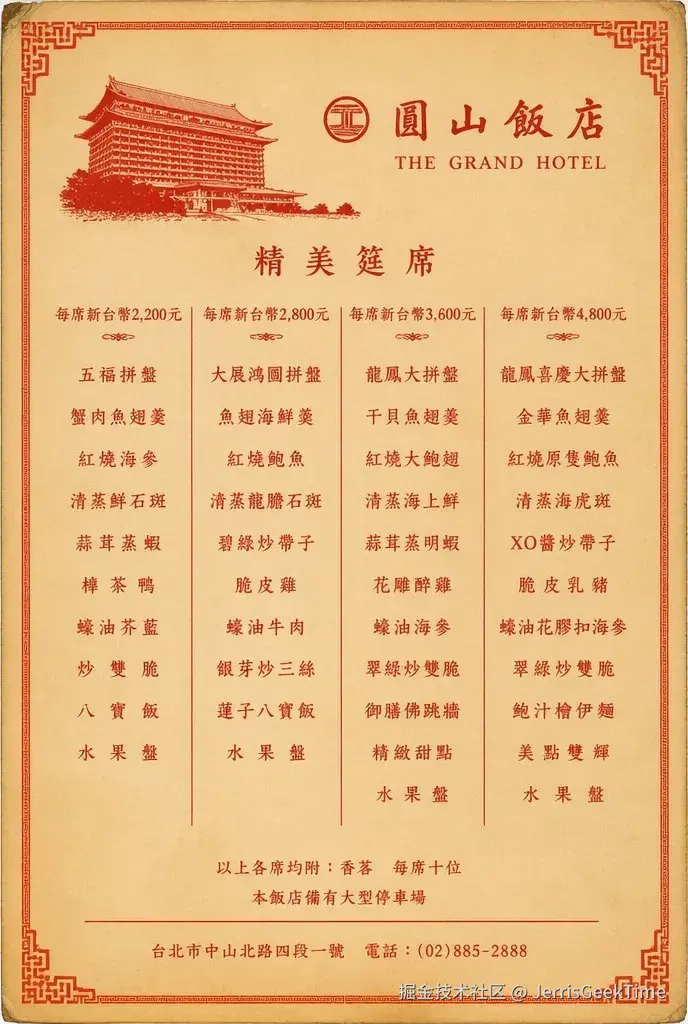
GPT-Image-2 不仅在此基础上有所改进。根据 OpenAI 的新闻稿以及 TechCrunch 的测试结果,它能够以高达 2K 的分辨率生成"小文本、图标、UI 元素、密集构图以及细微的风格约束"。99% 的准确率是内部基准,但自发布以来,实际测试已基本验证了其对拉丁字母和中日韩文字的有效性。
实际意义在于:过去需要人工设计师在人工智能生成文本后添加文字的工作流程,现在只需一次模型调用即可完成。广告创意可以添加真实的标题,产品模型可以添加真实的品牌文案,说明图表的标签也完全正确。这些都与六个月前截然不同。
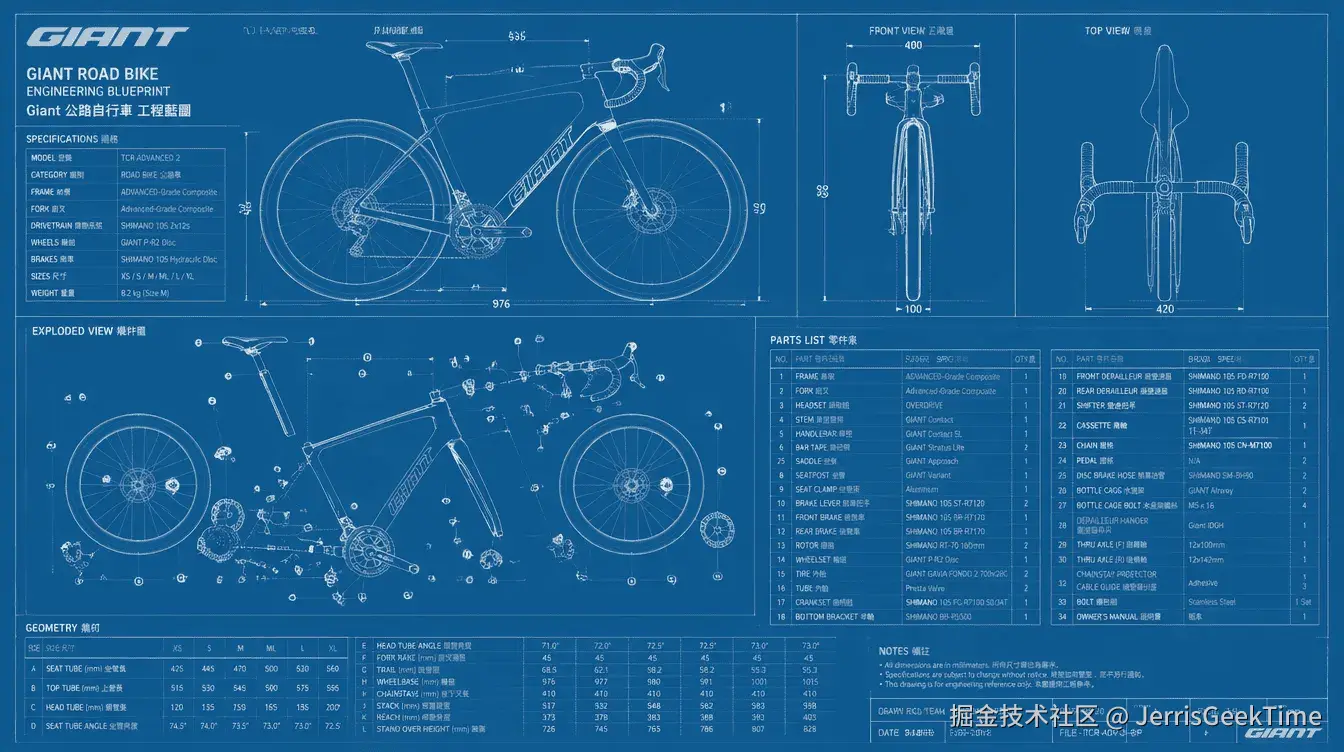
使用 GPT-Image-2 生成的自行车图纸:
问题本质:文字建模能力
GPT Image 2.0 之所以能够比较精准地生成汉字,关键并不是它突然学会了像 Word 一样"输入文字",而是图像生成模型对文字的视觉结构、语言规律和图文对应关系的建模能力得到了提升。
上述问题的本质其实是:"这与传统图像生成模型的训练目标有关"。
假设你让模型生成一张写着"人工智能"的海报。对于图像模型而言,这不仅仅是生成六个字符,还需要同时处理:
- 每个字符的具体笔画和空间结构。
- "人""工""智""能"之间的字符差异。
- 字体、字号、字距、行距与背景的关系。
- 文字是否清晰,以及它是否与整个画面协调。
汉字尤其具有挑战性。一个字符可能包含很多笔画,而少一笔、多一笔,或者将两个相似偏旁混淆,都可能改变字符含义。
传统扩散模型通常是在连续的图像表示上逐步生成内容。它们擅长捕捉"看起来像什么",但不一定能严格保证"这个字符究竟是什么"。
这就是视觉相似性与字符精确性之间的区别。
更好地学习了汉字的视觉结构
汉字不是随机组合的线条,而是有规律的二维结构。
例如,"晴"和"睛"都有相似的右半部分,但左侧偏旁不同;"未"和"末"只有细微的笔画位置差异,却是两个不同的字。
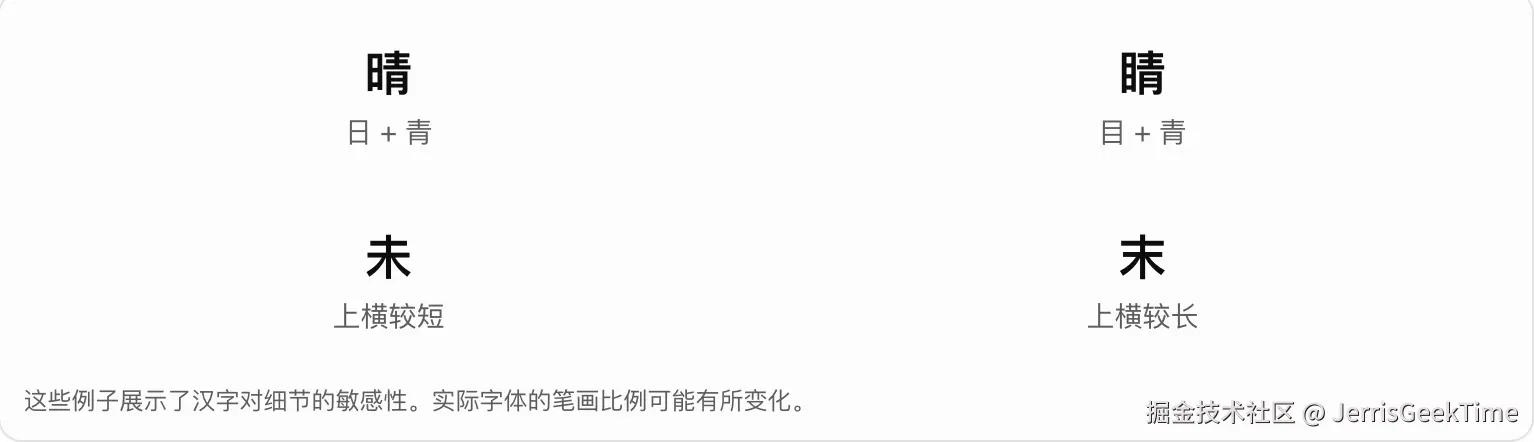
要把这些字符生成正确,模型必须学习的不只是整体轮廓,还包括局部笔画、部件之间的空间关系,以及这些细节如何组合成完整字符。
从通用模型原理来看,更高质量的图文训练、更强的视觉表征,以及更精细的图像生成能力,都可能对此有所帮助。但 OpenAI 并未公开 GPT Image 2.0 究竟采用了哪种专门的汉字结构训练方法,因此不能断言它内部一定存在独立的汉字识别器或笔画生成模块。
文字的语义和字形可以更好地协同
传统绘图模型可能知道"科技海报通常有标题",却不一定能稳定地把指定标题写对。
例如,你要求生成一张海报,标题必须是:
让 AI 真正理解代码
这里至少存在两层任务:
- 语义层:理解这句话的含义,知道它是海报标题,而不是背景说明。
- 视觉层:将指定文字转换成对应的汉字形状,并放在合适的位置。
模型的指令遵循和多语言文字生成能力提升后,这两个环节可以更好地配合:既理解应该写什么,也更好地生成这些字应该呈现的视觉形式。
不过,这并不意味着它采用了"先调用文字排版引擎,再把文字贴到图片上"的固定流程。仅凭生成效果,无法确定内部采用的是独立排版、联合生成,还是其他混合架构。
文字密集场景的生成能力提高了
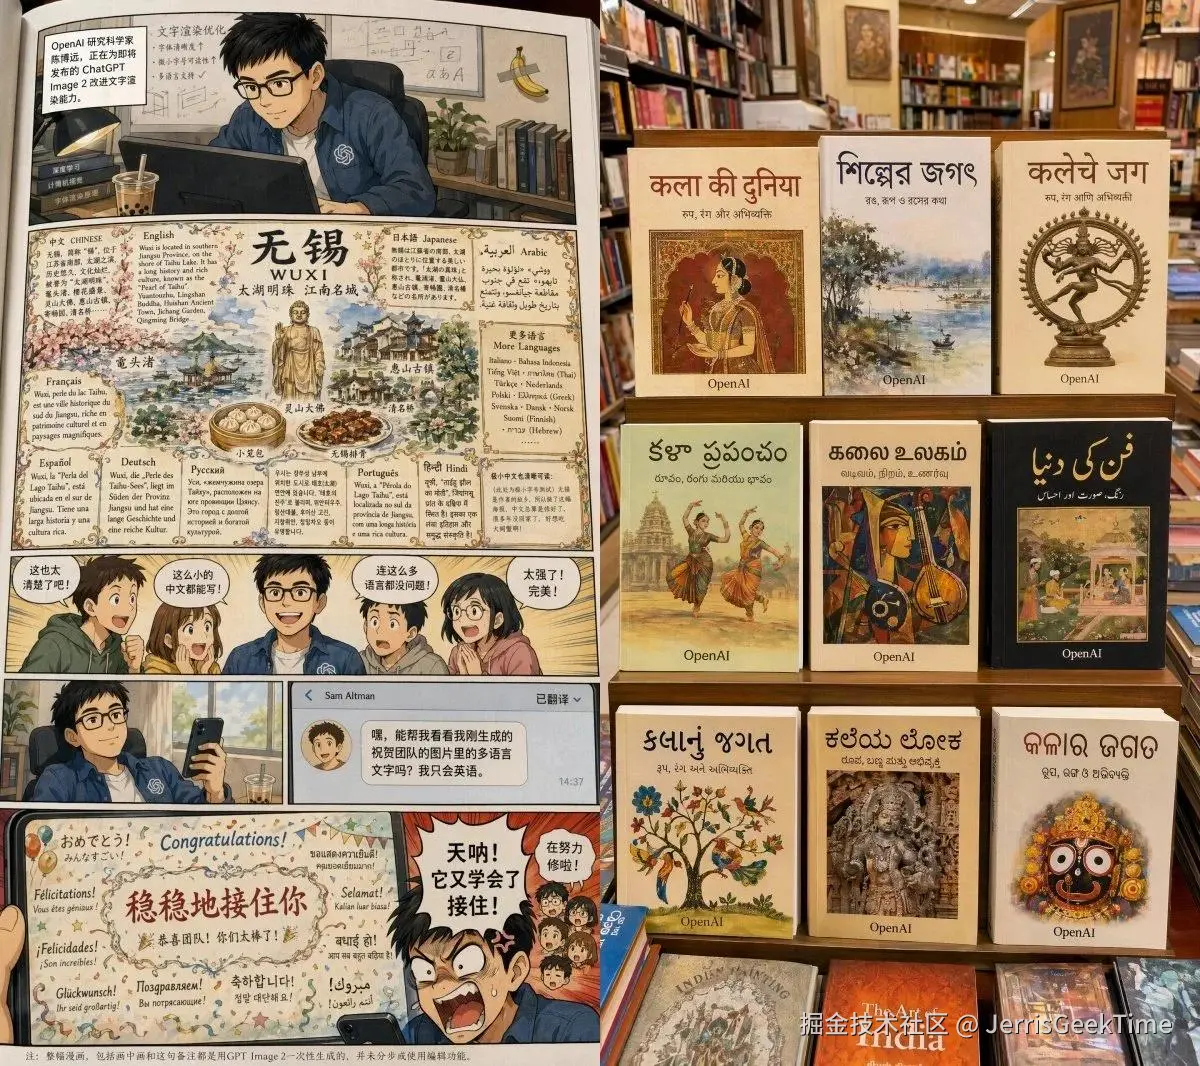
生成一个孤立的大字,与生成一张包含几十个文字元素的信息图,是完全不同的难度。
后者还要求模型处理:
- 不同文字区域之间的层级关系。
- 多行文字的排列与对齐。
- 小字号下的笔画清晰度。
- 标题、正文、数字、图标之间的空间关系。
GPT Image 2.0 的官方发布材料明确强调了密集文字和多语言文字渲染方面的改进。
这意味着它的提升不只是把单个汉字画得更像,而是更有能力在一张复杂画面中维持多个文字区域的可读性。
推理能力可以帮助复杂任务,但它不是万能的
GPT Image 2.0 还引入了带思考能力的图像生成工作流。官方系统卡介绍,这种模式可以结合推理、工具使用和联网搜索等能力,处理更复杂的创作任务。
例如,当你要求制作一张中文技术信息图时,系统可以在生成过程中更充分地考虑:
- 信息应该如何组织。
- 哪些内容应该成为主标题。
- 文字与图形应该如何布局。
- 复杂指令之间是否存在冲突。
但要注意:推理能力可以帮助规划画面,不等于每个汉字都经过了 OCR 校验。 即使整体布局很好,具体字符仍然可能出现错字、漏字或笔画异常。
到底是理解汉字还是把汉字画出来
严格来说,这两者并不完全相同。可以用三个层次来理解:
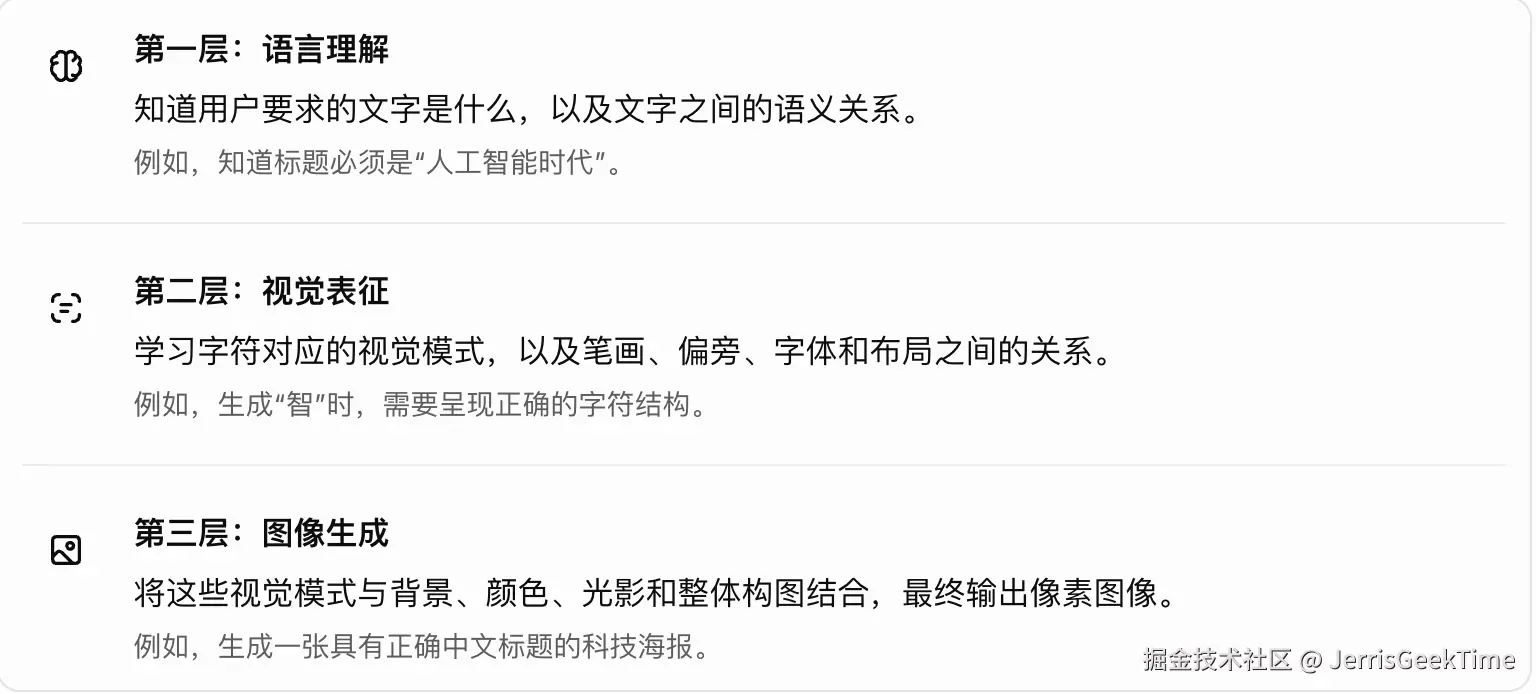
这三个层次是帮助理解的概念模型,不是 OpenAI 已公开确认的 GPT Image 2.0 内部模块划分。
真正值得注意的是:模型不一定需要像人一样逐笔书写,也不一定需要先把文字转换成标准字体文件。它可以通过训练学到文字的视觉规律,并在图像生成过程中复现这些规律。
做到100%精准?
不能。即使是 GPT Image 2.0,官方图像生成文档仍然指出,精确的文字位置和清晰度等方面可能存在问题。
不同任务的难度也不一样:
| 任务 | 主要难点 |
|---|---|
| 生成一个大号中文标题 | 字形与指定内容准确 |
| 生成多行中文海报 | 字符准确、排版与层级 |
| 生成小字号中文信息图 | 笔画清晰度与字符区分 |
| 生成大量连续中文段落 | 长文本完整性、错漏字 |
| 生成专业术语或生僻字 | 低频字符与细节结构 |
尤其要区分两件事:看起来像汉字,不代表文字内容正确;画面很漂亮,也不代表文字没有错误。
如果用于正式出版、产品包装、品牌标识或技术信息图,建议对生成结果进行 OCR 检查,再逐字校对。对文字要求极高的场景,也可以先让图像模型生成背景和装饰,再使用 SVG、Canvas 或专业排版工具叠加真实文字。
总结:真正的技术突破是什么?
GPT Image 2.0 的汉字生成能力,可以概括为三个方面的协同提升:
- 语言与指令理解更强:更准确地理解需要呈现什么内容。
- 文字视觉建模更强:更好地生成复杂字符、密集文字与多语言排版。
- 整体图像控制更强:更好地将文字融入构图,同时兼顾细节和视觉效果。
这些能力的提升是 OpenAI 已公开描述的方向;至于具体通过什么网络结构、训练数据配比、损失函数或字符级监督实现,公开资料还不足以给出确定答案。
我认为最值得关注的不是 AI 终于能把汉字画对了,而是图像生成模型正在从"根据描述绘制一幅画",走向"根据约束生成一份可用的视觉作品"。文字准确性只是其中一环,布局、语义、细节一致性和可编辑性同样重要。
学习资料
给大家推荐一个学习人工智能理论基础的网站:人工智能学习网,这里面有丰富的人工智能专业的学习资料。