虚拟线程不是无限并发:Java Agent 后端真正该限制的是这些资源
Java 服务改用虚拟线程后,最危险的误解不是 API 用错,而是把"线程更便宜"理解成"系统可以无限并发"。
虚拟线程确实改变了阻塞式 Java 服务的成本结构。过去,一个请求占住一个平台线程等待数据库、HTTP 或模型响应,平台线程很快成为扩展瓶颈;现在,等待中的虚拟线程可以暂时卸载,让少量载体线程继续执行其他任务。我们因此能够用更直观的 thread-per-request 写法承载更多阻塞型任务。
但虚拟线程只放宽了执行载体这一层。数据库连接、HTTP 连接、模型服务配额、外部工具并发、CPU、内存和消息消费者能力并没有随之增加。线程入口一旦变得足够便宜,真正稀缺的资源反而会更快暴露:更多任务同时去借连接、发 RPC、请求模型,最终在下游排队、超时和重试。
所以,采用虚拟线程之后,容量治理的中心必须从"线程池开多大"转向另一个问题:每一种真实稀缺资源,允许多少在途工作,又该如何排队、拒绝、超时和观测?
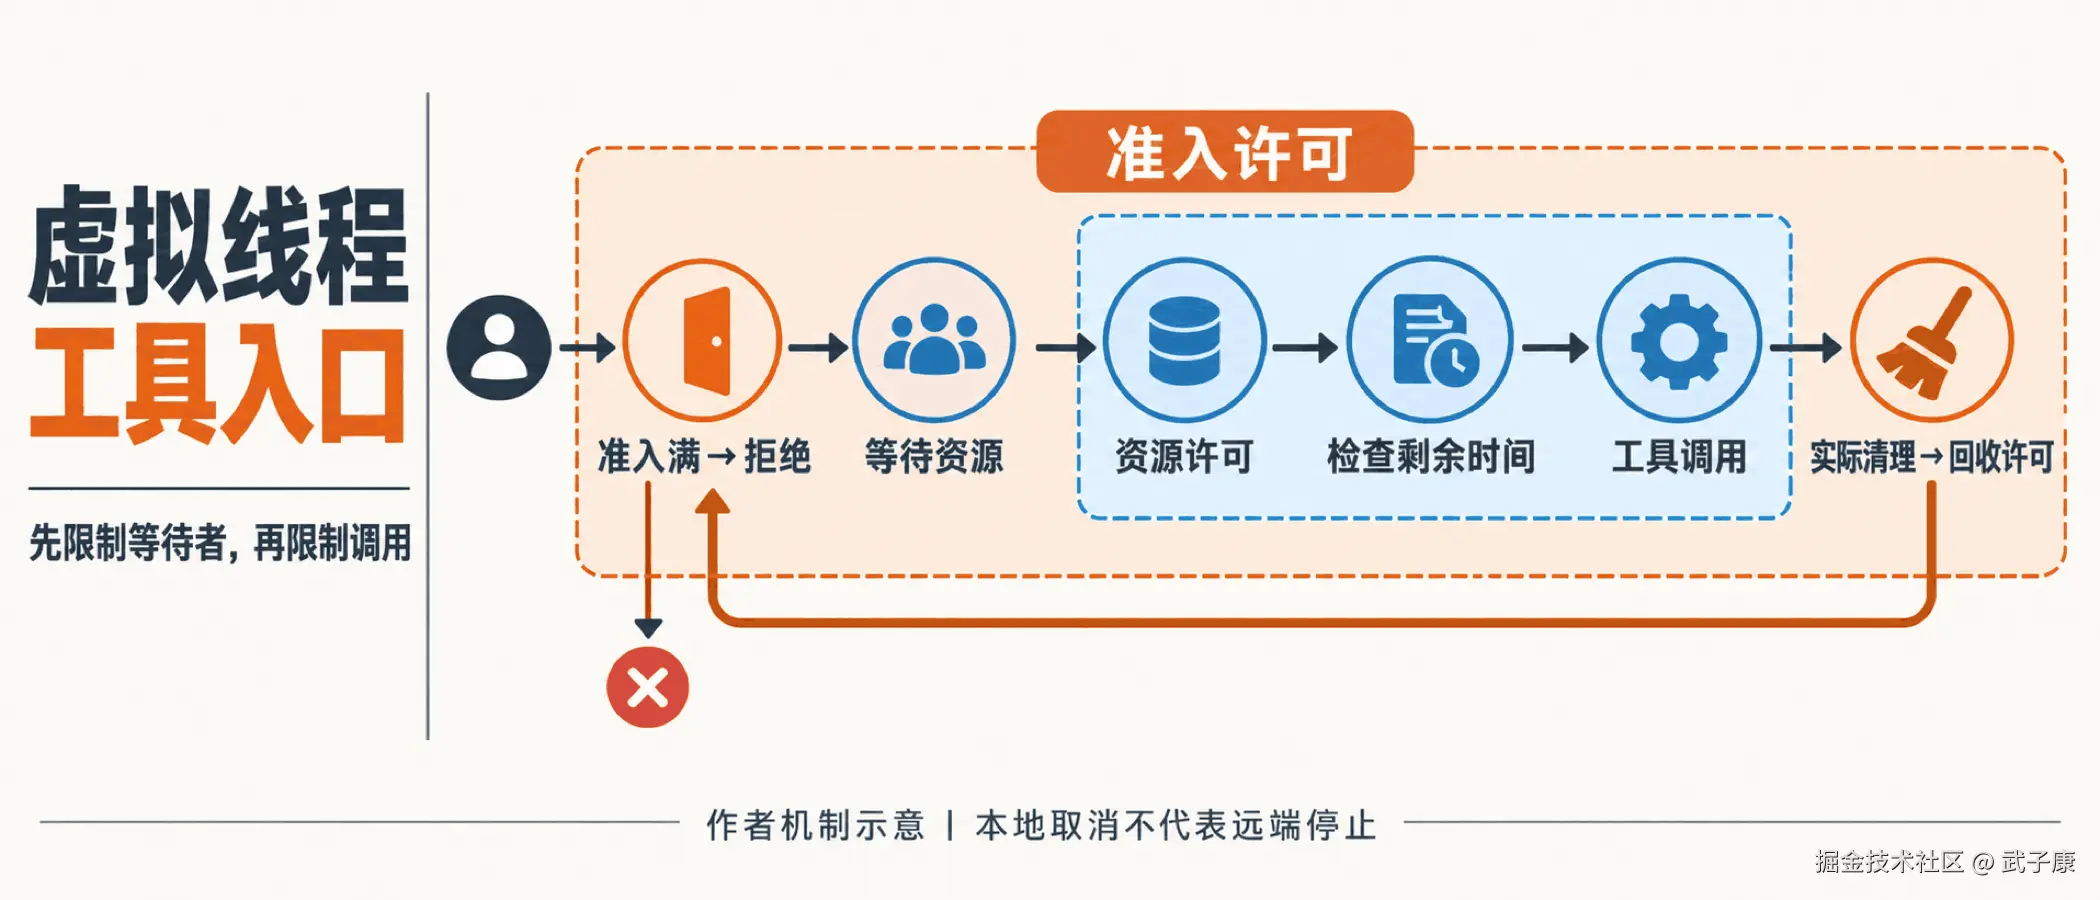
一、先把两个并发概念拆开
传统平台线程昂贵,线程池通常同时承担两个职责:
- 复用有限的平台线程,避免频繁创建与销毁;
- 通过线程数和队列,间接限制同时运行的任务量。
虚拟线程改变了第一点。OpenJDK JEP 444 对 JDK 21 虚拟线程的说明指出,虚拟线程仍然是 java.lang.Thread,适合大量主要等待阻塞 I/O 的任务;推荐的方式是每个任务创建一个虚拟线程,而不是为了复用去建立"虚拟线程池"。它的目标主要是提高 thread-per-request 服务的吞吐,不是降低单个请求的延迟,也不是加速 CPU 密集计算。
这不意味着第二个职责消失了,只意味着并发限制不应该继续绑在线程数量上。
我们需要明确区分:
| 概念 | 它回答的问题 | 虚拟线程带来的变化 |
|---|---|---|
| 执行并发 | 有多少任务可以拥有一个执行上下文 | 创建和等待成本显著降低 |
| 资源并发 | 有多少任务可以同时占用某个稀缺资源 | 数据库、模型、HTTP、CPU 等容量不变 |
例如,一个 Agent 请求可能依次访问向量库、模型服务、业务数据库和三个外部工具。为每个请求创建虚拟线程很合理,但如果所有请求都能不受控制地进入四类下游,系统只是把"等待平台线程"改成"等待连接、额度或远端响应"。
虚拟线程解决的是等候方式,不是容量守恒。
二、不要给虚拟线程建池,要给稀缺资源设闸门
"每任务一个虚拟线程"经常被误读为"不做任何限制"。更准确的做法是:执行层按任务创建虚拟线程,资源入口通过连接池、信号量、限流器、租户配额或领域级调度器控制并发。
先看一个经常被遗漏的差别:只有资源信号量,会限制已拿到许可的调用,却允许任意多任务创建虚拟线程并等待。等待者各自保留请求对象、上下文和输入数据;即使都能在超时后退出,瞬时在途数量仍可能让内存先耗尽。Semaphore.getQueueLength() 是监控估计值,不能先读取它再据此提交,那样检查与提交之间存在竞态。
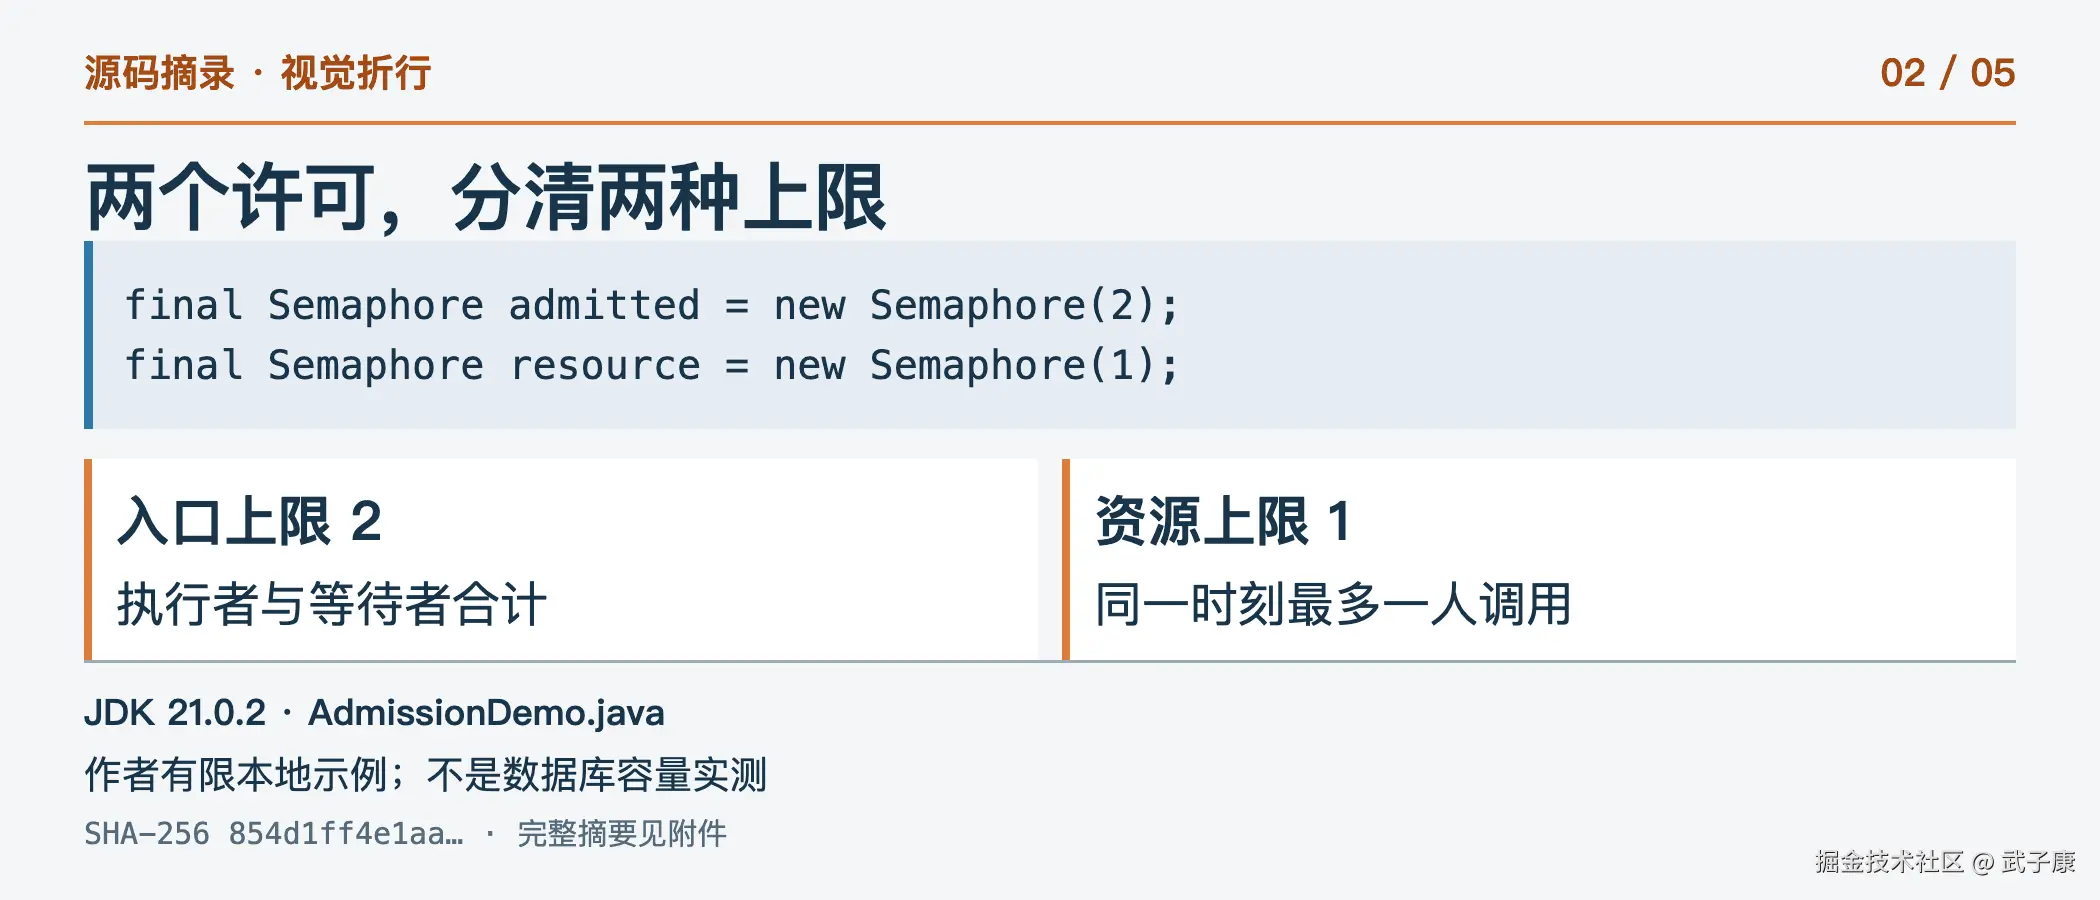
一种小实现是两道闸门。外层准入许可把"执行中加等待中"限制在有限数量;入口 tryAcquire() 失败就同步拒绝,不先创建任务。内层资源许可只包住真正的工具调用,排队消耗同一 deadline。两层不是两条无界队列,也不负责请求速率、租户公平和供应商 token 配额,这些仍是另外的约束。
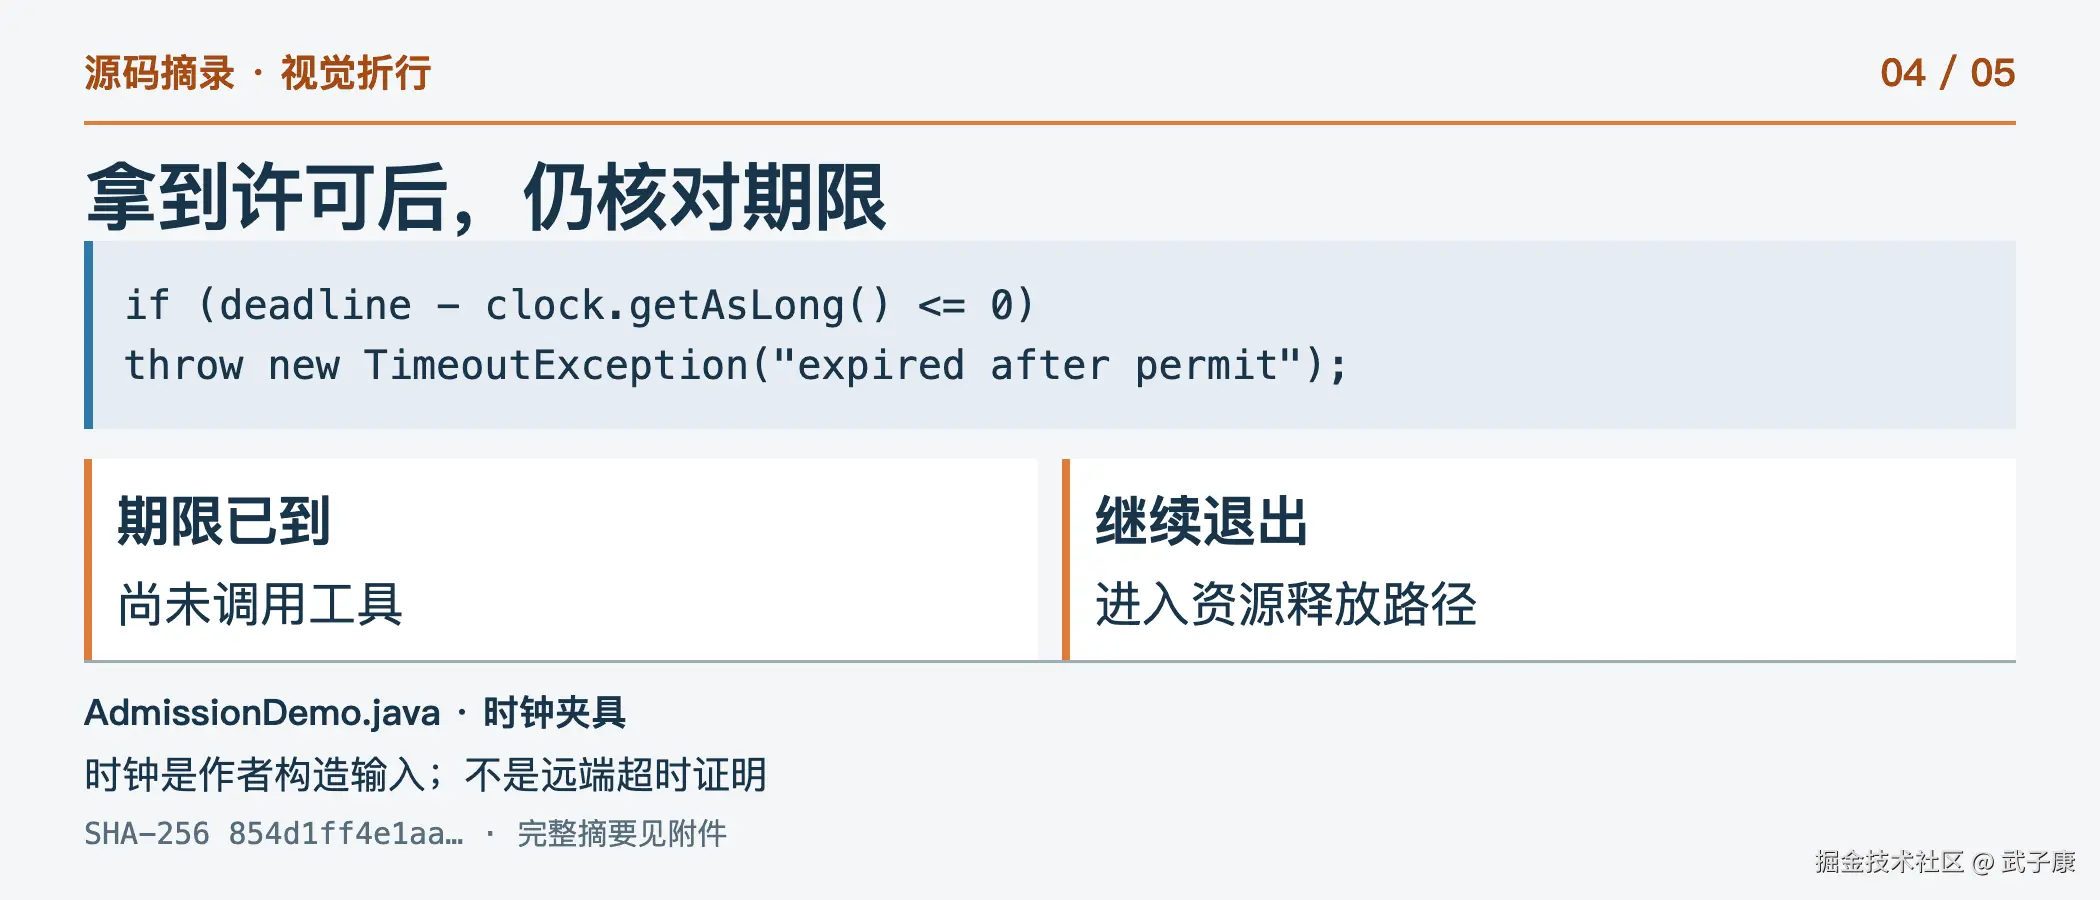
下面是完整的 JDK 21 最小示例,保存为 AdmissionDemo.java。算例把准入容量设为 2、工具并发设为 1,是为了让分支可观察,不是生产推荐值。clock 默认由调用者传入 System::nanoTime;最后一个测试使用固定单调时钟序列,专门让"已获得许可但预算已过期"的边界可重现。这个时钟算例不测操作系统的真实等待时长。
java
import java.util.concurrent.*;
import java.util.concurrent.atomic.AtomicInteger;
import java.util.function.LongSupplier;

public class AdmissionDemo {
    static final class Gate implements AutoCloseable {
        final Semaphore admitted = new Semaphore(2);
        final Semaphore resource = new Semaphore(1);
        final ExecutorService threads = Executors.newVirtualThreadPerTaskExecutor();
        final AtomicInteger active = new AtomicInteger(), peak = new AtomicInteger();
        final LongSupplier clock;
        Gate(LongSupplier clock) { this.clock = clock; }

        FutureTask<String> submit(long deadline, Callable<String> call,
                                  CountDownLatch settled) {
            if (!admitted.tryAcquire()) throw new RejectedExecutionException("admission full");
            FutureTask<String> task = new FutureTask<>(() -> {
                long remaining = deadline - clock.getAsLong();
                if (remaining <= 0) throw new TimeoutException("expired before wait");
                if (!resource.tryAcquire(remaining, TimeUnit.NANOSECONDS))
                    throw new TimeoutException("resource wait expired");
                try {
                    if (deadline - clock.getAsLong() <= 0)
                        throw new TimeoutException("expired after permit");
                    if (Thread.currentThread().isInterrupted()) throw new InterruptedException();
                    int n = active.incrementAndGet();
                    peak.accumulateAndGet(n, Math::max);
                    try { return call.call(); }
                    finally { active.decrementAndGet(); }
                } finally { resource.release(); }
            }) {
                @Override public void run() {
                    try { super.run(); }
                    finally { admitted.release(); settled.countDown(); }
                }
            };
            try { threads.execute(task); }
            catch (RuntimeException e) { admitted.release(); settled.countDown(); throw e; }
            return task;
        }
        @Override public void close() { threads.close(); }
    }
    static long deadline() { return System.nanoTime() + TimeUnit.SECONDS.toNanos(3); }
    static void check(boolean ok) { if (!ok) throw new AssertionError(); }
    static String failure(Future<?> f) throws Exception {
        try { f.get(3, TimeUnit.SECONDS); throw new AssertionError("expected failure"); }
        catch (ExecutionException e) { return e.getCause().getMessage(); }
    }
    static void await(CountDownLatch latch) throws Exception {
        check(latch.await(3, TimeUnit.SECONDS));
    }
    public static void main(String[] args) throws Exception {
        try (Gate gate = new Gate(System::nanoTime)) {
            CountDownLatch entered = new CountDownLatch(1), done1 = new CountDownLatch(1);
            FutureTask<String> holder = gate.submit(deadline(), () -> {
                check(Thread.currentThread().isVirtual()); entered.countDown();
                new CountDownLatch(1).await(); return "unreachable";
            }, done1);
            try {
            await(entered);
            CountDownLatch done2 = new CountDownLatch(1);
            FutureTask<String> waiter = gate.submit(System.nanoTime() +
                    TimeUnit.SECONDS.toNanos(1), () -> "unreachable", done2);
            String refusal;
            try { gate.submit(deadline(), () -> "unreachable", new CountDownLatch(1));
                  throw new AssertionError("expected refusal"); }
            catch (RejectedExecutionException e) { refusal = e.getMessage(); }
            check(refusal.equals("admission full"));
            System.out.println("refusal=" + refusal);
            String timed = failure(waiter); check(timed.equals("resource wait expired"));
            await(done2); System.out.println("timeout=" + timed);
            check(holder.cancel(true)); await(done1);
            check(holder.isCancelled() && gate.active.get() == 0);
            System.out.println("cancel=local interruption observed; cleanup complete");
            CountDownLatch done3 = new CountDownLatch(1);
            FutureTask<String> broken = gate.submit(deadline(), () -> {
                throw new IllegalStateException("tool failed");
            }, done3);
            check(failure(broken).equals("tool failed")); await(done3);
            System.out.println("exception=tool failed; cleanup complete");
            check(gate.peak.get() == 1 && gate.admitted.availablePermits() == 2 &&
                  gate.resource.availablePermits() == 1);
            System.out.println("peak_active=1; admission_permits=2; resource_permits=1");
            } finally { holder.cancel(true); }
        }
        AtomicInteger reads = new AtomicInteger(), calls = new AtomicInteger();
        try (Gate gate = new Gate(() -> reads.getAndIncrement() == 0 ? 0 : 2)) {
            CountDownLatch settled = new CountDownLatch(1);
            FutureTask<String> stale = gate.submit(1, () -> {
                calls.incrementAndGet(); return "unreachable";
            }, settled);
            String result = failure(stale); await(settled);
            check(result.equals("expired after permit") && calls.get() == 0 &&
                  gate.resource.availablePermits() == 1 && gate.admitted.availablePermits() == 2);
            System.out.println("clock_fixture=" + result + "; tool_calls=0; permits_restored=true");
        }
    }
}
在装有 JDK 21 的目录执行以下命令,示例不需要第三方依赖,不使用预览特性。生产 deadline 使用单调时钟的进程内纳秒值,不能把该数值直接发给另一台机器;跨进程协议应另外定义墙上时间或经过校准的剩余预算。
bash
javac --release 21 AdmissionDemo.java
java AdmissionDemo
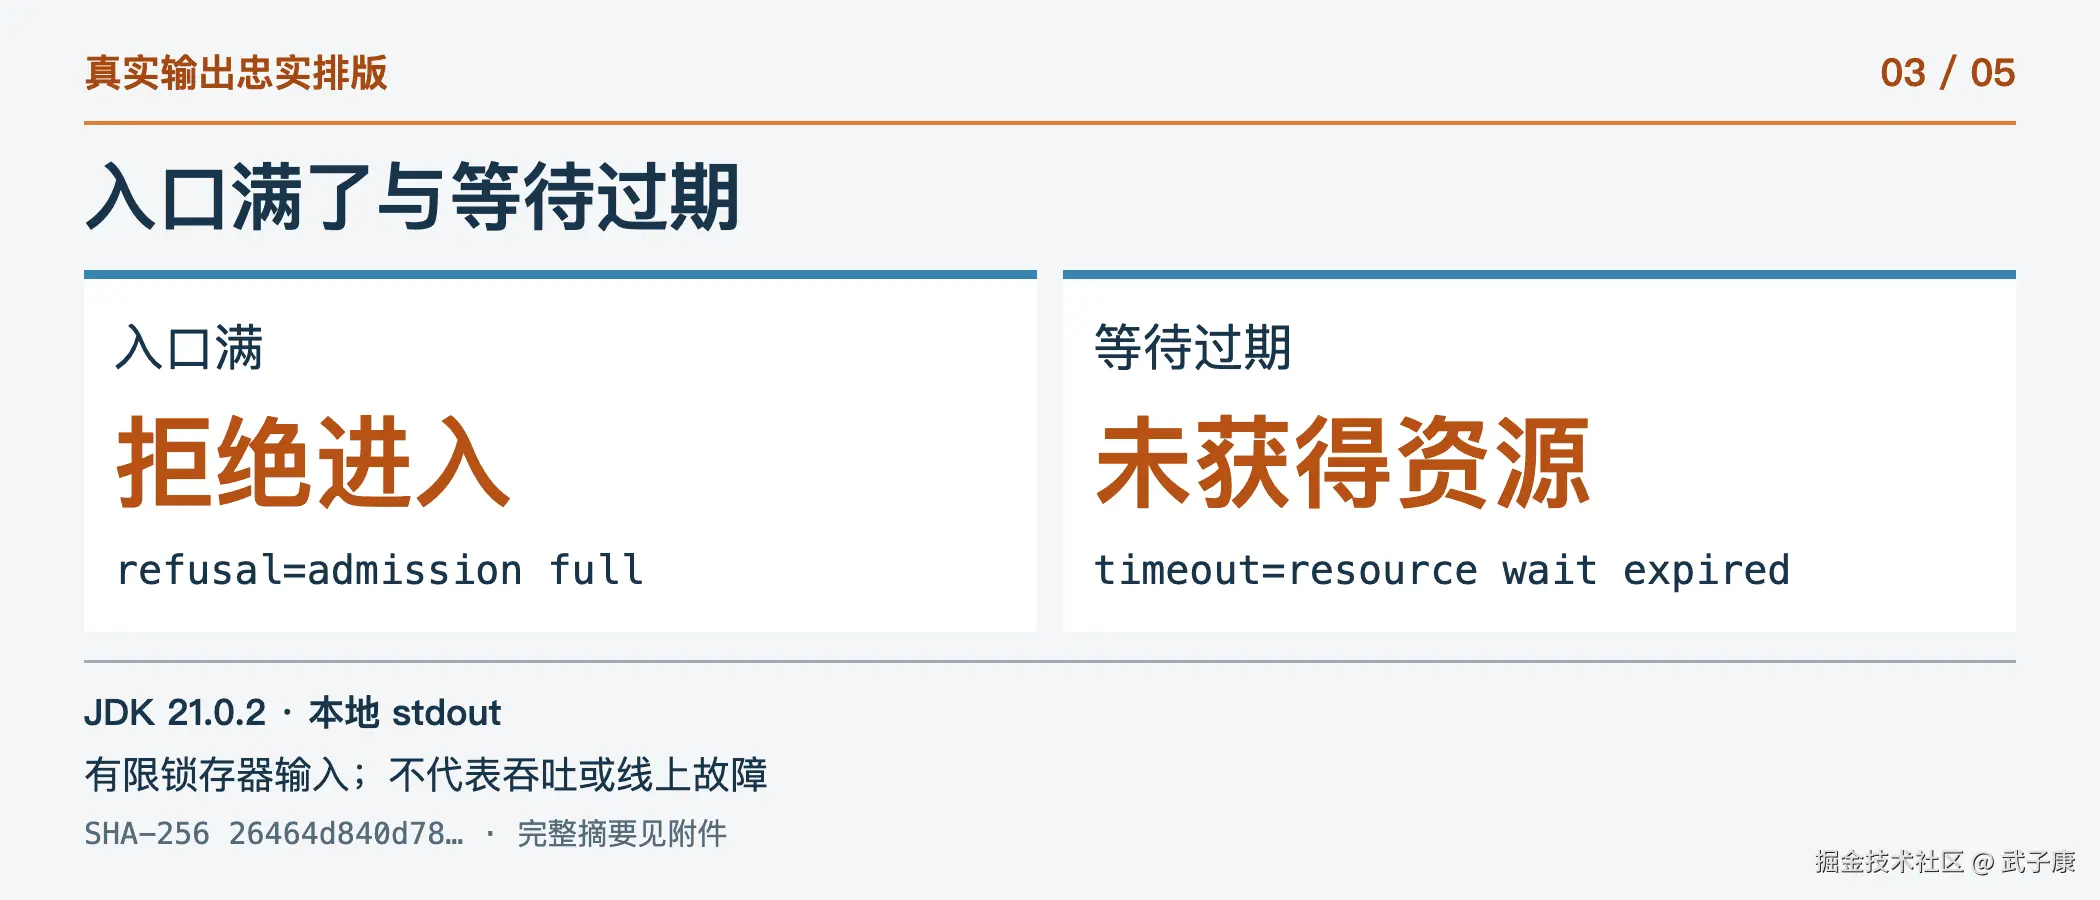
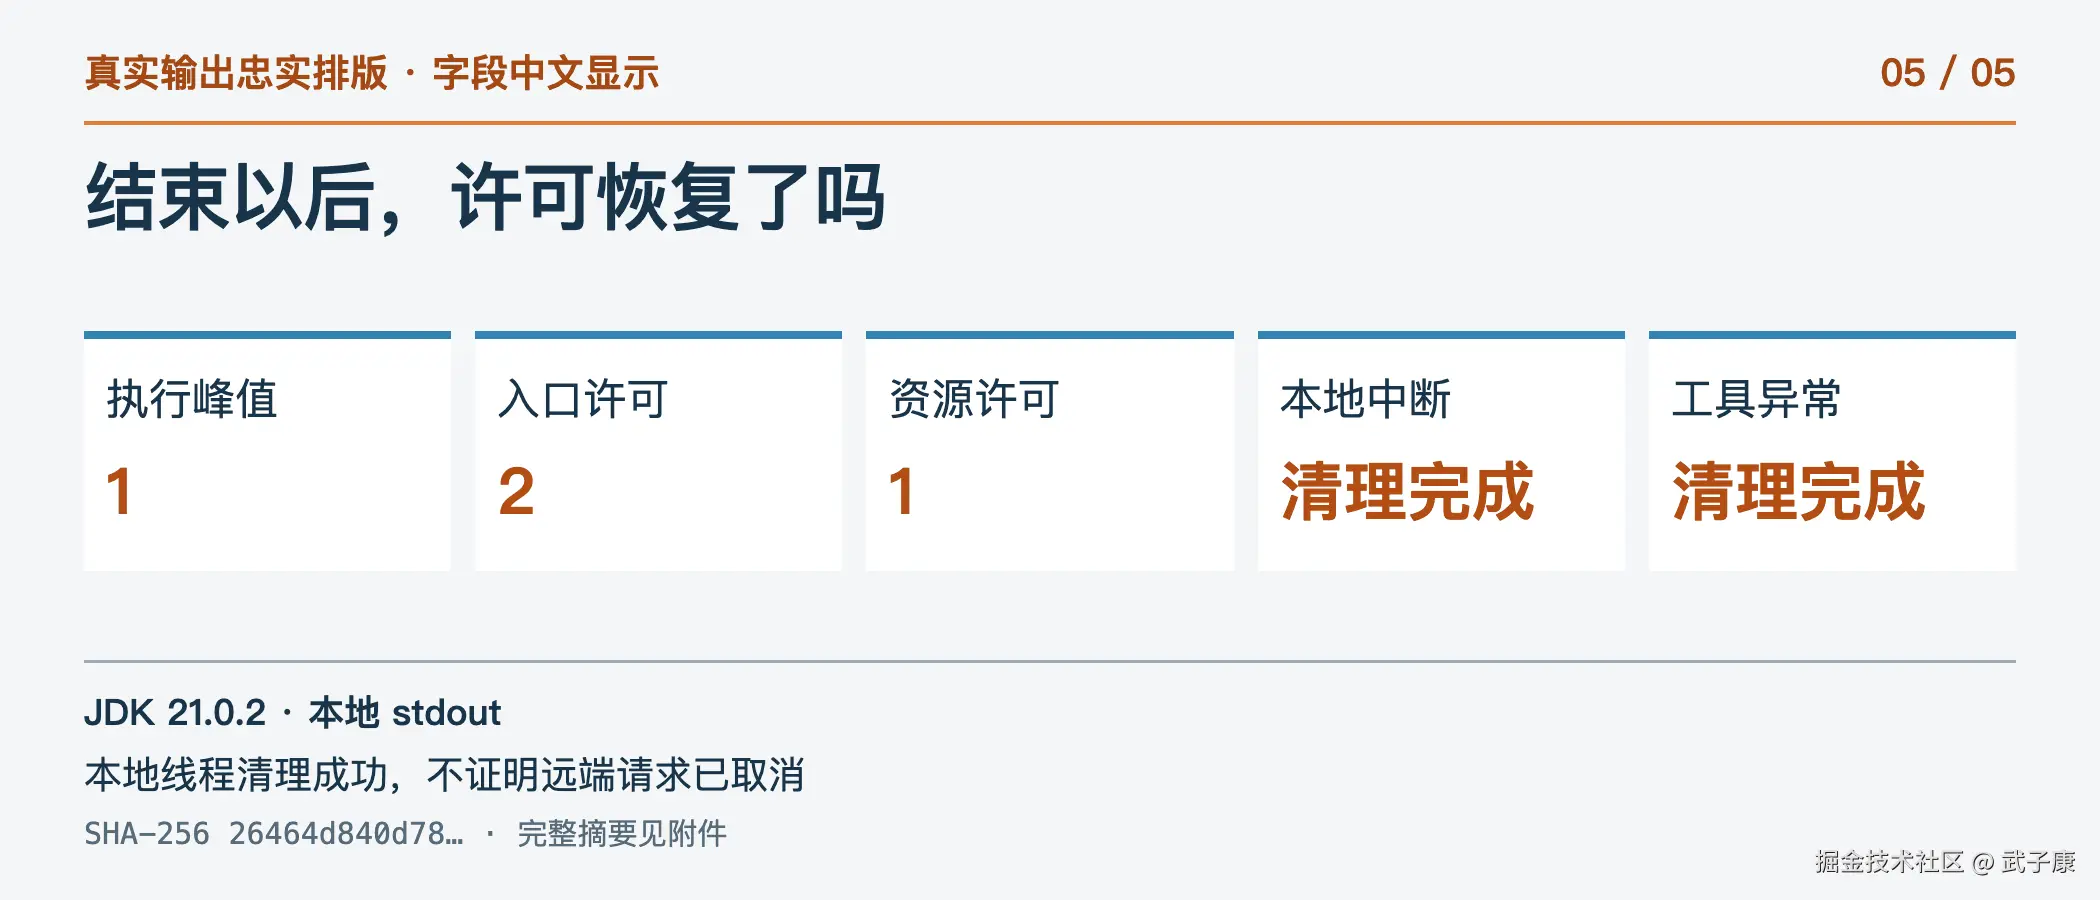
本次实际运行环境为 macOS arm64、GraalVM CE 21.0.2,编译退出码 0,执行退出码 0。输出如下:
text
refusal=admission full
timeout=resource wait expired
cancel=local interruption observed; cleanup complete
exception=tool failed; cleanup complete
peak_active=1; admission_permits=2; resource_permits=1
clock_fixture=expired after permit; tool_calls=0; permits_restored=true输出验证了有限算例中的准入拒绝、资源等待超时、本地取消后清理、工具抛异常后的清理和实际资源峰值。peak_active=1 来自在真正进入 call.call() 的计数,没有用"创建了多少虚拟线程"代替工具并发。最后一行只验证注入时钟下获得许可后的再次检查,并确认过期任务没有调用工具。
取消还有一个容易误算的地方:FutureTask.cancel(true) 可能先把 Future 标为取消,再由运行线程响应中断并清理。因此代码把准入释放放在实际 run() 的 finally,不能放在 Future 的 done() 回调里,否则旧任务仍在执行时,新请求就可能被提前放行。算例等待独立的 settled 信号后才检查许可恢复。如果任务在开始前被取消,执行器仍运行这个已取消的包装任务,super.run() 不再调用业务,外层 finally 回收准入。
这个实现对关闭和提交失败也要算账:执行器拒绝任务时同步释放入口许可;正常 close() 等待任务结束。若业务代码完全不响应中断,取消与关闭可能持续等待,它也会继续占用入口容量。示例故意使用可中断 latch,不模拟远端已经停止,更不证明真实模型、数据库或 HTTP 客户端支持取消。实际客户端必须设置连接、读取和请求超时,并验证释放发生在连接或调用真正结束之后。
toolConcurrencyLimit 不能从博客里抄一个数字。它应来自供应商配额、连接池容量、代表性负载、尾延迟目标、错误预算和故障实验。不同工具甚至不同租户可能需要不同闸门。
也不要只在最外层放一个"全局并发数"。全局闸门无法表达不同资源的容量差异:数据库可能有自己的连接上限,模型服务按账户和模型限流,某个外部工具允许更少的在途调用,CPU 计算又受核心数约束。把这些限制压成一个数字,要么浪费资源,要么保护不住最脆弱的下游。
三、Java Agent 后端至少要看六类稀缺资源
1. 数据库连接
虚拟线程可以让大量请求同时阻塞等待连接,但连接池不会因此增长。若任务先持有其他资源,再等待数据库连接,还可能形成级联占用。需要关注的不只是活跃连接数,还包括:
- 获取连接的等待时间;
- 池耗尽和获取超时;
- 事务持有连接的时间;
- 慢 SQL、锁等待和长事务;
- 重试是否再次申请连接并放大压力。
合理的闸门通常应接近数据库访问边界,并与连接池容量和事务模式协同。不要让远多于可服务能力的任务先进入数据库阶段,再靠连接池排出一条长队。
2. HTTP 连接与外部工具
HTTP 客户端本身可能有连接池、每主机限制、DNS、TLS 和响应体读取成本。远端服务还可能有配额、限流和并发约束。虚拟线程能便宜地等待 HTTP 响应,却不能让远端更快。
Agent 工具尤其需要独立舱壁。搜索、浏览器、代码执行和业务写入不应共享一个无差别额度。一个慢工具出现故障时,如果能占住所有请求的通用并发,其他健康工具也会被拖垮。
3. 模型请求和 token 配额
模型调用的限制可能同时包含请求速率、token 速率、在途数、账户额度和模型级策略。只限制虚拟线程数量无法表达这些维度。
模型闸门至少要考虑:请求进入时的剩余 deadline、预计 token 成本、租户配额、重试预算和优先级。交互请求与后台生成也不应默认争抢同一份容量。
4. CPU
虚拟线程不增加 CPU 核心。解析大型文档、压缩图片、运行本地推理、复杂序列化或代码分析,若主要时间消耗在计算上,创建更多虚拟线程只会增加调度竞争。
CPU 密集阶段应该进入有界计算池,容量与实际核心、任务成本和延迟目标联动。I/O 阶段可以使用虚拟线程,CPU 阶段受控切换到计算执行器。一个业务流程同时采用两种执行模型并不矛盾,关键是按任务性质分类。
5. 内存与每线程状态
虚拟线程比平台线程轻量,不等于没有内存成本。请求对象、缓冲区、响应体、日志字段和 ThreadLocal 值都会随在途任务放大。
如果框架或业务把大型对象放入 ThreadLocal,大量虚拟线程会把这部分成本显性化。请求结束时要清理上下文;更重要的是,先审查哪些信息真的需要线程本地保存。trace ID、租户、用户、安全主体和 deadline 应有明确传播清单,prompt、工具参数和敏感内容不应默认进入 MDC 或高基数指标标签。
6. 消息分区与消费者能力
消息队列可以把长任务从请求连接中解耦,却不能创造下游容量。增加消费者并发还可能受到分区数、数据库写入、外部 API 和幂等检查能力限制。
消息生产成功、消费确认和业务副作用完成是不同状态。虚拟线程可以简化消费者里的阻塞代码,但重复投递、迟到结果、死信和最终状态仍需应用协议治理。
四、CPU、ThreadLocal 与 pinning:三个容易被忽略的运行时边界
CPU 密集任务不会因为线程便宜而加速
判断任务是否适合虚拟线程,不要看方法名字,也不要看它是不是"异步",而要看大部分时间花在哪里:
- 大部分时间等待网络、数据库、文件或其他阻塞 I/O:通常适合;
- 大部分时间持续占用核心做计算:仍需要有界计算并发;
- 同时包含两者:拆分阶段,分别治理。
单个请求延迟也不会因为换成虚拟线程自动下降。虚拟线程的价值主要体现在大量阻塞任务并发时,减少平台线程占用并保持顺序代码结构。是否真的提高吞吐,仍要用代表性负载验证。
ThreadLocal 需要按"每个在途任务"重新算账
平台线程池时代,一些团队习惯把格式化器、缓存、鉴权信息甚至大对象挂在线程本地,因为线程数看起来有限。虚拟线程时代,线程数量可能远高于过去,按线程复制的状态会改变内存曲线。
这不意味着 ThreadLocal 一律不能用,而是要回答:值多大、存多久、是否清理、是否包含敏感信息、是否真的需要线程本地语义。上下文跨消息或远程调用时,还必须显式编码必要字段,不能把 ThreadLocal 当作跨进程协议。
pinning 和兼容性要靠运行证据判断
pinning 必须绑定实际 JDK 版本。JEP 444 描述 JDK 21 中在 synchronized 区域和某些 native/foreign 调用内阻塞时的限制。本次算例运行在 JDK 21,不能拿它证明新版本同步实现的行为。JEP 491 已在 JDK 24 交付,消除了由 Java monitor 引起的这类 pinning;native/foreign 边界仍需按版本和调用路径核验。不能把"所有 synchronized 都应改为 ReentrantLock"写成跨版本优化建议,也不能把 JDK 24 的变化解释为任意库路径都不会占住载体线程。
正确做法是对真实阻塞路径进行压测,并结合 JFR、线程转储、锁等待、CPU、内存和下游指标观察。关注的是:载体线程是否长时间被占用、吞吐是否随并发异常停滞、尾延迟是否扩大,以及问题来自锁、I/O、CPU 还是下游限流。
五、背压不能只做"限流",还要包含排队、拒绝和 deadline
很多实现加了一个信号量就认为完成了背压。实际上,一个完整的资源闸门至少要定义五件事:
- 准入条件:按资源、租户、优先级还是任务类型判断;
- 等待边界:能否排队,队列是否有界,最长等待受什么控制;
- 拒绝语义:容量不足时返回什么状态,调用方能否区分过载与业务失败;
- 超时预算:排队是否消耗端到端 deadline;
- 重试规则:谁可以重试,何时退避,重试是否重新占用配额。
为什么 deadline 必须贯穿排队和执行
假设入口给一个任务设置总 deadline。任务在模型闸门前等待了一段时间,获得许可后,调用模型时应该只使用剩余预算。如果每一层都重新启动一个完整超时,端到端耗时会不断叠加;上游早已放弃,后台工作仍持续占用资源。
deadline 还应该传播到数据库、HTTP 工具、消息任务和子任务。无法真正取消的远端操作,也至少要定义迟到结果是否接受、资源何时释放以及副作用如何确认。
为什么明确拒绝比无限排队更可靠
无界队列看起来减少了拒绝,实际上只是把过载隐藏成长等待、内存压力和过期任务。任务终于出队时,用户可能已经离开,deadline 已耗尽,下游仍要为一个没有价值的请求付费。
可解释的拒绝是一种保护协议。调用方可以降级、稍后重试或告诉用户系统繁忙;无限排队则让失败发生得更晚、更昂贵,也更难定位。
重试必须进入容量预算
当下游变慢时,超时和重试往往同时增加。如果重试不受同一资源闸门约束,系统会在最脆弱的时候主动放大流量。重试需要退避、抖动、最大尝试边界,并区分可重试依赖错误、业务拒绝和永久失败。
六、不要问"能开多少",先建立测量闭环
虚拟线程迁移最常见的问题是:"那我们到底能开多少并发?"这个问题没有脱离场景的固定答案。真正可复用的是测量方法。
第一步:画出资源路径
列出一个请求从入口到完成会经过哪些阶段,每个阶段使用什么资源:
text
请求入口
  -> 鉴权 / 租户配额
  -> 检索:HTTP + 向量库连接
  -> 模型:请求与 token 配额
  -> 工具:供应商并发 + HTTP 连接
  -> 业务写入:数据库连接 + 事务
  -> 结果记录:消息或任务状态
如果一个阶段看不到资源所有者、等待位置和失败语义,就还没有完成容量设计。
第二步:为每个闸门定义指标
至少记录:
| 维度 | 建议观察 |
|---|---|
| 准入 | 请求数、获得许可数、拒绝数 |
| 排队 | 当前等待数、等待时长分布、过期数 |
| 执行 | 在途数、执行时长、成功与异常 |
| 下游 | 连接池、限流、超时、响应状态、配额消耗 |
| JVM | CPU、内存、GC、锁、平台/虚拟线程、JFR 事件 |
| 用户结果 | 首反馈、最终完成、取消生效、迟到结果 |
只看虚拟线程数量没有诊断价值。线程很多可能只是大量任务在正常等待,也可能是下游已阻塞。必须把线程、闸门、下游和用户结果关联起来。
第三步:使用代表性负载逐步提高压力
测试需要覆盖真实的阻塞比例、响应体大小、模型耗时分布、工具失败和数据库事务,而不是只让一个空接口 sleep。逐步增加到达率,观察哪个资源先出现等待、尾延迟、拒绝或错误拐点。
容量值应留有故障余量。一个系统在所有下游健康时达到的峰值,不是生产闸门的直接答案。还要测试下游变慢、部分超时、连接池收缩、实例发布和重试增加时,系统是否能明确拒绝并恢复。
第四步:做对照,而不是只测新方案
保留平台线程池基线,对比相同业务路径下的吞吐、尾延迟、CPU、内存、连接等待和错误率。若虚拟线程提高了入口吞吐,却让数据库等待和失败显著增加,说明执行层优化成功,但资源治理没有跟上。
七、把验证结果接到真实入口
上面的代码只完成进程内、有固定容量的工具入口。接入 Web 服务前,还要避免在更外层保留一条无界队列:如果框架已经缓存大量请求,入口闸门即使有效,内存和用户等待仍可能发生在它之前。应把准入位置、请求体大小上限和上游超时一起记录,拒绝返回使用服务自己的过载协议,别让调用方把它当作可立即无限重试的业务异常。
对一个真实模型工具,至少用相同路径做三组验证。第一组令下游正常,核对已接纳、正在等待、正在调用、拒绝和终止数能否对上;第二组让调用持续变慢,确认等待有界、过期不进入下一步,记录连接是否真的回收;第三组在排队与执行两个阶段分别取消,检查旧调用仍存活时是否继续占用容量。如果真实客户端不支持中断,就保留"取消请求已发出"而非"远端已停止",直到获得下游证据。
多实例部署时,本文信号量仅保护当前进程。若每个副本都使用同一容量,副本数增加会提高整个账户的在途总量。供应商账号级限额、数据库总体连接预算和租户跨实例配额,需要在入口或共享调度层另外分配;不能仅靠每个 JVM 的许可数推导全局安全。扩缩容、滚动发布与失联恢复时,应同时测试旧实例排空、新实例准入和剩余额度,而不是重复抄一份并发数字。
读者可以先把示例接到单一工具,记录上述状态,再决定是否需要更复杂的公平队列。若没有多租户优先级要求,立即拒绝加短等待通常更容易解释;若要保证优先级、公平或不同任务重量,就需显式调度策略。增加更多 semaphore 不会自动形成租户公平,拿着一种资源再等待另一种还可能造成饥饿,因此应核对获取顺序和持有范围,尽量避免携带数据库事务去等模型配额。
结语:线程可以很轻,资源边界必须很重
虚拟线程让 Java 后端重新获得一种很有价值的能力:用顺序、直观的阻塞式代码表达大量 I/O 并发,而不必为了节省平台线程,把所有流程都改造成复杂回调链。
但它没有取消容量规划。恰恰相反,当线程不再是第一瓶颈,数据库、HTTP、模型、工具、CPU 和内存的真实边界会更快暴露。工程重点也应随之变化:不再试图用一个线程池数字控制整个系统,而是给每种稀缺资源建立独立闸门,明确排队、拒绝、deadline、重试和观测。
可以记住一句判断:
虚拟线程负责让等待更便宜,资源闸门负责让系统不会因为等待更便宜而失控。
采用虚拟线程之前,先画资源路径;采用之后,先看资源等待。只有执行模型和容量协议同时成立,吞吐提升才不会变成下游拥塞。
公开资料
- OpenJDK JEP 444:JDK 21 虚拟线程
- OpenJDK JEP 491:JDK 24 monitor pinning 变化
- JDK 21 Semaphore:许可与监控边界
- Oracle Java 25:Virtual Threads
- Java Language Specification:Threads and Locks
- Spring Framework:Task Execution and Scheduling
本文基于公开资料、架构推演与本地有限 Java 算例,不包含具体项目配置、代表性压测数据或效果结论。并发、队列、超时和重试参数必须根据自己的下游配额、代表性负载与 SLO 验证。