Codex 每次启动,会把项目根目录到当前目录路径上的 AGENTS.md 拼起来作为项目指令,总量上限默认 32 KiB(32,768 字节)。超出部分按字节截掉,日志里留一条 warning,界面上没有任何提示。Codex 先读根目录的、再一层层读子目录的,预算被根目录用掉,被截掉的就是子目录里的那几份,也就是专门写给你正在改的那块代码的规则。Claude Code 的规则不同:单个 CLAUDE.md 在 4 MiB 以内整份读入,超过就整份跳过;它从 v2.1.277 起也读 AGENTS.md,但只要路径上有一个 CLAUDE.md 或 CLAUDE.local.md,AGENTS.md 就不读了。
这个问题最早由 Sertan Helvacı 在 10 月 20 日的文章《How Big Can AGENTS.md and CLAUDE.md Get?》里整理过。本文只看 Codex 和 Claude Code 两家:读了 Codex 的源码 agents_md.rs,对照 Claude Code 的官方文档,再在本地用 Codex CLI 0.162.1 和 Claude Code 2.1.304 埋标记实测。最后拿 OpenAI 自己的 openai-agents-python 仓库验证,它的 AGENTS.md 有 38,241 字节。
这个仓库的结果说明了问题的性质。AGENTS.md 最后一节写的是测试命令和 PR 规范,Codex 默认只读到「Development Workflow」一节中间的半句「Implement the」。维护者写给 agent 的测试要求,agent 从来没看到过,而写文件的人和读文件的工具来自同一家公司。
指令文件看起来像配置,实际上是要塞进上下文的文本,每个工具对「塞多少、塞不下怎么办」各有规则。文件超过 30 KB,就该先确认工具实际读进了多少,再讨论写得好不好。
Codex 32 KiB 预算在 agents_md.rs 里的扣法
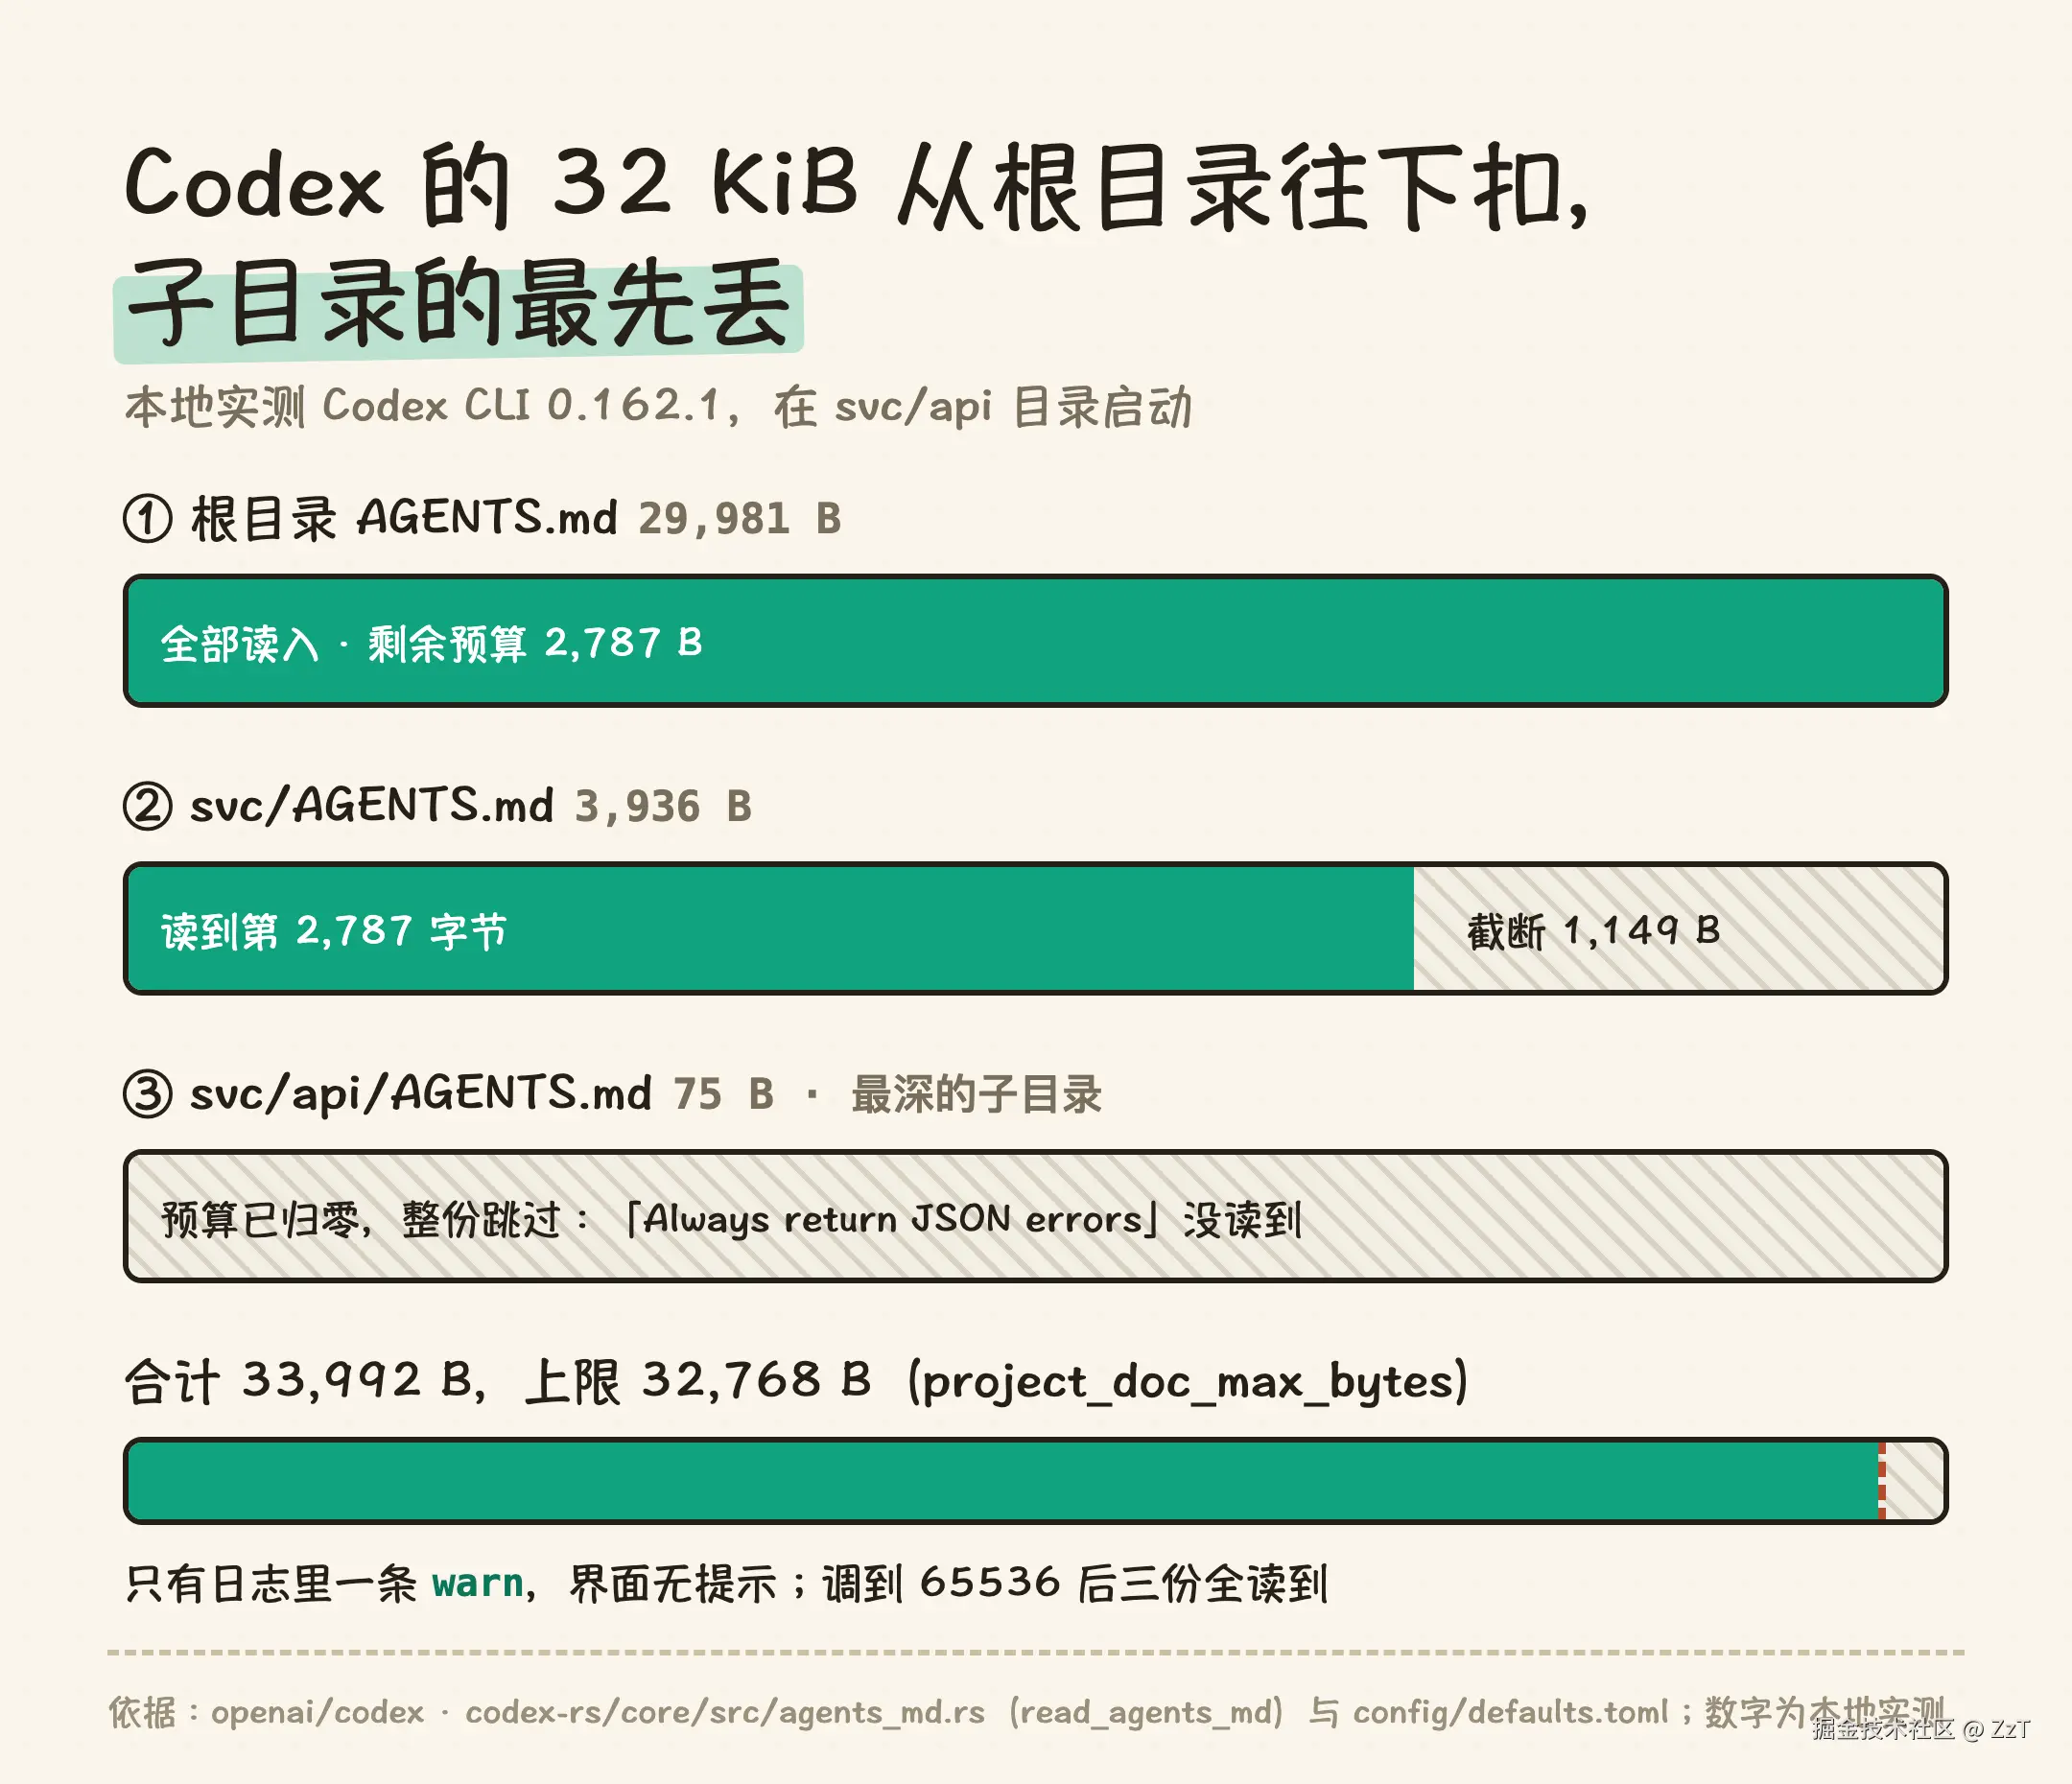
上限来自配置项 project_doc_max_bytes,默认值写在 codex-rs/config/defaults.toml:project_doc_max_bytes = 32768。读取逻辑在 codex-rs/core/src/agents_md.rs,分两步。
第一步是找文件。从当前目录往上找项目根(默认以 .git 为标记),再把路径反转成「根目录在前、当前目录在后」。每个目录按 AGENTS.override.md、AGENTS.md、project_doc_fallback_filenames 里配置的名字依次查找,命中第一个就停,所以一个目录最多贡献一个文件。当前目录以下的子目录不会去找。
第二步是按顺序读,边读边扣预算:
rust
let size = data.len() as u64;
if size > remaining {
    data.truncate(remaining as usize);
}
if size > remaining {
    tracing::warn!(path = %p, remaining_bytes = remaining,
        "project doc exceeds remaining budget; truncating");
}
// ...
remaining = remaining.saturating_sub(data.len() as u64);
前面的文件吃掉预算,后面的文件就只剩余额。跨过上限的那份文件按字节截断,剩余预算归零后,更深的文件直接跳过。Codex 官方文档的描述是合计达到上限后「stops adding files」,没有提到跨界那份会被截一半;同一份文档还写着越近的文件「override earlier guidance」,但按这个扣法,子目录的文件恰恰最先被丢。
全局的 ~/.codex/AGENTS.md 不占这 32 KiB。它作为用户指令单独传入,项目预算从 project_doc_max_bytes 起算。
三层目录实测:svc/api 的 AGENTS.md 一个字都没读到
为了确认源码和实际行为一致,我建了一个三层的 git 仓库,每份 AGENTS.md 的开头和结尾各埋一个标记,然后在最深的 svc/api 目录跑 codex exec,让它只根据已加载的指令列出看到的标记。
| 文件 | 大小 | 读到的标记 |
|---|---|---|
AGENTS.md(根目录) |
29,981 B | 开头、结尾都在 |
svc/AGENTS.md |
3,936 B | 只有开头,结尾被截 |
svc/api/AGENTS.md |
75 B | 一个都没有 |
三份合计 33,992 字节。根目录用掉 29,981 字节后只剩 2,787 字节,svc 那份读到第 2,787 字节被截断,svc/api 整份跳过。这份 75 字节的文件只有一条规则「Always return JSON errors」,正是在这个目录干活时最该知道的那条。
把上限调到 65,536 字节(codex exec -c project_doc_max_bytes=65536)后再跑,6 个标记全部出现。
OpenAI 自家的 openai-agents-python 被截掉 5,473 字节
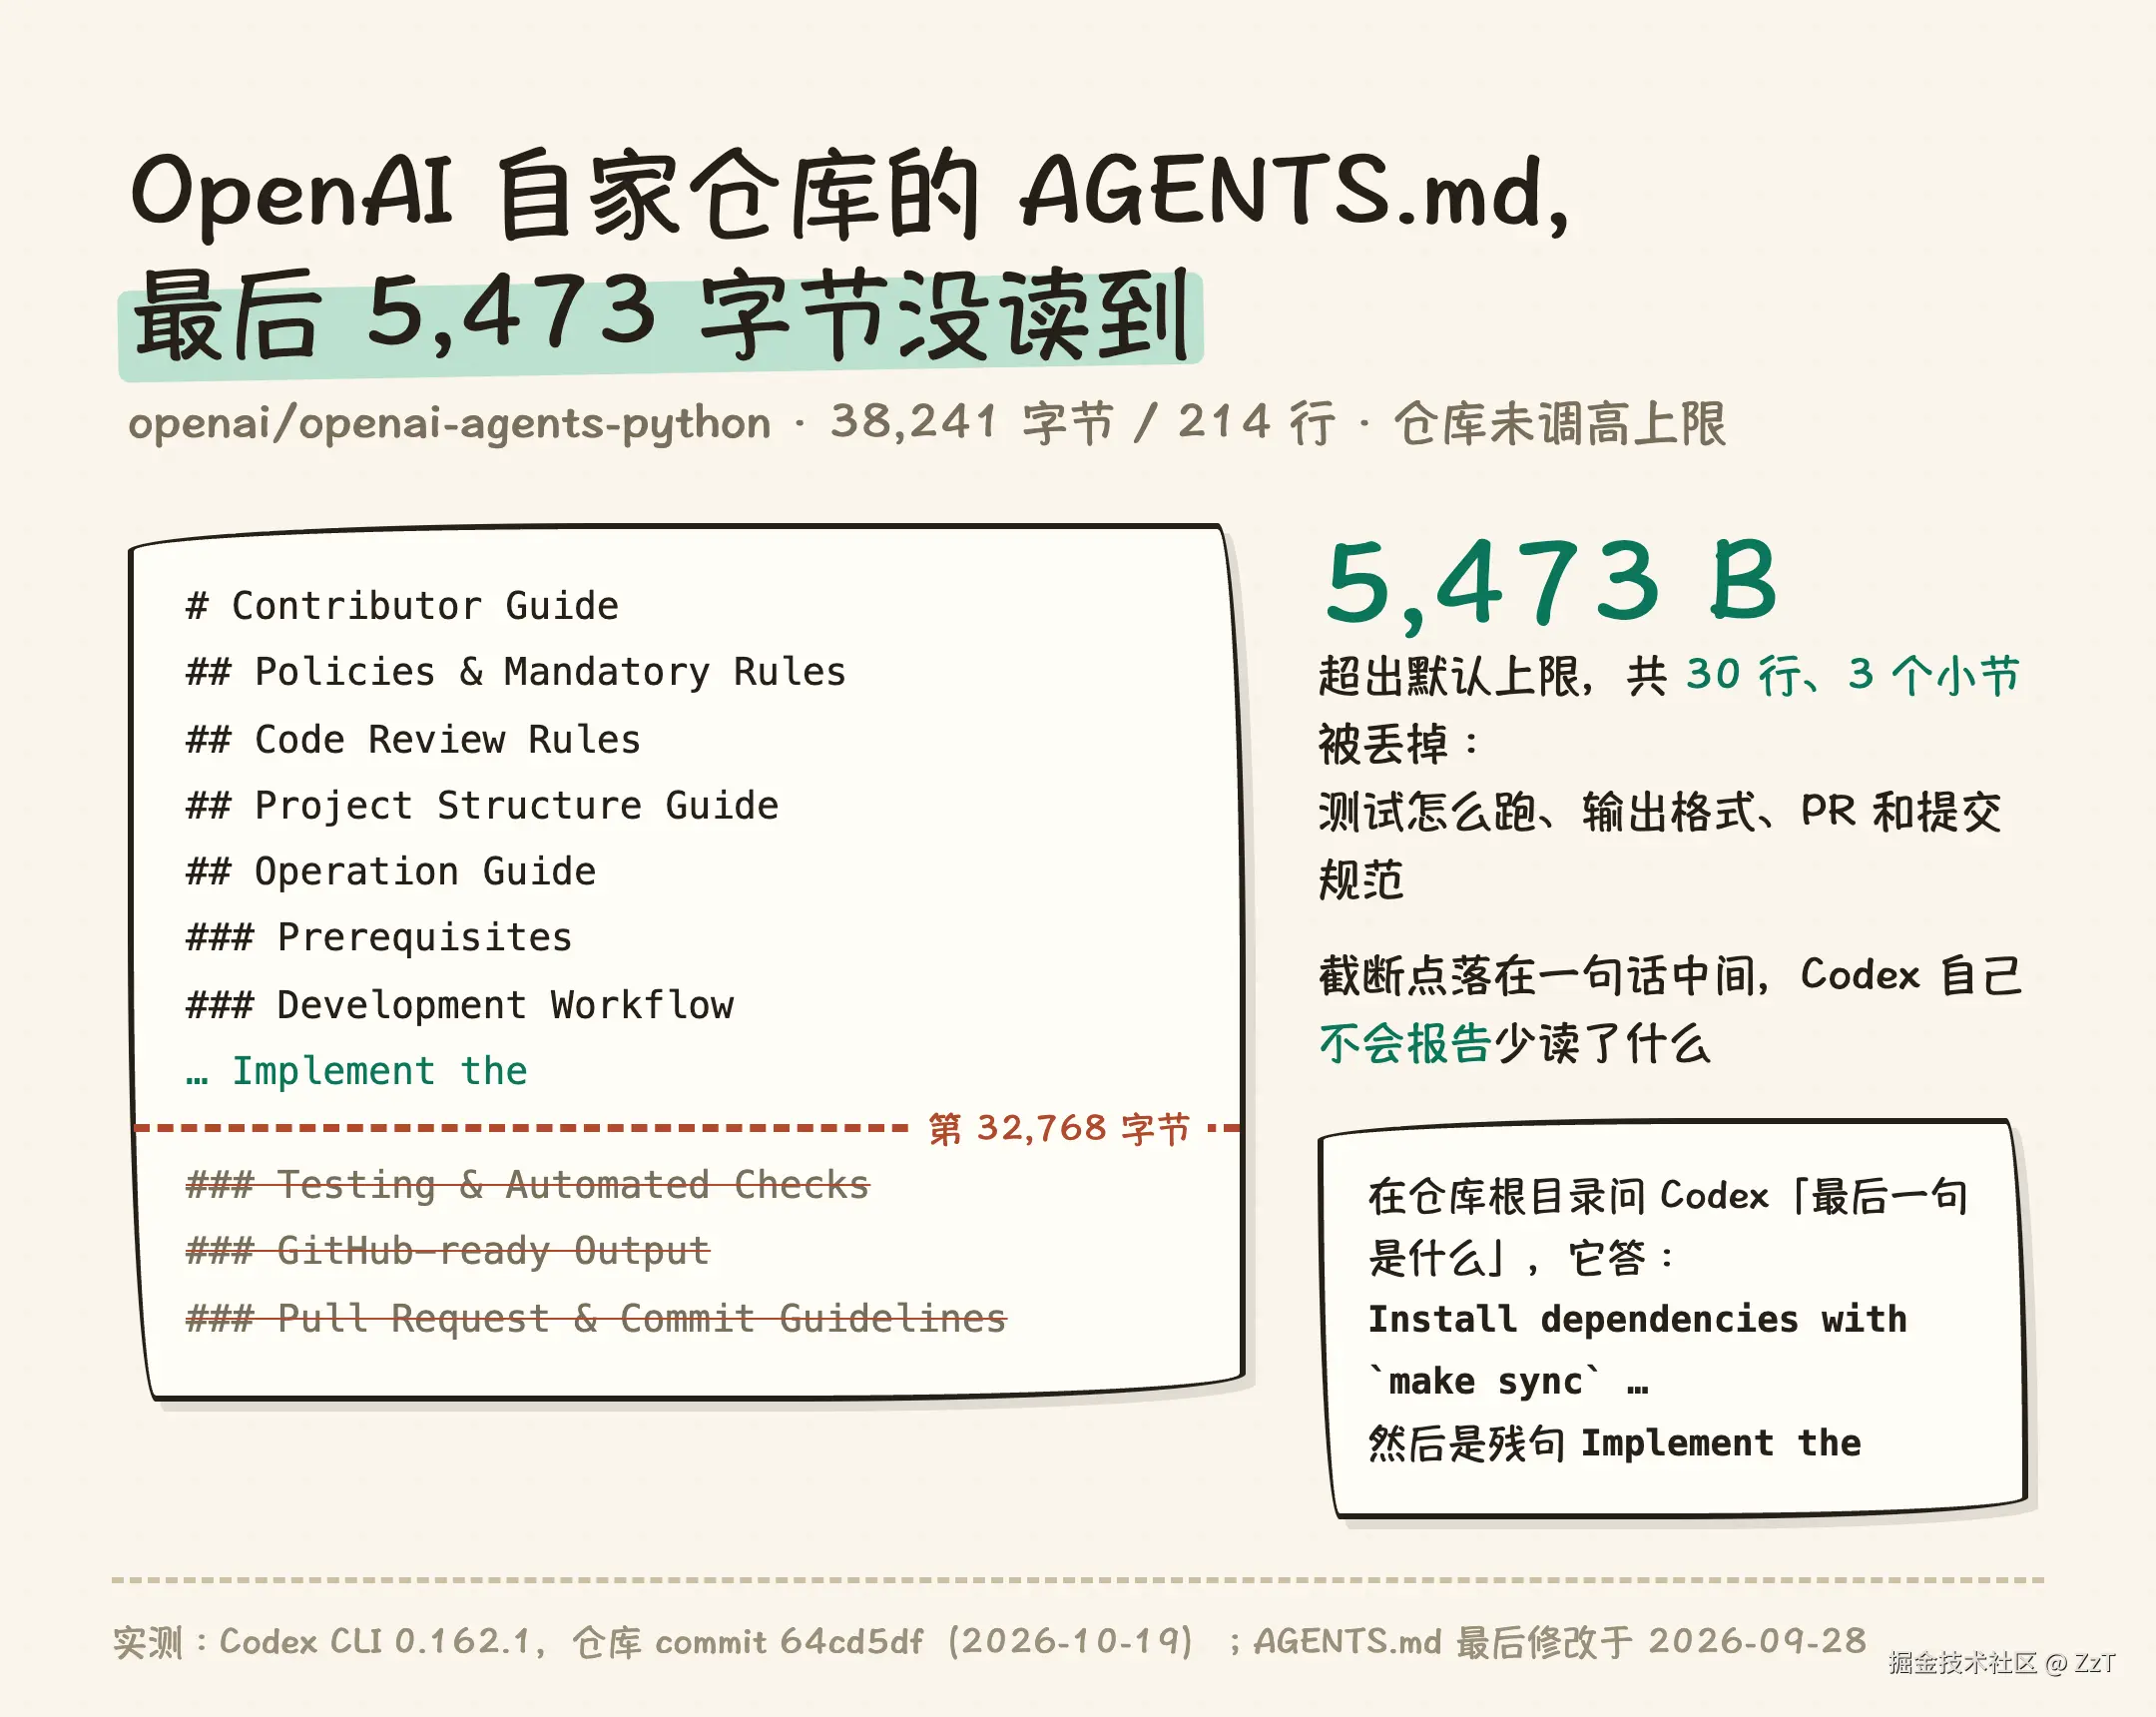
openai-agents-python 是 OpenAI 的 Agents SDK,根目录只有一份 AGENTS.md,38,241 字节、214 行,最后一次修改是 9 月 28 日。仓库里没有 .codex/config.toml,也就没有调高上限。
按 32,768 字节截断,多出的 5,473 字节被丢掉,涉及最后 30 行、三个小节:
- Testing & Automated Checks:测试与自动检查
- GitHub-ready Output:输出格式要求
- Pull Request & Commit Guidelines:PR 与提交规范
我把仓库克隆下来(10 月 19 日的 64cd5df),在根目录跑 codex exec,让它列出项目指令里的所有标题,并引用最后一句。它列到「### Development Workflow」为止,给出的最后一句完整的话是「Install dependencies with make sync for a fresh checkout or changed dependencies.」,后面跟着一个残句「Implement the」。
一个用默认配置的贡献者在这个仓库里让 Codex 改代码,Codex 不知道该跑哪些测试,也不知道 PR 该怎么写,而它自己不会报告这件事。
作为参照,我量了几个知名仓库根目录指令文件的大小:
| 仓库 | 文件 | 大小 | 行数 |
|---|---|---|---|
| openai/openai-agents-python | AGENTS.md | 38,241 B | 214 |
| anthropics/anthropic-sdk-python | CLAUDE.md | 31,559 B | 368 |
| vercel/next.js | AGENTS.md | 31,214 B | 545 |
| apache/airflow | AGENTS.md | 22,567 B | 251 |
| langchain-ai/langchain | AGENTS.md | 20,580 B | 390 |
| pytorch/pytorch | AGENTS.md | 16,518 B | 365 |
next.js 的根文件已经用掉默认预算的 95%,子目录里还有 turbopack/、apps/bundle-analyzer/ 等 AGENTS.md,目前单条路径的合计还在 32,768 字节以内,余量约 1.5 KB。Anthropic 的 anthropic-sdk-python 在 Claude Code 下能整份读入,但 368 行超过了 Anthropic 自己建议的 200 行。
中文写的 AGENTS.md:32 KiB 约合 1.09 万字
上限按字节算,不按字符算。UTF-8 里常用汉字占 3 字节,32,768 字节约等于 10,922 个汉字。同样的规则用中文写,能放进去的内容约是英文的三分之一。
截断用的是 data.truncate(remaining),切点不看字符边界,之后再用 String::from_utf8_lossy 转成文本。切点落在一个汉字的 3 个字节中间时,这个字会变成替换字符「�」,后面的内容照样丢掉。
Claude Code 的 4 MiB 上限与 200 行建议
Claude Code 官方文档对 CLAUDE.md 的说法是:「loads a CLAUDE.md file of up to 4 MiB in full and skips a larger file」。4 MiB 以内整份读入,超过就整份跳过,不做截断。正常写出来的指令文件碰不到这个上限。
真正有约束力的是建议值:每个 CLAUDE.md 控制在 200 行以内,理由是「Longer files consume more context and reduce adherence」。超过建议长度时,启动和 /status 都会给警告;几个文件各自没超、合计超过组合上限,也会警告。常被引用的「200 行或 25KB」是 auto memory 里 MEMORY.md 的读取上限,文档专门写了「This limit applies only to MEMORY.md」,和 CLAUDE.md 无关。
我用同一个三层测试仓库,在 svc/api 跑 claude -p。目录里只有 AGENTS.md,Claude Code 把三份 33,992 字节全部读入,6 个标记都在。
拆文件不会省上下文。@path 导入最多 4 跳,被导入的文件在启动时就展开进上下文,文档原话是拆成导入「helps organization but doesn't reduce context」。能减少每轮读入量的只有按需加载:子目录里的 CLAUDE.md 在 Claude 读写该目录文件时才加载;.claude/rules/ 里带 paths: 的规则在碰到匹配文件时才加载。
一个 CLAUDE.local.md 让 Claude Code 不再读 AGENTS.md
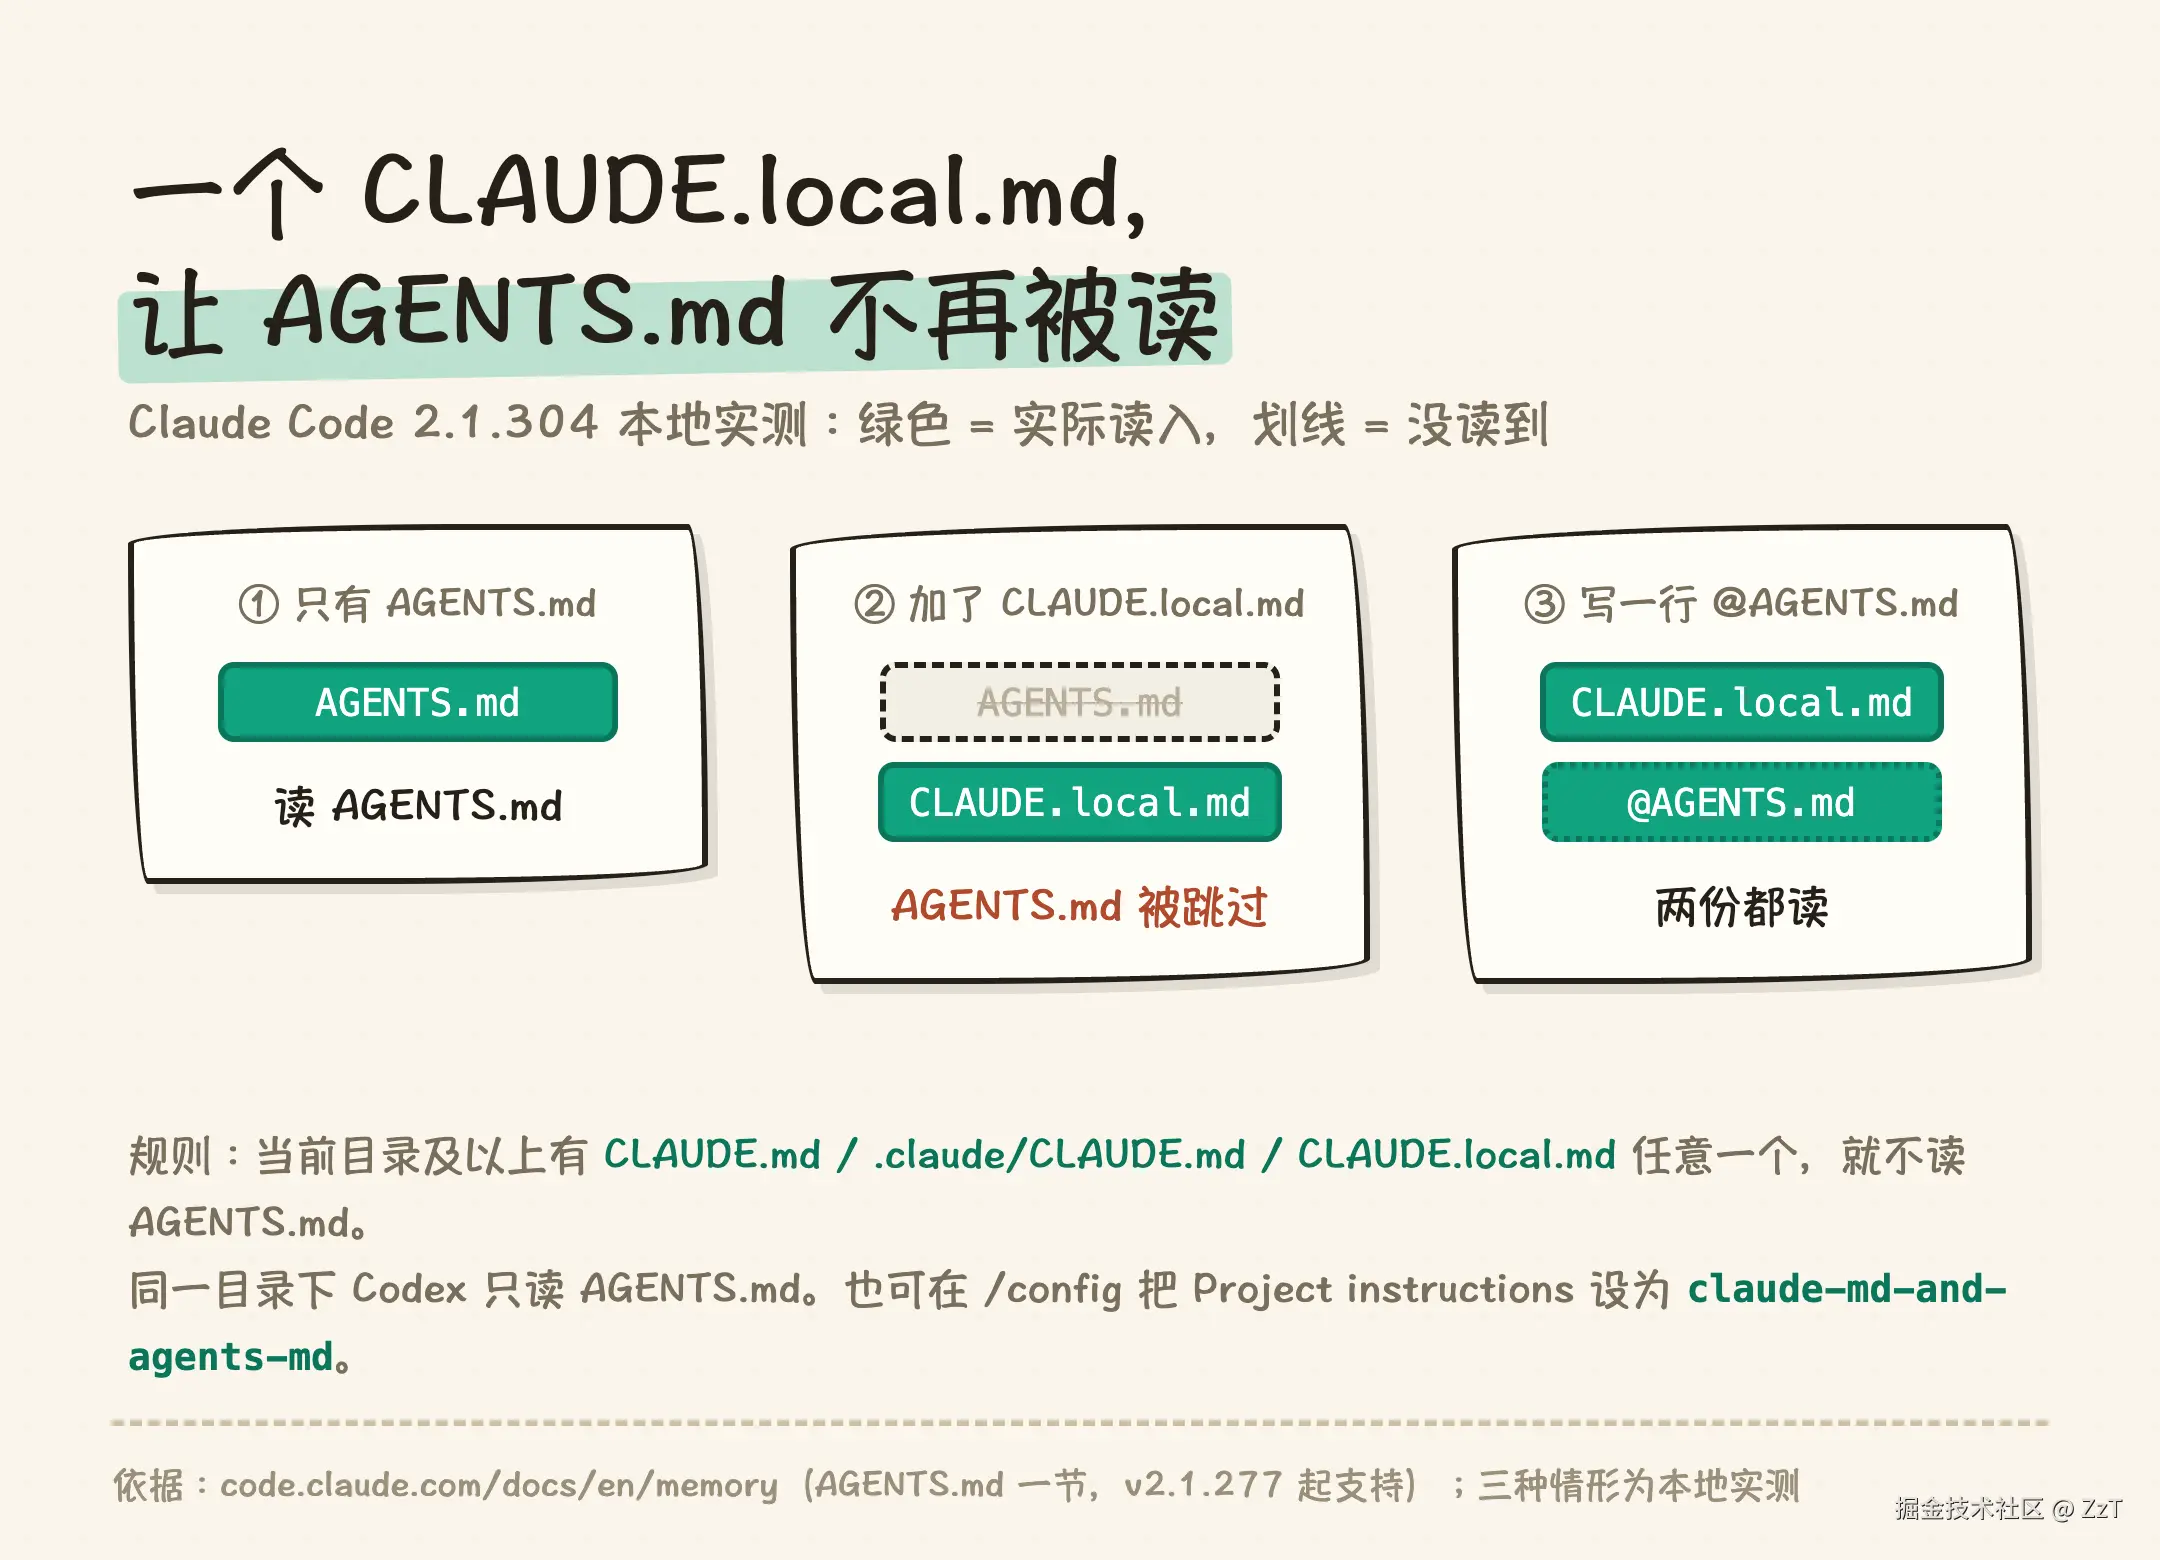
同时用两个工具的团队常见做法是只维护一份 AGENTS.md。Claude Code 从 v2.1.277 起会直接读它,但规则是二选一:当前目录及以上只要有 CLAUDE.md、.claude/CLAUDE.md 或 CLAUDE.local.md 中的任何一个,就只读 CLAUDE 系的文件。~/.claude/CLAUDE.md 和 .claude/rules/ 不算在内。
CLAUDE.local.md 是放个人偏好、不进版本库的文件,最容易随手加。本地实测三步:
| 目录里的文件 | Claude Code 读到的 |
|---|---|
| 只有 AGENTS.md | AGENTS.md |
| AGENTS.md + CLAUDE.local.md | 只有 CLAUDE.local.md |
CLAUDE.local.md 里加一行 @AGENTS.md |
两份都读 |
同一个目录下,Codex 只读 AGENTS.md,不看 CLAUDE.local.md。同一个仓库,两个工具读到的指令已经不一样了。
要两份都读,除了加 @AGENTS.md 导入,也可以在 /config 里把 Project instructions 设成 claude-md-and-agents-md。
自查与修法
Codex:量路径上的合计字节数。 在你常用的工作目录执行:
bash
d=$PWD; t=0
while :; do
  f="$d/AGENTS.override.md"; [ -f "$f" ] || f="$d/AGENTS.md"
  [ -f "$f" ] && s=$(wc -c < "$f") && t=$((t+s)) && echo "$s $f"
  [ -e "$d/.git" ] || [ "$d" = / ] && break; d=$(dirname "$d")
done; echo "合计 $t / 32768"
输出从当前目录往上列,合计超过 32,768 时,列在最前面的几份(最深的子目录)就在被截。
Codex:调高上限,或给根文件减肥。 在 ~/.codex/config.toml 写 project_doc_max_bytes = 65536 能马上解决,但只对你自己生效,其他贡献者仍是默认值。对团队有效的做法是把根文件压到 20 KB 左右,只放全仓通用的规则;只跟某个目录有关的内容,挪到那个目录的 AGENTS.md。离根越远的文件越晚被读到,所以根文件越短,子目录文件越安全。
Claude Code:先看实际加载了哪些文件。 会话里跑 /memory,列出的就是已加载的指令文件;启动时出现长度警告,说明有文件超过 200 行建议值,或合计超了组合上限。
同时用两个工具: 只维护一份 AGENTS.md 时,在 CLAUDE.md 或 CLAUDE.local.md 里写一行 @AGENTS.md,或者把 Project instructions 设成 claude-md-and-agents-md,不要靠 Claude Code 的自动回退。
| Codex CLI | Claude Code | |
|---|---|---|
| 上限 | 路径上合计 32 KiB,可调 | 单个文件 4 MiB;建议 200 行 |
| 超限后 | 按字节截断,更深的整份跳过,只有日志 warning | 超 4 MiB 整份跳过;超建议长度有启动警告 |
| 最先丢的 | 最深子目录里的文件 | 不按位置丢 |
| 读 AGENTS.md | 只读它(每目录 override 优先) | 路径上没有任何 CLAUDE 系文件时才读 |
| 子目录 | 当前目录以下不读 | 碰到该目录文件时加载 |
指令文件写到 30 KB 以上,先要回答的问题是 agent 读到了多少,其次才是还缺什么没写。