同一个跨文件的代码调查问题,我在 Claude Code 里让主 agent 自己查,平均 93 秒、0.87 美元;让它拆给 3 个子 agent 并行查再汇总,平均 143 秒、1.92 美元。四次答案的核心结论完全一致。
10 月 22 日,Anthropic 的 Applied AI 团队发了一篇文章,题目是《When to fold subagents into your main agent loop》,结论和这组数字同一个方向:多数场景下,一个主 agent 加上按需加载的 skills 和工具,质量不低于子 agent 架构,成本和延迟往往更低。原文给了一个客户案例,把多 agent 架构换成单 agent 循环后运行速度快了约 2 倍。
本文先整理原文的结论和机制,再给出本地 4 次对照实验和 Quickchat 用 20 个 PR 做的代码评审实测,然后列出原文认为仍然该用子 agent 的三种情况,最后落到 Claude Code 里的具体用法。
子 agent 并行听起来像是在加速,但每多一个子 agent,就多一份系统提示、多一轮读代码、多一次把结果压成摘要交回去,主 agent 拿到摘要后往往还要自己再核一遍。这些成本都按 token 计费,并行省下的时间常常被它们吃掉。拆不拆,应该由上下文是否撑不下来决定,而不是由任务看起来是否「可以分工」决定。
Anthropic 原文的结论:单 agent 加 skills 常常更好
原文作者是 Anthropic 的 Diane Sarkis,面向的是在企业里搭 agent 的团队。核心建议是:用「progressively disclosed context via skills」和「progressively disclosing tools via tool search」把专职子 agent 折叠回主循环。
原文给出的依据有三条:
- 一个客户的对比:同一套任务,单 agent 循环的运行时间比多 agent 架构快约 2 倍。
- 多家企业部署的对比:带 skills 的单 agent 在质量上经常胜过「一个大 prompt 包办一切」和「子 agent 架构」两种设计,成本和单任务延迟也常常更低。这一条原文没有给具体数字。
- Claude Code 自己的例子:Anthropic 把 Claude Code 面向较强模型的系统提示精简了 80% 以上,其中一部分来自把 skills 和工具改成渐进披露。
原文还提到模型能力的变化:「Starting with Opus 4.5, models became capable of managing far more in a single loop than most teams expected.」过去拆子 agent 的主要理由是一个上下文装不下所有专业知识,渐进披露让主 agent 只在需要时才加载某个 skill 的完整内容,这个理由就弱了很多。
子 agent 的成本出在交接上
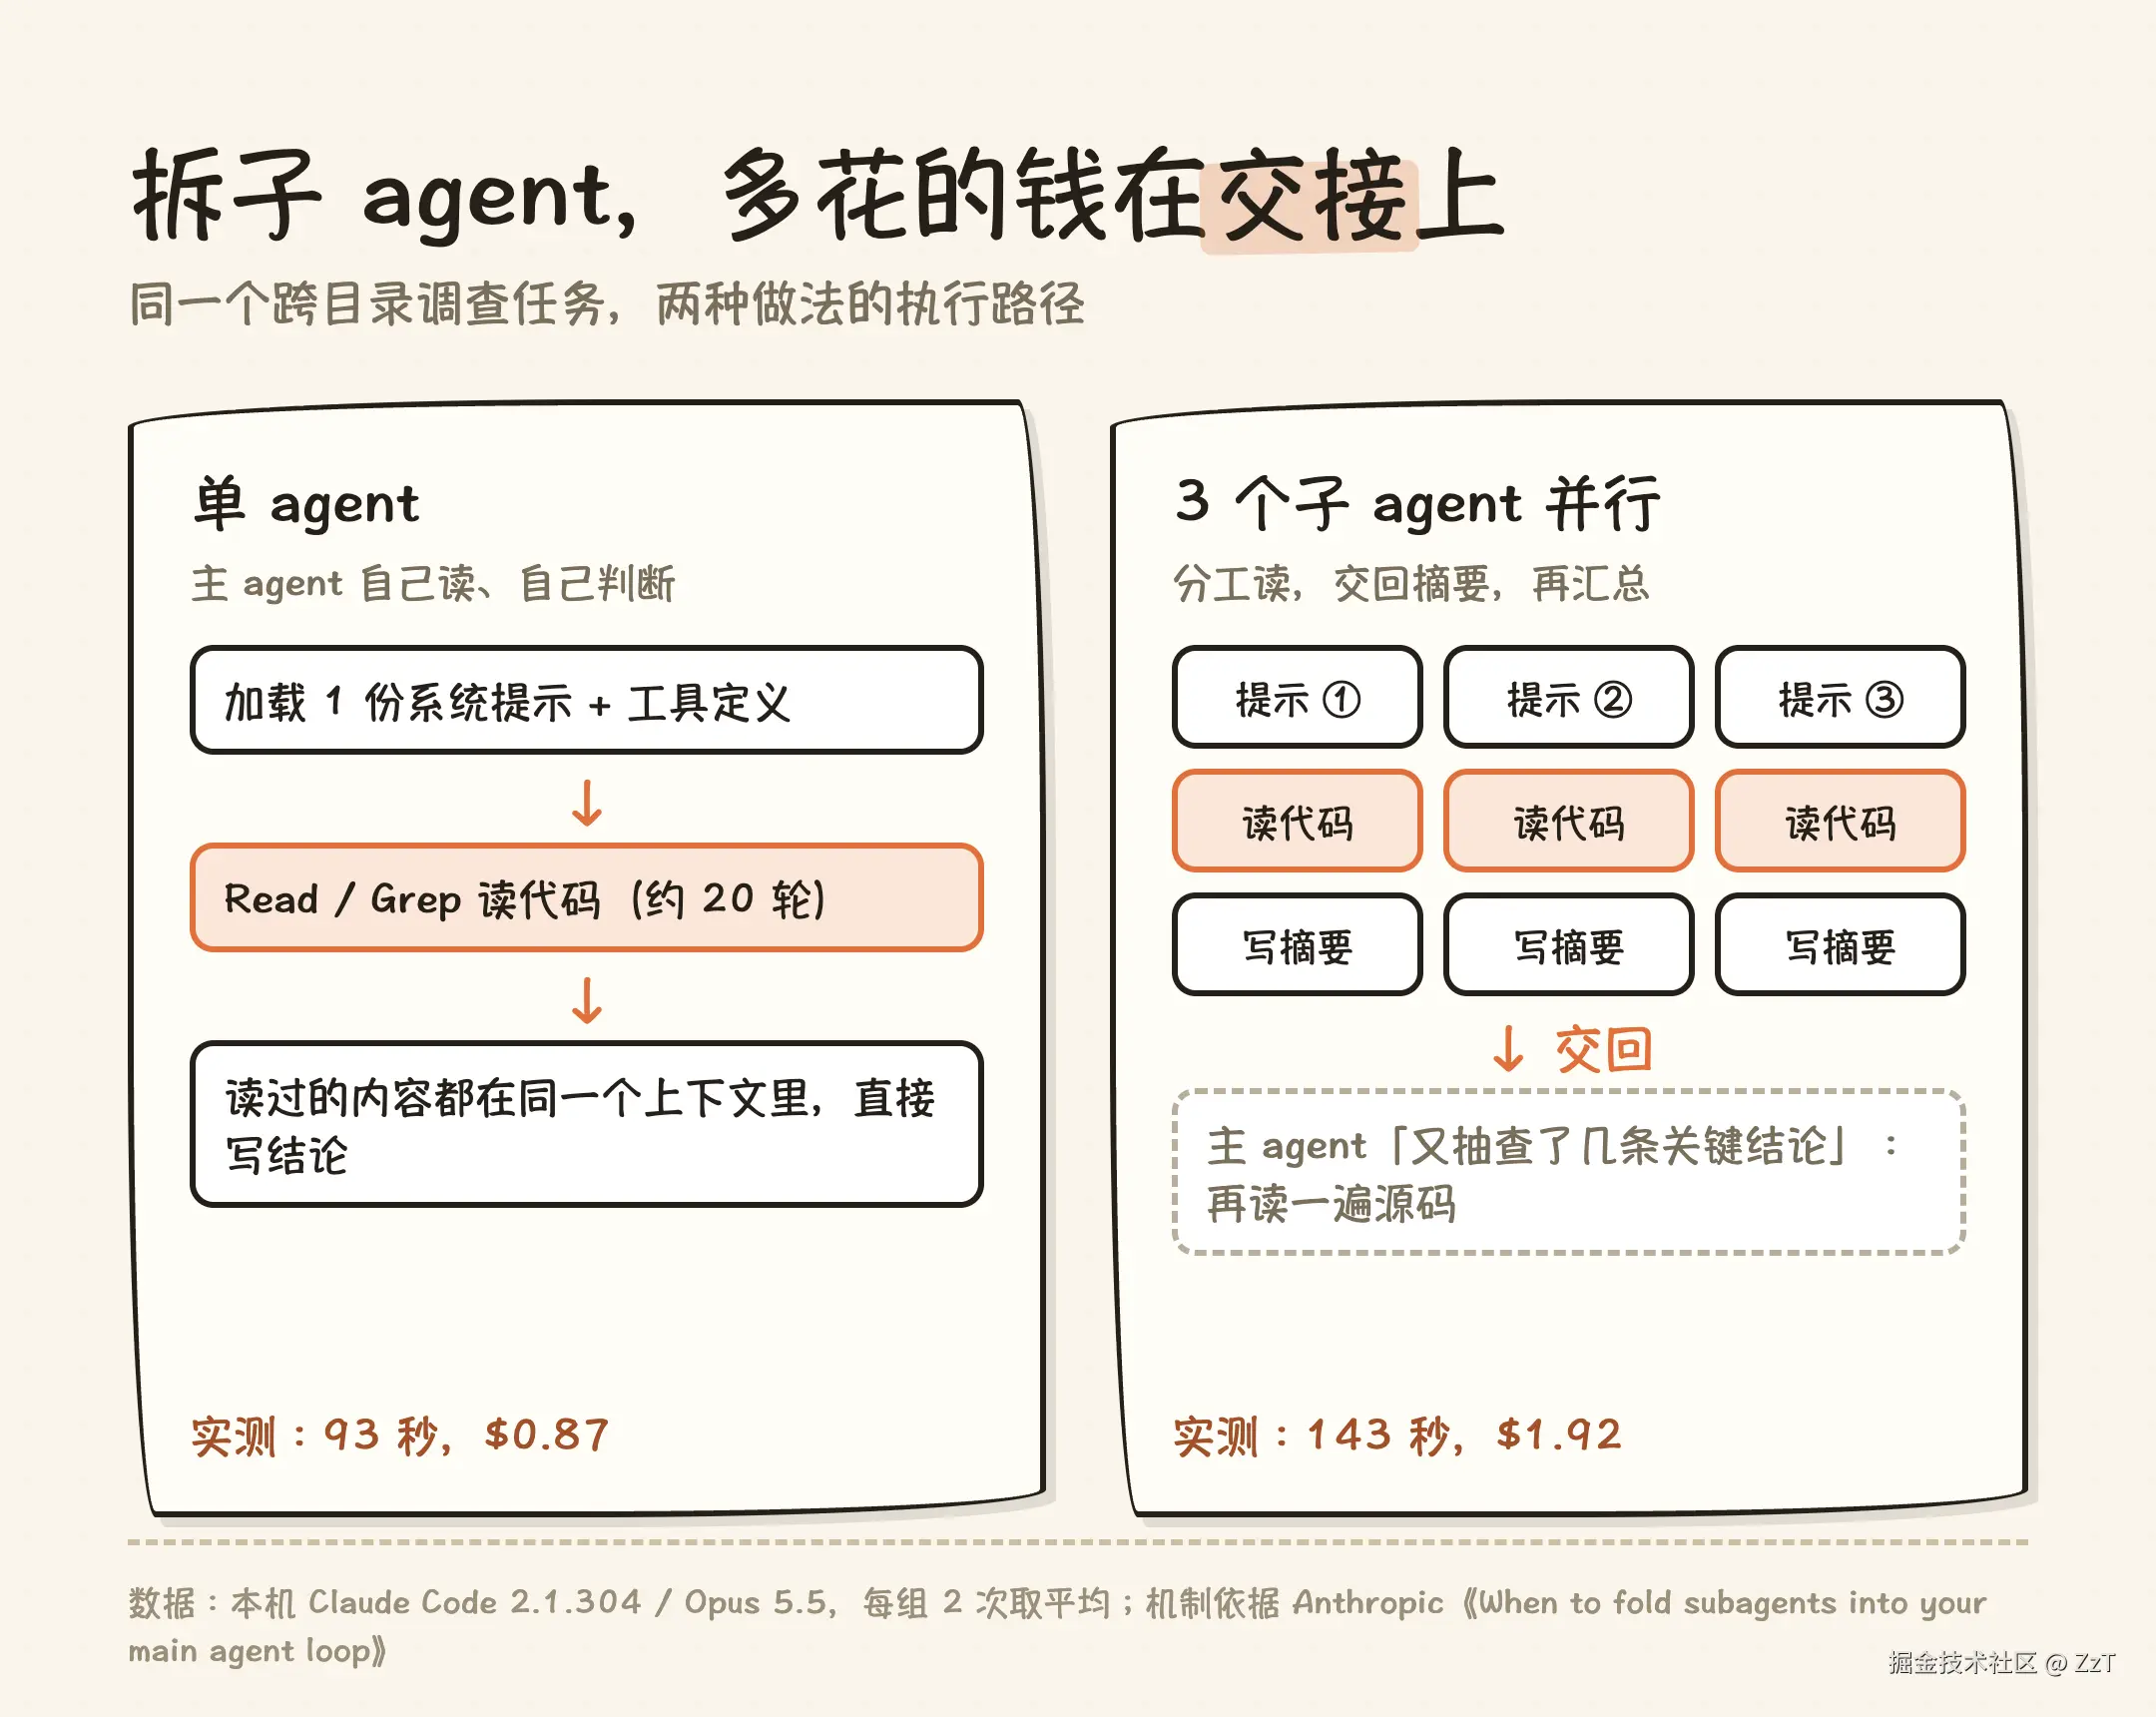
原文对多 agent 的批评集中在交接环节。团队要决定子 agent 之间传什么上下文,细节「often lose details in the back and forth」。而在长任务里,把前面每一步的结果都留在主窗口,主 agent 才能把它们联系起来,效果好过一组由子 agent 交回的摘要。
组织层面的问题更常见。原文把架构变成组织架构图的现象直接称为康威定律:每个团队都交付一个自己的子 agent,最后公司里有几百个职能重叠、没有统一标准、也没有明确负责人的子 agent;每个团队往系统提示里加一句话,拼出一个规则互相冲突的「Frankenprompt」。一家公司面向客户的 agent 里有十几个专职子 agent,结果品牌口径难以统一,延迟也上去了。
工具数量也是一个具体的拐点。原文写到,系统提示里的工具定义超过 30 到 50 个后,模型选工具的准确率会下降,建议按用户意图把工具分组,而不是一个 API 对应一个 tool。
本地 4 次对照:拆成 3 个子 agent 慢 54%、花费是 2.2 倍
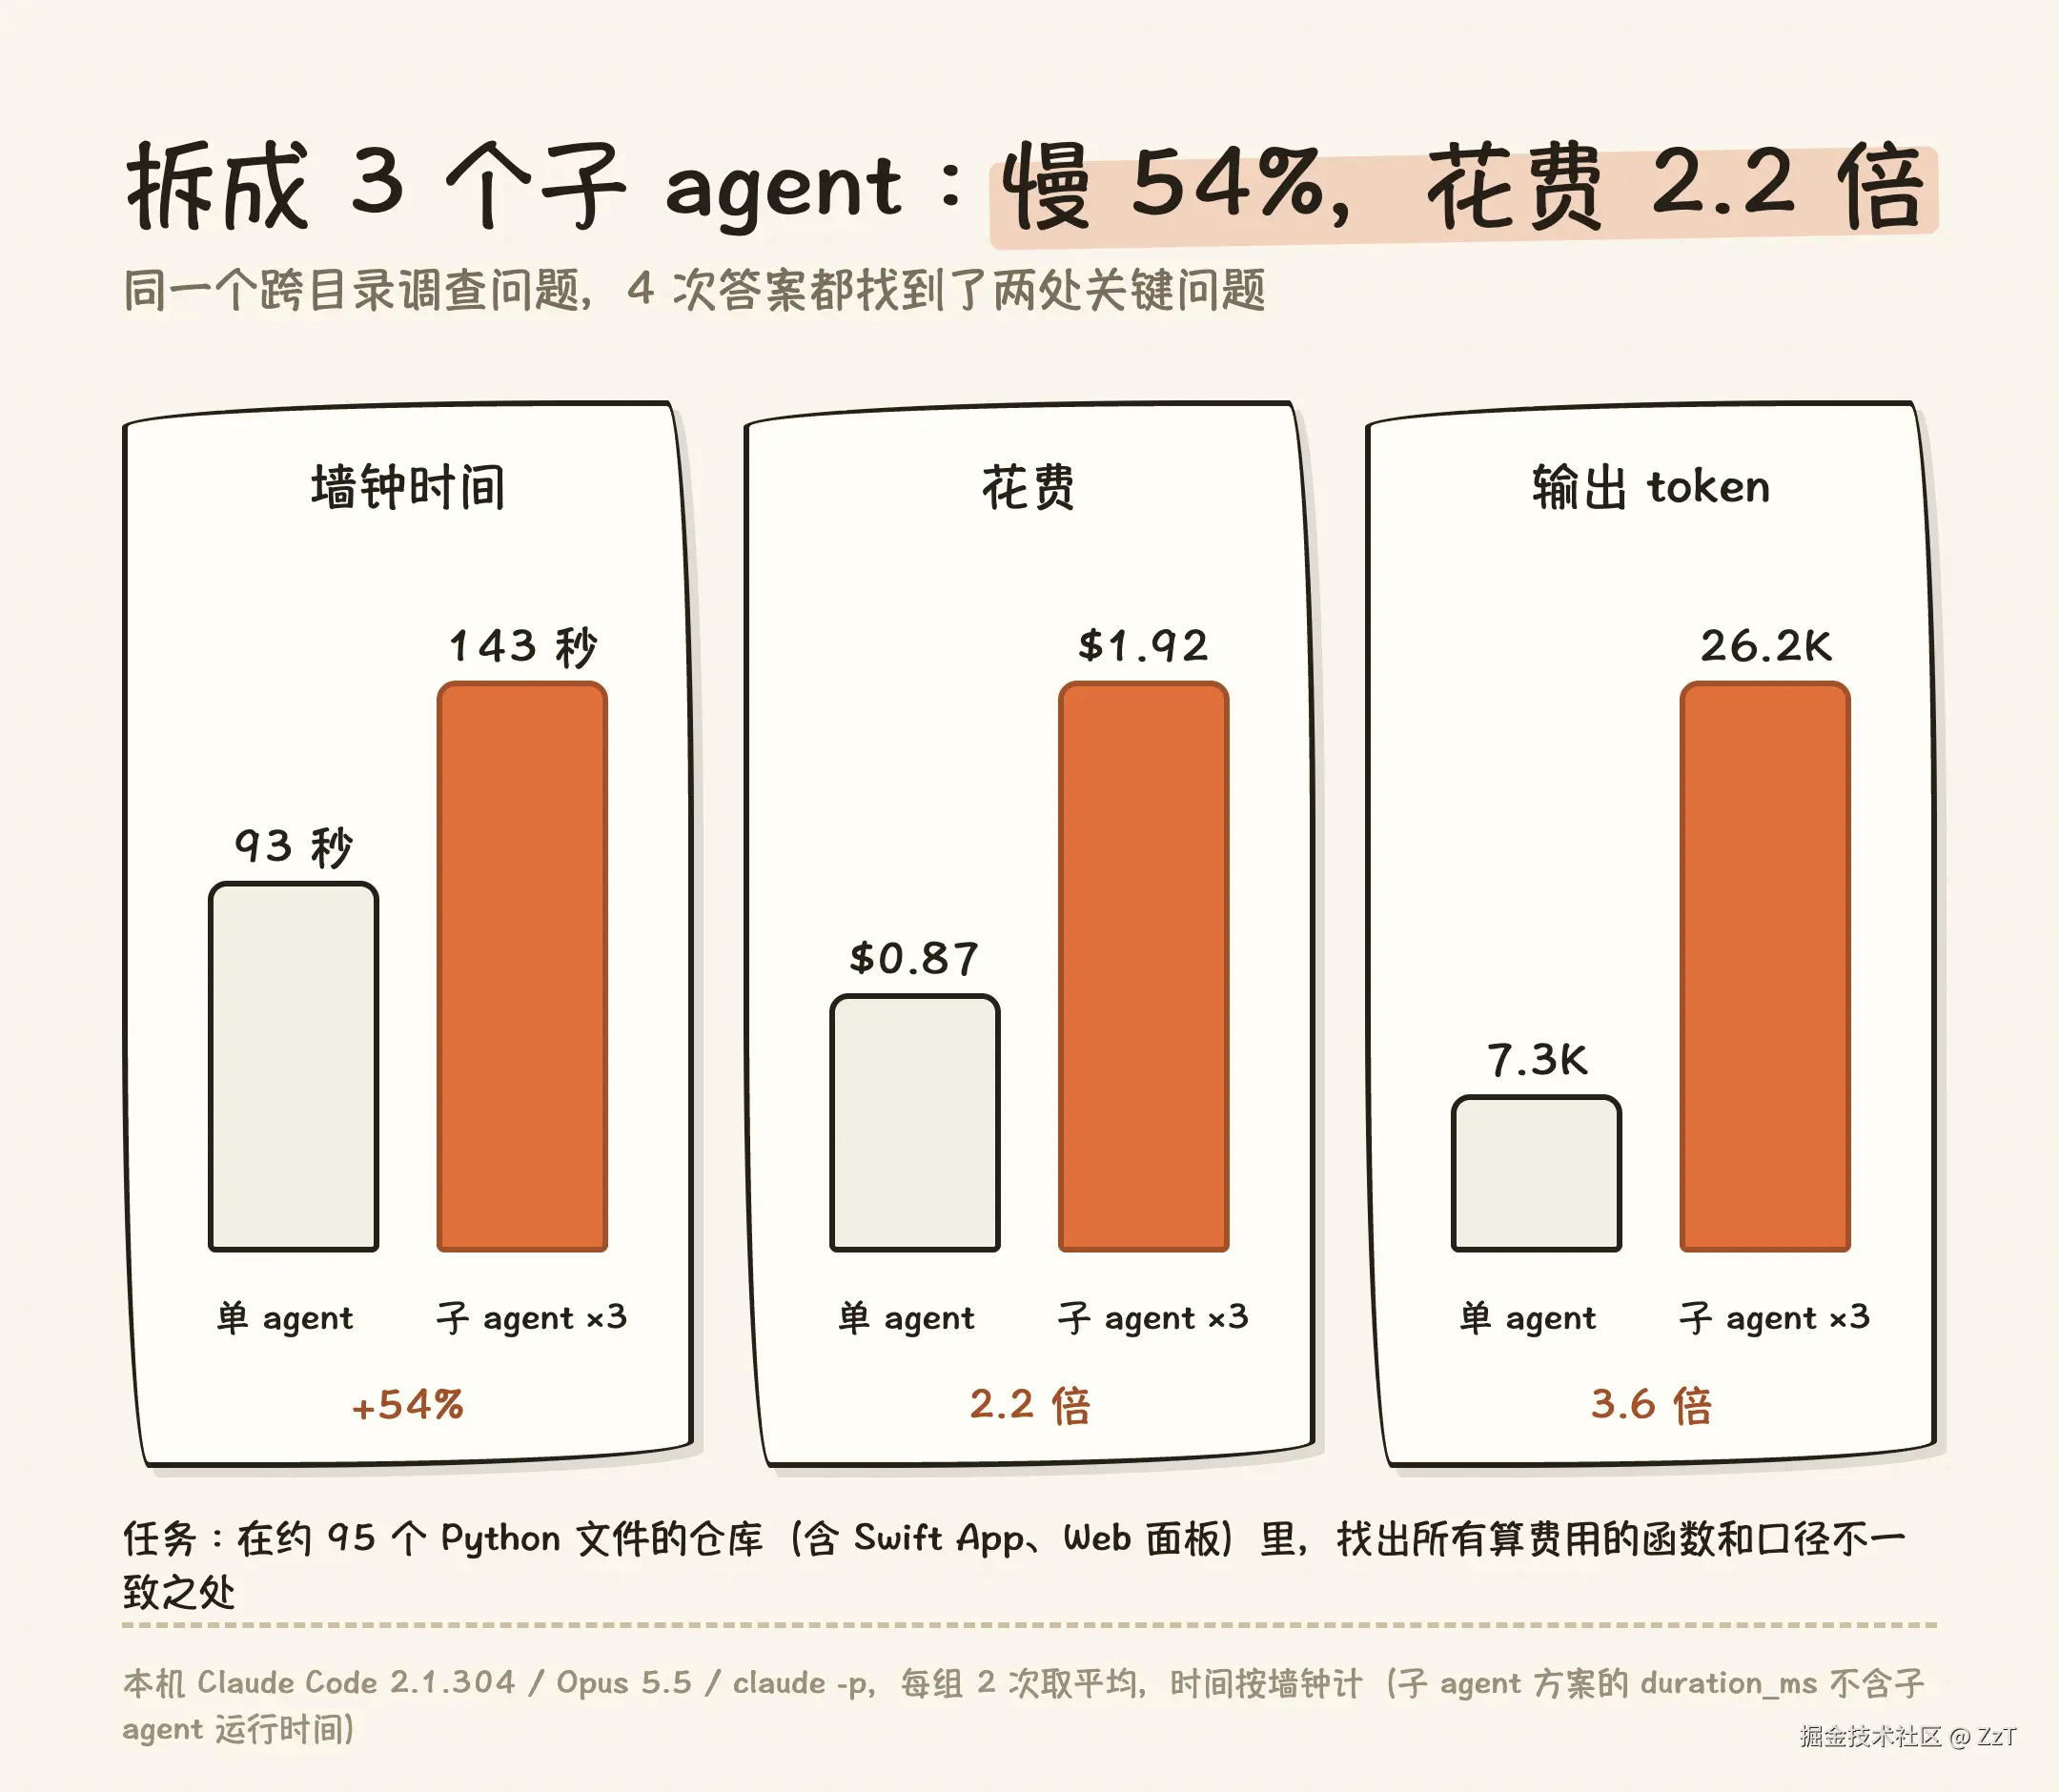
为了在个人使用场景下验证这个结论,我在本机用 Claude Code 2.1.304(Opus 5.5,默认 medium effort)做了一组对照。仓库是开源项目 cc-statistics 的副本,约 95 个 Python 文件,另有一个 Swift 写的 macOS App 和一个 Web 面板。
题目是一个典型的跨目录调查:列出仓库里所有计算美元费用的函数,说明每个函数是调用统一价格表 pricing.py 还是自己写了一套价格,是否计入 cache read 和 cache write,并指出不一致的地方。我事先人工核过标准答案,最关键的两处是:git_integration.py 写死了 Sonnet 的单价、完全不计 cache write;Swift App 里另有一份手抄的价格表。
两种做法各跑 2 次,都用 claude -p --output-format json、只开放只读工具:
- 单 agent:提示里要求不使用 Agent 工具,自己用 Read、Grep、Glob 查。
- 3 个子 agent:提示里要求先并行启动 3 个 Explore 子 agent,按目录分工,全部返回后再汇总。
| 单 agent | 3 个子 agent 并行 | |
|---|---|---|
| 墙钟时间 | 102 秒 / 84 秒 | 138 秒 / 149 秒 |
| 花费 | 0.98/0.77 | 1.84/2.01 |
| 输出 token(含子 agent) | 7,592 / 7,051 | 24,178 / 28,301 |
| cache write token | 86K / 65K | 197K / 208K |
| 找到 git_integration 的写死单价 | 2/2 | 2/2 |
| 找到 Swift 第二份价格表 | 2/2 | 2/2 |
平均下来,子 agent 方案慢 54%,花费是单 agent 的 2.2 倍,输出 token 是 3.6 倍。答案质量没有拉开差距:四次都找到了两处关键问题,各自多报或少报的是一些次要的口径差异。
多出来的成本可以从输出里看到原因。两次子 agent 运行,主 agent 在汇总前都写了类似「我又抽查了几条关键结论」「关键几处我也对照源码核过了」的话,也就是在子 agent 已经读过代码的基础上,主 agent 为了确认摘要可靠,又把关键文件读了一遍。三个子 agent 各自还要加载一份系统提示和工具定义,这部分体现在翻倍的 cache write 上。
还有一个容易踩的计时陷阱:claude -p 输出的 JSON 里,子 agent 方案的 duration_ms 只记了 30 秒左右,不包含子 agent 的运行时间。比较两种方案的耗时,要用墙钟时间。
这组实验样本小,每组只有 2 次,只覆盖了一个只读调查任务,不能直接推到写代码的任务上。它能说明的是:对于一个中等规模仓库、主上下文完全装得下的调查问题,拆子 agent 没有换来速度,也没有换来质量。
Quickchat 的 20 个 PR:代码评审 max 档花了 188 倍
另一组更大规模的数据来自 Quickchat AI 的 Mateusz Jakubczak(10 月 21 日)。他用 Martian Code Review Benchmark 里的 20 个 PR(来自 Sentry、Grafana、Cal.com 等项目,共 27 个严重或高危问题),对比了 Claude Code /code-review 的 high 和 max 两档。按他的观察,high 是一个 agent 依次过 8 个审查角度,max 是约 10 个 finder 子 agent 并行,再加 verifier 和一轮汇总;Claude Code 官方文档没有写明各档使用几个 agent。
| Sonnet 5.5,20 个 PR | high(单 agent) | max(多 agent) |
|---|---|---|
| 严重问题命中 | 21/27 | 23/27 |
| 全部问题命中 | 47/65 | 47/65 |
| 每个 PR 额外报告的条数 | 11.9 | 23.9 |
| 每次耗时 | 40 秒 | 56 分钟 |
| 每次花费 | $0.11 | $20.95 |
| 20 个 PR 总花费 | $2.12 | $398.03 |
多 agent 多找到 2 个严重问题,代价是 188 倍的花费、80 多倍的时间和翻倍的噪声。一个极端案例里,全部用 Opus、不设预算上限的 max 在一个 97 行的 PR 上花了 40.64 美元,撞到 30 分钟超时,一条结果都没输出。
这组数据要带着限定条件看。作者的公司做竞品 Quickchat Review,文中自己披露了;每种配置只跑了一次;20 个 PR 是挑出来的;质量评判只用了两个 LLM 裁判,而两个裁判只在 56% 的对局上意见一致。作者自己的建议是:大多数 PR 先用 /code-review high。
仍然该用子 agent 的三种情况
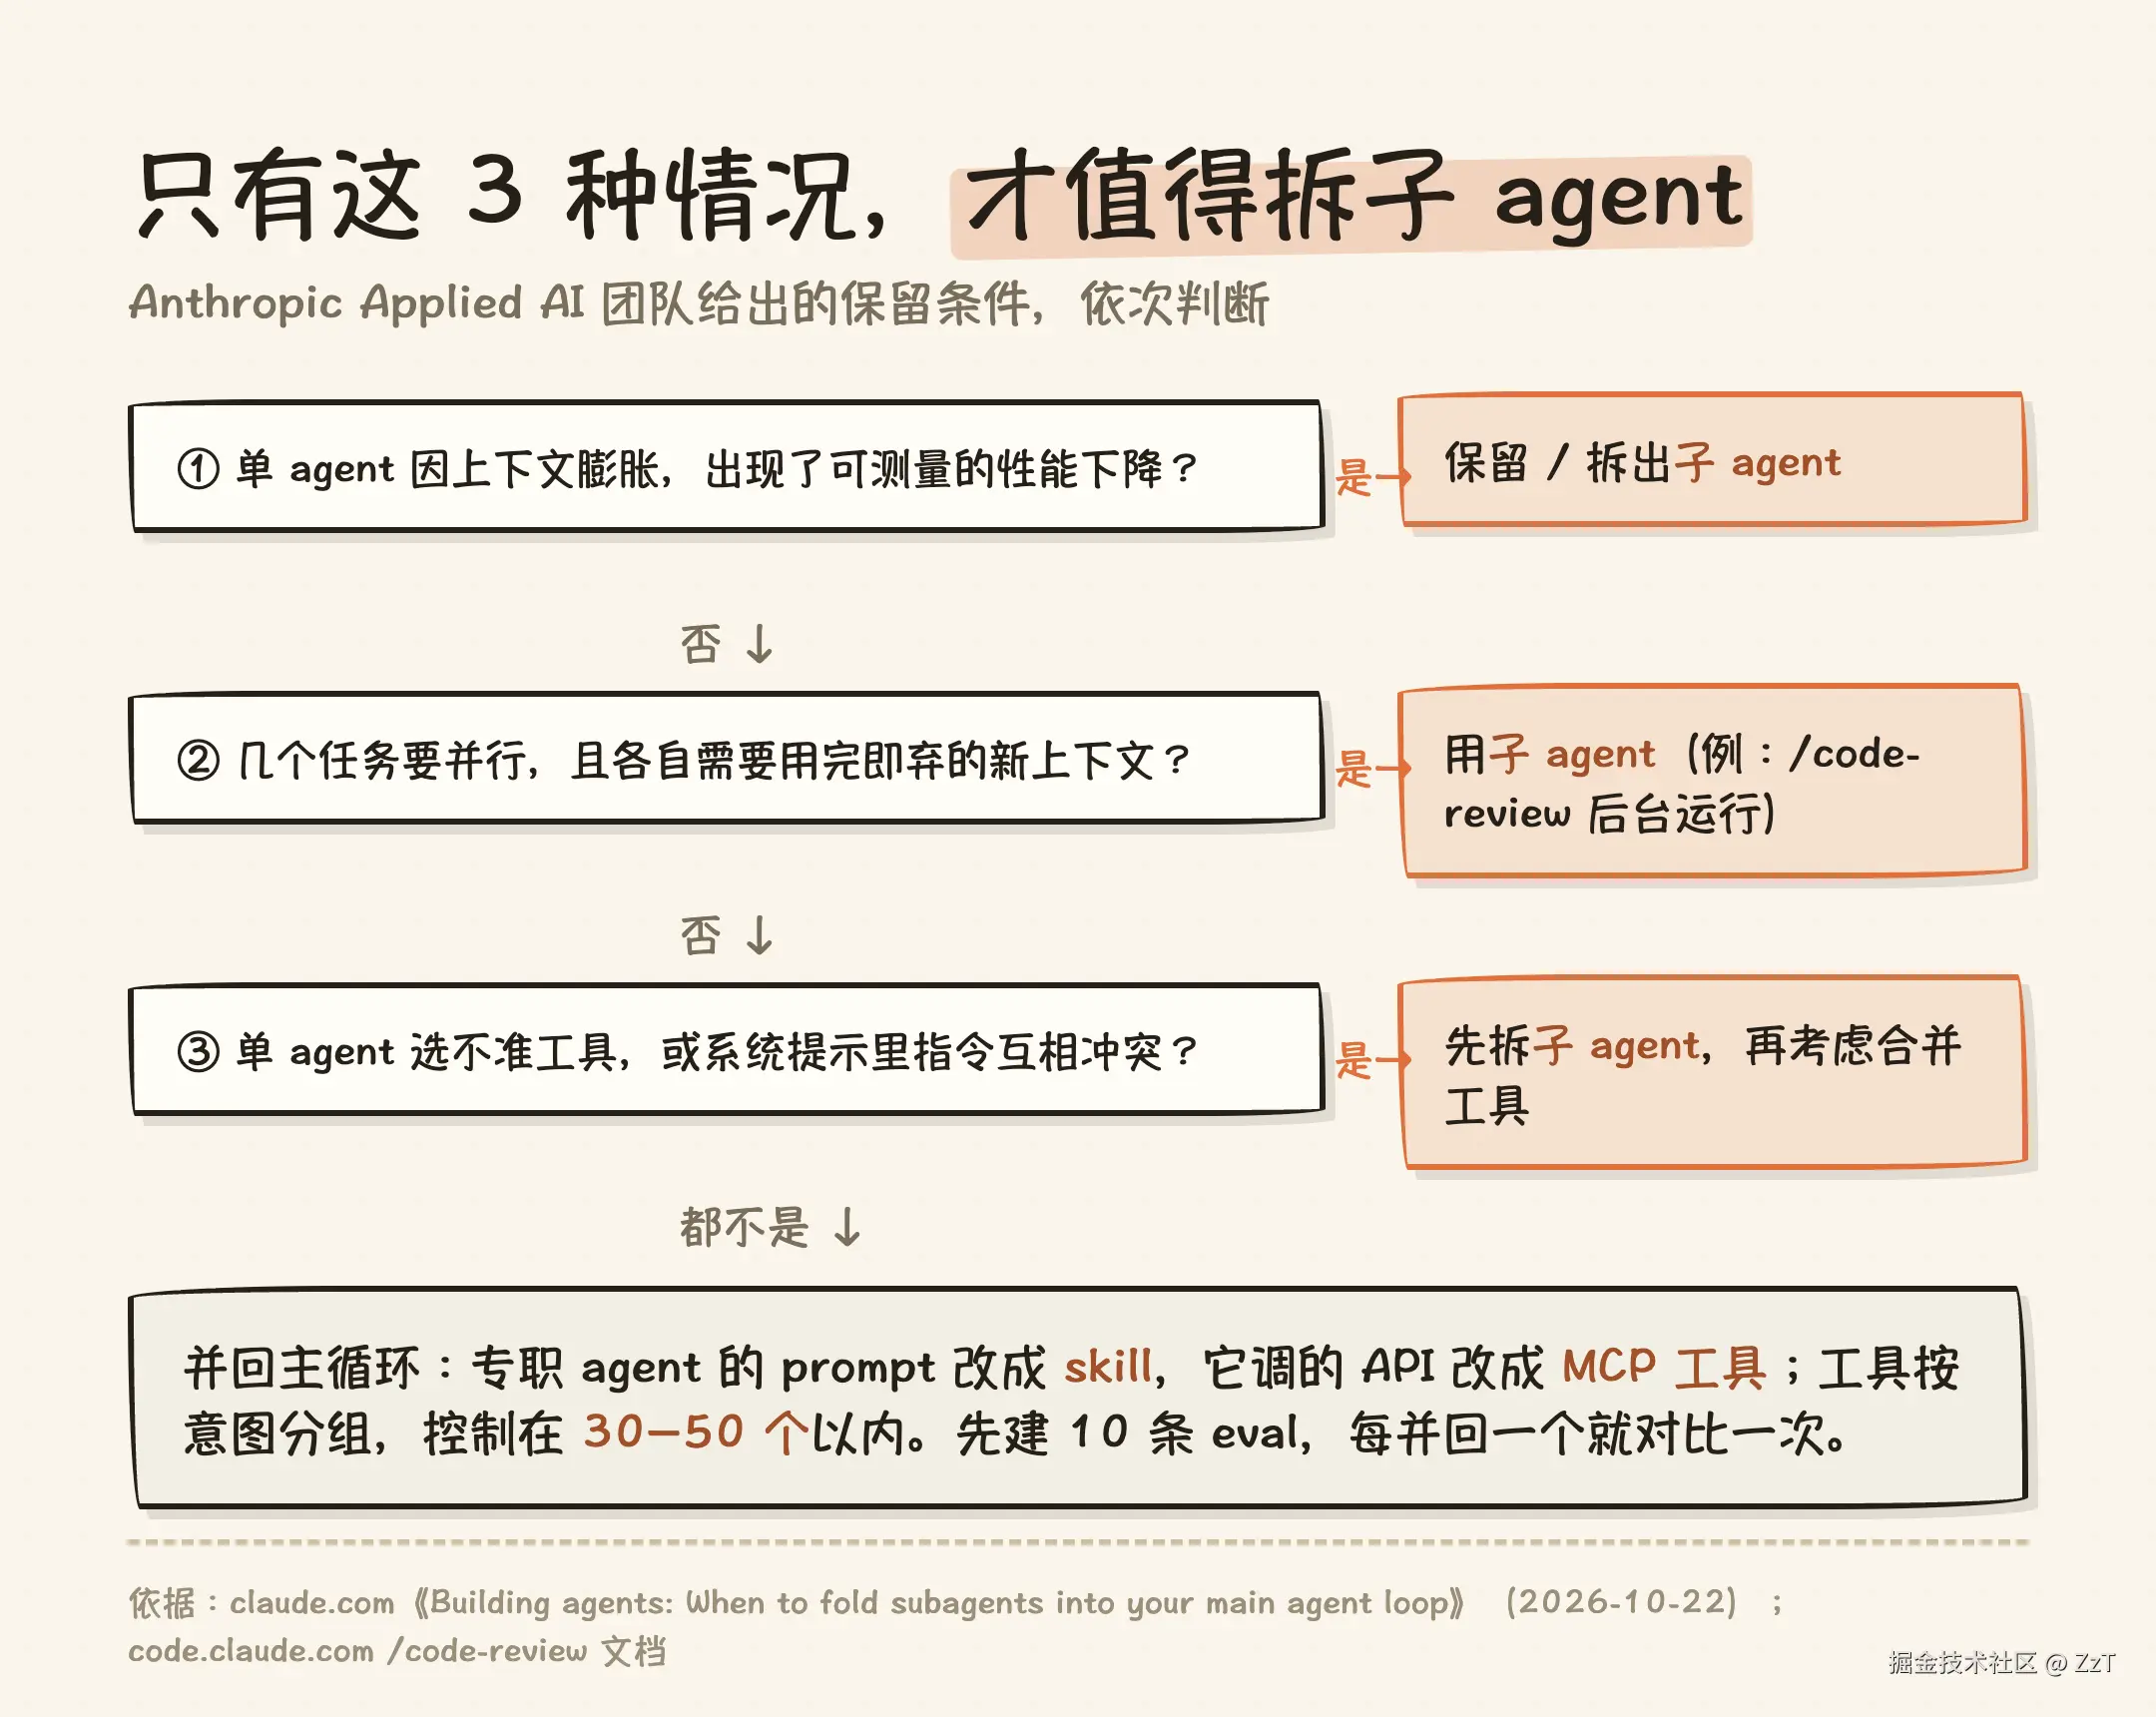
原文没有否定子 agent,而是给了三个明确的保留条件:
- 单 agent 循环因为上下文膨胀,出现了可测量的性能下降。
- 多个任务需要并行,并且每个任务需要一个用完即可丢弃的新上下文窗口。
- 单 agent 选不准工具,或者系统提示里有互相冲突的指令。
Claude Code 本身就有符合第 2 条的例子。官方文档写明,本地 /code-review 以后台子 agent 运行,有自己的上下文窗口,「so it doesn't fill your conversation」。评审过程中读的大量代码不会留在你的主对话里,这正是子 agent 该用的地方。
对于要从多 agent 迁回来的团队,原文给的顺序是:先建一个端到端 eval,10 条标准样例就够起步;优先合并互相调用、共享数据、经常一起被调用的子 agent;过渡期可以让主 agent 把子 agent 当工具调;然后逐个折叠,把子 agent 的 prompt 改成 skill,把它调用的 API 改成 MCP 工具,每折叠一个就对比一次 eval。
原文也记录了一次失败:在一个示例客服 agent 上合并一个子 agent 后延迟降了,但一个原本通过的流程坏了。主 agent 手里有查订单的工具,就自己回答了,没有去问配送专员要送达日期。所以 eval 里要覆盖生产中每一条一起运行的 agent 链和每一条不能违反的规则,每个任务跑不止一次。
在 Claude Code 里怎么用子 agent
| 场景 | 做法 | 依据 |
|---|---|---|
| 一个仓库里的调查、改动,上下文装得下 | 让主 agent 自己做,不要在 prompt 里要求「开几个 agent 并行」 | 本地实测:并行慢 54%、贵 2.2 倍,质量相同 |
| 要扫大量文件,但只需要结论 | 用子 agent,让它读完只交回结论 | 原文条件 2;主上下文不被大段文件内容占满 |
| 几个互不相关的任务要同时跑 | 用子 agent 并行 | 原文条件 2 |
| 一类工作有固定步骤和判断规则 | 写成 skill,而不是写成专职子 agent | 原文:skill 放「how a team does work」 |
| 工具或 MCP 越接越多 | 按意图合并工具,控制在 30 到 50 个以内 | 原文:超过后选工具准确率下降 |
| 代码评审 | 先用 /code-review high,重要的 PR 再考虑更高档 |
Quickchat:max 花费 188 倍,严重问题多找到 2 个 |
判断标准只有一个:主 agent 的上下文是否真的装不下,或者是否真的需要一份用完即弃的独立上下文。两者都不满足时,拆出去的子 agent 只是在重复读代码、重复写摘要,最后由主 agent 再核一遍,时间和钱都花了两次。