2026 年云栖大会,Hologres 发布全新 5.0 版本,以"Agent Native 的全模态实时数仓"为核心理念,提出"从实时数据,到可靠行动"的演进方向。Hologres 负责人姜伟华在演讲中指出,随着 AI Agent 成为数据系统的全新用户角色,数据基础设施正面临从"服务人和报表"到"服务 Agent 自主决策与行动"的范式转变。Hologres 5.0 围绕实时完整的数据、可理解的语义、可信可控的行动、自适应执行四大支柱进行全面升级,并首次发布数据沙箱、图检索、Semantic View、User Defined Agent、OpenMemory、HoloScope 等多项重磅能力,致力于成为 Agent 时代企业最可靠的数据底座。
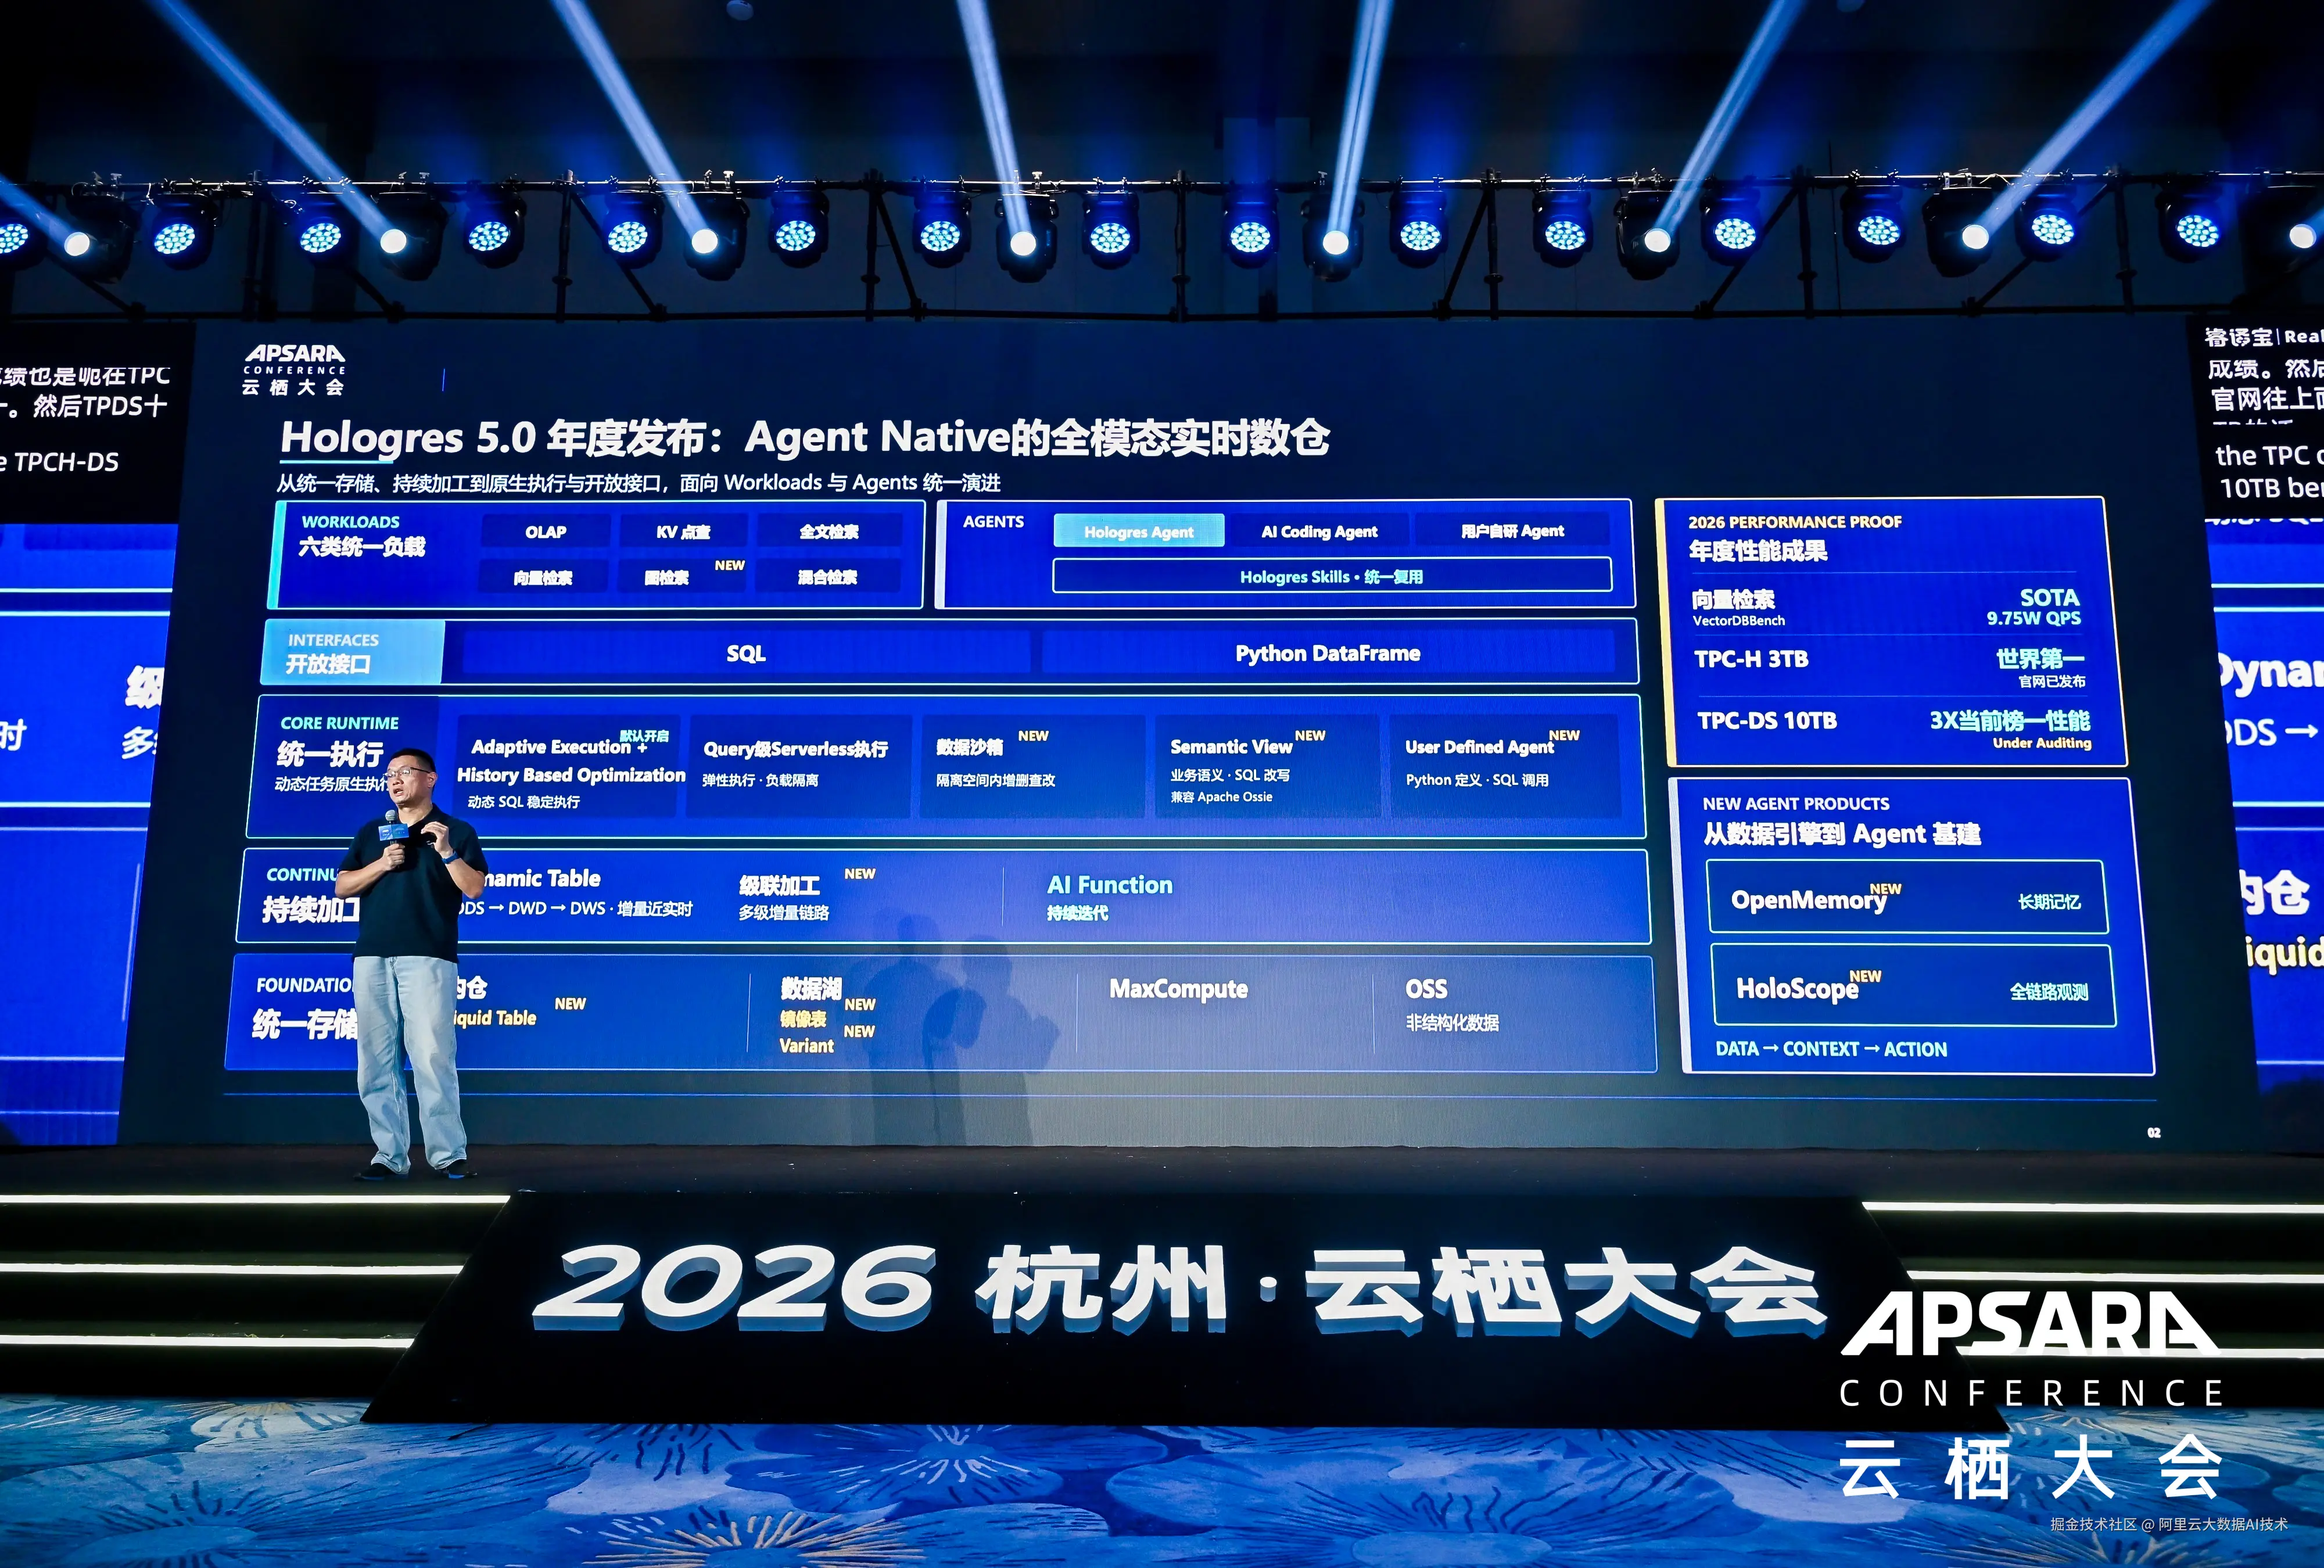
阿里云智能集团 · 计算平台事业部 Hologres 负责人 姜伟华
从服务人到服务 Agent:OLAP 迎来全新挑战
过去,数据系统主要服务于业务人员和 BI 报表,用户通过 SQL 提问、人工解释、人推动下一步行动;而现在,Agent 正在成为新的"数据用户"------它持续运行、自主组合上下文、检索推理并调用工具,结果直接回流到下一轮判断与行动中。
Agent 带来的价值显而易见:更低门槛的自然语言理解复杂数据、持续实时感知变化、从洞察走向闭环行动。但与此同时,它也给数据系统提出了四项全新挑战。
第一,实时完整的数据。 Agent 需要同时处理结构化、多模态、关联关系等多种数据形态,且要求数据实时可查。过去数据可能散落在各个孤立系统中,但现在 Agent 需要访问完整的数据视图,才能做出足够深入的洞察。
第二,可理解的语义。 指标口径、实体关系等业务语义必须内建于数据系统,而非依赖人工反复解释物理表结构。"什么是有效订单"------这类过去只存在于 SQL 和业务人员脑子里的概念,现在必须被显式表达出来,让 Agent 能够理解。这也是为什么近期与 Agent 相关的本体论研究变得非常热门。
第三,可信可控的行动。 Agent 的操作必须有权限围栏、隔离环境和完整观测,确保每一步行动可审阅、可追溯。OLAP 系统往往直接服务于 2B 或 2C 的线上系统,Agent 如果随意操作,很容易影响线上稳定性。即使 Agent 是善意的,一条未经优化的 SQL 也可能瞬间耗尽实例资源,导致系统崩溃。
第四,查询不可预测,功能优先于性能。 Agent 的访问模式和资源消耗难以提前预判,数据引擎必须具备自适应优化能力。Agent 更关注功能是否正确,而不会像人类工程师那样精心调优 SQL 性能,但 OLAP 系统对查询性能极其敏感,如何让 Agent 生成的 SQL 稳定高效地运行,是一个巨大的挑战。
数据沙箱:让 Agent 拥有安全的行动空间
Hologres 5.0 首次发布数据沙箱能力。 这是基于当前生产实例创建的隔离Agent工作空间,支持Agent任意增删查改,而不会影响原实例的生产数据。
数据沙箱的设计理念是在生产实例之上创建一个可写、可验证的隔离环境。Agent 可以在沙箱中自由执行分析、修改指标口径、实验表结构优化,所有操作均使用独立计算资源,不影响生产系统。验证通过并审批后,变更才合并回原实例。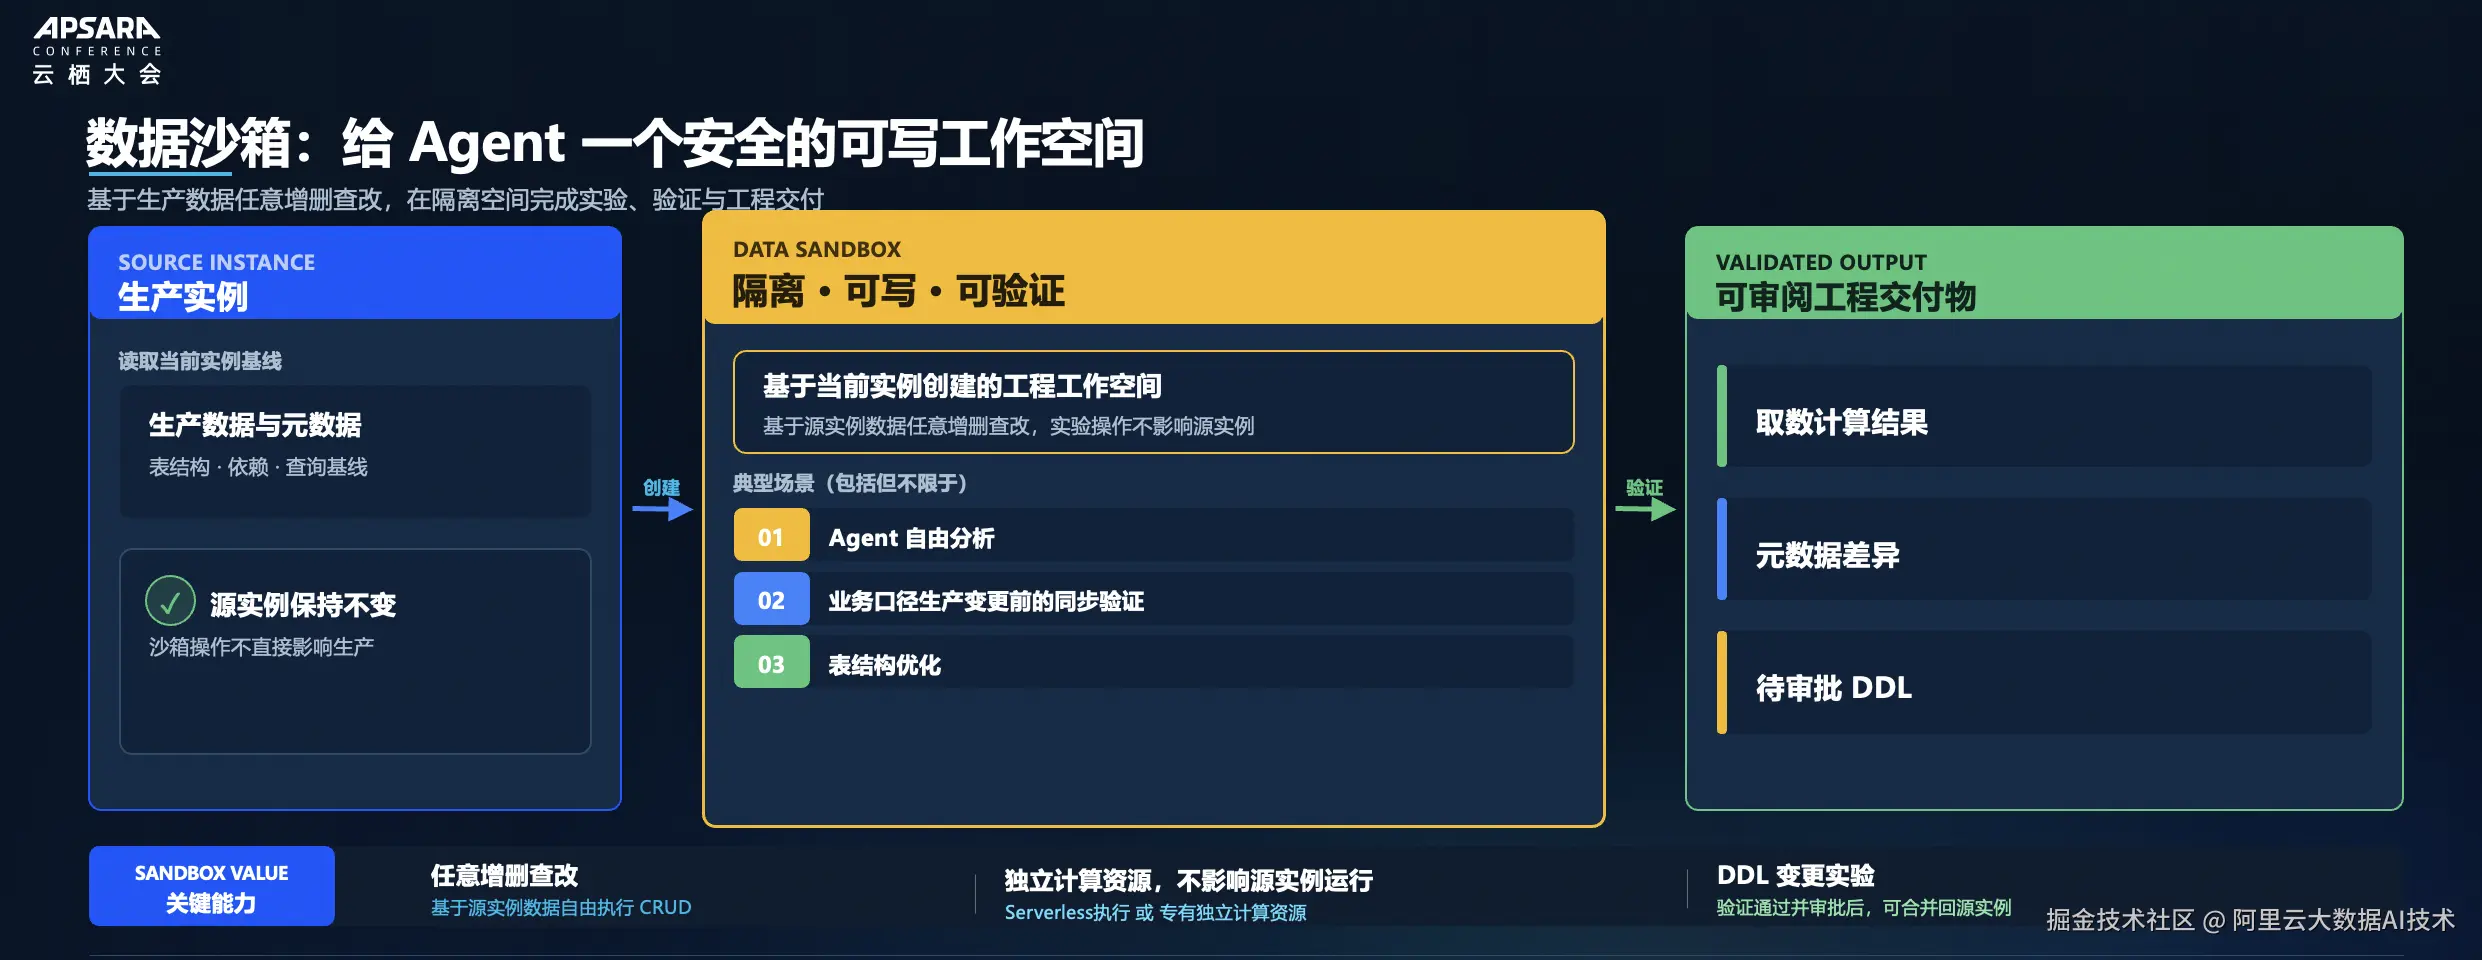
这一能力对 Agent 场景尤为关键。在过去,Agent 直接操作生产数据存在巨大风险;有了数据沙箱,Agent 获得了一个"自由但安全"的行动空间,可以先实验、再验证、最后交付,真正实现从洞察到执行的闭环。即使面对 PB 级数据,Hologres 也能快速克隆出沙箱环境,让 Agent 在其中执行长时间、多步骤的复杂操作。 Hologres Agent Demo 演示 >>
全新图检索:从"找相似"走向"懂关系"
在标量查询、全文检索、向量检索的基础上,Hologres 5.0 全新发布图检索能力,基于 AGE 扩展,通过 SQL 调用 Cypher 子集并与普通 SQL 组合分析。这标志着 Hologres 从"分析与相似检索"迈向"实体关系与路径查询",成为真正的全模态数仓。
图检索的核心价值在于回答"为什么相关、如何关联"。过去计算数据更多是找各种数据之间的相关性,向量检索就是一种相关性的检索;但在本体论的时代,关系、知识图谱变得非常重要。以电商场景为例,传统向量检索可以找到相似商品,但图检索可以沿着"客户→下单→订单→包含→商品→规则命中→渠道→品牌"的关系路径进行多跳查询,支撑知识图谱构建与 Agent 决策。
在 Agent 应用中,图检索的价值尤为突出:Agent 从一个业务问题出发,通过图检索找到正确的数据、理解指标口径、生成有据可查的分析结果,让 AI 推理不再"凭空猜测",而是沿着真实的关系网络展开。姜伟华透露,目前已有多个内部和外部客户基于 Hologres 的图能力构建知识图谱。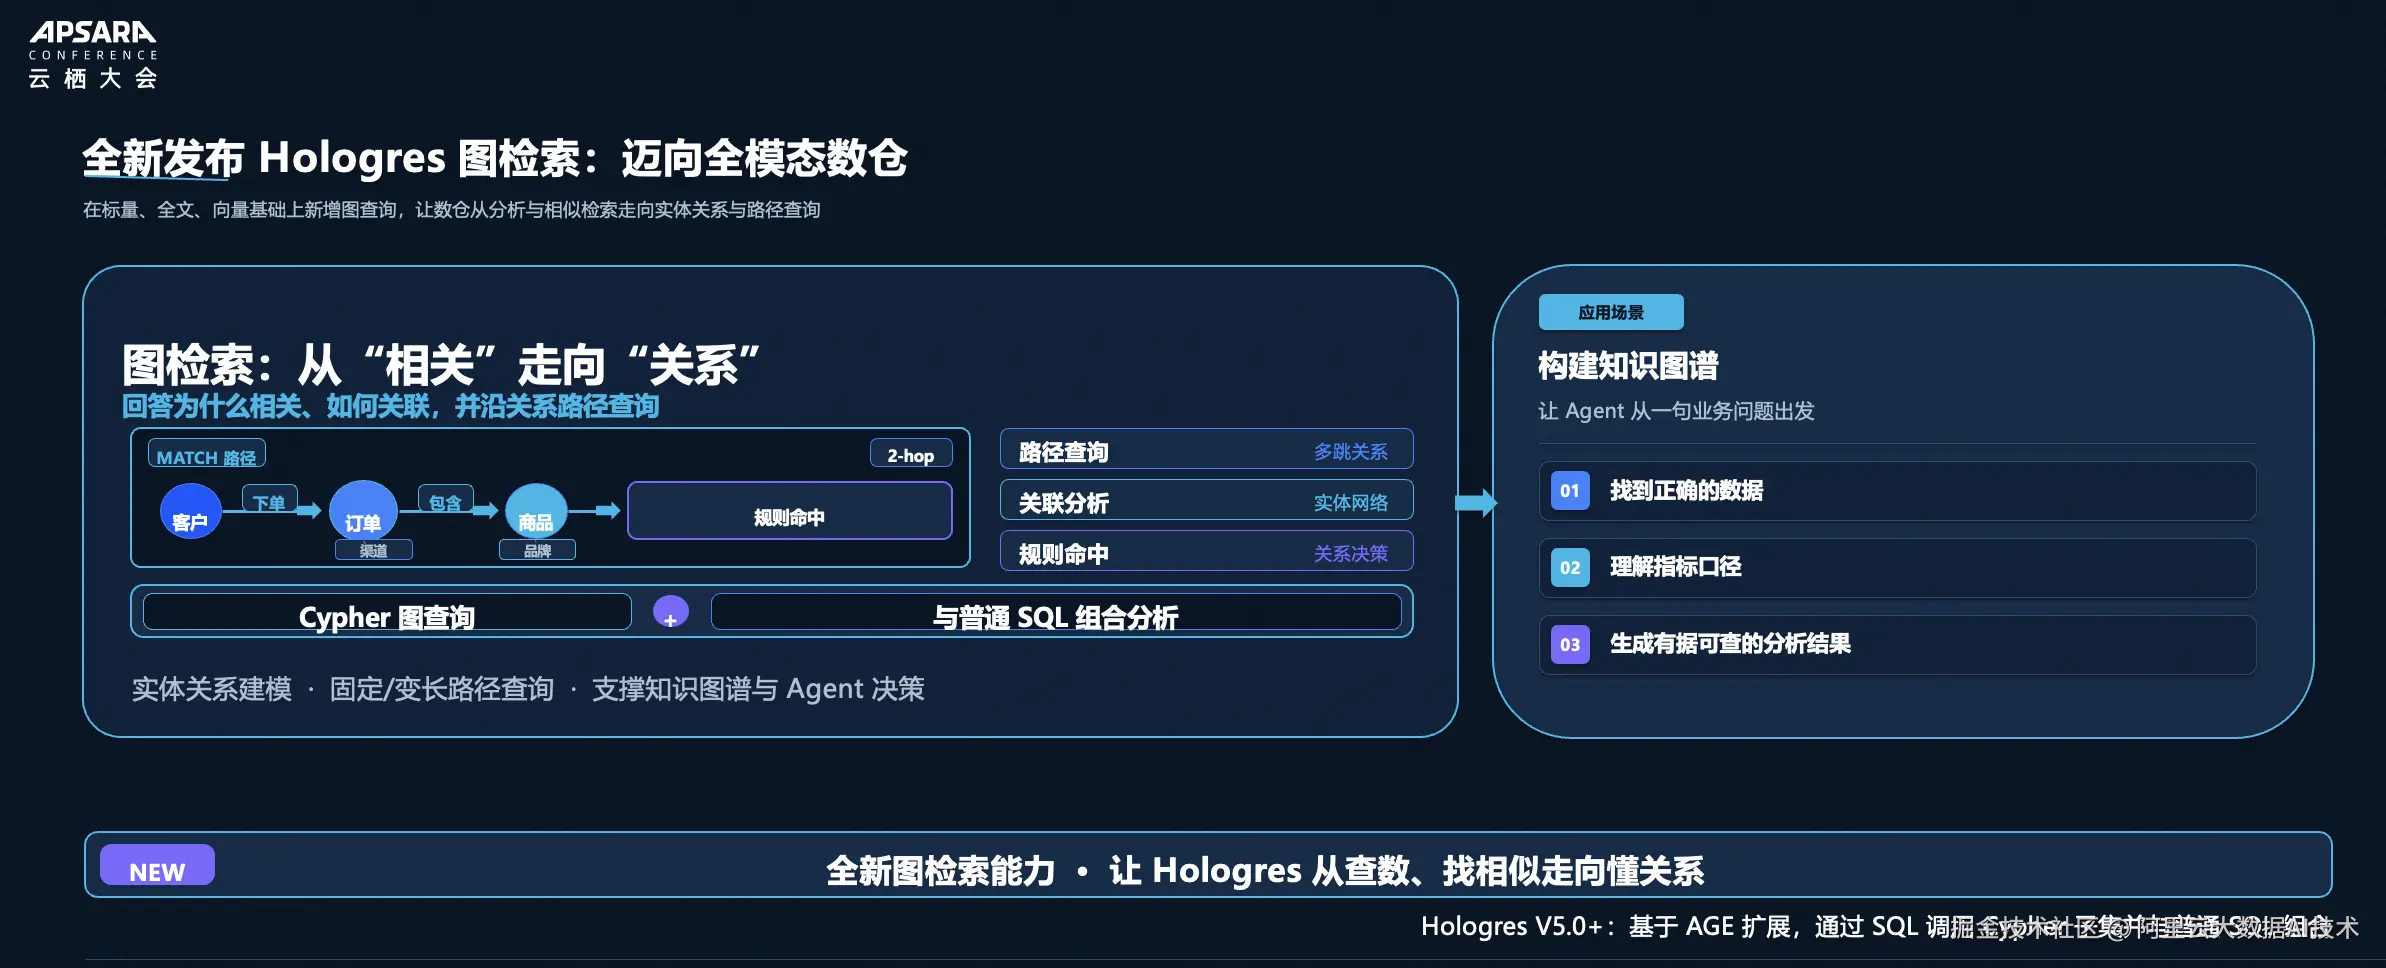
Semantic View:让人、BI 和 AI 使用同一套业务语言
同一指标多套算法、星型模型 JOIN 复杂、一对多 JOIN 造成指标放大、AI 只看物理表容易猜口径------这些长期困扰数据团队的痛点,在 Hologres 5.0 中通过 Semantic View 得到系统性解决。
Semantic View 允许用户以声明式方式定义表间关系(TABLES / RELATIONSHIPS)、业务维度(DIMENSIONS)和指标(METRICS),由引擎自动完成最小 JOIN 子树计算、表裁剪与先聚合后关联,规避 fan-out 问题,保证同一条记录对同一维度至多贡献一次。最终生成 YAML 语义模型,供 BI 工具和 AI Agent / NL2SQL 直接读取。Semantic View 兼容 Apache Ossie,这是当前最流行的语义层定义标准之一。
这意味着,业务人员、BI 报表和 AI Agent 终于可以使用同一套业务语言进行数据交互,不再需要反复解释物理 JOIN 与指标口径。对 Agent 而言,Semantic View 让它能够"听懂"业务语义,大幅提升数据访问的准确性和效率。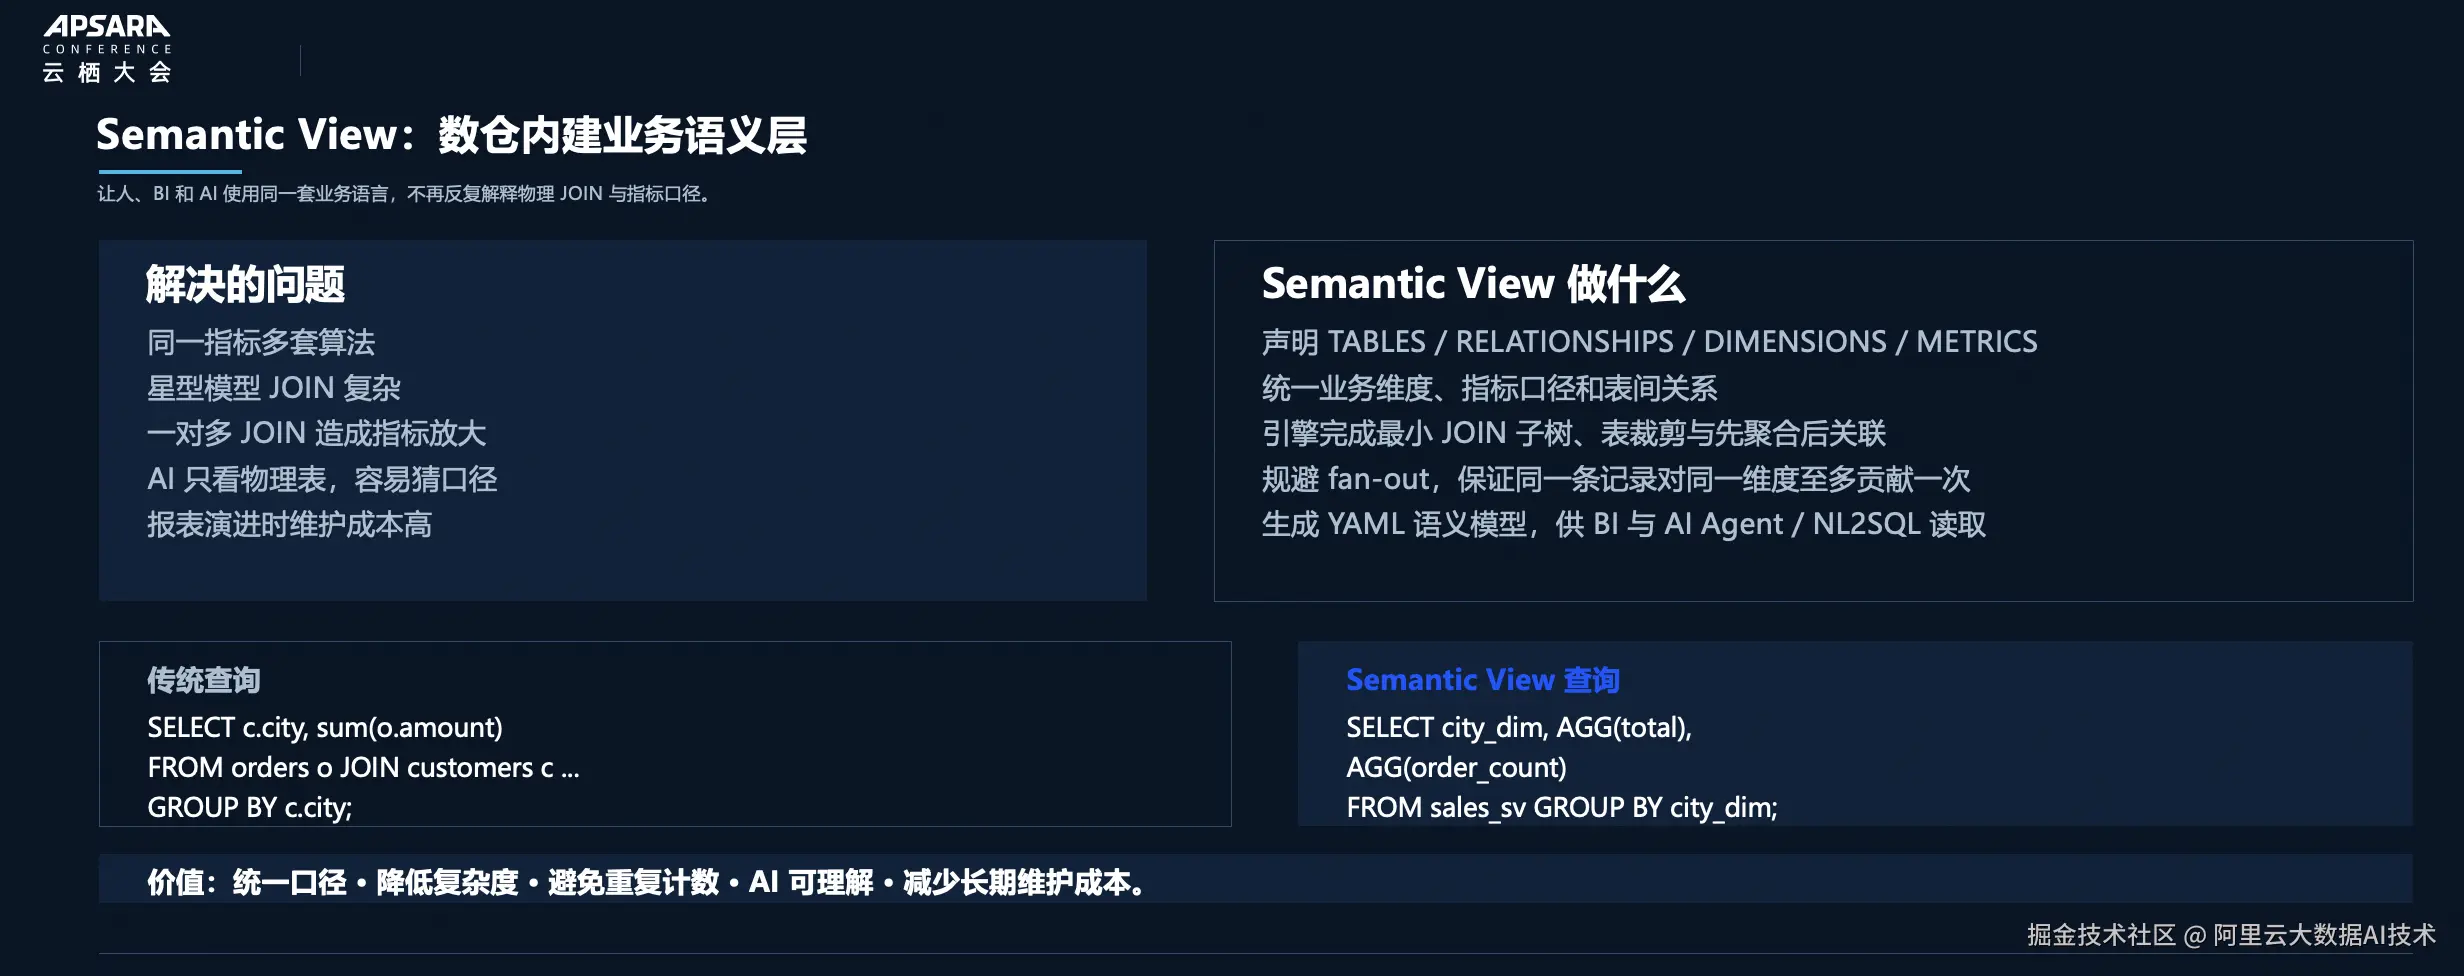
User Defined Agent:让 Agent 与数据深度绑定
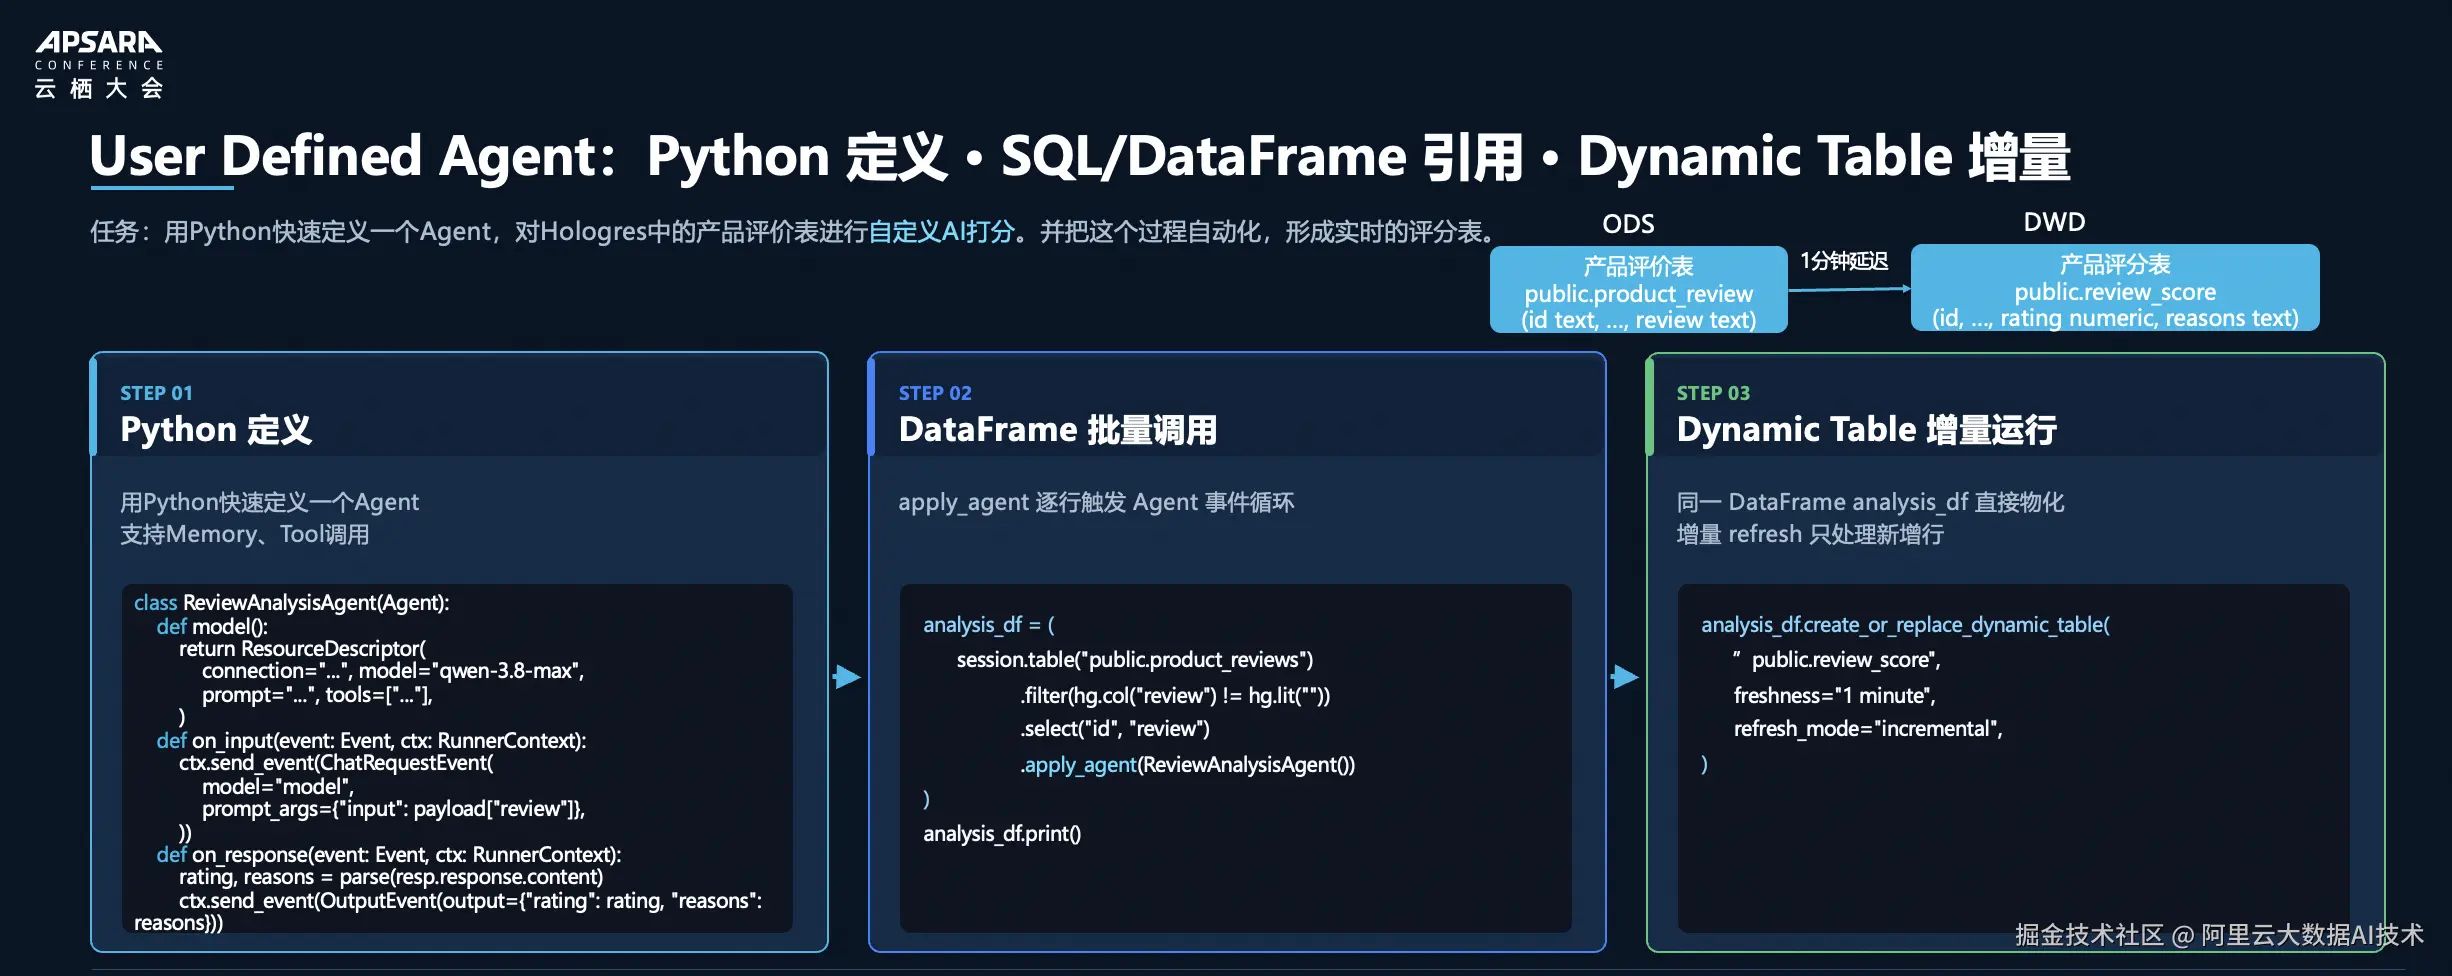
Hologres 5.0 发布了 User Defined Agent 能力,开发者可以用 Python 快速定义一个 Agent,支持 Memory 和 Tool 调用,并通过 DataFrame API 实现批量调用与增量运行。
以一个实时评分场景为例:用户有大量文本形式的商品评价数据,希望将这些评价自动转换为好评分数。首先用 Python 简单定义一个 Agent 类,声明模型连接、Prompt 和工具集;然后通过 DataFrame 的 apply_agent 方法逐行触发 Agent 事件循环进行批量分析,可以直接运行查看结果是否符合预期;符合预期后,将同一 DataFrame 物化为 Dynamic Table,以增量刷新方式持续运行,仅处理新增行。这样就了构建一个一分钟延迟的实时数据管线。整个过程通过 Agent 与 Dynamic Table 的深度结合实现:Agent 不再是外挂式的应用,而是与 Hologres 数据深度融合的"原生居民",可以直接在数据仓库内运行,利用 Dynamic Table 的增量加工能力持续处理新数据,真正实现"数据驱动行动"。
这一能力本质上是将过去的用户定义函数(UDF)升级为用户定义 Agent。Agent 可以直接与 DataFrame 联用,就像一种 AI 算子,让传统的数据处理流程具备了智能分析能力。
OpenMemory 与 HoloScope:服务所有通用 Agent
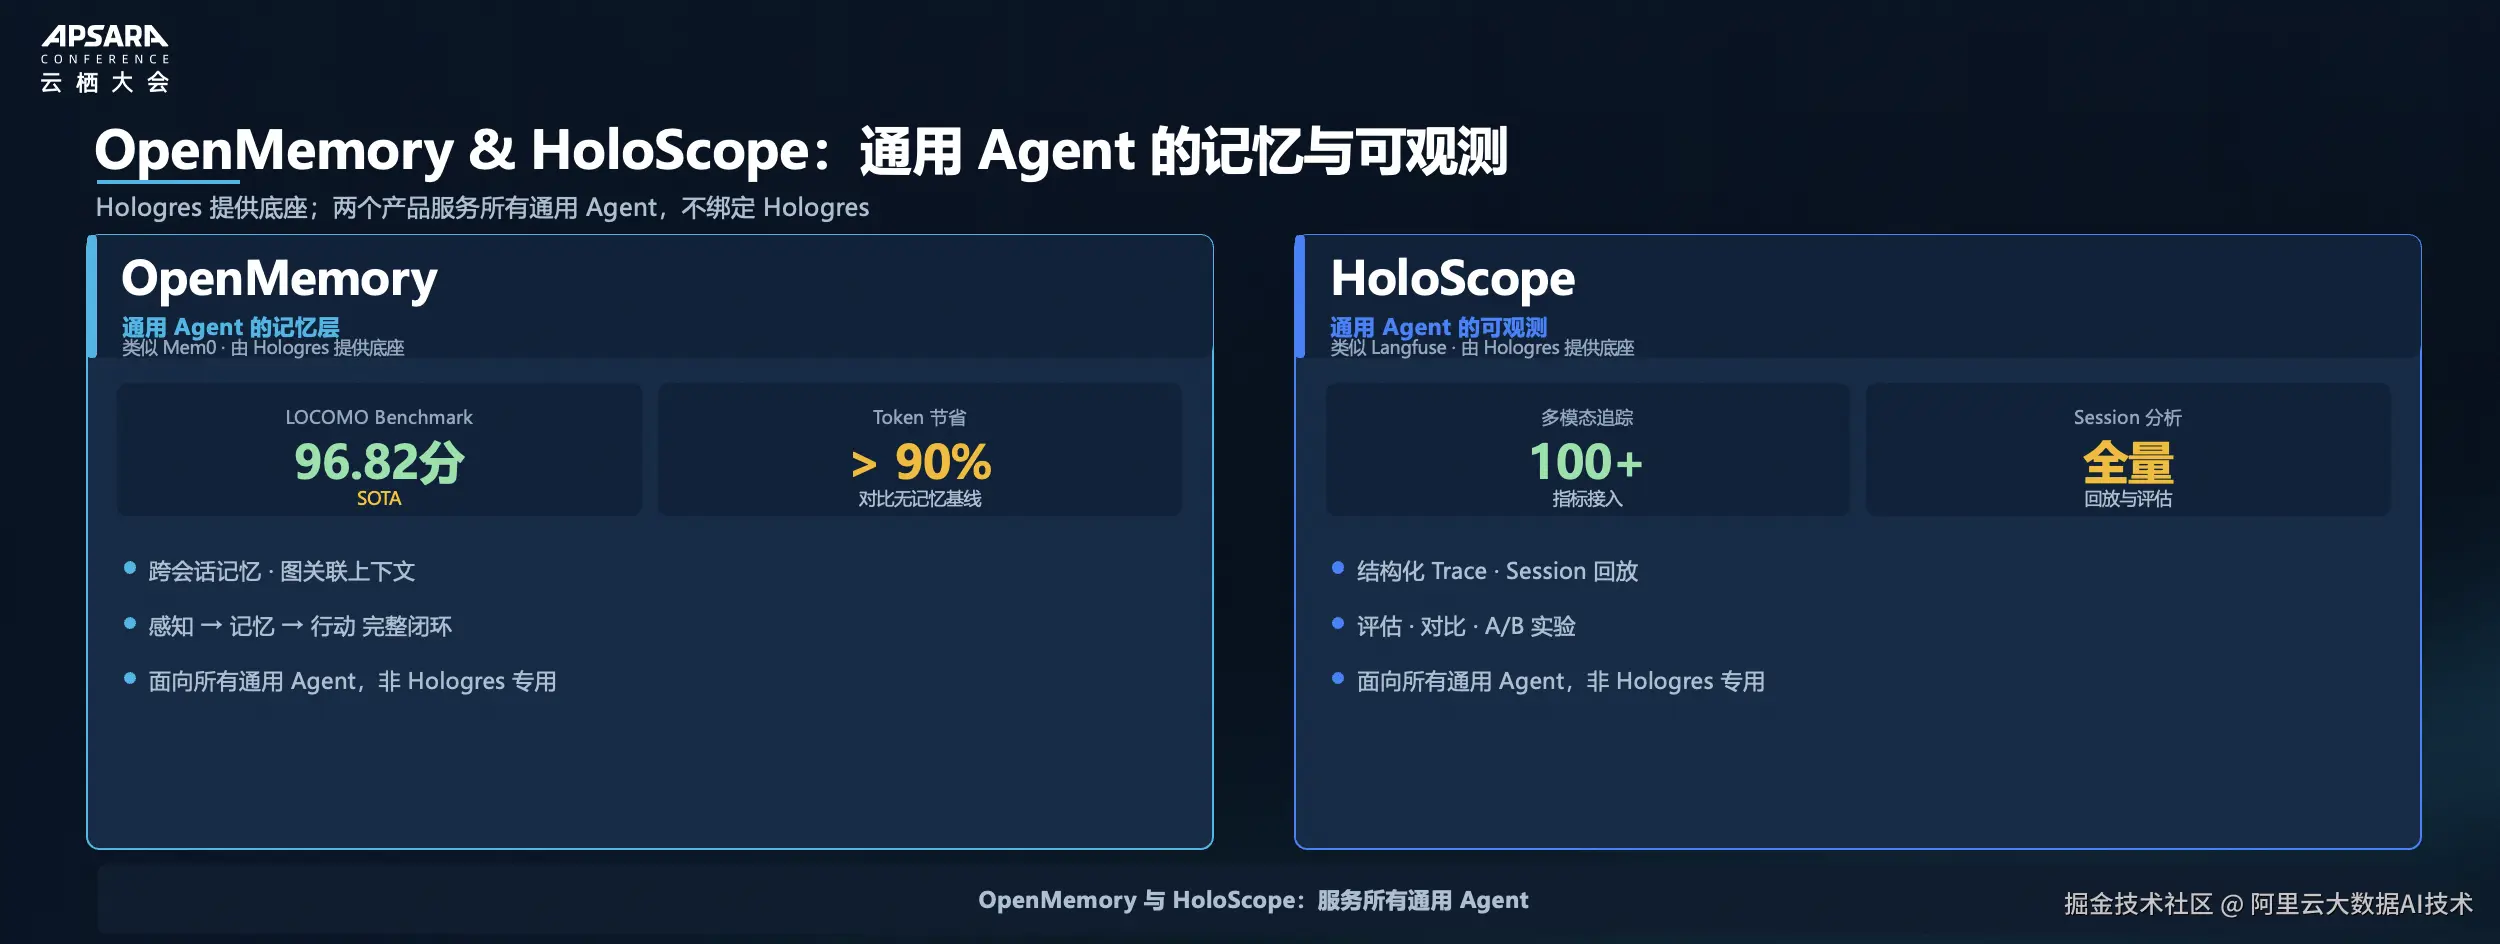
Hologres 5.0 还发布了两项面向通用 Agent 生态的基础设施能力:OpenMemory 和 HoloScope。
OpenMemory 是通用 Agent 的记忆层,类似 Mem0,由 Hologres 提供存储底座。它支持跨会话、跨设备的记忆协作,实现"感知→记忆→行动"的完整闭环。在评估记忆能力最权威的基准测试之一 LOCOMO Benchmark 中,OpenMemory 以 96.82 分的成绩达到世界最高水平。 姜伟华透露,相比没有记忆的基线,OpenMemory 能够节省 90% 以上的 Token 消耗。OpenMemory 的接口基本兼容 Mem0 方案,面向所有通用 Agent,并非 Hologres 专用。
HoloScope 则是通用 Agent 的可观测平台,同样由 Hologres 提供底座。当 Agent 真正放到生产环境后,需要一套完整的可观测、验证、CI/CD 体系来保证稳定性。HoloScope 支持多模态追踪、100+ 指标接入、全量 Session 回放与评估,以及对比和 A/B 实验能力。结构化 Trace 和 Session 回放让 Agent 的每一步行动都可追踪、可审计。
四大支柱:构建 Agent 时代的完整数据底座
姜伟华在演讲最后将 Hologres 5.0 的能力总结为四大支柱:
在数据层面, Hologres 实现统一访问内仓、数据湖、MaxCompute 和 OSS,支持结构化、半结构化(JSON、Variant)和非结构化数据的全模态存储,并通过 Dynamic Table 进行增量近实时加工,生成更适合 Agent 访问的数据形态。姜伟华特别强调,数据分层对 Agent 尤为重要------本质上是数据的清洗和加工,让数据口径更加对齐,Agent 就能访问到更好的数据。今年 Dynamic Table 还新增了级联加工能力,上游第一级加工后,下游会逐级触发,避免了以往多级加工延迟累加的问题。
在语义层面, Semantic View 和 Hologres Agent 共同描述业务语义与指标口径,配合图检索能力,让 Agent 不仅能找到数据,还能理解数据之间的关系。从传统的查询"找相似",升级为"找关系、找路径"。
在行动层面, 完整的权限体系(包括新增的行级权限)为 Agent 明确可操作边界;Skills 默认 Readonly 加 Serverless 执行,不影响生产实例;数据沙箱提供Agent自由安全的行动空间;User Defined Agent 让 Agent 与数据紧密结合。
在执行层面, Adaptive Execution(分阶段自适应执行)和 History Based Optimization(HBO,基于历史的优化)让查询无需精细调优就能稳定执行;Serverless Computing 让大 Query 稳定执行;Liquid Table 让表按需 Resharding,弹性应对不可预测的 Agent 访问模式。
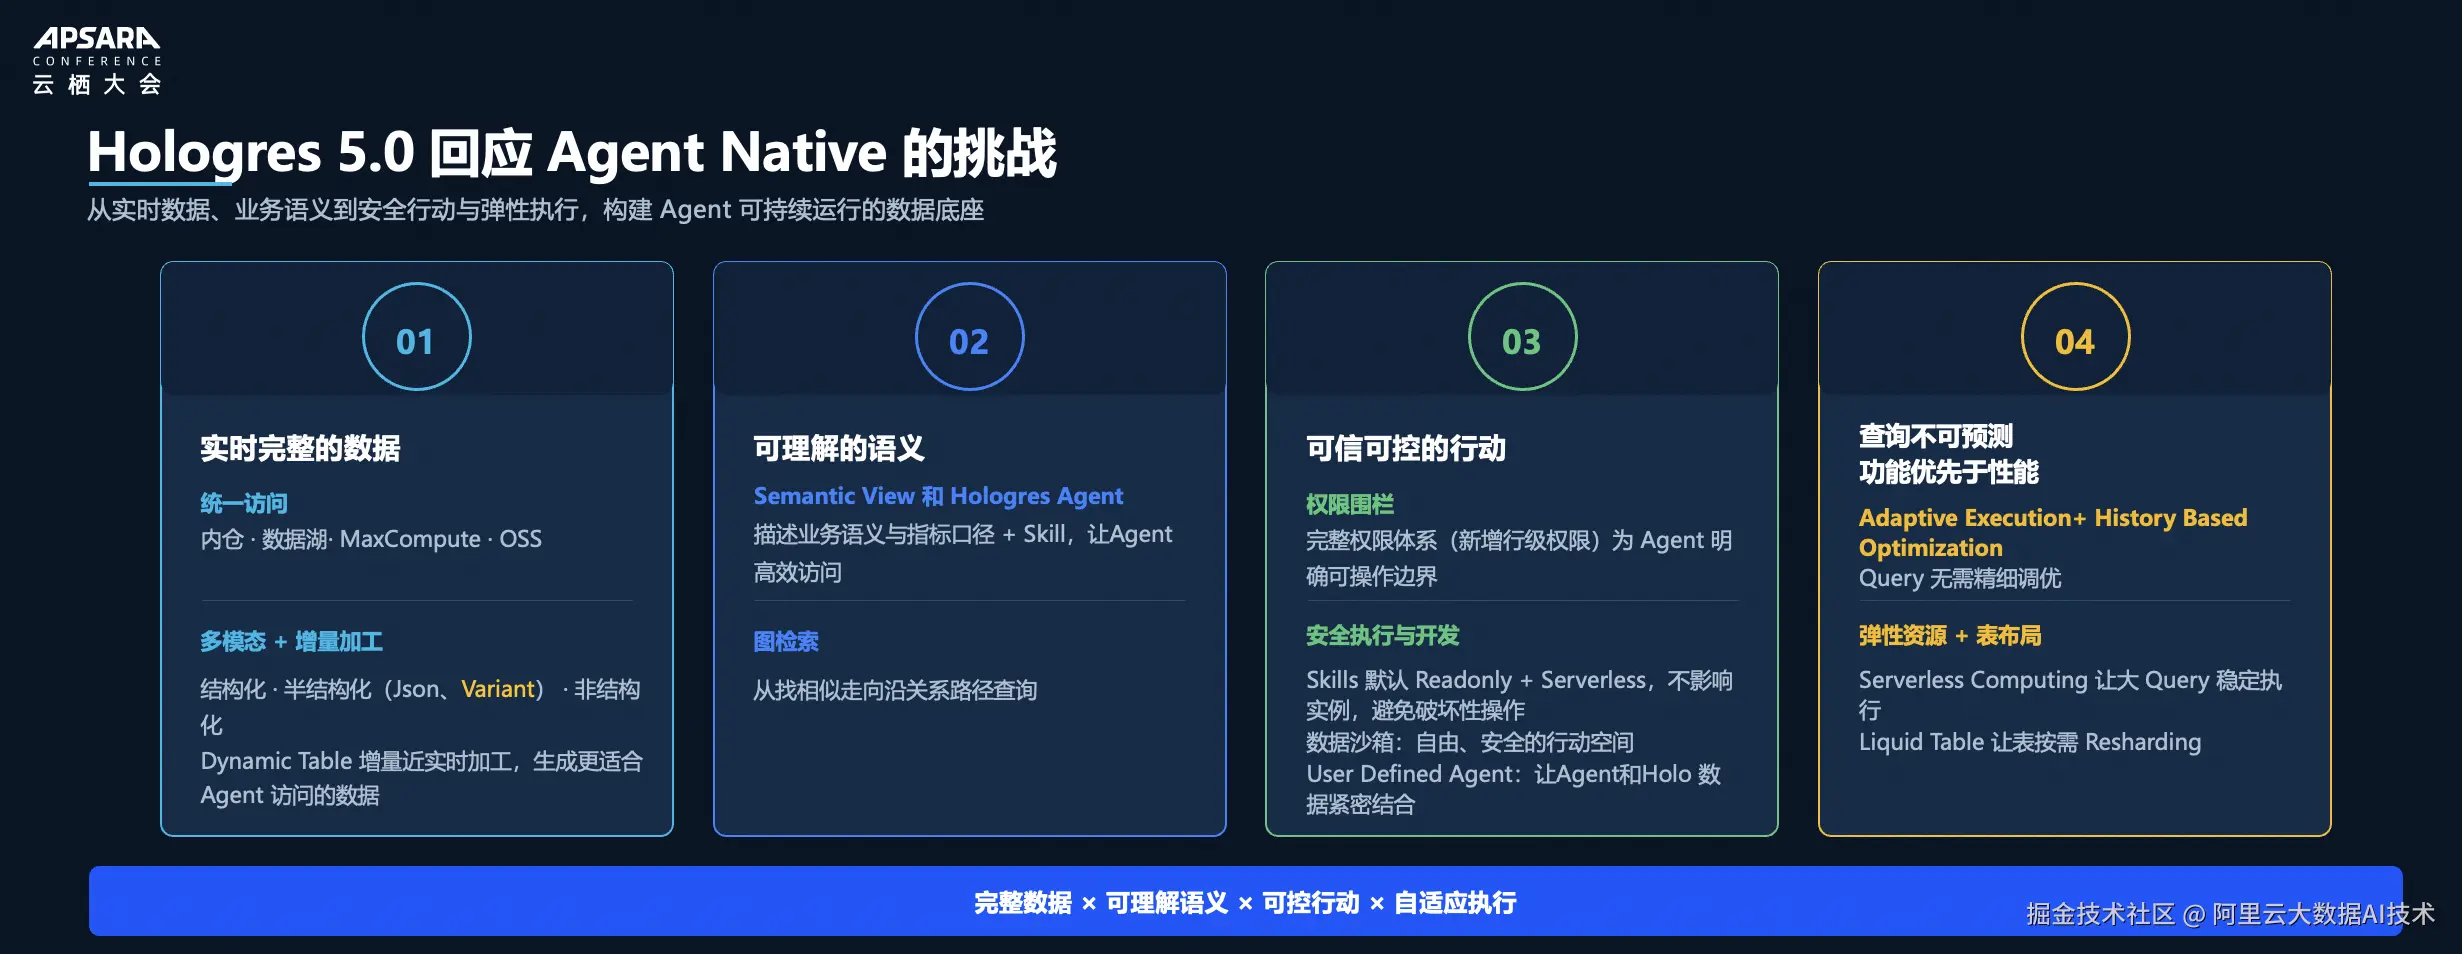
完整数据、可理解语义、可控行动、自适应执行------这四者的结合,让 Hologres 5.0 真正成为 Agent Native 的全模态实时数仓。 Hologres 的目标是让数据不仅仅是实时数据,更让 Agent 在实时数据上能够可靠执行。
性能表现:多项业界第一
即使在 Agent 时代,性能依然至关重要。姜伟华在演讲中分享了 Hologres 今年的几项亮眼成绩:在向量检索领域,VectorDB Bench 测试中达到 9.75 万 QPS,位居业界第一;TPC-H 3TB 测试成绩在 TPC 官网上同样是业界第一;TPC-DS 10TB 已向 TPC 官网提交成绩,正在审核中,代表三倍于目前榜首的性能水平。
这些成绩背后,是 Hologres 在存储引擎和查询优化上的持续投入。今年 Hologres 提供了Liquid Table无损 Resharding 能力,解决了业界长期面临的难题------当数据量增长时,如何在不影响性能的前提下重新分布数据。同时,Dynamic Table 持续增强与 AI Function 的整合,让增量近实时加工能力更加强大。
结语
Hologres 5.0 的发布,标志着 Hologres 从"多模态分析平台"向"Agent 原生数据底座"的战略升级。在 AI Agent 快速发展的今天,数据系统不再只是被动的存储和查询工具,而是主动参与决策和行动的核心基础设施。从实时数据到可靠行动,Hologres 正在为 Agent 时代构建最坚实的数据底座。
正如姜伟华在演讲结尾所说:"简单来说,Hologres 5.0 的产品口号就是------从全模态实时数仓,变成 Agent Native 的全模态实时数仓。让数据不仅仅是实时数据,我们希望让 Agent 在实时数据上能够做可靠的执行。"