业务系统要接大模型,最忌讳的是把 AI 调用撒进各个业务模块------key 散落、成本算不清、换个模型全项目改。我的做法是收敛成一层统一模型网关:路由、限流、重试降级、Token 成本核算全部收在网关里,业务方只面对一个稳定接口。这篇文章讲这层网关的设计和实测数据。
先交代技术栈:Spring Boot 3.4 + Spring AI 1.0,主模型 DeepSeek、备用通义千问,数据库默认 H2 内存库(免安装,可切 MySQL)。整个工程的目标只有一个------业务系统引入 AI 的全部代价,是一次 HTTP 调用。
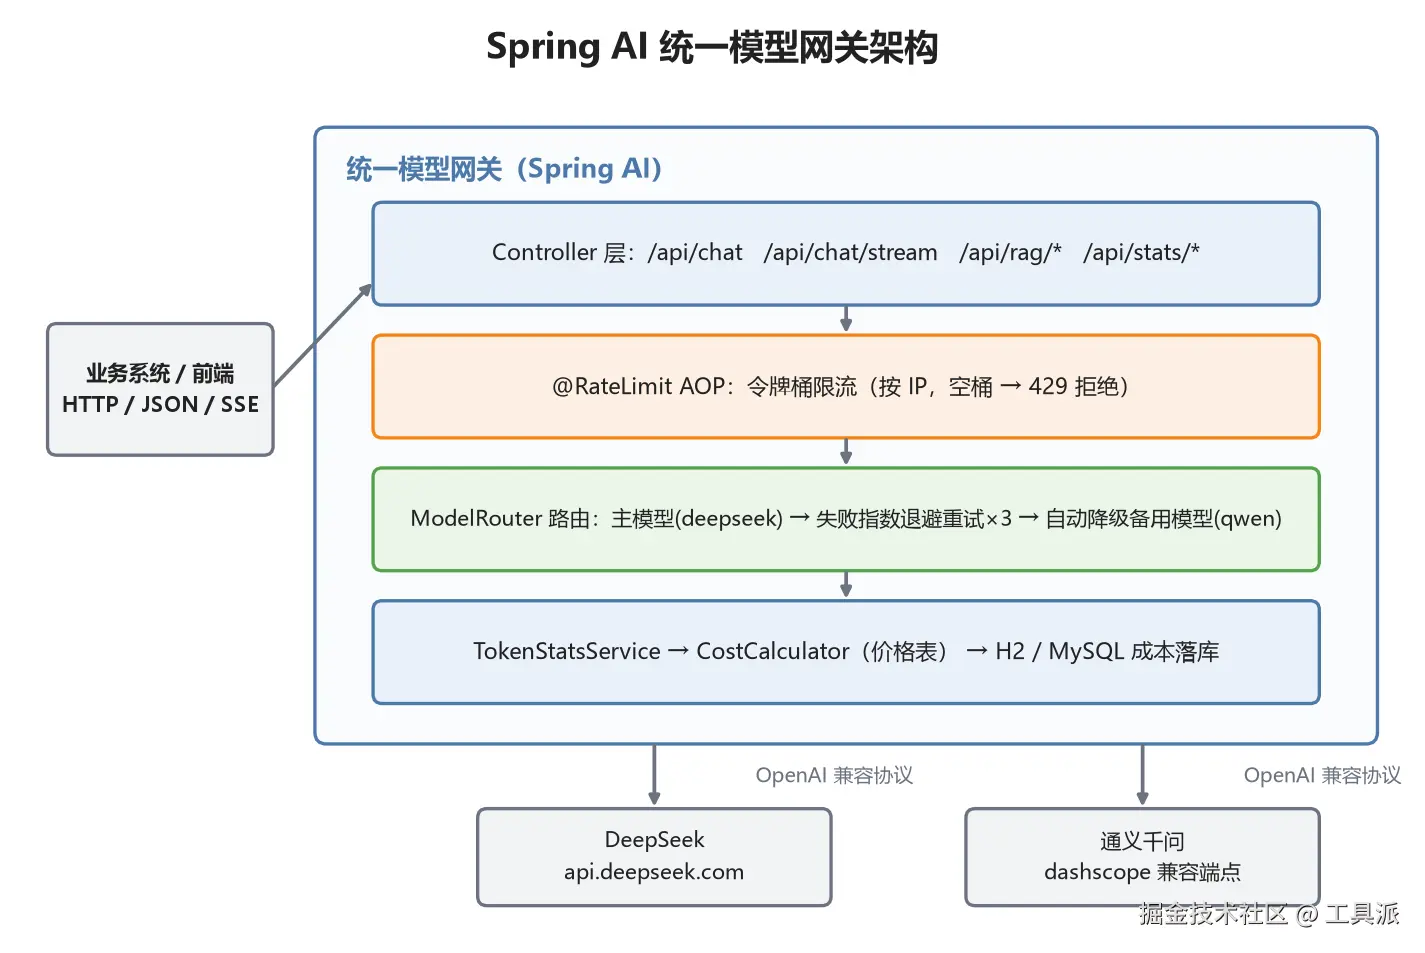
定位:调用关系,不是侵入关系
网关本身是一个独立的 Spring Boot 3.4 应用(Spring AI 1.0),对业务系统暴露四个接口:同步对话、SSE 流式对话、RAG 问答、成本报表。AI 挂了,业务系统拿到的是一次普通的失败响应,重试或降级都发生在网关内部------AI 层的故障不向上传导,这是"加能力"而不是"改架构"。
这个定位决定了几个实现取向:
- 网关对上只讲 HTTP + JSON,不暴露任何 Spring AI 类型。调用方拿到的
RouteResult里是回答文本、命中模型、是否降级、token 用量------全是普通字段; - 模型概念被封在网关里。业务方传
model参数只是"偏好",真正用哪个模型、失败后切给谁,调用方无感; - 成本数据在网关落库,业务系统不用接任何 SDK 就能拿到报表。
四个接口的具体形态:POST /api/chat 同步对话,请求体就是 {"message": "...", "model": "..."};GET /api/chat/stream SSE 流式;RAG 拆成 POST /api/rag/ingest 灌知识和 POST /api/rag/ask 问答两步;GET /api/stats/today 成本报表。路径全部以 /api 开头、进出全是 JSON,对调用方来说这就是一组再普通不过的内部 REST 服务,接它的方式和接公司里任何下游服务没有区别。
四个核心设计
1. 多模型装配 + 开箱即跑。 DeepSeek 做主模型、通义千问做备用,都走 OpenAI 兼容协议,接入参数全部在 application.yml。这是 Spring AI 最省事的一点:DeepSeek、通义、Kimi、智谱都提供 OpenAI 兼容端点,对 Spring AI 来说都只是 OpenAiChatModel,区别只有 base-url、api-key、model 三个参数。装配代码摘自 config/AiModelConfig.java:
java
/** DeepSeek 模型(网关默认主模型) */
@Bean("deepseekChatModel")
public ChatModel deepseekChatModel(
        @Value("${gateway.deepseek.base-url}") String baseUrl,
        @Value("${gateway.deepseek.api-key}") String apiKey,
        @Value("${gateway.deepseek.model}") String model) {
    return buildChatModel("deepseek", baseUrl, apiKey, model);
}

/** 通义千问模型(网关默认降级模型) */
@Bean("qwenChatModel")
public ChatModel qwenChatModel(
        @Value("${gateway.qwen.base-url}") String baseUrl,
        @Value("${gateway.qwen.api-key}") String apiKey,
        @Value("${gateway.qwen.model}") String model) {
    return buildChatModel("qwen", baseUrl, apiKey, model);
}

/**
 * 构建一个 OpenAI 兼容协议的 ChatModel。
 * apiKey 为空时装配 Mock 模型,保证工程开箱即跑。
 */
private ChatModel buildChatModel(String vendor, String baseUrl, String apiKey, String model) {
    if (apiKey == null || apiKey.isBlank()) {
        log.warn("[模型配置] {} 的 API Key 未配置(环境变量为空),已切换为 Mock 模型,仅用于演示流程", vendor);
        return new MockChatModel(vendor + "-mock");
    }
    // 1) OpenAiApi:封装了"往哪个地址、带什么 key 发 HTTP 请求"
    OpenAiApi openAiApi = OpenAiApi.builder()
            .baseUrl(baseUrl)
            .apiKey(apiKey)
            .build();
    // 2) 默认调用参数:模型名、温度(越大越发散,0.7 是通用聊天常用值)
    OpenAiChatOptions options = OpenAiChatOptions.builder()
            .model(model)
            .temperature(0.7)
            .build();
    // 3) 组装成 ChatModel ------ 之后所有调用都只面向 ChatModel 接口,与厂商解耦
    return OpenAiChatModel.builder()
            .openAiApi(openAiApi)
            .defaultOptions(options)
            .build();
}
一个细节:两个 key 都没配时,网关自动切换 Mock 模型(返回固定文案 + 伪造 usage),路由、限流、统计全链路照常演示------clone 下来不用申请 key 就能跑。Mock 的实现就是个测试替身,等价于单测里的 Mockito stub:
java
static class MockChatModel implements ChatModel {
    private final String name;
    MockChatModel(String name) { this.name = name; }

    @Override
    public ChatResponse call(Prompt prompt) {
        String userText = prompt.getContents();
        String reply = "【Mock回复-" + name + "】未配置真实 API Key,这是演示回复。你的问题是:"
                + (userText == null ? "" : userText.substring(0, Math.min(50, userText.length())));
        AssistantMessage message = new AssistantMessage(reply);
        Generation generation = new Generation(message);
        // 伪造一份 token 用量,让成本统计链路也能跑起来
        ChatResponseMetadata metadata = ChatResponseMetadata.builder()
                .model(name)
                .usage(new DefaultUsage(20, 30))
                .build();
        return new ChatResponse(List.of(generation), metadata);
    }
    // stream() 同理:把固定文案切三块依次吐出,模拟打字机效果,此处从略
}
要让"没配 key 也能启动"成立,还得关掉 OpenAI starter 的自动配置------它默认强制要求 spring.ai.openai.api-key,缺了直接启动失败。application.yml 里排除掉对应的 AutoConfiguration,模型 Bean 全部由上面的 AiModelConfig 手工接管。这个组合拳打完,"开箱即跑"才真正成立。
实际验证也就两步:不设任何环境变量直接启动,调一次 /api/chat,拿到的是"【Mock回复-deepseek-mock】未配置真实 API Key..."开头的回答,限流、重试、统计照常生效;配上 key 重启,同样的请求开始返回真实模型输出。两种形态之间没有任何散落在业务里的 if-else,全部收在 buildChatModel 一个工厂方法里------装配期的差异,不该变成运行期的分支。
2. 令牌桶限流,注解 + AOP。 容量 20、每秒补 1,@RateLimit 打在 Controller 方法上。注解本身没有任何属性,就是个开关标记:
java
@Target(ElementType.METHOD)        // 只能标在方法上
@Retention(RetentionPolicy.RUNTIME) // 运行期保留,AOP 才能读到
@Documented
public @interface RateLimit {
}
真正干活的是切面,按调用方 IP 各发一个桶:
java
@Around("@annotation(com.example.aigateway.ratelimit.RateLimit)")
public Object around(ProceedingJoinPoint joinPoint) throws Throwable {
    String key = resolveKey();
    // computeIfAbsent:第一次见到的 IP 才新建桶,线程安全
    TokenBucket bucket = buckets.computeIfAbsent(key, k -> new TokenBucket(capacity, refillPerSecond));
    if (!bucket.tryAcquire()) {
        throw new RateLimitException("请求过于频繁,已被限流(key=" + key + "),请稍后重试");
    }
    return joinPoint.proceed();
}桶的实现是惰性补充:不开后台线程,每次请求来时按流逝时间补令牌,synchronized 保证"补充 + 扣减"原子。这是单机内存版,注释里写明了边界------集群部署时每个实例各有一个桶,总阈值会被放大 N 倍,生产集群版应该换 Redis + Lua。
实测 25 个并发请求打过去:20 个放行、5 个被拒,超限请求 100% 拦截,和桶容量精确吻合。
3. 指数退避重试 + 自动降级。 主模型调用失败(429/超时)按 500ms 基准指数退避重试 3 次,耗尽后把同一个 Prompt 发给备用模型,响应标记 downgraded=true 并落库。我用故障地址做注入测试:连续 3 次,全部成功降级到 qwen,降级耗时 2.0~4.1 秒,统计接口里 DOWNGRADE_COUNT 准确记为 3。重试器、路由降级的完整实现和故障注入过程,下一篇单独展开,这里只说定位:重试和降级是网关的内部机制,业务方的请求该怎么发还怎么发。
4. Token 成本核算落库。 每次调用解析响应里的 usage 字段,按"输入/输出分开、输出更贵"的价格表折算人民币,写进 token_usage 表。计价逻辑收在 CostCalculator 一个类里:
java
/**
 * 价格表:model -> [输入单价, 输出单价](元 / 1000 tokens)
 * 示例换算:DeepSeek 输入 2 元/百万 tokens = 0.002 元/千 tokens
 */
private static final Map<String, double[]> PRICE_TABLE = Map.of(
        "deepseek-chat", new double[]{0.002, 0.008},
        "qwen-plus", new double[]{0.0008, 0.002},
        "mock", new double[]{0.0, 0.0}   // Mock 模型不计费
);

/** 兜底价格:表里没收录的模型按 DeepSeek 价估,宁可高估不要漏算 */
private static final double[] DEFAULT_PRICE = {0.002, 0.008};

public BigDecimal calc(String model, int promptTokens, int completionTokens) {
    double[] price = resolvePrice(model);
    double cost = promptTokens / 1000.0 * price[0]
            + completionTokens / 1000.0 * price[1];
    return BigDecimal.valueOf(cost).setScale(6, RoundingMode.HALF_UP);
}三个设计点:输入输出分开计价(输出贵,因为生成更耗算力);模型名支持包含匹配(deepseek-mock 能命中 mock 的零价格);表里没有的模型按 DeepSeek 价兜底------成本宁高估不漏算。价格表是代码里的常量,官网调价只改这一处。实测 45 次调用、2431 tokens、成本 ¥0.0164,/api/stats/today 一条 SQL 就能回答"今天烧了多少钱"。
/api/stats/today 返回的是按模型分组的明细加合计。评测脚本在功能测试阶段调它落盘的真实响应长这样(JSON 原样摘自评测记录,快照时点累计 5 次调用):
json
{
  "byModel": [
    {
      "MODEL": "deepseek",
      "CALL_COUNT": 5,
      "PROMPT_TOKENS": 226,
      "COMPLETION_TOKENS": 159,
      "TOTAL_TOKENS": 385,
      "COST_YUAN": 0.001724,
      "DOWNGRADE_COUNT": 0
    }
  ],
  "totalCostYuan": 0.001724
}
当天把同步对话、SSE、RAG、25 并发压测和降级注入全部跑完后,累计到 45 次调用、2431 tokens、¥0.0164,降级测试的 3 次也通过 DOWNGRADE_COUNT 单独入账。报表结构从第一次调用起就没变过------这就是"网关统一记账"的好处:今天接 DeepSeek,明天加 Kimi,报表消费方什么都不用改。
网关自己的全部接入参数收敛在 application.yml 的 gateway 段,原样贴出:
yaml
gateway:
  # 主模型与降级模型(application 里只写"名字",具体接入参数在下面各自的小节)
  model:
    primary: deepseek      # 默认走 DeepSeek,便宜好用
    fallback: qwen         # DeepSeek 连续失败时自动降级到通义千问

  # DeepSeek(OpenAI 兼容协议)
  # 注意:Spring AI 会自动在 base-url 后追加 /v1/chat/completions,
  # 所以这里【不要】以 /v1 结尾,否则会拼出双重路径导致 404
  deepseek:
    base-url: https://api.deepseek.com
    api-key: ${DEEPSEEK_API_KEY:}
    model: deepseek-chat

  # 通义千问(阿里云百炼的 OpenAI 兼容端点),key 走环境变量 DASHSCOPE_API_KEY
  qwen:
    base-url: https://dashscope.aliyuncs.com/compatible-mode
    api-key: ${DASHSCOPE_API_KEY:}
    model: qwen-plus

  # 限流:内存令牌桶(演示版,单机;集群环境应换 Redis + Lua)
  rate-limit:
    capacity: 20            # 桶容量:最多瞬时放行 20 个请求
    refill-per-second: 1.0  # 每秒补充 1 个令牌

  # 失败重试:指数退避
  retry:
    max-attempts: 3         # 最多尝试 3 次(含第一次)
    base-delay-ms: 500      # 基础等待 500ms,之后 1s、2s......翻倍
注意 key 全部是 ${DEEPSEEK_API_KEY:} 这种环境变量占位符------冒号后面留空表示缺省为空串,空串正好触发上面的 Mock 兜底。整条链路是自洽的:不配 key → Mock 模型 → 照常路由、限流、记账。
一个配置上的真实坑
Spring AI 会自动在 base-url 后面拼 /v1/chat/completions,所以通义的 base-url 不能 写成以 /v1 结尾------我最初照抄了官方 compatible-mode 的完整地址,降级时全部 404。排掉这个坑之后降级链路才真正跑通。这类"协议帮你拼路径"的约定,换任何 SDK 都值得先确认一遍。
这个坑的隐蔽之处在于:主模型 DeepSeek 的地址 https://api.deepseek.com 不带 /v1,怎么调都对;只有降级流量第一次打到通义时才炸。测试时如果只测主链路,根本发现不了。所以我后来把"降级链路单独注入一次故障"列为网关的固定验证项------每个分支都要真的走到,而不是推理它"应该能走通"。
对老系统的要求
没有。业务方引入一个 SDK 客户端或者直接 HTTP 调网关即可,不需要引 Spring AI、不需要感知模型概念。以后换模型、加模型、做成本分摊,都只动网关。
补一个边界说明:这层网关目前是单机版------令牌桶在内存、统计在单库。它解决的是"接入方式和成本可见性"问题;等真上量,限流换 Redis、报表换时序库、路由加权重,都是网关内部的活,四个接口的契约不变。这也是"调用关系不是侵入关系"的另一层意思:网关自己可以一直重构,业务方不用跟。
代码在这里,README 有逐接口的验证命令: