大模型每生成一个 token,都要从头开始计算吗? 为什么加了一块小小的缓存,生成速度就能快几十倍? 这篇文章用最通俗的方式,把
KV Cache一次讲透。
本文收录于微信公众号:愤怒的代码 AngryCode
0x00、大模型是如何推理的
在聊 KV Cache 之前,得先搞清楚一件容易被想当然的事:
大模型不是一次性把整句话想好了再说出来的,而是一个字接一个字"蹦"出来的。简单的说大语言模型是做文字接龙的游戏。
这里的"字",专业术语叫 Token(词元)。它可能是一个完整的词、半个词,甚至一个标点符号。为方便理解,你可以先把它当成"一个字"。
举个例子,你输入:
深圳今天
模型看着这四个字,预测出下一个最可能的字是"天":
深圳今天天
然后它把"天"接到后面,再看"深圳今天天"这五个字,预测下一个字"气":
深圳今天天气
如此循环,直到模型觉得该停了为止。这个过程叫自回归生成(Autoregressive Generation)。
关键点来了:模型每预测一个新字,都必须"看"一眼前面所有的字,才能决定下一个字写什么。
这句话,是理解 KV Cache 一切的起点。
0x01、注意力机制:Query、Key、Value 三兄弟
那"看一眼前面的字"具体是怎么做的?
大模型内部有个核心组件叫注意力层(Attention Layer) ,是整个 Transformer 架构的心脏。它的职责是:判断前面的字里,哪些对预测下一个字更重要。
比如预测"深圳今天天"后面的字时,"今天""天"显然比"深圳"更重要。注意力的作用,就是自动算出这种"重要程度"。
在注意力层里,每个字都会被转化成三样东西:
- Query(查询,Q):这个字"想找什么"。
- Key(键,K):这个字"身上有什么标签"。
- Value(值,V):这个字"实际携带的信息"。
打个比方,你去图书馆想找讲 Transformer 的书:
- Query 是你的需求:"我想找讲 Transformer 的书"。
- Key 是每本书侧边贴的标签:"深度学习""机器学习""川菜菜谱"......
- Value 是书本身的正文内容。
过程是:拿你的 Query 去和所有书的 Key 比对相似度,算出每本书有多"相关",然后按相关度,把最相关那几本书的 Value(正文)拿过来用。
翻译成数学公式,就是那行著名的:
scss
Attention(Q, K, V) = softmax(Q · Kᵀ / √d) · VQ · Kᵀ:拿 Query 和所有 Key 做点积,算出"相关度分数"。softmax:把分数归一化成"注意力权重",加起来等于 1。· V:用权重对所有 Value 加权求和,得到最终的输出。
注意一个细节 :每个字的 K 和 V,只由这个字自己决定,和后面来了什么字无关。这一点极其重要,它正是 KV Cache 能成立的根本原因(后面会讲)。
0x02、问题:大量重复计算
现在回到生成过程,看看哪里浪费了。
没有缓存 时,模型每预测一个新字,都要把整句话所有字重新过一遍网络------它们的 Q、K、V 要重算,前馈层(FFN)要重跑,注意力分数矩阵也要重新算。而这一轮算出来的东西,除了最后一个位置,其余全部丢掉。
所以浪费的算力远不止"Q、K、V 重算"这一项。真正的大头其实是那些旧 token 的前馈层和投影计算,只是它们算完就被扔了,谁也没用上。
以上面的例子走一遍:
| 步骤 | 输入 | 需要计算 Q/K/V 的字 |
|---|---|---|
| 第 1 步 | 深圳今天 | 深、圳、今、天(4 个) |
| 第 2 步 | 深圳今天天 | 深、圳、今、天、天(5 个) |
| 第 3 步 | 深圳今天天气 | 深、圳、今、天、天、气(6 个) |
发现问题了吗?
"深"的 K 和 V,在第 1 步算过一遍,第 2 步又算一遍,第 3 步再算一遍。每个已经见过的字,都在被反复计算。
句子越写越长,浪费越严重:如果已经生成了 1000 个字,那么预测第 1001 个字时,就要把前面 1000 个字的 K、V 全部重算一遍,只为算出 1 个新字。
这就是自回归生成最致命的性能瓶颈------计算量随序列长度呈平方级增长。
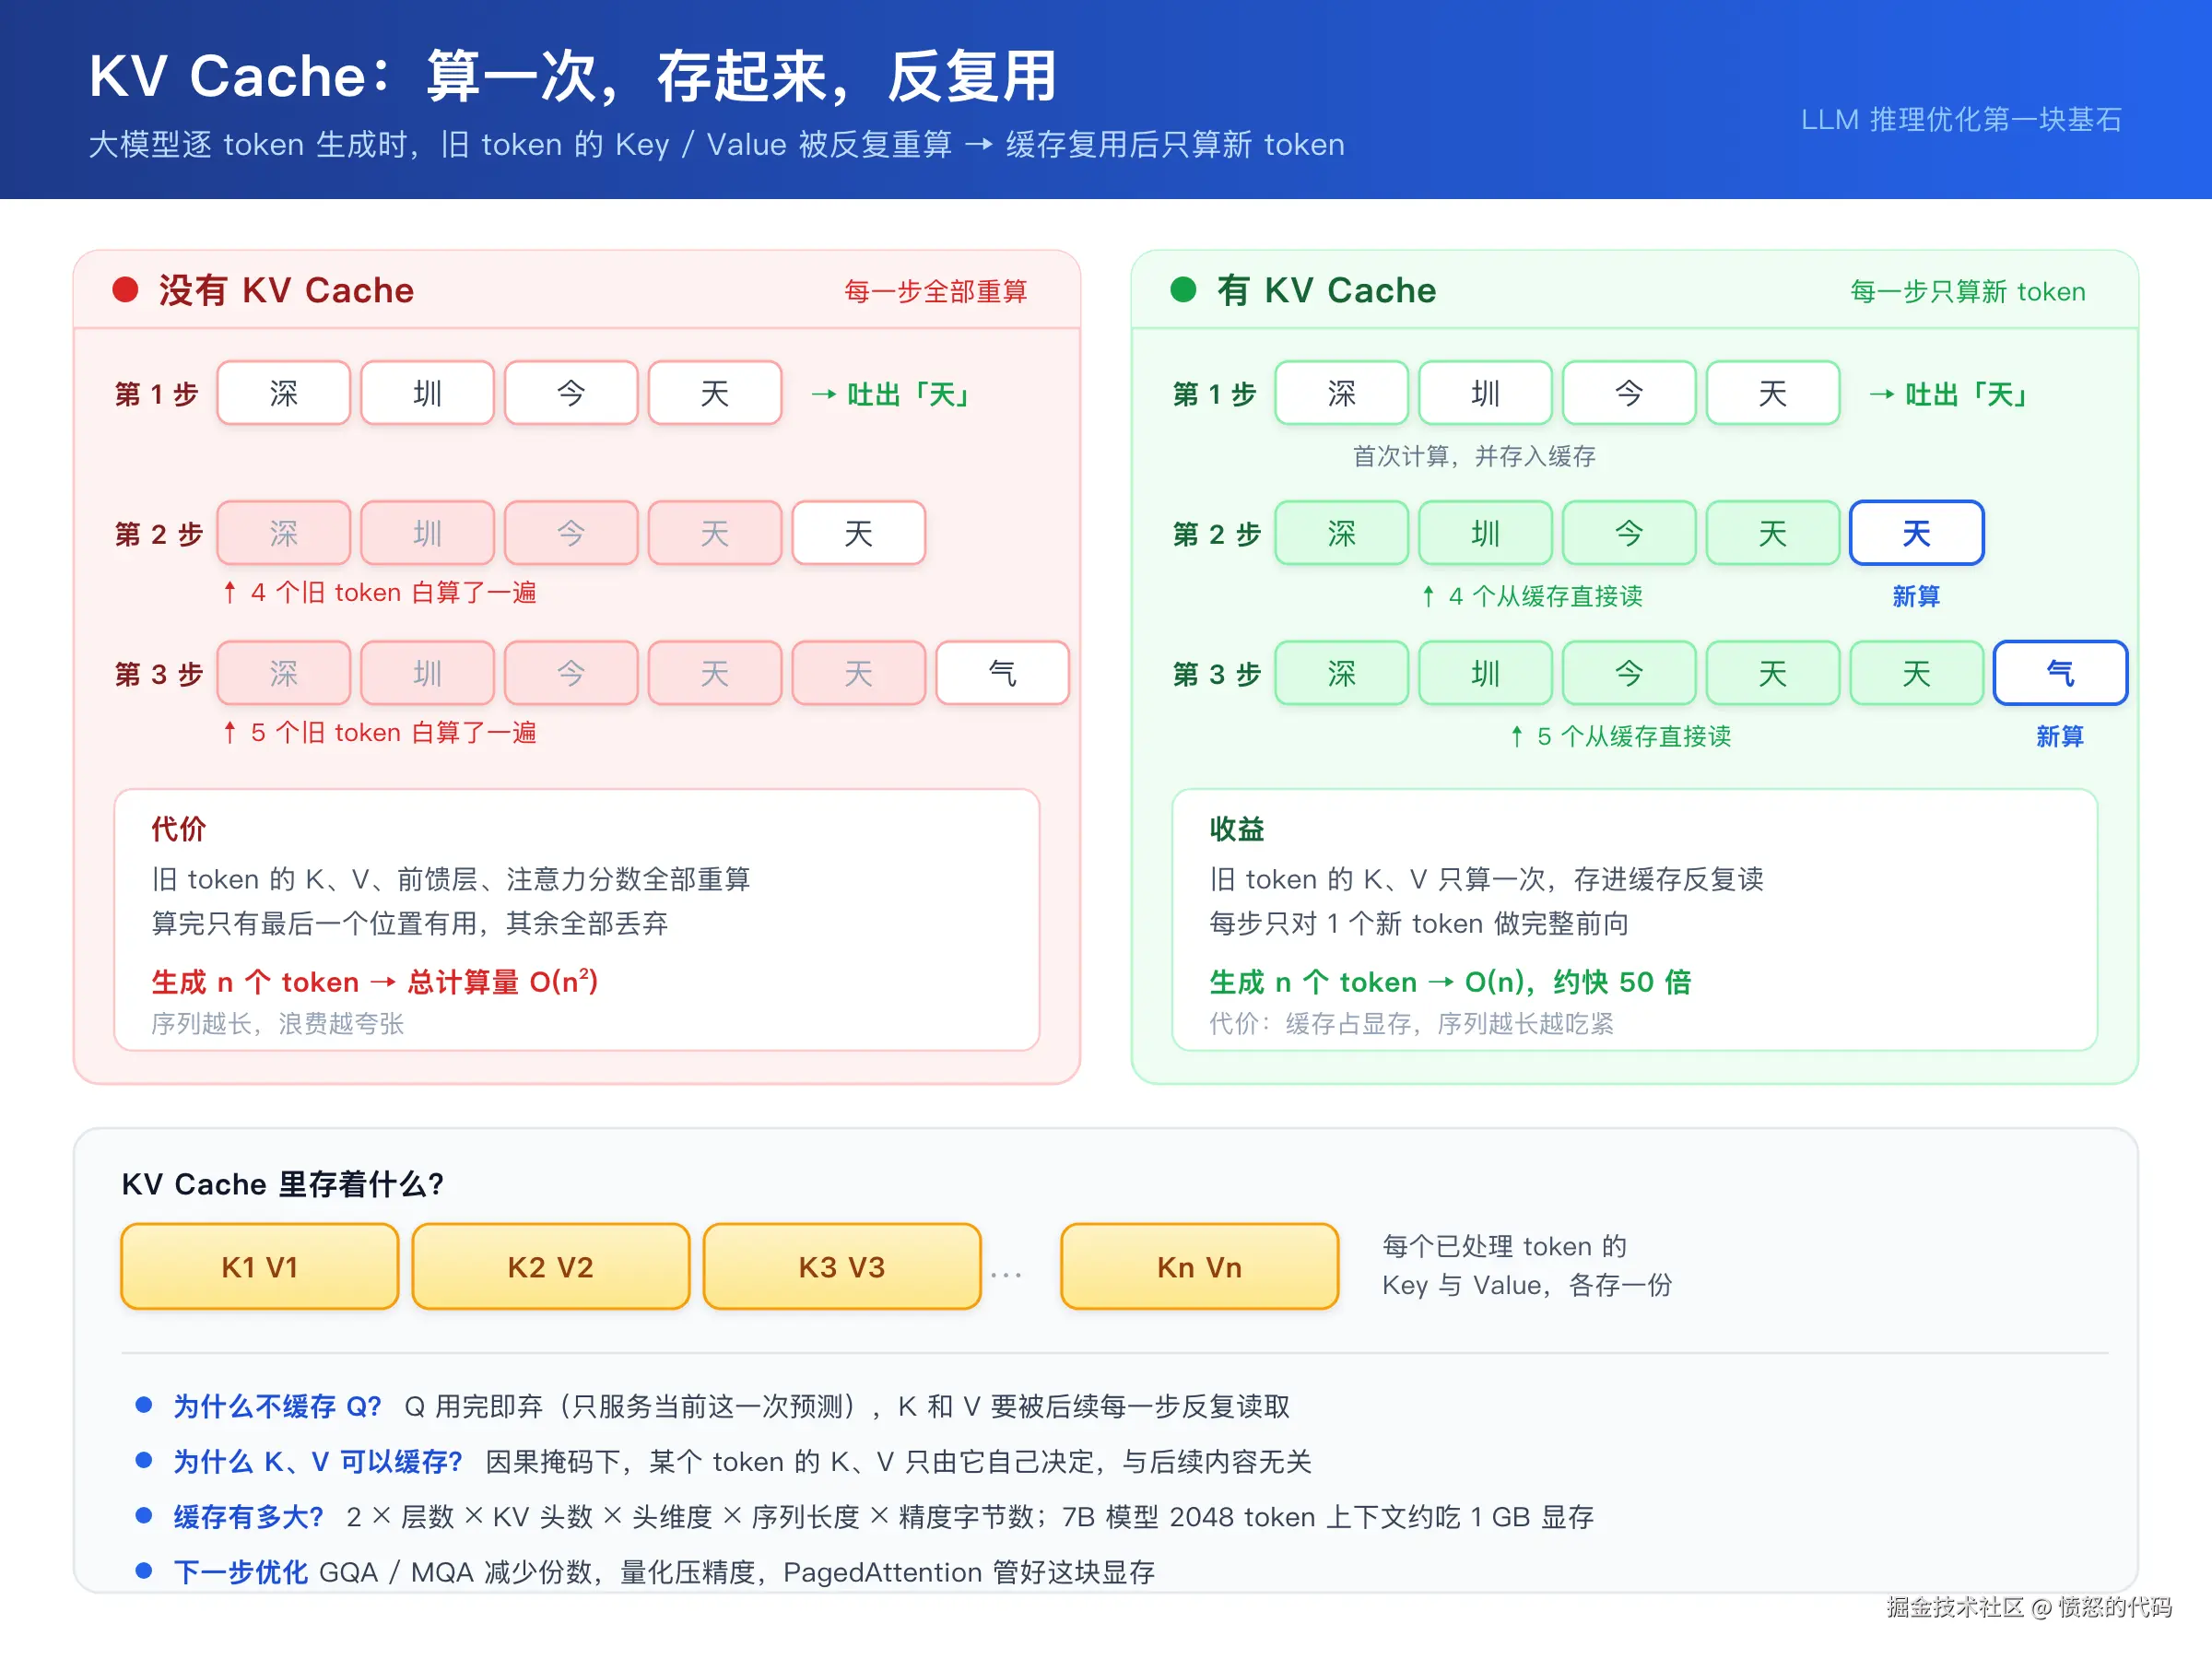
↑ 同样的「深圳今天天气」,左边每一步都在重算整句,右边只算新 token
0x03、KV Cache 的核心思想:算一次,存起来,反复用
解决思路也很简单:
每个字的 K 和 V,只算一次,存进一块内存里,以后每次直接用,不再重算。
这块内存,就是 KV Cache。
再看一遍刚才的例子,这次有缓存:
第 1 步:输入"深圳今天"
- 计算 4 个字的 K、V,存进缓存。
- 预测出"天"。
- 缓存里现在有:深、圳、今、天 的 K 和 V。
第 2 步:这次只需要输入新字"天"
- 前面的 K、V 直接从缓存里读,不重算。
- 只为新字"天"算一次 K、V、Q,算完也存进缓存。
- 预测出"气"。
- 缓存里现在有:深、圳、今、天、天 的 K 和 V。
第 3 步:只需输入新字"气"
- 前面 5 个字的 K、V 全部从缓存读。
- 只为"气"算一次 K、V、Q,存进缓存。
- 预测出下一个字......
看出来了吧:每一步只算 1 个新字,剩下的全部复用缓存。
0x04、为什么只缓存 K 和 V,不缓存 Q?
这是几乎每个人都会问的问题。答案一句话:
Q 是一次性的,K 和 V 是要反复用的。
展开说:
- Query 只在"当前这个字被预测"的那一刻用一次。当前字拿自己的 Q 去和前面所有字的 K 比对,比对完,这个 Q 的使命就结束了,再也不会有人用到它。
- K 和 V 则要在未来每一个字生成时都被用到。因为每一个新字都要"看"前面所有字,而"看"的动作,本质上就是用新字的 Q 去查所有旧字的 K,再取旧字的 V。
所以缓存里只存 K 和 V,不存 Q------这也是它叫 KV Cache 而不是 QKV Cache 的原因。
0x05、到底快了多少?算一笔账
假设从 1 个字开始,生成到 100 个字:
没有 KV Cache,每个字都要对整句算一遍 K、V,总计算量是:
ini
1 + 2 + 3 + ... + 100 = 5,050 次有 KV Cache,第 1 步算 1 次,之后每步只算新字 1 次:
ini
1 + 1 + 1 + ... + 1 = 100 次约 50 倍的差距。而且序列越长,差距越大------这是典型的"把 O(n²) 降成 O(n)"。
需要说明的是,上面这个计数是个简化模型:它只数了 K、V 的投影次数,没有把 FFN、注意力分数这些开销算进来。但即便如此,实际的加速比通常还要更可观。
这就是为什么 KV Cache 是 LLM 推理加速里最基础、也最重要的一个技巧。
0x06、天下没有免费的午餐:速度换内存
KV Cache 用速度换来了一个代价:内存。
缓存里要存下"到目前为止每一个字的 K 和 V",所以:
序列越长,缓存越大。
缓存大小可以用一个公式精确算出来:
KV Cache 大小 = 2 × 层数 × KV头数 × 头维度 × 序列长度 × 每元素字节数2:因为 K 和 V 各一份。每元素字节数:FP16 精度下是 2 字节。
代入几个真实模型(FP16、单个 token):
| 模型 | 层数 | KV 头数 | 头维度 | 每个 token 的缓存 |
|---|---|---|---|---|
| Llama 2 7B | 32 | 32 | 128 | ~0.5 MB |
| Llama 2 13B | 40 | 40 | 128 | ~0.8 MB |
| Llama 2 70B(GQA) | 80 | 8 | 128 | ~0.3 MB |
看着每 token 才 0.5 MB 不吓人?算上序列长度就惊人了:
7B 模型,2048 个 token 的上下文,单个请求就要 ~1 GB 的 KV 缓存。
如果同时服务 32 个用户(batch = 32),光 KV 缓存就要 32 GB 显存。这还没算模型本身的权重。
这就是为什么"并发服务很多用户"时,KV Cache 的内存会成为真正的瓶颈 (可以理解今天内存那么昂贵了吧T_T)。
0x07、进阶:当缓存本身成为瓶颈怎么办
理解了上面这些,你就能看懂业界一系列优化是在干什么了。它们本质上都在回答同一个问题:怎么让这块缓存更小、更省、更好管?
1. GQA / MQA:从源头减少缓存
- MQA(多查询注意力,Multi-Query Attention):让所有注意力头共享同一份 K 和 V,缓存直接砍到原来的 1/头数。
- GQA(分组查询注意力,Grouped-Query Attention):折中方案,几个头共享一份 K、V。上表里 Llama 2 70B 的 KV 头数只有 8,就是用 GQA 把缓存压了下来。
(顺便提一下老一代的多头注意力 MHA(Multi-Head Attention,多头注意力):每个头都有自己独立的 K 和 V,缓存最大。MQA 和 GQA 本质上都是往 MHA 这个方向做"减法"。)
2. KV Cache 量化
缓存不用存 FP16,改成 8-bit 甚至 4-bit,内存占用再砍一半以上,而精度损失通常很小。(可以翻阅前面量化的数学原理的文章)
3. PagedAttention(分页注意力)
这是 vLLM 提出的经典方案:把 KV 缓存像操作系统管理内存一样,切成固定大小的"页"来管理,按需分配、灵活回收,彻底解决"预留一块连续大内存"造成的碎片和浪费,大幅提升并发能力。
4. 滑动窗口 / 注意力汇聚(Attention Sink)
对于无限长的对话,只保留最近一段窗口,加上开头几个"注意力锚点",让缓存固定在一个大小,不再无限膨胀。
这些名字你现在听来可能陌生,但只要记住一句话就够了:它们全部是冲着 KV Cache 的内存开销去的。
0x08、总结
把这篇文章浓缩成几句话:
- 大模型逐字生成,每预测一个字都要参考前面所有字。
- 回头看前面那些字,靠的是 Q、K、V:Q 查、K 匹配、V 取值。
- 如果不缓存,每个旧字的 K、V 会被反复重算,计算量呈平方级增长。
KV Cache的核心:每个字的 K、V 只算一次,存起来反复用,把计算量从 O(n²) 降到 O(n)。- 只缓存 K、V 不缓存 Q,因为 Q 是一次性的,K、V 要反复用。
- 代价是内存------序列越长、并发越高,缓存越吃显存。
- 后续的 GQA/MQA、量化、PagedAttention 等优化,都是在跟这块缓存的内存开销较劲。
KV Cache 是大模型推理优化的第一块基石。理解了它,你就拿到了进入 LLM 推理、vLLM、量化压缩这些话题的入场券。