10 月 22 日,Anthropic 宣布把 Agent Skills 捐给 Agentic AI Foundation(AAIF)。AAIF 是 Linux 基金会之下的一个基金,去年 12 月由 Anthropic、Block、OpenAI 共同发起,此前已经托管了 MCP 和 AGENTS.md。按 Anthropic 给出的数字,Agent Skills 已被 70 多个 agent 平台接入,累计发布约 100 万个 skill,安装近 2.8 亿次。
本文先说明这次捐赠交出了什么,再整理规范本身的规定,然后用一个按规范逐条写的检查脚本,查了我本机 Claude Code 里的 65 个 skill,最后落到写 skill 的人需要调整什么。
这次捐赠在功能上没有带来任何新东西,规范文本、文件格式、存放位置都没变。变的是归属:skill 的格式从一家公司的产品约定,变成了 Google、OpenAI 等公司的工程师共同维护的标准。对写 skill 的人来说,这意味着 SKILL.md 里 name 和 description 两个字段的写法,从此是跨平台的契约。本地自查的结果说明,这份契约最容易被忽视的不是格式错误,而是体量:65 个 skill 里只有 3 个格式不合规,却有 13 个正文超过了规范建议的 5000 token。
Anthropic 交出的三样东西:名称、域名和 GitHub 组织
原文列得很具体,捐出的是三样东西:Agent Skills 的名称和 logo、GitHub 组织 agentskills,以及 agentskills.io 域名。规范文本继续放在 agentskills.io,地址不变。
维护方式随之改变。原文写明,标准今后由 Anthropic、Google、OpenAI 等公司的工程师共同维护,两位 Lead Maintainer 是 David Soria Parra 和 Mahesh Murag。路线图上有三件事:版本化发布、正式的提案流程、安全指南。原文还特意说明,开发者不需要加入 AAIF,也可以继续使用和参与贡献这个标准。
采用数据方面,原文点名的平台有 ChatGPT、Cursor、GitHub Copilot 和 VS Code。规范仓库 agentskills/agentskills 创建于 2025 年 12 月,采用 Apache-2.0 许可,截至 10 月 24 日有 26529 个星。
AAIF 托管的 4 个项目分别管 agent 的哪一层
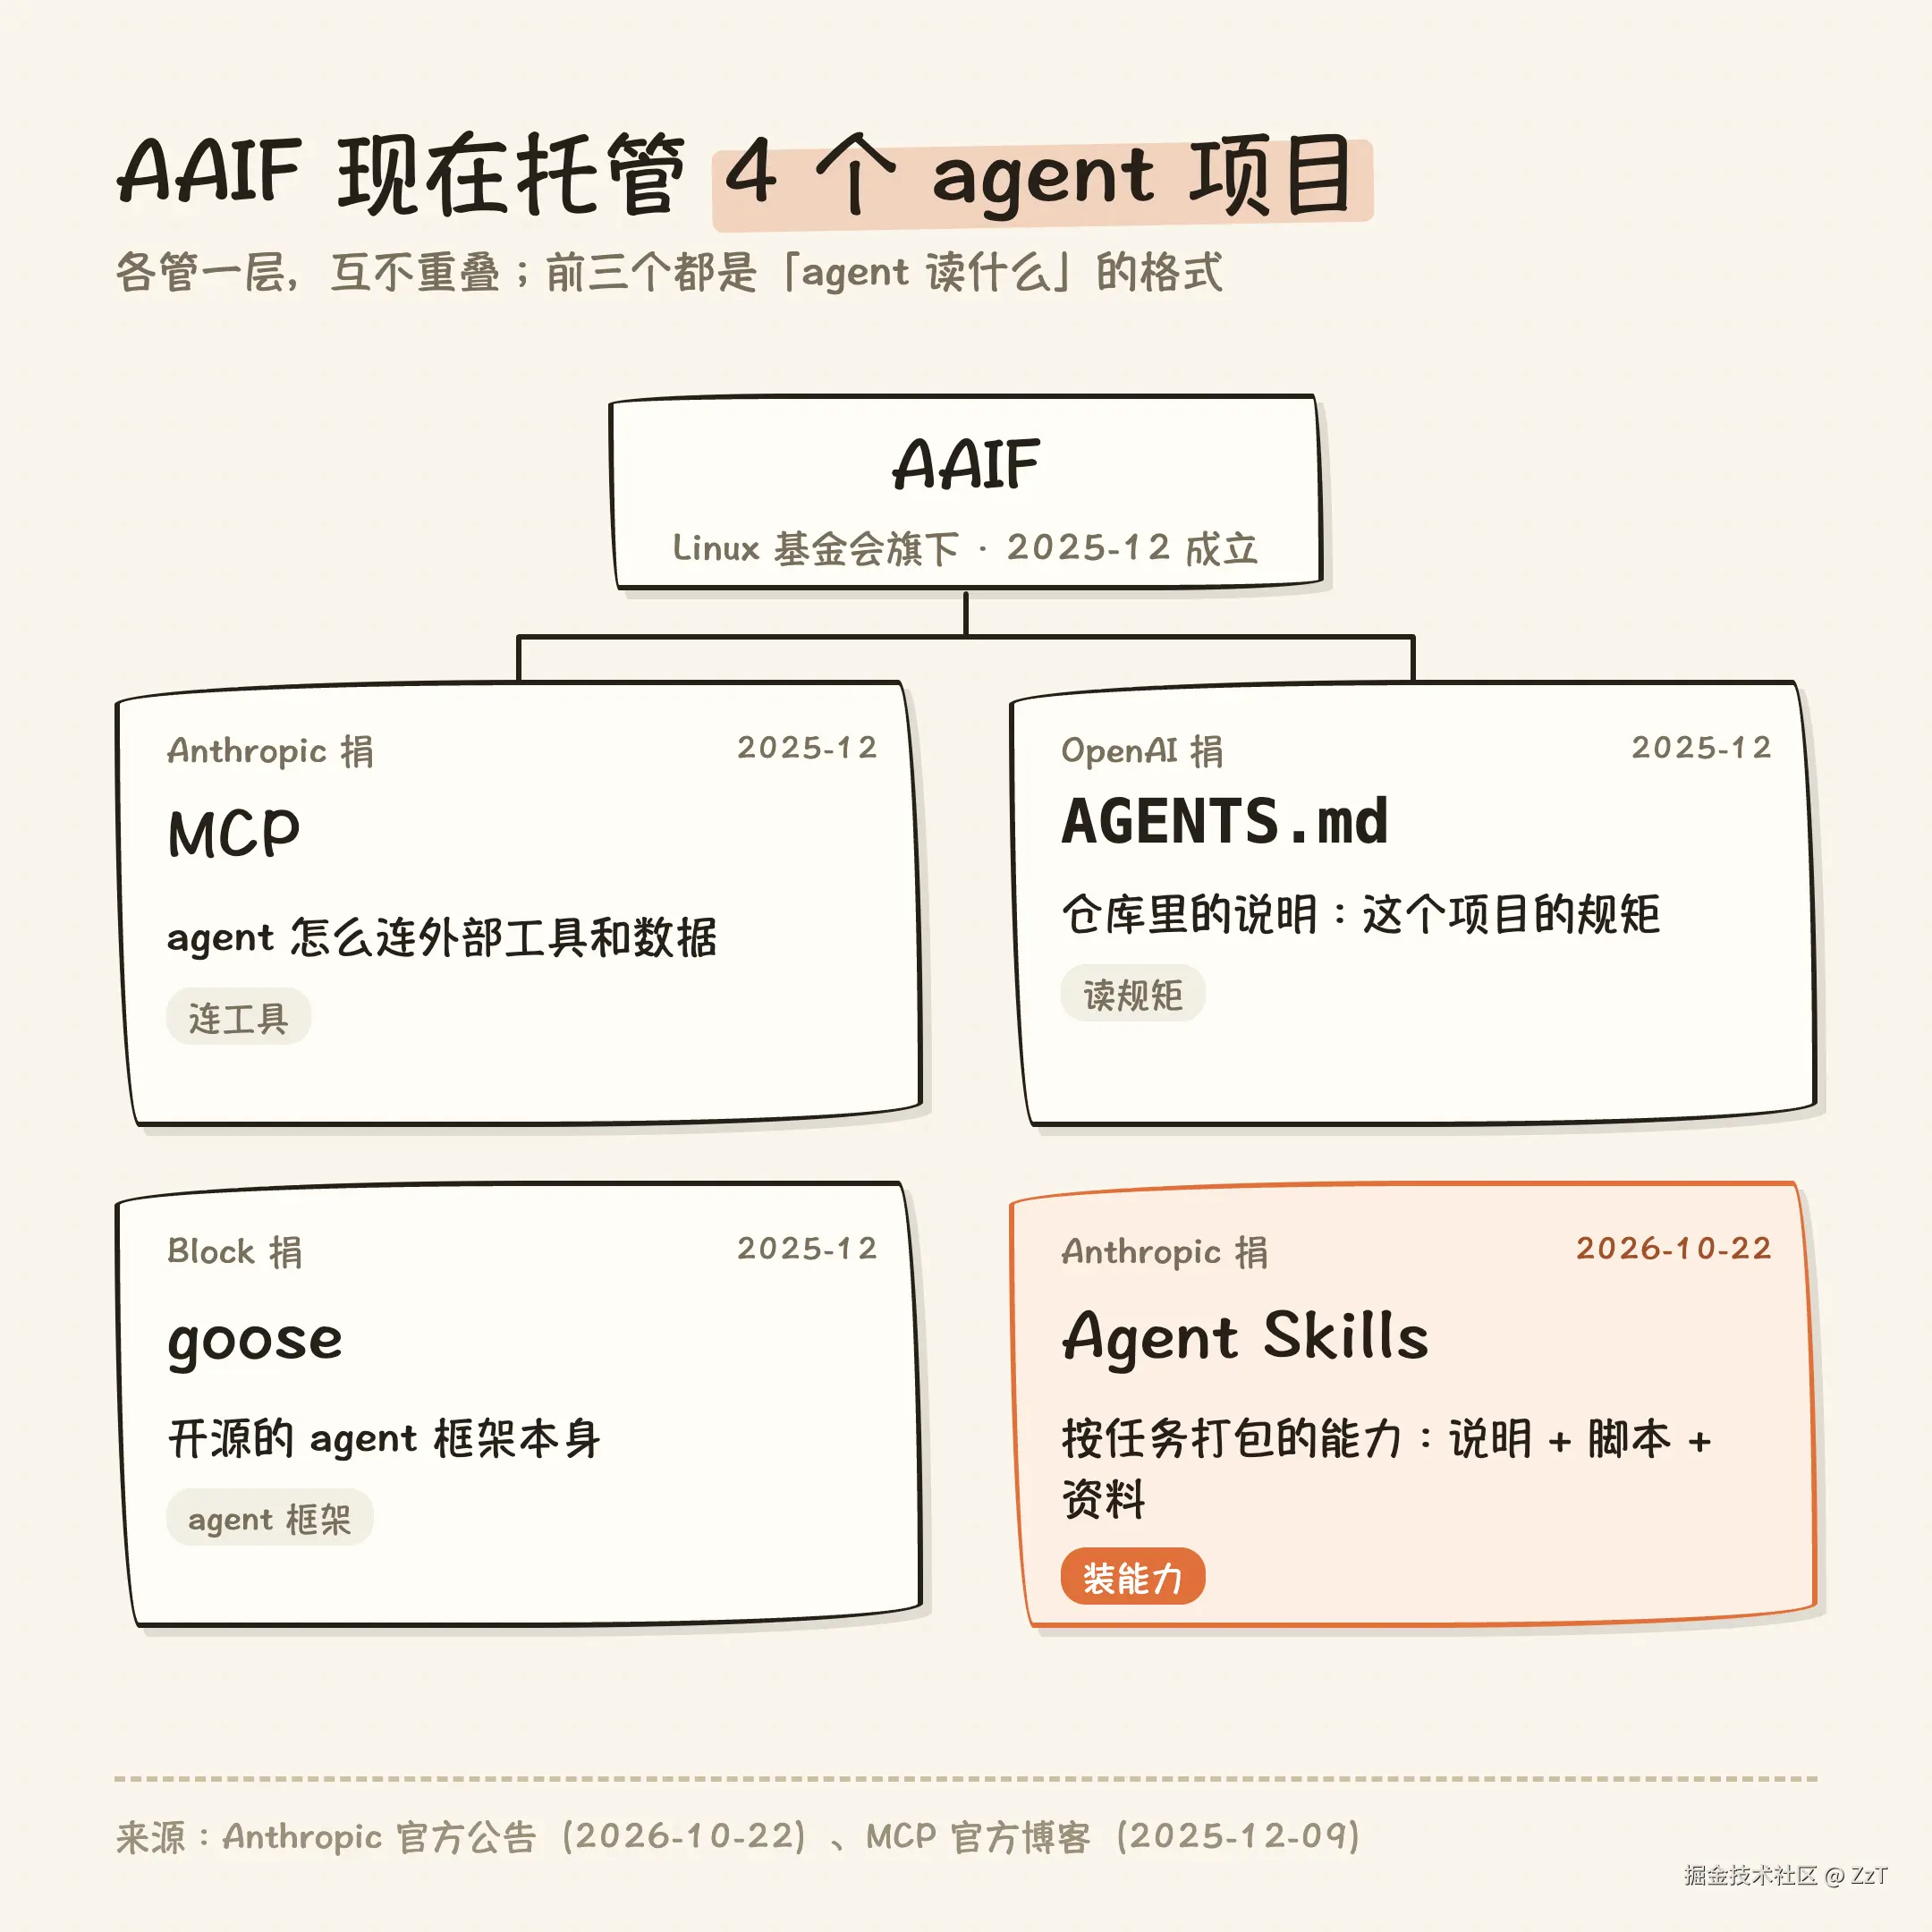
AAIF 成立时有三个创始项目:Anthropic 的 MCP、Block 的 goose、OpenAI 的 AGENTS.md。加上这次的 Agent Skills,一共 4 个。
这 4 个项目分管 agent 的不同层面,彼此不重叠。MCP 规定 agent 怎么连接外部工具和数据;AGENTS.md 是放在仓库里的一份说明,告诉编程 agent 这个项目的规矩;Agent Skills 是按任务打包的能力,包括说明、脚本和参考资料;goose 是一个开源的 agent 框架本身。
前三个都是「agent 读什么」的格式约定,正是最需要跨平台统一的部分。一个团队如果同时用 Claude Code、Codex 和 Cursor,工具接入、仓库规矩、可复用的能力包这三样东西,现在都有了不归属于任何一家厂商的格式。
MCP 加入 AAIF 时的经验可以参考。MCP 官方博客当时写道,加入后「For MCP little changes」,决策仍然由原来的维护者做,社区通过 SEP 提案流程参与。Agent Skills 的路线图里也写了「正式提案流程」,可以对照 MCP 的 SEP 流程来理解。
规范的核心是三层渐进加载
规范对目录结构的要求很少:一个 skill 是一个目录,里面至少有一个 SKILL.md;scripts/、references/、assets/ 三个子目录是可选的约定。
SKILL.md 开头必须是 YAML frontmatter,必填字段只有两个。name 只能用小写字母、数字和连字符,长度 1 到 64,不能以连字符开头或结尾,不能出现连续两个连字符,并且必须和所在目录同名。description 长度 1 到 1024 字符,要写清楚这个 skill 做什么、什么时候该用。可选字段有 license、compatibility、metadata,以及标注为实验性的 allowed-tools。
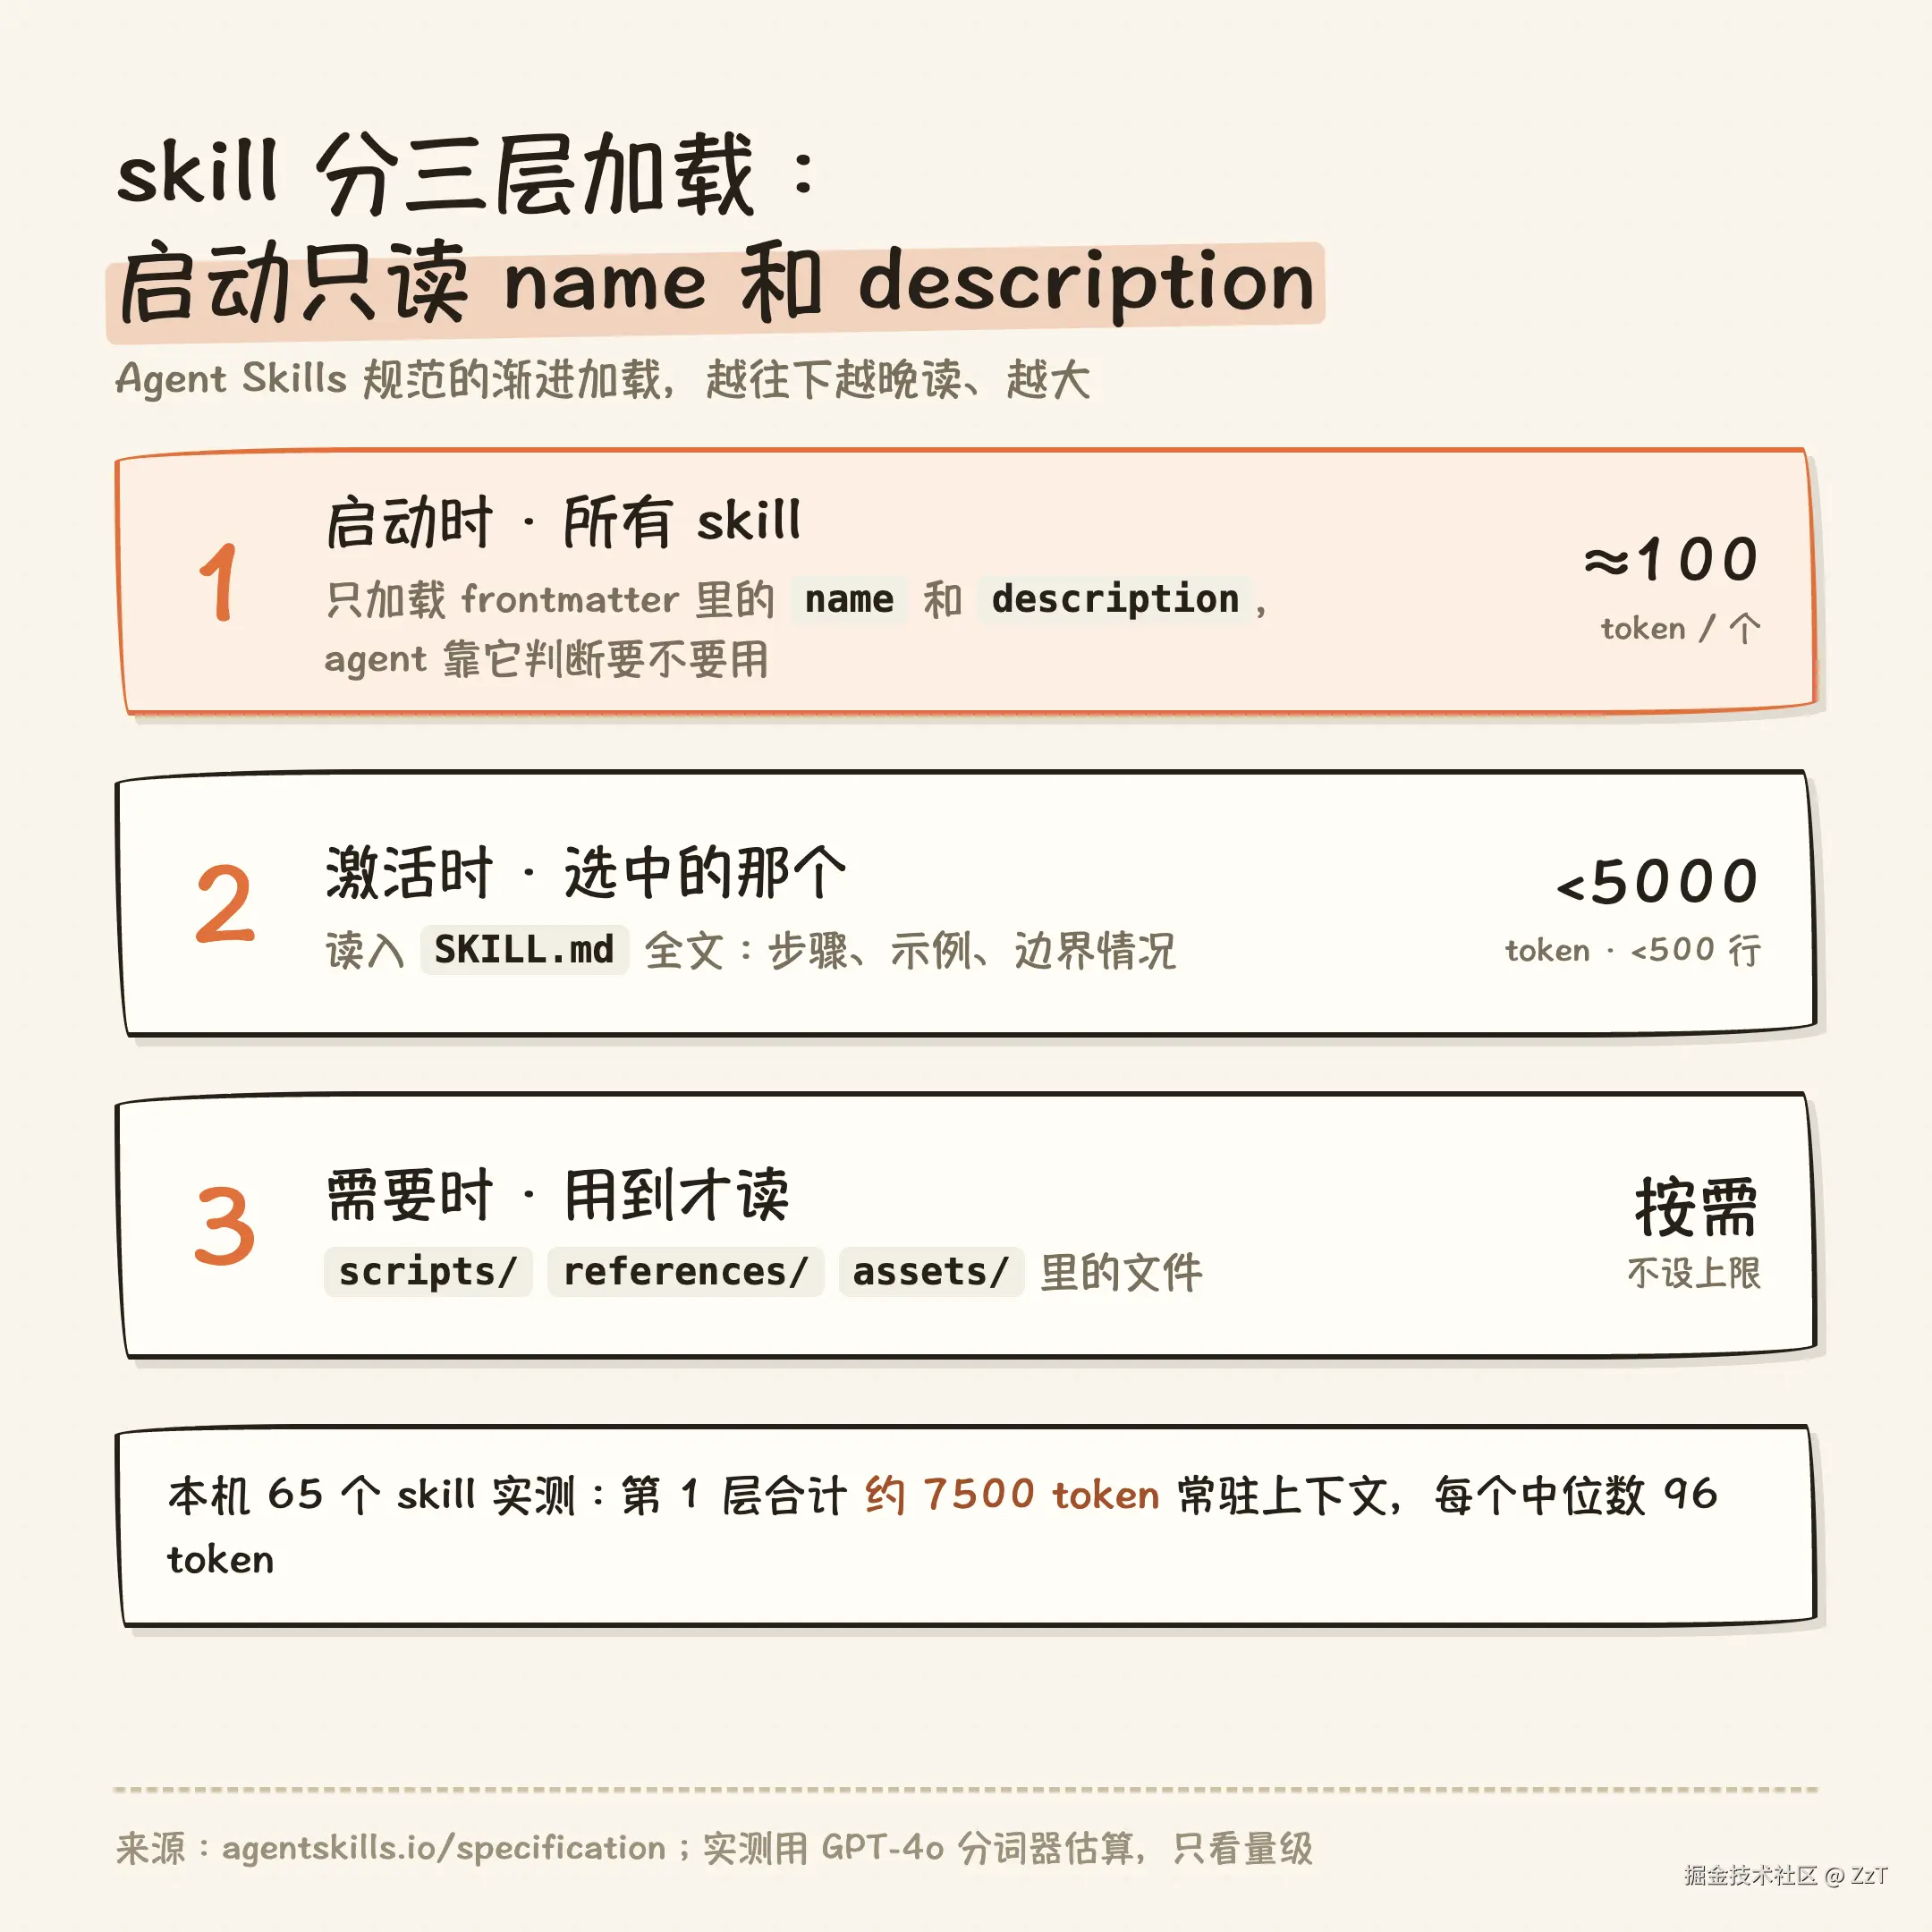
规范真正约束的是加载方式,分三层:
- 启动时:所有 skill 的 name 和 description 都会被加载,规范给的量级是每个约 100 token。
- 激活时:agent 判断要用某个 skill,才读入 SKILL.md 全文,建议控制在 5000 token 以内、500 行以内。
- 需要时:scripts、references、assets 里的文件,只在任务用到时才读。
这套设计决定了 description 的分量。它是唯一一段对所有 skill 常驻上下文的文字,agent 只能靠它判断要不要激活这个 skill。写得太短,agent 匹配不到任务;写得太长,每多装一个 skill,所有对话都要为它多付一份 token。
本地 65 个 skill 的自查结果
规范仓库提供了官方校验工具 skills-ref。这次我没有运行官方工具,而是照着规范原文,把上面每一条约束写成了一个检查脚本,对本机 Claude Code 目录下的 65 个 skill 逐个检查。token 用 GPT-4o 的分词器估算,和 Claude 实际的分词数会有出入,只看量级。
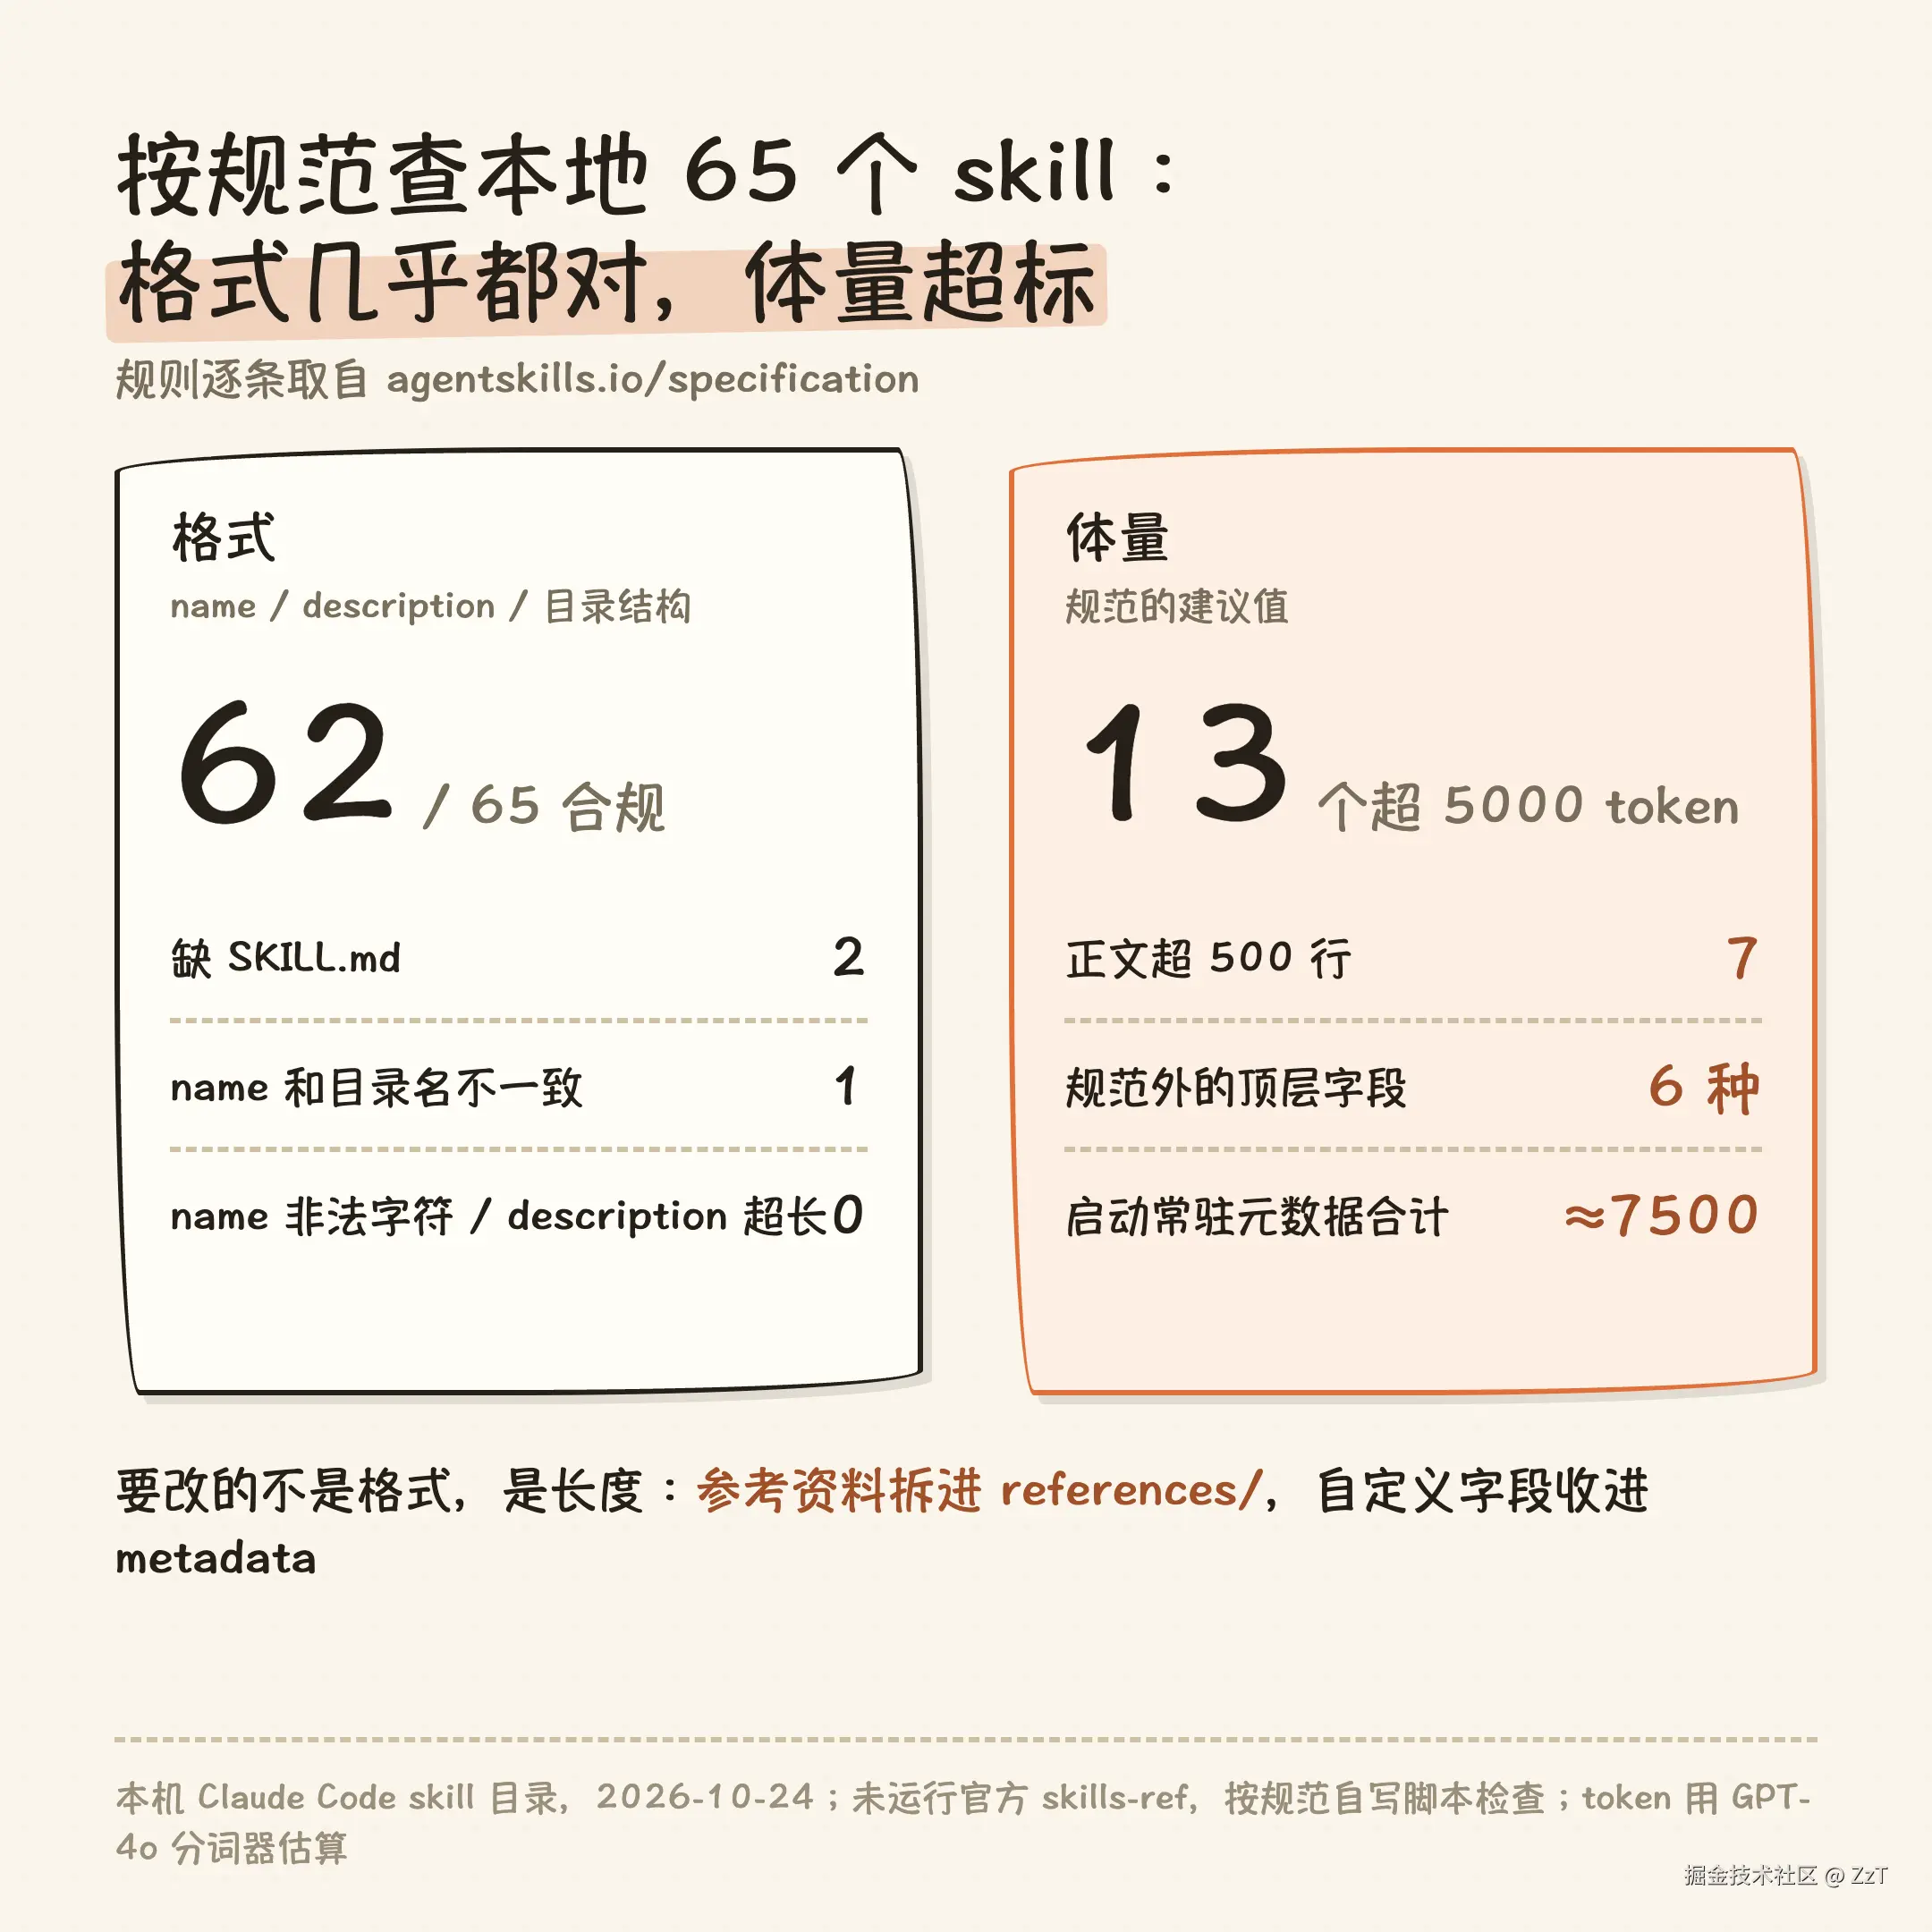
格式层面的问题很少。65 个里有 62 个完全合规,3 个有问题:2 个目录里没有 SKILL.md,1 个 name 和目录名不一致。没有出现大写字母、下划线或超长 description。
问题集中在体量上:
- 13 个 skill 正文超过 5000 token,其中 7 个超过 500 行。它们一旦被激活,就会一次性占掉相当一块上下文。
- 启动时常驻的元数据合计约 7500 token。每个 skill 的 name 加 description 中位数 96 token,和规范给的约 100 token 吻合;最长的一个有 545 token。
- 6 种规范外的 frontmatter 字段,最多的是 origin,出现在 5 个 skill 里。规范给额外信息留的位置是 metadata 字段,直接写在顶层的字段,规范没有定义,换一个平台不一定能被识别。
另有 44 个 skill 带了 scripts、references 或 assets 子目录,把细节拆到子目录、正文只留步骤的写法已经很普遍。超长的那 13 个,正是规范建议把参考资料拆进 references/ 的对象。
对写 skill 的人有哪些变化
格式本身没有变化,已经写好的 skill 不需要迁移。值得调整的是三件事。
第一,把 description 当作跨平台的接口来写。规范已经由多家公司共同维护,name 和 description 的规则会是各平台都遵守的最小公约数。description 里写清楚「做什么」和「什么时候用」,比堆砌功能列表更容易被不同的 agent 正确匹配。
第二,把平台专属信息收进 metadata。像 origin 这类自定义字段,放在顶层只有当前平台认识;metadata 是规范里明确定义的扩展位置。
第三,把来路不明的 skill 当代码看待。skill 可以带可执行脚本,allowed-tools 字段还能预先批准工具调用。路线图把「安全指南」列为待办,说明这部分规范目前还没有定。在它发布之前,第三方 skill 装进来之前,至少读一遍 scripts 目录里的内容。
规范的硬性规则只有十来条,照着原文写一个检查脚本并不费事。给自己的 skill 目录做一次体检,先看格式错误,再看哪些正文超过 5000 token、该把参考资料拆进 references/。